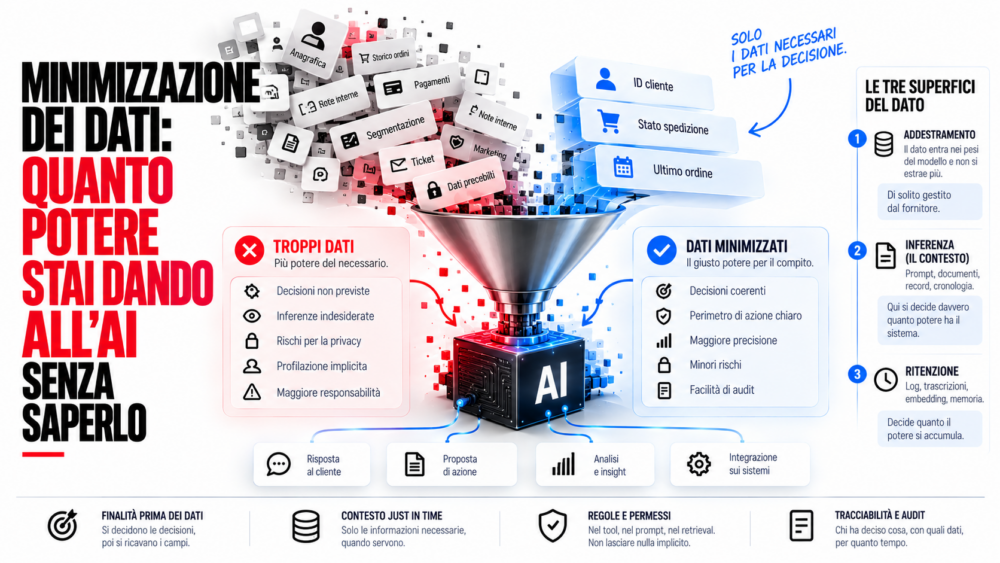
Il Global MOOC on the Ethics of AI, sviluppato da UNESCO con LG AI Research e distribuito su Coursera, dedica alla minimizzazione dei dati un video intero, dentro il modulo su privacy, protezione dei dati e data governance. Il terzo video di quel modulo si intitola “Data Minimization: Limiting What AI Systems Collect and Retain” e una delle slide dice, in sostanza, che la minimizzazione dei dati è una scelta di governance su quanto potere l’AI ricava dai dati personali. L’ho vista passare in una storia di Fabrizio Rinaldi, che il corso lo sta seguendo, e mi ha fatto tornare in mente quante volte nei progetti di adozione la minimizzazione viene trattata come la casella che il DPO spunta alla fine, quando l’architettura è già decisa.
Il principio ha dieci anni. Sta nell’articolo 5, paragrafo 1, lettera c del GDPR, approvato nel 2016 e applicabile dal maggio 2018: i dati devono essere adeguati, pertinenti e limitati a quanto necessario rispetto alle finalità. Con i sistemi basati su modelli linguistici e con gli agenti che li orchestrano, quella frase cambia natura, perché “quanto necessario” smette di essere una quantità di record in un database e diventa la misura di quello che il sistema può decidere.
Un principio del 2016 dentro un sistema del 2026
Quando il GDPR è stato scritto, il dato personale viveva in una tabella, aveva un titolare, una finalità dichiarata e un ciclo di vita che un registro dei trattamenti poteva descrivere. Minimizzare voleva dire raccogliere meno campi e cancellarli prima.
In un sistema con un LLM al centro il dato personale attraversa tre superfici diverse, con proprietari diversi. La prima è l’addestramento, dove il dato entra nei pesi del modello e da lì non si estrae più, e che per quasi tutte le aziende italiane è una superficie che appartiene al fornitore. La seconda è il contesto di inferenza, cioè quello che finisce nella finestra del modello a ogni chiamata: il prompt di sistema, i documenti recuperati, il record del cliente letto via API, la cronologia della conversazione. La terza è la ritenzione, ovvero log, trascrizioni, embedding negli indici vettoriali, file di memoria degli agenti.
La seconda superficie è quella che le aziende controllano davvero ed è quella dove la minimizzazione viene quasi sempre ignorata, perché nessuno la vede come raccolta. Il dato c’era già nel CRM, lo stiamo solo passando al modello. Ecco il punto cieco.
Il contesto come perimetro del potere
Nel manuale sui quattro livelli che sto usando come base dei corsi in accademia tratto il contesto come una risorsa finita, da assemblare, selezionare e comprimere. Qui conviene guardarlo da un’altra angolazione: tutto quello che sta nella finestra di contesto è materiale su cui il modello può ragionare, correlare e decidere, senza che nessuno gli abbia detto esplicitamente di farlo.
Facciamo un esempio numerico dichiarato tale. Un agente di assistenza clienti riceve a ogni turno il record completo dell’utente: anagrafica, storico ordini, stato dei pagamenti, note libere degli operatori, segmentazione marketing. Trenta campi, diciamo. La finalità dichiarata è rispondere a una domanda sullo stato di una spedizione. Per quella finalità servono tre campi. Gli altri ventisette non sono inerti: il modello li legge, e se nelle note libere c’è scritto “cliente difficile, ha minacciato reclamo” il tono della risposta cambierà, se nello stato pagamenti c’è un insoluto la priorità percepita cambierà, se la segmentazione dice “alto valore” l’offerta compensativa sarà più generosa. Nessuna di queste decisioni è stata progettata. Sono tutte derivate dal fatto che il dato era lì.
La minimizzazione dei dati, in questo quadro, significa decidere quali decisioni il sistema può prendere e solo dopo ricavare quali dati gli servono. La direzione del ragionamento conta. Partendo dai dati disponibili si arriva sempre a passarli tutti, perché “potrebbero servire”, e si finisce per delegare un potere decisionale che nessuno ha deliberato. Partendo dalle decisioni si arriva a un elenco di campi corto, difendibile davanti a un regolatore e, cosa che sorprende chi lo prova, a un sistema più preciso, perché il modello non viene distratto da informazioni fuori finalità.
Anthropic, nei suoi materiali sul context engineering, parla di just in time context, ovvero caricare l’informazione nel momento in cui serve invece di precaricarla tutta. È presentata come tecnica di performance. Letta con gli occhi dell’articolo 5 è una tecnica di minimizzazione, e il fatto che le due cose coincidano dovrebbe far sospettare che il trade-off tra privacy e qualità, in questi sistemi, sia molto meno netto di come lo raccontano i fornitori.
Minimizzazione dei dati nell’architettura: dalle decisioni ai campi
Sul piano tecnico la minimizzazione nel contesto si fa in tre punti dell’architettura, e in Harness engineering: runtime, contesto, permessi avevo descritto il guscio che sta intorno al modello proprio per ospitare controlli di questo tipo.
Il primo punto è la descrizione dei tool. Un tool che espone get_customer(id) e restituisce l’intero record è una decisione di governance travestita da comodità per lo sviluppatore. La versione minimizzata espone get_shipment_status(order_id) e restituisce i tre campi necessari. La differenza tra i due non è nel codice, che è banale in entrambi i casi, ma nel fatto che il secondo incorpora una finalità e il primo no. Chi scrive la firma del tool sta scrivendo il perimetro del potere dell’agente.
Poi c’è il livello di recupero. Se il sistema usa un retrieval su documenti o su un grafo della conoscenza, il filtro va messo prima che il contenuto arrivi al modello, non dopo. In L’ontologia che ti lascia cancellare un ordine avevo ragionato sul modello di dominio messo sopra i sistemi: è lì che si dichiara quali attributi di una persona sono visibili a quale ruolo, e un agente è un ruolo come un altro. Un retrieval che restituisce un chunk di testo libero contenente dati sanitari scritti da un operatore nel campo note è una violazione di minimizzazione che nessun controllo a valle recupera, perché il modello quel chunk l’ha già letto.
L’ultimo è il prompt di sistema, insieme alla memoria dell’agente. Un’istruzione del tipo “usa tutte le informazioni disponibili sul cliente per personalizzare la risposta” trasforma qualunque dato presente in contesto in input decisionale. La versione corretta nomina i campi ammessi e vieta esplicitamente di inferire attributi non forniti, con una riga che vale più di molte policy: se un’informazione non è nel contesto, non va dedotta. I modelli attuali seguono questa istruzione con una certa disciplina, che va comunque verificata con valutazioni ripetute, perché la capacità di inferenza è esattamente la cosa che li rende utili e la cosa che li rende pericolosi.
La ritenzione è dove il potere si accumula
Il titolo del video UNESCO parla di collect and retain, e la seconda parola è quella che in azienda viene dimenticata più spesso. Un sistema agentico produce dati personali nuovi a ogni turno: la trascrizione della conversazione, i log delle chiamate ai tool con i parametri in chiaro, gli embedding generati dai documenti caricati, e nei sistemi più recenti i file di memoria in cui l’agente annota quello che ha imparato sull’utente per riusarlo nelle sessioni successive.
La memoria degli agenti è il caso più delicato, perché somiglia a un beneficio. L’agente che si ricorda che il cliente preferisce essere chiamato per nome e che ha un figlio con un’allergia sta offrendo un servizio migliore e sta anche costruendo, sessione dopo sessione, un profilo che nessuna finalità dichiarata copre. In Pelle Digitale avevo descritto la mediazione tra persona e sistema come uno strato che si ispessisce con l’uso: la memoria dell’agente è quello strato, reso persistente e interrogabile.
Operativamente questo richiede tre cose che oggi quasi nessun progetto specifica: un tempo di vita per ogni classe di dato prodotto (la trascrizione sopravvive trenta giorni, il file di memoria viene rigenerato dalla sola lista dei campi ammessi, l’embedding viene cancellato con il documento sorgente), una regola su cosa l’agente può scrivere in memoria (preferenze di canale sì, informazioni sanitarie dedotte no, e questa è una riga di prompt più un controllo nel codice), e un registro che renda visibile dove ogni classe di dato è finita, perché un embedding in un indice vettoriale è un dato personale e la Corte di giustizia non ha ancora detto una parola su come si esercita il diritto di cancellazione su un vettore.
Chi firma la scelta
Se la minimizzazione dei dati è una scelta di governance, serve qualcuno che la faccia e che ne risponda. Nei progetti che seguo la scelta la prende, in pratica, chi scrive la descrizione del tool o il prompt di sistema, che di solito è uno sviluppatore con una scadenza, e viene ratificata mesi dopo da un DPO che legge il registro dei trattamenti senza aver mai visto la finestra di contesto.
Il modello che propongo ai clienti, e che ho messo dentro i gate del metodo di ZeroFive.AI, prevede che per ogni caso d’uso esista un documento di una pagina che elenca le decisioni delegate al sistema, i campi ammessi nel contesto per ciascuna, le classi di dato prodotte e il loro tempo di vita. Lo firma chi ha il potere di cambiare lo schema dei dati, non chi lo interroga, e viene riletto ogni volta che un tool cambia firma. Non è burocrazia, è la specifica del perimetro di potere che stiamo concedendo a un sistema che non ha interesse proprio ma che eredita gli interessi di chiunque gli abbia passato un dato.
La slide del corso UNESCO dice che il potere che l’AI deriva dai dati personali è una scelta. Aggiungerei che è una scelta che viene fatta comunque, anche quando nessuno la prende, e che in quel caso la prende l’architettura per default, a favore del massimo. Quante delle decisioni che i vostri agenti prendono oggi sono state deliberate da qualcuno, e quante sono semplicemente il risultato di un record passato intero?
Fonte: Global MOOC on the Ethics of AI, UNESCO e LG AI Research su Coursera, modulo “Privacy, Data Protection and Data Governance in AI”, video 3 “Data Minimization: Limiting What AI Systems Collect and Retain”.