Azienda agentica: gli otto strati da progettare prima dell’interfaccia

Da prima di agosto ho messo da parte, uno dopo l’altro, gli schemi con cui i grandi fornitori di software aziendale raccontano la loro offerta di intelligenza artificiale, per studiarli: quello di uno dei CRM più diffusi, quello della suite d’ufficio che quasi tutti abbiamo sul portatile, quelli delle piattaforme verticali per la logistica e la distribuzione e così via. Cambiano i nomi, cambiano i colori, a volte i prodotti cambiano nome da un mese all’altro e chi prova a seguirli fatica a capire cosa sia stato annunciato e cosa porta veramente di differente sul mercato.

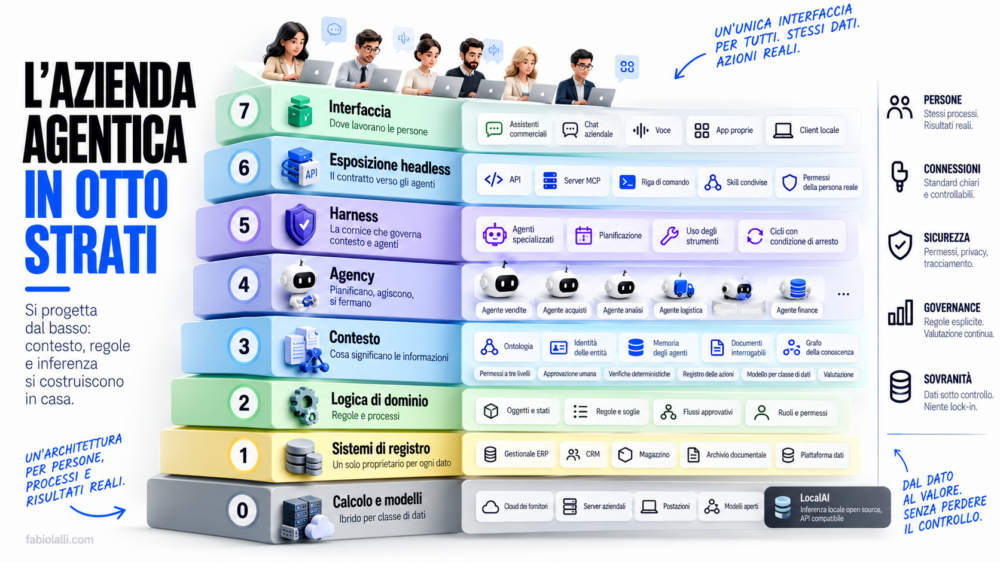
Messi uno accanto all’altro, però, disegnano la stessa torre, e ognuno a modo suo descrive l’azienda agentica.

In basso ci sono i sistemi dove vive la verità aziendale, sopra di loro uno strato che trasforma i dati in contesto leggibile da un modello, sopra ancora gli agenti che ragionano e agiscono, e in cima un’interfaccia conversazionale dove le persone fanno domande e approvano azioni.

Attorno a tutto, disegnato come una cornice e quasi mai come un piano, l’insieme di servizi che nessuno compra a parte, che spesso vanno decisi e scritti proprio internamente e che, però, tiene in piedi la costruzione: permessi, sicurezza, tracciamento delle azioni, valutazione dei risultati.

La torre descrive bene dove stanno andando le aziende dal mio punto di vista.

Gli schemi lasciano fuori, perché a chi li disegna conviene darlo per scontato, una domanda molto specifica e importante: chi possiede gli strati bassi?

Dove gira il modello, dove viene assemblato il contesto, chi può leggere il registro di quello che gli agenti hanno fatto.

Su questa domanda ho costruito il lavoro di questo ultimo anno da quando ho fondato ZeroFive.AI e che sto portando nei progetti con le aziende, con LocalAI sull’inferenza locale e con Gideon, l’ultimo nato, l’assistente che uso ogni giorno come banco di prova. In questo approfondimento provo a descrivere in modo puntuale e sintetico (nemmeno troppo) l’approccio per intero, senza marchi di fornitori, perché questa architettura dell’azienda agentica vale anche per chi non comprerà mai una licenza da nessuno di loro.

Otto strati dell’azienda agentica, letti dal basso

La versione astratta della torre, quella che vale per qualunque azienda agentica, ha 8 strati. Li descrivo partendo dal basso perché è l’ordine in cui andrebbero progettati, anche se quasi tutti i progetti che incontro partono dall’alto, dalla scelta dell’assistente da comprare per i dipendenti, o dal modello o dalla tecnologia in generale.

Strato Cosa contiene Domanda da fare prima di costruirlo
0. Calcolo e modelli dove gira l’inferenza: cloud, server aziendali, postazioni quali dati possono raggiungere quale modello?
1. Sistemi di registro gestionale, CRM, archivi documentali, magazzino per ogni dato, qual è l’unico sistema proprietario?
2. Logica di dominio oggetti, regole, flussi approvativi, permessi quali regole oggi stanno solo nella testa di qualcuno?
3. Contesto identità delle entità, ontologia, memoria degli agenti, testi vettorizzati cosa significano le informazioni e chi lo decide?
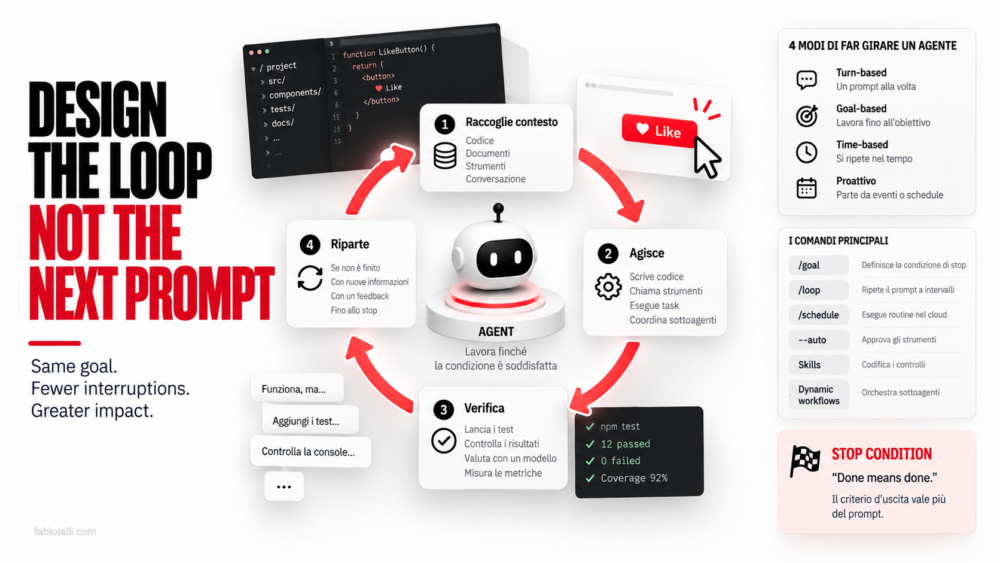
4. Agency ragionamento, pianificazione, agenti specializzati, cicli di esecuzione quali compiti si delegano e con quale condizione di arresto?
5. Harness governo, sicurezza, osservabilità, valutazione, scelta del modello cosa può fare un agente senza chiedere, e chi lo verifica?
6. Esposizione headless API, server MCP, riga di comando, skill quale contratto vede chi sta sopra?
7. Interfaccia assistenti commerciali, chat aziendali, voce, app proprie dove lavorano già le persone?

Lo strato zero è quello che nessuno compra e tutti pagano. Nella torre dei fornitori coincide con il loro cloud e non compare quasi mai nei disegni, eppure decide dove finisce ogni frase che un agente legge, e quanto costa leggerla.

Sopra stanno i sistemi di registro, che le aziende conoscono da trent’anni e che con l’arrivo degli agenti chiedono una sola regola, la più difficile da rispettare: ogni dato ha un solo sistema proprietario, e tutti gli altri lo citano invece di copiarlo. Un’anagrafica cliente duplicata in due posti produce, dopo pochi mesi, due verità su chi decide in quell’azienda, e un modello che le legge entrambe sceglie a caso quale riportare.

La logica di dominio è lo strato che trasforma i dati in processi. Un ordine ha uno stato, uno sconto oltre una certa soglia richiede una firma, un fornitore nuovo passa da una verifica prima di ricevere il primo pagamento. Molte di queste regole vivono nel codice dei gestionali, molte altre in procedure che qualcuno ha scritto anni fa, e una parte consistente solo nell’abitudine di chi fa quel lavoro da tanto tempo. Il modello dati è una teoria dell’azienda, e gli agenti la ereditano così com’è, con le scelte fatte da un consulente dieci anni fa per far quadrare la contabilità analitica.

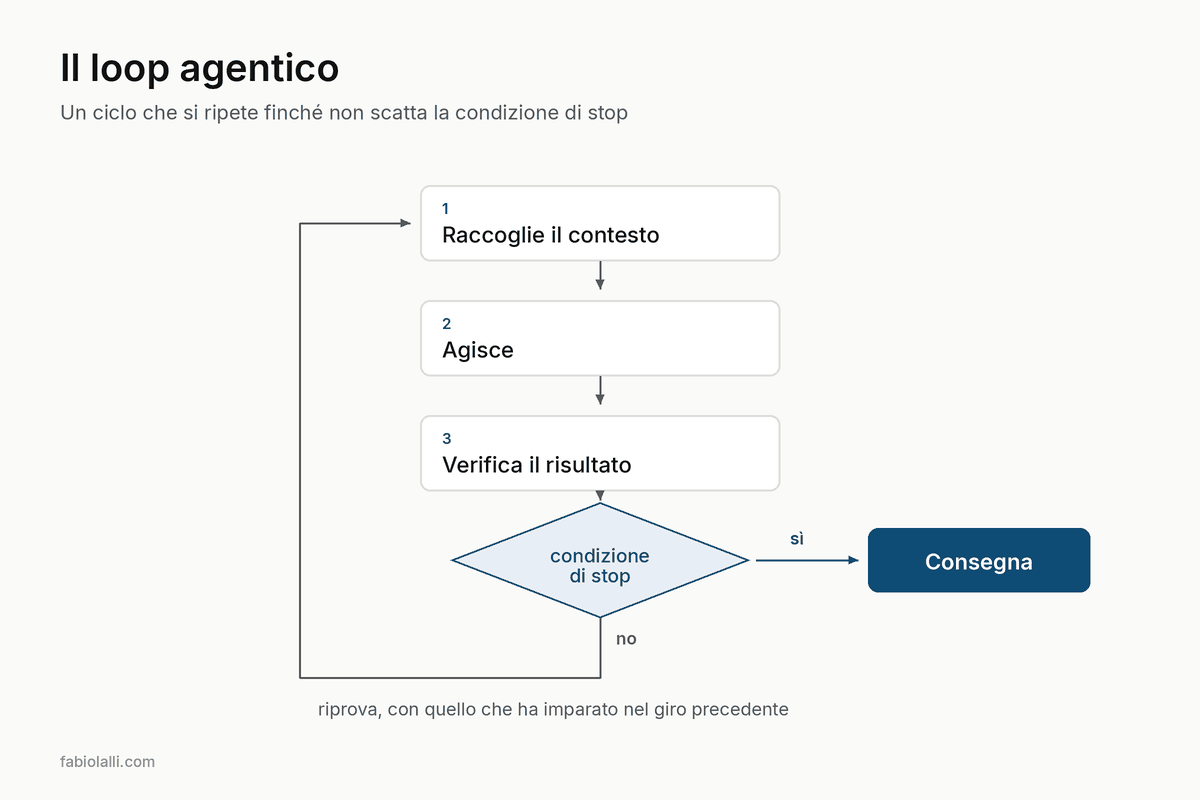
Il contesto è lo strato dove l’azienda dice a un modello cosa significano le sue informazioni: che “cliente” in amministrazione vuol dire chi ha una fattura aperta e in commerciale chi ha un’opportunità attiva, che due nomi diversi indicano la stessa persona, quale decisione presa in una riunione di marzo ha superato quella di gennaio. Qui stanno l’ontologia, la risoluzione delle identità, la memoria di lungo periodo degli agenti e il testo dei documenti reso interrogabile. Sopra lavora l’agency, cioè la parte che pianifica, sceglie gli strumenti, esegue e controlla il risultato in un ciclo che si ripete finché non scatta una condizione di arresto.

L’harness ha un numero in tabella per comodità, ma nel disegno andrebbe tracciato come una cornice attorno al contesto e agli agenti. È tutto quello che serve a un agente in produzione e che non è il modello: i permessi con cui agisce, le regole che decidono quando deve chiedere, il registro di quello che ha fatto, le verifiche automatiche sui risultati, la scelta di quale modello usare per quale classe di dati.

Sopra ancora c’è l’esposizione headless, che rende disponibile tutto quello che sta sotto senza bisogno di uno schermo, attraverso API, server MCP, riga di comando e skill.

In cima l’interfaccia, che grazie ai due strati precedenti può essere quasi qualunque cosa.

L’interfaccia esce dal centro del progetto

Per vent’anni il software aziendale ha coinciso con il suo schermo. Si comprava una licenza per ogni postazione, si formavano le persone sull’interfaccia, si misurava l’adozione contando quanti accessi faceva ciascuno ogni settimana, e il fornitore teneva il cliente proprio attraverso quell’abitudine visiva: cambiare CRM voleva dire riaddestrare centinaia di persone a cliccare in posti diversi. Il valore stava sopra, nell’interfaccia, e i dati sotto erano il prezzo da pagare per usarla.

Nell’azienda agentica questo rapporto si rovescia. Le persone lavorano dentro l’assistente che preferiscono, un client commerciale, la chat aziendale, la voce in macchina, e chiedono a quell’assistente di andare a prendere le informazioni dove si trovano e di agire per loro conto. In Pelle Digitale avevo provato a descrivere l’interfaccia come il punto di contatto fra la persona e il sistema digitale che la circonda; con gli agenti quel punto si moltiplica e si assottiglia, diventa una superficie che cambia a seconda del momento e del dispositivo, e domani anche dello spazio fisico, come racconto in Spatial Shift. Il prodotto che un’azienda deve costruire verso i propri agenti non è più uno schermo, è un contratto: quali operazioni si possono chiedere, con quali permessi, con quali garanzie sul risultato.

Il Model Context Protocol è oggi la forma più diffusa di quel contratto, e il motivo per cui lo strato sei della tabella è diventato progettabile da un’azienda di medie dimensioni senza un esercito di sviluppatori. Un server MCP espone gli strumenti di un sistema a qualunque client compatibile, e lo stesso server serve il dipendente che usa un assistente commerciale, il collega che preferisce un client locale e l’agente notturno che prepara i report del lunedì. La regola che tengo ferma in ogni progetto riguarda l’identità: il modello opera sempre con i permessi reali della persona che lo sta usando, mai con un’utenza tecnica capace di tutto.

C’è un test semplice per capire a che punto è un’azienda, e lo propongo spesso nelle prime riunioni.

Se domani i dipendenti cambiassero assistente, quanto lavoro andrebbe rifatto?

Quando la logica vive nei prompt salvati dentro il prodotto di un fornitore, nelle sue memorie e nei suoi agenti preconfigurati, va rifatto quasi tutto. Quando vive negli strati dal tre al sei, il cambio è una configurazione, e la scelta dell’assistente torna a essere una decisione su costo e riservatezza.

C’è un lavoro enorme da fare ed è sottovalutato

Nelle dimostrazioni un agente risponde in pochi secondi a una domanda sul portafoglio clienti, prepara una bozza di offerta e propone il prossimo passo commerciale. In produzione lo stesso agente deve sapere che la parola “cliente” ha tre significati in tre uffici, non deve leggere i margini se la persona che lo interroga non è autorizzata a vederli, deve lasciare traccia di quello che ha fatto e deve fermarsi quando la confidenza è bassa. Tutto questo vive in due strati che nelle demo non si vedono, il contesto e l’harness, ed è lì che passa la maggior parte del tempo di un progetto serio.

Sul contesto ho scritto molto in queste settimane, e nelle aziende lo riduco a una regola: il significato va deciso prima che lo decida un modello. Un modello collegato a dati senza tipi e senza relazioni dichiarate ricostruisce da solo il senso delle cose, ogni volta in modo leggermente diverso, e due risposte alla stessa domanda a una settimana di distanza smettono di coincidere. Un’ontologia operativa fissa i tipi di oggetto, le relazioni e le azioni ammesse su ciascuno, e ha un effetto collaterale che i direttori finanziari capiscono subito: riduce i token che un agente spende per orientarsi. Lo stesso vale per la quantità di materiale che si carica nella finestra di contesto, dove il superfluo compete con quello che serve invece di essere scartato.

L’harness è lo strato su cui i fornitori sono più indietro, e lo dicono loro stessi. In almeno uno degli annunci più ambiziosi di quest’autunno, governo e sicurezza compaiono fra le capacità della piattaforma con l’annotazione che sono in parte ancora da costruire. La parte del sistema che decide cosa può fare un agente senza chiedere, chi lo verifica e cosa rimane scritto dopo è quindi la meno matura nelle offerte chiavi in mano, e quella che chi costruisce un’azienda agentica ha più interesse a progettare in casa.

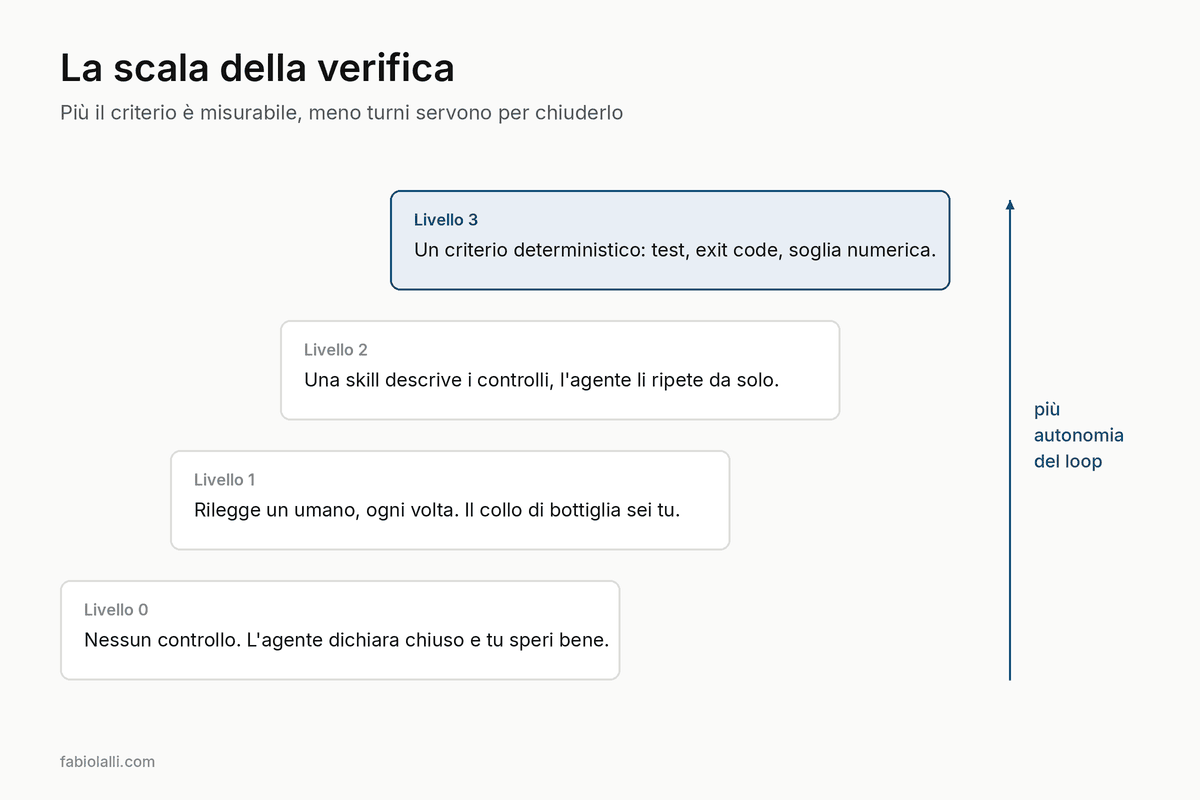
Nei progetti la scrivo prima degli agenti, con quattro famiglie di regole. I permessi sugli strumenti hanno tre livelli, negato, consentito con conferma, consentito senza conferma, e ogni strumento nasce al livello più restrittivo. Le scritture passano da un’approvazione umana: il modello propone, le persone firmano, e nessuna informazione entra nella memoria aziendale senza un responsabile con nome e cognome. Tutto quello che si può verificare in modo deterministico va tolto al giudizio del modello e affidato a uno script, dal totale di un preventivo alla validità di un pacchetto di modifiche. E ogni chiamata lascia una riga in un registro leggibile, con chi l’ha chiesta, quale modello l’ha eseguita e quali dati sono usciti dal perimetro.

Chi possiede gli strati bassi

Ogni volta che un agente lavora, il contesto viene assemblato e spedito al modello. Quel pacchetto contiene il distillato più prezioso che un’azienda produce: il modo in cui classifica i clienti, le decisioni prese e le ragioni per cui sono state prese, le relazioni fra persone, contratti e progetti. Nella torre dei grandi fornitori quel distillato viaggia verso un data center che non controlli, con le garanzie del contratto che hai firmato, a un prezzo calcolato a token che può cambiare alla prossima revisione del listino, su modelli che il fornitore può ritirare con qualche mese di preavviso. Sono condizioni accettabili per molte classi di dati, a patto di conoscerle prima della firma, cosa che capita molto meno spesso di quanto si pensi.

La sovranità di cui parlo con le aziende è una scelta per classe di dati, senza ideologia contro il cloud.

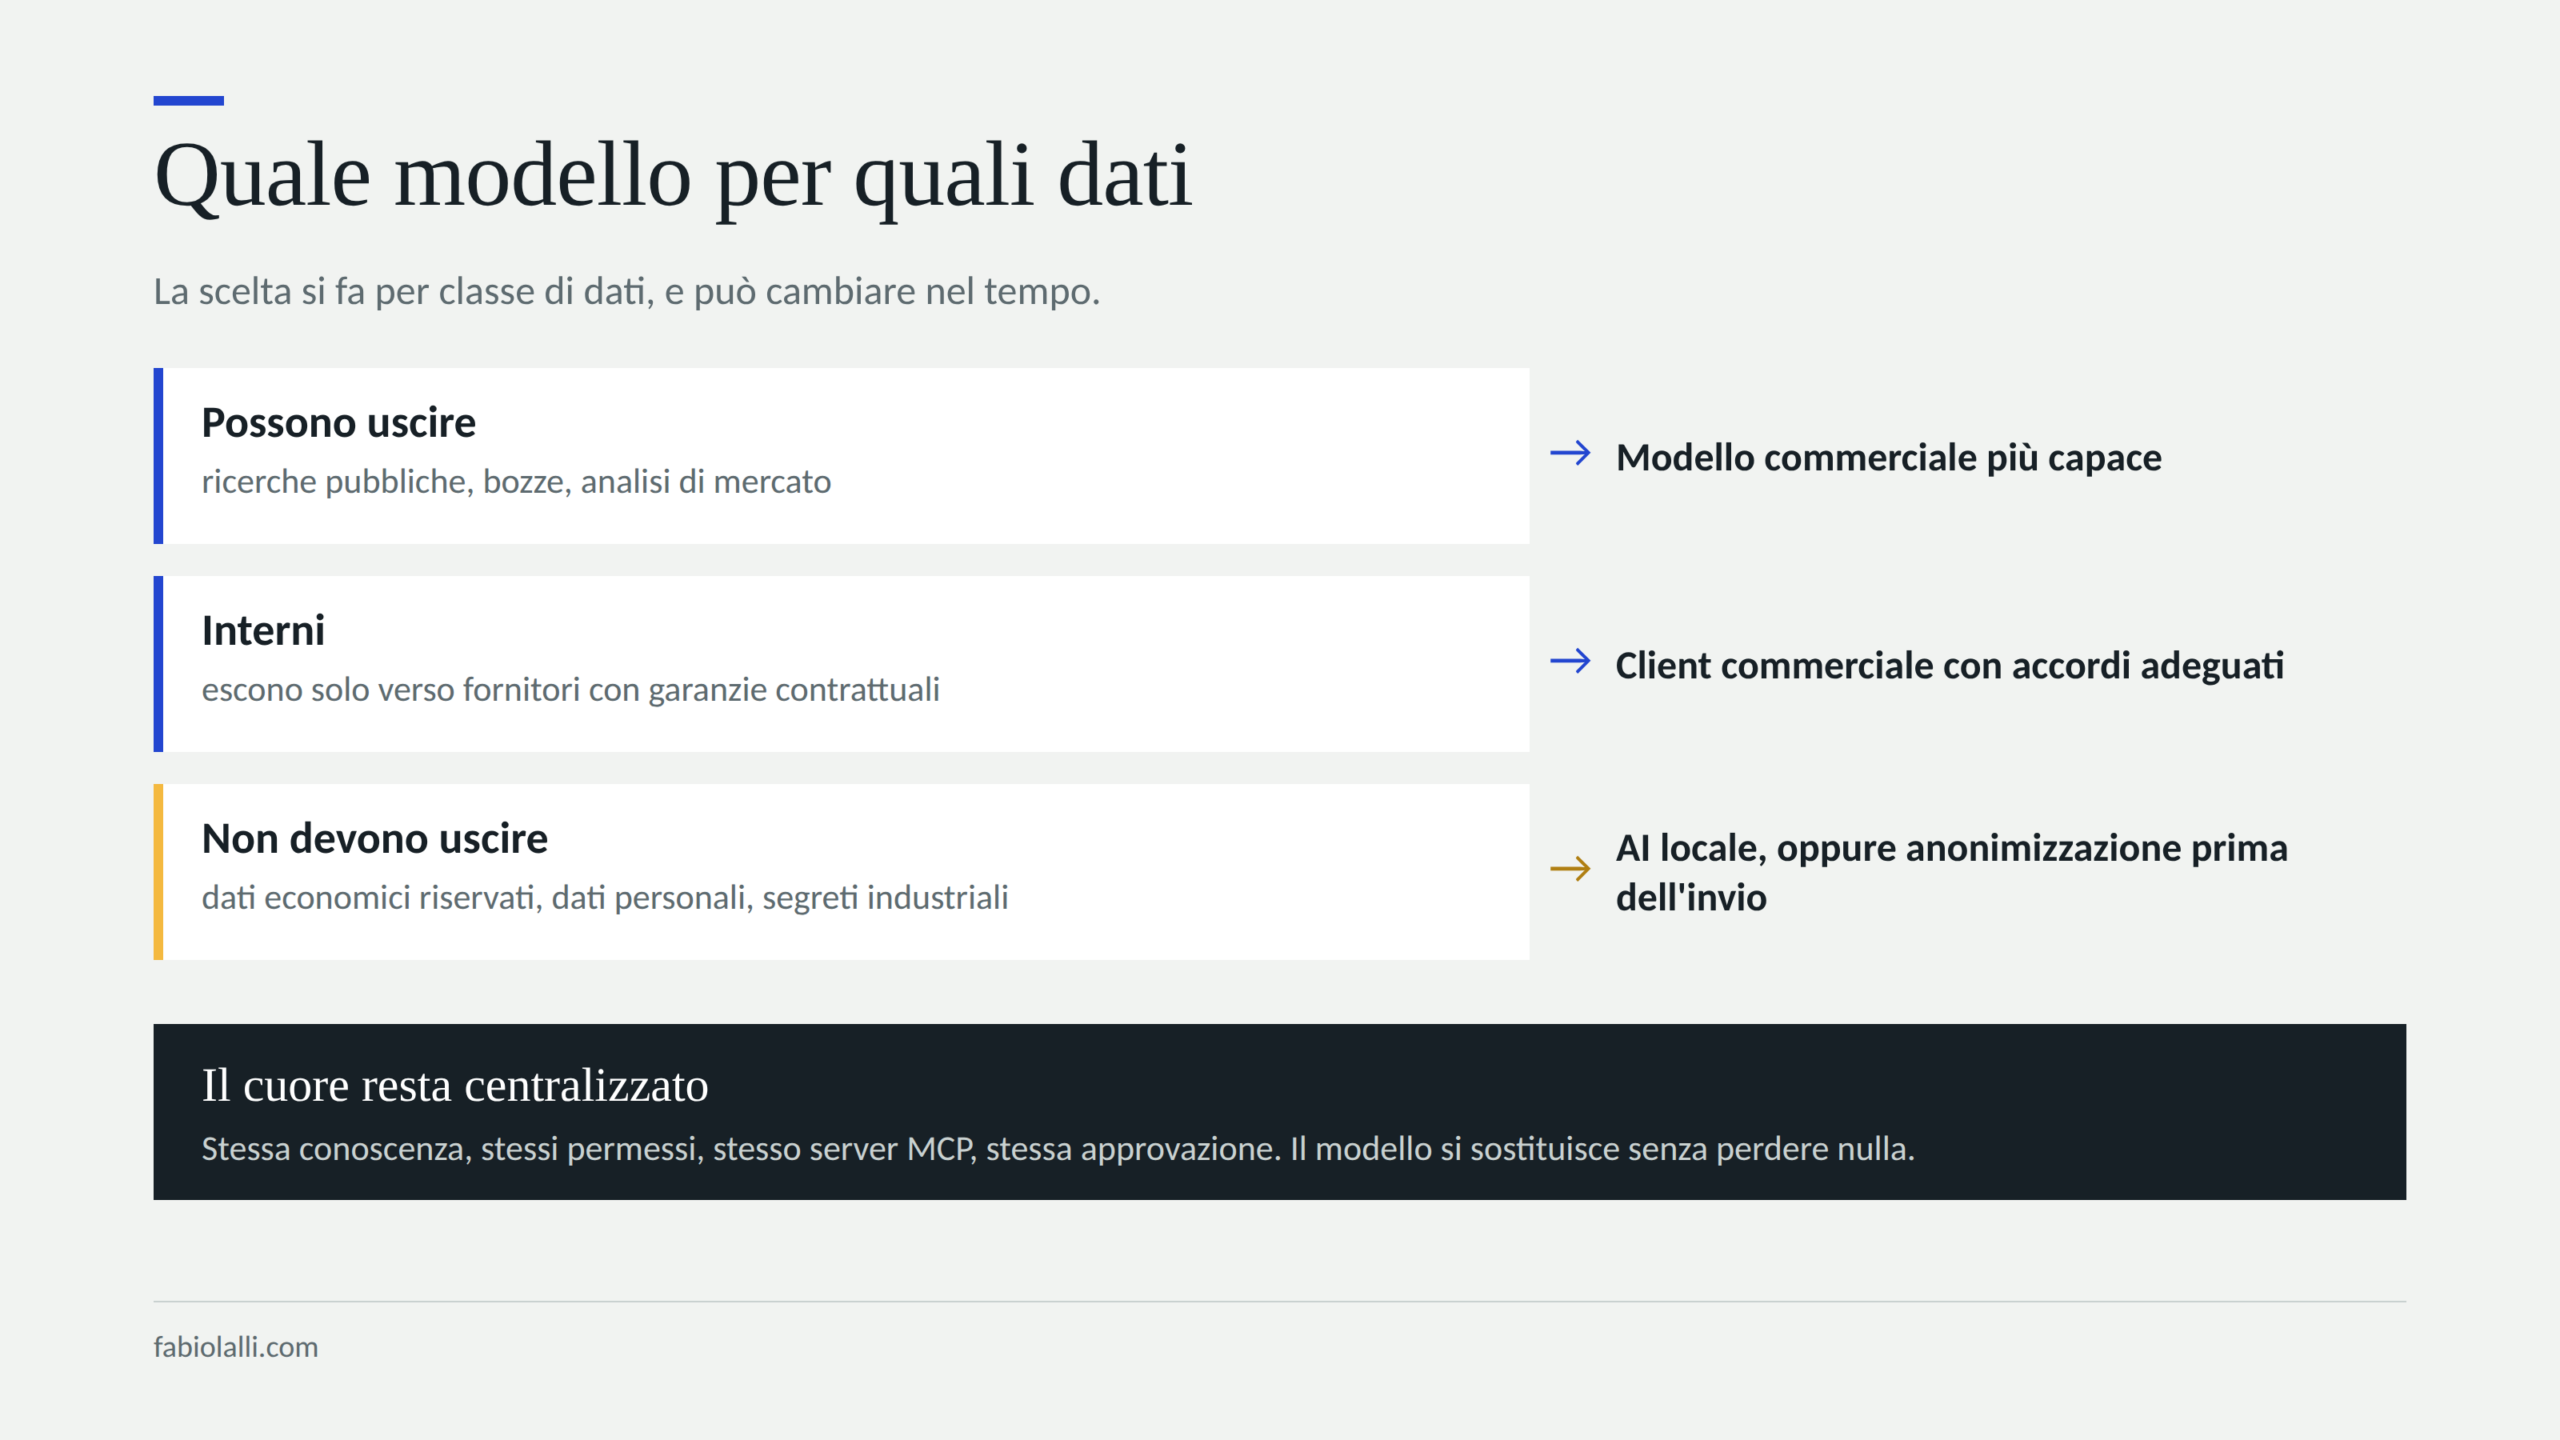
Il metodo che uso divide le informazioni in tre gruppi: quelle che possono uscire liberamente, come ricerche pubbliche e bozze di contenuti, quelle interne che possono uscire solo verso fornitori con garanzie contrattuali adeguate, quelle che non devono uscire per nessun motivo, come i dati economici riservati o i segreti industriali. Ai primi due gruppi si applica il modello più capace disponibile, al terzo un modello che gira dentro il perimetro, oppure un passaggio di anonimizzazione prima dell’invio.

Per molto tempo il terzo gruppo ha avuto poche soluzioni pratiche, perché i modelli aperti erano lontani da quelli commerciali e farli girare richiedeva competenze che un’azienda media non aveva in casa. Oggi lo strato zero si può possedere.

LocalAI, il progetto open source di inferenza locale di cui sono cofondatore e dove seguo il prodotto, nasce esattamente per questo: fa girare modelli aperti su hardware aziendale, dal server nel seminterrato alla workstation di un reparto, ed espone un’interfaccia di programmazione compatibile con quella dei principali fornitori commerciali. Gli strati che stanno sopra non si accorgono del cambio, e un’azienda può affiancare un modello locale a uno commerciale e smistare le chiamate in base alla classe del dato, senza riscrivere né il contesto né gli agenti.

L’azienda agentica che ne esce è ibrida quasi sempre, a mio avviso, e va bene così. Quello che cambia rispetto alla torre comprata intera è la posizione del cuore: ontologia, memoria, regole e registri restano dentro l’azienda, e il modello diventa un lettore che si può sostituire, affiancare o spegnere senza perdere nulla. Cambiare fornitore smette di essere un progetto di migrazione e diventa una riga di configurazione.

“Gideon” come banco di prova

Prima di proporre un’architettura a un’azienda la provo su di me. Gideon è il mio assistente personale, prende il nome dall’intelligenza artificiale di The Flash (Jarvis è troppo abusato ormai, anche io lo chiamavo così), e in questi mesi è diventato il posto dove verifico ogni strato della tabella con dati veri, i miei. Il principio di progettazione è lo stesso che porto nelle aziende: la memoria sta fuori dal modello, e il modello si può cambiare in qualunque momento.

Le funzioni su cui sto lavorando seguono gli strati quasi uno per uno. Gideon fa girare modelli locali e può affiancare modelli esterni quando il compito lo richiede, e già questo sposta la proprietà dello strato zero. Il lavoro parte da cartelle collegate e file caricati, perché la domanda più frequente che una persona fa a un assistente riguarda i propri documenti, e quei documenti devono essere interrogabili senza uscire dalla macchina. I connettori MCP, che sono la sua esposizione verso il resto del mondo, sono divisi in tre famiglie (interni all’assistente, servizi aziendali, servizi di terze parti) e per ciascuno il sistema propone una descrizione di quando usarlo, che l’utente può correggere.

L’harness è la parte dove ho investito di più. Ogni strumento ha i tre livelli di permesso, dal divieto all’esecuzione senza conferma. Una protezione della riservatezza si attiva nel campo dove si scrive la richiesta e lavora anche quando la richiesta va verso un modello esterno, togliendo dal testo quello che non deve uscire. E una pagina sullo stato del sistema mostra i consumi, le chiamate e soprattutto le uscite di dati verso terzi e verso i connettori, perché un’azienda che non sa cosa è uscito ieri non può decidere cosa far uscire domani.

Nessuna di queste funzioni è una scoperta. Ognuna esiste già da qualche parte, sparsa fra prodotti diversi, e quello che manca quasi sempre è la loro composizione in un unico sistema dove il cuore rimane in mano a chi lo usa. Gideon serve a me per capire quanto costa questa composizione, dove si inceppa e quali scelte sopravvivono al passaggio da una persona a un team.

Come accompagno un’azienda dentro lo stack

Il lavoro con le aziende comincia quasi sempre da una richiesta che sta in cima alla torre: quale assistente comprare, come portare gli agenti nel servizio clienti, come far parlare il CRM con la chat aziendale. La prima cosa che faccio è rimettere la torre in piedi, e disegnare con il team la mappa dei suoi otto strati com’è oggi. Per ogni strato scriviamo chi ne è proprietario, quale contratto espone allo strato superiore e se si potrebbe sostituire senza toccare gli altri. Le mappe che ne escono si somigliano spesso: i sistemi di registro esistono e funzionano, la logica di dominio è per metà nel software e per metà nelle persone, il contesto manca, l’harness manca, l’interfaccia è stata già comprata da qualcuno.

Da lì il percorso sale dal basso.

La classificazione dei dati nei tre gruppi viene per prima, perché decide cosa si può fare allo strato zero e quali modelli possono leggere cosa. Poi la regola del sistema proprietario per ogni dato, e un’ontologia minima che fissa i tipi di oggetto, le relazioni e chi decide quando due fonti si contraddicono. Poi l’harness, scritto prima che esista un solo agente in produzione: permessi, approvazioni, verifiche automatiche, registro delle azioni. Solo a quel punto si espongono i sistemi attraverso server MCP con i permessi reali delle persone, si costruiscono le skill condivise che fanno parlare a tutti gli assistenti la stessa lingua aziendale, e si sceglie l’interfaccia, spesso più d’una, guardando dove le persone lavorano già.

In ZeroFive.AI questo percorso è organizzato in cinque fasi, ALIGN, ASSESS, ARCHITECT, ACTIVATE e AMPLIFY (come si vede nell’immagine), con cancelli decisionali fra l’una e l’altra che il cliente deve superare prima di spendere nella fase successiva.

Il rischio legato all’AI si misura nella fase di valutazione e non a sistema già acceso, e nessun caso d’uso entra nel portafoglio senza un confronto scritto con l’alternativa che non usa l’intelligenza artificiale, perché in una parte dei casi uno script ben fatto risolve lo stesso problema a una frazione del costo.

Il “Workspace progetti” per esempio, la piattaforma con cui gestiamo i progetti dei clienti in ICONICO e Zerofive, è il caso che porto come esempio in aula per far vedere come facciamo le cose: molte delle regole descritte qui, dal sistema proprietario per ogni dato all’approvazione umana delle proposte, sono già in produzione al nostro interno, ed è il modo più rapido per mostrare a un’azienda come funzionano prima che decida se costruire le proprie.

C’è poi la parte che nessun diagramma che di solito non si trova, e cioè le persone.

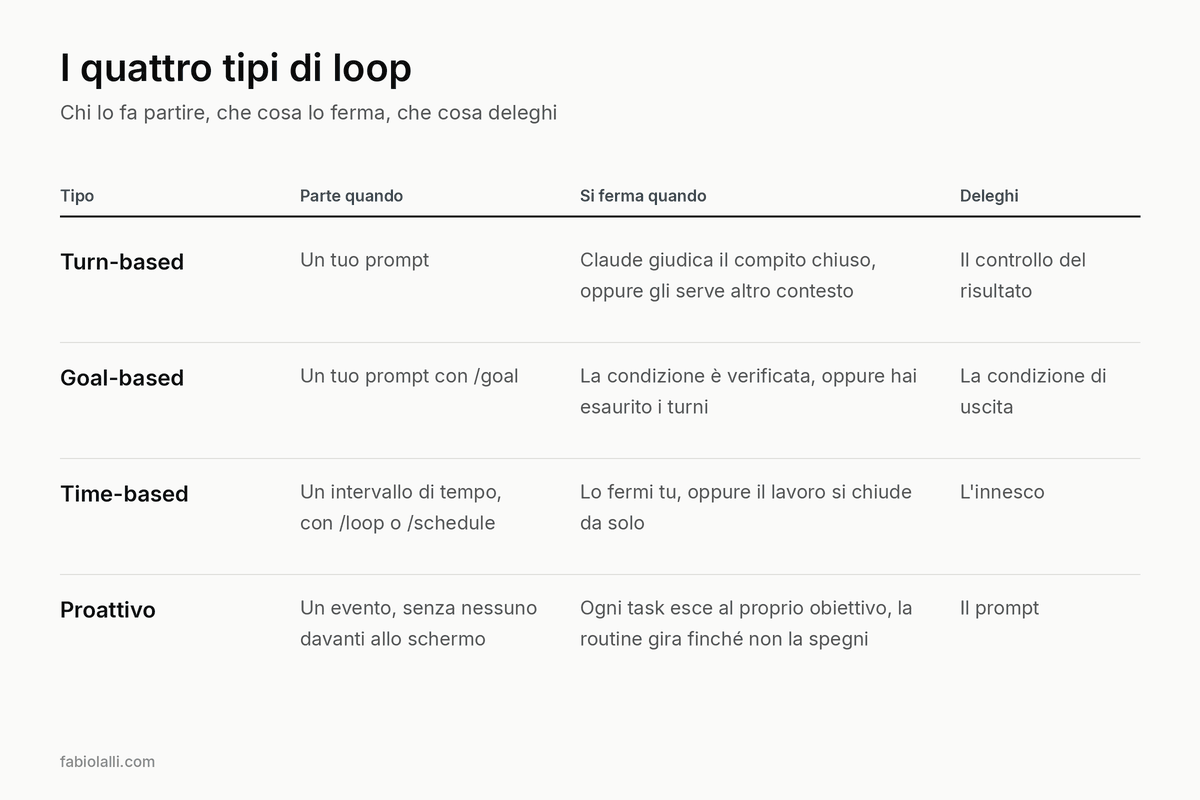
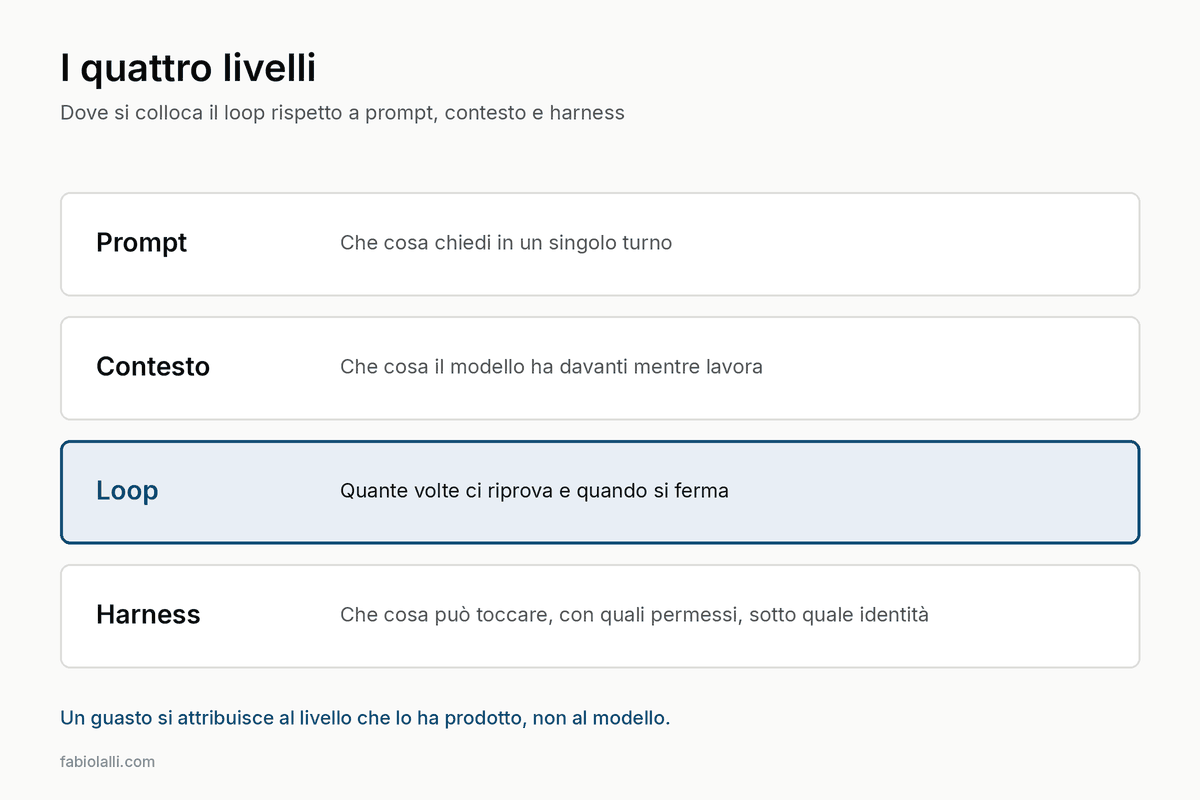
Il corso che sto portando nelle business school e nei percorsi aziendali è costruito su quattro discipline che corrispondono a 4 zone della torre: prompt engineering per l’interfaccia, context engineering per lo strato del contesto, loop engineering per gli agenti, harness engineering per la cornice che li governa.

Un’azienda che compra uno stack senza avere nessuno capace di ragionare su queste quattro zone si ritrova un sistema che funziona finché funziona, e che nessuno sa correggere quando cambia qualcosa e che soprattutto nessuno sa avere potenzialità più avanzate.

Chi vuole capire da dove partire nella propria organizzazione può scrivermi: la prima mappa degli otto strati si costruisce insieme alle persone che conoscono davvero i sistemi, e dice già molto su quali investimenti fatti finora sono riutilizzabili e quali andranno rifatti. 

Fondamenta da tenere in casa

Nei prossimi due anni l’interfaccia cambierà più volte.

Gli assistenti di oggi verranno rinominati, accorpati, sostituiti da altri che ancora non conosciamo, e una parte del lavoro passerà dalla chat alla voce e agli ambienti.

Un’azienda agentica che avrà costruito in casa il contesto, l’harness e l’esposizione dei propri sistemi cambierà assistente con la stessa facilità con cui oggi si cambia browser, e sceglierà ogni volta il modello più adatto alla classe di dati che deve trattare.

Chi avrà comprato la torre intera tratterà ogni anno con il fornitore il prezzo di accesso al proprio contesto, cioè alla descrizione più accurata di sé che abbia mai prodotto. La torre la disegneranno i fornitori, ed è giusto che sia così; le fondamenta conviene che ogni azienda le tenga a casa propria.
L’ontologia che ti lascia cancellare un ordine

Il cruscotto dice che l’ordine 4471 è fermo da sei giorni. Lo guardano il direttore commerciale, il customer care e da qualche mese anche l’agente che presidia gli SLA, tutti sulla stessa dashboard, tutti con lo stesso numero davanti. Per cancellarlo qualcuno deve aprire il gestionale, cercare la riga a mano e sapere che un ordine già uscito dal magazzino non si annulla, si gestisce come reso.

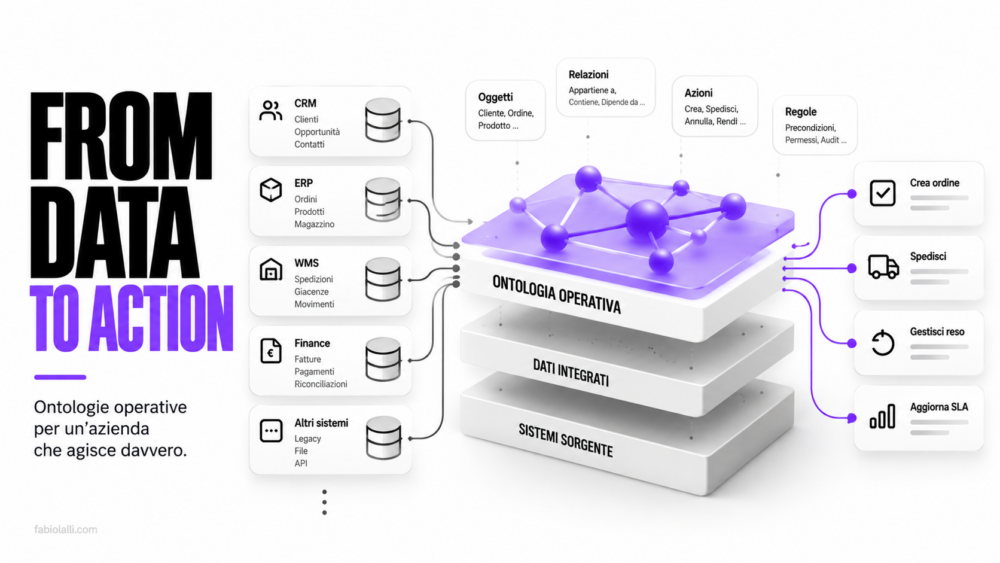
Quella distanza fra il livello dove guardi e il livello dove agisci è il residuo di dieci anni di piattaforme dati. Abbiamo costruito data lake, poi lakehouse, poi semantic layer, e ci siamo ritrovati un’azienda che si vede benissimo e che continua a muoversi dentro i sistemi sorgente, ognuno con le sue regole, scritte in epoche diverse da persone che non si sono mai parlate.

Il primo agosto un ingegnere che firma gura105 ha pubblicato su dev.to il risultato di settimane passate a smontare Palantir Foundry per capire cosa sia davvero quella cosa che in Palantir chiamano Ontology. Ne ha ricavato un nome, ontologia operativa, e quattro proprietà che si possono verificare una per una su qualunque sistema. Poi ha messo su GitHub un’implementazione di riferimento in TypeScript, licenza MIT, piccola abbastanza da leggersi in una sera, con il README anche in giapponese.

Il modello di dominio fuori dall’applicazione

Lo sviluppo di un’applicazione gestionale funziona da sempre nello stesso ordine: raccogli i requisiti, modelli il dominio, crei le tabelle che quel modello richiede, ci costruisci sopra l’applicazione. Foundry, scrive gura105, è quello stesso mestiere eseguito al contrario. I dati fisici esistono già, sono di qualcun altro, nessuno te li ha disegnati addosso, e il modello di dominio arriva dopo, sopra, come strato condiviso da cui pescano tutte le applicazioni. Un’ontologia operativa nasce esattamente da qui, dal prendere atto che i dati non li ha ordinati nessuno per te e che il modello va costruito sopra quello che c’è.

Il rovesciamento sembra un dettaglio di sequenza ed è una scelta di proprietà. Nel modo classico le regole di business vivono dentro l’applicazione che possiede le tabelle, e ogni altro consumatore o le riscrive per conto suo o le scavalca. Chi ha già lavorato su un’integrazione fra CRM e gestionale sa esattamente di cosa parlo: la regola che un ordine spedito non si cancella esiste in tre punti diversi, formulata in tre modi diversi, e almeno uno dei tre è sbagliato.

Palantir descrive la sua Ontology come un livello operativo dell’organizzazione che sta sopra gli asset digitali integrati nella piattaforma, e la divide in elementi semantici, cioè oggetti, proprietà e relazioni, ed elementi cinetici, cioè azioni, funzioni e sicurezza dinamica. La parte semantica la conosciamo tutti, è quella di cui ho scritto parlando di ontologie e grafi di conoscenza. La parte cinetica è quella che nessun semantic layer ha mai avuto, e coincide con il motivo per cui Foundry costa quello che costa.

C’è un vantaggio pratico in questa inversione, ed è il motivo per cui la trovo adatta alle aziende italiane più di quanto sembri. Non chiede di migrare niente. Il gestionale del 2011 resta dov’è, con la sua teoria implicita dell’azienda scritta da un consulente che non c’è più, e sopra ci metti un modello che dice cosa significano davvero cliente, ordine e prodotto oggi, senza toccare una riga di quelle tabelle.

Un semantic layer non cancella un ordine

Le quattro proprietà che fanno di un sistema un’ontologia operativa sono un test, non una certificazione, e gura105 le ha scritte in modo che siano verificabili guardando il comportamento di quel sistema invece che la sua brochure.

La prima chiede che oggetti e relazioni siano modellati esplicitamente sopra dati fisici che esistevano prima e che appartengono ad altri. La seconda chiede che lo stato cambi solo attraverso azioni con un nome, senza nessun percorso di aggiornamento generico, né per l’utente né per l’applicazione né per l’agente. La terza chiede che le regole di dominio stiano dentro l’azione, come precondizioni che rifiutano le violazioni con errori leggibili da una macchina, e che ogni tentativo finisca nel registro, compresi quelli respinti. La quarta chiede che il modello dichiari, per ogni pezzo di stato, quale sistema ne è proprietario, e che le modifiche tornino indietro verso quel sistema.

Il test che le riassume sta in una domanda da fare in riunione, dal vostro semantic layer si può cancellare un ordine? Se la risposta è no, avete un livello di lettura, che è una cosa utile e diversa. Se è sì ma nessuna riga cambia in nessun sistema di record, avete un database parallelo che fra sei mesi diverge dal gestionale e nessuno saprà quale dei due ha ragione. Se cancella anche gli ordini già spediti senza fare una piega, avete una write API, e la terza proprietà è tutta la differenza.

Lo scenario del demo è volutamente banale, ed è per questo che funziona. Un’azienda ne compra un’altra e si ritrova due sistemi ordini legacy, schemi diversi, codifiche di stato diverse, la solita eredità che in Italia conosciamo bene dopo ogni operazione straordinaria. Qualche decina di righe di SQL li integra, l’ontologia modella sopra cliente, ordine e prodotto, e aggiunge un tipo che in nessuno dei due sistemi esiste: la nota. Poi il demo attraversa la relazione per rispondere a quali ordini contengono un certo prodotto pescando da entrambi i sistemi, assegna un ordine a una persona scrivendo uno stato che nel legacy non ha nemmeno una colonna, si vede rifiutare la cancellazione di un ordine spedito, ne cancella uno aperto e la riga nell’ERP cambia davvero, poi ricarica le sorgenti e l’assegnazione sopravvive al refresh.

Dal permesso revocabile all’azione che lascia traccia

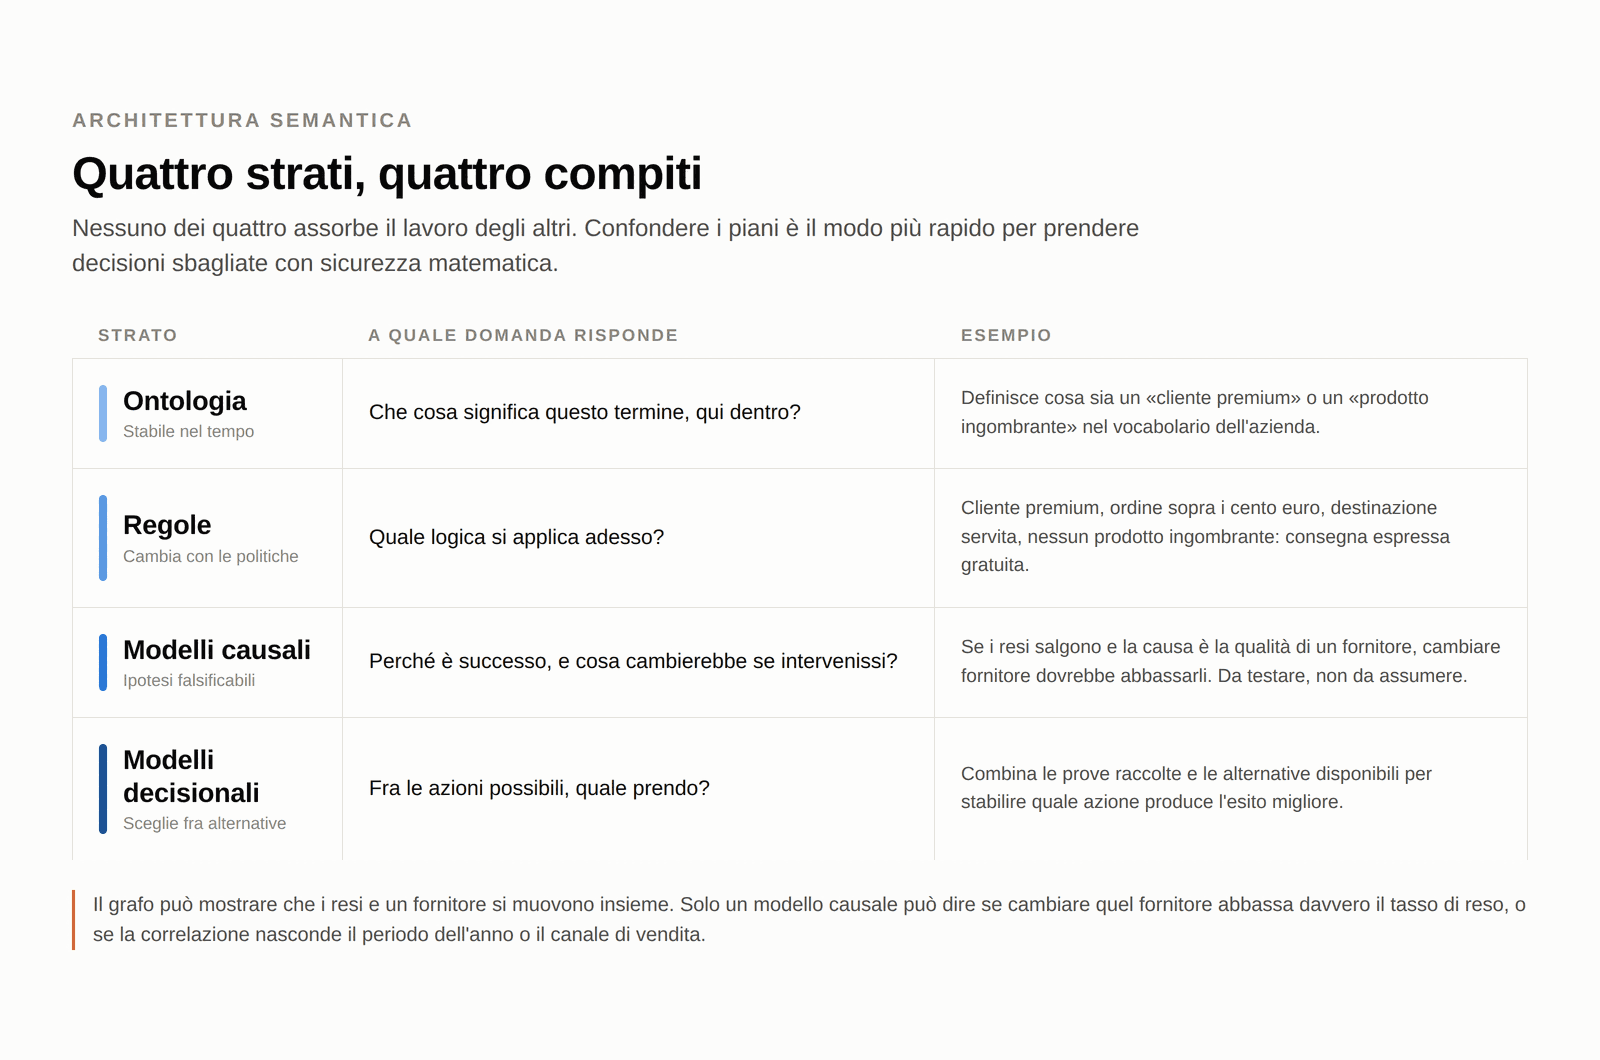
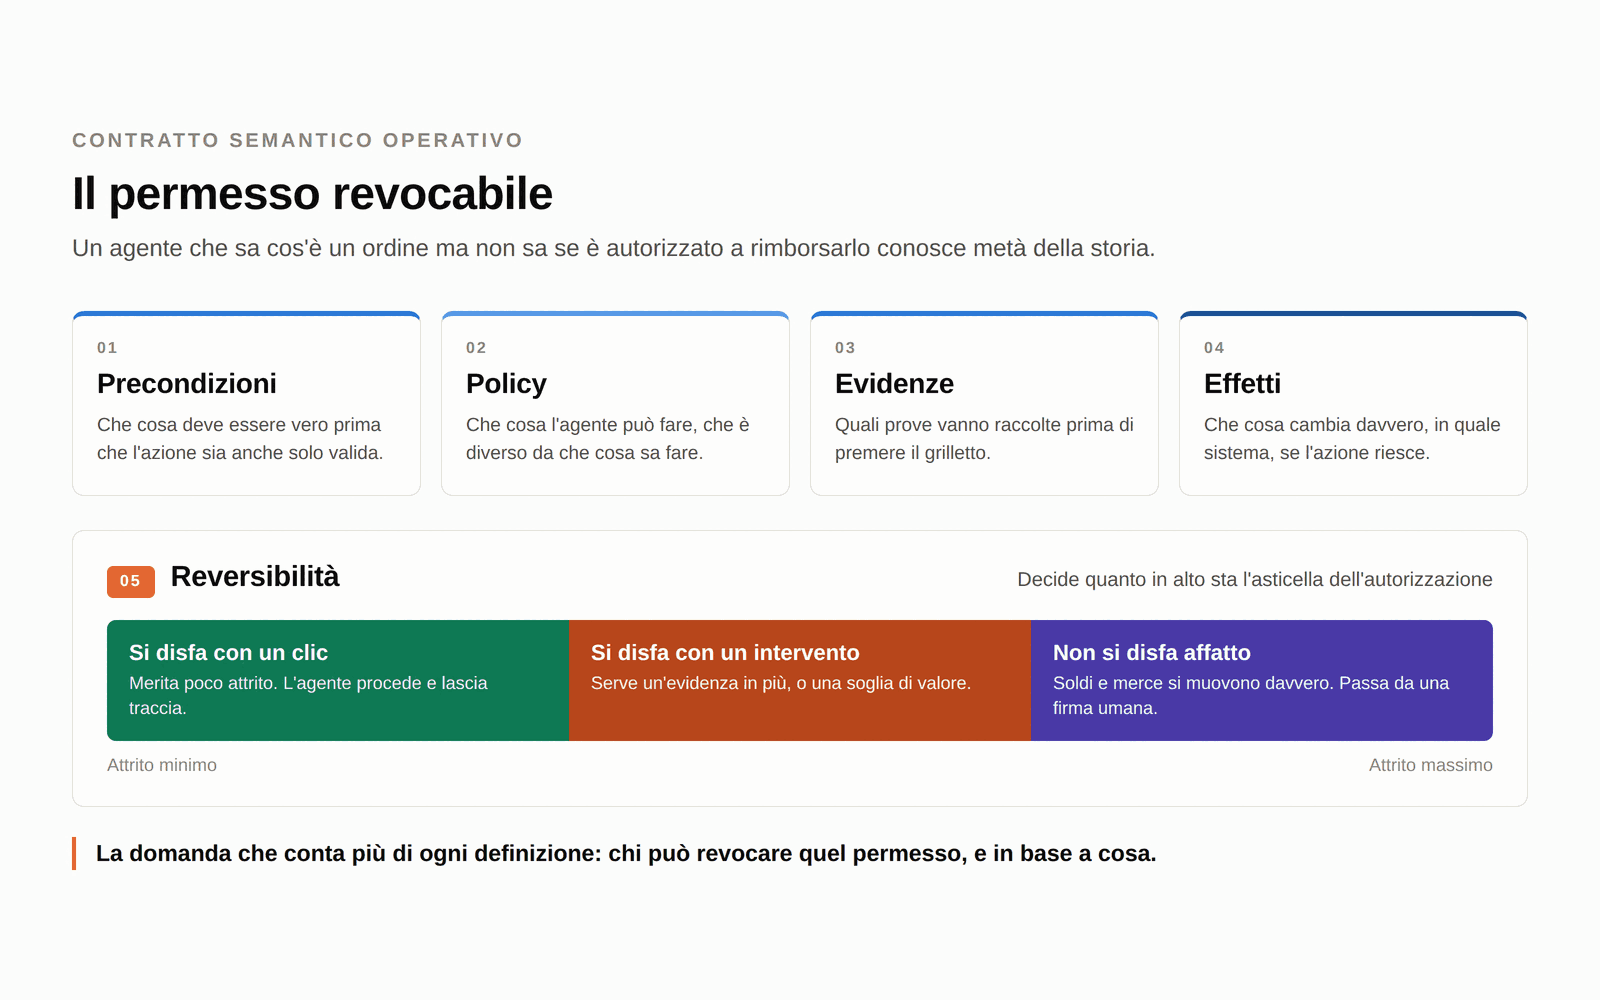
Ad agosto, commentando la mappa di Fanghua Yu sull’evoluzione dell’ontologia, avevo chiamato permesso revocabile quello che lui chiamava contratto semantico operativo: un agente che sa cos’è un ordine ma non sa se è autorizzato a rimborsarlo conosce metà della storia, e la parte che gli manca è fatta di precondizioni, evidenze, effetti e reversibilità. Quel pezzo si fermava dove finiva il concetto. Questo repository è il primo posto dove lo vedo messo in codice eseguibile, con i rifiuti che portano un codice e il registro che si scrive da solo.

Nel modello, le precondizioni sono una chiave obbligatoria. Una lista vuota va dichiarata, perché scrivere che un’azione non ha condizioni è una decisione che qualcuno deve prendersi, non un default che si eredita per distrazione. La dichiarazione di proprietà segue la stessa logica: ogni pezzo di stato è di qualcuno, e le possibilità sono tre. Quando il dato è mastered a monte, come lo status dell’ordine che vive nell’ERP, la modifica torna indietro verso quel sistema come effetto collaterale governato, e la sorgente conserva l’autorità. Per l’assegnatario o la nota di triage, che nel legacy non hanno nemmeno una colonna dove stare, il sistema di record diventa l’ontologia stessa, per dichiarazione esplicita e non per ripiego. Il terzo caso è lo stato calcolato, che non si scrive mai.

Quello che la proprietà vieta è lo stato senza padrone dichiarato, cioè la copia locale di un dato altrui che viene modificata e non torna mai indietro. È esattamente la situazione in cui si trovano parecchi progetti di data platform che ho visto passare sui tavoli negli ultimi anni, e che nessuno chiama con il suo nome finché non arriva la prima riconciliazione a mano.

Il runtime non si fida delle dichiarazioni, le verifica. Prima di eseguire qualunque azione valida i parametri, valuta le precondizioni, genera il piano di modifiche, lo prova a vuoto passando dallo stesso codice che userà per il commit, poi lo confronta con le dichiarazioni di proprietà e lo rifiuta se un’azione tocca stato del sistema di record senza averlo dichiarato, oppure se ne mescola due tipi nello stesso piano. Solo dopo scrive verso la sorgente, e solo alla fine committa le modifiche e la riga di registro in un’unica transazione.

L’ordine di quei passaggi porta con sé una scelta che va guardata bene. Il write-back gira prima del commit locale, quindi se l’ERP rifiuta non cambia niente da questa parte. Il fallimento opposto può comunque accadere: la sorgente accetta, il commit locale fallisce, i due sistemi divergono e la riconciliazione tocca a un essere umano. Il repository lo scrive in chiaro e aggiunge che la documentazione di Palantir ammette lo stesso buco nella propria modalità di write-back. Quella franchezza sul limite, per me, vale più di metà delle slide di architettura che mi capita di leggere, e andrebbe usata come criterio per valutare chiunque venda qualcosa di simile.

Il registro, intanto, tiene tutto: i tentativi applicati, quelli rifiutati, quelli andati in crash, con il piano completo. Sulla tracciabilità come prova di un’azione automatica torno spesso, e qui il materiale che l’AI Act chiede di saper ricostruire per i sistemi ad alto rischio, con un calendario che il Digital Omnibus ha rimesso in discussione, si produce da sé come sottoprodotto dell’architettura invece che come adempimento aggiunto dopo.

Le regole non stanno nel prompt

La superficie MCP viene generata dal modello. Uno strumento per ogni forma di interrogazione, uno per ogni azione, e nessuno strumento SQL grezzo, il che significa che un agente riceve esattamente le operazioni che il dominio definisce e nient’altro. Le stesse precondizioni che valgono per una persona valgono per lui, e quando prova a cancellare un ordine spedito si prende in faccia un SHIPPED_ORDER_CANNOT_BE_CANCELLED, un rifiuto che può leggere, da cui può recuperare e che può spiegare al suo utente senza inventarsi una scusa.

Vale la pena mettere in fila le alternative, perché è la scelta che in questo momento sta facendo chiunque colleghi un modello ai sistemi aziendali. Con un MCP sul database l’agente legge tabelle e scrive UPDATE senza limiti, e le regole di business stanno nel prompt, cioè da nessuna parte, perché un prompt è una raccomandazione e non un cancello. Con un semantic layer o un MCP di metriche si ottengono letture governate e nessuna scrittura. Con una collezione di wrapper API ogni endpoint applica le regole del backend che ha dietro, in modo diverso dagli altri, e la coerenza la garantisce la speranza. Con un’ontologia operativa le letture sono oggetti e relazioni, le scritture passano solo da azioni con un nome, e le regole stanno nel modello insieme al registro dei tentativi.

Su questo passaggio si gioca una partita che in Italia è appena cominciata. Nei progetti che seguo la richiesta arriva quasi sempre nella stessa forma, collegare un modello al gestionale perché sbrighi da solo le tre o quattro cose ripetitive che oggi occupano una persona a tempo pieno, e la soluzione più rapida da costruire è anche quella più difficile da difendere: un accesso diretto al database con un prompt lungo che spiega cosa non deve fare. Regge la demo, regge qualche settimana in produzione, e cade il giorno in cui un caso limite che nessuno aveva previsto incontra un modello che quella mattina interpreta la raccomandazione in modo un po’ più largo del solito.

È la stessa cosa che chiamo harness engineering quando parlo del guscio che decide se un agente regge in produzione, portata però al livello dell’azienda intera invece che del singolo workflow. Il guscio smette di essere un file di configurazione scritto da chi ha costruito quell’agente lì e diventa infrastruttura condivisa, la stessa per il cruscotto del direttore commerciale, per lo script del controllo di gestione e per il modello che presidia gli SLA.

Anche le letture portano un’identità: ogni chiamata gira per conto di un attore e le policy di visibilità attaccate al modello decidono cosa quell’attore vede, con un oggetto nascosto che è indistinguibile da uno che non esiste. Sulla parte di autenticazione il repository è disarmante: su stdio tutti i chiamanti collassano in un attore solo, il nome si passa da variabile d’ambiente, ed è etichettatura, non protezione. Dichiarare dove finisce la dimostrazione è la ragione per cui mi fido del resto.

Dove l’ontologia operativa si ferma

La versione zero ha come unico obiettivo la leggibilità, quindi le assenze sono parecchie e sono tutte elencate. Niente cancellazioni, niente proprietà sulle relazioni, niente chiavi composte, nessuna infrastruttura di indicizzazione, nessun costruttore di interfacce. Niente federazione, soprattutto: un’ontologia è un contesto delimitato, e chi possiede il modello quando ce ne sono cinque in cinque divisioni è una domanda vera che il repository dichiara di non affrontare.

L’evoluzione dello schema sta fuori per la stessa ragione, con una scelta che trovo elegante. Il modello è un valore, cioè un pezzo di codice enumerabile, quindi si diffa, si versiona e si revisiona come qualunque altro sorgente, e la governance dello schema viene delegata in blocco a git. Ne esce una separazione netta fra due canali: le istanze si governano a runtime con le azioni e il registro, lo schema si governa in fase di sviluppo con le pull request. Chi in azienda ha il potere di approvare quella pull request ha il potere di ridefinire cosa significa cliente, ed è una carica che nessun organigramma ha mai assegnato formalmente.

C’è poi un default che per un’azienda europea è sbagliato e che il repository dichiara sbagliato per sé: un oggetto senza policy è visibile a chiunque. La dimostrazione non ha autenticazione, quindi fingere di essere chiusi non avrebbe senso, e chi volesse portarlo verso un deployment reale parte dal rendere obbligatoria la visibilità e aggiunge sotto autenticazione vera, permessi sulle azioni e accesso al registro con i suoi confini.

Fuori dallo scopo c’è anche la parte che rende Foundry un prodotto da milioni di euro, cioè l’indicizzazione incrementale, gli indici di adiacenza e i backend di ricerca che servono miliardi di oggetti con tempi di risposta accettabili. Su scala dimostrativa una query ingenua basta, e l’autore lo dichiara senza giri, perché la scala appartiene alle implementazioni e non al pattern. Vale come promemoria per chi legge poche centinaia di righe di TypeScript e crede di avere in mano un sostituto: qui c’è la definizione, non il prodotto che la applica a un’azienda da ventimila persone.

Da qui esce la cosa più riutilizzabile di tutto il lavoro, e la consiglio a chi in questi mesi si trova sul tavolo offerte di piattaforme che si sono ribattezzate ontologie nel giro di un trimestre. Qualunque ontologia operativa deve dichiarare quattro cose: chi possiede ogni pezzo di stato, cosa succede quando la scrittura verso la sorgente riesce e il commit locale no, se le modifiche fatte nell’ontologia sopravvivono a un ricaricamento delle sorgenti, e cosa vede chi non ha nessuna policy addosso. Le quattro risposte possono essere diverse da quelle di questo repository e il sistema rimane dentro il pattern. Quello che non può succedere è che il fornitore non le abbia, perché senza quelle dichiarazioni il permesso revocabile di cui parliamo da mesi non ha niente a cui appoggiarsi.

La domanda che mi è venuta in mente dopo aver letto il codice non riguarda Palantir, e nemmeno la scelta fra costruire e comprare. Riguarda chi oggi dentro un’organizzazione italiana di media dimensione ha oggi l’autorità di dichiarare che lo status di un ordine appartiene all’ERP e l’assegnatario appartiene all’ontologia operativa. È una dichiarazione tecnica nella forma e una delibera nella sostanza, perché stabilisce chi può cambiare cosa e sotto quali condizioni quel permesso continua a valere, che è poi il cuore del permesso revocabile applicato ai sistemi invece che agli agenti. Prima o poi arriva sul tavolo di qualcuno che non l’ha chiesta, nel momento peggiore, sotto forma di due numeri diversi per lo stesso ordine.

Company Brain: come si costruisce il “Jarvis” di un’azienda

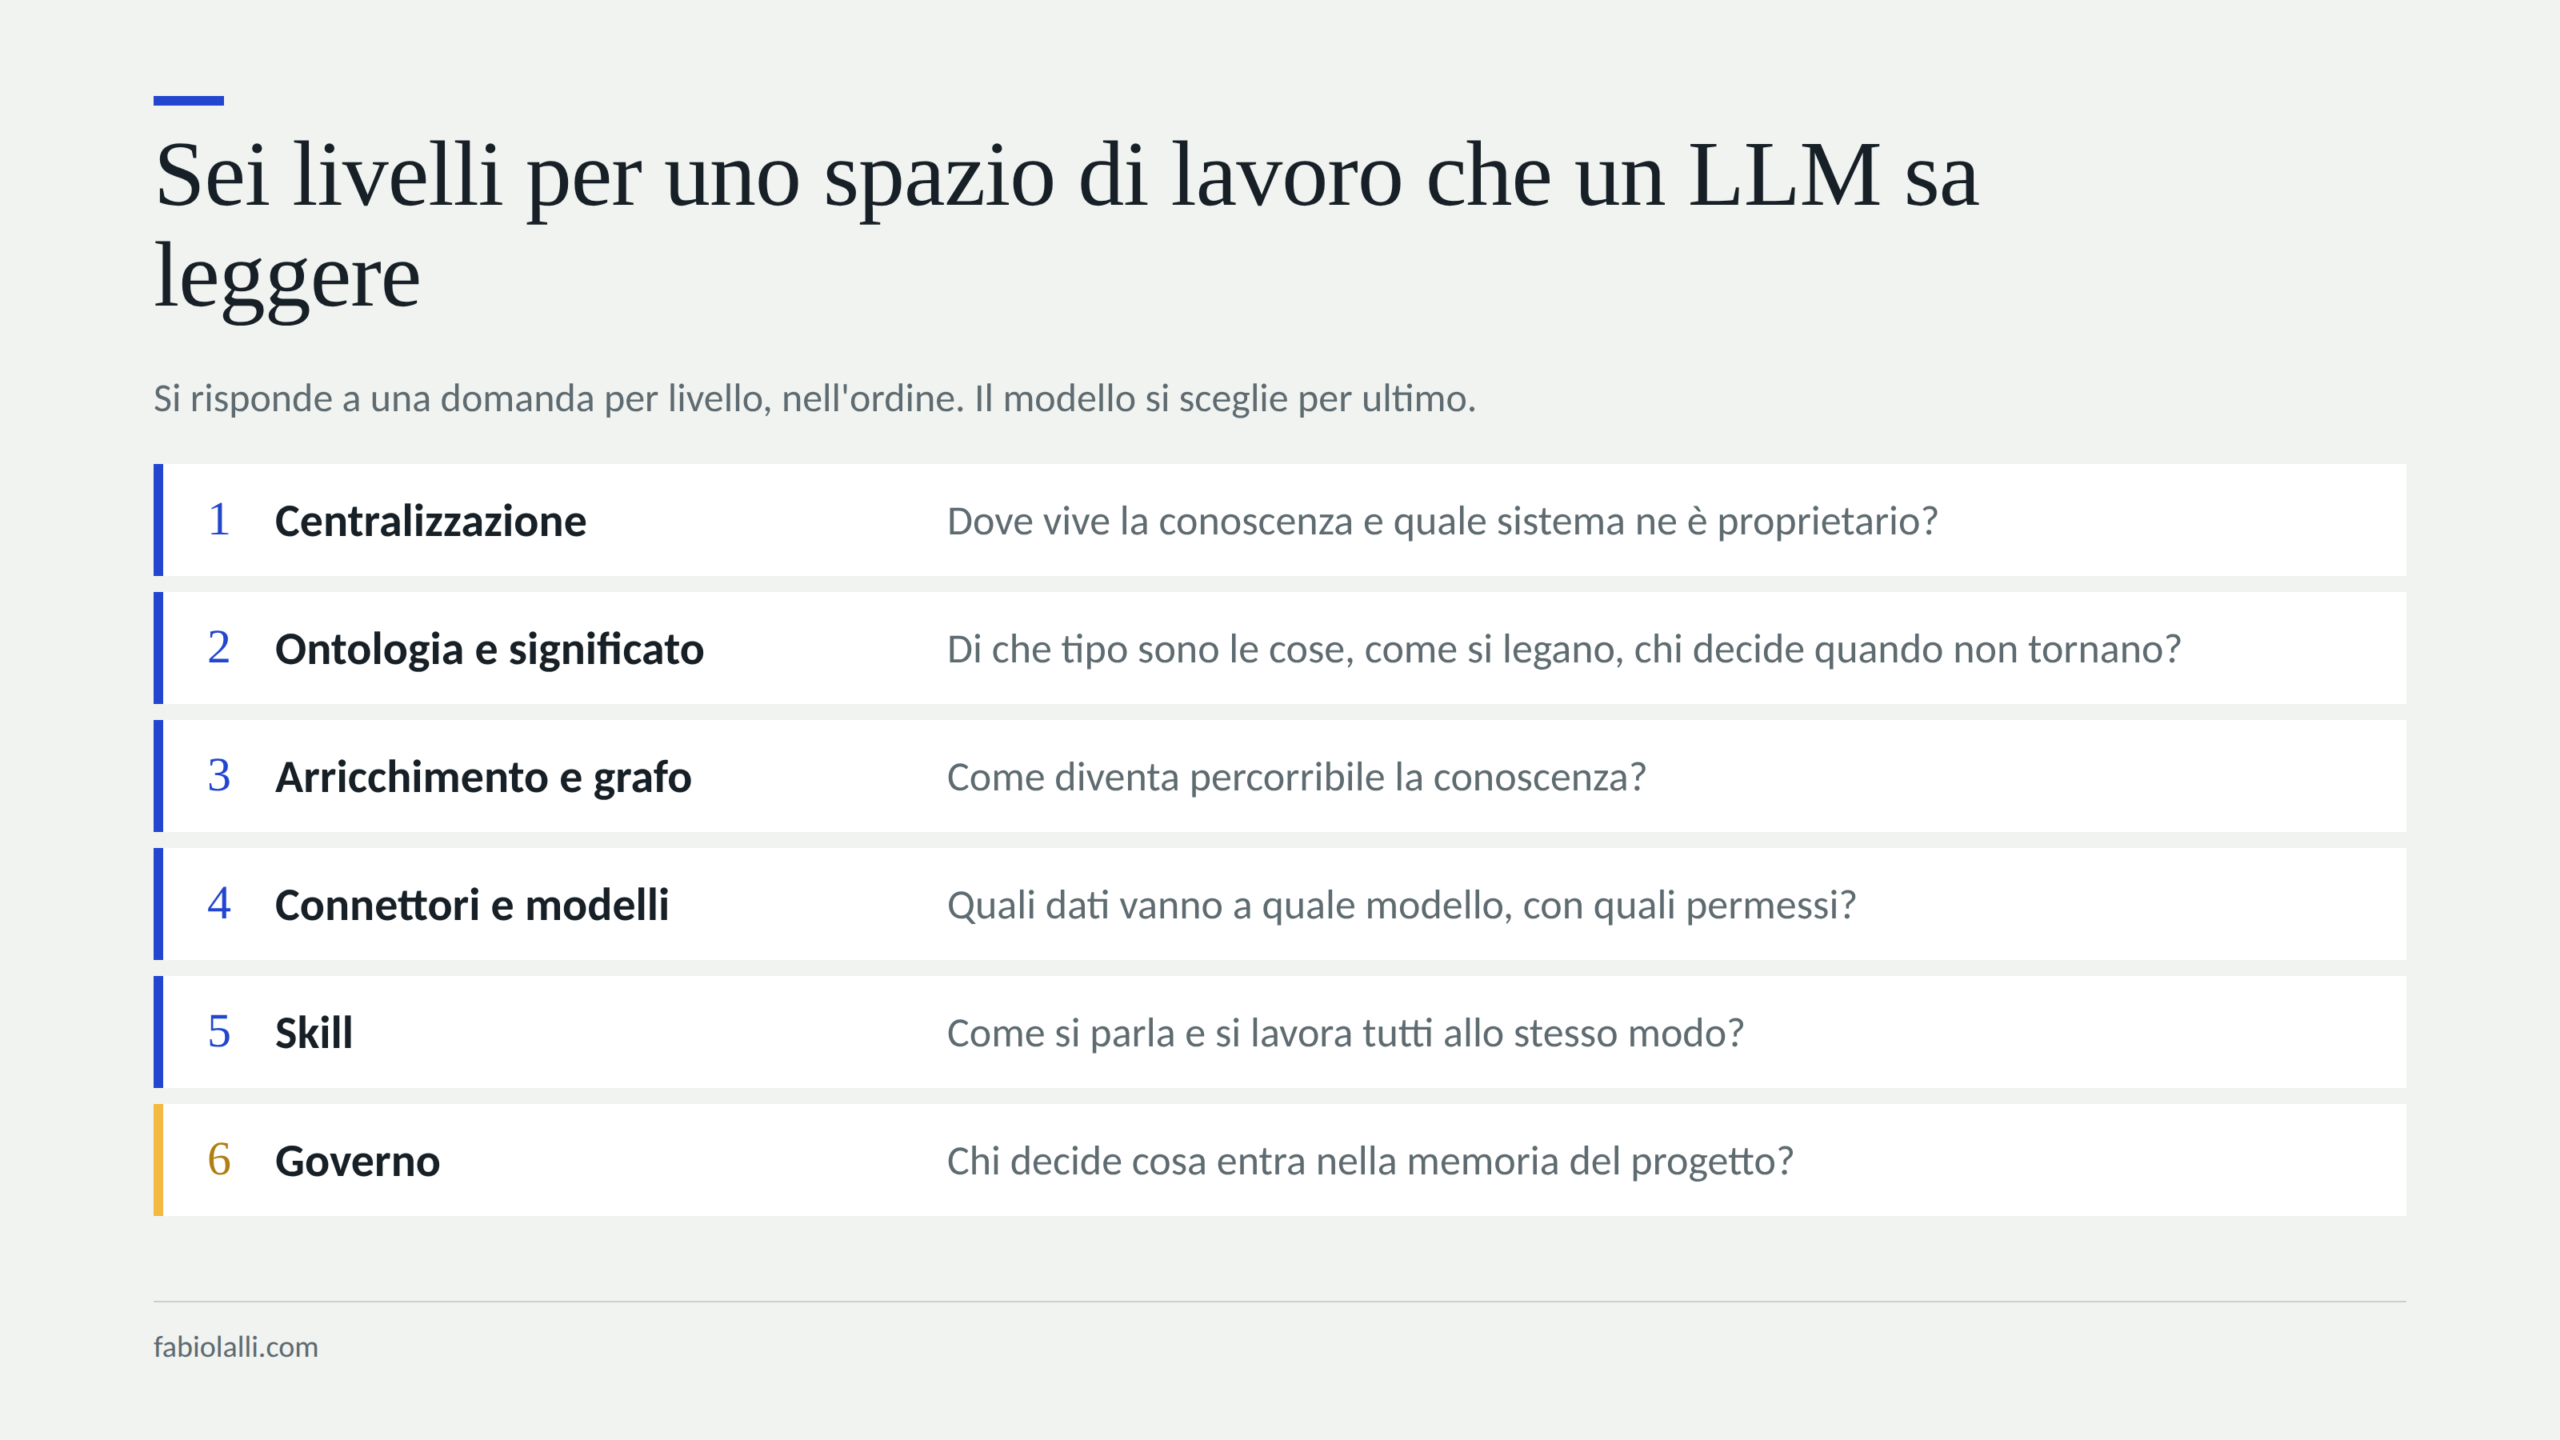
Progettare uno spazio di lavoro che un LLM sa leggere

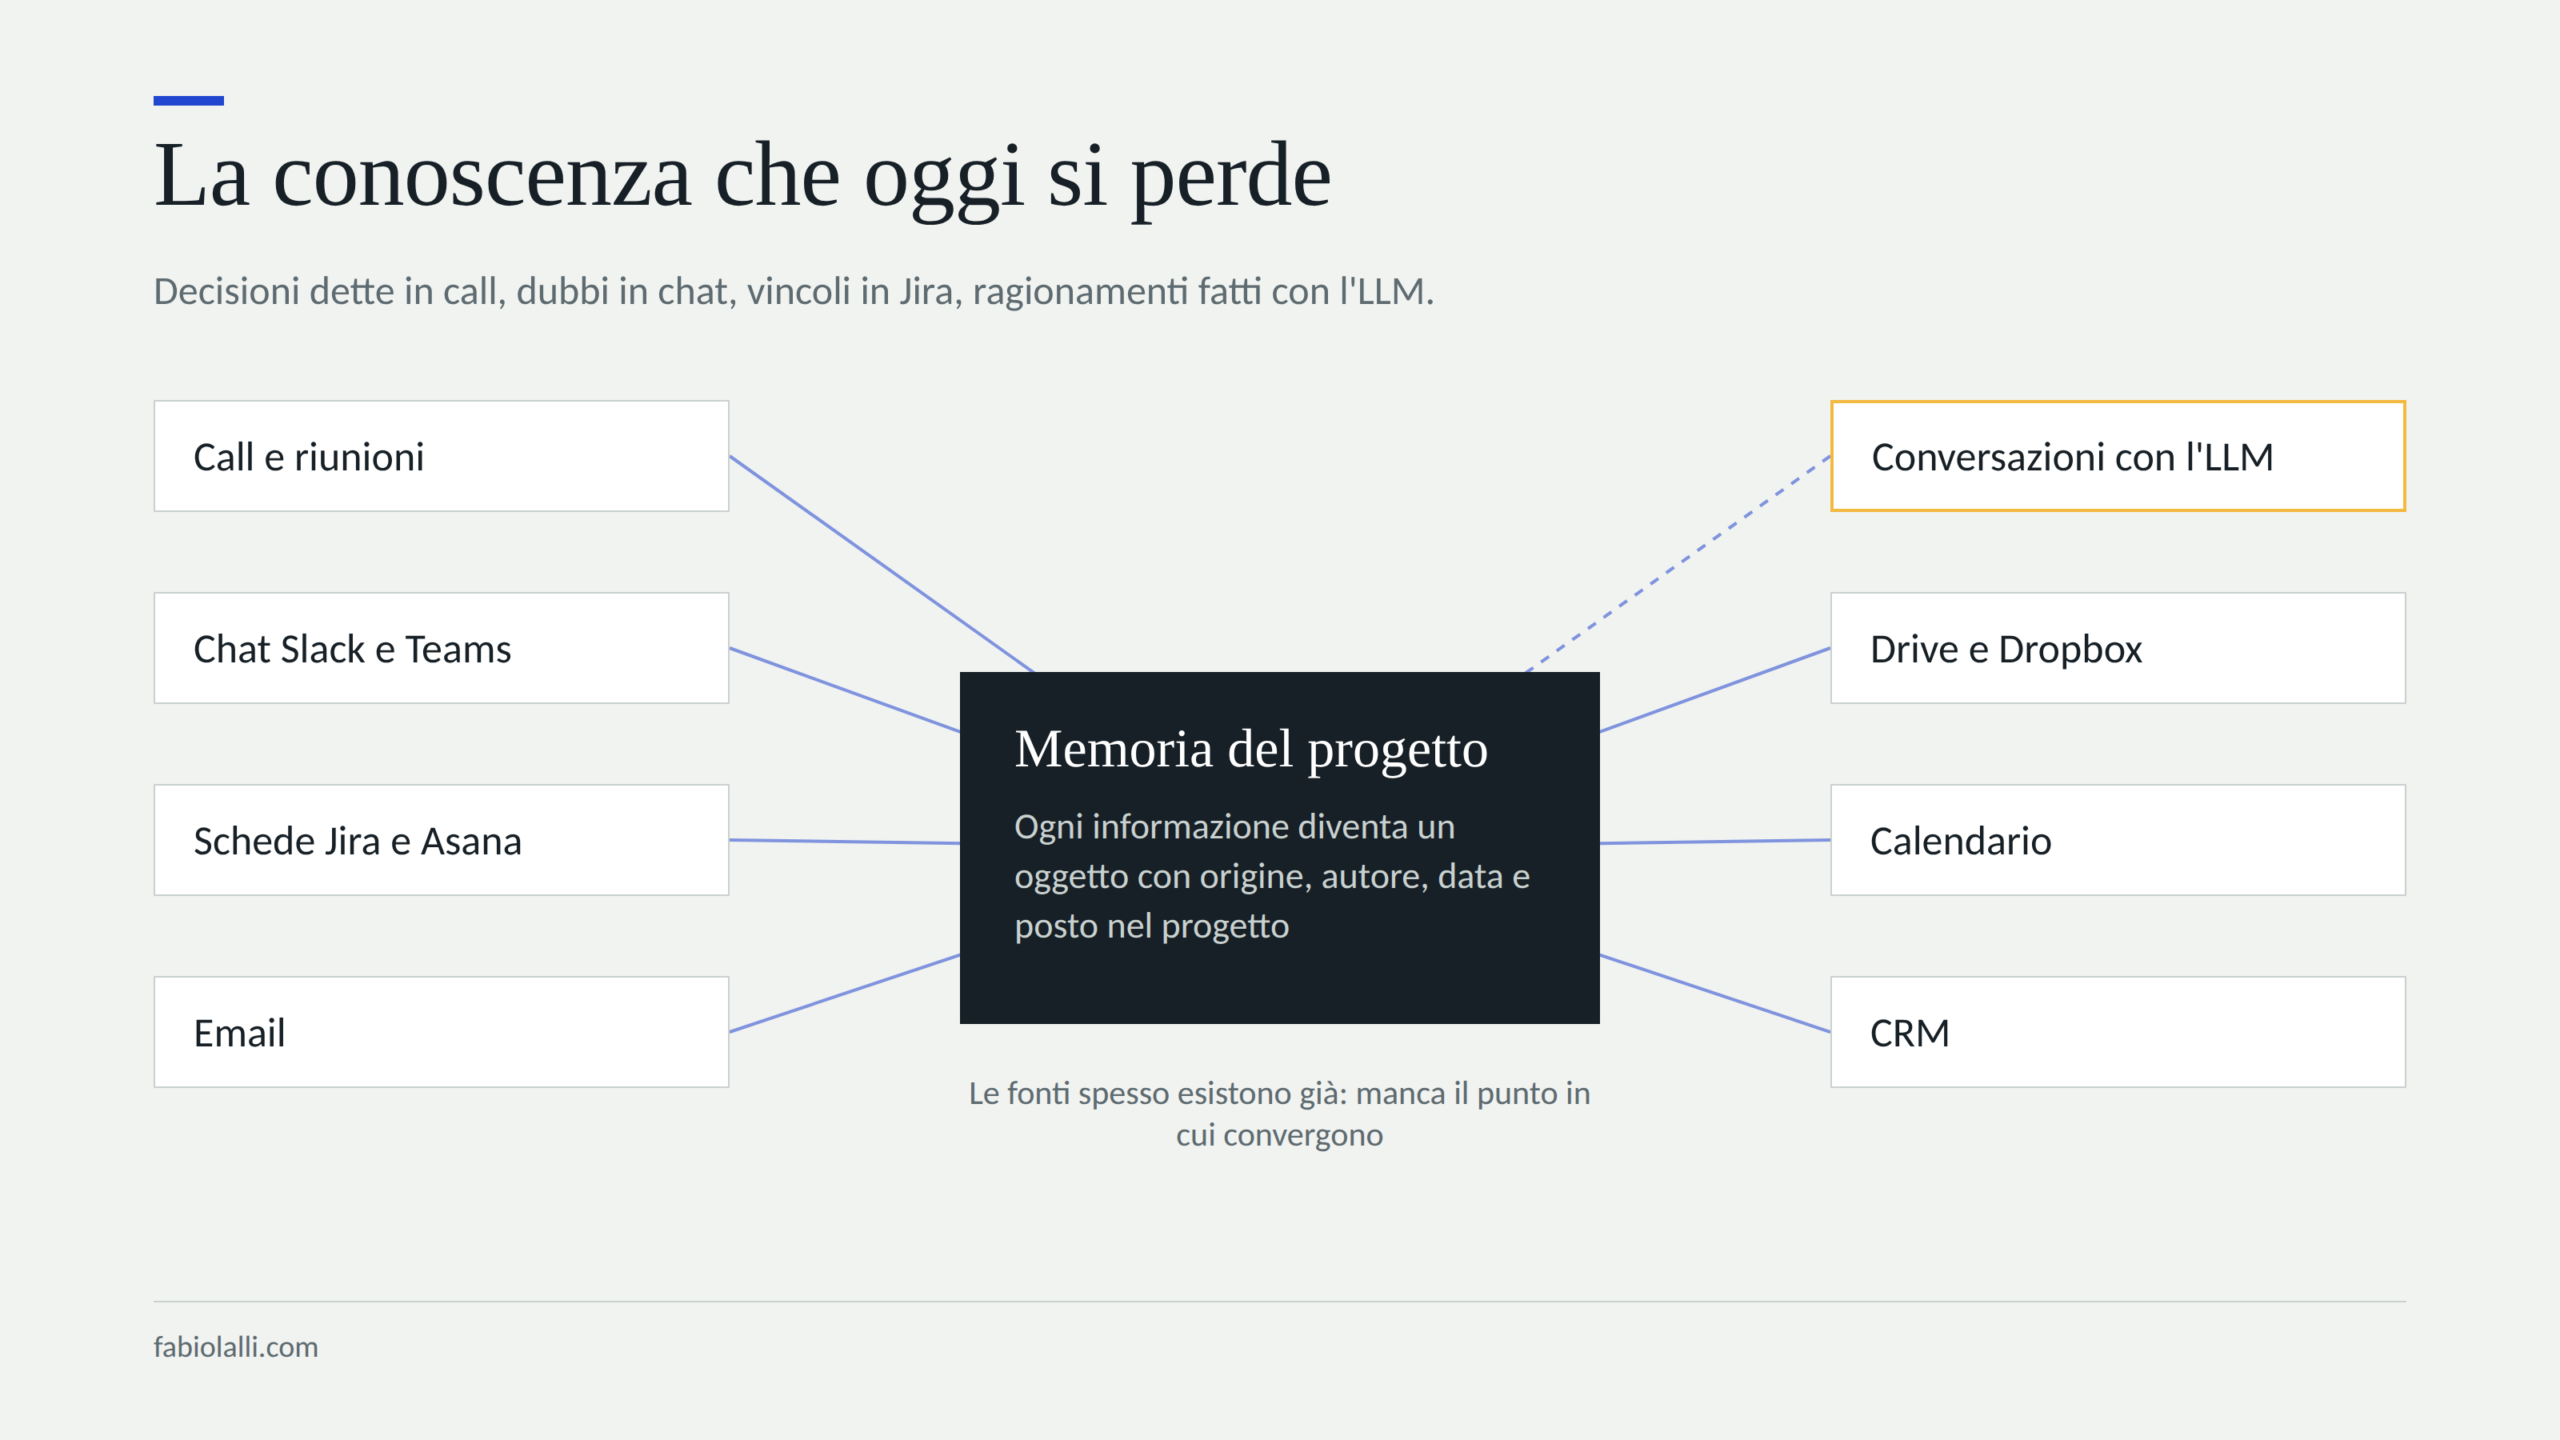
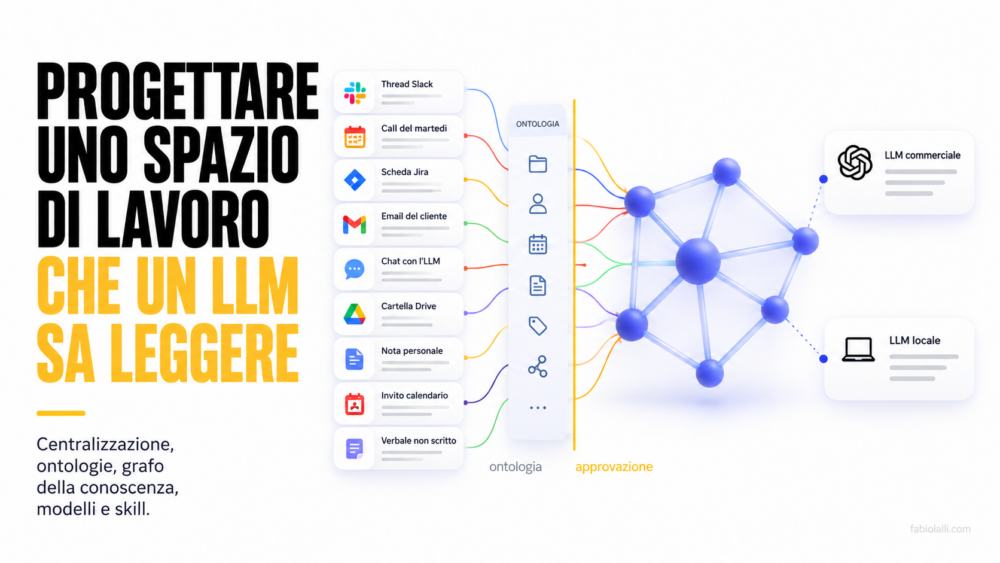
In quasi tutte le aziende che incontro la conoscenza di un progetto vive in sette o otto posti diversi: le registrazioni delle riunioni, le caselle di posta, una cartella condivisa su Drive e un’altra su Dropbox, il calendario, il CRM, i canali Slack o Teams, le schede di Jira o di Asana, le note personali di ciascuno. C’è poi un posto nuovo, che fino a due anni fa non esisteva e oggi contiene una parte rilevante del ragionamento di un team: le conversazioni che ogni persona ha con il proprio assistente AI mentre lavora. Ciascuno di questi posti funziona bene da solo, e nessuno sa dell’esistenza degli altri.

La reazione più diffusa è collegare un LLM a tutte queste fonti e aspettarsi che dal collegamento nasca un’intelligenza del progetto. È l’idea del Jarvis aziendale, che in questi mesi circola con nomi diversi, Company Brain, Brain OS, Company OS: un assistente che sa tutto dell’azienda perché vede tutto. Succede il contrario. Più fonti si collegano senza una struttura che le tenga insieme, più il modello produce risposte plausibili costruite su frammenti, e più diventa difficile capire da dove arriva un’affermazione, chi l’ha verificata e se è ancora vera.

Uno spazio di lavoro intelligente si progetta, e la scelta del modello arriva per ultima. Il metodo che propongo lo divide in sei livelli, ciascuno con una domanda a cui rispondere prima di passare al successivo. Come caso concreto uso il Workspace ICONICO, la piattaforma interna di gestione dei progetti che stiamo costruendo in questi mesi: è ancora giovane, ma ogni scelta descritta qui è già in produzione.

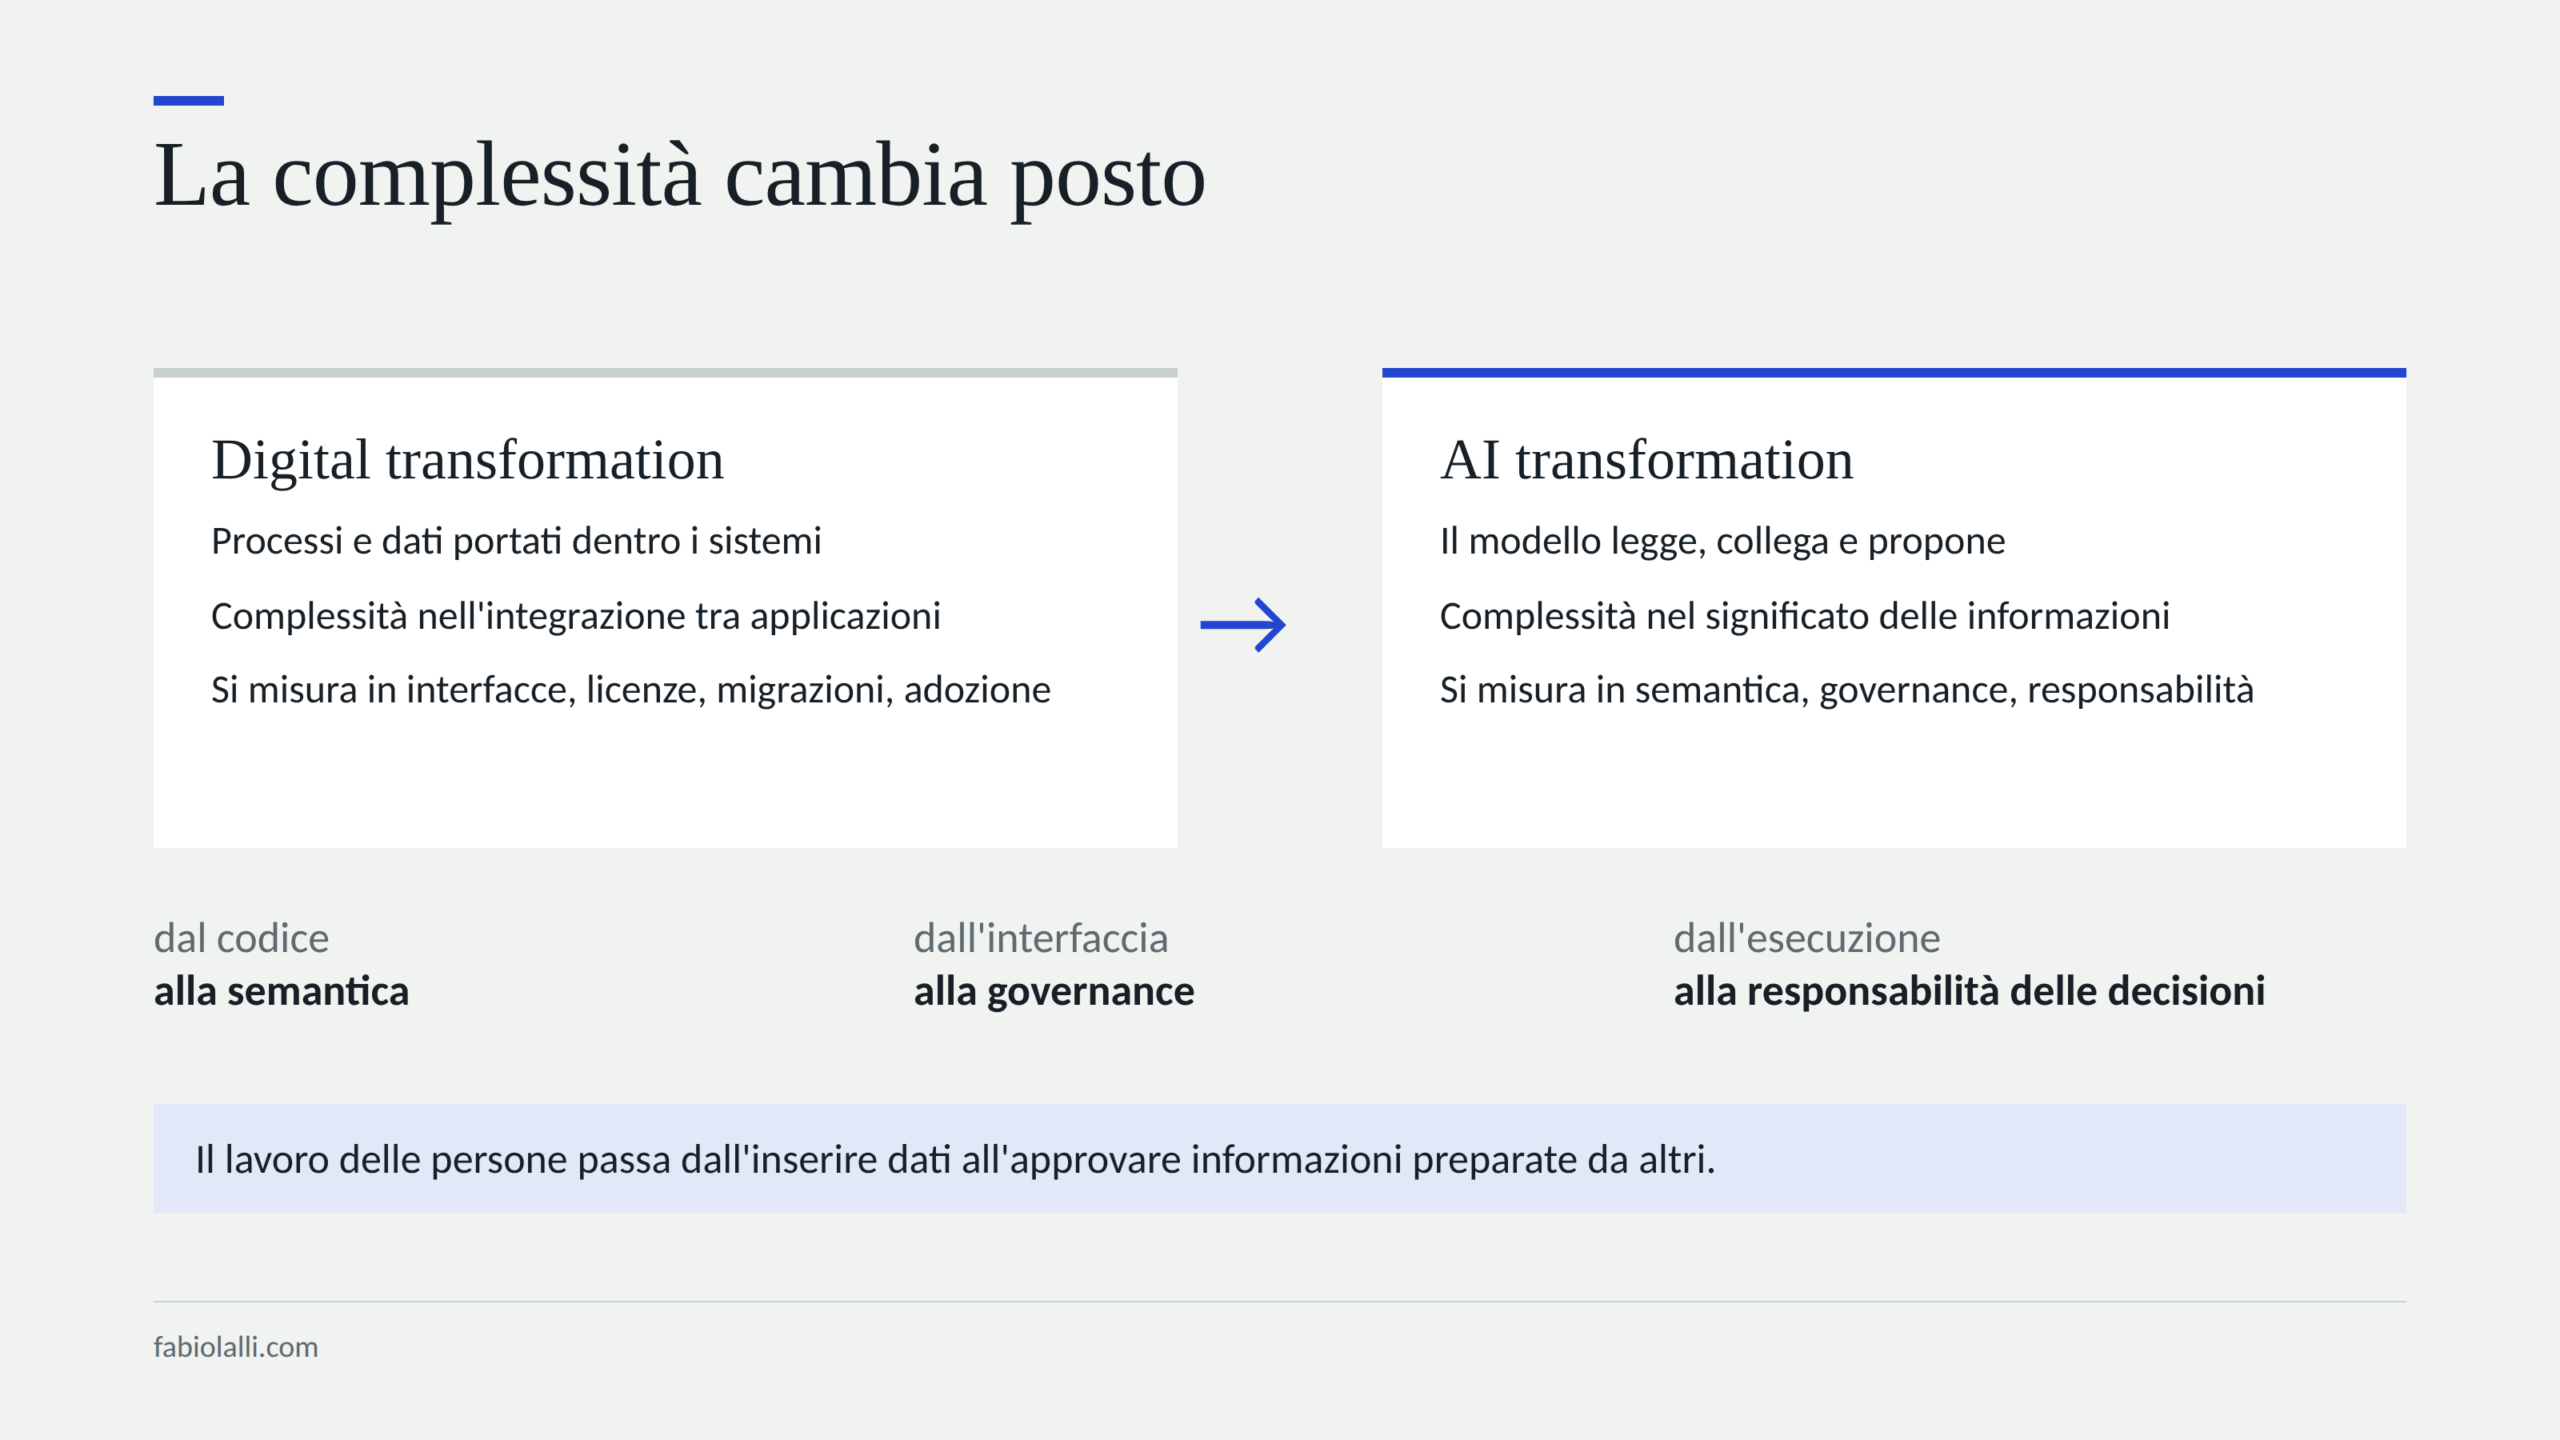
La complessità cambia posto

Prima dei livelli conviene chiarire che tipo di trasformazione è questa, perché la si confonde spesso con quella che le aziende hanno attraversato negli ultimi quindici anni. La digital transformation ha portato processi e dati dentro i sistemi: la carta è diventata un modulo, la riunione una videochiamata, l’archivio un drive condiviso, e la complessità stava nell’integrazione tra applicazioni e nell’adozione degli strumenti da parte delle persone. Si misurava in interfacce, licenze, migrazioni, formazione all’uso del software.

La AI transformation sposta la complessità altrove. Gli strumenti in buona parte ci sono già, e i dati anche, solo che sono sparsi e senza significato condiviso. Quando un modello legge, riassume, collega e propone al posto delle persone, il problema smette di essere come si esegue una procedura dentro un’applicazione e diventa cosa significano le informazioni, chi ha titolo per confermarle e cosa succede quando due fonti dicono cose diverse. La complessità passa dal codice alla semantica, dall’interfaccia alla governance, dall’esecuzione delle operazioni alla responsabilità delle decisioni.

Questo ha una conseguenza pratica che molti sottovalutano. Il lavoro di chi usa il sistema cambia natura: meno inserimento di dati, meno ricerca, molte più approvazioni, correzioni e scelte su informazioni preparate da altri. Una persona che prima compilava il verbale di una riunione ora riceve un verbale già scritto, con i task estratti e collegati alle persone giuste, e il suo compito è dire se è corretto. È un lavoro più leggero e più delicato insieme, perché richiede di sapere cosa si sta approvando.

Un posto per ogni informazione

Centralizzare la conoscenza non significa copiare tutto in un unico contenitore. Un archivio dove finiscono i file di tutti è soltanto un altro silo, più grande. Serve un luogo dove un’informazione diventa un oggetto con un’identità, un autore, una data e una posizione nel progetto: una nota di riunione, un task con un assegnatario e una scadenza, un documento con le sue versioni, un referente con il suo ruolo, un’opportunità con il suo stadio, un’ora di lavoro registrata su un’attività.

La regola che evita più problemi è che ogni dato ha un solo sistema proprietario. Nel Workspace ICONICO clienti, contatti e opportunità restano nel CRM aziendale, e la piattaforma non li duplica: tiene un collegamento e una copia del nome per poterlo mostrare, e quando dal progetto nasce un’opportunità è la piattaforma a scriverla nel CRM, con la nota di progetto e l’attività già collegate. Un’anagrafica duplicata produce, dopo pochi mesi, due verità su chi è il decisore di un cliente, e un modello che le legge entrambe sceglie a caso quale citare.

Il vantaggio più sottovalutato della centralizzazione riguarda le informazioni che oggi non arrivano da nessuna parte. Una decisione presa in una call e mai scritta, un dubbio sollevato in un canale Slack e poi dimenticato, un vincolo annotato in una scheda Jira che nessuno del commerciale leggerà, un’email in cui il cliente cambia una priorità rispondendo a un’altra domanda. E poi il ragionamento che una persona fa con il proprio LLM mentre prepara una proposta o analizza un problema, che spesso contiene il passaggio più utile della giornata e svanisce quando si chiude la finestra. Ognuna di queste informazioni, presa da sola, vale poco. Raccolte nel progetto, con la loro origine, diventano la memoria che l’azienda non aveva mai avuto, e smettono di dipendere da chi era presente quel giorno.

Per ottenere questo vantaggio non sempre serve costruire infrastruttura nuova. In molti casi le fonti esistono già, con i loro connettori, e manca soltanto il punto in cui convergono e un criterio per decidere cosa ne entra. Nel Workspace il controllo degli accessi è applicato al livello più basso possibile, con regole a livello di riga su ognuna delle 28 tabelle del database, per cui la stessa domanda posta da due persone con ruoli diversi restituisce risposte diverse: è la condizione per dare a un modello l’accesso a tutto il progetto senza dover filtrare a mano ogni volta.

Il significato viene prima dei dati

È la parte che quasi tutti saltano, e si capisce: parlare di ontologia in una riunione di direzione fa alzare gli occhi al cielo. Eppure un modello collegato a dati senza tipi e senza relazioni dichiarate ricostruisce da solo il significato delle cose, ogni volta in modo leggermente diverso, e due risposte alla stessa domanda a una settimana di distanza non coincidono. L’ontologia è il punto in cui un’azienda decide cosa significano le sue informazioni, prima che lo decida un modello al suo posto.

Si comincia dai tipi di oggetto. Nel Workspace le note sono appunti, verbali di riunione, decisioni, rischi, insight, feedback, opportunità o conoscenza consolidata, e il tipo cambia il trattamento: una decisione pesa più di un appunto, un rischio genera attenzione, una nota di conoscenza è il risultato di una verifica e non di un’impressione. Anche il vocabolario fa parte dell’ontologia. I tag vengono normalizzati, minuscoli e con il trattino al posto degli spazi, e prima di crearne uno nuovo il sistema lo confronta per somiglianza con quelli esistenti: se esiste già “commerciale-b2b”, la variante “commerciale b2b” non nasce e chi la scrive riceve un avviso, perché il tag è il punto in cui la tassonomia di un’azienda si sfalda più in fretta.

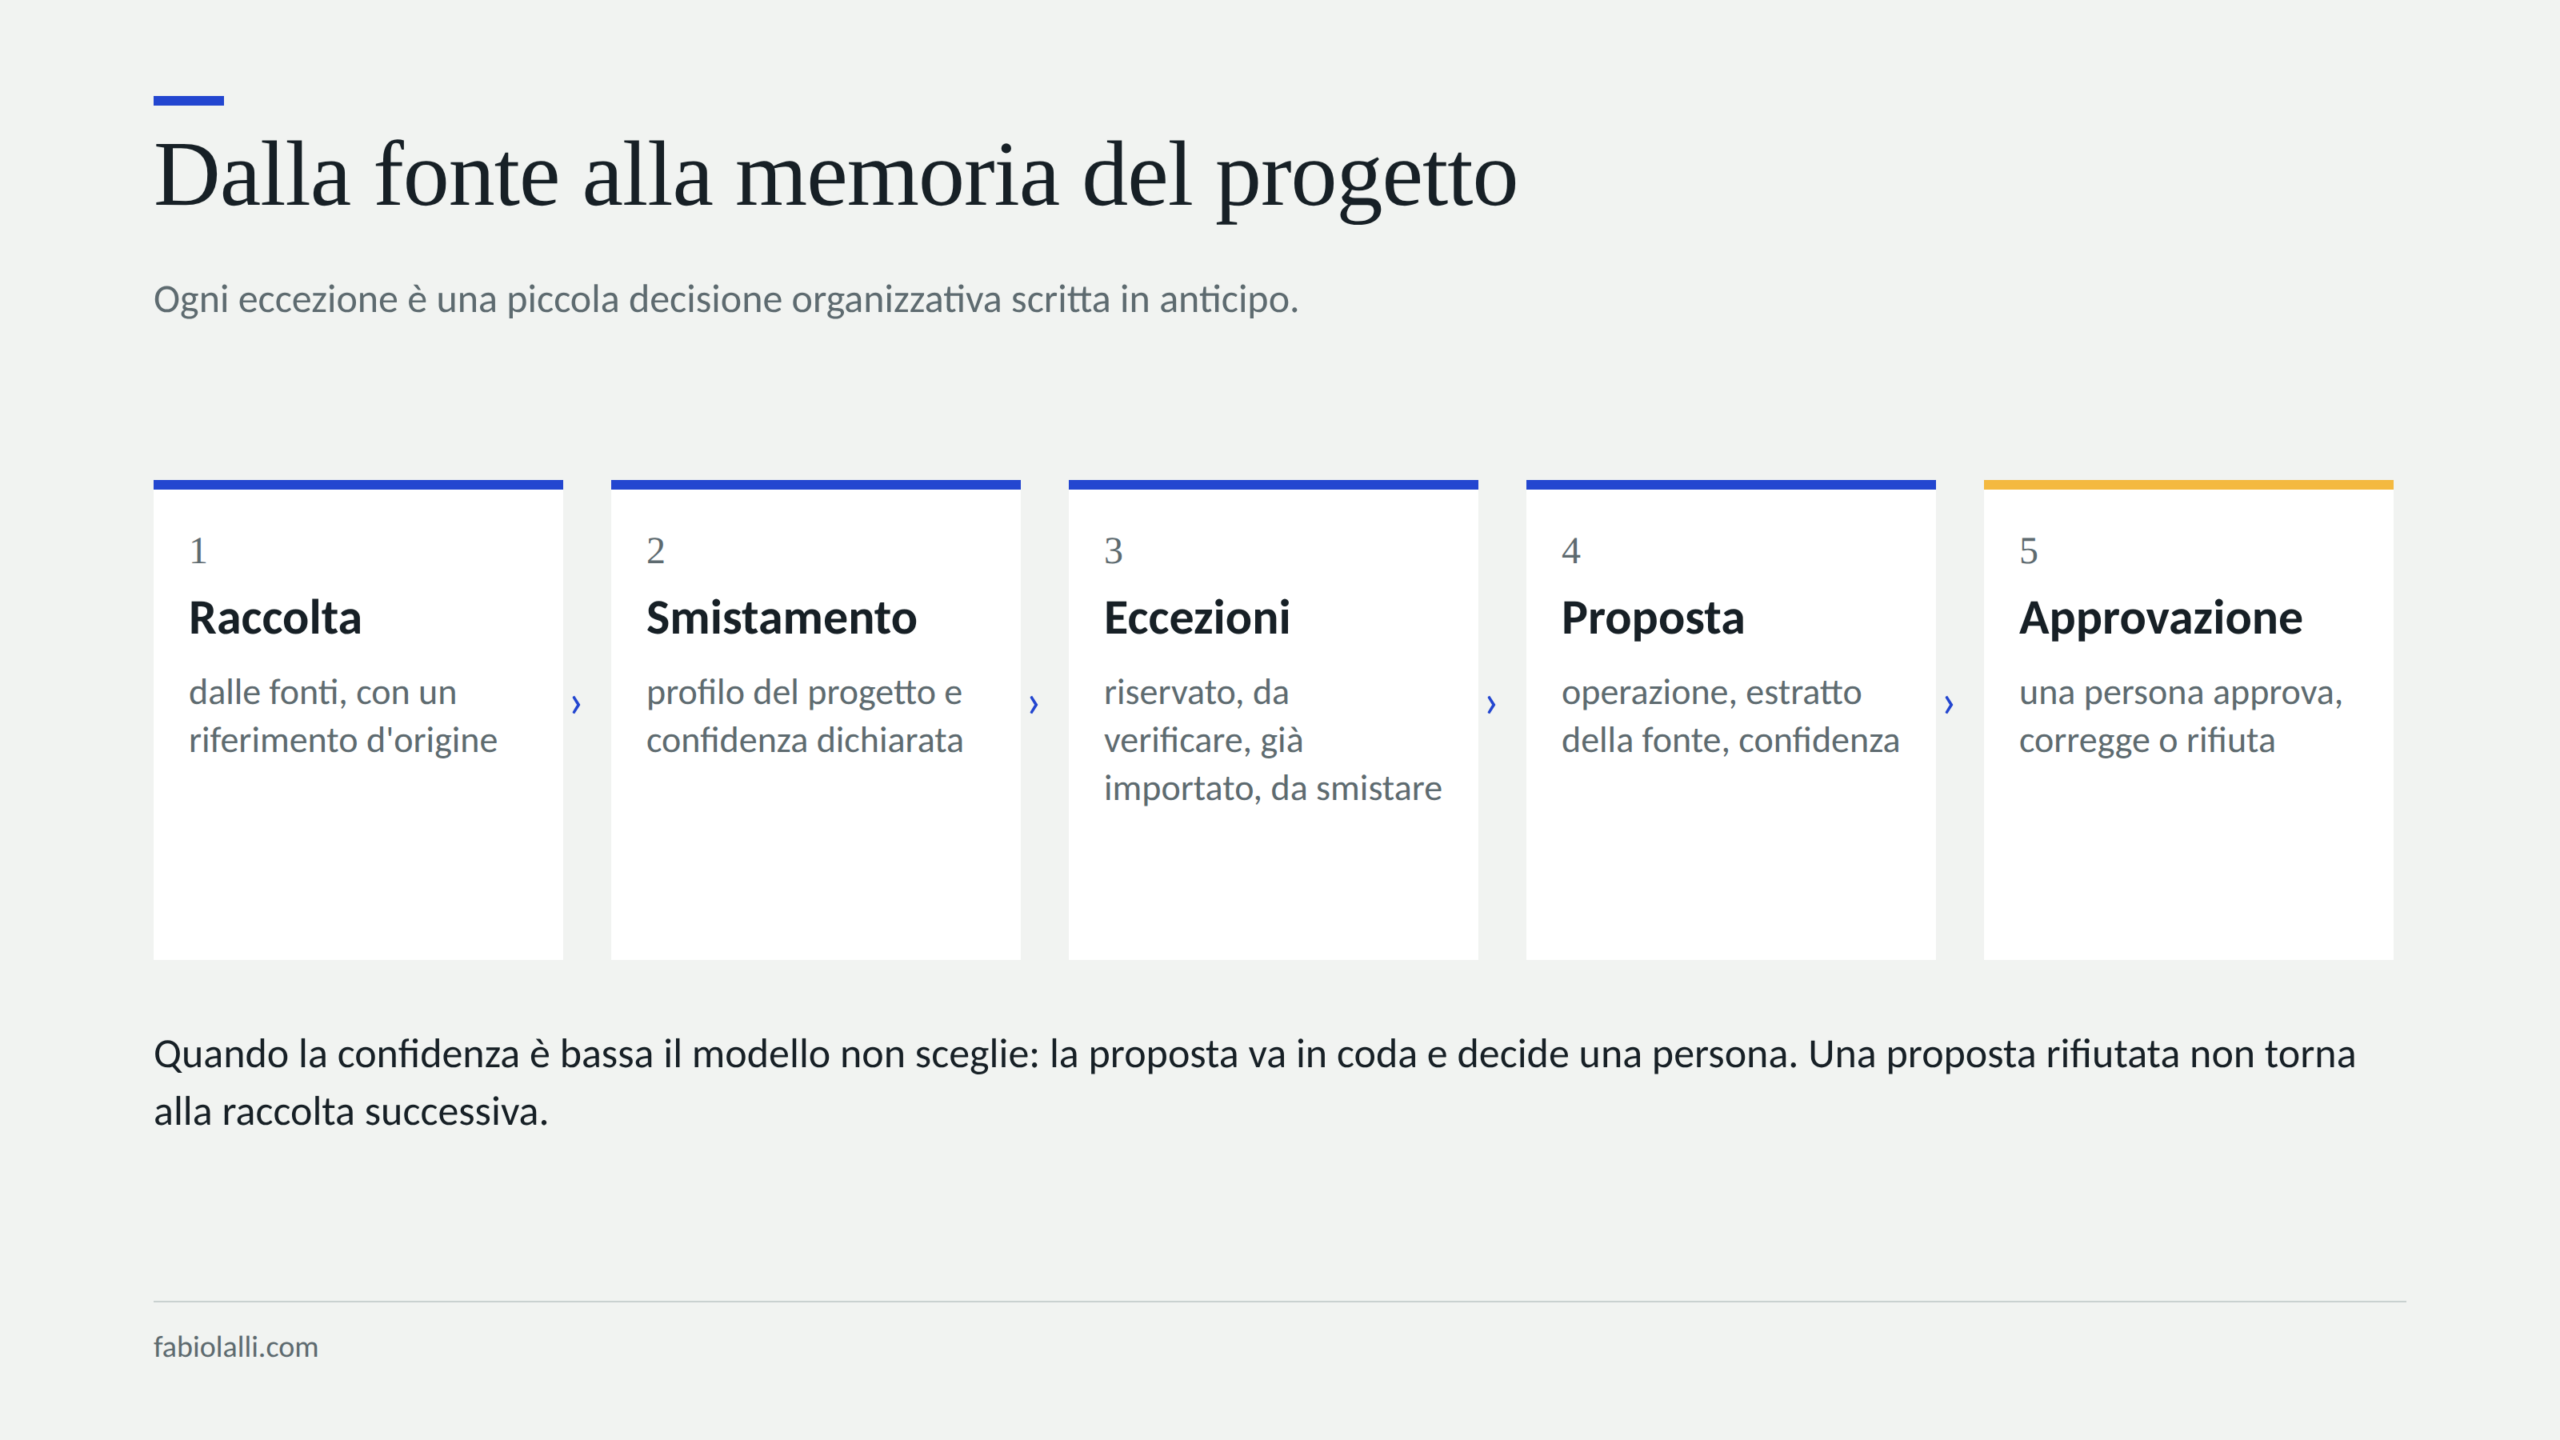
Poi viene lo smistamento, cioè la decisione su dove va un’informazione appena raccolta. Ogni progetto ha un profilo leggibile dal modello: i domini email del cliente e dei partner, le parole chiave e le sigle ricorrenti, le cartelle standard, le convenzioni di nome. Con queste poche righe una mail da un certo dominio, o una registrazione in cui ricorre una sigla, viene attribuita al progetto giusto con un livello di confidenza dichiarato. Quando la confidenza è bassa, o l’informazione potrebbe appartenere a due progetti, il modello non sceglie: la proposta finisce in una coda da smistare e la decisione torna a una persona.

Le eccezioni vanno progettate quanto i casi normali. Un’informazione con cifre economiche viene marcata come riservata e resta visibile solo ai responsabili del progetto. Un’informazione dubbia porta il marcatore da verificare. Un contenuto già importato viene riconosciuto dalla sua origine e non entra una seconda volta. Ognuna di queste regole è una piccola decisione organizzativa scritta in anticipo, e ciascuna toglie al modello un’occasione di improvvisare.

Il caso più delicato sono le collisioni, quando due fonti affermano cose diverse sullo stesso punto. Per gestirle le relazioni tra oggetti sono tipizzate: un collegamento tra due note può essere un riferimento, una conferma, un’integrazione, una divergenza o un consolidamento. Nel progetto pilota due note scritte da persone diverse, a pochi giorni di distanza, si contraddicevano su sei punti. Un sistema ingenuo avrebbe tenuto l’ultima, o le avrebbe fuse in un riassunto. Con le relazioni tipizzate la divergenza diventa un collegamento esplicito e apre un task di verifica assegnato a una persona, che si chiude con una nota di conoscenza: cita entrambe le fonti e dichiara per ciascuna se è stata confermata, integrata o superata su quel punto. Le note originali restano intatte e i loro autori ricevono una notifica.

Le conferme hanno lo stesso trattamento, con il segno opposto. Quando una seconda fonte indipendente dice la stessa cosa della prima, il collegamento di conferma alza il valore di quell’informazione, e chi interroga il progetto sa che quel fatto è sostenuto da due origini e non da una. È il modo in cui la conoscenza di un team acquista peso nel tempo, invece di accumularsi tutta allo stesso livello.

Arricchire i dati e renderli percorribili

Un’informazione raccolta e smistata è ancora un oggetto isolato. Diventa conoscenza quando è collegata a ciò che la circonda: le persone che cita, l’opportunità a cui si riferisce, il documento che commenta, il task che ne è nato, le ore spese per produrla.

L’arricchimento avviene su più piani. Il primo è esplicito: nelle note e nei task gli oggetti si citano con le menzioni, scrivendo @ seguito dal nome di una persona, di un documento o di un’opportunità, e ogni menzione diventa un collegamento. Il secondo è automatico: il sistema rianalizza i testi, riconosce nomi di referenti, opportunità e documenti già presenti nel progetto e genera collegamenti suggeriti, che però restano suggerimenti finché qualcuno non li conferma, e se vengono rifiutati non vengono ricreati. Il terzo è operativo: un task porta con sé la nota da cui è nato, un’ora registrata porta con sé il task o la riunione a cui si riferisce, un’opportunità porta con sé la nota che l’ha fatta emergere.

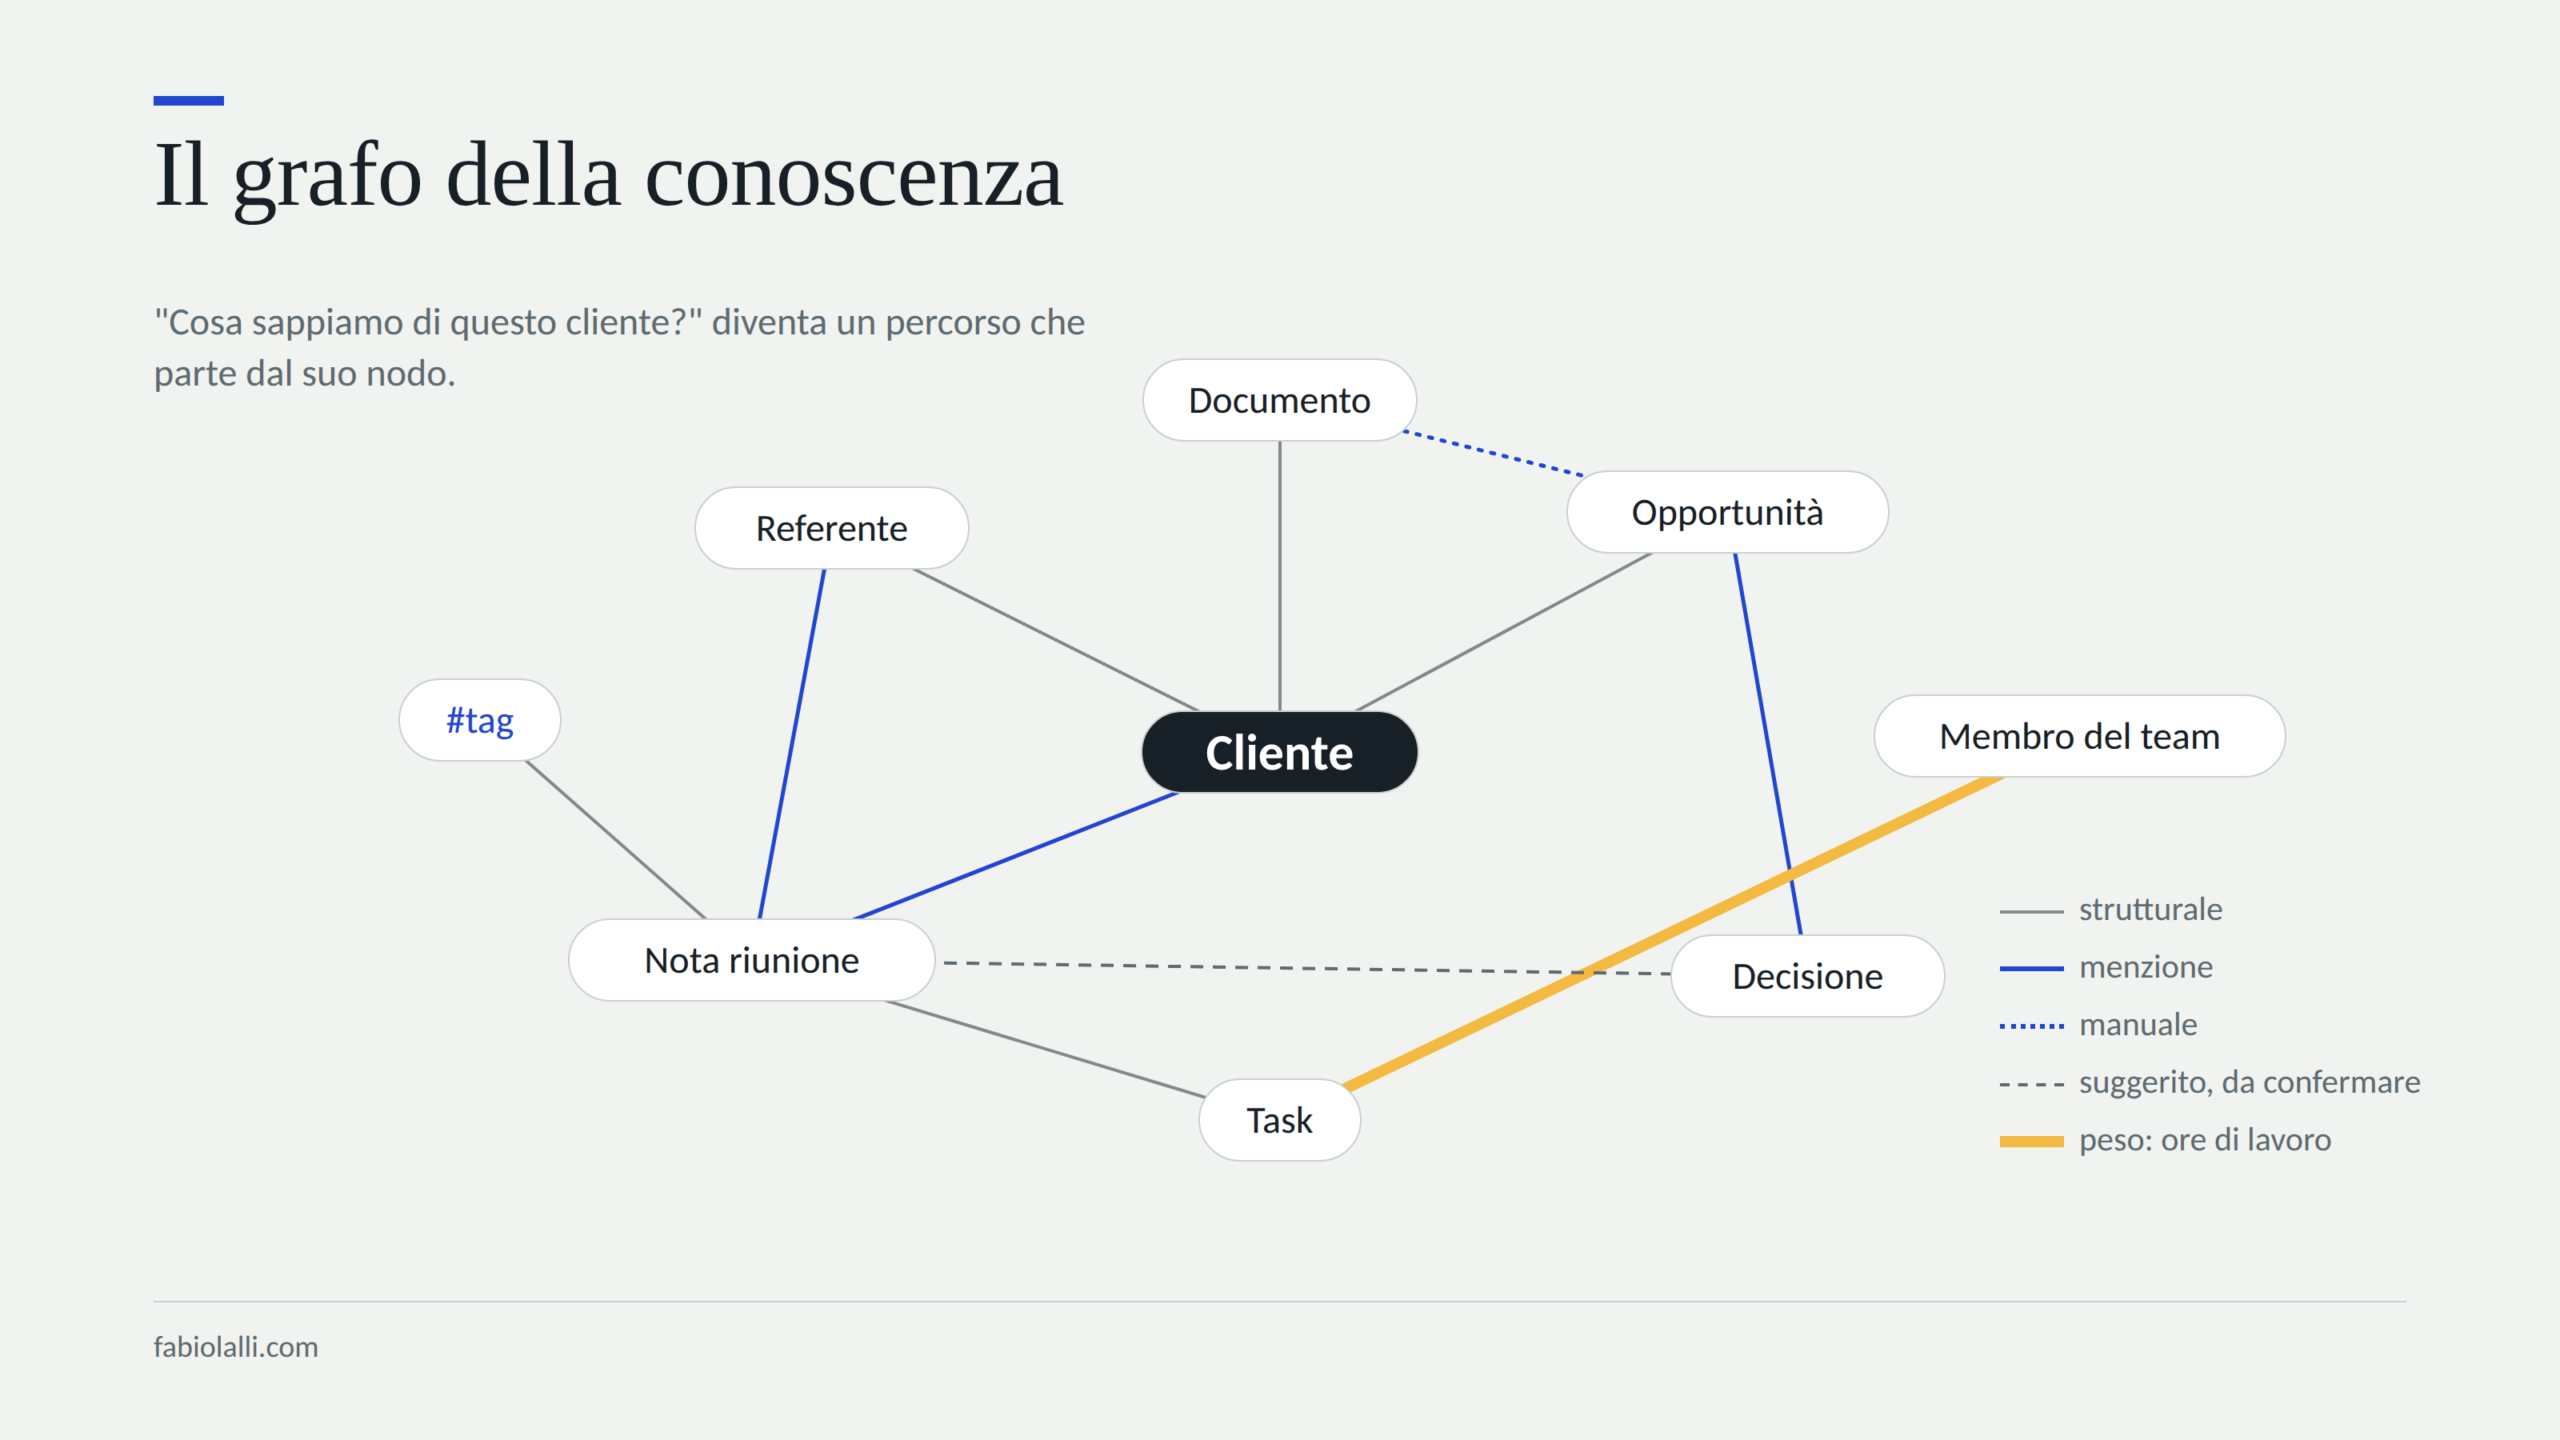
Il risultato è un grafo della conoscenza in cui i nodi sono note, task, documenti, referenti, opportunità, membri del team, cartelle, tag e organizzazioni, e gli archi hanno un’origine dichiarata: strutturale, da menzione, manuale o automatica. Alcuni archi hanno anche un peso, come le ore che una persona ha dedicato a un’attività, così la mappa mostra dove si concentra davvero il lavoro e non solo cosa è collegato a cosa.

Rendere la conoscenza percorribile vuol dire offrire più strade per arrivare alla stessa informazione. Dalla mappa del progetto si parte da un nodo e se ne esplora il vicinato fino a tre passi di distanza. Da ogni oggetto si vedono i collegamenti in uscita e quelli in entrata, cioè chi lo cita. La timeline restituisce la sequenza degli eventi, la ricerca attraversa note, task, documenti, testo estratto e tag di tutti i progetti leggibili. E il modello usa le stesse strade: prima di una riunione con un referente prepara il brief partendo dal suo nodo, raccogliendo le note recenti che lo citano, le opportunità aperte, i task in scadenza e le divergenze ancora da chiudere. Alla domanda “cosa sappiamo di questo cliente” il sistema risponde con un percorso nel grafo che parte dal nodo del cliente.

Quale modello per quali dati

Con la conoscenza centralizzata, strutturata e collegata, la scelta del modello diventa una decisione molto più semplice e molto meno rischiosa, perché il modello non contiene niente. Il cuore del sistema è il livello di conoscenza con il suo server di accesso: il modello è un lettore e un proponente, e si può sostituire senza perdere nulla. Il mio assistente personale si chiama Gideon, come l’intelligenza artificiale che in The Flash mostra a Barry Allen i giornali del futuro. Il mio si accontenta di sapere cosa abbiamo deciso martedì, e se domani cambiassi il modello che lo fa funzionare continuerebbe a saperlo, perché quella memoria non sta dentro di lui.

Il collegamento passa oggi quasi sempre da un server MCP, il protocollo che i principali assistenti usano per parlare con strumenti esterni. Il server del Workspace gira su un dominio proprio, con autenticazione OAuth, ed espone oltre sessanta strumenti: leggere e scrivere note, aprire task, caricare documenti, registrare il tempo di una riunione, interrogare il grafo di un progetto. Lo stesso server serve qualsiasi client compatibile, e il principio da tenere fermo è che il modello opera sempre con i permessi reali della persona che lo sta usando, mai con un’utenza tecnica onnipotente.

Da qui le strade sono sostanzialmente due, e spesso convivono. La prima sono i client dei prodotti noti, Claude, ChatGPT e gli altri assistenti commerciali: offrono i modelli più capaci, connettori già pronti verso posta, calendari e archivi, e un’esperienza che le persone conoscono. Il prezzo è che i dati letti dal modello transitano sui server del fornitore, con le garanzie contrattuali del piano sottoscritto. La seconda sono i client con AI locale, che eseguono modelli aperti su macchine aziendali o su server interni: i dati non escono dal perimetro dell’azienda, i costi sono prevedibili, e in cambio si accettano modelli meno potenti sui compiti più complessi, più lavoro di manutenzione e un’infrastruttura da gestire.

La scelta si fa per classe di dati, e può cambiare nel tempo. Un modo pratico è classificare le informazioni del progetto su tre livelli: dati che possono uscire (ricerche pubbliche, bozze di contenuti, analisi di mercato), dati interni che possono uscire solo verso fornitori con garanzie contrattuali adeguate, dati che non devono uscire per nessun motivo, come informazioni economiche riservate, dati personali sensibili o segreti industriali. Ai primi due livelli si applica il modello più capace disponibile, al terzo un modello locale, oppure un passaggio di anonimizzazione prima dell’invio. Nel Workspace questa classificazione è già parzialmente scritta nell’ontologia, perché le note e i documenti riservati sono marcati come tali, e quel marcatore diventa il criterio naturale per decidere quali oggetti affidare a un client locale.

Il punto fermo, in entrambi i casi, è che il cuore resta centralizzato. Che il modello giri in un data center americano o su un server nel seminterrato, legge la stessa conoscenza, con gli stessi permessi, attraverso lo stesso server, e propone modifiche che passano dalla stessa approvazione. Cambiare fornitore, o affiancarne due, diventa una decisione di costo e di riservatezza, senza progetti di migrazione.

Skill condivise in un catalogo unico

Una skill è il modo in cui si insegna a un assistente a fare una cosa sempre nello stesso modo: istruzioni in testo, riferimenti da consultare al momento giusto, script che verificano ciò che può essere verificato. Il paragone più vicino è il manuale operativo di un nuovo collaboratore, con la differenza che questo manuale viene letto davvero, ogni volta.

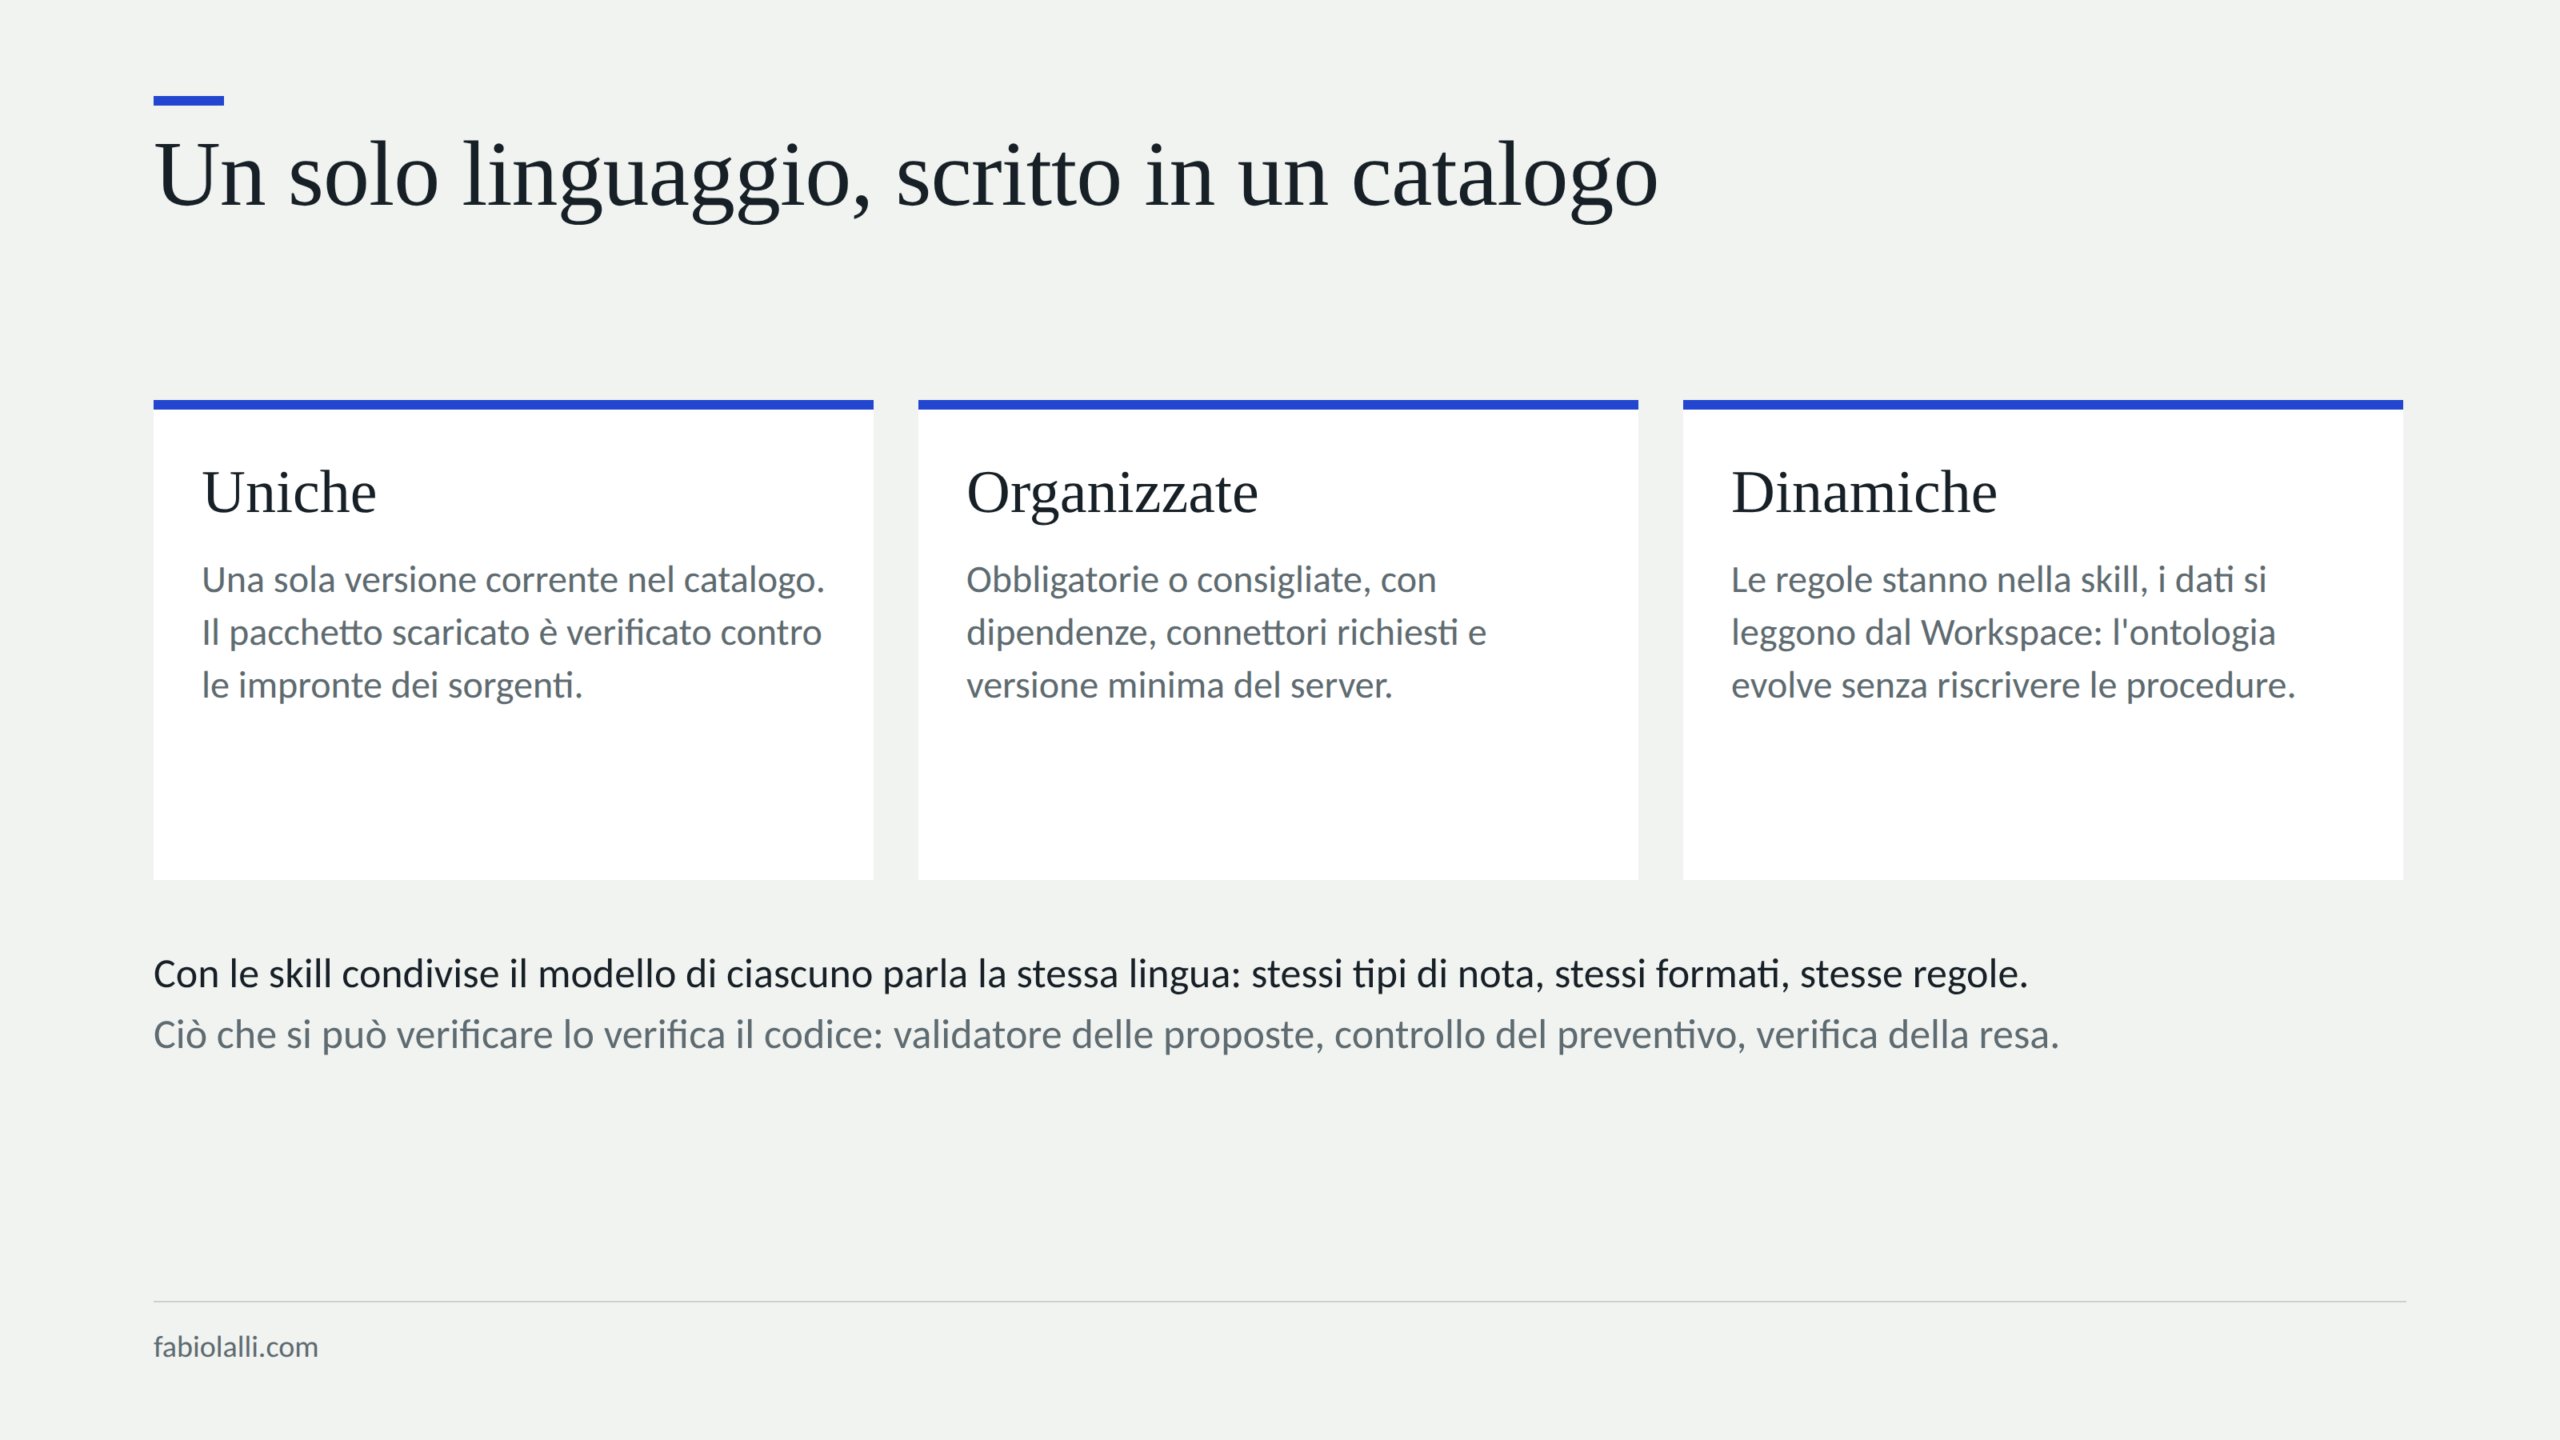
Il loro valore in un team va oltre l’efficienza del singolo. Quando dieci persone usano un LLM senza skill condivise, ciascuno scrive le note a modo suo, chiama le cose con nomi diversi, sceglie tag diversi, struttura le proposte con sezioni diverse, e il modello amplifica queste differenze invece di ridurle. Con le skill condivise il modello di ciascuno parla la stessa lingua: usa gli stessi tipi di nota, propone gli stessi formati, rispetta le stesse regole di stile, chiama un rischio “rischio” e una decisione “decisione”. Le skill sono il veicolo con cui l’ontologia arriva dentro ogni conversazione, senza che nessuno debba ricordarla.

Nel Workspace le skill sono tre e lavorano insieme. La skill di raccolta legge le fonti, smista per progetto, propone note, task, ore, referenti e collegamenti, prepara i brief, gestisce le verifiche. La skill documentale produce i documenti per i clienti da un motore unico: copertina, intestazione, palette e coordinate aziendali sono fisse, cambiano solo contenuti e firma di chi redige, e un controllo di stile automatico intercetta i tic di scrittura prima della consegna. Su questa si appoggia la skill commerciale, che segue una proposta dal brief all’opportunità nel progetto fino al preventivo nel CRM, con uno script che verifica al centesimo che documento e preventivo coincidano.

Conta molto anche il luogo dove le skill vengono scritte. Se vivono nei computer delle persone, dopo tre mesi ne esistono cinque versioni leggermente diverse, ognuna con le sue correzioni locali, e il linguaggio comune si disgrega dalla periferia. Per questo nel Workspace le skill stanno in un catalogo unico, dentro la piattaforma: ogni skill esiste in una sola versione corrente, con le note di rilascio, i connettori di cui ha bisogno, la versione minima del server, le altre skill da cui dipende e uno stato che la rende obbligatoria o consigliata. I sorgenti sono archiviati file per file con la loro impronta crittografica, e il pacchetto che ogni collaboratore scarica viene verificato contro quelle impronte.

Il catalogo rende le skill anche dinamiche nella struttura. Una skill ben scritta separa le regole dai dati: non contiene l’elenco dei tag del progetto né i domini del cliente, li legge dal Workspace nel momento in cui serve, così l’ontologia evolve senza dover riscrivere le procedure. Quando cambia una regola, si pubblica una nuova versione nel catalogo e ogni collaboratore la riceve con le note di rilascio. Il motore documentale è stato riscritto in Python con la sola libreria standard proprio per non legare le skill a un solo assistente: lo stesso pacchetto gira su qualsiasi piattaforma che esegua Python, compresi i client con AI locale.

La lezione tecnica più utile riguarda il confine tra quello che decide il modello e quello che decide il codice. Tutto ciò che si può verificare in modo deterministico va tolto al giudizio del modello. Prima di essere inviato, ogni pacchetto di proposte attraversa un validatore con nove regole. Il preventivo viene ricontrollato da uno script. Il documento passa da una verifica della resa in PDF. Al modello resta il lavoro che sa fare meglio, leggere, collegare e proporre, e il codice garantisce che il risultato rispetti le regole.


Il modello propone, le persone firmano

Il livello che tiene insieme tutti gli altri è una regola di governo molto semplice: niente entra nella memoria del progetto senza che una persona lo approvi. Quando il modello esegue la raccolta settimanale non scrive nulla, prepara un pacchetto di proposte. Ogni proposta dichiara l’operazione (crea una nota, apri un task, registra un’ora, collega due oggetti, apri una verifica), il progetto di destinazione, un estratto della fonte di massimo trecento caratteri con data e autore, un livello di confidenza e, quando serve, un marcatore che la segnala come da verificare o come contenuto economico riservato.

Il responsabile apre il pacchetto, approva, corregge o rifiuta. L’applicazione avviene con i suoi permessi, e se una proposta dipende da un’altra (un collegamento tra due note che nascono nello stesso pacchetto) il sistema le applica nell’ordine giusto. Una proposta rifiutata viene ricordata insieme alla sua origine e non torna alla raccolta successiva, quindi il sistema impara cosa non serve senza bisogno di istruzioni più lunghe.

La ragione di questa rigidità è pratica. Una base di conoscenza inquinata da un modello troppo zelante è peggio di una base vuota, perché nessuno sa più quali informazioni sono state verificate da una persona e quali sono state dedotte. Con le proposte approvate ogni oggetto del progetto ha un’origine e un responsabile, e se tra sei mesi qualcuno chiede perché è stata presa una certa decisione, la risposta porta a una riunione, a una persona, a una data.

Da dove cominciare

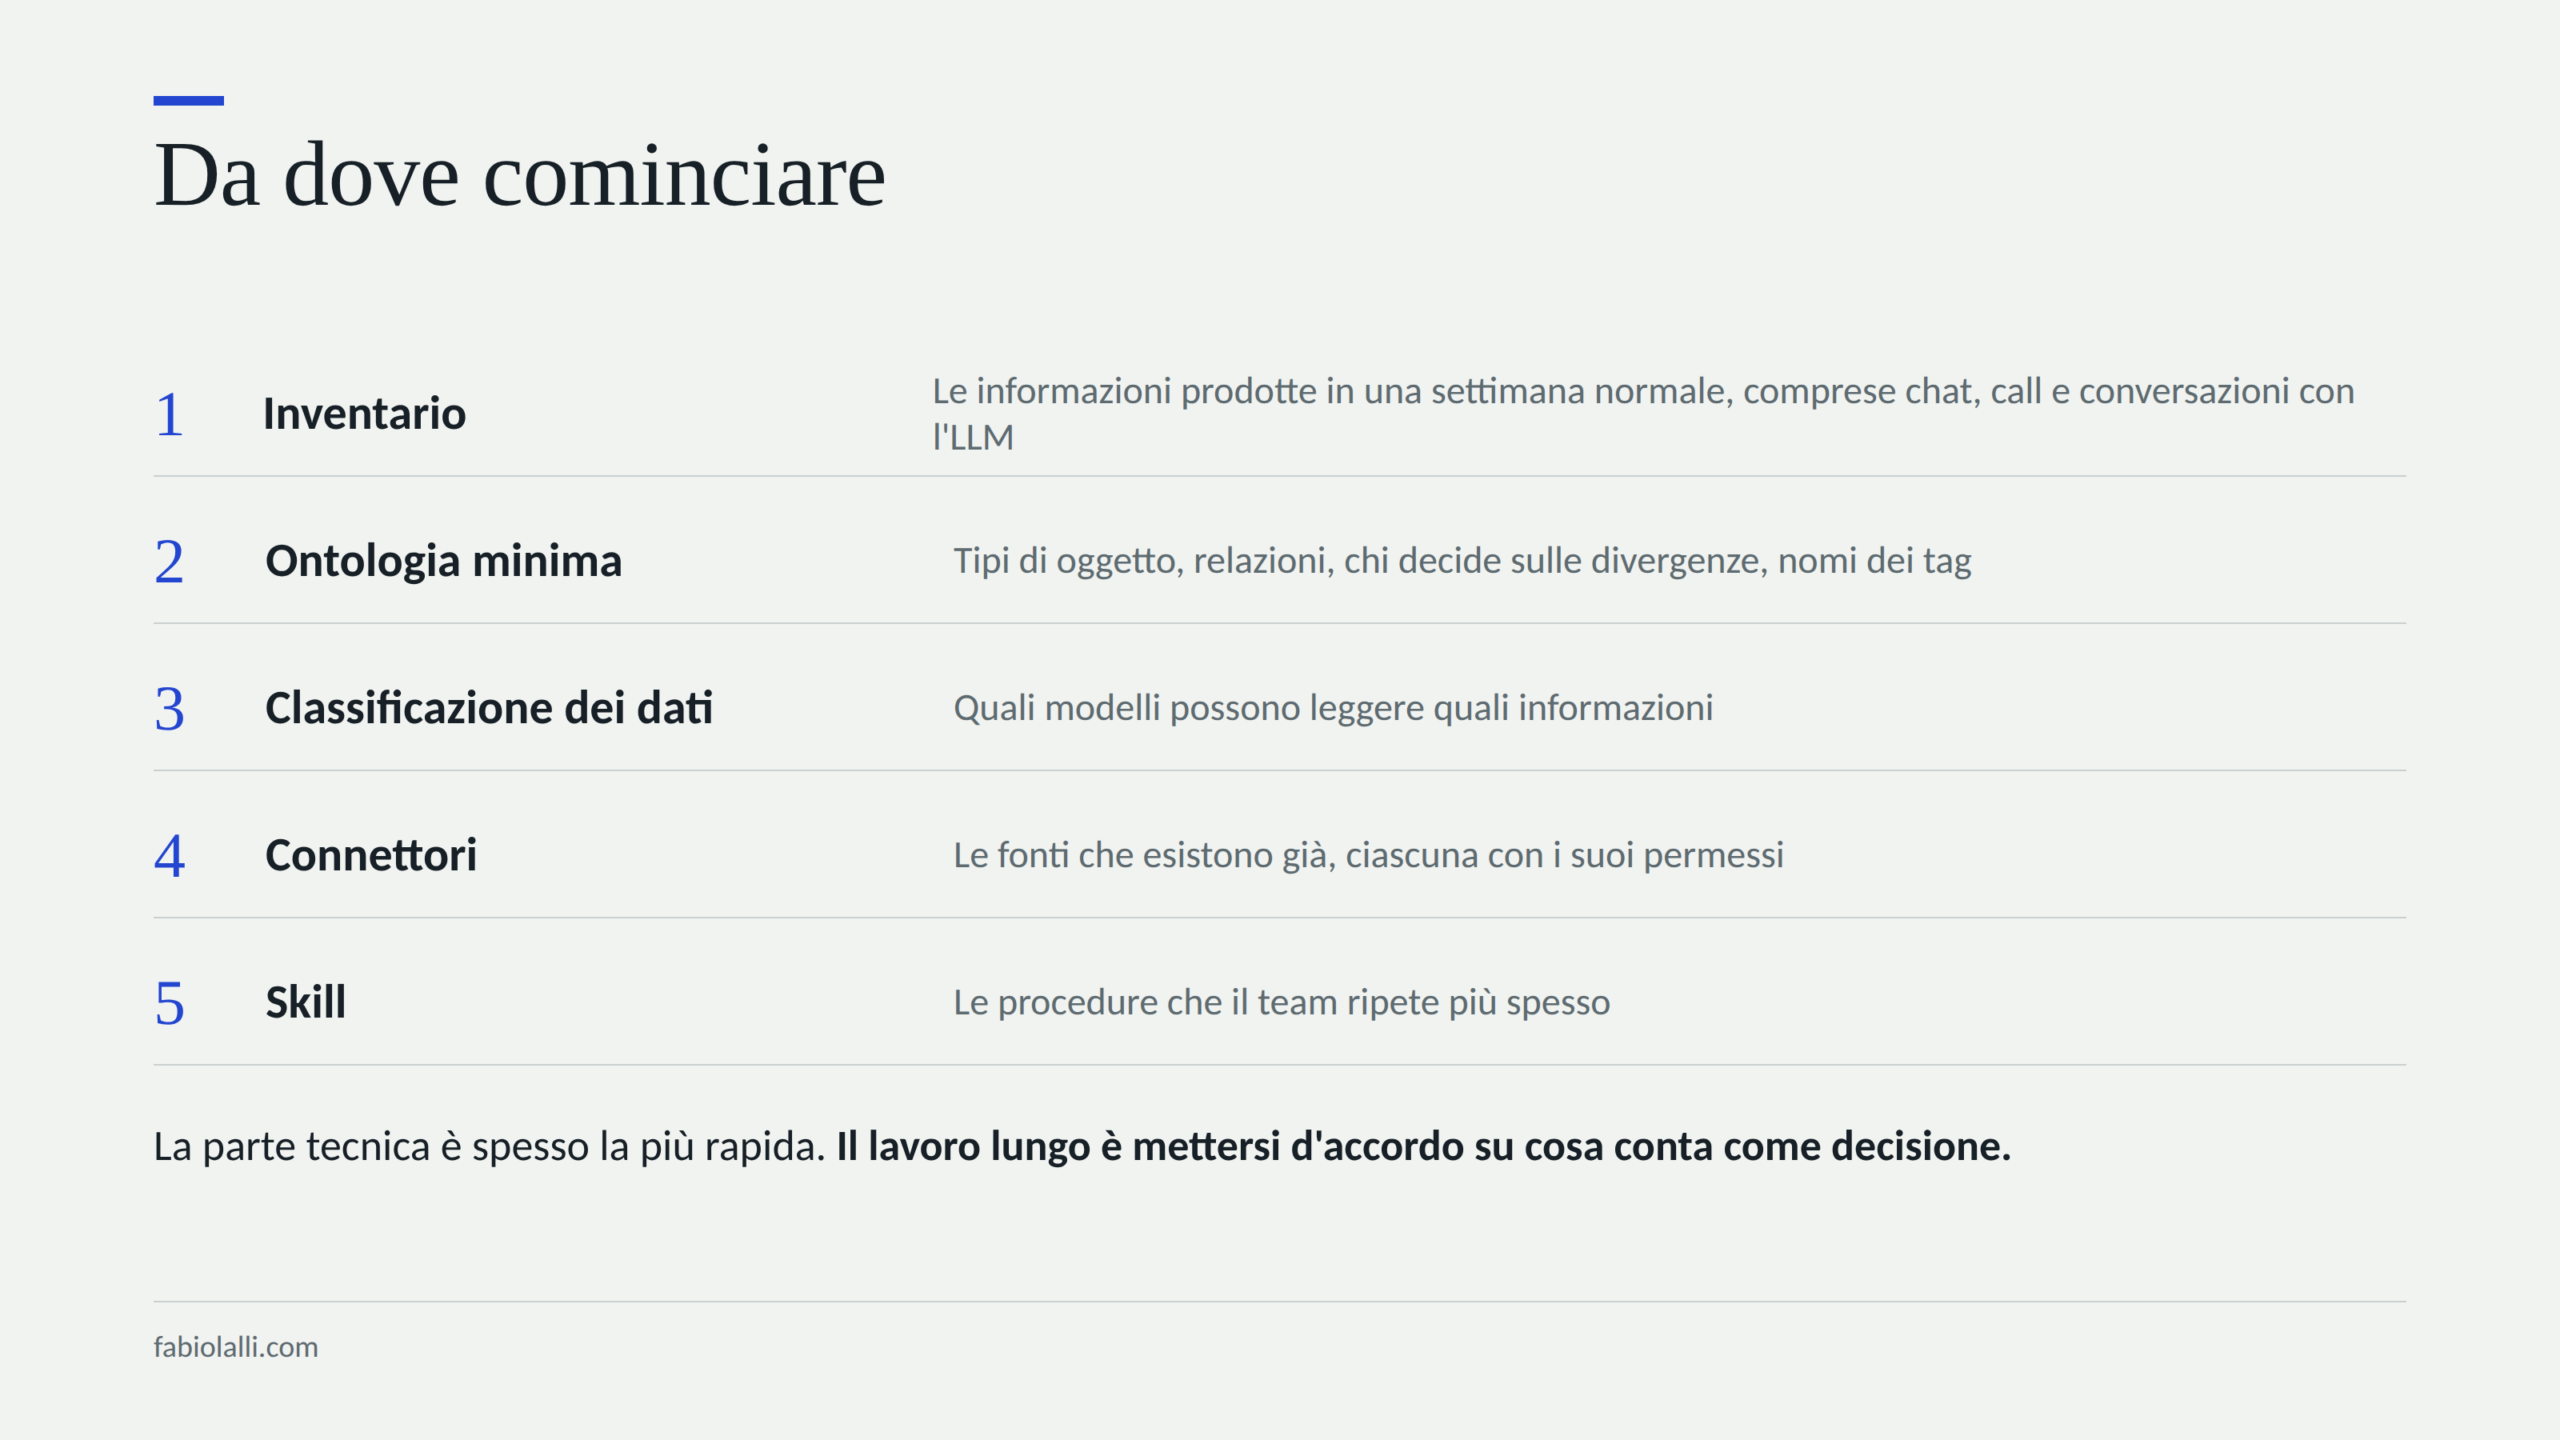
Chi parte da zero dovrebbe cominciare dalla carta e lasciare gli strumenti per dopo. Prima l’inventario delle informazioni che il team produce davvero in una settimana normale, comprese quelle che oggi si perdono nelle chat, nelle call e nelle conversazioni con l’LLM, e del sistema che ne è proprietario. Poi l’ontologia minima: quali tipi di oggetti esistono, quali relazioni servono, chi decide sulle divergenze, come si chiamano i tag. Poi la classificazione dei dati, che dice quali modelli possono leggerli. Infine i connettori e le skill, partendo dalle procedure che il team ripete più spesso e che oggi dipendono dalla memoria di una persona.

La parte tecnica, in molti casi, è la più rapida. Le fonti esistono già, hanno i loro connettori, e spesso basta farle convergere in un punto con un criterio di ingresso. Il lavoro più lungo è organizzativo: mettersi d’accordo su cosa conta come decisione, su chi può chiudere una divergenza, su quali dati non devono uscire dall’azienda e su quali tag hanno diritto di esistere è una conversazione che in molte aziende non è mai stata fatta. Scrivere nero su bianco quali sono gli oggetti della conoscenza di un team, e chi ne risponde, è il primo pezzo di uno spazio intelligente, e viene molto prima della scelta del modello da collegare.


Tool, skill e MCP: prima si disegna l’organizzazione, poi l’agente

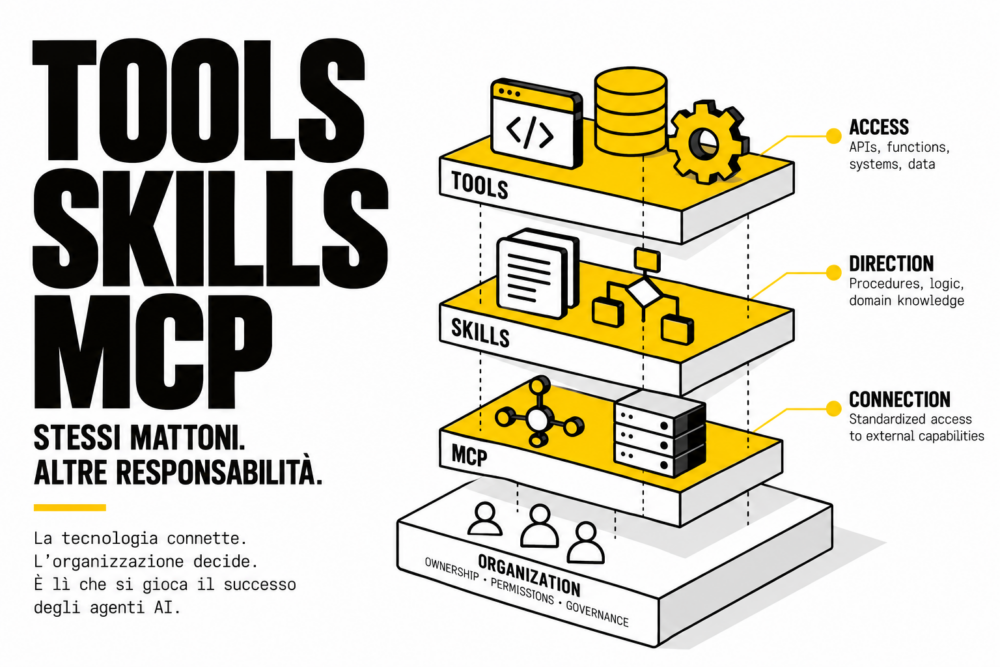
Su Medium ho trovato un articolo di Prabhu, che leggo da un po’, Tools vs Skills vs MCP, che mette in una tabella di tre righe i mattoni con cui oggi si costruisce un agente AI: i tool danno accesso, le skill danno direzione, MCP connette a capacità esterne. È una sistemazione utile per chi scrive codice e ha sentito usare le tre parole come sinonimi in una riunione, e la consiglio. Ho però l’impressione che per chi porta gli agenti dentro un’azienda quella tabella vada letta partendo da una colonna che non c’è, quella che dice chi ha deciso la procedura, chi ha concesso il permesso, chi possiede il sistema dall’altra parte del cavo.

Ogni riga della tabella tecnica ha un gemello organizzativo, e il gemello arriva prima. Una skill presuppone una procedura che qualcuno ha deciso e messo per iscritto, un tool presuppone una delega di potere con un perimetro, un server MCP presuppone un confine fra due sistemi che ha già un proprietario. Quando il gemello organizzativo manca la tecnologia non lo crea, lo simula, e la simulazione funziona benissimo finché non succede qualcosa.

Dentro il codice le tre cose si toccano

Conviene partire dal livello tecnico, perché è lì che la tabella semplifica di più. Un tool, nel senso che gli danno le API dei modelli, è una definizione: un nome, una descrizione in linguaggio naturale e uno schema JSON dei parametri. Il modello non esegue niente, produce una richiesta strutturata (chiama questa funzione con questi argomenti) e il runtime che gli sta intorno decide se eseguirla, con quali credenziali e cosa restituire. È la separazione su cui avevo costruito il pezzo sull’harness engineering: fra l’intenzione del modello e l’effetto nel mondo c’è sempre un pezzo di codice che qualcuno ha scritto e che può dire di no.

MCP, pubblicato da Anthropic a fine 2024 e poi adottato dagli altri grandi fornitori, sta un livello sotto i tool. È un protocollo costruito su JSON-RPC 2.0 con cui un’applicazione host apre connessioni verso uno o più server, e ogni server dichiara quali tool mette a disposizione del modello, affiancandoli se serve con risorse da leggere come contesto e con prompt riutilizzabili. Il trasporto può essere locale, un processo lanciato sulla macchina che parla attraverso lo standard input, oppure remoto su HTTP, con l’autorizzazione affidata a OAuth. In pratica MCP è il modo in cui i tool viaggiano: invece di cablare una funzione dentro ogni applicazione la si scrive una volta in un server e la si rende disponibile a qualunque client parli il protocollo.

Le skill sono l’oggetto più recente. Nel formato che Anthropic ha introdotto nell’autunno 2025 e poi aperto come standard, una skill è una cartella con un file SKILL.md, un’intestazione con nome e descrizione seguita da istruzioni in markdown, a cui si possono aggiungere file di riferimento e script eseguibili. Il meccanismo che la distingue da un prompt lungo si chiama progressive disclosure: il modello vede all’inizio solo nome e descrizione di tutte le skill installate e carica il corpo soltanto quando il compito lo richiede, così cento skill costano in contesto poche righe ciascuna finché restano inutilizzate. Una skill può contenere script, quindi porta con sé capacità, e un server MCP può esporre prompt, quindi porta con sé procedure. I confini si sovrappongono, e l’autore lo riconosce.

La colonna che mi convince meno è quella sulla manutenzione, dove MCP risulta «spesso gestito dal provider». Vale per GitHub o per Google Drive. Per il gestionale interno, per il CRM personalizzato da un fornitore che nel frattempo ha chiuso, per il database della produzione, il server MCP lo scrive e lo mantiene l’azienda, e il protocollo standardizza la forma della conversazione senza togliere a nessuno la responsabilità del contenuto.

La procedura di design che l’articolo propone parte da una domanda di capacità (cosa deve saper fare l’agente) e arriva ai sistemi esterni. Funziona per un team di sviluppo che costruisce un assistente per sé stesso. Dentro un’organizzazione la prima domanda riguarda l’autorità, e la capacità viene dopo.

Scrivere una skill obbliga a decidere il criterio

L’esempio dell’articolo è una skill per il rilascio di un’app Flutter in nove passi, dal controllo del branch fino al riepilogo finale. È un buon esempio proprio perché è facile: in un team di sviluppo quella procedura esiste già, spesso codificata in una pipeline di integrazione continua, e trasformarla in skill significa tradurla.

In azienda le procedure che vale la pena delegare a un agente raramente sono così. Come si valuta se un cliente merita una deroga sui tempi di pagamento, quando un reclamo va passato all’ufficio legale: sono decisioni che vivono nella testa di tre persone, ognuna con una versione leggermente diversa, mentre la versione ufficiale sta in un manuale qualità che nessuno apre da anni.

Quando si scrive la skill ci si accorge che manca il criterio, e a quel punto le strade sono due. Può scriverlo chi sta costruendo l’agente, un tecnico o un consulente che non ha l’autorità per decidere come l’azienda tratta i clienti morosi e che, per far funzionare il sistema, finisce per deciderlo lo stesso. Oppure ci si ferma e si chiede a chi ha quell’autorità di mettere il criterio per iscritto, ed è qui che il progetto rallenta, perché scrivere un criterio lo rende discutibile. Nel pezzo su chi delega all’AI il proprio lavoro avevo raccontato come la delega sia più bassa proprio nelle professioni dove il criterio è il patrimonio, e credo che dentro le aziende agisca la stessa dinamica.

Me ne accorgo ogni volta che scrivo le skill che uso per lavorare: la parte che richiede tempo sono sempre le regole, il formato del file si impara in un pomeriggio. La skill con cui preparo i pezzi per questo blog contiene un elenco di cose da evitare costruito correzione dopo correzione nel corso di mesi, e ogni riga è una decisione editoriale che prima stava solo nella mia testa e che adesso posso rileggere e contestare. Vista da fuori, una skill ben scritta è un documento di organizzazione con l’estensione .md.

Il permesso viene prima dello strumento

Un tool, guardato dall’organizzazione, è una delega di potere. createJiraTicket() è innocuo, issueRefund() no, e la differenza non sta nel codice (sono due chiamate HTTP molto simili) ma nel fatto che la seconda sposta denaro per conto di qualcuno.

Chi concede quel potere all’agente, e con quale identità l’agente lo esercita, sono domande che un’azienda sa già porsi per le persone, tanto che esistono procure, limiti di spesa per ruolo e doppie firme sopra una certa soglia. Per gli agenti queste regole di solito non ci sono, e il caso più frequente che incontro è l’agente che eredita le credenziali di chi lo ha configurato, con tutti i suoi permessi, compresi quelli che nessuno gli avrebbe mai delegato consapevolmente. Ogni tool concesso a un agente dovrebbe essere un permesso revocabile, con un titolare che sa di averlo firmato.

Nella guida alle istruzioni per Claude Code raccontavo come un’istruzione scritta nel prompt si pieghi sotto pressione mentre un hook no. Con i permessi succede lo stesso: scrivere nella skill «non emettere rimborsi sopra i 500 euro» esprime un desiderio, far rifiutare la chiamata al server sopra quella soglia stabilisce una regola. Il modello organizzativo decide la soglia e la tecnica la rende inviolabile, in quest’ordine, perché nessun ingegnere dovrebbe stabilire da solo quanta fiducia l’azienda concede a un software.

MCP disegna confini che hanno già un proprietario

Il diagramma dell’articolo mette l’applicazione AI in alto, il server MCP al centro e sotto GitHub, un database e Jira. Da dentro un’azienda ognuna di quelle scatole ha un responsabile, un budget, un fornitore con un contratto e spesso un’opinione precisa su chi può leggere i suoi dati. Scrivere un server MCP per il CRM significa decidere quali parti del CRM diventano leggibili da un agente e in nome di chi, e quella decisione appartiene al responsabile commerciale e al DPO prima che al team IT.

Il server MCP del blog su cui sto scrivendo ne è un esempio piccolo. Impone una sequenza di stati, dalla bozza alla revisione fino all’approvazione e alla programmazione, e rifiuta i salti. Quella sequenza è una decisione organizzativa su chi controlla cosa prima che un testo esca col mio nome, e sta nel server proprio perché non può dipendere dalla buona volontà del modello in una sessione qualsiasi.

C’è poi il livello del significato, che nessun protocollo tocca. Due server MCP possono esporre lo stesso campo «cliente» intendendo cose diverse, uno i clienti attivi e l’altro chiunque abbia mai ricevuto un’offerta, e l’agente li userà entrambi con la stessa sicurezza. Ne ho scritto a proposito dell’interoperabilità fra agenti, dove il vocabolario precede il protocollo, e del modello dati come teoria dell’azienda: MCP standardizza il tubo, e quello che ci scorre dentro porta con sé tutte le ambiguità organizzative che c’erano prima.

Il codice moltiplica il modello organizzativo che trova

Sarebbe sbagliato concludere che la tecnica sia un dettaglio da sistemare a valle. La sequenza che propongo alle aziende con cui lavoro differisce da quella dell’articolo soltanto nell’ordine delle domande, perché parte da chi decide e con quale criterio, passa per i poteri che si delegano e le soglie che li limitano, arriva ai confini fra sistemi e ai loro proprietari. A quel punto si scrivono skill, tool e server, e ognuno diventa la forma eseguibile di una decisione già presa.

Quando la decisione esiste, la tecnica le dà proprietà che sulla carta non ha mai avuto. Scritta in una skill, una procedura diventa versionata, e si può ricostruire quale versione ha guidato un’azione in una certa data; il permesso, quando sta nel server, si può testare e la sua violazione lascia un log; per spostare un confine dichiarato in un server MCP serve una modifica che qualcuno deve approvare. Il manuale qualità non aveva nessuna di queste caratteristiche, ed è per questo che nessuno lo apriva.

C’è anche un effetto di ritorno. Scrivere una skill è il modo più rapido che conosco per scoprire dove un’organizzazione non ha mai deciso niente, perché il modello, a differenza di un collega esperto, non riempie i vuoti con il buon senso del corridoio: li riempie con una media statistica, e la media si vede subito. Da quando ho scritto Pelle Digitale penso alle interfacce fra persone e macchine come ai punti in cui qualcosa di implicito è costretto a diventare esplicito, e gli agenti portano quel passaggio dentro l’organigramma.

Nei prossimi mesi i fornitori renderanno skill e server MCP facili da installare quanto un’app, e molte aziende ne avranno a decine prima di aver deciso chi li governa. Il vantaggio andrà a chi userà questo periodo per fare l’esercizio al contrario, prendendo una procedura alla volta e cercando chi l’ha decisa. Spesso la risposta sarà nessuno, e da lì comincia il progetto.


La tracciabilità di una risposta comincia dal percorso

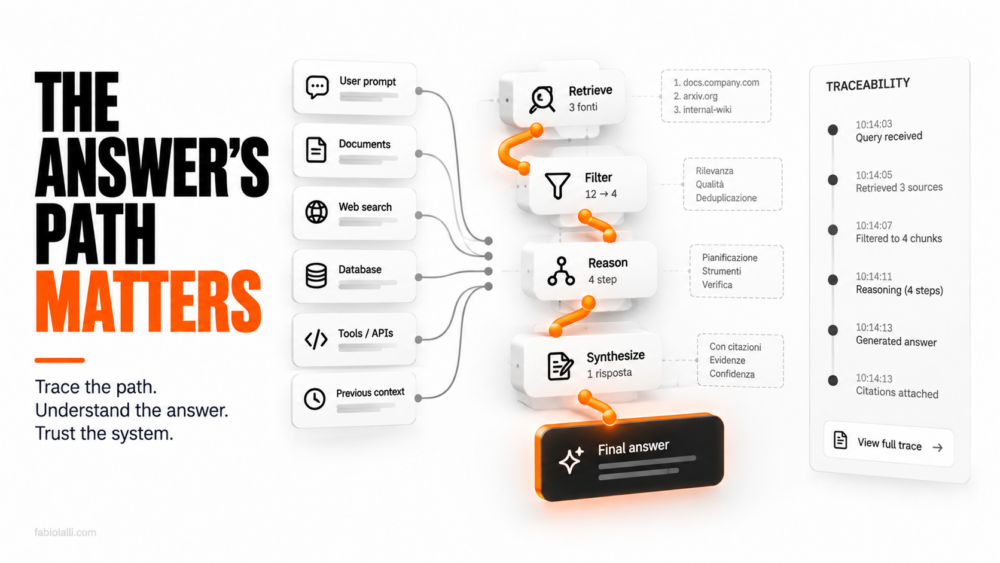
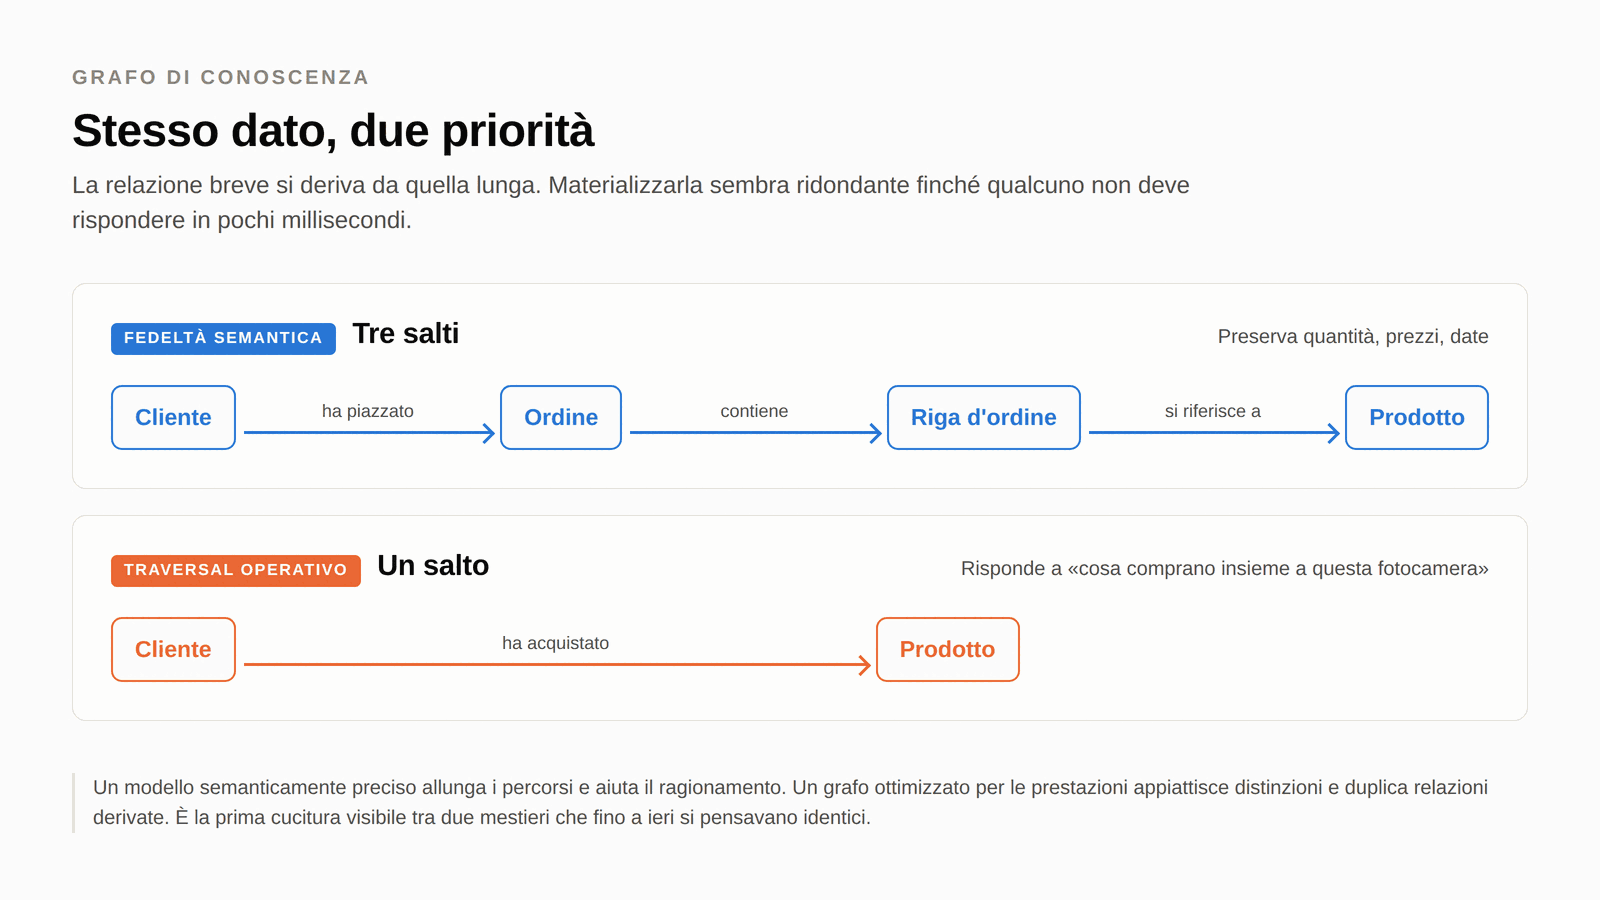
La tracciabilità di un sistema di ricerca semantica finisce prima di cominciare. Il sistema ti restituisce sei frammenti di documento e una risposta costruita su quei frammenti. Se chiedi come ci è arrivato, ottieni i punteggi di somiglianza. Sono numeri veri, calcolati su vettori, e non dicono niente che un revisore possa usare, perché la somiglianza fra due testi non è una ragione per cui una conclusione è corretta.

Un sistema che attraversa un grafo ti restituisce la stessa risposta con in più l’elenco dei passaggi che ha fatto, e quell’elenco è composto di relazioni che qualcuno ha definito e che qualcuno può contestare.

Una risposta senza itinerario

La differenza si vede quando qualcosa va storto. Nel primo caso la ricostruzione richiede di rifare l’esperimento sperando che il sistema si comporti allo stesso modo, e siccome il recupero dipende da come è stata formulata la domanda, da cosa era indicizzato quel giorno e da quale versione del modello di embedding stava girando, la riproducibilità è una speranza.

Nel secondo caso il percorso è un oggetto discreto, salvabile, confrontabile. Il cliente identificato con un certo codice, l’entità contraente collegata a quel codice, i tre contratti agganciati a quell’entità, la data presa dal campo di quel contratto, il record di origine nel sistema che lo custodisce. Se la risposta è sbagliata, l’errore sta in uno di quei passaggi, e si trova.

La tracciabilità nasce insieme all’esecuzione

Nelle architetture che vedo in giro la tracciabilità viene quasi sempre aggiunta dopo, sotto forma di registrazione delle chiamate e conservazione dei prompt. Funziona finché serve a capire cosa è stato chiesto, e smette di funzionare quando serve a capire perché la risposta era quella.

Con un grafo la traccia non va costruita, esiste come sottoprodotto dell’esecuzione. L’agente che percorre collegamenti lascia dietro di sé l’unica cosa che un revisore possa leggere senza essere un data scientist, cioè una catena di relazioni con nomi in lingua naturale. Quelle relazioni portano con sé anche i limiti di chi le ha disegnate, ed è utile leggerle sapendo che lo schema incorpora una teoria dell’azienda che nel percorso non si vede.

Quando qualcuno chiede come ci sei arrivato

L’AI Act chiede ai sistemi classificati ad alto rischio la registrazione automatica degli eventi lungo tutto il ciclo di vita, e chiede che la documentazione tecnica permetta di comprendere come il sistema produce i propri risultati. Nelle aziende con cui lavoro questi obblighi vengono affrontati come un problema di documentazione, e finiscono su un documento Word che descrive un comportamento atteso.

Un percorso salvato è una risposta diversa allo stesso obbligo, perché descrive il comportamento avvenuto, e dice insieme quali dati sono stati attraversati e con quale titolo, che è la coppia di domande intorno a cui ruota il confine fra significato e permesso. Il documento dice come dovrebbe funzionare, il log del traversal dice come ha funzionato quel martedì alle undici e dodici su quella richiesta.

Vale anche fuori dall’ambito normativo. Il giorno in cui un cliente contesta una fattura calcolata da un sistema automatico, la domanda che ti arriva non riguarda l’architettura, riguarda quel caso.

C’è una differenza pratica fra le due posizioni che si vede nel tempo di risposta. Chi ha il percorso salvato apre il caso, guarda i passaggi, individua il nodo in cui la relazione era sbagliata e risponde in mezza giornata con una spiegazione che la controparte può verificare. Chi ha soltanto i log delle chiamate apre una riunione, coinvolge chi ha costruito il sistema, prova a riprodurre il comportamento su un ambiente che nel frattempo è cambiato, e dopo due settimane produce una ricostruzione plausibile.

Dove il percorso non basta

Sarebbe comodo se tutte le risposte venissero da relazioni modellate, e non è così. Una parte consistente di quello che serve sta dentro testo libero che nessuno strutturerà mai: la clausola negoziata a mano in calce a un allegato, la mail in cui il cliente accetta una proroga, il verbale in cui si decide un’eccezione per quel caso.

Su quel materiale il grafo arriva fino a un certo punto, e la risposta finale la produce comunque un modello che legge prosa. La differenza sta in quanta prosa deve leggere e in quale prosa: un traversal che seleziona tre documenti pertinenti e li passa al modello produce una traccia che dice quali tre documenti, mentre un recupero per somiglianza su tutto l’archivio dice soltanto che quei tre erano i più vicini.

Il percorso quindi non elimina il giudizio del modello, lo circoscrive a un materiale identificato e ispezionabile. È una forma di prova più debole di una catena di relazioni e molto più forte di un punteggio di somiglianza, e per la maggior parte dei casi reali è il livello a cui si può arrivare davvero.

Il costo di ricostruire dopo

Chi ha già vissuto un audit sa che la spesa della tracciabilità non sta nel produrre le prove, sta nel cercarle a posteriori dentro sistemi che non erano stati pensati per essere interrogati in quel modo. Sono settimane di persone brave sottratte al lavoro, e il risultato è comunque una ricostruzione parziale accompagnata da una lettera che spiega i limiti della ricostruzione.

Chi costruisce adesso il proprio grafo per ridurre la spesa di inferenza si porta a casa la tracciabilità come effetto collaterale, e la paga una volta sola. Chi costruisce solo l’indice vettoriale otterrà risposte più economiche di oggi e si troverà con lo stesso problema di prova di sempre, spostato di un livello e reso più difficile dal fatto che adesso in mezzo c’è un modello statistico.

La differenza fra le due scelte non si vede il primo mese. Si vede il giorno in cui qualcuno con l’autorità per farlo ti chiede di dimostrare una cosa che il sistema ha detto sei mesi prima.

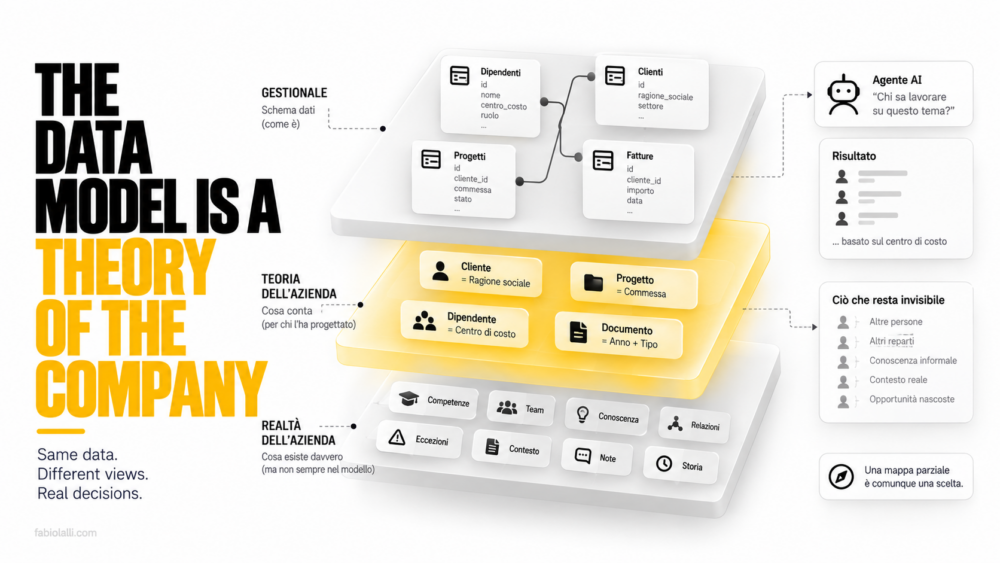
Il modello dati è una teoria dell’azienda

Nel modello dati del gestionale che usi il dipendente è agganciato a un centro di costo. È stato deciso quando l’azienda ha comprato quel software, probabilmente da un consulente che doveva far quadrare la contabilità analitica, e da allora nessuno l’ha più toccato perché funzionava.

Adesso su quei dati gira un agente a cui chiedi chi in azienda sa lavorare su un certo tema. L’agente risponde con la lista del centro di costo, perché è l’unica lente che gli hai dato, e le persone che quel tema lo presidiano da un altro reparto restano fuori dalla risposta senza che nessuno se ne accorga.

Il gestionale ha già deciso

L’ontologia aziendale non la scrive un ontologo. Esiste già, distribuita fra lo schema del gestionale, i campi obbligatori del CRM, le voci del piano dei conti e le tassonomie del sistema documentale, e riflette le priorità di chi ha firmato quegli acquisti.

Quasi sempre quelle priorità erano amministrative. Il cliente è la ragione sociale perché la fattura si intesta a una ragione sociale, il progetto è la commessa perché la commessa è l’unità di ricavo, il documento è classificato per anno e tipo perché così lo voleva la conservazione sostitutiva. Sono tutte scelte legittime, e nessuna è stata presa pensando che un giorno qualcuno ci avrebbe fatto ragionare una macchina sopra.

Il risultato è che gli agenti che stiamo mettendo in produzione ereditano la visione del mondo di un ufficio amministrativo di dieci anni fa, e la ereditano senza margine di discussione. Vale anche per chi pensa di partire da zero, perché un’ontologia implicita c’è comunque, e in assenza di decisione è quella del software che si è comprato.

Ogni modello dati è una mappa parziale

Ogni modello dati incorpora una teoria di cosa conta. Se modelli il fatturato per cliente vedi la concentrazione, se lo modelli per prodotto vedi il portafoglio, se lo modelli per persona che ha portato il contratto vedi una dipendenza da singoli individui che gli altri due tagli nascondono. Sono tre grafi diversi costruiti sugli stessi movimenti contabili, e rispondono in modo diverso alla stessa domanda su dove sta il rischio.

Una mappa utile è per costruzione parziale, ed è la parzialità a renderla utilizzabile. Il guaio comincia quando la parzialità sparisce dalla vista e la mappa viene presa per il territorio, che è quello che succede quando fra il modello e chi legge si interpone un sistema che risponde in prosa scorrevole e senza incertezze.

Il guidatore non discute la strada

Una persona che riceve un report strano ha una reazione che una macchina non ha. Alza la testa, dice che quel numero non torna con quello che vede in giro, e va a cercare come è stato costruito. Quella reazione nasce da una conoscenza del territorio che non sta in nessun sistema.

Un agente percorre la mappa che gli hai dato e non sospetta l’esistenza di strade che sulla mappa non compaiono. Non è un limite del modello, è una proprietà di come funziona: un sistema che interroga un grafo può essere valutato sulla correttezza del percorso, mai sulla completezza della mappa, perché la completezza è una proprietà del mondo e nel mondo il sistema non ci entra.

Ne avevo scritto arrivando dall’altro lato, quando mi ero chiesto dove finisce l’ontologia e comincia l’agente: il significato non copre il permesso, e adesso aggiungo che non copre nemmeno la propria incompletezza.

Leggere lo schema come un documento storico

C’è un esercizio che faccio volentieri quando entro in un’azienda che vuole mettere agenti sui propri dati, e costa mezza giornata. Si prende lo schema delle tre o quattro tabelle principali e si legge campo per campo chiedendosi perché quel campo è obbligatorio, chi lo compila, e cosa succedeva prima che esistesse.

Le risposte raccontano una storia precisa. Il campo obbligatorio che nessuno usa da sei anni è rimasto perché serviva a un adempimento abrogato nel frattempo. Il campo note, quello lungo e libero dove sta scritto tutto quello che la struttura non prevedeva, è il posto dove l’azienda ha depositato la propria complessità reale. Il codice cliente che ha due formati diversi a seconda dell’anno segna una migrazione fatta male che qualcuno ricorda ancora con fastidio.

Quel campo note merita attenzione particolare, perché è esattamente il punto in cui l’ontologia formale ha fallito e la conoscenza si è rifugiata. Contiene le eccezioni, gli accordi verbali, i motivi per cui una certa pratica va trattata in modo diverso, e sta lì in prosa libera, illeggibile per una query e perfettamente leggibile per un modello linguistico. Il paradosso è che oggi la parte meno strutturata dell’archivio è anche quella più ricca, ed è la prima che un progetto di modellazione tende a buttare via perché non entra in nessuna colonna.

Chi può emendare la mappa

La domanda operativa è chi ha il potere di cambiare lo schema, e in quasi tutte le aziende che vedo la risposta è che nessuno ce l’ha davvero. Il modello dati sta sotto una licenza software, dentro una personalizzazione fatta da un partner che nel frattempo è stato acquisito, e una modifica strutturale comporta una migrazione che nessuno vuole firmare.

Il rischio concreto non è che il modello sia sbagliato. È che sia congelato, mentre l’azienda intorno cambia e gli agenti continuano a rispondere con le categorie del 2014 usando un linguaggio che sembra attuale. Lo stesso problema si presenta ingrandito quando il vocabolario va concordato con altri, come nel caso della definizione condivisa lungo una filiera, dove a congelarsi sono due schemi invece di uno.

Quando metti un agente su un archivio, la prima domanda da fare non riguarda il modello di linguaggio che userai, riguarda il modello dati che c’è già. Riguarda chi ha scritto lo schema, quando, e per risolvere quale problema di allora. La risposta dice già gran parte di quello che quell’agente potrà e non potrà vedere.

Progettare il loop invece di scrivere il prompt successivo

Chiedi a Claude di aggiungere un pulsante di like e parte un loop agentico. Legge il codice, fa la modifica, lancia i test e ti restituisce qualcosa che crede funzioni. Poi tocca a te: apri la pagina, clicchi, guardi la console del browser, e scrivi il prompt successivo. Il collo di bottiglia sei tu, per come è fatto il ciclo: l’agente produce, l’umano controlla, un turno alla volta.

Delba de Oliveira e Michael Segner, del team di Claude Code, hanno messo per iscritto a fine giugno la definizione di loop agentico che usano internamente: «agents repeating cycles of work until a stop condition is met». Agenti che ripetono cicli di lavoro finché non scatta una condizione di stop. È una definizione povera di aggettivi e piena di conseguenze, perché tutto il peso si sposta su una domanda sola, chi scrive quella condizione.


Il ciclo di base: raccoglie contesto, agisce, verifica, e riparte finché la condizione di stop non è soddisfatta.

Quattro modi di far girare un agente

Il turn-based è il loop agentico che usiamo tutti senza chiamarlo così. Parte da un tuo prompt, Claude raccoglie il contesto, agisce, controlla il proprio lavoro e risponde, e si ferma quando giudica il compito chiuso oppure quando gli serve qualcosa che non ha. Quello che deleghi, se lo deleghi, è il controllo del risultato.

Il goal-based nasce quando un turno solo non basta. Con /goal dichiari che cosa significa fatto, e Claude continua a lavorare senza che tu debba rilanciarlo a ogni giro. Ogni volta che prova a fermarsi, un modello valutatore rilegge la conversazione e decide se la condizione regge, e se non regge lo rimanda al lavoro con una motivazione che diventa la guida del turno successivo. Qui deleghi la condizione di uscita, ed è la ragione per cui i criteri deterministici funzionano molto meglio delle formule generiche.

Il time-based serve al lavoro che torna, quello in cui il compito resta identico e cambiano solo gli ingressi: il riassunto dei messaggi del mattino, la pull request che riceve commenti di review e fa fallire la CI. Deleghi l’innesco.

Il proattivo è quello in cui davanti allo schermo non c’è nessuno. Un evento o una pianificazione fanno partire il lavoro, ogni task esce quando raggiunge il proprio obiettivo, la routine continua a girare finché non la spegni. Deleghi il prompt, cioè la parte che fino a ieri consideravamo il mestiere.

I comandi che Anthropic ha rilasciato

/goal imposta una condizione di completamento valida per la sessione, lunga fino a quattromila caratteri. A ogni fine turno un modello piccolo e veloce, Haiku per impostazione predefinita sull’API di Claude, restituisce uno di tre verdetti: soddisfatta, non ancora, impossibile. Il valutatore non esegue comandi e non legge file per conto suo, giudica soltanto quello che Claude ha già portato in conversazione, quindi la condizione va scritta come qualcosa che l’output può dimostrare. Dentro la condizione conviene mettere anche un tetto, «oppure fermati dopo venti turni», altrimenti il loop si allunga oltre quello che ti aspetti. Funziona anche in modalità non interattiva, con claude -p.

/loop rilancia lo stesso prompt a intervalli regolari e gira sul tuo computer, quindi si spegne quando spegni la macchina. /schedule sposta la stessa idea nel cloud e la trasforma in una routine, che continua a lavorare a portatile chiuso. Una routine può partire da una pianificazione oraria, giornaliera, feriale o settimanale, da una chiamata HTTP autenticata a un endpoint dedicato, oppure da un evento GitHub come l’apertura di una pull request o la pubblicazione di una release, con filtri su autore, titolo, branch, etichette. L’intervallo minimo è un’ora. Le routine sono disponibili sui piani a pagamento di Claude, si gestiscono da claude.ai/code/routines e hanno un tetto giornaliero di esecuzioni oltre al consumo ordinario dell’abbonamento.

Intorno a questi due comandi girano altri pezzi. La modalità auto approva le chiamate agli strumenti dentro un turno, e si combina bene con /goal, che invece toglie di mezzo la conferma tra un turno e l’altro. I dynamic workflows, in research preview, permettono a Claude di orchestrare sottoagenti in parallelo. Le skill descrivono i controlli da ripetere. Per chi non apre mai un terminale ci sono gli scheduled task di Cowork, che si configurano dall’interfaccia, girano da remoto anche a computer spento e usano i connettori e le skill già attive.

Il criterio d’uscita vale più del prompt

La qualità di un loop dipende dal sistema che gli sta intorno, e il pezzo che pesa di più è la verifica. Il consiglio di Anthropic è codificare in un file di skill i passaggi che oggi fai a mano, così che l’agente possa controllare il proprio lavoro dall’inizio alla fine invece di dichiararlo finito appena la modifica è andata a buon fine: avviare il server, aprire la pagina, cliccare il controllo nuovo, fare uno screenshot prima e dopo, guardare che in console non compaiano errori, misurare le metriche di performance. Più i controlli sono quantitativi, più l’autoverifica diventa semplice.

Nel mio flusso editoriale la condizione di uscita è un exit code. Uno script passa il testo al setaccio cercando i tic di scrittura che non voglio, e finché non esce zero il pezzo non si consegna. È un criterio grezzo, e misurabile, e chiude il loop in molti meno giri di qualunque descrizione a parole di che cosa sia un buon articolo.


Più il criterio d’uscita è misurabile, meno turni servono al loop per chiudersi da solo.

Due accorgimenti da rubare. Il primo è affidare la revisione a un secondo agente con contesto pulito, perché chi non ha seguito il ragionamento del primo è meno incline a confermarlo. Il secondo riguarda cosa fare quando un risultato non è all’altezza: correggere il singolo errore serve una volta sola, mentre spostare la correzione dentro la skill la rende valida per tutti i giri successivi. È la differenza tra un loop che migliora e uno che ti fa rimettere a posto la stessa cosa per la terza volta.

Sei loop da accendere questa settimana

La rassegna delle sette è il più facile da accendere: uno scheduled task che legge messaggi, posta e calendario delle ultime ventiquattro ore e consegna un brief prima che tu apra il computer. «Ogni mattina alle 7:00 riassumi Slack, email e calendario delle ultime 24 ore e scrivimi trecento parole con le tre cose che oggi richiedono una mia decisione».

Quando le richieste arrivano su un canale condiviso, la coda si accumula da sola e qualcuno passa la giornata a smistarla. Una routine oraria con un obiettivo esplicito la tiene bassa: «ogni ora controlla il canale delle richieste, e non fermarti finché ogni segnalazione trovata in questo giro non ha un responsabile, una priorità e una risposta».

C’è poi il documento che non esce finché non passa l’audit, il caso in cui il criterio esiste già da qualche parte e nessuno lo aveva mai dato in pasto all’agente: «l’articolo passa lo script di audit con exit code 0 e resta sopra le 1.400 parole, fermati dopo sei tentativi».

Anche il debito accumulato su un sito si può assegnare a un lunedì mattina: «ogni lunedì alle 6:00 controlla i post pubblicati nell’ultimo mese, segnala meta description mancanti, immagini senza testo alternativo e link interni rotti, e prepara le correzioni in bozza».

Sulle pull request funziona meglio l’intervallo, perché quello che cambia sta fuori dal tuo progetto e arriva quando arriva: /loop 10m controlla la mia PR, rispondi ai commenti di review, sistema la CI che fallisce.

L’ultimo parte da un evento invece che da un orario. La pipeline di deploy chiama via HTTP l’endpoint della routine appena il rilascio è in produzione, la routine esegue gli smoke test, cerca regressioni nei log e scrive go o no-go nel canale di release prima che la finestra si chiuda. Lo stesso schema regge sugli alert: il sistema di monitoraggio passa il corpo dell’allarme, l’agente correla lo stack trace con i commit recenti e apre una bozza di pull request con una proposta di correzione, così chi è di turno trova qualcosa su cui lavorare invece di un terminale vuoto.

Per scegliere quale accendere per primo, Anthropic propone un criterio pratico: guarda il lavoro che già fai, prendi un compito in cui sei tu a rallentare tutto, e chiediti quale pezzo puoi passare alla macchina, se sai scrivere il controllo di verifica, se l’obiettivo è già abbastanza chiaro da poter essere giudicato da un altro modello, oppure se il lavoro arriva comunque a scadenze regolari.

Quanto costa tenere acceso un loop

Un loop senza confini è un modo elegante di bruciare token. Il primo controllo è la scelta del pezzo giusto: un compito piccolo non ha bisogno di più agenti, e parecchio lavoro gira benissimo su modelli più economici, tenendo quello più capace per le decisioni di giudizio. Il secondo è la precisione del criterio di uscita, che deve essere specifico abbastanza da far arrivare Claude alla soluzione presto, senza però farlo fermare troppo presto.

Poi ci sono due regole che sembrano banali e non lo sono. Quando una parte del lavoro è deterministica, conviene che sia uno script a farla, perché eseguire uno script costa meno che ragionare ogni volta sugli stessi passaggi. E l’intervallo di una routine va tarato su quanto spesso cambia davvero la cosa che stai guardando, non su quanto ti piacerebbe essere aggiornato. Prima di lanciare un workflow su tutto il perimetro conviene provarlo su una fetta piccola, visto che l’orchestrazione dinamica può generare centinaia di agenti.

Per misurare c’è /usage, che scompone il consumo recente per skill, sottoagenti e connettori, /goal senza argomenti, che mostra turni e token spesi finora, e /workflows, da cui si vede quanto sta consumando ogni agente e si può fermarne uno al volo.

Una routine firma con la tua identità

Qui arriva la parte che in azienda pesa più del risparmio di tempo. Una routine gira come sessione autonoma: durante l’esecuzione non ci sono richieste di permesso, e Claude può usare tutti gli strumenti dei connettori inclusi, comprese le scritture. Quando crei una routine i connettori attivi vengono inclusi tutti per impostazione predefinita, e toglierli è un gesto che conviene fare subito.

Quello che la routine fa attraverso la tua identità appare come fatto da te. I commit e le pull request portano il tuo utente GitHub, i messaggi su Slack e i ticket su Linear passano dai tuoi account collegati. L’ambiente cloud definisce a quali domini la sessione può arrivare, e il testo che accompagna un’attivazione via API viene consegnato all’agente dentro un blocco marcato come dato non affidabile, così il prompt della routine deve dichiarare esplicitamente di volerlo usare prima che quel testo possa orientare il lavoro.

Sono dettagli di configurazione, e insieme disegnano una superficie di responsabilità nuova. Permesso revocabile è la formula che uso da tempo per questa condizione, in cui l’autonomia di un sistema è sempre concessa e sempre ritirabile. Con le routine la domanda operativa diventa chi ha aperto il permesso, quali strumenti ha lasciato dentro, e in quanto tempo qualcuno se ne accorge.

Il livello che stavamo saltando

Per due anni abbiamo lavorato quasi solo sul primo livello, la formulazione del singolo turno, e poi sul secondo, il contesto da mettere davanti al modello. Sopra c’è l’harness, il guscio che decide che cosa l’agente può toccare e con quali permessi. In mezzo sta il livello che stavamo saltando: quante volte l’agente ci riprova, e a quali condizioni ha il diritto di dire che ha finito.


Il loop sta sopra il contesto e sotto l’harness: un guasto si attribuisce al livello che lo ha prodotto.

Chi progetta il loop agentico decide dove finisce il lavoro della macchina e dove comincia la responsabilità di una persona. Nei prossimi mesi credo che nelle organizzazioni comparirà un ruolo che oggi non ha ancora un nome: qualcuno che scrive le condizioni di stop, le rivede quando cambia il contesto, e risponde di tutto quello che quelle condizioni lasciano passare.

Maledetto AI slop

Arrivo alla fine del secondo paragrafo e mi accorgo che sto ancora aspettando. Il testo è scritto bene, le transizioni sono al posto giusto, i paragrafi hanno tutti la stessa lunghezza cortese, non c’è un refuso, e non c’è una riga che qualcuno abbia voluto scrivere. Chiudo la pagina e dopo dieci secondi non saprei ricordarmene una parte né ripeterne i concetti.

In inglese la parola l’hanno trovata, ed è brutta apposta. Slop è la broda di scarti e avanzi che si versa ai maiali, riciclata sul modello di spam per indicare i testi prodotti in serie dai modelli. E AI slop si è attaccato subito perché descrive la consistenza prima del contenuto: qualcosa di uniforme, versato, senza pezzi riconoscibili e autentici dentro. Della metà che riguarda chi scrive, cioè della voce che si perde un aggettivo alla volta, ho già detto la mia. Qui mi interessa l’altra metà: chi legge, chi paga il conto e chi mette la firma sotto al pezzo.

Un testo scritto senza un giudizio

L’AI slop non si riconosce dagli errori, perché di errori spesso non ne ha. Anzi, se ci fossero degli errori forse sarebbe umano. Si riconosce dal fatto che, tolta la superficie, quella delle parole ben strutturate e delle frasi ben formattate, dentro non c’è nessun giudizio, nessuna idea che qualcuno abbia sentito come propria, e nessun punto in cui l’autore avrebbe potuto sbagliare.

Un testo scritto da qualcuno porta con sé i segni di quello che ha buttato via (le scelte di non dire cose, per capirci), e il segno più affidabile è l’obiezione rimasta dentro senza risposta, quella che l’autore non sapeva chiudere e non se l’è sentita di far sparire. Lo slop di obiezioni aperte non ne ha. Non ha rinunciato a niente, dice tutto il dicibile sull’argomento, e lascia chi legge esattamente dove l’ha preso.

Per questo supera i controlli di qualità: la leggibilità è alta e i fatti a volte sono pure giusti. Manca la ragione per cui quel testo esisteva.

Nessuno si sveglia la mattina con l’intenzione di produrre slop

Il modello fa esattamente quello per cui è costruito: la continuazione più probabile, poi limata per piacere a chi legge. Il risultato ha una forma precisa, simmetrica, chiusa bene, e quella forma è la media di tutto ciò che era già stato scritto sull’argomento. I tic che ormai riconosciamo tutti, il trattino lungo, le frasi che pesano tutte dodici parole, le triadi che suonano incisive, le chiusure che riassumono il paragrafo appena letto, sono l’impronta di quella media.

C’è però una causa che pesa più del modello, ed è l’incentivo di chi pubblica. Produrre un testo è passato da ore a secondi, la pressione a pubblicare è rimasta identica, anzi è cresciuta, perché il calendario editoriale, il posizionamento, la presenza sui canali chiedono volume e il volume adesso è gratis. Per secoli la quantità di testo è stata una misura indiretta della fatica di qualcuno, e quella misura ha smesso di funzionare in diciotto mesi.

Poi c’è l’ultimo anello: la catena che andava dall’autore al lettore aveva in mezzo qualcuno che leggeva prima. Un direttore, o anche solo il collega scocciato che ti diceva che non si capiva niente. Quella figura è saltata quasi ovunque, e il primo lettore di gran parte di quello che circola è il destinatario finale.

Scriverlo costa zero, leggerlo costa come prima

La lettura è ferma dov’era. Duecento parole al minuto scarse, un limite che nessun aggiornamento software sposta, e un’attenzione che rimane la risorsa più rigida che abbiamo.

L’economista George Akerlof, nel 1970, descrisse il mercato delle auto usate: quando il compratore non riesce a distinguere prima dell’acquisto un’auto buona da un bidone, offre a tutti un prezzo medio, i venditori onesti si ritirano perché quel prezzo non copre la qualità, e sul mercato sopravvivono i bidoni. Vinse un Nobel per aver spiegato come l’asimmetria informativa distrugga un mercato dall’interno.

Con i testi il prezzo è l’attenzione. Il lettore che si è preso tre fregature di fila abbassa l’offerta su tutti, comincia a scorrere invece di leggere, e apre ogni pagina con una domanda in sottofondo che riguarda chi l’ha scritta. Il sospetto diventa l’impostazione predefinita, e i primi a pagarlo sono i testi onesti, che adesso devono dimostrare di esserlo prima ancora di essere letti.

C’è un secondo giro, più lento e più preoccupante. I modelli imparano da ciò che trovano scritto in giro, e ciò che trovano scritto in giro è prodotto in quota crescente da altri modelli. Fotocopia di fotocopia: ogni passaggio perde le code della distribuzione, cioè le voci rare, gli usi strani, le formulazioni che nessun altro avrebbe scelto. Stiamo dando in pasto ai modelli la loro stessa broda.

L’AI slop dentro i documenti che decidono

Fuori dal feed la faccenda si fa seria. In azienda i testi non servono a intrattenere, servono a far prendere decisioni, e la forma tipica è la nota di quattro pagine che circola il giorno prima di un consiglio, quando nessuno ha più il tempo di verificarla.

Un documento generato ha la forma dell’analisi, con il linguaggio di chi i dati li ha guardati davvero e la cautela messa nei punti in cui serve cautela. Il rischio grosso non arriva dall’errore fattuale, che prima o poi qualcuno scopre, arriva dalla fluidità che copre l’assenza di ragionamento, perché un testo che scorre bene viene approvato più in fretta di uno che inciampa e obbliga a fermarsi.

E poi c’è la domanda che faccio sempre quando mi trovo davanti a un documento del genere: chi risponde di questa frase, se tra otto mesi si rivela sbagliata? Nei sistemi con più agenti che lavorano insieme la questione è la stessa, e l’ho già affrontata parlando di chi decide quando due agenti non sono d’accordo: il criterio che nessuno ha messo per iscritto finisce comunque dentro il processo, solo che nessuno l’ha deliberato.

Le organizzazioni che riempiono di AI slop la propria documentazione accumulano debito cognitivo. Producono più pagine di quante ne sappiano difendere, e il conto arriva quando qualcuno le contesta, di solito in una due diligence o davanti a un’autorità. Vale anche qui la regola del mercato dei bidoni, applicata all’interno: quando i lettori interni smettono di distinguere i documenti che contengono lavoro da quelli che contengono forma, smettono di leggerli sul serio, e la produzione documentale diventa un rito.

Superare l’audit e non dire niente

Ogni cosa che pubblico passa da uno script che conta i trattini lunghi, le triadi, le frasi tutte della stessa misura, le formule che fingono sincerità. Lo uso da mesi e ho imparato una cosa che all’inizio mi ha infastidito: serve meno di quanto pensassi.

Un testo può superare l’audit e continuare a essere slop. I tic sono l’impronta digitale, il reato è un altro. Togli i trattini, spezzi le simmetrie, allunghi due periodi e accorci gli altri, e ottieni un testo medio travestito da testo personale. È lavaggio, e se ne vede sempre di più, perché la caccia ai tic è diventata a sua volta un prompt.

L’unica verifica che non si automatizza è anche la più scomoda, e consiste nel chiedersi cosa si è tolto: quale frase, tra quelle che il modello aveva proposto e che suonavano bene, è stata buttata perché non ci credevo. Se la risposta è nessuna, quel testo è slop anche con lo script a zero, e il fatto che sia gradevole peggiora la situazione invece di migliorarla.

L’ordine in cui si fanno le cose

Lavoro con questi strumenti tutti i giorni e non ho nessuna intenzione di smettere, quindi la domanda pratica diventa dove metterli nella sequenza. La differenza tra un pezzo mio e uno slop sta quasi tutta lì, nell’ordine delle operazioni, molto più che nella quantità di AI che c’è dentro.

Prima la tesi. Non apro la chat per scoprire cosa penso di un argomento, ci arrivo con una frase che sono disposto a difendere, anche brutta, anche mal messa. Se quella frase manca, il modello riempirà il vuoto con la media di ciò che esiste, e la riconoscerò tardi.

Poi il modello come avversario. Gli chiedo dove ho torto e quale obiezione mi farebbe la persona più competente della stanza. Usato come ghostwriter produce slop, usato come sparring partner mi tira fuori obiezioni che da solo non mi sarei fatto, e quelle obiezioni cambiano il pezzo.

Delego volentieri la fatica meccanica, la ricerca, la verifica, il riordino. Tengo l’attrito nel punto in cui si decide cosa entra e cosa esce, perché è lì che si forma il giudizio, e un modello, di sua iniziativa, non toglie mai niente: aggiunge sempre. Scriviamo con le stesse parole con cui pensiamo, e la pelle digitale tra noi e le macchine si forma lì, molto prima che in qualsiasi interfaccia.

Alla fine metto il nome sotto. Prima di pubblicare mi chiedo se difenderei quel testo in una stanza con dieci persone che ne sanno più di me, e se la risposta è no lo riscrivo o lo butto. Non è un problema di stile, è un problema di responsabilità: lo slop è quello che resta sulla pagina quando nessuno se ne assume nessuna.

Per secoli un testo ben fatto costava tempo, e proprio per questo funzionava come segnale di competenza. Adesso costa niente e non segnala più niente, il che spiega perché tanti mestieri che si reggevano su quel segnale si sentano il pavimento cedere sotto.

Akerlof indicava anche la via d’uscita dal mercato dei bidoni, e non passava dalla capacità del compratore di riconoscere la merce buona: passava dalla garanzia, cioè da qualcuno che accetta di rispondere del prodotto anche dopo averlo venduto. Vale per le auto usate e vale per i testi. La cosa scarsa, da qui in avanti, sarà qualcuno disposto a mettere la faccia sotto una frase e a risponderne quando viene contestata. Le aziende che avranno tenuto in casa persone capaci di scrivere una pagina difendibile scopriranno di avere un vantaggio che non avevano messo a bilancio, e lo scopriranno nel momento peggiore, che è sempre quello in cui i vantaggi si contano.

Chi decide quando due agenti AI non sono d’accordo

Al tavolo di un cliente, qualche settimana fa, la riunione si è fermata su una domanda che non era tecnica. Avevano due agenti AI quasi pronti, uno che istruisce le pratiche e uno che interroga i sistemi di rischio, e a un certo punto qualcuno ha chiesto cosa succede quando il secondo contraddice il primo. Il silenzio che è seguito non era imbarazzo. Quella regola non stava scritta da nessuna parte nemmeno per le persone che facevano lo stesso identico lavoro il giorno prima, e per quindici anni era bastato così, perché c’era un capo servizio che la teneva in testa e la applicava caso per caso, con criteri che nessuno gli aveva mai chiesto di dettare.

Da un paio d’anni ripeto una cosa che sembra ovvia e nella pratica non lo è mai: mettere più modelli linguistici dentro lo stesso spazio computazionale non produce da sé né i benefici né i rischi. Li produce il modello di coordinamento che gli diamo, e quel modello va scritto, in forma esplicita, con protocolli, criteri, autorità. Attendersi che il valore emerga da solo da un collettivo di macchine è la versione tecnologica della speranza che un’orchestra suoni bene perché i musicisti sono bravi.

La parte scomoda arriva subito dopo: progettare un modello di coordinamento presuppone che da qualche parte, in azienda, ce ne sia già uno leggibile da cui partire, e quasi nessuna organizzazione ce l’ha.

Il collettivo di agenti AI eredita quello che trova

Un sistema di agenti AI messo in produzione dentro un’azienda non arriva su una tabula rasa, si innesta sul modo in cui quell’azienda coordina già le proprie persone. Dove quel modo è esplicito, e capita nelle filiere regolate, nella logistica, in parte della sanità, gli agenti trovano un substrato: chi ha l’ultima parola su cosa, quale eccezione va scalata a chi, entro quanto, con quale traccia. Il collettivo computazionale eredita una grammatica e ci si appoggia.

Dove invece il coordinamento vive nella testa di sette persone anziane e in una manciata di chat, non c’è niente da ereditare. E quel vuoto lo riempie chi integra, il martedì pomeriggio, con la scelta di implementazione che gli sembra più ragionevole in quel momento. È così che il modello di coordinamento di un’impresa finisce dentro un file di orchestrazione senza che nessuno l’abbia mai deliberato, e senza che nessuno se ne accorga finché non arriva la prima contestazione seria.

Avevo affrontato la stessa questione dal lato del significato quando scrivevo di ontologia come infrastruttura invisibile: lì il problema era che un agente non sa cosa vuol dire “cliente attivo” se l’azienda non l’ha mai definito. Qui il problema è gemello e sta un piano sopra, perché anche sapendo cosa significa un ordine bisogna ancora stabilire chi può agire su di esso, e chi può fermare l’altro.

Quando il protocollo fra due uffici non esiste

Di questi progetti il pezzo più utile matura molto prima della messa in produzione, e non ha niente di tecnologico. Provare a scrivere il protocollo di coordinamento fra due agenti AI costringe a scoprire che non esisteva nemmeno fra due uffici.

Nelle sessioni di assessment che conduco succede quasi sempre lo stesso movimento: si parte con la domanda su quale modello usare, si finisce a ricostruire chi ha l’autorità di annullare una decisione presa da qualcun altro, e quanto vale quell’autorità dopo che la decisione è già stata comunicata al cliente. Sono domande di governance che l’azienda si porta dietro irrisolte da anni, tollerabili finché a coordinare erano persone che si conoscono e si telefonano, insostenibili nel momento in cui il coordinamento passa a un collettivo di agenti AI che esegue e basta.

Su questo tema ho una posizione che ripeto da un po’: la vera unità di misura di un agente non è quello che sa fare, è il permesso revocabile sotto cui lo fa. La maturità di un’organizzazione cognitiva si misura sulla capacità di dire, per ciascun agente in circolazione, chi gliel’ha concesso, fino a quando, e con quale gesto glielo si toglie.

La gavetta era il posto dove passava il criterio

C’è una trasformazione che vedo sottovalutata quasi ovunque, e riguarda l’apprendimento. Questi sistemi si sono messi in mezzo fra le persone e la conoscenza di come si fanno le cose, e il primo posto dove si sono infilati sono i compiti di gavetta, quelli che nelle organizzazioni funzionavano da palestra per chi comincia. Una generazione intera rischia di perdere le occasioni di imparare che tutte le precedenti hanno avuto.

Dal mio tavolo si vede bene una cosa in più. La gavetta non serviva solo a formare chi la faceva. Era il momento in cui il criterio implicito veniva tirato fuori dalla testa del senior e messo in parole, malamente, di corsa, davanti a una pratica sbagliata da rifare, e in quell’attrito il criterio si riformulava ogni volta un po’ diverso e un po’ più preciso. Toglila di mezzo e non perdi soltanto il canale di trasmissione verso i giovani, perdi la sola occasione in cui l’azienda si spiegava a voce alta come funziona.

È il debito cognitivo nella sua forma meno visibile: non si accumula quando deleghiamo l’esecuzione, si accumula quando deleghiamo l’occasione di dover spiegare. Sulla superficie di contatto fra noi e le macchine si decide ogni giorno cosa passa e cosa no, e continuo a pensare che la parte da tenere di qua sia proprio quella, il momento in cui qualcuno è costretto a dire perché.

Governare uno strumento, non attendere un’entità

Nelle conversazioni con i board torna spesso l’idea, che si associa di solito a Nick Bostrom, dell’intelligenza artificiale come ultima invenzione che l’umanità dovrà fare, quella che poi risolverà i problemi troppo grandi per noi. È una formula che semplifica parecchio, e soprattutto colloca l’AI in una zona fuori portata, dove le decisioni le prende lei e a noi tocca aspettare l’esito.

Trovo che la cornice messianica, in azienda, faccia un danno preciso e poco spettacolare. Se l’AI è un destino, la cosa sensata da fare è aspettare, magari fare un pilota per dire che ci si sta muovendo, e rimandare. Se invece è uno strumento, la cosa sensata da fare è noiosa e comincia lunedì: scrivere il protocollo, assegnare le autorità, decidere dove gira il calcolo e con quali termini, verificare di poterli revocare. La narrazione dell’entità super intelligente è comoda perché sposta la responsabilità dal consiglio di amministrazione a un futuro indeterminato.

Della sovranità digitale ho parlato spesso come di una questione di infrastruttura, e lo è, ma la sua metà meno raccontata sta qui: sovrano è chi ha scritto le regole con cui i propri agenti AI si parlano e può cambiarle senza chiedere il permesso a un fornitore, molto più di chi si limita a ospitarli dentro il proprio perimetro.

Chi scrive il protocollo

La domanda più fastidiosa arriva alla fine, ed è chi materialmente questo lavoro lo fa. Il vendor porta un default ragionevole, calibrato su mille clienti diversi dal tuo, e non può fare altrimenti. L’integratore chiede le regole all’azienda e si vede consegnare un documento di processo del 2019 mai più aggiornato. All’IT da solo non si può lasciare, perché le regole di coordinamento fra agenti AI sono decisioni di business travestite da configurazione.

Nelle poche organizzazioni dove ho visto funzionare, il protocollo l’hanno scritto le persone che il lavoro lo fanno, sedute in una stanza per settimane, con qualcuno che faceva domande scomode e trascriveva. Costa parecchio e non produce nessuna demo da mostrare in comitato. Ed è l’unica parte del progetto che l’azienda si tiene anche se cambia modello, fornitore e architettura tre volte in cinque anni.

Se davvero l’era agentica ci obbliga a mettere per iscritto come coordiniamo il lavoro, allora l’effetto più duraturo dell’AI in azienda potrebbe non avere niente a che fare con le macchine, e riguardare il fatto che per la prima volta molte imprese saranno costrette a leggere ad alta voce come funzionano davvero. Vediamo quante reggono la lettura.

Il permesso, non solo il significato: dove finisce l’ontologia e comincia l’agente

Il 16 agosto Fanghua Yu ha pubblicato su Medium una mappa dell’evoluzione dell’ontologia che mi ha tenuto incollato allo schermo più a lungo di quanto i suoi dodici minuti dichiarati di lettura lascino immaginare. La tesi è semplice da enunciare, meno da digerire: un’ontologia non serve più a un solo tipo di sistema, e la definizione che bastava a un reasoner logico negli anni Novanta non è la stessa che serve oggi a un agente chiamato ad autorizzare un rimborso.

Di cosa sia un’ontologia, e di chi debba possederne il significato dentro un’azienda, ho già scritto su ontologie e grafi di conoscenza e su governare il significato. Quella domanda resta in piedi, e qui non la riapro. Quello che il pezzo di Yu mette a fuoco, e che i due articoli precedenti lasciano fuori campo, è cosa succede quando il significato smette di dover reggere una query e comincia a dover reggere un’azione autonoma. Con conseguenze che, a leggerle bene, portano dritte al concetto che uso per definire i limiti operativi di un agente: il permesso revocabile.

Il grafo impone la sua logica

Yu parte da un’osservazione che in trent’anni di ontologia formale nessuno aveva mai dovuto affrontare seriamente: nel momento in cui l’ontologia diventa lo schema che regge un grafo di conoscenza operativo, la domanda smette di essere solo “qual è la rappresentazione più fedele del dominio” e comincia a essere anche “quale struttura del grafo serve davvero alle applicazioni che ci devono girare sopra”.

L’esempio che porta è chirurgico. Rappresentare un acquisto come Cliente → ha piazzato → Ordine → contiene → Riga d'ordine → si riferisce a → Prodotto preserva tutta la struttura transazionale, quantità, prezzi, date. Un motore di raccomandazione, però, ha bisogno molto più spesso di un salto diretto: Cliente → ha acquistato → Prodotto. Quella relazione si può derivare dal percorso lungo, e da un punto di vista puramente formale materializzarla sembra ridondante. Dal punto di vista di chi deve rispondere in pochi millisecondi a “cosa comprano insieme a questa fotocamera”, è tutt’altro che superfluo.

Stesso dato, due priorità diverse: la fedeltà semantica conta i salti, il traversal operativo li taglia.

Il knowledge graph, scrive Yu, trasforma l’ontologia da modello del significato ad architettura di navigazione. E qui l’idea di un’unica ontologia “migliore in assoluto” comincia a scricchiolare, perché un modello semanticamente preciso introduce astrazioni e percorsi lunghi che aiutano il ragionamento ma appesantiscono le query, mentre un grafo ottimizzato per le prestazioni appiattisce distinzioni e duplica relazioni derivate per convenienza operativa. Non è un dettaglio da architetti di dati: è la prima cucitura visibile tra due mestieri che fino a ieri si pensavano identici.

Dal significato alla decisione

Il passaggio dove mi fermo di più, per me, comincia dove Yu smette di parlare di ragionamento semantico e comincia a parlare di decisione. L’ontologia, scrive, ha sempre avuto una capacità di inferenza, con l’OWL un reasoner deriva da Smartphone ⊆ Prodotto Elettronico e Prodotto Elettronico ⊆ Prodotto che Smartphone ⊆ Prodotto, pura logica di classe. Ma un sistema aziendale oggi deve rispondere a domande più larghe: dato quello che sappiamo, quale logica si applica, perché è successo, cosa potrebbe succedere, cosa dovremmo fare.

Dal significato alla decisione: quattro strati con compiti diversi, non uno che li assorbe tutti.

Yu propone una separazione che trovo più utile di qualunque tentativo di far fare tutto all’ontologia da sola. L’ontologia definisce cosa significa “cliente premium” o “prodotto ingombrante”, e resta relativamente stabile nel tempo. Le regole applicano quel significato alla logica del momento: se il cliente è premium, l’ordine supera i cento euro, la destinazione è servita e non ci sono prodotti ingombranti, allora si offre la consegna espressa gratuita. I modelli causali rappresentano ipotesi su cause ed effetti, non correlazioni: se il tasso di reso aumenta e la causa è la qualità di un fornitore, cambiare fornitore dovrebbe abbassarlo, ammesso che l’ipotesi regga alla prova. I modelli decisionali, infine, combinano prove e alternative per stabilire quale azione prendere.

La distinzione conta perché smette di chiedere all’ontologia di fare un lavoro che non le compete. Un’azienda italiana che lavora su una filiera manifatturiera lo sa bene quando vede aumentare i resi su una linea di prodotto: il grafo di conoscenza può mostrare la correlazione con un fornitore, ma solo un modello causale, testato e falsificabile, può dire se cambiare quel fornitore abbasserebbe davvero il tasso di reso o se la correlazione nasconde una terza variabile, magari il periodo dell’anno o il canale di vendita. Confondere i due piani è il modo più rapido per prendere decisioni sbagliate con sicurezza matematica.

Il permesso, non solo il significato

Ed eccoci al punto che, letto da chi lavora tutti i giorni con architetture agentiche, cambia registro rispetto al resto del pezzo. Un sistema tradizionale, anche generativo, legge, recupera, riassume, spiega. Un agente interpreta per agire. La differenza non è cosmetica.

Prendi una richiesta banale: “le cuffie che ho comprato la settimana scorsa sono difettose, sostituiscile con il modello nuovo”. Un agente che la esegue deve trovare l’ordine, identificare l’articolo, capire quale politica di reso si applica, verificare la disponibilità del ricambio, calcolare l’eventuale differenza di prezzo, creare l’ordine sostitutivo, generare l’etichetta di reso, emettere o richiedere un rimborso. A quel punto un fraintendimento sul significato di “cliente” o di “reso” non è più un problema di qualità dell’informazione. È un’azione sbagliata, con soldi e merce che si muovono davvero.

Yu chiama questo passaggio “operational semantic contract”, un contratto semantico operativo che lega concetti, relazioni, dati autorevoli, capacità disponibili, precondizioni, policy, evidenze richieste ed effetti attesi. È un vocabolario tecnico corretto. Preferisco però nominarlo con una parola che uso da tempo per la stessa idea, perché la rende immediatamente operativa in una conversazione con un board: permesso revocabile.

Il permesso non è un interruttore acceso o spento. È una funzione delle precondizioni, delle evidenze raccolte e della reversibilità dell’azione.

Un agente che sa cos’è un ordine ma non sa se è autorizzato a rimborsarlo conosce metà della storia. Le precondizioni gli dicono cosa deve essere vero prima che l’azione sia valida. Le policy gli dicono cosa può fare, non solo cosa sa fare, ed è una distinzione che nell’harness engineering, di cui ho scritto qui, diventa architettura concreta, non principio astratto. Le evidenze gli dicono quali prove raccogliere prima di premere il grilletto. Gli effetti gli dicono cosa cambia davvero, in quale sistema, se l’azione riesce. E la reversibilità decide quanto in alto deve stare l’asticella dell’autorizzazione: un’azione che si può disfare con un clic merita meno attrito di una che non si può disfare affatto.

Questo è il cuore del permesso revocabile applicato alla semantica: non basta che l’agente capisca cosa significa “ordine” o “rimborso” nel vocabolario dell’azienda. Deve sapere, prima di agire, se quel permesso specifico è ancora valido in quel momento, con quelle evidenze, per quella azione, e se può essere ritirato nel momento in cui qualcosa cambia. Un’ontologia che descrive solo cosa esiste, senza descrivere cosa un agente è autorizzato a fare con ciò che esiste, prepara il terreno a errori che nessun modello linguistico, per quanto capace, può correggere da solo.

Quando capire male diventa agire male

Yu arriva a una conclusione che condivido fino in fondo: quando un sistema si limita a leggere e spiegare, una semantica confusa produce al massimo una risposta confusa, ma quando un sistema agisce da solo, la stessa confusione si traduce in una decisione presa male e in un’azione reale, con soldi o merce che si muovono sulla base di un errore. Questo salto, da capire male a fare male, è la ragione per cui la modellazione semantica smette di essere un esercizio da specialisti isolati e diventa una competenza condivisa tra chi disegna i grafi, chi costruisce i modelli decisionali, chi progetta gli harness degli agenti e chi conosce il dominio dall’interno.

Non credo che il futuro sia un’unica ontologia perfetta capace di servire reasoner, grafi, motori decisionali e agenti con la stessa struttura. Credo, e qui la lettura di Yu mi conferma più che convincermi, che il lavoro sia costruire un’architettura semantica coerente, dove ontologie, grafi, regole, modelli causali e contratti operativi lavorano insieme senza pretendere che uno solo di questi livelli assorba il compito degli altri. E dove, ogni volta che un agente riceve la possibilità di agire, quella possibilità porti con sé la domanda che conta più di ogni definizione: chi può revocarla, e in base a cosa.


Spunto da The Evolution of Ontology: From Formal Semantics to Knowledge Graphs, Decisions and AI Agents di Fanghua (Joshua) Yu, pubblicato su Medium il 16 agosto 2026.