L’ontologia che ti lascia cancellare un ordine
Il cruscotto dice che l’ordine 4471 è fermo da sei giorni. Lo guardano il direttore commerciale, il customer care e da qualche mese anche l’agente che presidia gli SLA, tutti sulla stessa dashboard, tutti con lo stesso numero davanti. Per cancellarlo qualcuno deve aprire il gestionale, cercare la riga a mano e sapere che un ordine già uscito dal magazzino non si annulla, si gestisce come reso.
Quella distanza fra il livello dove guardi e il livello dove agisci è il residuo di dieci anni di piattaforme dati. Abbiamo costruito data lake, poi lakehouse, poi semantic layer, e ci siamo ritrovati un’azienda che si vede benissimo e che continua a muoversi dentro i sistemi sorgente, ognuno con le sue regole, scritte in epoche diverse da persone che non si sono mai parlate.
Il primo agosto un ingegnere che firma gura105 ha pubblicato su dev.to il risultato di settimane passate a smontare Palantir Foundry per capire cosa sia davvero quella cosa che in Palantir chiamano Ontology. Ne ha ricavato un nome, ontologia operativa, e quattro proprietà che si possono verificare una per una su qualunque sistema. Poi ha messo su GitHub un’implementazione di riferimento in TypeScript, licenza MIT, piccola abbastanza da leggersi in una sera, con il README anche in giapponese.
Il modello di dominio fuori dall’applicazione
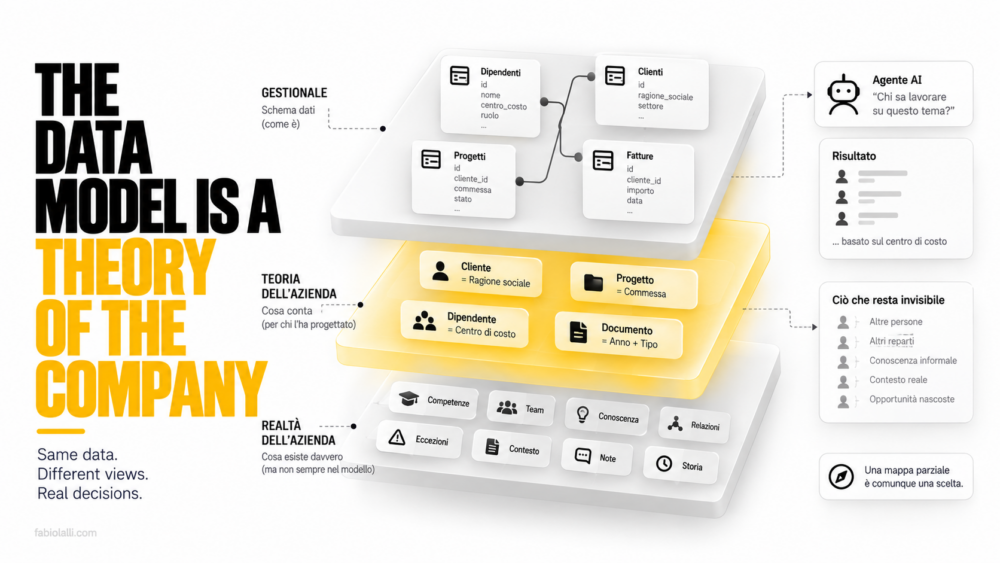
Lo sviluppo di un’applicazione gestionale funziona da sempre nello stesso ordine: raccogli i requisiti, modelli il dominio, crei le tabelle che quel modello richiede, ci costruisci sopra l’applicazione. Foundry, scrive gura105, è quello stesso mestiere eseguito al contrario. I dati fisici esistono già, sono di qualcun altro, nessuno te li ha disegnati addosso, e il modello di dominio arriva dopo, sopra, come strato condiviso da cui pescano tutte le applicazioni. Un’ontologia operativa nasce esattamente da qui, dal prendere atto che i dati non li ha ordinati nessuno per te e che il modello va costruito sopra quello che c’è.
Il rovesciamento sembra un dettaglio di sequenza ed è una scelta di proprietà. Nel modo classico le regole di business vivono dentro l’applicazione che possiede le tabelle, e ogni altro consumatore o le riscrive per conto suo o le scavalca. Chi ha già lavorato su un’integrazione fra CRM e gestionale sa esattamente di cosa parlo: la regola che un ordine spedito non si cancella esiste in tre punti diversi, formulata in tre modi diversi, e almeno uno dei tre è sbagliato.
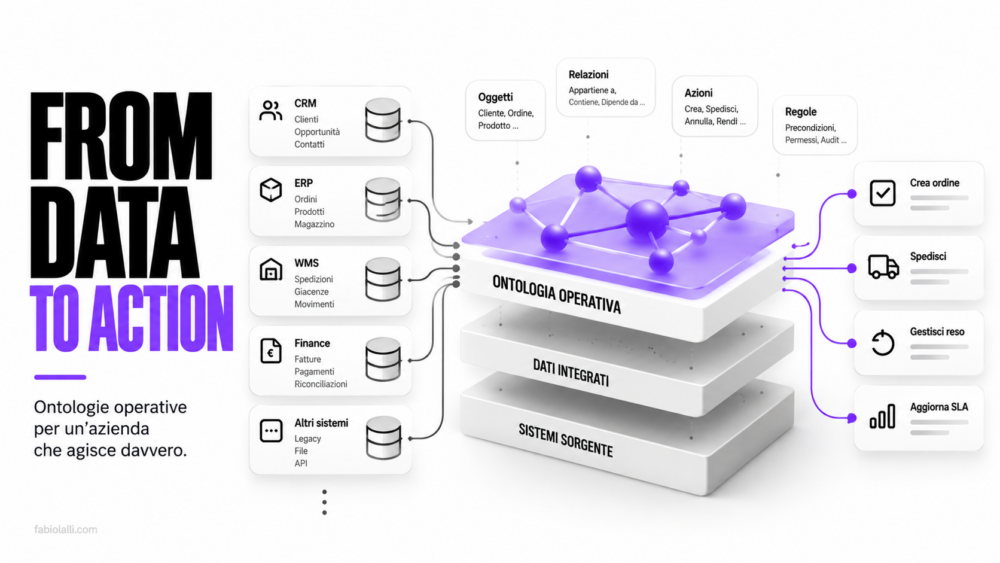
Palantir descrive la sua Ontology come un livello operativo dell’organizzazione che sta sopra gli asset digitali integrati nella piattaforma, e la divide in elementi semantici, cioè oggetti, proprietà e relazioni, ed elementi cinetici, cioè azioni, funzioni e sicurezza dinamica. La parte semantica la conosciamo tutti, è quella di cui ho scritto parlando di ontologie e grafi di conoscenza. La parte cinetica è quella che nessun semantic layer ha mai avuto, e coincide con il motivo per cui Foundry costa quello che costa.
C’è un vantaggio pratico in questa inversione, ed è il motivo per cui la trovo adatta alle aziende italiane più di quanto sembri. Non chiede di migrare niente. Il gestionale del 2011 resta dov’è, con la sua teoria implicita dell’azienda scritta da un consulente che non c’è più, e sopra ci metti un modello che dice cosa significano davvero cliente, ordine e prodotto oggi, senza toccare una riga di quelle tabelle.
Un semantic layer non cancella un ordine
Le quattro proprietà che fanno di un sistema un’ontologia operativa sono un test, non una certificazione, e gura105 le ha scritte in modo che siano verificabili guardando il comportamento di quel sistema invece che la sua brochure.
La prima chiede che oggetti e relazioni siano modellati esplicitamente sopra dati fisici che esistevano prima e che appartengono ad altri. La seconda chiede che lo stato cambi solo attraverso azioni con un nome, senza nessun percorso di aggiornamento generico, né per l’utente né per l’applicazione né per l’agente. La terza chiede che le regole di dominio stiano dentro l’azione, come precondizioni che rifiutano le violazioni con errori leggibili da una macchina, e che ogni tentativo finisca nel registro, compresi quelli respinti. La quarta chiede che il modello dichiari, per ogni pezzo di stato, quale sistema ne è proprietario, e che le modifiche tornino indietro verso quel sistema.
Il test che le riassume sta in una domanda da fare in riunione, dal vostro semantic layer si può cancellare un ordine? Se la risposta è no, avete un livello di lettura, che è una cosa utile e diversa. Se è sì ma nessuna riga cambia in nessun sistema di record, avete un database parallelo che fra sei mesi diverge dal gestionale e nessuno saprà quale dei due ha ragione. Se cancella anche gli ordini già spediti senza fare una piega, avete una write API, e la terza proprietà è tutta la differenza.
Lo scenario del demo è volutamente banale, ed è per questo che funziona. Un’azienda ne compra un’altra e si ritrova due sistemi ordini legacy, schemi diversi, codifiche di stato diverse, la solita eredità che in Italia conosciamo bene dopo ogni operazione straordinaria. Qualche decina di righe di SQL li integra, l’ontologia modella sopra cliente, ordine e prodotto, e aggiunge un tipo che in nessuno dei due sistemi esiste: la nota. Poi il demo attraversa la relazione per rispondere a quali ordini contengono un certo prodotto pescando da entrambi i sistemi, assegna un ordine a una persona scrivendo uno stato che nel legacy non ha nemmeno una colonna, si vede rifiutare la cancellazione di un ordine spedito, ne cancella uno aperto e la riga nell’ERP cambia davvero, poi ricarica le sorgenti e l’assegnazione sopravvive al refresh.
Dal permesso revocabile all’azione che lascia traccia
Ad agosto, commentando la mappa di Fanghua Yu sull’evoluzione dell’ontologia, avevo chiamato permesso revocabile quello che lui chiamava contratto semantico operativo: un agente che sa cos’è un ordine ma non sa se è autorizzato a rimborsarlo conosce metà della storia, e la parte che gli manca è fatta di precondizioni, evidenze, effetti e reversibilità. Quel pezzo si fermava dove finiva il concetto. Questo repository è il primo posto dove lo vedo messo in codice eseguibile, con i rifiuti che portano un codice e il registro che si scrive da solo.
Nel modello, le precondizioni sono una chiave obbligatoria. Una lista vuota va dichiarata, perché scrivere che un’azione non ha condizioni è una decisione che qualcuno deve prendersi, non un default che si eredita per distrazione. La dichiarazione di proprietà segue la stessa logica: ogni pezzo di stato è di qualcuno, e le possibilità sono tre. Quando il dato è mastered a monte, come lo status dell’ordine che vive nell’ERP, la modifica torna indietro verso quel sistema come effetto collaterale governato, e la sorgente conserva l’autorità. Per l’assegnatario o la nota di triage, che nel legacy non hanno nemmeno una colonna dove stare, il sistema di record diventa l’ontologia stessa, per dichiarazione esplicita e non per ripiego. Il terzo caso è lo stato calcolato, che non si scrive mai.
Quello che la proprietà vieta è lo stato senza padrone dichiarato, cioè la copia locale di un dato altrui che viene modificata e non torna mai indietro. È esattamente la situazione in cui si trovano parecchi progetti di data platform che ho visto passare sui tavoli negli ultimi anni, e che nessuno chiama con il suo nome finché non arriva la prima riconciliazione a mano.
Il runtime non si fida delle dichiarazioni, le verifica. Prima di eseguire qualunque azione valida i parametri, valuta le precondizioni, genera il piano di modifiche, lo prova a vuoto passando dallo stesso codice che userà per il commit, poi lo confronta con le dichiarazioni di proprietà e lo rifiuta se un’azione tocca stato del sistema di record senza averlo dichiarato, oppure se ne mescola due tipi nello stesso piano. Solo dopo scrive verso la sorgente, e solo alla fine committa le modifiche e la riga di registro in un’unica transazione.
L’ordine di quei passaggi porta con sé una scelta che va guardata bene. Il write-back gira prima del commit locale, quindi se l’ERP rifiuta non cambia niente da questa parte. Il fallimento opposto può comunque accadere: la sorgente accetta, il commit locale fallisce, i due sistemi divergono e la riconciliazione tocca a un essere umano. Il repository lo scrive in chiaro e aggiunge che la documentazione di Palantir ammette lo stesso buco nella propria modalità di write-back. Quella franchezza sul limite, per me, vale più di metà delle slide di architettura che mi capita di leggere, e andrebbe usata come criterio per valutare chiunque venda qualcosa di simile.
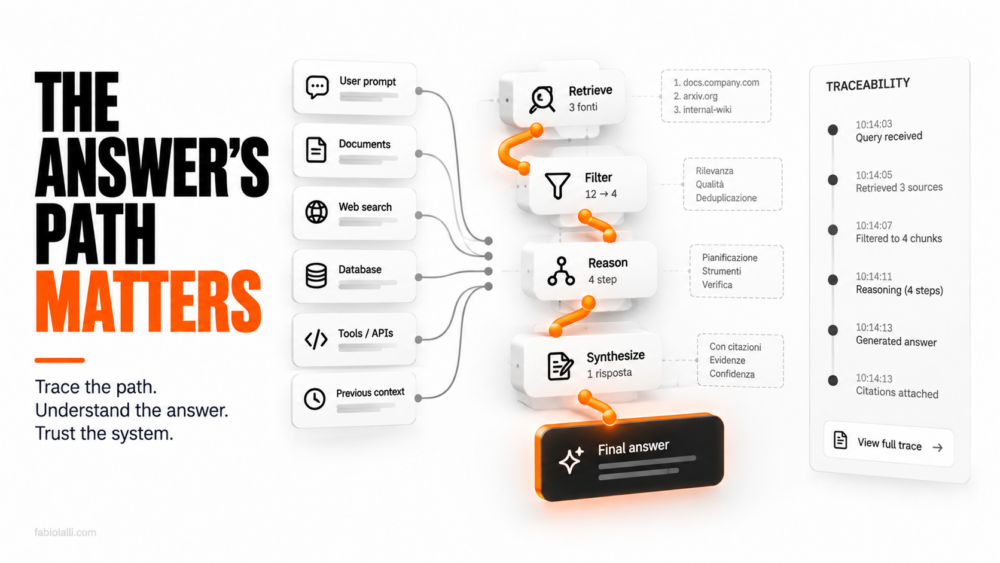
Il registro, intanto, tiene tutto: i tentativi applicati, quelli rifiutati, quelli andati in crash, con il piano completo. Sulla tracciabilità come prova di un’azione automatica torno spesso, e qui il materiale che l’AI Act chiede di saper ricostruire per i sistemi ad alto rischio, con un calendario che il Digital Omnibus ha rimesso in discussione, si produce da sé come sottoprodotto dell’architettura invece che come adempimento aggiunto dopo.
Le regole non stanno nel prompt
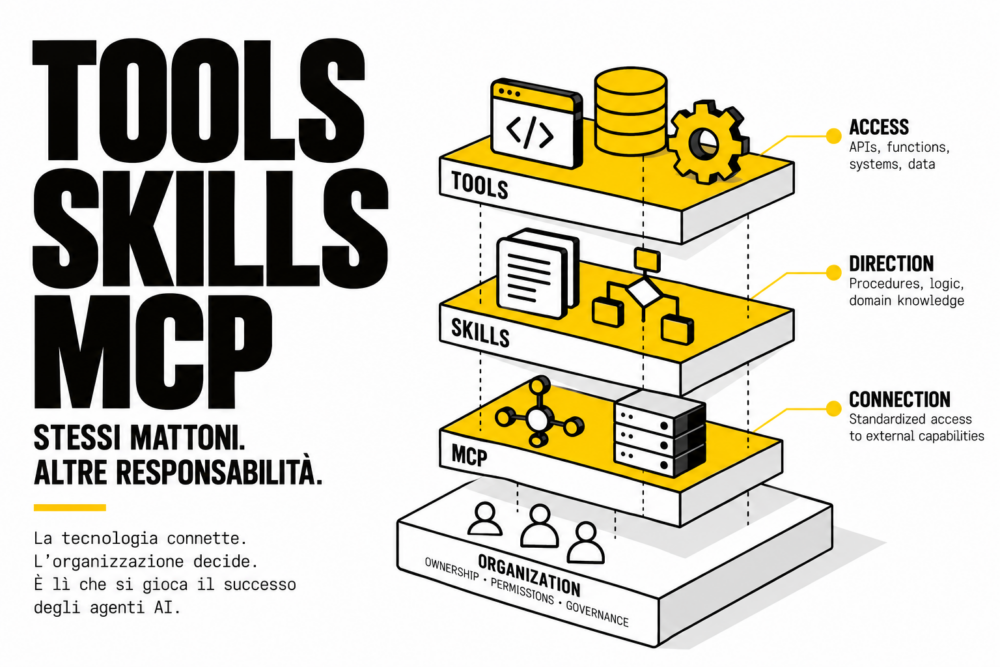
La superficie MCP viene generata dal modello. Uno strumento per ogni forma di interrogazione, uno per ogni azione, e nessuno strumento SQL grezzo, il che significa che un agente riceve esattamente le operazioni che il dominio definisce e nient’altro. Le stesse precondizioni che valgono per una persona valgono per lui, e quando prova a cancellare un ordine spedito si prende in faccia un SHIPPED_ORDER_CANNOT_BE_CANCELLED, un rifiuto che può leggere, da cui può recuperare e che può spiegare al suo utente senza inventarsi una scusa.
Vale la pena mettere in fila le alternative, perché è la scelta che in questo momento sta facendo chiunque colleghi un modello ai sistemi aziendali. Con un MCP sul database l’agente legge tabelle e scrive UPDATE senza limiti, e le regole di business stanno nel prompt, cioè da nessuna parte, perché un prompt è una raccomandazione e non un cancello. Con un semantic layer o un MCP di metriche si ottengono letture governate e nessuna scrittura. Con una collezione di wrapper API ogni endpoint applica le regole del backend che ha dietro, in modo diverso dagli altri, e la coerenza la garantisce la speranza. Con un’ontologia operativa le letture sono oggetti e relazioni, le scritture passano solo da azioni con un nome, e le regole stanno nel modello insieme al registro dei tentativi.
Su questo passaggio si gioca una partita che in Italia è appena cominciata. Nei progetti che seguo la richiesta arriva quasi sempre nella stessa forma, collegare un modello al gestionale perché sbrighi da solo le tre o quattro cose ripetitive che oggi occupano una persona a tempo pieno, e la soluzione più rapida da costruire è anche quella più difficile da difendere: un accesso diretto al database con un prompt lungo che spiega cosa non deve fare. Regge la demo, regge qualche settimana in produzione, e cade il giorno in cui un caso limite che nessuno aveva previsto incontra un modello che quella mattina interpreta la raccomandazione in modo un po’ più largo del solito.
È la stessa cosa che chiamo harness engineering quando parlo del guscio che decide se un agente regge in produzione, portata però al livello dell’azienda intera invece che del singolo workflow. Il guscio smette di essere un file di configurazione scritto da chi ha costruito quell’agente lì e diventa infrastruttura condivisa, la stessa per il cruscotto del direttore commerciale, per lo script del controllo di gestione e per il modello che presidia gli SLA.
Anche le letture portano un’identità: ogni chiamata gira per conto di un attore e le policy di visibilità attaccate al modello decidono cosa quell’attore vede, con un oggetto nascosto che è indistinguibile da uno che non esiste. Sulla parte di autenticazione il repository è disarmante: su stdio tutti i chiamanti collassano in un attore solo, il nome si passa da variabile d’ambiente, ed è etichettatura, non protezione. Dichiarare dove finisce la dimostrazione è la ragione per cui mi fido del resto.
Dove l’ontologia operativa si ferma
La versione zero ha come unico obiettivo la leggibilità, quindi le assenze sono parecchie e sono tutte elencate. Niente cancellazioni, niente proprietà sulle relazioni, niente chiavi composte, nessuna infrastruttura di indicizzazione, nessun costruttore di interfacce. Niente federazione, soprattutto: un’ontologia è un contesto delimitato, e chi possiede il modello quando ce ne sono cinque in cinque divisioni è una domanda vera che il repository dichiara di non affrontare.
L’evoluzione dello schema sta fuori per la stessa ragione, con una scelta che trovo elegante. Il modello è un valore, cioè un pezzo di codice enumerabile, quindi si diffa, si versiona e si revisiona come qualunque altro sorgente, e la governance dello schema viene delegata in blocco a git. Ne esce una separazione netta fra due canali: le istanze si governano a runtime con le azioni e il registro, lo schema si governa in fase di sviluppo con le pull request. Chi in azienda ha il potere di approvare quella pull request ha il potere di ridefinire cosa significa cliente, ed è una carica che nessun organigramma ha mai assegnato formalmente.
C’è poi un default che per un’azienda europea è sbagliato e che il repository dichiara sbagliato per sé: un oggetto senza policy è visibile a chiunque. La dimostrazione non ha autenticazione, quindi fingere di essere chiusi non avrebbe senso, e chi volesse portarlo verso un deployment reale parte dal rendere obbligatoria la visibilità e aggiunge sotto autenticazione vera, permessi sulle azioni e accesso al registro con i suoi confini.
Fuori dallo scopo c’è anche la parte che rende Foundry un prodotto da milioni di euro, cioè l’indicizzazione incrementale, gli indici di adiacenza e i backend di ricerca che servono miliardi di oggetti con tempi di risposta accettabili. Su scala dimostrativa una query ingenua basta, e l’autore lo dichiara senza giri, perché la scala appartiene alle implementazioni e non al pattern. Vale come promemoria per chi legge poche centinaia di righe di TypeScript e crede di avere in mano un sostituto: qui c’è la definizione, non il prodotto che la applica a un’azienda da ventimila persone.
Da qui esce la cosa più riutilizzabile di tutto il lavoro, e la consiglio a chi in questi mesi si trova sul tavolo offerte di piattaforme che si sono ribattezzate ontologie nel giro di un trimestre. Qualunque ontologia operativa deve dichiarare quattro cose: chi possiede ogni pezzo di stato, cosa succede quando la scrittura verso la sorgente riesce e il commit locale no, se le modifiche fatte nell’ontologia sopravvivono a un ricaricamento delle sorgenti, e cosa vede chi non ha nessuna policy addosso. Le quattro risposte possono essere diverse da quelle di questo repository e il sistema rimane dentro il pattern. Quello che non può succedere è che il fornitore non le abbia, perché senza quelle dichiarazioni il permesso revocabile di cui parliamo da mesi non ha niente a cui appoggiarsi.
La domanda che mi è venuta in mente dopo aver letto il codice non riguarda Palantir, e nemmeno la scelta fra costruire e comprare. Riguarda chi oggi dentro un’organizzazione italiana di media dimensione ha oggi l’autorità di dichiarare che lo status di un ordine appartiene all’ERP e l’assegnatario appartiene all’ontologia operativa. È una dichiarazione tecnica nella forma e una delibera nella sostanza, perché stabilisce chi può cambiare cosa e sotto quali condizioni quel permesso continua a valere, che è poi il cuore del permesso revocabile applicato ai sistemi invece che agli agenti. Prima o poi arriva sul tavolo di qualcuno che non l’ha chiesta, nel momento peggiore, sotto forma di due numeri diversi per lo stesso ordine.