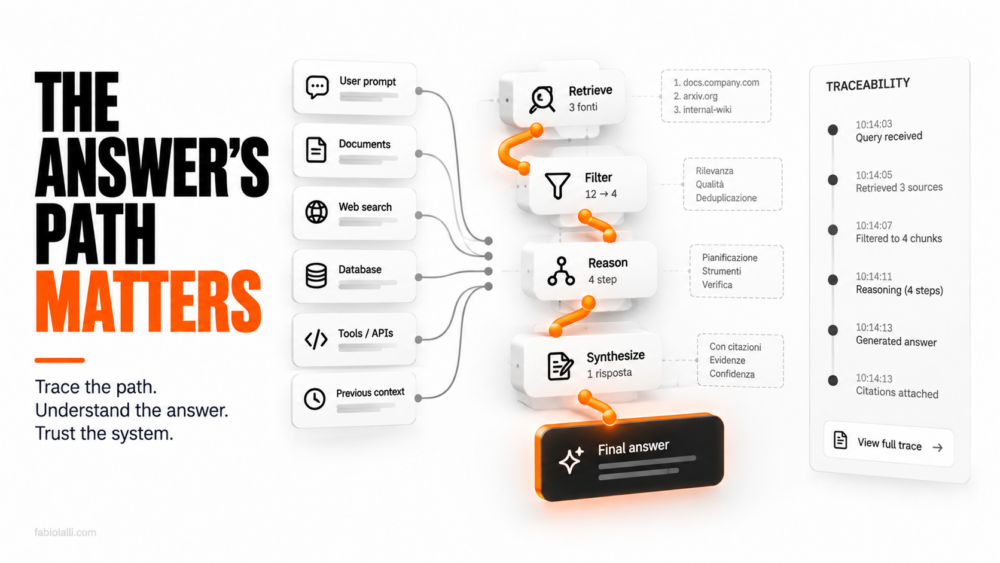
La tracciabilità di un sistema di ricerca semantica finisce prima di cominciare. Il sistema ti restituisce sei frammenti di documento e una risposta costruita su quei frammenti. Se chiedi come ci è arrivato, ottieni i punteggi di somiglianza. Sono numeri veri, calcolati su vettori, e non dicono niente che un revisore possa usare, perché la somiglianza fra due testi non è una ragione per cui una conclusione è corretta.
Un sistema che attraversa un grafo ti restituisce la stessa risposta con in più l’elenco dei passaggi che ha fatto, e quell’elenco è composto di relazioni che qualcuno ha definito e che qualcuno può contestare.
Una risposta senza itinerario
La differenza si vede quando qualcosa va storto. Nel primo caso la ricostruzione richiede di rifare l’esperimento sperando che il sistema si comporti allo stesso modo, e siccome il recupero dipende da come è stata formulata la domanda, da cosa era indicizzato quel giorno e da quale versione del modello di embedding stava girando, la riproducibilità è una speranza.
Nel secondo caso il percorso è un oggetto discreto, salvabile, confrontabile. Il cliente identificato con un certo codice, l’entità contraente collegata a quel codice, i tre contratti agganciati a quell’entità, la data presa dal campo di quel contratto, il record di origine nel sistema che lo custodisce. Se la risposta è sbagliata, l’errore sta in uno di quei passaggi, e si trova.
La tracciabilità nasce insieme all’esecuzione
Nelle architetture che vedo in giro la tracciabilità viene quasi sempre aggiunta dopo, sotto forma di registrazione delle chiamate e conservazione dei prompt. Funziona finché serve a capire cosa è stato chiesto, e smette di funzionare quando serve a capire perché la risposta era quella.
Con un grafo la traccia non va costruita, esiste come sottoprodotto dell’esecuzione. L’agente che percorre collegamenti lascia dietro di sé l’unica cosa che un revisore possa leggere senza essere un data scientist, cioè una catena di relazioni con nomi in lingua naturale. Quelle relazioni portano con sé anche i limiti di chi le ha disegnate, ed è utile leggerle sapendo che lo schema incorpora una teoria dell’azienda che nel percorso non si vede.
Quando qualcuno chiede come ci sei arrivato
L’AI Act chiede ai sistemi classificati ad alto rischio la registrazione automatica degli eventi lungo tutto il ciclo di vita, e chiede che la documentazione tecnica permetta di comprendere come il sistema produce i propri risultati. Nelle aziende con cui lavoro questi obblighi vengono affrontati come un problema di documentazione, e finiscono su un documento Word che descrive un comportamento atteso.
Un percorso salvato è una risposta diversa allo stesso obbligo, perché descrive il comportamento avvenuto, e dice insieme quali dati sono stati attraversati e con quale titolo, che è la coppia di domande intorno a cui ruota il confine fra significato e permesso. Il documento dice come dovrebbe funzionare, il log del traversal dice come ha funzionato quel martedì alle undici e dodici su quella richiesta.
Vale anche fuori dall’ambito normativo. Il giorno in cui un cliente contesta una fattura calcolata da un sistema automatico, la domanda che ti arriva non riguarda l’architettura, riguarda quel caso.
C’è una differenza pratica fra le due posizioni che si vede nel tempo di risposta. Chi ha il percorso salvato apre il caso, guarda i passaggi, individua il nodo in cui la relazione era sbagliata e risponde in mezza giornata con una spiegazione che la controparte può verificare. Chi ha soltanto i log delle chiamate apre una riunione, coinvolge chi ha costruito il sistema, prova a riprodurre il comportamento su un ambiente che nel frattempo è cambiato, e dopo due settimane produce una ricostruzione plausibile.
Dove il percorso non basta
Sarebbe comodo se tutte le risposte venissero da relazioni modellate, e non è così. Una parte consistente di quello che serve sta dentro testo libero che nessuno strutturerà mai: la clausola negoziata a mano in calce a un allegato, la mail in cui il cliente accetta una proroga, il verbale in cui si decide un’eccezione per quel caso.
Su quel materiale il grafo arriva fino a un certo punto, e la risposta finale la produce comunque un modello che legge prosa. La differenza sta in quanta prosa deve leggere e in quale prosa: un traversal che seleziona tre documenti pertinenti e li passa al modello produce una traccia che dice quali tre documenti, mentre un recupero per somiglianza su tutto l’archivio dice soltanto che quei tre erano i più vicini.
Il percorso quindi non elimina il giudizio del modello, lo circoscrive a un materiale identificato e ispezionabile. È una forma di prova più debole di una catena di relazioni e molto più forte di un punteggio di somiglianza, e per la maggior parte dei casi reali è il livello a cui si può arrivare davvero.
Il costo di ricostruire dopo
Chi ha già vissuto un audit sa che la spesa della tracciabilità non sta nel produrre le prove, sta nel cercarle a posteriori dentro sistemi che non erano stati pensati per essere interrogati in quel modo. Sono settimane di persone brave sottratte al lavoro, e il risultato è comunque una ricostruzione parziale accompagnata da una lettera che spiega i limiti della ricostruzione.
Chi costruisce adesso il proprio grafo per ridurre la spesa di inferenza si porta a casa la tracciabilità come effetto collaterale, e la paga una volta sola. Chi costruisce solo l’indice vettoriale otterrà risposte più economiche di oggi e si troverà con lo stesso problema di prova di sempre, spostato di un livello e reso più difficile dal fatto che adesso in mezzo c’è un modello statistico.
La differenza fra le due scelte non si vede il primo mese. Si vede il giorno in cui qualcuno con l’autorità per farlo ti chiede di dimostrare una cosa che il sistema ha detto sei mesi prima.