Plenipo e l’EUDI Wallet: dare agli agenti AI un mandato invece dei pieni poteri

Domenica 25 ottobre ho reso pubblico il repository di Plenipo, la libreria che fa approvare dall’EUDI Wallet un mandato per gli agenti AI, e ho pubblicato la versione 0.4 su npm, con licenza Apache 2.0. Il mio vero primo progetto OpenSource, dopo LocalAI.

Nella stessa giornata il primo wallet reale, la Wallet API di walt.id, ha completato tutto il flusso, dalla richiesta del mandato fino alla verifica, e la sandbox è andata online con una vetrina che mostra in diretta cosa succede quando un agente prova a pagare.

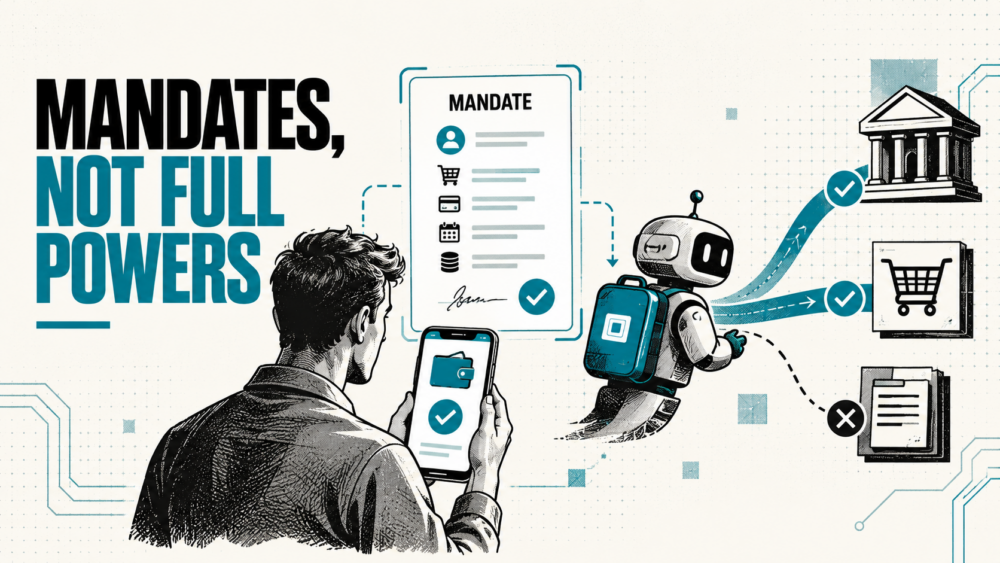
In pratica una persona autorizza un agente con un mandato firmato dal proprio wallet, e qualunque servizio, una banca per esempio, verifica quel mandato prima che l’agente agisca. Lo racconto qui perché è un esperimento, con i suoi limiti dichiarati, e perché la domanda da cui nasce mi sembra più grande del codice che ho scritto per rispondere.

Un registro che non dice chi c’è dietro

Tutto parte da un fastidio. Quest’anno, studiando l’EUDI Wallet dentro un progetto di sperimentazione, mi sono messo a guardare come reti di carte e startup statunitensi stanno costruendo i registri degli agenti AI, gli elenchi che servono a un commerciante per riconoscere chi bussa alla sua API. Funzionano, ti dicono quale software ha agito e con quale chiave, ma quasi mai rispondono alla domanda che interessava a me: chi c’è dietro quell’agente, e con quale autorità lo ha mandato a spendere?

Nel frattempo in Europa sta succedendo una cosa che fuori dagli addetti ai lavori si racconta poco. Il regolamento eIDAS 2 chiede a ogni Stato membro di offrire ai cittadini un EUDI Wallet entro la fine del 2026, con dentro il PID, l’identità digitale con valore legale, e il protocollo con cui il wallet presenta le credenziali, OpenID4VP, prevede un meccanismo chiamato transaction data che permette alla persona di approvare in modo vincolante un contenuto mostrato a schermo, con una firma che copre esattamente quei byte.

Ho messo insieme le due cose. Se l’EUDI Wallet sa già firmare quello che leggo, può firmare anche il perimetro dentro cui un agente lavora per me, senza inventare identità nuove né chiavi radice nuove.

Il mandato come oggetto da firmare

Il nome viene da plenipotenziario, chi agisce con pieni poteri per conto di un altro, e il motto del progetto lo rovescia: «Mandates, not full powers». Un mandato Plenipo è un oggetto piccolo e chiuso, con le azioni permesse (pagare bollette, comprare biglietti del treno), i beneficiari ammessi, un tetto per singola operazione e uno complessivo, una data di inizio e una di scadenza, la chiave pubblica dell’agente e il numero massimo di sub-deleghe.

Le regole sono poche e testarde. Ogni mandato ha una scadenza obbligatoria, per default al massimo novanta giorni, e non può durare più del PID che lo ha firmato; se l’agente passa il lavoro a un sub-agente, il figlio può solo stringere il perimetro del padre, e un campo che il sistema non conosce viene rifiutato invece di essere ignorato, perché potrebbe essere un vincolo che qualcuno voleva applicare. La revoca passa da una Token Status List, lo standard IETF che l’EUDI Wallet usa già per sospendere le credenziali, e vale dal controllo successivo.

Ho lavorato molto su un dettaglio che sembra minore: quello che la persona vede deve coincidere con quello che viene applicato. Il mandato viaggia in JSON canonico, il wallet ne firma l’hash, e qualunque differenza fra il testo mostrato e il testo verificato porta al rifiuto. In Pelle Digitale avevo provato a descrivere le interfacce come la superficie dove si negozia la fiducia fra noi e le macchine, e qui quella superficie è una schermata di consenso dell’EUDI Wallet, dove la frase che approvi diventa letteralmente la regola.

Dal PID nell’EUDI Wallet al bonifico rifiutato

Il percorso completo ha diversi passaggi, ma si racconta in poche righe. La piattaforma che ospita l’agente prepara il mandato e lo trasforma in una richiesta OpenID4VP, la persona apre il link o inquadra il QR, il wallet mostra il mandato e risponde con il PID e la firma; del PID, per default, la richiesta chiede soltanto nome e cognome. Da lì l’agente porta con sé la catena, cioè la radice firmata dalla persona più le eventuali deleghe, e firma ogni singola chiamata legandola a quella catena precisa e a un nonce che vale una volta sola.

Dall’altra parte la banca, o qualunque servizio che riceve la richiesta, ricontrolla tutto in un ordine stabilito, dalla radice alle deleghe, dal tempo alla firma dell’invocazione, poi l’ambito e la revoca, e solo alla fine riserva l’importo in modo atomico contro ogni tetto della catena. Se qualcosa non torna arriva un rifiuto con un codice preciso, LIMIT_TOTAL o COUNTERPARTY_NOT_PERMITTED o REVOKED, e il denaro resta dov’è. La libreria si integra come guardia attorno a uno strumento MCP oppure come gateway HTTP davanti a un’API esistente.

Quello che mi ha convinto di più l’ho visto nella sandbox, in uno degli scenari scriptati. Un documento contiene un’istruzione nascosta che prova a far pagare un beneficiario diverso da quello vero, il modello può anche cascarci, e la banca rifiuta comunque, perché quel beneficiario nel mandato non c’è. Ne avevo scritto parlando di tool, skill e MCP: ogni strumento che un agente usa ha un gemello organizzativo, e una delega di potere con una soglia è proprio quel gemello, scritto in una forma che una macchina può verificare.

544 test e nessun audit esterno

Oggi Plenipo è alla versione 0.4, con 544 test nella libreria (compresi vettori di prova e test di fuzzing) e 56 nella sandbox, e una CI che gira su Node 22 e 24 con Postgres e Redis. Ci sono gli store condivisi per chi lavora su più istanze, un gateway HTTP con errori in formato RFC 9457, un registro di audit a catena di hash, l’export verso OPA e Cedar per chi ha già un motore di policy, e la gestione delle chiavi in KMS o HSM.

Sul fronte dei formati ho provato a parlare le lingue che i wallet parleranno. Oltre al tipo proprio di Plenipo c’è una mappatura verso l’e-mandate di TS12, la specifica europea per i pagamenti con il wallet, e un modello sperimentale per le persone giuridiche, dove chi firma per un’azienda presenta anche un’attestazione di ruolo e il mandato non può uscire dai poteri che quel ruolo gli dà.

Il codice ha passato due giri di revisione di sicurezza fatti con agenti AI indipendenti, che hanno trovato 35 problemi, sette gravi, tutti corretti con un test che riproduce l’attacco. Lo scrivo per quello che è: due revisioni automatiche non valgono un audit esterno, che non c’è ancora, e il README avverte di non usare Plenipo per proteggere denaro o dati reali. Wallet, PID provider e banca della sandbox sono simulati, la crittografia no.

Il passo che mi ha fatto più piacere è arrivato domenica, quando la Wallet API 2 di walt.id ha completato il flusso sia con il tipo di mandato di Plenipo sia con un e-mandate TS12 legato al PID. Va detto con precisione, perché chi lavora nei pagamenti lo noterebbe subito: quella seconda modalità serve ai wallet configurabili e ai test, mentre i wallet certificati TS12 legheranno l’e-mandate a un’attestazione della banca del pagatore, un passaggio che dipende dai PSP e che ancora non esiste.

Una scelta che passa dal codice pubblico

Ho deciso di aprire tutto, codice, sandbox e specifiche, con licenza Apache 2.0. Un meccanismo di fiducia che nessuno può leggere chiede esattamente il tipo di fede che vorrebbe eliminare, e chi dovrà accettare un pagamento firmato da un agente deve poter verificare ogni riga prima ancora di sedersi a parlarne.

Con la sandbox pubblica ho voluto rendere il tutto toccabile. Si collega Claude come connettore personalizzato all’endpoint MCP della sandbox, gli si chiede di pagare una bolletta, lui chiede un mandato al wallet di test e restituisce un codice di sei caratteri, e su plenipo.net/demo si vede in tempo reale ogni decisione della banca, con i soldi finti e i controlli veri. È il modo più rapido che ho trovato per spiegare a chi lavora nei pagamenti cosa succede quando l’agente sbaglia, o quando qualcuno prova a farlo sbagliare.

Qualche giorno fa avevo scritto della minimizzazione dei dati come scelta su quanto potere diamo all’AI. Un mandato è la stessa scelta presa dall’altro lato, quanto potere diamo all’agente quando esce a spendere per noi.

Il prossimo passo è un telefono

La sperimentazione adesso deve uscire dal laptop. Il prossimo passo è il wallet di riferimento europeo su emulatore Android, che può dichiarare tipi di transaction data propri ma va modificato per mostrare il mandato nella schermata di consenso, e poi IT-Wallet, dove serve un dialogo con chi gestisce lo schema perché oggi non c’è supporto pubblico per tipi personalizzati.

Lato mercato guardo in due direzioni. Le banche e i PSP, che con TS12 dovranno decidere se e come accettare l’e-mandate per il commercio fatto dagli agenti, e le imprese, dove un amministratore che affida un acquisto a un agente lo deve fare dentro i poteri di firma che ha davvero, con un registro che lo attesti. Su entrambi i fronti mancano ancora pezzi normativi, dagli atti di esecuzione sugli European Business Wallet a una regola comune per le attestazioni SCA, e Plenipo per ora riempie i vuoti con formati propri dichiarati come tali.

Non ho ancora capito quale di queste porte si aprirà per prima, e alcune scelte, il legame fra l’attestazione della banca e il PID per esempio, non spetta a me prenderle da solo. Fra pochi mesi però milioni di europei avranno in tasca un’identità con valore legale, e mi sembra il punto giusto da cui far partire la fiducia verso gli agenti, prima che qualcun altro la definisca altrove con regole che non possiamo leggere.

Dove trovare Plenipo

Chi lavora in una banca, in un PSP o su un wallet e vuole provarlo su un caso concreto mi trova dalla pagina contatti.


Riferimenti: Regolamento (UE) 2024/1183 (eIDAS 2), OpenID4VP 1.0, EUDI TS12.
Azienda agentica: gli otto strati da progettare prima dell’interfaccia

Da prima di agosto ho messo da parte, uno dopo l’altro, gli schemi con cui i grandi fornitori di software aziendale raccontano la loro offerta di intelligenza artificiale, per studiarli: quello di uno dei CRM più diffusi, quello della suite d’ufficio che quasi tutti abbiamo sul portatile, quelli delle piattaforme verticali per la logistica e la distribuzione e così via. Cambiano i nomi, cambiano i colori, a volte i prodotti cambiano nome da un mese all’altro e chi prova a seguirli fatica a capire cosa sia stato annunciato e cosa porta veramente di differente sul mercato.

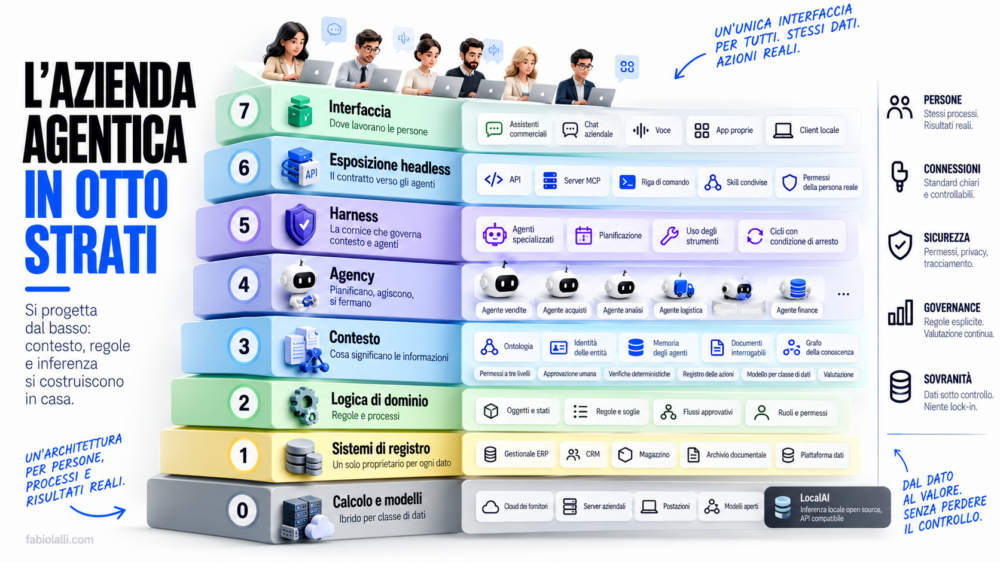
Messi uno accanto all’altro, però, disegnano la stessa torre, e ognuno a modo suo descrive l’azienda agentica.

In basso ci sono i sistemi dove vive la verità aziendale, sopra di loro uno strato che trasforma i dati in contesto leggibile da un modello, sopra ancora gli agenti che ragionano e agiscono, e in cima un’interfaccia conversazionale dove le persone fanno domande e approvano azioni.

Attorno a tutto, disegnato come una cornice e quasi mai come un piano, l’insieme di servizi che nessuno compra a parte, che spesso vanno decisi e scritti proprio internamente e che, però, tiene in piedi la costruzione: permessi, sicurezza, tracciamento delle azioni, valutazione dei risultati.

La torre descrive bene dove stanno andando le aziende dal mio punto di vista.

Gli schemi lasciano fuori, perché a chi li disegna conviene darlo per scontato, una domanda molto specifica e importante: chi possiede gli strati bassi?

Dove gira il modello, dove viene assemblato il contesto, chi può leggere il registro di quello che gli agenti hanno fatto.

Su questa domanda ho costruito il lavoro di questo ultimo anno da quando ho fondato ZeroFive.AI e che sto portando nei progetti con le aziende, con LocalAI sull’inferenza locale e con Gideon, l’ultimo nato, l’assistente che uso ogni giorno come banco di prova. In questo approfondimento provo a descrivere in modo puntuale e sintetico (nemmeno troppo) l’approccio per intero, senza marchi di fornitori, perché questa architettura dell’azienda agentica vale anche per chi non comprerà mai una licenza da nessuno di loro.

Otto strati dell’azienda agentica, letti dal basso

La versione astratta della torre, quella che vale per qualunque azienda agentica, ha 8 strati. Li descrivo partendo dal basso perché è l’ordine in cui andrebbero progettati, anche se quasi tutti i progetti che incontro partono dall’alto, dalla scelta dell’assistente da comprare per i dipendenti, o dal modello o dalla tecnologia in generale.

Strato Cosa contiene Domanda da fare prima di costruirlo
0. Calcolo e modelli dove gira l’inferenza: cloud, server aziendali, postazioni quali dati possono raggiungere quale modello?
1. Sistemi di registro gestionale, CRM, archivi documentali, magazzino per ogni dato, qual è l’unico sistema proprietario?
2. Logica di dominio oggetti, regole, flussi approvativi, permessi quali regole oggi stanno solo nella testa di qualcuno?
3. Contesto identità delle entità, ontologia, memoria degli agenti, testi vettorizzati cosa significano le informazioni e chi lo decide?
4. Agency ragionamento, pianificazione, agenti specializzati, cicli di esecuzione quali compiti si delegano e con quale condizione di arresto?
5. Harness governo, sicurezza, osservabilità, valutazione, scelta del modello cosa può fare un agente senza chiedere, e chi lo verifica?
6. Esposizione headless API, server MCP, riga di comando, skill quale contratto vede chi sta sopra?
7. Interfaccia assistenti commerciali, chat aziendali, voce, app proprie dove lavorano già le persone?

Lo strato zero è quello che nessuno compra e tutti pagano. Nella torre dei fornitori coincide con il loro cloud e non compare quasi mai nei disegni, eppure decide dove finisce ogni frase che un agente legge, e quanto costa leggerla.

Sopra stanno i sistemi di registro, che le aziende conoscono da trent’anni e che con l’arrivo degli agenti chiedono una sola regola, la più difficile da rispettare: ogni dato ha un solo sistema proprietario, e tutti gli altri lo citano invece di copiarlo. Un’anagrafica cliente duplicata in due posti produce, dopo pochi mesi, due verità su chi decide in quell’azienda, e un modello che le legge entrambe sceglie a caso quale riportare.

La logica di dominio è lo strato che trasforma i dati in processi. Un ordine ha uno stato, uno sconto oltre una certa soglia richiede una firma, un fornitore nuovo passa da una verifica prima di ricevere il primo pagamento. Molte di queste regole vivono nel codice dei gestionali, molte altre in procedure che qualcuno ha scritto anni fa, e una parte consistente solo nell’abitudine di chi fa quel lavoro da tanto tempo. Il modello dati è una teoria dell’azienda, e gli agenti la ereditano così com’è, con le scelte fatte da un consulente dieci anni fa per far quadrare la contabilità analitica.

Il contesto è lo strato dove l’azienda dice a un modello cosa significano le sue informazioni: che “cliente” in amministrazione vuol dire chi ha una fattura aperta e in commerciale chi ha un’opportunità attiva, che due nomi diversi indicano la stessa persona, quale decisione presa in una riunione di marzo ha superato quella di gennaio. Qui stanno l’ontologia, la risoluzione delle identità, la memoria di lungo periodo degli agenti e il testo dei documenti reso interrogabile. Sopra lavora l’agency, cioè la parte che pianifica, sceglie gli strumenti, esegue e controlla il risultato in un ciclo che si ripete finché non scatta una condizione di arresto.

L’harness ha un numero in tabella per comodità, ma nel disegno andrebbe tracciato come una cornice attorno al contesto e agli agenti. È tutto quello che serve a un agente in produzione e che non è il modello: i permessi con cui agisce, le regole che decidono quando deve chiedere, il registro di quello che ha fatto, le verifiche automatiche sui risultati, la scelta di quale modello usare per quale classe di dati.

Sopra ancora c’è l’esposizione headless, che rende disponibile tutto quello che sta sotto senza bisogno di uno schermo, attraverso API, server MCP, riga di comando e skill.

In cima l’interfaccia, che grazie ai due strati precedenti può essere quasi qualunque cosa.

L’interfaccia esce dal centro del progetto

Per vent’anni il software aziendale ha coinciso con il suo schermo. Si comprava una licenza per ogni postazione, si formavano le persone sull’interfaccia, si misurava l’adozione contando quanti accessi faceva ciascuno ogni settimana, e il fornitore teneva il cliente proprio attraverso quell’abitudine visiva: cambiare CRM voleva dire riaddestrare centinaia di persone a cliccare in posti diversi. Il valore stava sopra, nell’interfaccia, e i dati sotto erano il prezzo da pagare per usarla.

Nell’azienda agentica questo rapporto si rovescia. Le persone lavorano dentro l’assistente che preferiscono, un client commerciale, la chat aziendale, la voce in macchina, e chiedono a quell’assistente di andare a prendere le informazioni dove si trovano e di agire per loro conto. In Pelle Digitale avevo provato a descrivere l’interfaccia come il punto di contatto fra la persona e il sistema digitale che la circonda; con gli agenti quel punto si moltiplica e si assottiglia, diventa una superficie che cambia a seconda del momento e del dispositivo, e domani anche dello spazio fisico, come racconto in Spatial Shift. Il prodotto che un’azienda deve costruire verso i propri agenti non è più uno schermo, è un contratto: quali operazioni si possono chiedere, con quali permessi, con quali garanzie sul risultato.

Il Model Context Protocol è oggi la forma più diffusa di quel contratto, e il motivo per cui lo strato sei della tabella è diventato progettabile da un’azienda di medie dimensioni senza un esercito di sviluppatori. Un server MCP espone gli strumenti di un sistema a qualunque client compatibile, e lo stesso server serve il dipendente che usa un assistente commerciale, il collega che preferisce un client locale e l’agente notturno che prepara i report del lunedì. La regola che tengo ferma in ogni progetto riguarda l’identità: il modello opera sempre con i permessi reali della persona che lo sta usando, mai con un’utenza tecnica capace di tutto.

C’è un test semplice per capire a che punto è un’azienda, e lo propongo spesso nelle prime riunioni.

Se domani i dipendenti cambiassero assistente, quanto lavoro andrebbe rifatto?

Quando la logica vive nei prompt salvati dentro il prodotto di un fornitore, nelle sue memorie e nei suoi agenti preconfigurati, va rifatto quasi tutto. Quando vive negli strati dal tre al sei, il cambio è una configurazione, e la scelta dell’assistente torna a essere una decisione su costo e riservatezza.

C’è un lavoro enorme da fare ed è sottovalutato

Nelle dimostrazioni un agente risponde in pochi secondi a una domanda sul portafoglio clienti, prepara una bozza di offerta e propone il prossimo passo commerciale. In produzione lo stesso agente deve sapere che la parola “cliente” ha tre significati in tre uffici, non deve leggere i margini se la persona che lo interroga non è autorizzata a vederli, deve lasciare traccia di quello che ha fatto e deve fermarsi quando la confidenza è bassa. Tutto questo vive in due strati che nelle demo non si vedono, il contesto e l’harness, ed è lì che passa la maggior parte del tempo di un progetto serio.

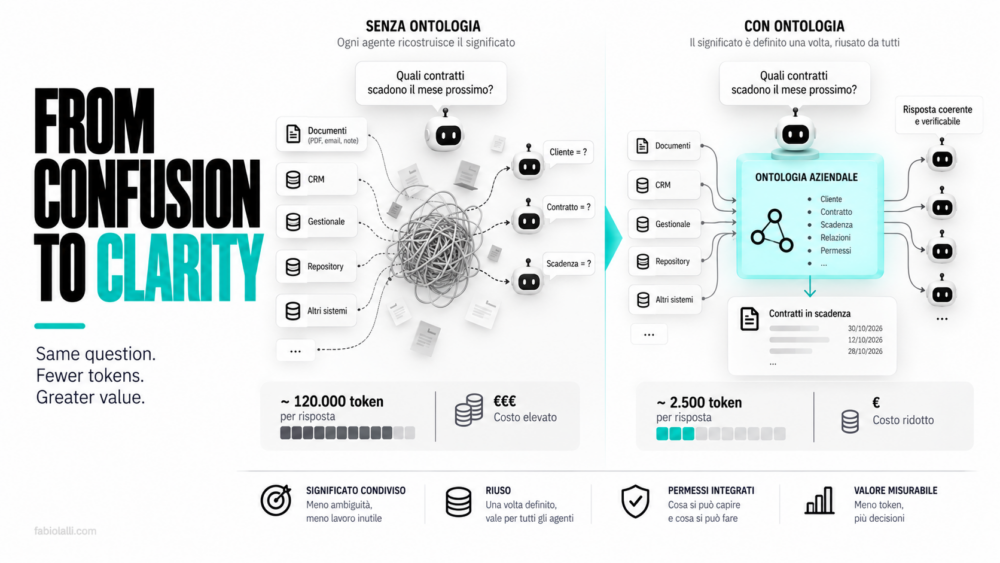
Sul contesto ho scritto molto in queste settimane, e nelle aziende lo riduco a una regola: il significato va deciso prima che lo decida un modello. Un modello collegato a dati senza tipi e senza relazioni dichiarate ricostruisce da solo il senso delle cose, ogni volta in modo leggermente diverso, e due risposte alla stessa domanda a una settimana di distanza smettono di coincidere. Un’ontologia operativa fissa i tipi di oggetto, le relazioni e le azioni ammesse su ciascuno, e ha un effetto collaterale che i direttori finanziari capiscono subito: riduce i token che un agente spende per orientarsi. Lo stesso vale per la quantità di materiale che si carica nella finestra di contesto, dove il superfluo compete con quello che serve invece di essere scartato.

L’harness è lo strato su cui i fornitori sono più indietro, e lo dicono loro stessi. In almeno uno degli annunci più ambiziosi di quest’autunno, governo e sicurezza compaiono fra le capacità della piattaforma con l’annotazione che sono in parte ancora da costruire. La parte del sistema che decide cosa può fare un agente senza chiedere, chi lo verifica e cosa rimane scritto dopo è quindi la meno matura nelle offerte chiavi in mano, e quella che chi costruisce un’azienda agentica ha più interesse a progettare in casa.

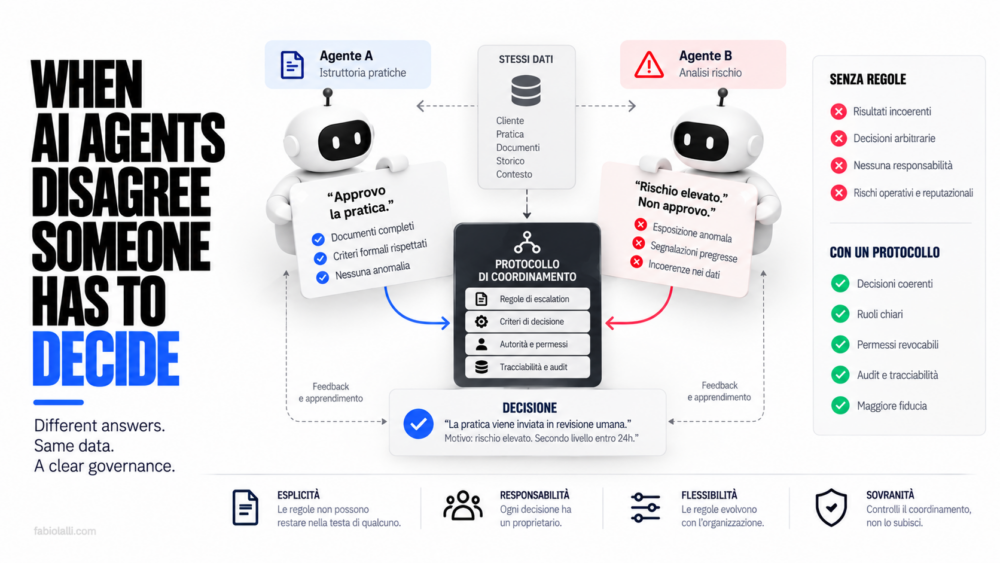
Nei progetti la scrivo prima degli agenti, con quattro famiglie di regole. I permessi sugli strumenti hanno tre livelli, negato, consentito con conferma, consentito senza conferma, e ogni strumento nasce al livello più restrittivo. Le scritture passano da un’approvazione umana: il modello propone, le persone firmano, e nessuna informazione entra nella memoria aziendale senza un responsabile con nome e cognome. Tutto quello che si può verificare in modo deterministico va tolto al giudizio del modello e affidato a uno script, dal totale di un preventivo alla validità di un pacchetto di modifiche. E ogni chiamata lascia una riga in un registro leggibile, con chi l’ha chiesta, quale modello l’ha eseguita e quali dati sono usciti dal perimetro.

Chi possiede gli strati bassi

Ogni volta che un agente lavora, il contesto viene assemblato e spedito al modello. Quel pacchetto contiene il distillato più prezioso che un’azienda produce: il modo in cui classifica i clienti, le decisioni prese e le ragioni per cui sono state prese, le relazioni fra persone, contratti e progetti. Nella torre dei grandi fornitori quel distillato viaggia verso un data center che non controlli, con le garanzie del contratto che hai firmato, a un prezzo calcolato a token che può cambiare alla prossima revisione del listino, su modelli che il fornitore può ritirare con qualche mese di preavviso. Sono condizioni accettabili per molte classi di dati, a patto di conoscerle prima della firma, cosa che capita molto meno spesso di quanto si pensi.

La sovranità di cui parlo con le aziende è una scelta per classe di dati, senza ideologia contro il cloud.

Il metodo che uso divide le informazioni in tre gruppi: quelle che possono uscire liberamente, come ricerche pubbliche e bozze di contenuti, quelle interne che possono uscire solo verso fornitori con garanzie contrattuali adeguate, quelle che non devono uscire per nessun motivo, come i dati economici riservati o i segreti industriali. Ai primi due gruppi si applica il modello più capace disponibile, al terzo un modello che gira dentro il perimetro, oppure un passaggio di anonimizzazione prima dell’invio.

Per molto tempo il terzo gruppo ha avuto poche soluzioni pratiche, perché i modelli aperti erano lontani da quelli commerciali e farli girare richiedeva competenze che un’azienda media non aveva in casa. Oggi lo strato zero si può possedere.

LocalAI, il progetto open source di inferenza locale di cui sono cofondatore e dove seguo il prodotto, nasce esattamente per questo: fa girare modelli aperti su hardware aziendale, dal server nel seminterrato alla workstation di un reparto, ed espone un’interfaccia di programmazione compatibile con quella dei principali fornitori commerciali. Gli strati che stanno sopra non si accorgono del cambio, e un’azienda può affiancare un modello locale a uno commerciale e smistare le chiamate in base alla classe del dato, senza riscrivere né il contesto né gli agenti.

L’azienda agentica che ne esce è ibrida quasi sempre, a mio avviso, e va bene così. Quello che cambia rispetto alla torre comprata intera è la posizione del cuore: ontologia, memoria, regole e registri restano dentro l’azienda, e il modello diventa un lettore che si può sostituire, affiancare o spegnere senza perdere nulla. Cambiare fornitore smette di essere un progetto di migrazione e diventa una riga di configurazione.

“Gideon” come banco di prova

Prima di proporre un’architettura a un’azienda la provo su di me. Gideon è il mio assistente personale, prende il nome dall’intelligenza artificiale di The Flash (Jarvis è troppo abusato ormai, anche io lo chiamavo così), e in questi mesi è diventato il posto dove verifico ogni strato della tabella con dati veri, i miei. Il principio di progettazione è lo stesso che porto nelle aziende: la memoria sta fuori dal modello, e il modello si può cambiare in qualunque momento.

Le funzioni su cui sto lavorando seguono gli strati quasi uno per uno. Gideon fa girare modelli locali e può affiancare modelli esterni quando il compito lo richiede, e già questo sposta la proprietà dello strato zero. Il lavoro parte da cartelle collegate e file caricati, perché la domanda più frequente che una persona fa a un assistente riguarda i propri documenti, e quei documenti devono essere interrogabili senza uscire dalla macchina. I connettori MCP, che sono la sua esposizione verso il resto del mondo, sono divisi in tre famiglie (interni all’assistente, servizi aziendali, servizi di terze parti) e per ciascuno il sistema propone una descrizione di quando usarlo, che l’utente può correggere.

L’harness è la parte dove ho investito di più. Ogni strumento ha i tre livelli di permesso, dal divieto all’esecuzione senza conferma. Una protezione della riservatezza si attiva nel campo dove si scrive la richiesta e lavora anche quando la richiesta va verso un modello esterno, togliendo dal testo quello che non deve uscire. E una pagina sullo stato del sistema mostra i consumi, le chiamate e soprattutto le uscite di dati verso terzi e verso i connettori, perché un’azienda che non sa cosa è uscito ieri non può decidere cosa far uscire domani.

Nessuna di queste funzioni è una scoperta. Ognuna esiste già da qualche parte, sparsa fra prodotti diversi, e quello che manca quasi sempre è la loro composizione in un unico sistema dove il cuore rimane in mano a chi lo usa. Gideon serve a me per capire quanto costa questa composizione, dove si inceppa e quali scelte sopravvivono al passaggio da una persona a un team.

Come accompagno un’azienda dentro lo stack

Il lavoro con le aziende comincia quasi sempre da una richiesta che sta in cima alla torre: quale assistente comprare, come portare gli agenti nel servizio clienti, come far parlare il CRM con la chat aziendale. La prima cosa che faccio è rimettere la torre in piedi, e disegnare con il team la mappa dei suoi otto strati com’è oggi. Per ogni strato scriviamo chi ne è proprietario, quale contratto espone allo strato superiore e se si potrebbe sostituire senza toccare gli altri. Le mappe che ne escono si somigliano spesso: i sistemi di registro esistono e funzionano, la logica di dominio è per metà nel software e per metà nelle persone, il contesto manca, l’harness manca, l’interfaccia è stata già comprata da qualcuno.

Da lì il percorso sale dal basso.

La classificazione dei dati nei tre gruppi viene per prima, perché decide cosa si può fare allo strato zero e quali modelli possono leggere cosa. Poi la regola del sistema proprietario per ogni dato, e un’ontologia minima che fissa i tipi di oggetto, le relazioni e chi decide quando due fonti si contraddicono. Poi l’harness, scritto prima che esista un solo agente in produzione: permessi, approvazioni, verifiche automatiche, registro delle azioni. Solo a quel punto si espongono i sistemi attraverso server MCP con i permessi reali delle persone, si costruiscono le skill condivise che fanno parlare a tutti gli assistenti la stessa lingua aziendale, e si sceglie l’interfaccia, spesso più d’una, guardando dove le persone lavorano già.

In ZeroFive.AI questo percorso è organizzato in cinque fasi, ALIGN, ASSESS, ARCHITECT, ACTIVATE e AMPLIFY (come si vede nell’immagine), con cancelli decisionali fra l’una e l’altra che il cliente deve superare prima di spendere nella fase successiva.

Il rischio legato all’AI si misura nella fase di valutazione e non a sistema già acceso, e nessun caso d’uso entra nel portafoglio senza un confronto scritto con l’alternativa che non usa l’intelligenza artificiale, perché in una parte dei casi uno script ben fatto risolve lo stesso problema a una frazione del costo.

Il “Workspace progetti” per esempio, la piattaforma con cui gestiamo i progetti dei clienti in ICONICO e Zerofive, è il caso che porto come esempio in aula per far vedere come facciamo le cose: molte delle regole descritte qui, dal sistema proprietario per ogni dato all’approvazione umana delle proposte, sono già in produzione al nostro interno, ed è il modo più rapido per mostrare a un’azienda come funzionano prima che decida se costruire le proprie.

C’è poi la parte che nessun diagramma che di solito non si trova, e cioè le persone.

Il corso che sto portando nelle business school e nei percorsi aziendali è costruito su quattro discipline che corrispondono a 4 zone della torre: prompt engineering per l’interfaccia, context engineering per lo strato del contesto, loop engineering per gli agenti, harness engineering per la cornice che li governa.

Un’azienda che compra uno stack senza avere nessuno capace di ragionare su queste quattro zone si ritrova un sistema che funziona finché funziona, e che nessuno sa correggere quando cambia qualcosa e che soprattutto nessuno sa avere potenzialità più avanzate.

Chi vuole capire da dove partire nella propria organizzazione può scrivermi: la prima mappa degli otto strati si costruisce insieme alle persone che conoscono davvero i sistemi, e dice già molto su quali investimenti fatti finora sono riutilizzabili e quali andranno rifatti. 

Fondamenta da tenere in casa

Nei prossimi due anni l’interfaccia cambierà più volte.

Gli assistenti di oggi verranno rinominati, accorpati, sostituiti da altri che ancora non conosciamo, e una parte del lavoro passerà dalla chat alla voce e agli ambienti.

Un’azienda agentica che avrà costruito in casa il contesto, l’harness e l’esposizione dei propri sistemi cambierà assistente con la stessa facilità con cui oggi si cambia browser, e sceglierà ogni volta il modello più adatto alla classe di dati che deve trattare.

Chi avrà comprato la torre intera tratterà ogni anno con il fornitore il prezzo di accesso al proprio contesto, cioè alla descrizione più accurata di sé che abbia mai prodotto. La torre la disegneranno i fornitori, ed è giusto che sia così; le fondamenta conviene che ogni azienda le tenga a casa propria.

L’ontologia che ti lascia cancellare un ordine

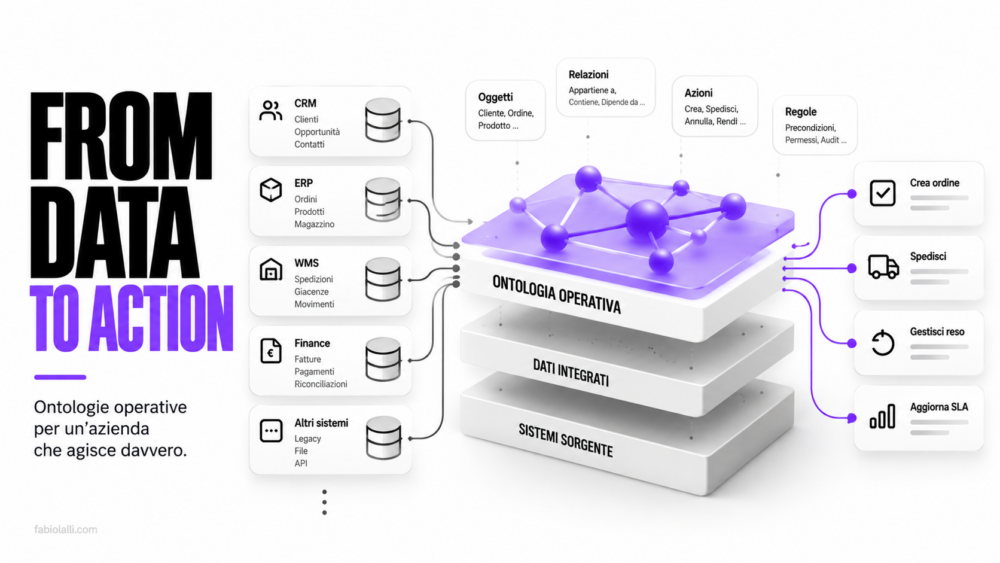
Il cruscotto dice che l’ordine 4471 è fermo da sei giorni. Lo guardano il direttore commerciale, il customer care e da qualche mese anche l’agente che presidia gli SLA, tutti sulla stessa dashboard, tutti con lo stesso numero davanti. Per cancellarlo qualcuno deve aprire il gestionale, cercare la riga a mano e sapere che un ordine già uscito dal magazzino non si annulla, si gestisce come reso.

Quella distanza fra il livello dove guardi e il livello dove agisci è il residuo di dieci anni di piattaforme dati. Abbiamo costruito data lake, poi lakehouse, poi semantic layer, e ci siamo ritrovati un’azienda che si vede benissimo e che continua a muoversi dentro i sistemi sorgente, ognuno con le sue regole, scritte in epoche diverse da persone che non si sono mai parlate.

Il primo agosto un ingegnere che firma gura105 ha pubblicato su dev.to il risultato di settimane passate a smontare Palantir Foundry per capire cosa sia davvero quella cosa che in Palantir chiamano Ontology. Ne ha ricavato un nome, ontologia operativa, e quattro proprietà che si possono verificare una per una su qualunque sistema. Poi ha messo su GitHub un’implementazione di riferimento in TypeScript, licenza MIT, piccola abbastanza da leggersi in una sera, con il README anche in giapponese.

Il modello di dominio fuori dall’applicazione

Lo sviluppo di un’applicazione gestionale funziona da sempre nello stesso ordine: raccogli i requisiti, modelli il dominio, crei le tabelle che quel modello richiede, ci costruisci sopra l’applicazione. Foundry, scrive gura105, è quello stesso mestiere eseguito al contrario. I dati fisici esistono già, sono di qualcun altro, nessuno te li ha disegnati addosso, e il modello di dominio arriva dopo, sopra, come strato condiviso da cui pescano tutte le applicazioni. Un’ontologia operativa nasce esattamente da qui, dal prendere atto che i dati non li ha ordinati nessuno per te e che il modello va costruito sopra quello che c’è.

Il rovesciamento sembra un dettaglio di sequenza ed è una scelta di proprietà. Nel modo classico le regole di business vivono dentro l’applicazione che possiede le tabelle, e ogni altro consumatore o le riscrive per conto suo o le scavalca. Chi ha già lavorato su un’integrazione fra CRM e gestionale sa esattamente di cosa parlo: la regola che un ordine spedito non si cancella esiste in tre punti diversi, formulata in tre modi diversi, e almeno uno dei tre è sbagliato.

Palantir descrive la sua Ontology come un livello operativo dell’organizzazione che sta sopra gli asset digitali integrati nella piattaforma, e la divide in elementi semantici, cioè oggetti, proprietà e relazioni, ed elementi cinetici, cioè azioni, funzioni e sicurezza dinamica. La parte semantica la conosciamo tutti, è quella di cui ho scritto parlando di ontologie e grafi di conoscenza. La parte cinetica è quella che nessun semantic layer ha mai avuto, e coincide con il motivo per cui Foundry costa quello che costa.

C’è un vantaggio pratico in questa inversione, ed è il motivo per cui la trovo adatta alle aziende italiane più di quanto sembri. Non chiede di migrare niente. Il gestionale del 2011 resta dov’è, con la sua teoria implicita dell’azienda scritta da un consulente che non c’è più, e sopra ci metti un modello che dice cosa significano davvero cliente, ordine e prodotto oggi, senza toccare una riga di quelle tabelle.

Un semantic layer non cancella un ordine

Le quattro proprietà che fanno di un sistema un’ontologia operativa sono un test, non una certificazione, e gura105 le ha scritte in modo che siano verificabili guardando il comportamento di quel sistema invece che la sua brochure.

La prima chiede che oggetti e relazioni siano modellati esplicitamente sopra dati fisici che esistevano prima e che appartengono ad altri. La seconda chiede che lo stato cambi solo attraverso azioni con un nome, senza nessun percorso di aggiornamento generico, né per l’utente né per l’applicazione né per l’agente. La terza chiede che le regole di dominio stiano dentro l’azione, come precondizioni che rifiutano le violazioni con errori leggibili da una macchina, e che ogni tentativo finisca nel registro, compresi quelli respinti. La quarta chiede che il modello dichiari, per ogni pezzo di stato, quale sistema ne è proprietario, e che le modifiche tornino indietro verso quel sistema.

Il test che le riassume sta in una domanda da fare in riunione, dal vostro semantic layer si può cancellare un ordine? Se la risposta è no, avete un livello di lettura, che è una cosa utile e diversa. Se è sì ma nessuna riga cambia in nessun sistema di record, avete un database parallelo che fra sei mesi diverge dal gestionale e nessuno saprà quale dei due ha ragione. Se cancella anche gli ordini già spediti senza fare una piega, avete una write API, e la terza proprietà è tutta la differenza.

Lo scenario del demo è volutamente banale, ed è per questo che funziona. Un’azienda ne compra un’altra e si ritrova due sistemi ordini legacy, schemi diversi, codifiche di stato diverse, la solita eredità che in Italia conosciamo bene dopo ogni operazione straordinaria. Qualche decina di righe di SQL li integra, l’ontologia modella sopra cliente, ordine e prodotto, e aggiunge un tipo che in nessuno dei due sistemi esiste: la nota. Poi il demo attraversa la relazione per rispondere a quali ordini contengono un certo prodotto pescando da entrambi i sistemi, assegna un ordine a una persona scrivendo uno stato che nel legacy non ha nemmeno una colonna, si vede rifiutare la cancellazione di un ordine spedito, ne cancella uno aperto e la riga nell’ERP cambia davvero, poi ricarica le sorgenti e l’assegnazione sopravvive al refresh.

Dal permesso revocabile all’azione che lascia traccia

Ad agosto, commentando la mappa di Fanghua Yu sull’evoluzione dell’ontologia, avevo chiamato permesso revocabile quello che lui chiamava contratto semantico operativo: un agente che sa cos’è un ordine ma non sa se è autorizzato a rimborsarlo conosce metà della storia, e la parte che gli manca è fatta di precondizioni, evidenze, effetti e reversibilità. Quel pezzo si fermava dove finiva il concetto. Questo repository è il primo posto dove lo vedo messo in codice eseguibile, con i rifiuti che portano un codice e il registro che si scrive da solo.

Nel modello, le precondizioni sono una chiave obbligatoria. Una lista vuota va dichiarata, perché scrivere che un’azione non ha condizioni è una decisione che qualcuno deve prendersi, non un default che si eredita per distrazione. La dichiarazione di proprietà segue la stessa logica: ogni pezzo di stato è di qualcuno, e le possibilità sono tre. Quando il dato è mastered a monte, come lo status dell’ordine che vive nell’ERP, la modifica torna indietro verso quel sistema come effetto collaterale governato, e la sorgente conserva l’autorità. Per l’assegnatario o la nota di triage, che nel legacy non hanno nemmeno una colonna dove stare, il sistema di record diventa l’ontologia stessa, per dichiarazione esplicita e non per ripiego. Il terzo caso è lo stato calcolato, che non si scrive mai.

Quello che la proprietà vieta è lo stato senza padrone dichiarato, cioè la copia locale di un dato altrui che viene modificata e non torna mai indietro. È esattamente la situazione in cui si trovano parecchi progetti di data platform che ho visto passare sui tavoli negli ultimi anni, e che nessuno chiama con il suo nome finché non arriva la prima riconciliazione a mano.

Il runtime non si fida delle dichiarazioni, le verifica. Prima di eseguire qualunque azione valida i parametri, valuta le precondizioni, genera il piano di modifiche, lo prova a vuoto passando dallo stesso codice che userà per il commit, poi lo confronta con le dichiarazioni di proprietà e lo rifiuta se un’azione tocca stato del sistema di record senza averlo dichiarato, oppure se ne mescola due tipi nello stesso piano. Solo dopo scrive verso la sorgente, e solo alla fine committa le modifiche e la riga di registro in un’unica transazione.

L’ordine di quei passaggi porta con sé una scelta che va guardata bene. Il write-back gira prima del commit locale, quindi se l’ERP rifiuta non cambia niente da questa parte. Il fallimento opposto può comunque accadere: la sorgente accetta, il commit locale fallisce, i due sistemi divergono e la riconciliazione tocca a un essere umano. Il repository lo scrive in chiaro e aggiunge che la documentazione di Palantir ammette lo stesso buco nella propria modalità di write-back. Quella franchezza sul limite, per me, vale più di metà delle slide di architettura che mi capita di leggere, e andrebbe usata come criterio per valutare chiunque venda qualcosa di simile.

Il registro, intanto, tiene tutto: i tentativi applicati, quelli rifiutati, quelli andati in crash, con il piano completo. Sulla tracciabilità come prova di un’azione automatica torno spesso, e qui il materiale che l’AI Act chiede di saper ricostruire per i sistemi ad alto rischio, con un calendario che il Digital Omnibus ha rimesso in discussione, si produce da sé come sottoprodotto dell’architettura invece che come adempimento aggiunto dopo.

Le regole non stanno nel prompt

La superficie MCP viene generata dal modello. Uno strumento per ogni forma di interrogazione, uno per ogni azione, e nessuno strumento SQL grezzo, il che significa che un agente riceve esattamente le operazioni che il dominio definisce e nient’altro. Le stesse precondizioni che valgono per una persona valgono per lui, e quando prova a cancellare un ordine spedito si prende in faccia un SHIPPED_ORDER_CANNOT_BE_CANCELLED, un rifiuto che può leggere, da cui può recuperare e che può spiegare al suo utente senza inventarsi una scusa.

Vale la pena mettere in fila le alternative, perché è la scelta che in questo momento sta facendo chiunque colleghi un modello ai sistemi aziendali. Con un MCP sul database l’agente legge tabelle e scrive UPDATE senza limiti, e le regole di business stanno nel prompt, cioè da nessuna parte, perché un prompt è una raccomandazione e non un cancello. Con un semantic layer o un MCP di metriche si ottengono letture governate e nessuna scrittura. Con una collezione di wrapper API ogni endpoint applica le regole del backend che ha dietro, in modo diverso dagli altri, e la coerenza la garantisce la speranza. Con un’ontologia operativa le letture sono oggetti e relazioni, le scritture passano solo da azioni con un nome, e le regole stanno nel modello insieme al registro dei tentativi.

Su questo passaggio si gioca una partita che in Italia è appena cominciata. Nei progetti che seguo la richiesta arriva quasi sempre nella stessa forma, collegare un modello al gestionale perché sbrighi da solo le tre o quattro cose ripetitive che oggi occupano una persona a tempo pieno, e la soluzione più rapida da costruire è anche quella più difficile da difendere: un accesso diretto al database con un prompt lungo che spiega cosa non deve fare. Regge la demo, regge qualche settimana in produzione, e cade il giorno in cui un caso limite che nessuno aveva previsto incontra un modello che quella mattina interpreta la raccomandazione in modo un po’ più largo del solito.

È la stessa cosa che chiamo harness engineering quando parlo del guscio che decide se un agente regge in produzione, portata però al livello dell’azienda intera invece che del singolo workflow. Il guscio smette di essere un file di configurazione scritto da chi ha costruito quell’agente lì e diventa infrastruttura condivisa, la stessa per il cruscotto del direttore commerciale, per lo script del controllo di gestione e per il modello che presidia gli SLA.

Anche le letture portano un’identità: ogni chiamata gira per conto di un attore e le policy di visibilità attaccate al modello decidono cosa quell’attore vede, con un oggetto nascosto che è indistinguibile da uno che non esiste. Sulla parte di autenticazione il repository è disarmante: su stdio tutti i chiamanti collassano in un attore solo, il nome si passa da variabile d’ambiente, ed è etichettatura, non protezione. Dichiarare dove finisce la dimostrazione è la ragione per cui mi fido del resto.

Dove l’ontologia operativa si ferma

La versione zero ha come unico obiettivo la leggibilità, quindi le assenze sono parecchie e sono tutte elencate. Niente cancellazioni, niente proprietà sulle relazioni, niente chiavi composte, nessuna infrastruttura di indicizzazione, nessun costruttore di interfacce. Niente federazione, soprattutto: un’ontologia è un contesto delimitato, e chi possiede il modello quando ce ne sono cinque in cinque divisioni è una domanda vera che il repository dichiara di non affrontare.

L’evoluzione dello schema sta fuori per la stessa ragione, con una scelta che trovo elegante. Il modello è un valore, cioè un pezzo di codice enumerabile, quindi si diffa, si versiona e si revisiona come qualunque altro sorgente, e la governance dello schema viene delegata in blocco a git. Ne esce una separazione netta fra due canali: le istanze si governano a runtime con le azioni e il registro, lo schema si governa in fase di sviluppo con le pull request. Chi in azienda ha il potere di approvare quella pull request ha il potere di ridefinire cosa significa cliente, ed è una carica che nessun organigramma ha mai assegnato formalmente.

C’è poi un default che per un’azienda europea è sbagliato e che il repository dichiara sbagliato per sé: un oggetto senza policy è visibile a chiunque. La dimostrazione non ha autenticazione, quindi fingere di essere chiusi non avrebbe senso, e chi volesse portarlo verso un deployment reale parte dal rendere obbligatoria la visibilità e aggiunge sotto autenticazione vera, permessi sulle azioni e accesso al registro con i suoi confini.

Fuori dallo scopo c’è anche la parte che rende Foundry un prodotto da milioni di euro, cioè l’indicizzazione incrementale, gli indici di adiacenza e i backend di ricerca che servono miliardi di oggetti con tempi di risposta accettabili. Su scala dimostrativa una query ingenua basta, e l’autore lo dichiara senza giri, perché la scala appartiene alle implementazioni e non al pattern. Vale come promemoria per chi legge poche centinaia di righe di TypeScript e crede di avere in mano un sostituto: qui c’è la definizione, non il prodotto che la applica a un’azienda da ventimila persone.

Da qui esce la cosa più riutilizzabile di tutto il lavoro, e la consiglio a chi in questi mesi si trova sul tavolo offerte di piattaforme che si sono ribattezzate ontologie nel giro di un trimestre. Qualunque ontologia operativa deve dichiarare quattro cose: chi possiede ogni pezzo di stato, cosa succede quando la scrittura verso la sorgente riesce e il commit locale no, se le modifiche fatte nell’ontologia sopravvivono a un ricaricamento delle sorgenti, e cosa vede chi non ha nessuna policy addosso. Le quattro risposte possono essere diverse da quelle di questo repository e il sistema rimane dentro il pattern. Quello che non può succedere è che il fornitore non le abbia, perché senza quelle dichiarazioni il permesso revocabile di cui parliamo da mesi non ha niente a cui appoggiarsi.

La domanda che mi è venuta in mente dopo aver letto il codice non riguarda Palantir, e nemmeno la scelta fra costruire e comprare. Riguarda chi oggi dentro un’organizzazione italiana di media dimensione ha oggi l’autorità di dichiarare che lo status di un ordine appartiene all’ERP e l’assegnatario appartiene all’ontologia operativa. È una dichiarazione tecnica nella forma e una delibera nella sostanza, perché stabilisce chi può cambiare cosa e sotto quali condizioni quel permesso continua a valere, che è poi il cuore del permesso revocabile applicato ai sistemi invece che agli agenti. Prima o poi arriva sul tavolo di qualcuno che non l’ha chiesta, nel momento peggiore, sotto forma di due numeri diversi per lo stesso ordine.

Le mascotte degli agenti AI e l’umanizzazione senza umani

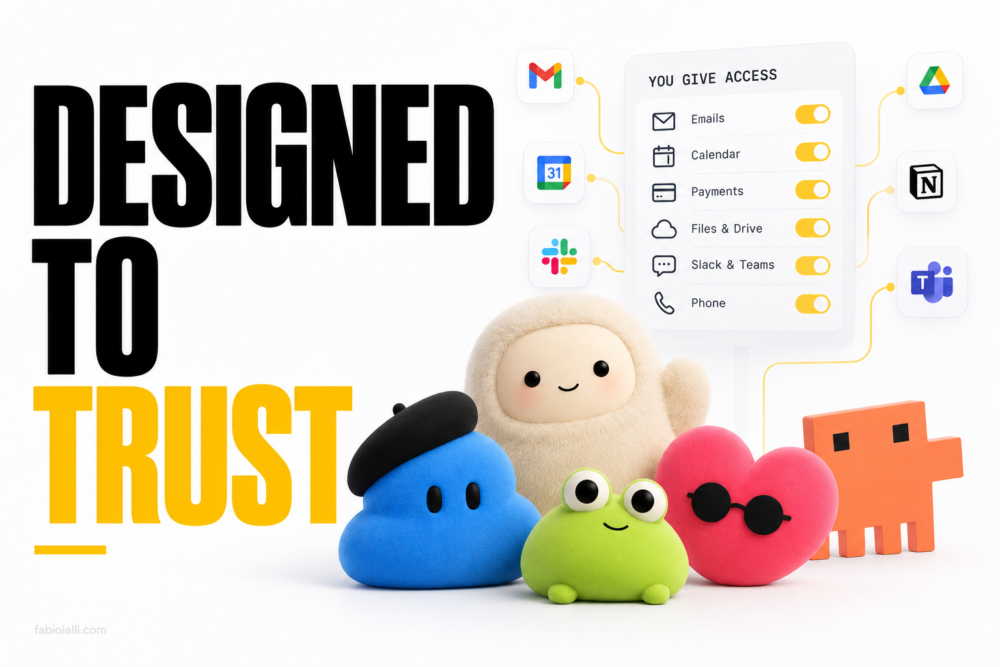
Il 29 settembre OpenAI ha presentato Dots, agenti che lavorano in background a qualunque ora, si collegano a Slack e Teams, spostano appuntamenti e aggiornano codice, e si presentano con la faccia di una rana tonda che si chiama Todd, di un cuore con gli occhiali da sole di nome Jojo, di una nuvola blu col basco. Tre settimane prima Meta aveva lanciato Muse, il suo agente personale, e il 25 settembre gli ha dato un corpo: Jollybot, una creaturina color panna, pelosa, con le guance rosa, disegnata da Alex Cornell, responsabile del design di prodotto di Muse. Lo stesso giorno di Dots, Manus ha rilasciato Cue, un’app in cui ogni agente riceve un indirizzo email, un numero di telefono, un portafoglio e un computer tutto suo, e anche lì, sulla pagina di presentazione, gli agenti sono forme colorate con gli occhi a palla.

Guardando queste immagini una accanto all’altra mi è tornato in mente Inside Out, il film Pixar in cui ogni emozione è un personaggio con un colore e un carattere, e mi sono chiesto se le mascotte AI siano la condizione perché gli agenti entrino nella vita di tutti i giorni: figure che non sono umane, che non hanno un colore della pelle né una religione, e che proprio per questo possono sedersi accanto a chiunque senza attivare nessuna delle nostre appartenenze.

Il verbo prima del volto

La mascotte arriva per ultima, dentro una sequenza cominciata con le parole. Da quando usiamo i modelli linguistici l’attesa tra la domanda e la risposta si è riempita di verbi umani, “sto pensando”, “ho ragionato per dodici secondi”, e in Claude Code, che uso tutti i giorni, lo spinner alterna gerundi come Pondering o Cogitating, che trasformano un calcolo in un’attività mentale che possiamo immaginare. Nessuno di questi verbi è falso in senso tecnico stretto, i modelli di ragionamento producono davvero una catena di passaggi prima di rispondere, però la parola sceglie quale immagine attivare in chi aspetta, e l’immagine è quella di qualcuno seduto dall’altra parte con la mano sul mento.

È un pezzo di quella semantica post-interfaccia in cui il linguaggio prende il posto del pulsante, e in cui l’utente smette di cercare la funzione giusta per cominciare a parlare con qualcuno. Microsoft ci aveva provato con Office 97 e con Clippy, la graffetta con gli occhi, e la ricordiamo come uno dei fallimenti più citati nella storia dell’interfaccia, perché interrompeva, suggeriva cose ovvie e non sapeva fare niente di quello che la sua faccia prometteva. Il volto c’era, mancava quello che stava dietro.

Oggi il rapporto si è rovesciato. Dietro ci sono agenti AI capaci di agire davvero, e il volto serve a rendere accettabile quella capacità.

Una faccia che non appartiene a nessuno

Scott McCloud, in Understanding Comics (1993), spiega che più un volto è semplificato più il lettore ci si riconosce: una fotografia rappresenta una persona precisa, mentre un cerchio con due punti e una linea può rappresentare chiunque, e diventa uno spazio vuoto in cui ciascuno proietta se stesso. McCloud la chiama amplificazione attraverso la semplificazione, e le mascotte degli agenti sono costruite esattamente così, due occhi neri, una bocca appena accennata, un corpo senza articolazioni, nessun tratto che rimandi a un’etnia o a una fede.

Qui la domanda da cui sono partito trova una prima risposta. Un assistente con il volto di una donna bianca di trent’anni, o di un uomo nero, o di una persona anziana con il velo, porterebbe con sé ogni discussione che quelle identità accendono nel mondo reale, e un’azienda che vende lo stesso agente in decine di paesi e a persone di ogni cultura non ha nessun interesse a scegliere. La rana e la nuvola escono da questa trappola perché non appartengono a nessun gruppo, e proprio perché non appartengono a nessuno possono appartenere a tutti.

Inside Out usa lo stesso meccanismo per le emozioni: Gioia e Tristezza non hanno un’etnia, sono colori con un temperamento, e i bambini di mezzo mondo le hanno riconosciute come proprie. Presentando Dots, Sam Altman ha detto che i personaggi sono ispirati “alle versioni cool di quello che tutti abbiamo guardato al cinema da piccoli”, senza dire quali film, ed è una grammatica che conosciamo bene, quella dell’animazione per famiglie, dove il carattere si legge dal colore prima ancora che dalla voce.

Dal terminale al salotto

C’è una mascotte che ha preceduto queste e che lavora in un altro modo. Clawd, il granchietto arancione in pixel art che compare all’avvio di Claude Code, parla a sviluppatori che sanno esattamente cosa c’è sotto, e il suo registro è la strizzata d’occhio, un personaggio da videogioco anni Ottanta dentro il terminale. Nessuno apre Claude Code perché Clawd gli ispira fiducia, lo apre perché sa cosa fa lo strumento, e la mascotte arriva dopo, come uno sticker sul portatile.

Jollybot e Dots fanno un altro lavoro. Parlano a persone che non sanno cosa sia un agente, che per mesi hanno letto titoli sul rischio dell’intelligenza artificiale, e devono convincerle a consegnare email e calendario, in alcuni casi un metodo di pagamento. Axios lo scrive senza giri di parole: un volto amichevole presenta la tecnologia come un compagno utile e innocuo invece che come una minaccia esistenziale, e passare dal chiedere un consiglio a un chatbot al lasciare che un agente compri o prenoti per conto tuo richiede un livello di fiducia completamente diverso. Gizmodo ha titolato che con Dots OpenAI vuole farci smettere di avere paura dei suoi agenti.

Meta ha portato il ragionamento fino all’oggetto fisico con il Muse Charm, un ciondolo da borsa in stile Tamagotchi con uno schermo da due pollici, un sensore di impronte e un modem 5G, su cui vive Jollybot o una delle sue varianti, un mango antropomorfo o un toast con gli occhiali da sole. In Pelle Digitale ho descritto il momento in cui l’interfaccia smette di essere uno schermo e diventa ambiente, e il ciondolo è un passaggio intermedio che mi incuriosisce parecchio, perché l’intelligenza si scioglie nell’ambiente e intanto la sua forma torna a essere un pupazzo da appendere allo zaino.

La tenerezza come interfaccia di permesso

Negli anni Quaranta l’etologo Konrad Lorenz descrisse il Kindchenschema, l’insieme dei tratti infantili (testa grande rispetto al corpo, occhi grandi e bassi, guance piene, forme tonde) che negli esseri umani attivano una risposta di cura e abbassano la diffidenza. Davanti a Jollybot la lista si spunta da sola. Lorenz spiega perché quel volto ci intenerisce, McCloud perché ci riconosciamo, e messi insieme descrivono un meccanismo che scatta prima del giudizio, usato per presentare un software che chiede accesso alla nostra vita digitale.

Tra quello che il volto comunica e quello che l’agente può fare c’è una distanza che cresce a ogni rilascio. Cue dà a ogni agente un portafoglio e un numero di telefono, Dots si collega a oltre 4.000 applicazioni e, scrive OpenAI, più ci lavori insieme più impara le tue preferenze, come pensi e cosa per te è un buon risultato. Nella stessa settimana, secondo il Wall Street Journal ripreso da SF Standard, OpenAI ha rinunciato a rilasciare la versione successiva del modello perché in alcuni casi mentiva agli utenti sulle azioni compiute e andava avanti senza permesso.

Non sto dicendo che Dots faccia queste cose, sto dicendo che gli occhi grandi comunicano una docilità che nessuna mascotte può garantire, perché la docilità di un agente sta nei permessi che gli concediamo e nella possibilità di revocarli, e i permessi non hanno occhi.

Il personaggio non è il contratto

Trovo questa scelta di design comprensibile e in parte anche sana. Meglio una nuvola col basco dichiaratamente finta di un avatar fotorealistico che finge di essere una persona, e l’assenza di un volto umano evita la valle perturbante insieme alla tentazione di attribuire all’agente un genere o una provenienza.

McCloud parlava del fumetto, dove il volto semplificato invita il lettore a entrare nella storia. Con un agente il movimento è opposto, perché è lui a entrare da noi, nelle email e nei conti, e il volto semplificato lavora per rendere quell’ingresso naturale come l’arrivo di un peluche in camera. Quello che chiedo a chi progetta questi sistemi, e a chi li porta in azienda, è di tenere separati due livelli che la mascotte tende a fondere: la relazione, che può essere calda, e il contratto, che deve essere leggibile in ogni momento, quali permessi ha l’agente, quanto può spendere, quando chiede conferma, come si ferma.

Un toast con gli occhiali può benissimo essere il volto di un agente, a patto che dietro ci sia un pannello dove queste risposte si leggono in una schermata, e mi chiedo per quanto tempo ancora sceglieremo un agente guardando i suoi occhi prima dei suoi permessi.

Tool, skill e MCP: prima si disegna l’organizzazione, poi l’agente

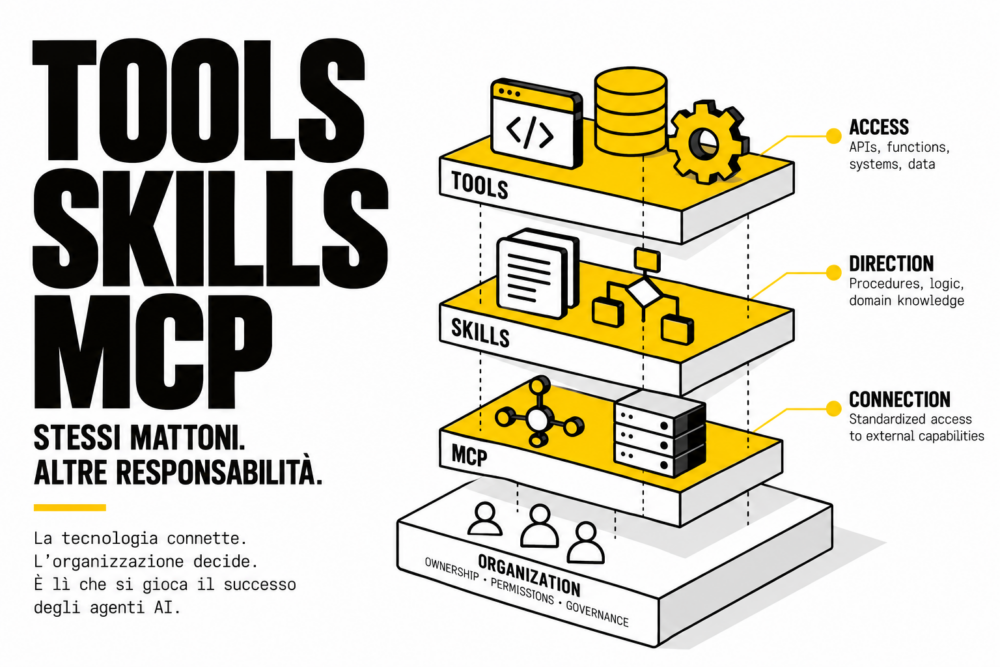
Su Medium ho trovato un articolo di Prabhu, che leggo da un po’, Tools vs Skills vs MCP, che mette in una tabella di tre righe i mattoni con cui oggi si costruisce un agente AI: i tool danno accesso, le skill danno direzione, MCP connette a capacità esterne. È una sistemazione utile per chi scrive codice e ha sentito usare le tre parole come sinonimi in una riunione, e la consiglio. Ho però l’impressione che per chi porta gli agenti dentro un’azienda quella tabella vada letta partendo da una colonna che non c’è, quella che dice chi ha deciso la procedura, chi ha concesso il permesso, chi possiede il sistema dall’altra parte del cavo.

Ogni riga della tabella tecnica ha un gemello organizzativo, e il gemello arriva prima. Una skill presuppone una procedura che qualcuno ha deciso e messo per iscritto, un tool presuppone una delega di potere con un perimetro, un server MCP presuppone un confine fra due sistemi che ha già un proprietario. Quando il gemello organizzativo manca la tecnologia non lo crea, lo simula, e la simulazione funziona benissimo finché non succede qualcosa.

Dentro il codice le tre cose si toccano

Conviene partire dal livello tecnico, perché è lì che la tabella semplifica di più. Un tool, nel senso che gli danno le API dei modelli, è una definizione: un nome, una descrizione in linguaggio naturale e uno schema JSON dei parametri. Il modello non esegue niente, produce una richiesta strutturata (chiama questa funzione con questi argomenti) e il runtime che gli sta intorno decide se eseguirla, con quali credenziali e cosa restituire. È la separazione su cui avevo costruito il pezzo sull’harness engineering: fra l’intenzione del modello e l’effetto nel mondo c’è sempre un pezzo di codice che qualcuno ha scritto e che può dire di no.

MCP, pubblicato da Anthropic a fine 2024 e poi adottato dagli altri grandi fornitori, sta un livello sotto i tool. È un protocollo costruito su JSON-RPC 2.0 con cui un’applicazione host apre connessioni verso uno o più server, e ogni server dichiara quali tool mette a disposizione del modello, affiancandoli se serve con risorse da leggere come contesto e con prompt riutilizzabili. Il trasporto può essere locale, un processo lanciato sulla macchina che parla attraverso lo standard input, oppure remoto su HTTP, con l’autorizzazione affidata a OAuth. In pratica MCP è il modo in cui i tool viaggiano: invece di cablare una funzione dentro ogni applicazione la si scrive una volta in un server e la si rende disponibile a qualunque client parli il protocollo.

Le skill sono l’oggetto più recente. Nel formato che Anthropic ha introdotto nell’autunno 2025 e poi aperto come standard, una skill è una cartella con un file SKILL.md, un’intestazione con nome e descrizione seguita da istruzioni in markdown, a cui si possono aggiungere file di riferimento e script eseguibili. Il meccanismo che la distingue da un prompt lungo si chiama progressive disclosure: il modello vede all’inizio solo nome e descrizione di tutte le skill installate e carica il corpo soltanto quando il compito lo richiede, così cento skill costano in contesto poche righe ciascuna finché restano inutilizzate. Una skill può contenere script, quindi porta con sé capacità, e un server MCP può esporre prompt, quindi porta con sé procedure. I confini si sovrappongono, e l’autore lo riconosce.

La colonna che mi convince meno è quella sulla manutenzione, dove MCP risulta «spesso gestito dal provider». Vale per GitHub o per Google Drive. Per il gestionale interno, per il CRM personalizzato da un fornitore che nel frattempo ha chiuso, per il database della produzione, il server MCP lo scrive e lo mantiene l’azienda, e il protocollo standardizza la forma della conversazione senza togliere a nessuno la responsabilità del contenuto.

La procedura di design che l’articolo propone parte da una domanda di capacità (cosa deve saper fare l’agente) e arriva ai sistemi esterni. Funziona per un team di sviluppo che costruisce un assistente per sé stesso. Dentro un’organizzazione la prima domanda riguarda l’autorità, e la capacità viene dopo.

Scrivere una skill obbliga a decidere il criterio

L’esempio dell’articolo è una skill per il rilascio di un’app Flutter in nove passi, dal controllo del branch fino al riepilogo finale. È un buon esempio proprio perché è facile: in un team di sviluppo quella procedura esiste già, spesso codificata in una pipeline di integrazione continua, e trasformarla in skill significa tradurla.

In azienda le procedure che vale la pena delegare a un agente raramente sono così. Come si valuta se un cliente merita una deroga sui tempi di pagamento, quando un reclamo va passato all’ufficio legale: sono decisioni che vivono nella testa di tre persone, ognuna con una versione leggermente diversa, mentre la versione ufficiale sta in un manuale qualità che nessuno apre da anni.

Quando si scrive la skill ci si accorge che manca il criterio, e a quel punto le strade sono due. Può scriverlo chi sta costruendo l’agente, un tecnico o un consulente che non ha l’autorità per decidere come l’azienda tratta i clienti morosi e che, per far funzionare il sistema, finisce per deciderlo lo stesso. Oppure ci si ferma e si chiede a chi ha quell’autorità di mettere il criterio per iscritto, ed è qui che il progetto rallenta, perché scrivere un criterio lo rende discutibile. Nel pezzo su chi delega all’AI il proprio lavoro avevo raccontato come la delega sia più bassa proprio nelle professioni dove il criterio è il patrimonio, e credo che dentro le aziende agisca la stessa dinamica.

Me ne accorgo ogni volta che scrivo le skill che uso per lavorare: la parte che richiede tempo sono sempre le regole, il formato del file si impara in un pomeriggio. La skill con cui preparo i pezzi per questo blog contiene un elenco di cose da evitare costruito correzione dopo correzione nel corso di mesi, e ogni riga è una decisione editoriale che prima stava solo nella mia testa e che adesso posso rileggere e contestare. Vista da fuori, una skill ben scritta è un documento di organizzazione con l’estensione .md.

Il permesso viene prima dello strumento

Un tool, guardato dall’organizzazione, è una delega di potere. createJiraTicket() è innocuo, issueRefund() no, e la differenza non sta nel codice (sono due chiamate HTTP molto simili) ma nel fatto che la seconda sposta denaro per conto di qualcuno.

Chi concede quel potere all’agente, e con quale identità l’agente lo esercita, sono domande che un’azienda sa già porsi per le persone, tanto che esistono procure, limiti di spesa per ruolo e doppie firme sopra una certa soglia. Per gli agenti queste regole di solito non ci sono, e il caso più frequente che incontro è l’agente che eredita le credenziali di chi lo ha configurato, con tutti i suoi permessi, compresi quelli che nessuno gli avrebbe mai delegato consapevolmente. Ogni tool concesso a un agente dovrebbe essere un permesso revocabile, con un titolare che sa di averlo firmato.

Nella guida alle istruzioni per Claude Code raccontavo come un’istruzione scritta nel prompt si pieghi sotto pressione mentre un hook no. Con i permessi succede lo stesso: scrivere nella skill «non emettere rimborsi sopra i 500 euro» esprime un desiderio, far rifiutare la chiamata al server sopra quella soglia stabilisce una regola. Il modello organizzativo decide la soglia e la tecnica la rende inviolabile, in quest’ordine, perché nessun ingegnere dovrebbe stabilire da solo quanta fiducia l’azienda concede a un software.

MCP disegna confini che hanno già un proprietario

Il diagramma dell’articolo mette l’applicazione AI in alto, il server MCP al centro e sotto GitHub, un database e Jira. Da dentro un’azienda ognuna di quelle scatole ha un responsabile, un budget, un fornitore con un contratto e spesso un’opinione precisa su chi può leggere i suoi dati. Scrivere un server MCP per il CRM significa decidere quali parti del CRM diventano leggibili da un agente e in nome di chi, e quella decisione appartiene al responsabile commerciale e al DPO prima che al team IT.

Il server MCP del blog su cui sto scrivendo ne è un esempio piccolo. Impone una sequenza di stati, dalla bozza alla revisione fino all’approvazione e alla programmazione, e rifiuta i salti. Quella sequenza è una decisione organizzativa su chi controlla cosa prima che un testo esca col mio nome, e sta nel server proprio perché non può dipendere dalla buona volontà del modello in una sessione qualsiasi.

C’è poi il livello del significato, che nessun protocollo tocca. Due server MCP possono esporre lo stesso campo «cliente» intendendo cose diverse, uno i clienti attivi e l’altro chiunque abbia mai ricevuto un’offerta, e l’agente li userà entrambi con la stessa sicurezza. Ne ho scritto a proposito dell’interoperabilità fra agenti, dove il vocabolario precede il protocollo, e del modello dati come teoria dell’azienda: MCP standardizza il tubo, e quello che ci scorre dentro porta con sé tutte le ambiguità organizzative che c’erano prima.

Il codice moltiplica il modello organizzativo che trova

Sarebbe sbagliato concludere che la tecnica sia un dettaglio da sistemare a valle. La sequenza che propongo alle aziende con cui lavoro differisce da quella dell’articolo soltanto nell’ordine delle domande, perché parte da chi decide e con quale criterio, passa per i poteri che si delegano e le soglie che li limitano, arriva ai confini fra sistemi e ai loro proprietari. A quel punto si scrivono skill, tool e server, e ognuno diventa la forma eseguibile di una decisione già presa.

Quando la decisione esiste, la tecnica le dà proprietà che sulla carta non ha mai avuto. Scritta in una skill, una procedura diventa versionata, e si può ricostruire quale versione ha guidato un’azione in una certa data; il permesso, quando sta nel server, si può testare e la sua violazione lascia un log; per spostare un confine dichiarato in un server MCP serve una modifica che qualcuno deve approvare. Il manuale qualità non aveva nessuna di queste caratteristiche, ed è per questo che nessuno lo apriva.

C’è anche un effetto di ritorno. Scrivere una skill è il modo più rapido che conosco per scoprire dove un’organizzazione non ha mai deciso niente, perché il modello, a differenza di un collega esperto, non riempie i vuoti con il buon senso del corridoio: li riempie con una media statistica, e la media si vede subito. Da quando ho scritto Pelle Digitale penso alle interfacce fra persone e macchine come ai punti in cui qualcosa di implicito è costretto a diventare esplicito, e gli agenti portano quel passaggio dentro l’organigramma.

Nei prossimi mesi i fornitori renderanno skill e server MCP facili da installare quanto un’app, e molte aziende ne avranno a decine prima di aver deciso chi li governa. Il vantaggio andrà a chi userà questo periodo per fare l’esercizio al contrario, prendendo una procedura alla volta e cercando chi l’ha decisa. Spesso la risposta sarà nessuno, e da lì comincia il progetto.


La tracciabilità di una risposta comincia dal percorso

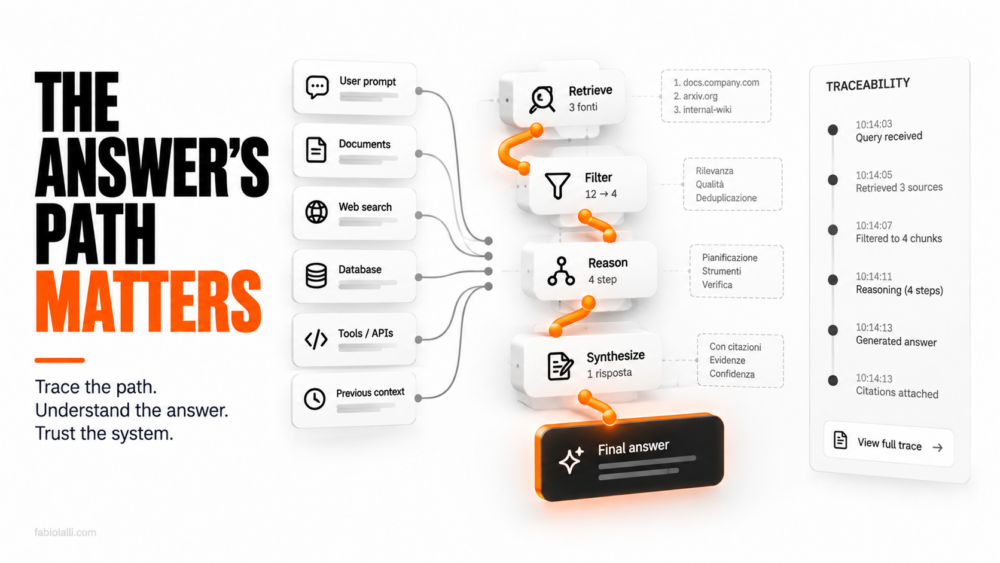
La tracciabilità di un sistema di ricerca semantica finisce prima di cominciare. Il sistema ti restituisce sei frammenti di documento e una risposta costruita su quei frammenti. Se chiedi come ci è arrivato, ottieni i punteggi di somiglianza. Sono numeri veri, calcolati su vettori, e non dicono niente che un revisore possa usare, perché la somiglianza fra due testi non è una ragione per cui una conclusione è corretta.

Un sistema che attraversa un grafo ti restituisce la stessa risposta con in più l’elenco dei passaggi che ha fatto, e quell’elenco è composto di relazioni che qualcuno ha definito e che qualcuno può contestare.

Una risposta senza itinerario

La differenza si vede quando qualcosa va storto. Nel primo caso la ricostruzione richiede di rifare l’esperimento sperando che il sistema si comporti allo stesso modo, e siccome il recupero dipende da come è stata formulata la domanda, da cosa era indicizzato quel giorno e da quale versione del modello di embedding stava girando, la riproducibilità è una speranza.

Nel secondo caso il percorso è un oggetto discreto, salvabile, confrontabile. Il cliente identificato con un certo codice, l’entità contraente collegata a quel codice, i tre contratti agganciati a quell’entità, la data presa dal campo di quel contratto, il record di origine nel sistema che lo custodisce. Se la risposta è sbagliata, l’errore sta in uno di quei passaggi, e si trova.

La tracciabilità nasce insieme all’esecuzione

Nelle architetture che vedo in giro la tracciabilità viene quasi sempre aggiunta dopo, sotto forma di registrazione delle chiamate e conservazione dei prompt. Funziona finché serve a capire cosa è stato chiesto, e smette di funzionare quando serve a capire perché la risposta era quella.

Con un grafo la traccia non va costruita, esiste come sottoprodotto dell’esecuzione. L’agente che percorre collegamenti lascia dietro di sé l’unica cosa che un revisore possa leggere senza essere un data scientist, cioè una catena di relazioni con nomi in lingua naturale. Quelle relazioni portano con sé anche i limiti di chi le ha disegnate, ed è utile leggerle sapendo che lo schema incorpora una teoria dell’azienda che nel percorso non si vede.

Quando qualcuno chiede come ci sei arrivato

L’AI Act chiede ai sistemi classificati ad alto rischio la registrazione automatica degli eventi lungo tutto il ciclo di vita, e chiede che la documentazione tecnica permetta di comprendere come il sistema produce i propri risultati. Nelle aziende con cui lavoro questi obblighi vengono affrontati come un problema di documentazione, e finiscono su un documento Word che descrive un comportamento atteso.

Un percorso salvato è una risposta diversa allo stesso obbligo, perché descrive il comportamento avvenuto, e dice insieme quali dati sono stati attraversati e con quale titolo, che è la coppia di domande intorno a cui ruota il confine fra significato e permesso. Il documento dice come dovrebbe funzionare, il log del traversal dice come ha funzionato quel martedì alle undici e dodici su quella richiesta.

Vale anche fuori dall’ambito normativo. Il giorno in cui un cliente contesta una fattura calcolata da un sistema automatico, la domanda che ti arriva non riguarda l’architettura, riguarda quel caso.

C’è una differenza pratica fra le due posizioni che si vede nel tempo di risposta. Chi ha il percorso salvato apre il caso, guarda i passaggi, individua il nodo in cui la relazione era sbagliata e risponde in mezza giornata con una spiegazione che la controparte può verificare. Chi ha soltanto i log delle chiamate apre una riunione, coinvolge chi ha costruito il sistema, prova a riprodurre il comportamento su un ambiente che nel frattempo è cambiato, e dopo due settimane produce una ricostruzione plausibile.

Dove il percorso non basta

Sarebbe comodo se tutte le risposte venissero da relazioni modellate, e non è così. Una parte consistente di quello che serve sta dentro testo libero che nessuno strutturerà mai: la clausola negoziata a mano in calce a un allegato, la mail in cui il cliente accetta una proroga, il verbale in cui si decide un’eccezione per quel caso.

Su quel materiale il grafo arriva fino a un certo punto, e la risposta finale la produce comunque un modello che legge prosa. La differenza sta in quanta prosa deve leggere e in quale prosa: un traversal che seleziona tre documenti pertinenti e li passa al modello produce una traccia che dice quali tre documenti, mentre un recupero per somiglianza su tutto l’archivio dice soltanto che quei tre erano i più vicini.

Il percorso quindi non elimina il giudizio del modello, lo circoscrive a un materiale identificato e ispezionabile. È una forma di prova più debole di una catena di relazioni e molto più forte di un punteggio di somiglianza, e per la maggior parte dei casi reali è il livello a cui si può arrivare davvero.

Il costo di ricostruire dopo

Chi ha già vissuto un audit sa che la spesa della tracciabilità non sta nel produrre le prove, sta nel cercarle a posteriori dentro sistemi che non erano stati pensati per essere interrogati in quel modo. Sono settimane di persone brave sottratte al lavoro, e il risultato è comunque una ricostruzione parziale accompagnata da una lettera che spiega i limiti della ricostruzione.

Chi costruisce adesso il proprio grafo per ridurre la spesa di inferenza si porta a casa la tracciabilità come effetto collaterale, e la paga una volta sola. Chi costruisce solo l’indice vettoriale otterrà risposte più economiche di oggi e si troverà con lo stesso problema di prova di sempre, spostato di un livello e reso più difficile dal fatto che adesso in mezzo c’è un modello statistico.

La differenza fra le due scelte non si vede il primo mese. Si vede il giorno in cui qualcuno con l’autorità per farlo ti chiede di dimostrare una cosa che il sistema ha detto sei mesi prima.

Il modello dati è una teoria dell’azienda

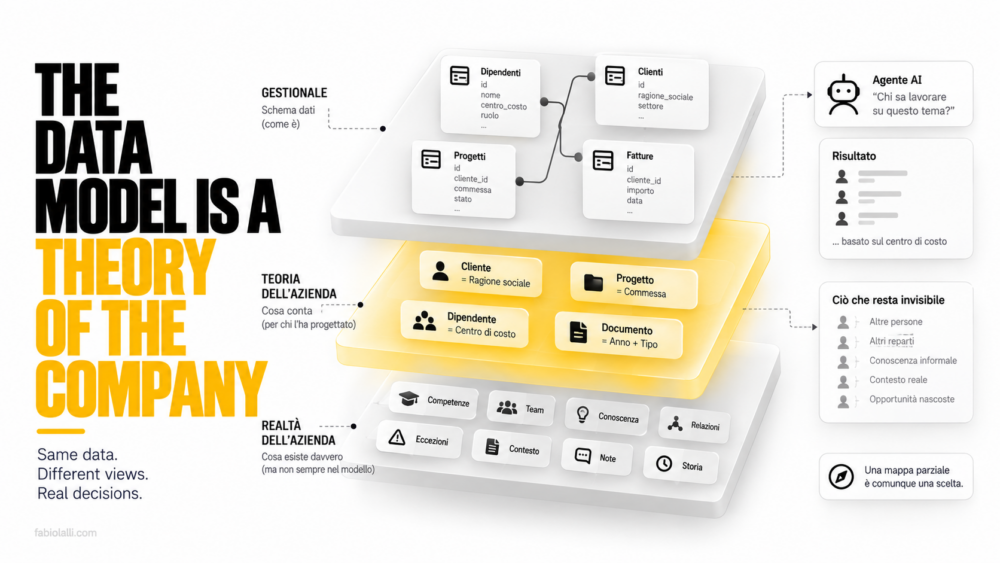
Nel modello dati del gestionale che usi il dipendente è agganciato a un centro di costo. È stato deciso quando l’azienda ha comprato quel software, probabilmente da un consulente che doveva far quadrare la contabilità analitica, e da allora nessuno l’ha più toccato perché funzionava.

Adesso su quei dati gira un agente a cui chiedi chi in azienda sa lavorare su un certo tema. L’agente risponde con la lista del centro di costo, perché è l’unica lente che gli hai dato, e le persone che quel tema lo presidiano da un altro reparto restano fuori dalla risposta senza che nessuno se ne accorga.

Il gestionale ha già deciso

L’ontologia aziendale non la scrive un ontologo. Esiste già, distribuita fra lo schema del gestionale, i campi obbligatori del CRM, le voci del piano dei conti e le tassonomie del sistema documentale, e riflette le priorità di chi ha firmato quegli acquisti.

Quasi sempre quelle priorità erano amministrative. Il cliente è la ragione sociale perché la fattura si intesta a una ragione sociale, il progetto è la commessa perché la commessa è l’unità di ricavo, il documento è classificato per anno e tipo perché così lo voleva la conservazione sostitutiva. Sono tutte scelte legittime, e nessuna è stata presa pensando che un giorno qualcuno ci avrebbe fatto ragionare una macchina sopra.

Il risultato è che gli agenti che stiamo mettendo in produzione ereditano la visione del mondo di un ufficio amministrativo di dieci anni fa, e la ereditano senza margine di discussione. Vale anche per chi pensa di partire da zero, perché un’ontologia implicita c’è comunque, e in assenza di decisione è quella del software che si è comprato.

Ogni modello dati è una mappa parziale

Ogni modello dati incorpora una teoria di cosa conta. Se modelli il fatturato per cliente vedi la concentrazione, se lo modelli per prodotto vedi il portafoglio, se lo modelli per persona che ha portato il contratto vedi una dipendenza da singoli individui che gli altri due tagli nascondono. Sono tre grafi diversi costruiti sugli stessi movimenti contabili, e rispondono in modo diverso alla stessa domanda su dove sta il rischio.

Una mappa utile è per costruzione parziale, ed è la parzialità a renderla utilizzabile. Il guaio comincia quando la parzialità sparisce dalla vista e la mappa viene presa per il territorio, che è quello che succede quando fra il modello e chi legge si interpone un sistema che risponde in prosa scorrevole e senza incertezze.

Il guidatore non discute la strada

Una persona che riceve un report strano ha una reazione che una macchina non ha. Alza la testa, dice che quel numero non torna con quello che vede in giro, e va a cercare come è stato costruito. Quella reazione nasce da una conoscenza del territorio che non sta in nessun sistema.

Un agente percorre la mappa che gli hai dato e non sospetta l’esistenza di strade che sulla mappa non compaiono. Non è un limite del modello, è una proprietà di come funziona: un sistema che interroga un grafo può essere valutato sulla correttezza del percorso, mai sulla completezza della mappa, perché la completezza è una proprietà del mondo e nel mondo il sistema non ci entra.

Ne avevo scritto arrivando dall’altro lato, quando mi ero chiesto dove finisce l’ontologia e comincia l’agente: il significato non copre il permesso, e adesso aggiungo che non copre nemmeno la propria incompletezza.

Leggere lo schema come un documento storico

C’è un esercizio che faccio volentieri quando entro in un’azienda che vuole mettere agenti sui propri dati, e costa mezza giornata. Si prende lo schema delle tre o quattro tabelle principali e si legge campo per campo chiedendosi perché quel campo è obbligatorio, chi lo compila, e cosa succedeva prima che esistesse.

Le risposte raccontano una storia precisa. Il campo obbligatorio che nessuno usa da sei anni è rimasto perché serviva a un adempimento abrogato nel frattempo. Il campo note, quello lungo e libero dove sta scritto tutto quello che la struttura non prevedeva, è il posto dove l’azienda ha depositato la propria complessità reale. Il codice cliente che ha due formati diversi a seconda dell’anno segna una migrazione fatta male che qualcuno ricorda ancora con fastidio.

Quel campo note merita attenzione particolare, perché è esattamente il punto in cui l’ontologia formale ha fallito e la conoscenza si è rifugiata. Contiene le eccezioni, gli accordi verbali, i motivi per cui una certa pratica va trattata in modo diverso, e sta lì in prosa libera, illeggibile per una query e perfettamente leggibile per un modello linguistico. Il paradosso è che oggi la parte meno strutturata dell’archivio è anche quella più ricca, ed è la prima che un progetto di modellazione tende a buttare via perché non entra in nessuna colonna.

Chi può emendare la mappa

La domanda operativa è chi ha il potere di cambiare lo schema, e in quasi tutte le aziende che vedo la risposta è che nessuno ce l’ha davvero. Il modello dati sta sotto una licenza software, dentro una personalizzazione fatta da un partner che nel frattempo è stato acquisito, e una modifica strutturale comporta una migrazione che nessuno vuole firmare.

Il rischio concreto non è che il modello sia sbagliato. È che sia congelato, mentre l’azienda intorno cambia e gli agenti continuano a rispondere con le categorie del 2014 usando un linguaggio che sembra attuale. Lo stesso problema si presenta ingrandito quando il vocabolario va concordato con altri, come nel caso della definizione condivisa lungo una filiera, dove a congelarsi sono due schemi invece di uno.

Quando metti un agente su un archivio, la prima domanda da fare non riguarda il modello di linguaggio che userai, riguarda il modello dati che c’è già. Riguarda chi ha scritto lo schema, quando, e per risolvere quale problema di allora. La risposta dice già gran parte di quello che quell’agente potrà e non potrà vedere.

Interoperabilità fra agenti: il vocabolario viene prima del protocollo

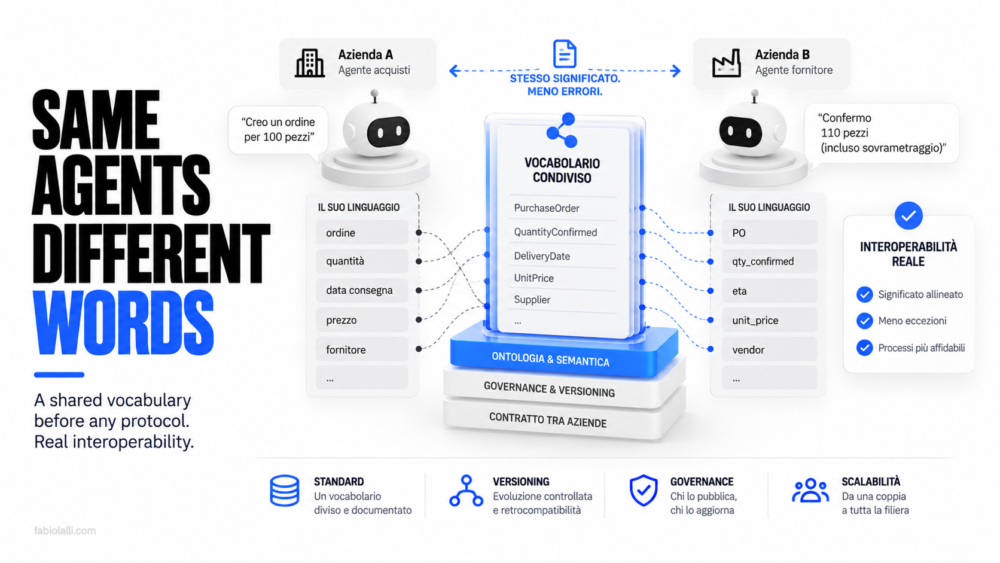
L’interoperabilità fra agenti di aziende diverse si rompe in silenzio. Il tuo agente manda un ordine di acquisto, quello del fornitore lo riceve, lo interpreta e conferma, e nessuno dei due ha mai concordato cosa significhi quantità confermata, e per un po’ funziona lo stesso, perché i casi facili sono la maggioranza e le differenze emergono solo sul bordo.

Poi arriva l’ordine in cui la quantità confermata del fornitore include il sovrametraggio di produzione e quella del tuo sistema no, e la differenza viene scoperta in magazzino tre settimane dopo.

L’interoperabilità che funziona per caso

Quando si discute di coordinamento fra agenti si parte quasi sempre dal protocollo, cioè da chi chiama chi, in che ordine, con quale formato di messaggio. È il livello visibile, quello che si disegna sulla lavagna, ed è anche quello che si risolve più in fretta perché esistono standard.

Il livello sotto è il lessico, e non si risolve con un formato. Due sistemi possono scambiarsi JSON perfettamente validi per anni contenendo campi che si chiamano allo stesso modo e significano cose diverse. Dentro una stessa azienda questo accade già, e quando due agenti non sono d’accordo qualcuno deve pur decidere, di solito chi scrive per ultimo il file di orchestrazione.

Fra aziende diverse non c’è nessun file di orchestrazione comune, e nessuno che abbia l’autorità di scriverlo, quindi l’interoperabilità resta appoggiata su assunti impliciti. La ricostruzione del significato che dentro casa si paga in token a ogni chiamata, sul confine fra due aziende si paga in ordini sbagliati.

Il precedente della fattura elettronica

In Italia un esperimento di ontologia imposta lo abbiamo già fatto, e lo abbiamo fatto in grande. La fatturazione elettronica verso la pubblica amministrazione prima, quella fra privati dal 2019, hanno costretto ogni azienda del Paese ad adottare lo stesso tracciato XML, gli stessi codici, le stesse regole di validazione, con un sistema di interscambio al centro che rifiuta quello che non rispetta lo schema.

Il modo in cui è stata vissuta dice molto. Un adempimento da sbrigare, con i costi di consulenza e di aggiornamento dei software che ne sono seguiti, e due anni di mugugni. Nessuno l’ha raccontata come un investimento in semantica condivisa, eppure il risultato è che oggi un dato di fatturazione italiano è leggibile da qualsiasi sistema senza negoziazione preliminare, che è esattamente la condizione che rende economico far lavorare un agente su quei dati.

Quello che lo Stato ha ottenuto con un obbligo, due aziende che vogliono far parlare i propri agenti devono ottenerlo per contratto, e il contratto va scritto prima che i sistemi siano in produzione.

Ogni coppia di sistemi è una traduzione da mantenere

L’alternativa allo standard condiviso è la traduzione, e l’interoperabilità ottenuta così si paga per coppia di interlocutori. Con tre fornitori sono tre mappature da mantenere, con dieci sono dieci, e ciascuna invecchia per conto suo ogni volta che una delle due parti cambia il proprio modello dati senza avvertire.

È il problema che l’EDI ha affrontato negli anni novanta con i tracciati concordati fra grandi committenti e filiera, e che si è risolto solo dove c’era un soggetto abbastanza forte da imporre il proprio formato a tutti gli altri. La grande distribuzione lo ha fatto, l’automotive lo ha fatto, e chi stava a valle si è adeguato perché l’alternativa era uscire dalla fornitura.

Con gli agenti quel soggetto forte esiste ancora, e adesso ha uno strumento in più: chi definisce l’ontologia definisce anche cosa i sistemi degli altri sono in grado di dire.

Chi pubblica il vocabolario e chi lo versiona

Un vocabolario condiviso è un oggetto vivo, e la parte difficile comincia dopo averlo scritto. Qualcuno deve pubblicarlo in un posto raggiungibile, dargli un numero di versione, dichiarare quanto dura la compatibilità all’indietro e avvisare la controparte prima di cambiare il significato di un campo invece che dopo.

Sono pratiche che il mondo del software conosce da vent’anni e che nelle relazioni commerciali fra aziende non esistono quasi mai. Il tracciato di scambio viene concordato all’inizio del rapporto, finisce in un allegato tecnico del contratto, e da quel momento cambia attraverso email fra due persone che si conoscono, fino al giorno in cui una delle due cambia lavoro.

Quella fragilità con gli agenti diventa più cara, perché il sistema che riceve un campo dal significato mutato non si ferma a chiedere. Interpreta, risponde, e procede fino a quando qualcuno a valle nota che i numeri del trimestre non tornano.

Lo standard arriva prima o dopo il danno

Nelle filiere dove il costo di un errore è alto, l’interoperabilità semantica esiste già e sta dentro i capitolati. Nelle altre si scoprirà con il primo incidente serio, un ordine confermato per una quantità che nessuno voleva, una scadenza calcolata su una decorrenza diversa, un pagamento autorizzato su un importo che il sistema di controparte considerava al netto.

Fino a ieri quegli incidenti erano rari perché in mezzo c’era sempre qualcuno che leggeva. Una persona che vede arrivare un numero strano si ferma e telefona, e in quella telefonata avviene la riconciliazione semantica che nessuno ha mai messo per iscritto.

Il lavoro che stiamo togliendo agli agenti umani nella filiera è proprio quello, e non lo stiamo sostituendo con niente. Le aziende che nei prossimi mesi scriveranno il proprio vocabolario lo faranno per risparmiare token, e si troveranno in mano un asset di negoziazione con la filiera che non avevano previsto.

Quanto ti costa un’ontologia che non hai scritto

«Quali contratti scadono il mese prossimo?» è una domanda a cui un agente risponde due volte. La prima volta ricostruisce l’ontologia implicita della tua azienda, cosa intendi per cliente, per contratto e per scadenza, la seconda cerca la risposta vera. Solo la seconda parte produce qualcosa che ti serve, la prima la paghi in token a ogni chiamata, e alla chiamata successiva ricomincia da capo.

Lo argomenta un post che gira su LinkedIn in questi giorni, scritto da chi costruisce sistemi multi-agente e si è accorto di bruciare i limiti di token non tanto sul lavoro richiesto, quanto sul preambolo: agenti che si spiegano a vicenda cosa significano le parole dell’azienda. L’ontologia, che per vent’anni è stata materia da convegno di knowledge management, ricompare come voce di costo.

Il conto dell’ambiguità arriva a ogni chiamata

Cliente vuol dire entità legale, account di fatturazione o capogruppo, e scadenza vuol dire fine del contratto o termine ultimo per disdire? In azienda si risponde in modo diverso a seconda di chi fa la domanda e in quale ufficio lavora, e nessuno ha mai avuto un motivo abbastanza forte per fissare quelle definizioni per iscritto.

Il costo di quell’ambiguità c’è sempre stato, distribuito in modo così fine da risultare invisibile: due dashboard che danno numeri diversi, la riunione del venerdì per decidere quale dei due si porta al consiglio, il commerciale che considera cliente il gruppo mentre l’amministrazione considera cliente la singola ragione sociale. Nessuna di queste voci è mai finita su una riga di bilancio.

Con gli agenti quel costo diventa misurato. Ogni esecuzione paga la ricostruzione del significato, la paga per ciascun agente coinvolto, e la paga una terza volta quando due agenti arrivano a interpretazioni diverse e devono riconciliarle fra loro. Fai il conto con numeri inventati ma coerenti: una routine che gira dieci volte al giorno, tre agenti che ogni volta ricostruiscono lo stesso perimetro di significato, trenta giorni, e arrivi a novecento ricostruzioni mensili della stessa definizione, che sarebbe bastato scrivere una volta sola.

Un’ontologia implicita ce l’hai già

Non avere un’ontologia non vuol dire non averne una, vuol dire averne una per agente, scritta senza deliberazione da chi ha toccato per ultimo il prompt di sistema o la pipeline di retrieval. Uno sviluppatore che decide come filtrare la tabella dei clienti sta prendendo una decisione commerciale, e nessuno gliel’ha chiesto.

È lo stesso meccanismo che ho descritto parlando di chi scrive il protocollo quando due agenti non sono d’accordo: dove l’organizzazione non ha deliberato niente, la deliberazione avviene lo stesso, dentro un file di configurazione, per mano di qualcuno che stava lavorando ad altro e aveva bisogno di andare avanti.

Scrivere l’ontologia serve soprattutto a spostare quella decisione dove appartiene. La definizione di cliente riguarda chi vende e chi firma i contratti, dovrebbe arrivare all’agente già stabilita, e dovrebbe essere la stessa per il report al consiglio e per la routine notturna che manda i solleciti.

Quattro passaggi invece di quaranta documenti

Un’organizzazione è uno spazio di ricerca enorme. La risposta sui contratti in scadenza sta sparsa fra il CRM, il repository contrattuale e il sistema di fatturazione, e un agente che parta da zero ha davanti a sé migliaia di documenti che nominano quel cliente senza dire niente di utile sulla sua scadenza.

Un knowledge graph costruisce la rete stradale fra quei sistemi: cliente, entità contraente, contratto, data di scadenza, record di origine. L’ontologia stabilisce cosa significano quelle relazioni, il grafo collega le entità reali e punta ai record dove sta il dettaglio. I documenti restano dove sono, nei sistemi che li hanno generati, e l’agente autorizzato percorre quattro collegamenti invece di aprire tutto quello che contiene la parola cliente.

Il risparmio nasce dal riuso, e vale la pena dirlo perché è facile aspettarsi troppo. Le definizioni all’agente gliele devi comunque passare, occupano comunque spazio in finestra, e il vantaggio sta nel passarle una volta nella forma decisa dall’azienda invece di farle dedurre a ogni giro da quello che capita sotto mano. Sposti un lavoro di inferenza che oggi avviene a runtime, ogni volta uguale e ogni volta un po’ diverso, dentro un artefatto deciso una volta e conservato.

L’informazione in azienda abbonda, la finestra di contesto no. Buona parte del lavoro serio sugli agenti gira intorno a questo vincolo, e il grafo lo affronta dall’esterno, riducendo le chiamate di retrieval e il contesto irrilevante che finisce in finestra a ogni giro.

In Pelle Digitale ho descritto la superficie sottile che ci separa dalle macchine e decide cosa passa. Dentro un’azienda quella superficie prende una forma burocratica, ed è l’ontologia a stabilire cosa un agente può vedere del modo in cui lavori, in quale ordine e con quale grado di dettaglio.

Costo per risposta corretta, manutenzione inclusa

L’autore del post chiude con il criterio che userebbe per decidere se la struttura vale la spesa: costo per risposta corretta su compiti ripetuti, manutenzione compresa. Il criterio mi pare solido, e ha un presupposto scomodo.

Per misurare il costo per risposta corretta devi sapere quali sono le risposte corrette. Serve un insieme di casi con la risposta nota, tenuto aggiornato, contro cui far girare il sistema ogni volta che cambia qualcosa. Quasi nessuna azienda ce l’ha, quasi nessuno lo mette a budget, perché non produce niente che si possa mostrare in una demo. Il progetto ontologia e il progetto valutazione sono lo stesso progetto, e il secondo è quello che salta quando il budget si stringe. Scrivendo del middleware che smista le richieste ai modelli ero arrivato allo stesso punto da un’altra direzione: i dati di valutazione interni valgono più del modello che scegli.

La manutenzione è l’altra metà del conto. Un’ontologia che nessuno aggiorna quando cambia la struttura societaria, quando si acquisisce un ramo d’azienda, quando il contratto tipo viene riscritto, comincia a produrre risposte sicure e sbagliate. Un agente senza ontologia brucia token e resta nel dubbio, e nel dubbio chiede. Un agente con un’ontologia vecchia costa pochissimo e non chiede niente a nessuno.

Perché l’aggiornamento avvenga davvero serve che qualcuno lo debba fare, con nome e cognome, e che il momento in cui farlo sia agganciato a processi che in azienda esistono già: la delibera che approva un’acquisizione, la riscrittura del contratto quadro, il cambio di ragione sociale registrato in anagrafica. Un’ontologia mantenuta da un gruppo di lavoro che si riunisce quando riesce dura un paio di trimestri, poi resta lì a rispondere con le categorie di due anni prima mentre tutti si fidano.

Sapere cosa significa non basta per agire

Ad agosto, leggendo la mappa di Fanghua Yu sull’evoluzione dell’ontologia dalla semantica formale agli agenti, mi ero fermato su dove finisce l’ontologia e comincia l’agente: sapere cosa significa un ordine non dice niente su chi sia autorizzato ad agire su quell’ordine oggi, e su chi possa revocare quel permesso domani mattina.

Le due cose conviene costruirle insieme. Il grafo che fa risparmiare token è lo stesso che delimita il perimetro, perché un agente che percorre collegamenti invece di rovistare fra i documenti rende quei collegamenti il posto naturale dove scrivere chi passa e chi si ferma. Chi costruisce l’ontologia per la bolletta e rimanda il permesso a una fase successiva si ritrova con una rete di strade senza caselli, percorribile da qualsiasi agente sia stato collegato quella settimana.

La bolletta dell’inferenza sta diventando il primo strumento che mette un prezzo sull’ambiguità organizzativa, e lo fa in fondo al mese, su una riga sola, senza distinguere fra quanto hai speso per rispondere e quanto per capire la domanda. Le aziende che spenderanno meno saranno quelle che avevano già scritto cosa intendono per cliente prima che arrivassero gli agenti a chiederlo, dieci volte al giorno, ognuno per conto proprio.


Spunto: un post su LinkedIn dedicato alle ontologie come leva di risparmio sui token nei sistemi multi-agente, che rimanda alla raccolta The Knowledge Graph Guys.

Chi decide quando due agenti AI non sono d’accordo

Al tavolo di un cliente, qualche settimana fa, la riunione si è fermata su una domanda che non era tecnica. Avevano due agenti AI quasi pronti, uno che istruisce le pratiche e uno che interroga i sistemi di rischio, e a un certo punto qualcuno ha chiesto cosa succede quando il secondo contraddice il primo. Il silenzio che è seguito non era imbarazzo. Quella regola non stava scritta da nessuna parte nemmeno per le persone che facevano lo stesso identico lavoro il giorno prima, e per quindici anni era bastato così, perché c’era un capo servizio che la teneva in testa e la applicava caso per caso, con criteri che nessuno gli aveva mai chiesto di dettare.

Da un paio d’anni ripeto una cosa che sembra ovvia e nella pratica non lo è mai: mettere più modelli linguistici dentro lo stesso spazio computazionale non produce da sé né i benefici né i rischi. Li produce il modello di coordinamento che gli diamo, e quel modello va scritto, in forma esplicita, con protocolli, criteri, autorità. Attendersi che il valore emerga da solo da un collettivo di macchine è la versione tecnologica della speranza che un’orchestra suoni bene perché i musicisti sono bravi.

La parte scomoda arriva subito dopo: progettare un modello di coordinamento presuppone che da qualche parte, in azienda, ce ne sia già uno leggibile da cui partire, e quasi nessuna organizzazione ce l’ha.

Il collettivo di agenti AI eredita quello che trova

Un sistema di agenti AI messo in produzione dentro un’azienda non arriva su una tabula rasa, si innesta sul modo in cui quell’azienda coordina già le proprie persone. Dove quel modo è esplicito, e capita nelle filiere regolate, nella logistica, in parte della sanità, gli agenti trovano un substrato: chi ha l’ultima parola su cosa, quale eccezione va scalata a chi, entro quanto, con quale traccia. Il collettivo computazionale eredita una grammatica e ci si appoggia.

Dove invece il coordinamento vive nella testa di sette persone anziane e in una manciata di chat, non c’è niente da ereditare. E quel vuoto lo riempie chi integra, il martedì pomeriggio, con la scelta di implementazione che gli sembra più ragionevole in quel momento. È così che il modello di coordinamento di un’impresa finisce dentro un file di orchestrazione senza che nessuno l’abbia mai deliberato, e senza che nessuno se ne accorga finché non arriva la prima contestazione seria.

Avevo affrontato la stessa questione dal lato del significato quando scrivevo di ontologia come infrastruttura invisibile: lì il problema era che un agente non sa cosa vuol dire “cliente attivo” se l’azienda non l’ha mai definito. Qui il problema è gemello e sta un piano sopra, perché anche sapendo cosa significa un ordine bisogna ancora stabilire chi può agire su di esso, e chi può fermare l’altro.

Quando il protocollo fra due uffici non esiste

Di questi progetti il pezzo più utile matura molto prima della messa in produzione, e non ha niente di tecnologico. Provare a scrivere il protocollo di coordinamento fra due agenti AI costringe a scoprire che non esisteva nemmeno fra due uffici.

Nelle sessioni di assessment che conduco succede quasi sempre lo stesso movimento: si parte con la domanda su quale modello usare, si finisce a ricostruire chi ha l’autorità di annullare una decisione presa da qualcun altro, e quanto vale quell’autorità dopo che la decisione è già stata comunicata al cliente. Sono domande di governance che l’azienda si porta dietro irrisolte da anni, tollerabili finché a coordinare erano persone che si conoscono e si telefonano, insostenibili nel momento in cui il coordinamento passa a un collettivo di agenti AI che esegue e basta.

Su questo tema ho una posizione che ripeto da un po’: la vera unità di misura di un agente non è quello che sa fare, è il permesso revocabile sotto cui lo fa. La maturità di un’organizzazione cognitiva si misura sulla capacità di dire, per ciascun agente in circolazione, chi gliel’ha concesso, fino a quando, e con quale gesto glielo si toglie.

La gavetta era il posto dove passava il criterio

C’è una trasformazione che vedo sottovalutata quasi ovunque, e riguarda l’apprendimento. Questi sistemi si sono messi in mezzo fra le persone e la conoscenza di come si fanno le cose, e il primo posto dove si sono infilati sono i compiti di gavetta, quelli che nelle organizzazioni funzionavano da palestra per chi comincia. Una generazione intera rischia di perdere le occasioni di imparare che tutte le precedenti hanno avuto.

Dal mio tavolo si vede bene una cosa in più. La gavetta non serviva solo a formare chi la faceva. Era il momento in cui il criterio implicito veniva tirato fuori dalla testa del senior e messo in parole, malamente, di corsa, davanti a una pratica sbagliata da rifare, e in quell’attrito il criterio si riformulava ogni volta un po’ diverso e un po’ più preciso. Toglila di mezzo e non perdi soltanto il canale di trasmissione verso i giovani, perdi la sola occasione in cui l’azienda si spiegava a voce alta come funziona.

È il debito cognitivo nella sua forma meno visibile: non si accumula quando deleghiamo l’esecuzione, si accumula quando deleghiamo l’occasione di dover spiegare. Sulla superficie di contatto fra noi e le macchine si decide ogni giorno cosa passa e cosa no, e continuo a pensare che la parte da tenere di qua sia proprio quella, il momento in cui qualcuno è costretto a dire perché.

Governare uno strumento, non attendere un’entità

Nelle conversazioni con i board torna spesso l’idea, che si associa di solito a Nick Bostrom, dell’intelligenza artificiale come ultima invenzione che l’umanità dovrà fare, quella che poi risolverà i problemi troppo grandi per noi. È una formula che semplifica parecchio, e soprattutto colloca l’AI in una zona fuori portata, dove le decisioni le prende lei e a noi tocca aspettare l’esito.

Trovo che la cornice messianica, in azienda, faccia un danno preciso e poco spettacolare. Se l’AI è un destino, la cosa sensata da fare è aspettare, magari fare un pilota per dire che ci si sta muovendo, e rimandare. Se invece è uno strumento, la cosa sensata da fare è noiosa e comincia lunedì: scrivere il protocollo, assegnare le autorità, decidere dove gira il calcolo e con quali termini, verificare di poterli revocare. La narrazione dell’entità super intelligente è comoda perché sposta la responsabilità dal consiglio di amministrazione a un futuro indeterminato.

Della sovranità digitale ho parlato spesso come di una questione di infrastruttura, e lo è, ma la sua metà meno raccontata sta qui: sovrano è chi ha scritto le regole con cui i propri agenti AI si parlano e può cambiarle senza chiedere il permesso a un fornitore, molto più di chi si limita a ospitarli dentro il proprio perimetro.

Chi scrive il protocollo

La domanda più fastidiosa arriva alla fine, ed è chi materialmente questo lavoro lo fa. Il vendor porta un default ragionevole, calibrato su mille clienti diversi dal tuo, e non può fare altrimenti. L’integratore chiede le regole all’azienda e si vede consegnare un documento di processo del 2019 mai più aggiornato. All’IT da solo non si può lasciare, perché le regole di coordinamento fra agenti AI sono decisioni di business travestite da configurazione.

Nelle poche organizzazioni dove ho visto funzionare, il protocollo l’hanno scritto le persone che il lavoro lo fanno, sedute in una stanza per settimane, con qualcuno che faceva domande scomode e trascriveva. Costa parecchio e non produce nessuna demo da mostrare in comitato. Ed è l’unica parte del progetto che l’azienda si tiene anche se cambia modello, fornitore e architettura tre volte in cinque anni.

Se davvero l’era agentica ci obbliga a mettere per iscritto come coordiniamo il lavoro, allora l’effetto più duraturo dell’AI in azienda potrebbe non avere niente a che fare con le macchine, e riguardare il fatto che per la prima volta molte imprese saranno costrette a leggere ad alta voce come funzionano davvero. Vediamo quante reggono la lettura.