Azienda agentica: gli otto strati da progettare prima dell’interfaccia

Da prima di agosto ho messo da parte, uno dopo l’altro, gli schemi con cui i grandi fornitori di software aziendale raccontano la loro offerta di intelligenza artificiale, per studiarli: quello di uno dei CRM più diffusi, quello della suite d’ufficio che quasi tutti abbiamo sul portatile, quelli delle piattaforme verticali per la logistica e la distribuzione e così via. Cambiano i nomi, cambiano i colori, a volte i prodotti cambiano nome da un mese all’altro e chi prova a seguirli fatica a capire cosa sia stato annunciato e cosa porta veramente di differente sul mercato.

Messi uno accanto all’altro, però, disegnano la stessa torre, e ognuno a modo suo descrive l’azienda agentica.

In basso ci sono i sistemi dove vive la verità aziendale, sopra di loro uno strato che trasforma i dati in contesto leggibile da un modello, sopra ancora gli agenti che ragionano e agiscono, e in cima un’interfaccia conversazionale dove le persone fanno domande e approvano azioni.

Attorno a tutto, disegnato come una cornice e quasi mai come un piano, l’insieme di servizi che nessuno compra a parte, che spesso vanno decisi e scritti proprio internamente e che, però, tiene in piedi la costruzione: permessi, sicurezza, tracciamento delle azioni, valutazione dei risultati.

La torre descrive bene dove stanno andando le aziende dal mio punto di vista.

Gli schemi lasciano fuori, perché a chi li disegna conviene darlo per scontato, una domanda molto specifica e importante: chi possiede gli strati bassi?

Dove gira il modello, dove viene assemblato il contesto, chi può leggere il registro di quello che gli agenti hanno fatto.

Su questa domanda ho costruito il lavoro di questo ultimo anno da quando ho fondato ZeroFive.AI e che sto portando nei progetti con le aziende, con LocalAI sull’inferenza locale e con Gideon, l’ultimo nato, l’assistente che uso ogni giorno come banco di prova. In questo approfondimento provo a descrivere in modo puntuale e sintetico (nemmeno troppo) l’approccio per intero, senza marchi di fornitori, perché questa architettura dell’azienda agentica vale anche per chi non comprerà mai una licenza da nessuno di loro.

Otto strati dell’azienda agentica, letti dal basso

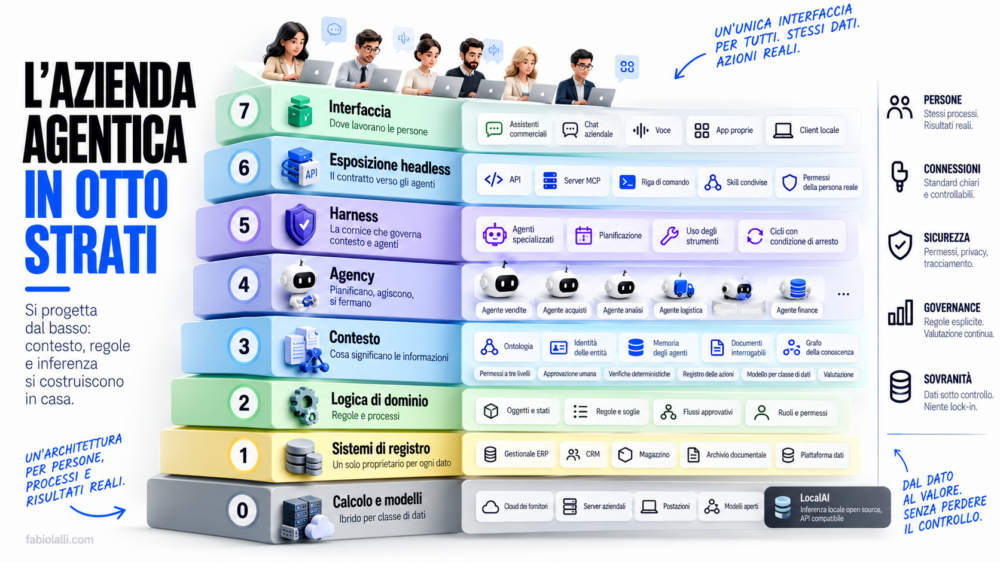
La versione astratta della torre, quella che vale per qualunque azienda agentica, ha 8 strati. Li descrivo partendo dal basso perché è l’ordine in cui andrebbero progettati, anche se quasi tutti i progetti che incontro partono dall’alto, dalla scelta dell’assistente da comprare per i dipendenti, o dal modello o dalla tecnologia in generale.

Strato Cosa contiene Domanda da fare prima di costruirlo
0. Calcolo e modelli dove gira l’inferenza: cloud, server aziendali, postazioni quali dati possono raggiungere quale modello?
1. Sistemi di registro gestionale, CRM, archivi documentali, magazzino per ogni dato, qual è l’unico sistema proprietario?
2. Logica di dominio oggetti, regole, flussi approvativi, permessi quali regole oggi stanno solo nella testa di qualcuno?
3. Contesto identità delle entità, ontologia, memoria degli agenti, testi vettorizzati cosa significano le informazioni e chi lo decide?
4. Agency ragionamento, pianificazione, agenti specializzati, cicli di esecuzione quali compiti si delegano e con quale condizione di arresto?
5. Harness governo, sicurezza, osservabilità, valutazione, scelta del modello cosa può fare un agente senza chiedere, e chi lo verifica?
6. Esposizione headless API, server MCP, riga di comando, skill quale contratto vede chi sta sopra?
7. Interfaccia assistenti commerciali, chat aziendali, voce, app proprie dove lavorano già le persone?

Lo strato zero è quello che nessuno compra e tutti pagano. Nella torre dei fornitori coincide con il loro cloud e non compare quasi mai nei disegni, eppure decide dove finisce ogni frase che un agente legge, e quanto costa leggerla.

Sopra stanno i sistemi di registro, che le aziende conoscono da trent’anni e che con l’arrivo degli agenti chiedono una sola regola, la più difficile da rispettare: ogni dato ha un solo sistema proprietario, e tutti gli altri lo citano invece di copiarlo. Un’anagrafica cliente duplicata in due posti produce, dopo pochi mesi, due verità su chi decide in quell’azienda, e un modello che le legge entrambe sceglie a caso quale riportare.

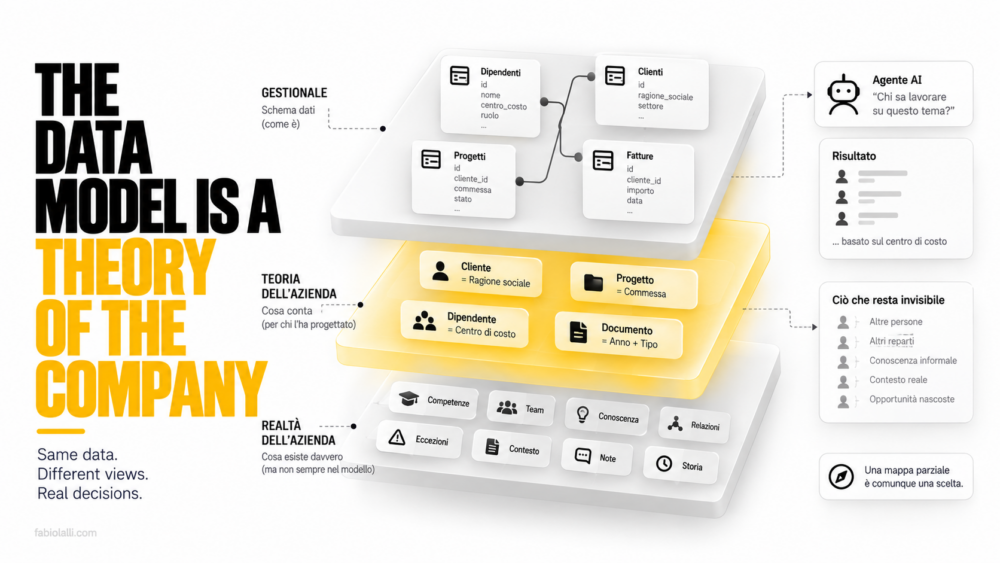
La logica di dominio è lo strato che trasforma i dati in processi. Un ordine ha uno stato, uno sconto oltre una certa soglia richiede una firma, un fornitore nuovo passa da una verifica prima di ricevere il primo pagamento. Molte di queste regole vivono nel codice dei gestionali, molte altre in procedure che qualcuno ha scritto anni fa, e una parte consistente solo nell’abitudine di chi fa quel lavoro da tanto tempo. Il modello dati è una teoria dell’azienda, e gli agenti la ereditano così com’è, con le scelte fatte da un consulente dieci anni fa per far quadrare la contabilità analitica.

Il contesto è lo strato dove l’azienda dice a un modello cosa significano le sue informazioni: che “cliente” in amministrazione vuol dire chi ha una fattura aperta e in commerciale chi ha un’opportunità attiva, che due nomi diversi indicano la stessa persona, quale decisione presa in una riunione di marzo ha superato quella di gennaio. Qui stanno l’ontologia, la risoluzione delle identità, la memoria di lungo periodo degli agenti e il testo dei documenti reso interrogabile. Sopra lavora l’agency, cioè la parte che pianifica, sceglie gli strumenti, esegue e controlla il risultato in un ciclo che si ripete finché non scatta una condizione di arresto.

L’harness ha un numero in tabella per comodità, ma nel disegno andrebbe tracciato come una cornice attorno al contesto e agli agenti. È tutto quello che serve a un agente in produzione e che non è il modello: i permessi con cui agisce, le regole che decidono quando deve chiedere, il registro di quello che ha fatto, le verifiche automatiche sui risultati, la scelta di quale modello usare per quale classe di dati.

Sopra ancora c’è l’esposizione headless, che rende disponibile tutto quello che sta sotto senza bisogno di uno schermo, attraverso API, server MCP, riga di comando e skill.

In cima l’interfaccia, che grazie ai due strati precedenti può essere quasi qualunque cosa.

L’interfaccia esce dal centro del progetto

Per vent’anni il software aziendale ha coinciso con il suo schermo. Si comprava una licenza per ogni postazione, si formavano le persone sull’interfaccia, si misurava l’adozione contando quanti accessi faceva ciascuno ogni settimana, e il fornitore teneva il cliente proprio attraverso quell’abitudine visiva: cambiare CRM voleva dire riaddestrare centinaia di persone a cliccare in posti diversi. Il valore stava sopra, nell’interfaccia, e i dati sotto erano il prezzo da pagare per usarla.

Nell’azienda agentica questo rapporto si rovescia. Le persone lavorano dentro l’assistente che preferiscono, un client commerciale, la chat aziendale, la voce in macchina, e chiedono a quell’assistente di andare a prendere le informazioni dove si trovano e di agire per loro conto. In Pelle Digitale avevo provato a descrivere l’interfaccia come il punto di contatto fra la persona e il sistema digitale che la circonda; con gli agenti quel punto si moltiplica e si assottiglia, diventa una superficie che cambia a seconda del momento e del dispositivo, e domani anche dello spazio fisico, come racconto in Spatial Shift. Il prodotto che un’azienda deve costruire verso i propri agenti non è più uno schermo, è un contratto: quali operazioni si possono chiedere, con quali permessi, con quali garanzie sul risultato.

Il Model Context Protocol è oggi la forma più diffusa di quel contratto, e il motivo per cui lo strato sei della tabella è diventato progettabile da un’azienda di medie dimensioni senza un esercito di sviluppatori. Un server MCP espone gli strumenti di un sistema a qualunque client compatibile, e lo stesso server serve il dipendente che usa un assistente commerciale, il collega che preferisce un client locale e l’agente notturno che prepara i report del lunedì. La regola che tengo ferma in ogni progetto riguarda l’identità: il modello opera sempre con i permessi reali della persona che lo sta usando, mai con un’utenza tecnica capace di tutto.

C’è un test semplice per capire a che punto è un’azienda, e lo propongo spesso nelle prime riunioni.

Se domani i dipendenti cambiassero assistente, quanto lavoro andrebbe rifatto?

Quando la logica vive nei prompt salvati dentro il prodotto di un fornitore, nelle sue memorie e nei suoi agenti preconfigurati, va rifatto quasi tutto. Quando vive negli strati dal tre al sei, il cambio è una configurazione, e la scelta dell’assistente torna a essere una decisione su costo e riservatezza.

C’è un lavoro enorme da fare ed è sottovalutato

Nelle dimostrazioni un agente risponde in pochi secondi a una domanda sul portafoglio clienti, prepara una bozza di offerta e propone il prossimo passo commerciale. In produzione lo stesso agente deve sapere che la parola “cliente” ha tre significati in tre uffici, non deve leggere i margini se la persona che lo interroga non è autorizzata a vederli, deve lasciare traccia di quello che ha fatto e deve fermarsi quando la confidenza è bassa. Tutto questo vive in due strati che nelle demo non si vedono, il contesto e l’harness, ed è lì che passa la maggior parte del tempo di un progetto serio.

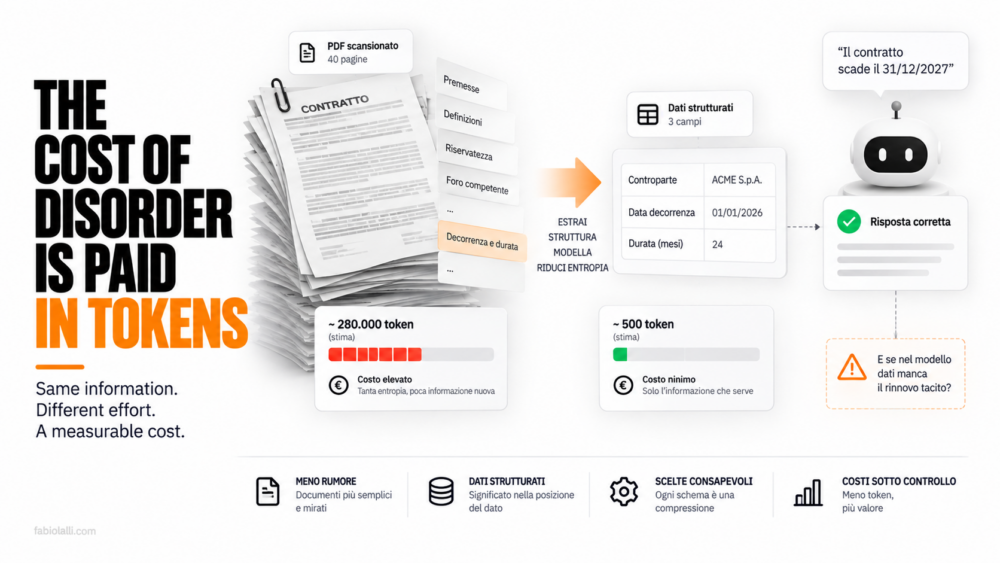
Sul contesto ho scritto molto in queste settimane, e nelle aziende lo riduco a una regola: il significato va deciso prima che lo decida un modello. Un modello collegato a dati senza tipi e senza relazioni dichiarate ricostruisce da solo il senso delle cose, ogni volta in modo leggermente diverso, e due risposte alla stessa domanda a una settimana di distanza smettono di coincidere. Un’ontologia operativa fissa i tipi di oggetto, le relazioni e le azioni ammesse su ciascuno, e ha un effetto collaterale che i direttori finanziari capiscono subito: riduce i token che un agente spende per orientarsi. Lo stesso vale per la quantità di materiale che si carica nella finestra di contesto, dove il superfluo compete con quello che serve invece di essere scartato.

L’harness è lo strato su cui i fornitori sono più indietro, e lo dicono loro stessi. In almeno uno degli annunci più ambiziosi di quest’autunno, governo e sicurezza compaiono fra le capacità della piattaforma con l’annotazione che sono in parte ancora da costruire. La parte del sistema che decide cosa può fare un agente senza chiedere, chi lo verifica e cosa rimane scritto dopo è quindi la meno matura nelle offerte chiavi in mano, e quella che chi costruisce un’azienda agentica ha più interesse a progettare in casa.

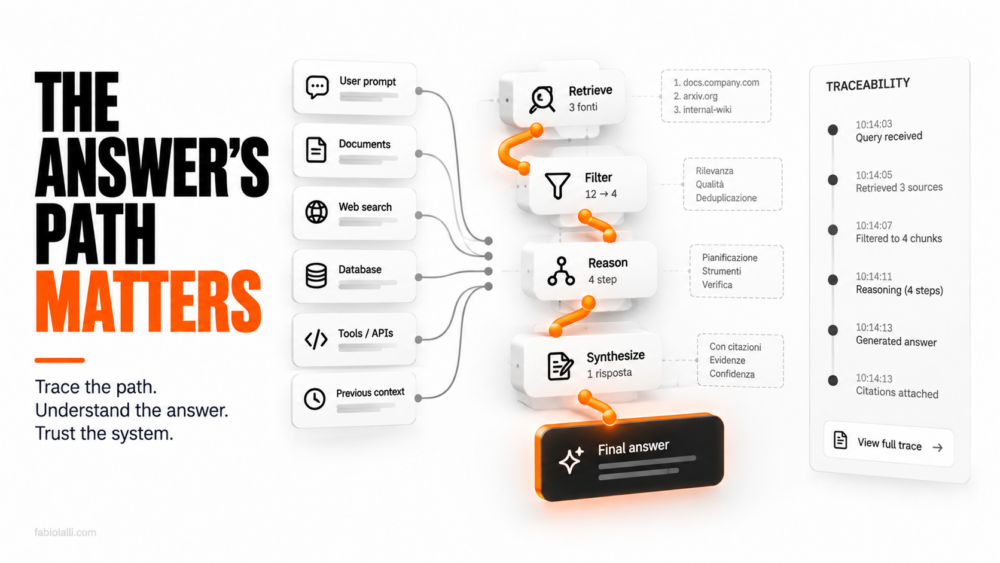
Nei progetti la scrivo prima degli agenti, con quattro famiglie di regole. I permessi sugli strumenti hanno tre livelli, negato, consentito con conferma, consentito senza conferma, e ogni strumento nasce al livello più restrittivo. Le scritture passano da un’approvazione umana: il modello propone, le persone firmano, e nessuna informazione entra nella memoria aziendale senza un responsabile con nome e cognome. Tutto quello che si può verificare in modo deterministico va tolto al giudizio del modello e affidato a uno script, dal totale di un preventivo alla validità di un pacchetto di modifiche. E ogni chiamata lascia una riga in un registro leggibile, con chi l’ha chiesta, quale modello l’ha eseguita e quali dati sono usciti dal perimetro.

Chi possiede gli strati bassi

Ogni volta che un agente lavora, il contesto viene assemblato e spedito al modello. Quel pacchetto contiene il distillato più prezioso che un’azienda produce: il modo in cui classifica i clienti, le decisioni prese e le ragioni per cui sono state prese, le relazioni fra persone, contratti e progetti. Nella torre dei grandi fornitori quel distillato viaggia verso un data center che non controlli, con le garanzie del contratto che hai firmato, a un prezzo calcolato a token che può cambiare alla prossima revisione del listino, su modelli che il fornitore può ritirare con qualche mese di preavviso. Sono condizioni accettabili per molte classi di dati, a patto di conoscerle prima della firma, cosa che capita molto meno spesso di quanto si pensi.

La sovranità di cui parlo con le aziende è una scelta per classe di dati, senza ideologia contro il cloud.

Il metodo che uso divide le informazioni in tre gruppi: quelle che possono uscire liberamente, come ricerche pubbliche e bozze di contenuti, quelle interne che possono uscire solo verso fornitori con garanzie contrattuali adeguate, quelle che non devono uscire per nessun motivo, come i dati economici riservati o i segreti industriali. Ai primi due gruppi si applica il modello più capace disponibile, al terzo un modello che gira dentro il perimetro, oppure un passaggio di anonimizzazione prima dell’invio.

Per molto tempo il terzo gruppo ha avuto poche soluzioni pratiche, perché i modelli aperti erano lontani da quelli commerciali e farli girare richiedeva competenze che un’azienda media non aveva in casa. Oggi lo strato zero si può possedere.

LocalAI, il progetto open source di inferenza locale di cui sono cofondatore e dove seguo il prodotto, nasce esattamente per questo: fa girare modelli aperti su hardware aziendale, dal server nel seminterrato alla workstation di un reparto, ed espone un’interfaccia di programmazione compatibile con quella dei principali fornitori commerciali. Gli strati che stanno sopra non si accorgono del cambio, e un’azienda può affiancare un modello locale a uno commerciale e smistare le chiamate in base alla classe del dato, senza riscrivere né il contesto né gli agenti.

L’azienda agentica che ne esce è ibrida quasi sempre, a mio avviso, e va bene così. Quello che cambia rispetto alla torre comprata intera è la posizione del cuore: ontologia, memoria, regole e registri restano dentro l’azienda, e il modello diventa un lettore che si può sostituire, affiancare o spegnere senza perdere nulla. Cambiare fornitore smette di essere un progetto di migrazione e diventa una riga di configurazione.

“Gideon” come banco di prova

Prima di proporre un’architettura a un’azienda la provo su di me. Gideon è il mio assistente personale, prende il nome dall’intelligenza artificiale di The Flash (Jarvis è troppo abusato ormai, anche io lo chiamavo così), e in questi mesi è diventato il posto dove verifico ogni strato della tabella con dati veri, i miei. Il principio di progettazione è lo stesso che porto nelle aziende: la memoria sta fuori dal modello, e il modello si può cambiare in qualunque momento.

Le funzioni su cui sto lavorando seguono gli strati quasi uno per uno. Gideon fa girare modelli locali e può affiancare modelli esterni quando il compito lo richiede, e già questo sposta la proprietà dello strato zero. Il lavoro parte da cartelle collegate e file caricati, perché la domanda più frequente che una persona fa a un assistente riguarda i propri documenti, e quei documenti devono essere interrogabili senza uscire dalla macchina. I connettori MCP, che sono la sua esposizione verso il resto del mondo, sono divisi in tre famiglie (interni all’assistente, servizi aziendali, servizi di terze parti) e per ciascuno il sistema propone una descrizione di quando usarlo, che l’utente può correggere.

L’harness è la parte dove ho investito di più. Ogni strumento ha i tre livelli di permesso, dal divieto all’esecuzione senza conferma. Una protezione della riservatezza si attiva nel campo dove si scrive la richiesta e lavora anche quando la richiesta va verso un modello esterno, togliendo dal testo quello che non deve uscire. E una pagina sullo stato del sistema mostra i consumi, le chiamate e soprattutto le uscite di dati verso terzi e verso i connettori, perché un’azienda che non sa cosa è uscito ieri non può decidere cosa far uscire domani.

Nessuna di queste funzioni è una scoperta. Ognuna esiste già da qualche parte, sparsa fra prodotti diversi, e quello che manca quasi sempre è la loro composizione in un unico sistema dove il cuore rimane in mano a chi lo usa. Gideon serve a me per capire quanto costa questa composizione, dove si inceppa e quali scelte sopravvivono al passaggio da una persona a un team.

Come accompagno un’azienda dentro lo stack

Il lavoro con le aziende comincia quasi sempre da una richiesta che sta in cima alla torre: quale assistente comprare, come portare gli agenti nel servizio clienti, come far parlare il CRM con la chat aziendale. La prima cosa che faccio è rimettere la torre in piedi, e disegnare con il team la mappa dei suoi otto strati com’è oggi. Per ogni strato scriviamo chi ne è proprietario, quale contratto espone allo strato superiore e se si potrebbe sostituire senza toccare gli altri. Le mappe che ne escono si somigliano spesso: i sistemi di registro esistono e funzionano, la logica di dominio è per metà nel software e per metà nelle persone, il contesto manca, l’harness manca, l’interfaccia è stata già comprata da qualcuno.

Da lì il percorso sale dal basso.

La classificazione dei dati nei tre gruppi viene per prima, perché decide cosa si può fare allo strato zero e quali modelli possono leggere cosa. Poi la regola del sistema proprietario per ogni dato, e un’ontologia minima che fissa i tipi di oggetto, le relazioni e chi decide quando due fonti si contraddicono. Poi l’harness, scritto prima che esista un solo agente in produzione: permessi, approvazioni, verifiche automatiche, registro delle azioni. Solo a quel punto si espongono i sistemi attraverso server MCP con i permessi reali delle persone, si costruiscono le skill condivise che fanno parlare a tutti gli assistenti la stessa lingua aziendale, e si sceglie l’interfaccia, spesso più d’una, guardando dove le persone lavorano già.

In ZeroFive.AI questo percorso è organizzato in cinque fasi, ALIGN, ASSESS, ARCHITECT, ACTIVATE e AMPLIFY (come si vede nell’immagine), con cancelli decisionali fra l’una e l’altra che il cliente deve superare prima di spendere nella fase successiva.

Il rischio legato all’AI si misura nella fase di valutazione e non a sistema già acceso, e nessun caso d’uso entra nel portafoglio senza un confronto scritto con l’alternativa che non usa l’intelligenza artificiale, perché in una parte dei casi uno script ben fatto risolve lo stesso problema a una frazione del costo.

Il “Workspace progetti” per esempio, la piattaforma con cui gestiamo i progetti dei clienti in ICONICO e Zerofive, è il caso che porto come esempio in aula per far vedere come facciamo le cose: molte delle regole descritte qui, dal sistema proprietario per ogni dato all’approvazione umana delle proposte, sono già in produzione al nostro interno, ed è il modo più rapido per mostrare a un’azienda come funzionano prima che decida se costruire le proprie.

C’è poi la parte che nessun diagramma che di solito non si trova, e cioè le persone.

Il corso che sto portando nelle business school e nei percorsi aziendali è costruito su quattro discipline che corrispondono a 4 zone della torre: prompt engineering per l’interfaccia, context engineering per lo strato del contesto, loop engineering per gli agenti, harness engineering per la cornice che li governa.

Un’azienda che compra uno stack senza avere nessuno capace di ragionare su queste quattro zone si ritrova un sistema che funziona finché funziona, e che nessuno sa correggere quando cambia qualcosa e che soprattutto nessuno sa avere potenzialità più avanzate.

Chi vuole capire da dove partire nella propria organizzazione può scrivermi: la prima mappa degli otto strati si costruisce insieme alle persone che conoscono davvero i sistemi, e dice già molto su quali investimenti fatti finora sono riutilizzabili e quali andranno rifatti. 

Fondamenta da tenere in casa

Nei prossimi due anni l’interfaccia cambierà più volte.

Gli assistenti di oggi verranno rinominati, accorpati, sostituiti da altri che ancora non conosciamo, e una parte del lavoro passerà dalla chat alla voce e agli ambienti.

Un’azienda agentica che avrà costruito in casa il contesto, l’harness e l’esposizione dei propri sistemi cambierà assistente con la stessa facilità con cui oggi si cambia browser, e sceglierà ogni volta il modello più adatto alla classe di dati che deve trattare.

Chi avrà comprato la torre intera tratterà ogni anno con il fornitore il prezzo di accesso al proprio contesto, cioè alla descrizione più accurata di sé che abbia mai prodotto. La torre la disegneranno i fornitori, ed è giusto che sia così; le fondamenta conviene che ogni azienda le tenga a casa propria.
L’ontologia che ti lascia cancellare un ordine

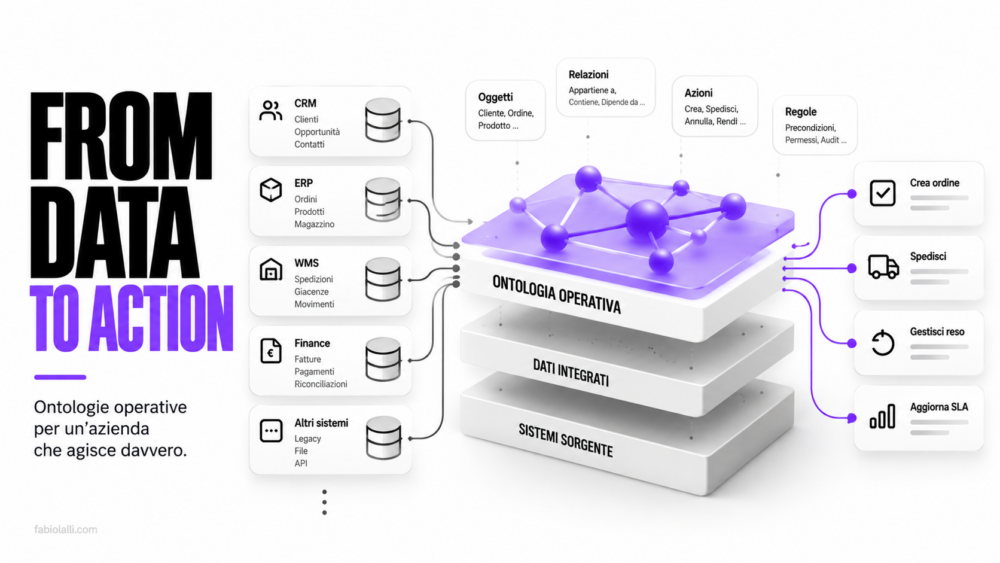
Il cruscotto dice che l’ordine 4471 è fermo da sei giorni. Lo guardano il direttore commerciale, il customer care e da qualche mese anche l’agente che presidia gli SLA, tutti sulla stessa dashboard, tutti con lo stesso numero davanti. Per cancellarlo qualcuno deve aprire il gestionale, cercare la riga a mano e sapere che un ordine già uscito dal magazzino non si annulla, si gestisce come reso.

Quella distanza fra il livello dove guardi e il livello dove agisci è il residuo di dieci anni di piattaforme dati. Abbiamo costruito data lake, poi lakehouse, poi semantic layer, e ci siamo ritrovati un’azienda che si vede benissimo e che continua a muoversi dentro i sistemi sorgente, ognuno con le sue regole, scritte in epoche diverse da persone che non si sono mai parlate.

Il primo agosto un ingegnere che firma gura105 ha pubblicato su dev.to il risultato di settimane passate a smontare Palantir Foundry per capire cosa sia davvero quella cosa che in Palantir chiamano Ontology. Ne ha ricavato un nome, ontologia operativa, e quattro proprietà che si possono verificare una per una su qualunque sistema. Poi ha messo su GitHub un’implementazione di riferimento in TypeScript, licenza MIT, piccola abbastanza da leggersi in una sera, con il README anche in giapponese.

Il modello di dominio fuori dall’applicazione

Lo sviluppo di un’applicazione gestionale funziona da sempre nello stesso ordine: raccogli i requisiti, modelli il dominio, crei le tabelle che quel modello richiede, ci costruisci sopra l’applicazione. Foundry, scrive gura105, è quello stesso mestiere eseguito al contrario. I dati fisici esistono già, sono di qualcun altro, nessuno te li ha disegnati addosso, e il modello di dominio arriva dopo, sopra, come strato condiviso da cui pescano tutte le applicazioni. Un’ontologia operativa nasce esattamente da qui, dal prendere atto che i dati non li ha ordinati nessuno per te e che il modello va costruito sopra quello che c’è.

Il rovesciamento sembra un dettaglio di sequenza ed è una scelta di proprietà. Nel modo classico le regole di business vivono dentro l’applicazione che possiede le tabelle, e ogni altro consumatore o le riscrive per conto suo o le scavalca. Chi ha già lavorato su un’integrazione fra CRM e gestionale sa esattamente di cosa parlo: la regola che un ordine spedito non si cancella esiste in tre punti diversi, formulata in tre modi diversi, e almeno uno dei tre è sbagliato.

Palantir descrive la sua Ontology come un livello operativo dell’organizzazione che sta sopra gli asset digitali integrati nella piattaforma, e la divide in elementi semantici, cioè oggetti, proprietà e relazioni, ed elementi cinetici, cioè azioni, funzioni e sicurezza dinamica. La parte semantica la conosciamo tutti, è quella di cui ho scritto parlando di ontologie e grafi di conoscenza. La parte cinetica è quella che nessun semantic layer ha mai avuto, e coincide con il motivo per cui Foundry costa quello che costa.

C’è un vantaggio pratico in questa inversione, ed è il motivo per cui la trovo adatta alle aziende italiane più di quanto sembri. Non chiede di migrare niente. Il gestionale del 2011 resta dov’è, con la sua teoria implicita dell’azienda scritta da un consulente che non c’è più, e sopra ci metti un modello che dice cosa significano davvero cliente, ordine e prodotto oggi, senza toccare una riga di quelle tabelle.

Un semantic layer non cancella un ordine

Le quattro proprietà che fanno di un sistema un’ontologia operativa sono un test, non una certificazione, e gura105 le ha scritte in modo che siano verificabili guardando il comportamento di quel sistema invece che la sua brochure.

La prima chiede che oggetti e relazioni siano modellati esplicitamente sopra dati fisici che esistevano prima e che appartengono ad altri. La seconda chiede che lo stato cambi solo attraverso azioni con un nome, senza nessun percorso di aggiornamento generico, né per l’utente né per l’applicazione né per l’agente. La terza chiede che le regole di dominio stiano dentro l’azione, come precondizioni che rifiutano le violazioni con errori leggibili da una macchina, e che ogni tentativo finisca nel registro, compresi quelli respinti. La quarta chiede che il modello dichiari, per ogni pezzo di stato, quale sistema ne è proprietario, e che le modifiche tornino indietro verso quel sistema.

Il test che le riassume sta in una domanda da fare in riunione, dal vostro semantic layer si può cancellare un ordine? Se la risposta è no, avete un livello di lettura, che è una cosa utile e diversa. Se è sì ma nessuna riga cambia in nessun sistema di record, avete un database parallelo che fra sei mesi diverge dal gestionale e nessuno saprà quale dei due ha ragione. Se cancella anche gli ordini già spediti senza fare una piega, avete una write API, e la terza proprietà è tutta la differenza.

Lo scenario del demo è volutamente banale, ed è per questo che funziona. Un’azienda ne compra un’altra e si ritrova due sistemi ordini legacy, schemi diversi, codifiche di stato diverse, la solita eredità che in Italia conosciamo bene dopo ogni operazione straordinaria. Qualche decina di righe di SQL li integra, l’ontologia modella sopra cliente, ordine e prodotto, e aggiunge un tipo che in nessuno dei due sistemi esiste: la nota. Poi il demo attraversa la relazione per rispondere a quali ordini contengono un certo prodotto pescando da entrambi i sistemi, assegna un ordine a una persona scrivendo uno stato che nel legacy non ha nemmeno una colonna, si vede rifiutare la cancellazione di un ordine spedito, ne cancella uno aperto e la riga nell’ERP cambia davvero, poi ricarica le sorgenti e l’assegnazione sopravvive al refresh.

Dal permesso revocabile all’azione che lascia traccia

Ad agosto, commentando la mappa di Fanghua Yu sull’evoluzione dell’ontologia, avevo chiamato permesso revocabile quello che lui chiamava contratto semantico operativo: un agente che sa cos’è un ordine ma non sa se è autorizzato a rimborsarlo conosce metà della storia, e la parte che gli manca è fatta di precondizioni, evidenze, effetti e reversibilità. Quel pezzo si fermava dove finiva il concetto. Questo repository è il primo posto dove lo vedo messo in codice eseguibile, con i rifiuti che portano un codice e il registro che si scrive da solo.

Nel modello, le precondizioni sono una chiave obbligatoria. Una lista vuota va dichiarata, perché scrivere che un’azione non ha condizioni è una decisione che qualcuno deve prendersi, non un default che si eredita per distrazione. La dichiarazione di proprietà segue la stessa logica: ogni pezzo di stato è di qualcuno, e le possibilità sono tre. Quando il dato è mastered a monte, come lo status dell’ordine che vive nell’ERP, la modifica torna indietro verso quel sistema come effetto collaterale governato, e la sorgente conserva l’autorità. Per l’assegnatario o la nota di triage, che nel legacy non hanno nemmeno una colonna dove stare, il sistema di record diventa l’ontologia stessa, per dichiarazione esplicita e non per ripiego. Il terzo caso è lo stato calcolato, che non si scrive mai.

Quello che la proprietà vieta è lo stato senza padrone dichiarato, cioè la copia locale di un dato altrui che viene modificata e non torna mai indietro. È esattamente la situazione in cui si trovano parecchi progetti di data platform che ho visto passare sui tavoli negli ultimi anni, e che nessuno chiama con il suo nome finché non arriva la prima riconciliazione a mano.

Il runtime non si fida delle dichiarazioni, le verifica. Prima di eseguire qualunque azione valida i parametri, valuta le precondizioni, genera il piano di modifiche, lo prova a vuoto passando dallo stesso codice che userà per il commit, poi lo confronta con le dichiarazioni di proprietà e lo rifiuta se un’azione tocca stato del sistema di record senza averlo dichiarato, oppure se ne mescola due tipi nello stesso piano. Solo dopo scrive verso la sorgente, e solo alla fine committa le modifiche e la riga di registro in un’unica transazione.

L’ordine di quei passaggi porta con sé una scelta che va guardata bene. Il write-back gira prima del commit locale, quindi se l’ERP rifiuta non cambia niente da questa parte. Il fallimento opposto può comunque accadere: la sorgente accetta, il commit locale fallisce, i due sistemi divergono e la riconciliazione tocca a un essere umano. Il repository lo scrive in chiaro e aggiunge che la documentazione di Palantir ammette lo stesso buco nella propria modalità di write-back. Quella franchezza sul limite, per me, vale più di metà delle slide di architettura che mi capita di leggere, e andrebbe usata come criterio per valutare chiunque venda qualcosa di simile.

Il registro, intanto, tiene tutto: i tentativi applicati, quelli rifiutati, quelli andati in crash, con il piano completo. Sulla tracciabilità come prova di un’azione automatica torno spesso, e qui il materiale che l’AI Act chiede di saper ricostruire per i sistemi ad alto rischio, con un calendario che il Digital Omnibus ha rimesso in discussione, si produce da sé come sottoprodotto dell’architettura invece che come adempimento aggiunto dopo.

Le regole non stanno nel prompt

La superficie MCP viene generata dal modello. Uno strumento per ogni forma di interrogazione, uno per ogni azione, e nessuno strumento SQL grezzo, il che significa che un agente riceve esattamente le operazioni che il dominio definisce e nient’altro. Le stesse precondizioni che valgono per una persona valgono per lui, e quando prova a cancellare un ordine spedito si prende in faccia un SHIPPED_ORDER_CANNOT_BE_CANCELLED, un rifiuto che può leggere, da cui può recuperare e che può spiegare al suo utente senza inventarsi una scusa.

Vale la pena mettere in fila le alternative, perché è la scelta che in questo momento sta facendo chiunque colleghi un modello ai sistemi aziendali. Con un MCP sul database l’agente legge tabelle e scrive UPDATE senza limiti, e le regole di business stanno nel prompt, cioè da nessuna parte, perché un prompt è una raccomandazione e non un cancello. Con un semantic layer o un MCP di metriche si ottengono letture governate e nessuna scrittura. Con una collezione di wrapper API ogni endpoint applica le regole del backend che ha dietro, in modo diverso dagli altri, e la coerenza la garantisce la speranza. Con un’ontologia operativa le letture sono oggetti e relazioni, le scritture passano solo da azioni con un nome, e le regole stanno nel modello insieme al registro dei tentativi.

Su questo passaggio si gioca una partita che in Italia è appena cominciata. Nei progetti che seguo la richiesta arriva quasi sempre nella stessa forma, collegare un modello al gestionale perché sbrighi da solo le tre o quattro cose ripetitive che oggi occupano una persona a tempo pieno, e la soluzione più rapida da costruire è anche quella più difficile da difendere: un accesso diretto al database con un prompt lungo che spiega cosa non deve fare. Regge la demo, regge qualche settimana in produzione, e cade il giorno in cui un caso limite che nessuno aveva previsto incontra un modello che quella mattina interpreta la raccomandazione in modo un po’ più largo del solito.

È la stessa cosa che chiamo harness engineering quando parlo del guscio che decide se un agente regge in produzione, portata però al livello dell’azienda intera invece che del singolo workflow. Il guscio smette di essere un file di configurazione scritto da chi ha costruito quell’agente lì e diventa infrastruttura condivisa, la stessa per il cruscotto del direttore commerciale, per lo script del controllo di gestione e per il modello che presidia gli SLA.

Anche le letture portano un’identità: ogni chiamata gira per conto di un attore e le policy di visibilità attaccate al modello decidono cosa quell’attore vede, con un oggetto nascosto che è indistinguibile da uno che non esiste. Sulla parte di autenticazione il repository è disarmante: su stdio tutti i chiamanti collassano in un attore solo, il nome si passa da variabile d’ambiente, ed è etichettatura, non protezione. Dichiarare dove finisce la dimostrazione è la ragione per cui mi fido del resto.

Dove l’ontologia operativa si ferma

La versione zero ha come unico obiettivo la leggibilità, quindi le assenze sono parecchie e sono tutte elencate. Niente cancellazioni, niente proprietà sulle relazioni, niente chiavi composte, nessuna infrastruttura di indicizzazione, nessun costruttore di interfacce. Niente federazione, soprattutto: un’ontologia è un contesto delimitato, e chi possiede il modello quando ce ne sono cinque in cinque divisioni è una domanda vera che il repository dichiara di non affrontare.

L’evoluzione dello schema sta fuori per la stessa ragione, con una scelta che trovo elegante. Il modello è un valore, cioè un pezzo di codice enumerabile, quindi si diffa, si versiona e si revisiona come qualunque altro sorgente, e la governance dello schema viene delegata in blocco a git. Ne esce una separazione netta fra due canali: le istanze si governano a runtime con le azioni e il registro, lo schema si governa in fase di sviluppo con le pull request. Chi in azienda ha il potere di approvare quella pull request ha il potere di ridefinire cosa significa cliente, ed è una carica che nessun organigramma ha mai assegnato formalmente.

C’è poi un default che per un’azienda europea è sbagliato e che il repository dichiara sbagliato per sé: un oggetto senza policy è visibile a chiunque. La dimostrazione non ha autenticazione, quindi fingere di essere chiusi non avrebbe senso, e chi volesse portarlo verso un deployment reale parte dal rendere obbligatoria la visibilità e aggiunge sotto autenticazione vera, permessi sulle azioni e accesso al registro con i suoi confini.

Fuori dallo scopo c’è anche la parte che rende Foundry un prodotto da milioni di euro, cioè l’indicizzazione incrementale, gli indici di adiacenza e i backend di ricerca che servono miliardi di oggetti con tempi di risposta accettabili. Su scala dimostrativa una query ingenua basta, e l’autore lo dichiara senza giri, perché la scala appartiene alle implementazioni e non al pattern. Vale come promemoria per chi legge poche centinaia di righe di TypeScript e crede di avere in mano un sostituto: qui c’è la definizione, non il prodotto che la applica a un’azienda da ventimila persone.

Da qui esce la cosa più riutilizzabile di tutto il lavoro, e la consiglio a chi in questi mesi si trova sul tavolo offerte di piattaforme che si sono ribattezzate ontologie nel giro di un trimestre. Qualunque ontologia operativa deve dichiarare quattro cose: chi possiede ogni pezzo di stato, cosa succede quando la scrittura verso la sorgente riesce e il commit locale no, se le modifiche fatte nell’ontologia sopravvivono a un ricaricamento delle sorgenti, e cosa vede chi non ha nessuna policy addosso. Le quattro risposte possono essere diverse da quelle di questo repository e il sistema rimane dentro il pattern. Quello che non può succedere è che il fornitore non le abbia, perché senza quelle dichiarazioni il permesso revocabile di cui parliamo da mesi non ha niente a cui appoggiarsi.

La domanda che mi è venuta in mente dopo aver letto il codice non riguarda Palantir, e nemmeno la scelta fra costruire e comprare. Riguarda chi oggi dentro un’organizzazione italiana di media dimensione ha oggi l’autorità di dichiarare che lo status di un ordine appartiene all’ERP e l’assegnatario appartiene all’ontologia operativa. È una dichiarazione tecnica nella forma e una delibera nella sostanza, perché stabilisce chi può cambiare cosa e sotto quali condizioni quel permesso continua a valere, che è poi il cuore del permesso revocabile applicato ai sistemi invece che agli agenti. Prima o poi arriva sul tavolo di qualcuno che non l’ha chiesta, nel momento peggiore, sotto forma di due numeri diversi per lo stesso ordine.

Company Brain: come si costruisce il “Jarvis” di un’azienda

Progettare uno spazio di lavoro che un LLM sa leggere

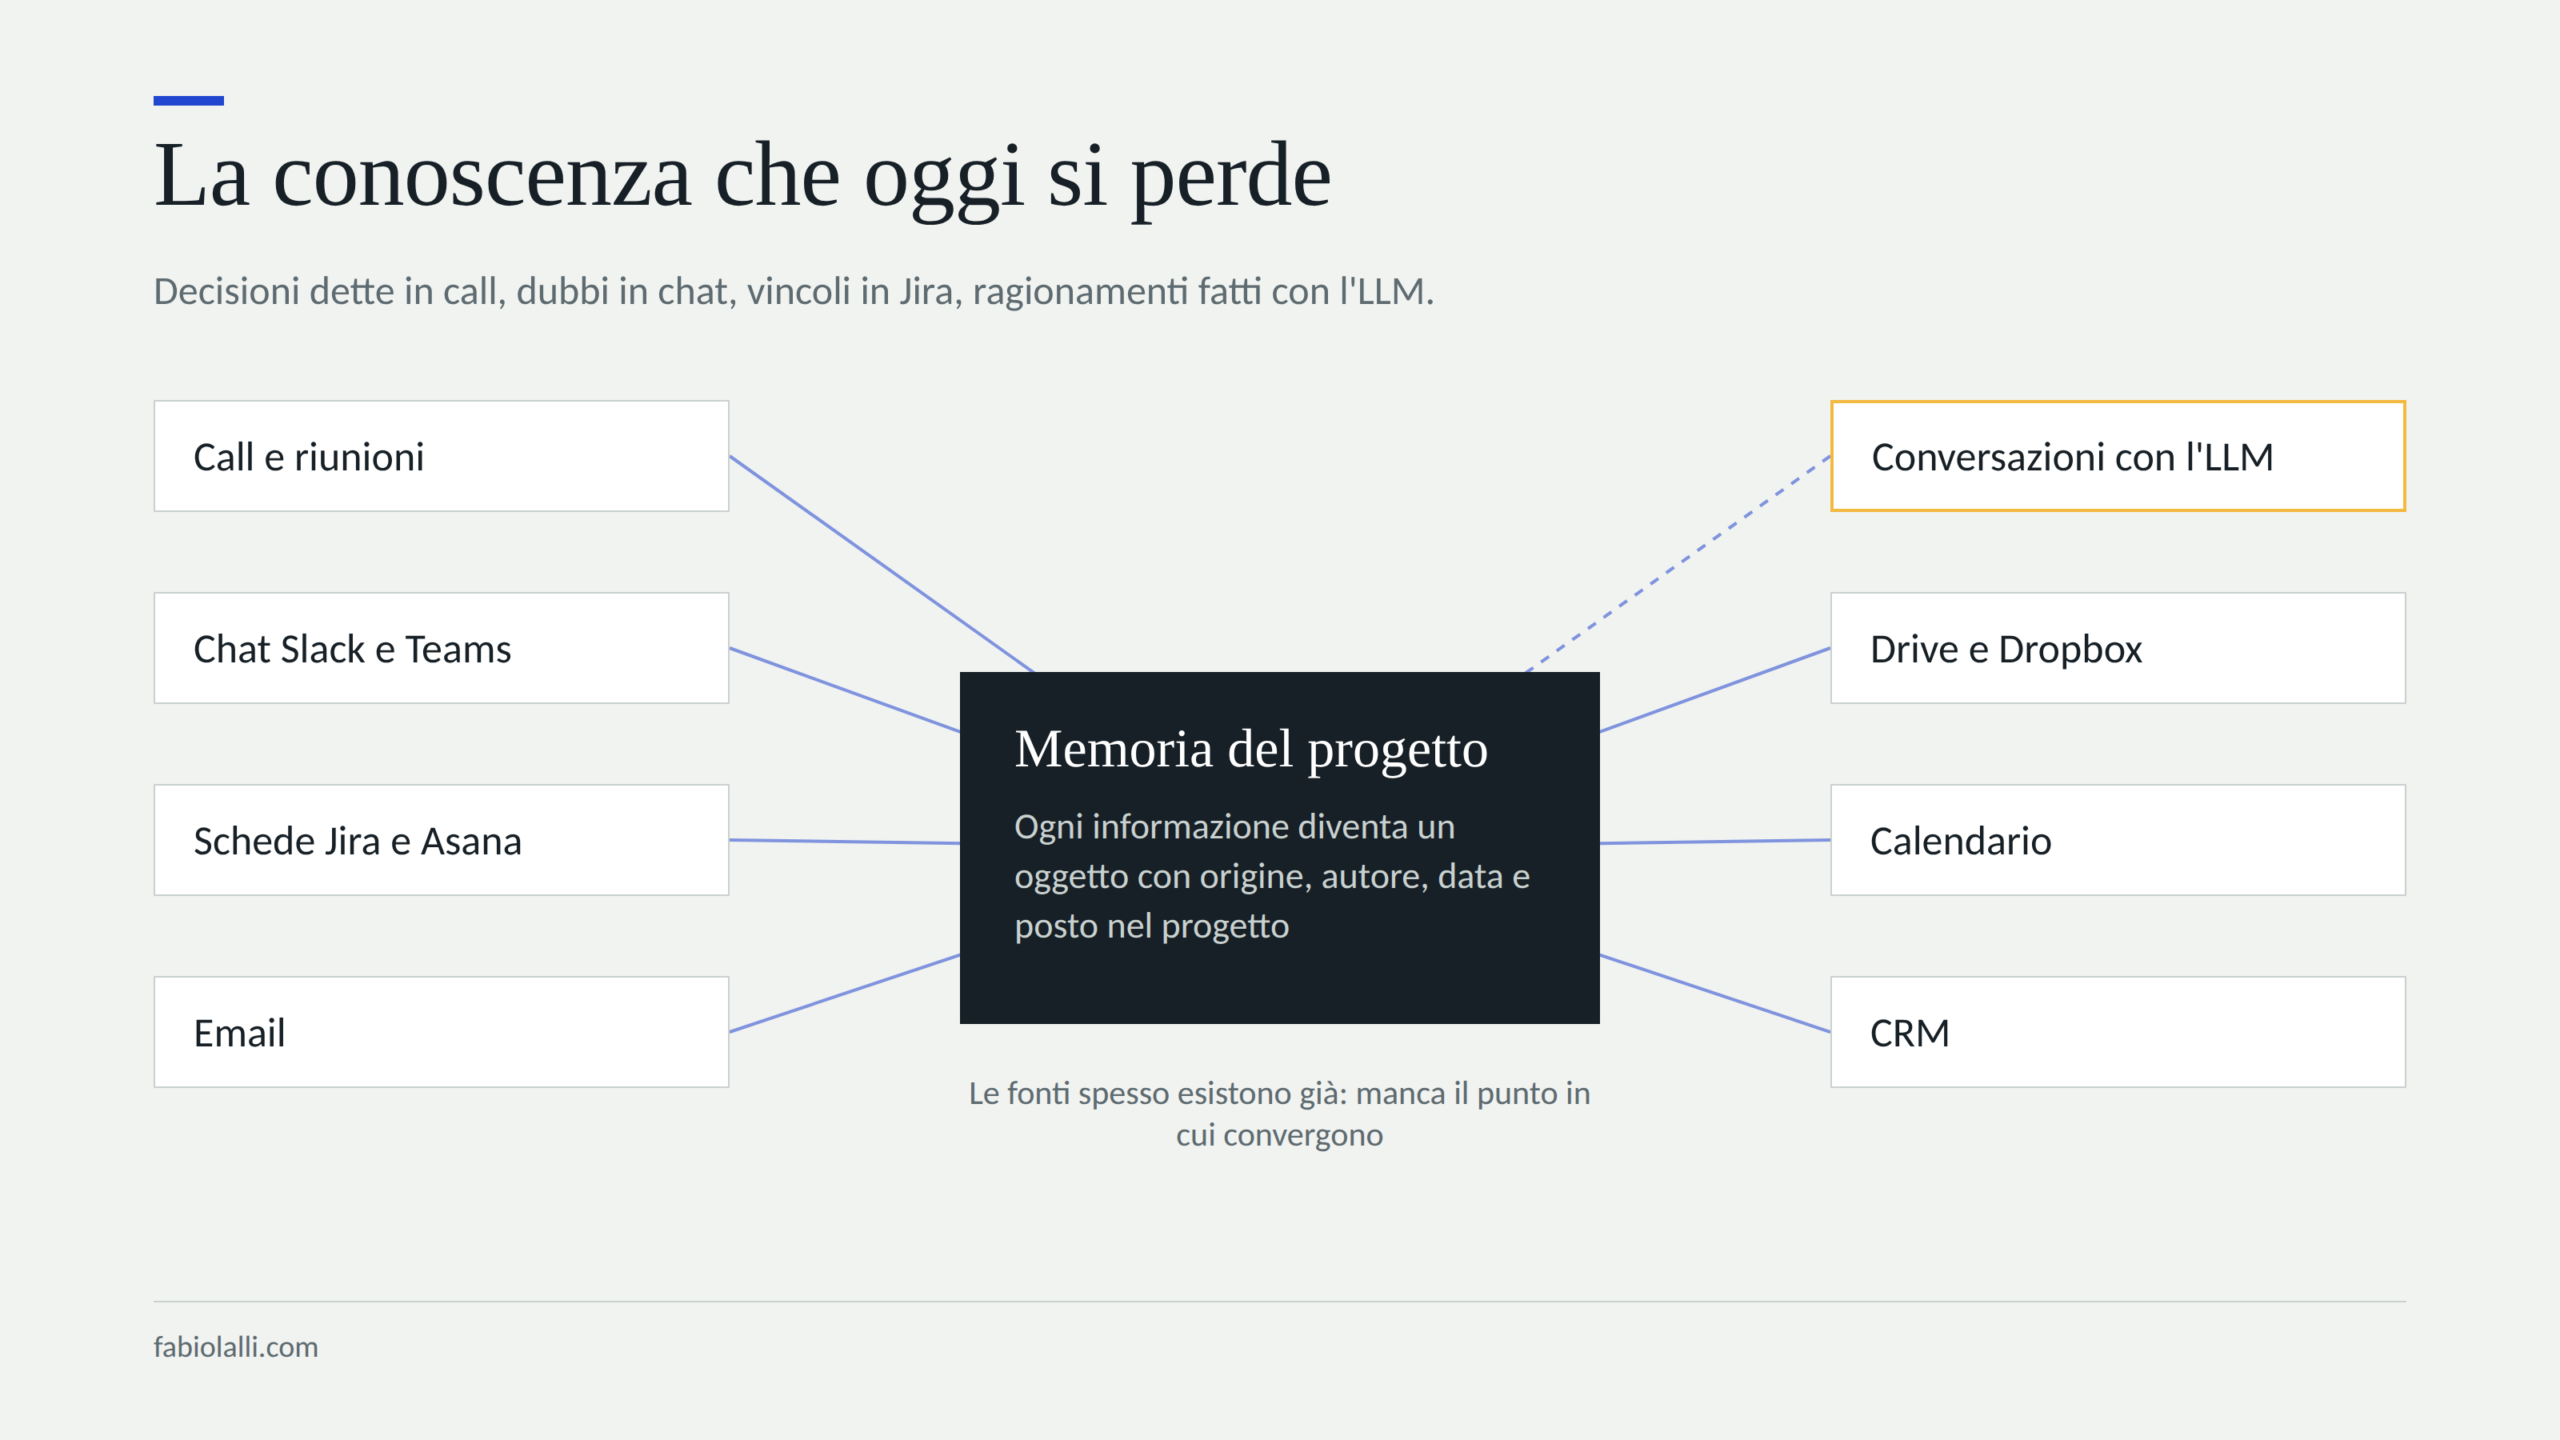
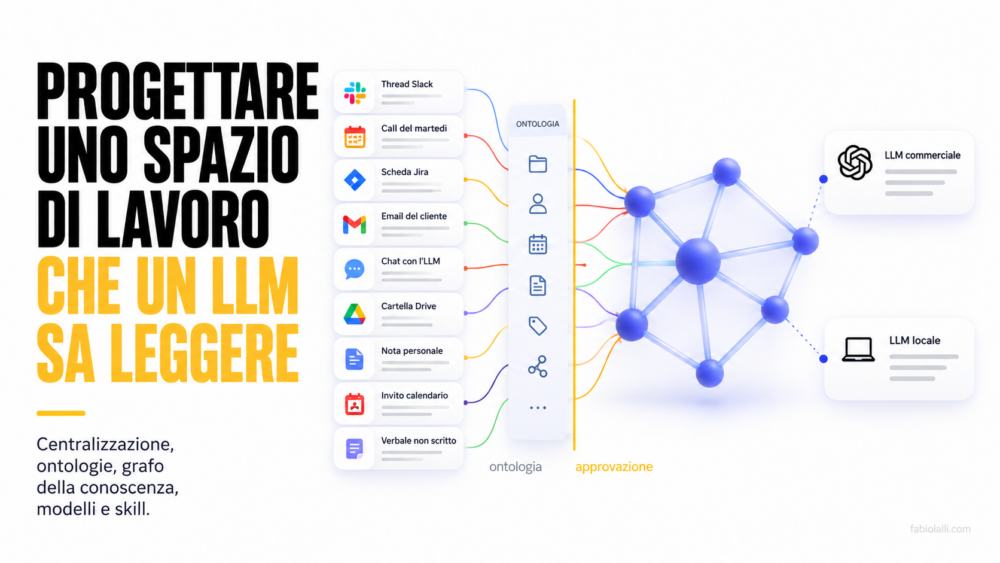
In quasi tutte le aziende che incontro la conoscenza di un progetto vive in sette o otto posti diversi: le registrazioni delle riunioni, le caselle di posta, una cartella condivisa su Drive e un’altra su Dropbox, il calendario, il CRM, i canali Slack o Teams, le schede di Jira o di Asana, le note personali di ciascuno. C’è poi un posto nuovo, che fino a due anni fa non esisteva e oggi contiene una parte rilevante del ragionamento di un team: le conversazioni che ogni persona ha con il proprio assistente AI mentre lavora. Ciascuno di questi posti funziona bene da solo, e nessuno sa dell’esistenza degli altri.

La reazione più diffusa è collegare un LLM a tutte queste fonti e aspettarsi che dal collegamento nasca un’intelligenza del progetto. È l’idea del Jarvis aziendale, che in questi mesi circola con nomi diversi, Company Brain, Brain OS, Company OS: un assistente che sa tutto dell’azienda perché vede tutto. Succede il contrario. Più fonti si collegano senza una struttura che le tenga insieme, più il modello produce risposte plausibili costruite su frammenti, e più diventa difficile capire da dove arriva un’affermazione, chi l’ha verificata e se è ancora vera.

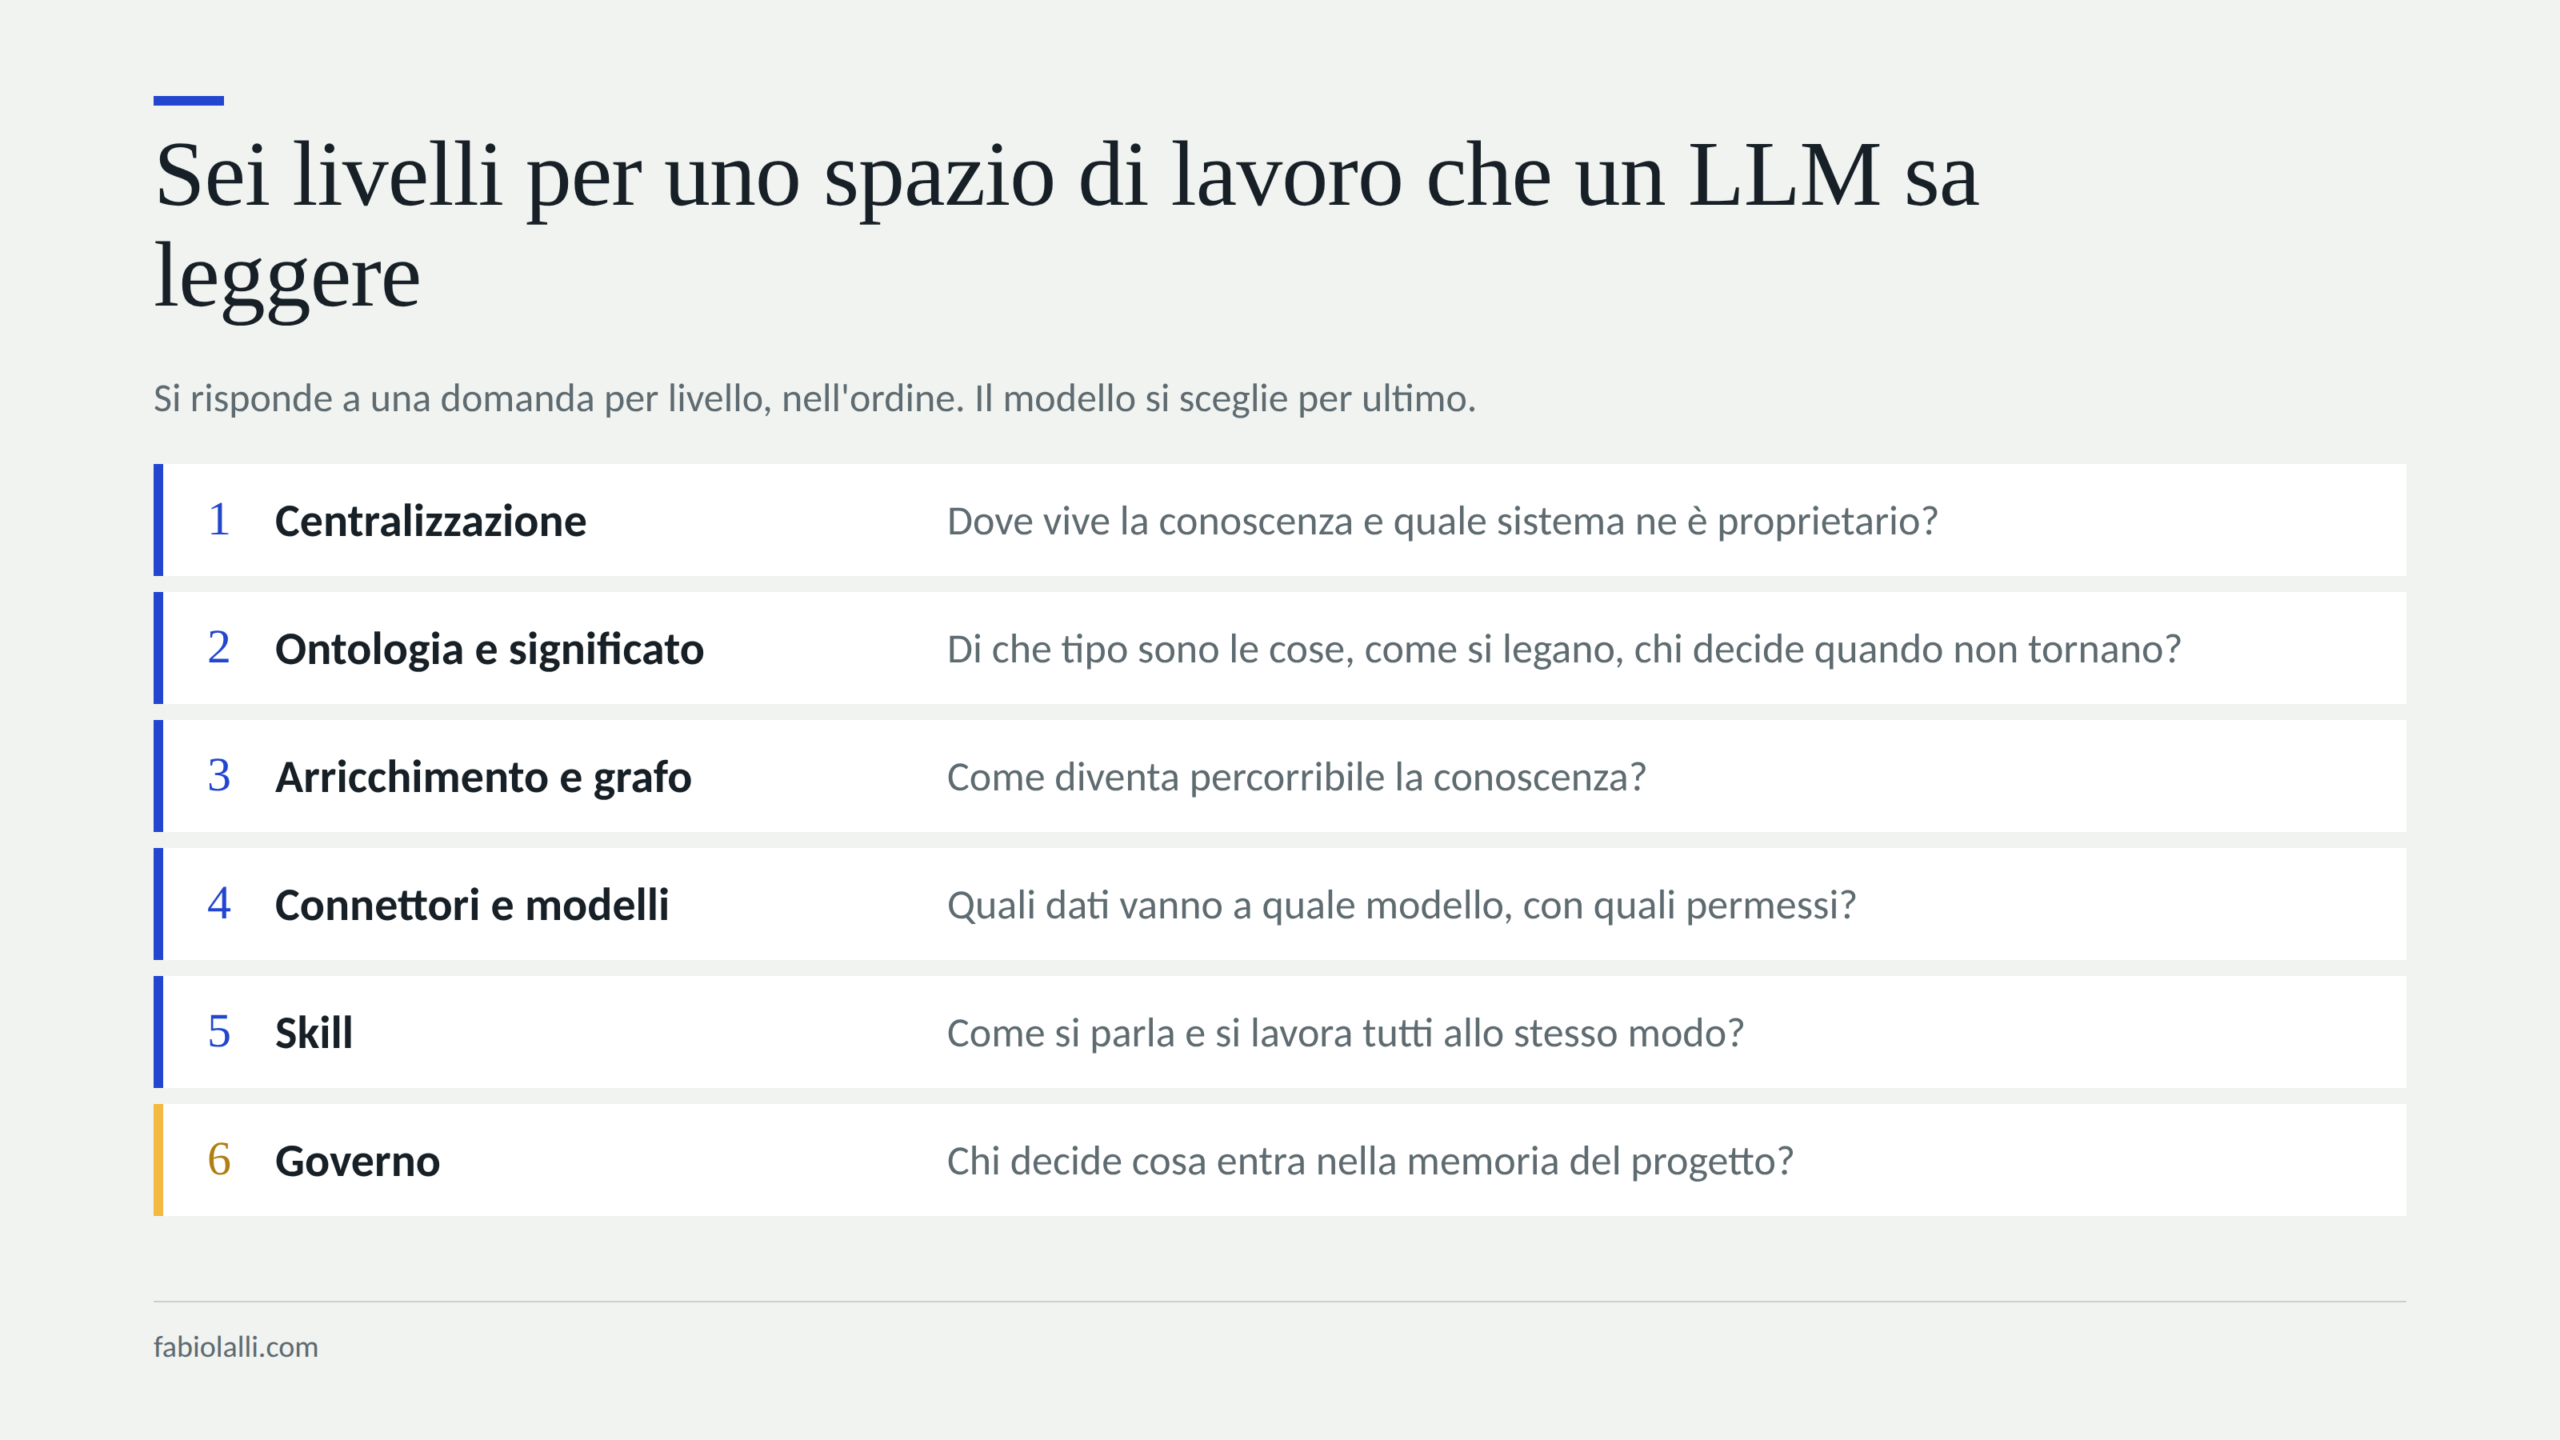
Uno spazio di lavoro intelligente si progetta, e la scelta del modello arriva per ultima. Il metodo che propongo lo divide in sei livelli, ciascuno con una domanda a cui rispondere prima di passare al successivo. Come caso concreto uso il Workspace ICONICO, la piattaforma interna di gestione dei progetti che stiamo costruendo in questi mesi: è ancora giovane, ma ogni scelta descritta qui è già in produzione.

La complessità cambia posto

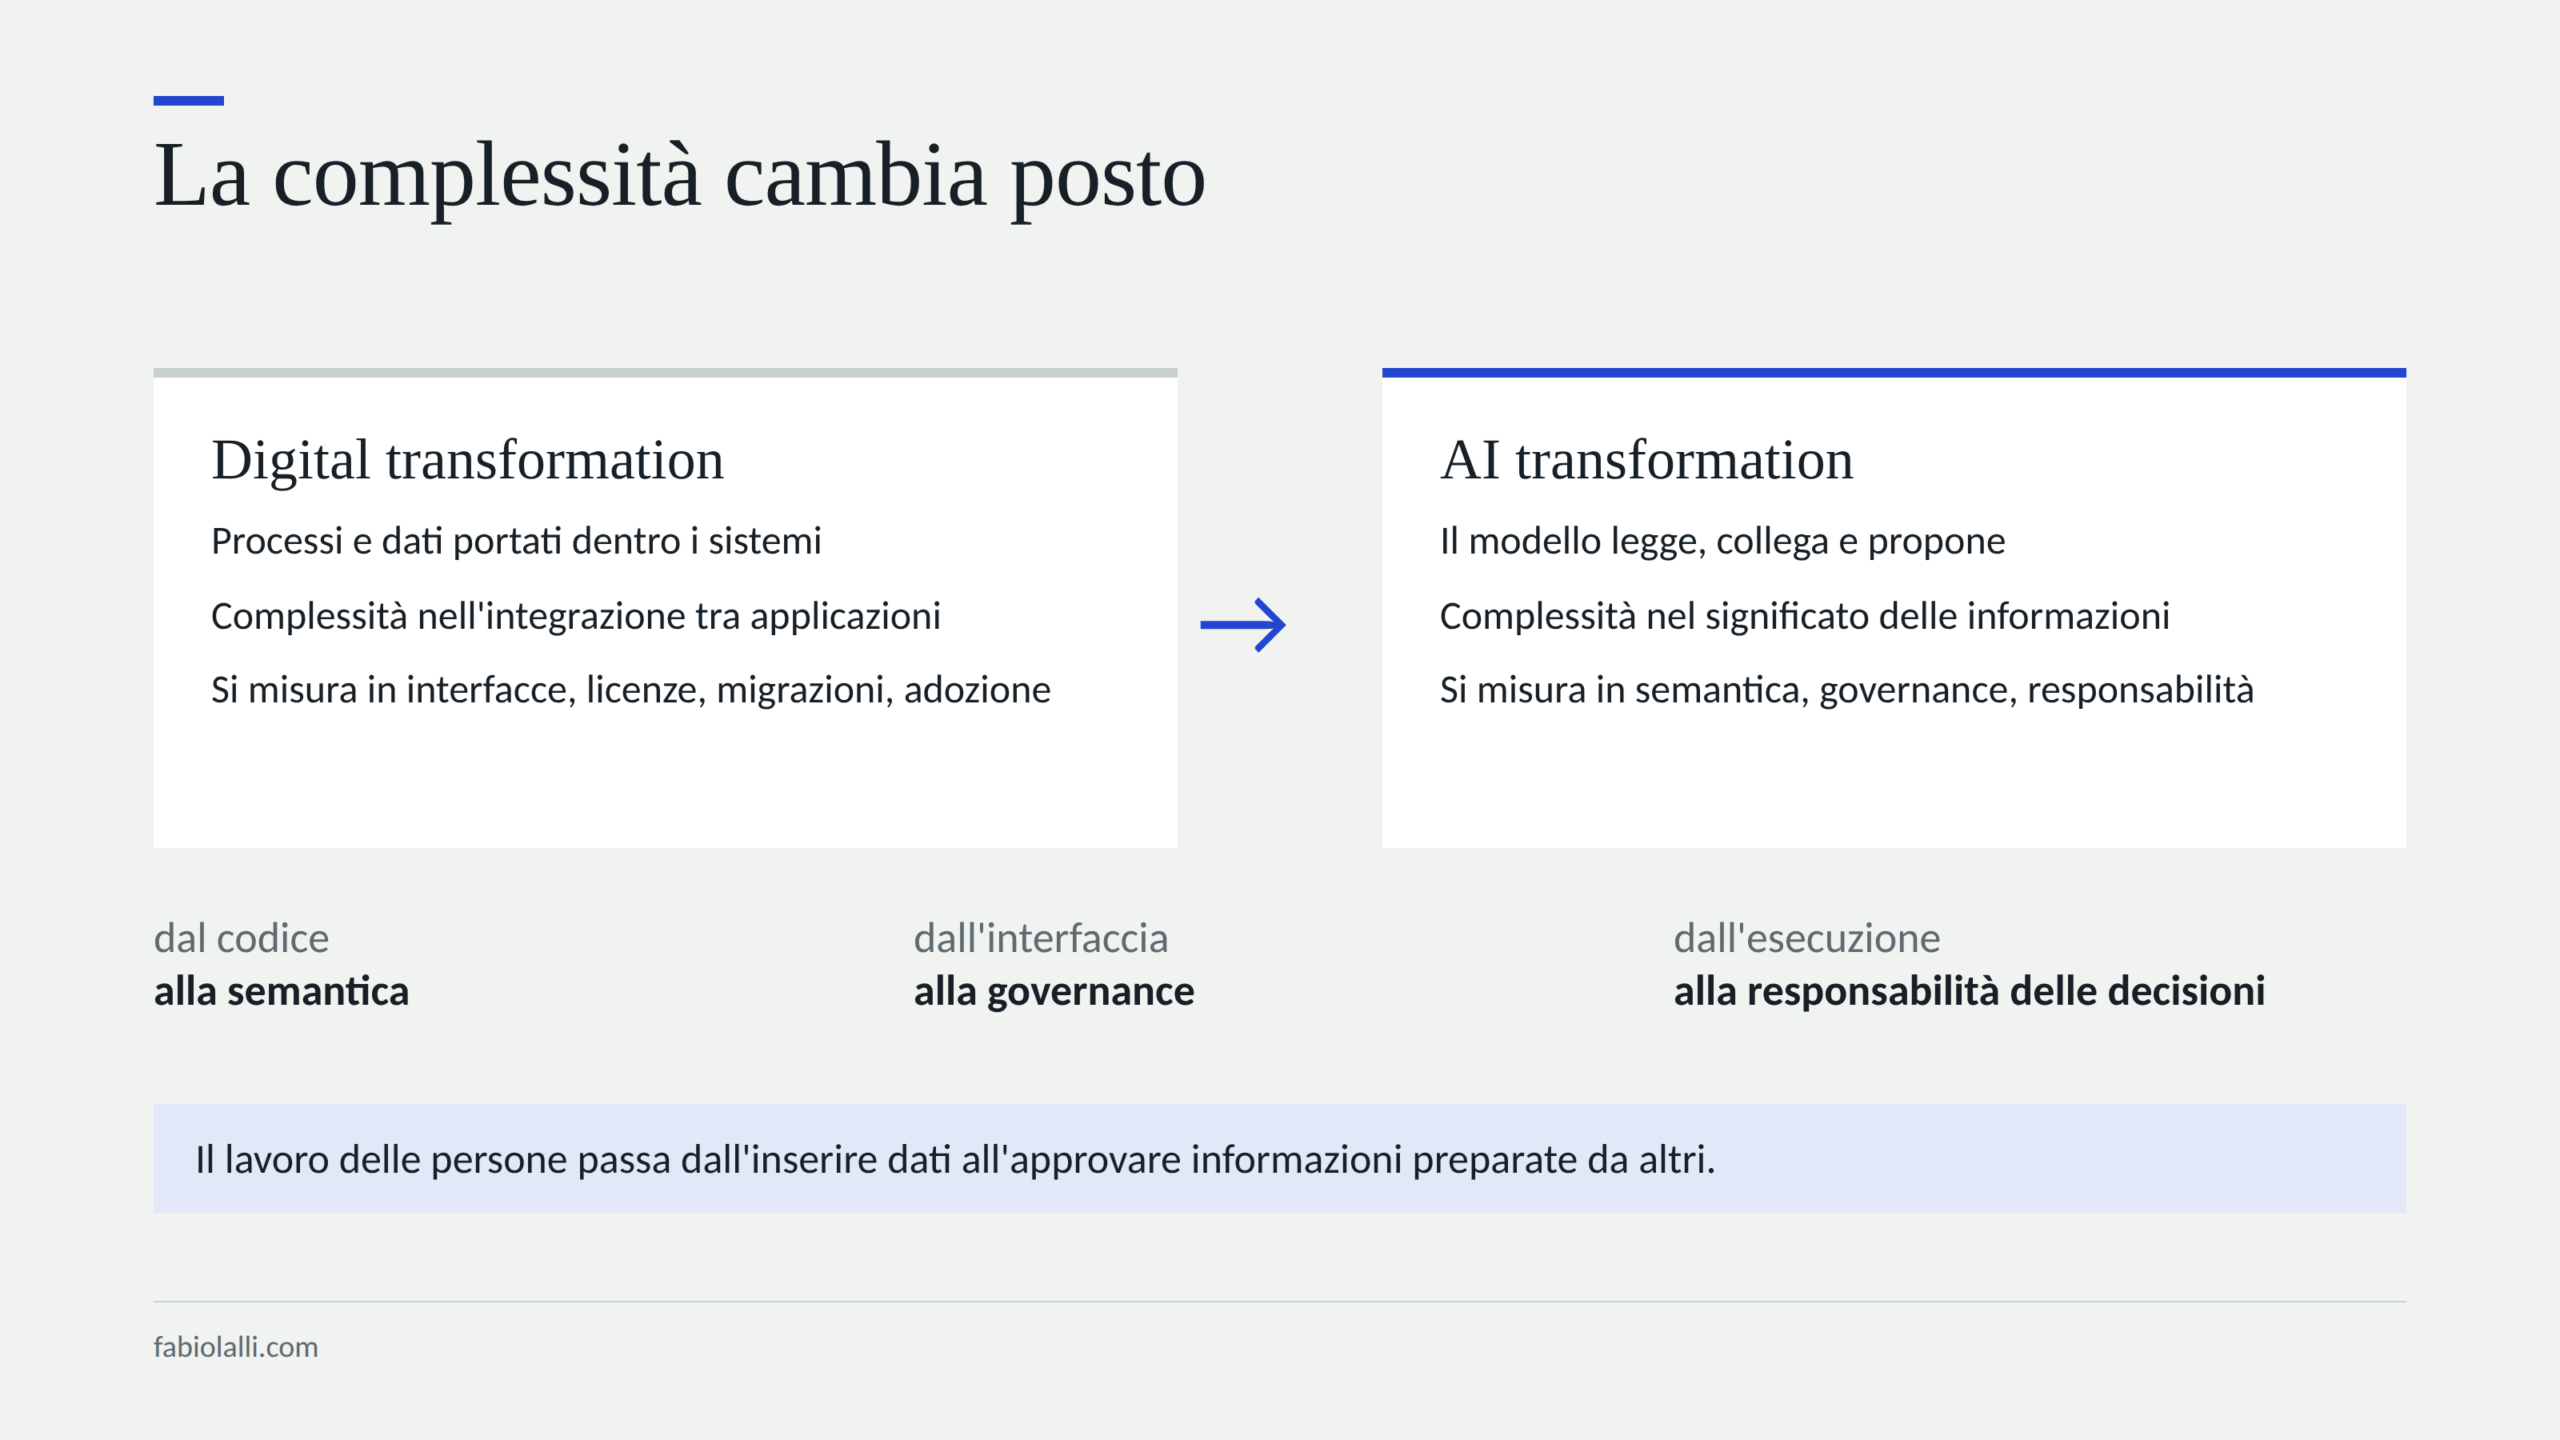
Prima dei livelli conviene chiarire che tipo di trasformazione è questa, perché la si confonde spesso con quella che le aziende hanno attraversato negli ultimi quindici anni. La digital transformation ha portato processi e dati dentro i sistemi: la carta è diventata un modulo, la riunione una videochiamata, l’archivio un drive condiviso, e la complessità stava nell’integrazione tra applicazioni e nell’adozione degli strumenti da parte delle persone. Si misurava in interfacce, licenze, migrazioni, formazione all’uso del software.

La AI transformation sposta la complessità altrove. Gli strumenti in buona parte ci sono già, e i dati anche, solo che sono sparsi e senza significato condiviso. Quando un modello legge, riassume, collega e propone al posto delle persone, il problema smette di essere come si esegue una procedura dentro un’applicazione e diventa cosa significano le informazioni, chi ha titolo per confermarle e cosa succede quando due fonti dicono cose diverse. La complessità passa dal codice alla semantica, dall’interfaccia alla governance, dall’esecuzione delle operazioni alla responsabilità delle decisioni.

Questo ha una conseguenza pratica che molti sottovalutano. Il lavoro di chi usa il sistema cambia natura: meno inserimento di dati, meno ricerca, molte più approvazioni, correzioni e scelte su informazioni preparate da altri. Una persona che prima compilava il verbale di una riunione ora riceve un verbale già scritto, con i task estratti e collegati alle persone giuste, e il suo compito è dire se è corretto. È un lavoro più leggero e più delicato insieme, perché richiede di sapere cosa si sta approvando.

Un posto per ogni informazione

Centralizzare la conoscenza non significa copiare tutto in un unico contenitore. Un archivio dove finiscono i file di tutti è soltanto un altro silo, più grande. Serve un luogo dove un’informazione diventa un oggetto con un’identità, un autore, una data e una posizione nel progetto: una nota di riunione, un task con un assegnatario e una scadenza, un documento con le sue versioni, un referente con il suo ruolo, un’opportunità con il suo stadio, un’ora di lavoro registrata su un’attività.

La regola che evita più problemi è che ogni dato ha un solo sistema proprietario. Nel Workspace ICONICO clienti, contatti e opportunità restano nel CRM aziendale, e la piattaforma non li duplica: tiene un collegamento e una copia del nome per poterlo mostrare, e quando dal progetto nasce un’opportunità è la piattaforma a scriverla nel CRM, con la nota di progetto e l’attività già collegate. Un’anagrafica duplicata produce, dopo pochi mesi, due verità su chi è il decisore di un cliente, e un modello che le legge entrambe sceglie a caso quale citare.

Il vantaggio più sottovalutato della centralizzazione riguarda le informazioni che oggi non arrivano da nessuna parte. Una decisione presa in una call e mai scritta, un dubbio sollevato in un canale Slack e poi dimenticato, un vincolo annotato in una scheda Jira che nessuno del commerciale leggerà, un’email in cui il cliente cambia una priorità rispondendo a un’altra domanda. E poi il ragionamento che una persona fa con il proprio LLM mentre prepara una proposta o analizza un problema, che spesso contiene il passaggio più utile della giornata e svanisce quando si chiude la finestra. Ognuna di queste informazioni, presa da sola, vale poco. Raccolte nel progetto, con la loro origine, diventano la memoria che l’azienda non aveva mai avuto, e smettono di dipendere da chi era presente quel giorno.

Per ottenere questo vantaggio non sempre serve costruire infrastruttura nuova. In molti casi le fonti esistono già, con i loro connettori, e manca soltanto il punto in cui convergono e un criterio per decidere cosa ne entra. Nel Workspace il controllo degli accessi è applicato al livello più basso possibile, con regole a livello di riga su ognuna delle 28 tabelle del database, per cui la stessa domanda posta da due persone con ruoli diversi restituisce risposte diverse: è la condizione per dare a un modello l’accesso a tutto il progetto senza dover filtrare a mano ogni volta.

Il significato viene prima dei dati

È la parte che quasi tutti saltano, e si capisce: parlare di ontologia in una riunione di direzione fa alzare gli occhi al cielo. Eppure un modello collegato a dati senza tipi e senza relazioni dichiarate ricostruisce da solo il significato delle cose, ogni volta in modo leggermente diverso, e due risposte alla stessa domanda a una settimana di distanza non coincidono. L’ontologia è il punto in cui un’azienda decide cosa significano le sue informazioni, prima che lo decida un modello al suo posto.

Si comincia dai tipi di oggetto. Nel Workspace le note sono appunti, verbali di riunione, decisioni, rischi, insight, feedback, opportunità o conoscenza consolidata, e il tipo cambia il trattamento: una decisione pesa più di un appunto, un rischio genera attenzione, una nota di conoscenza è il risultato di una verifica e non di un’impressione. Anche il vocabolario fa parte dell’ontologia. I tag vengono normalizzati, minuscoli e con il trattino al posto degli spazi, e prima di crearne uno nuovo il sistema lo confronta per somiglianza con quelli esistenti: se esiste già “commerciale-b2b”, la variante “commerciale b2b” non nasce e chi la scrive riceve un avviso, perché il tag è il punto in cui la tassonomia di un’azienda si sfalda più in fretta.

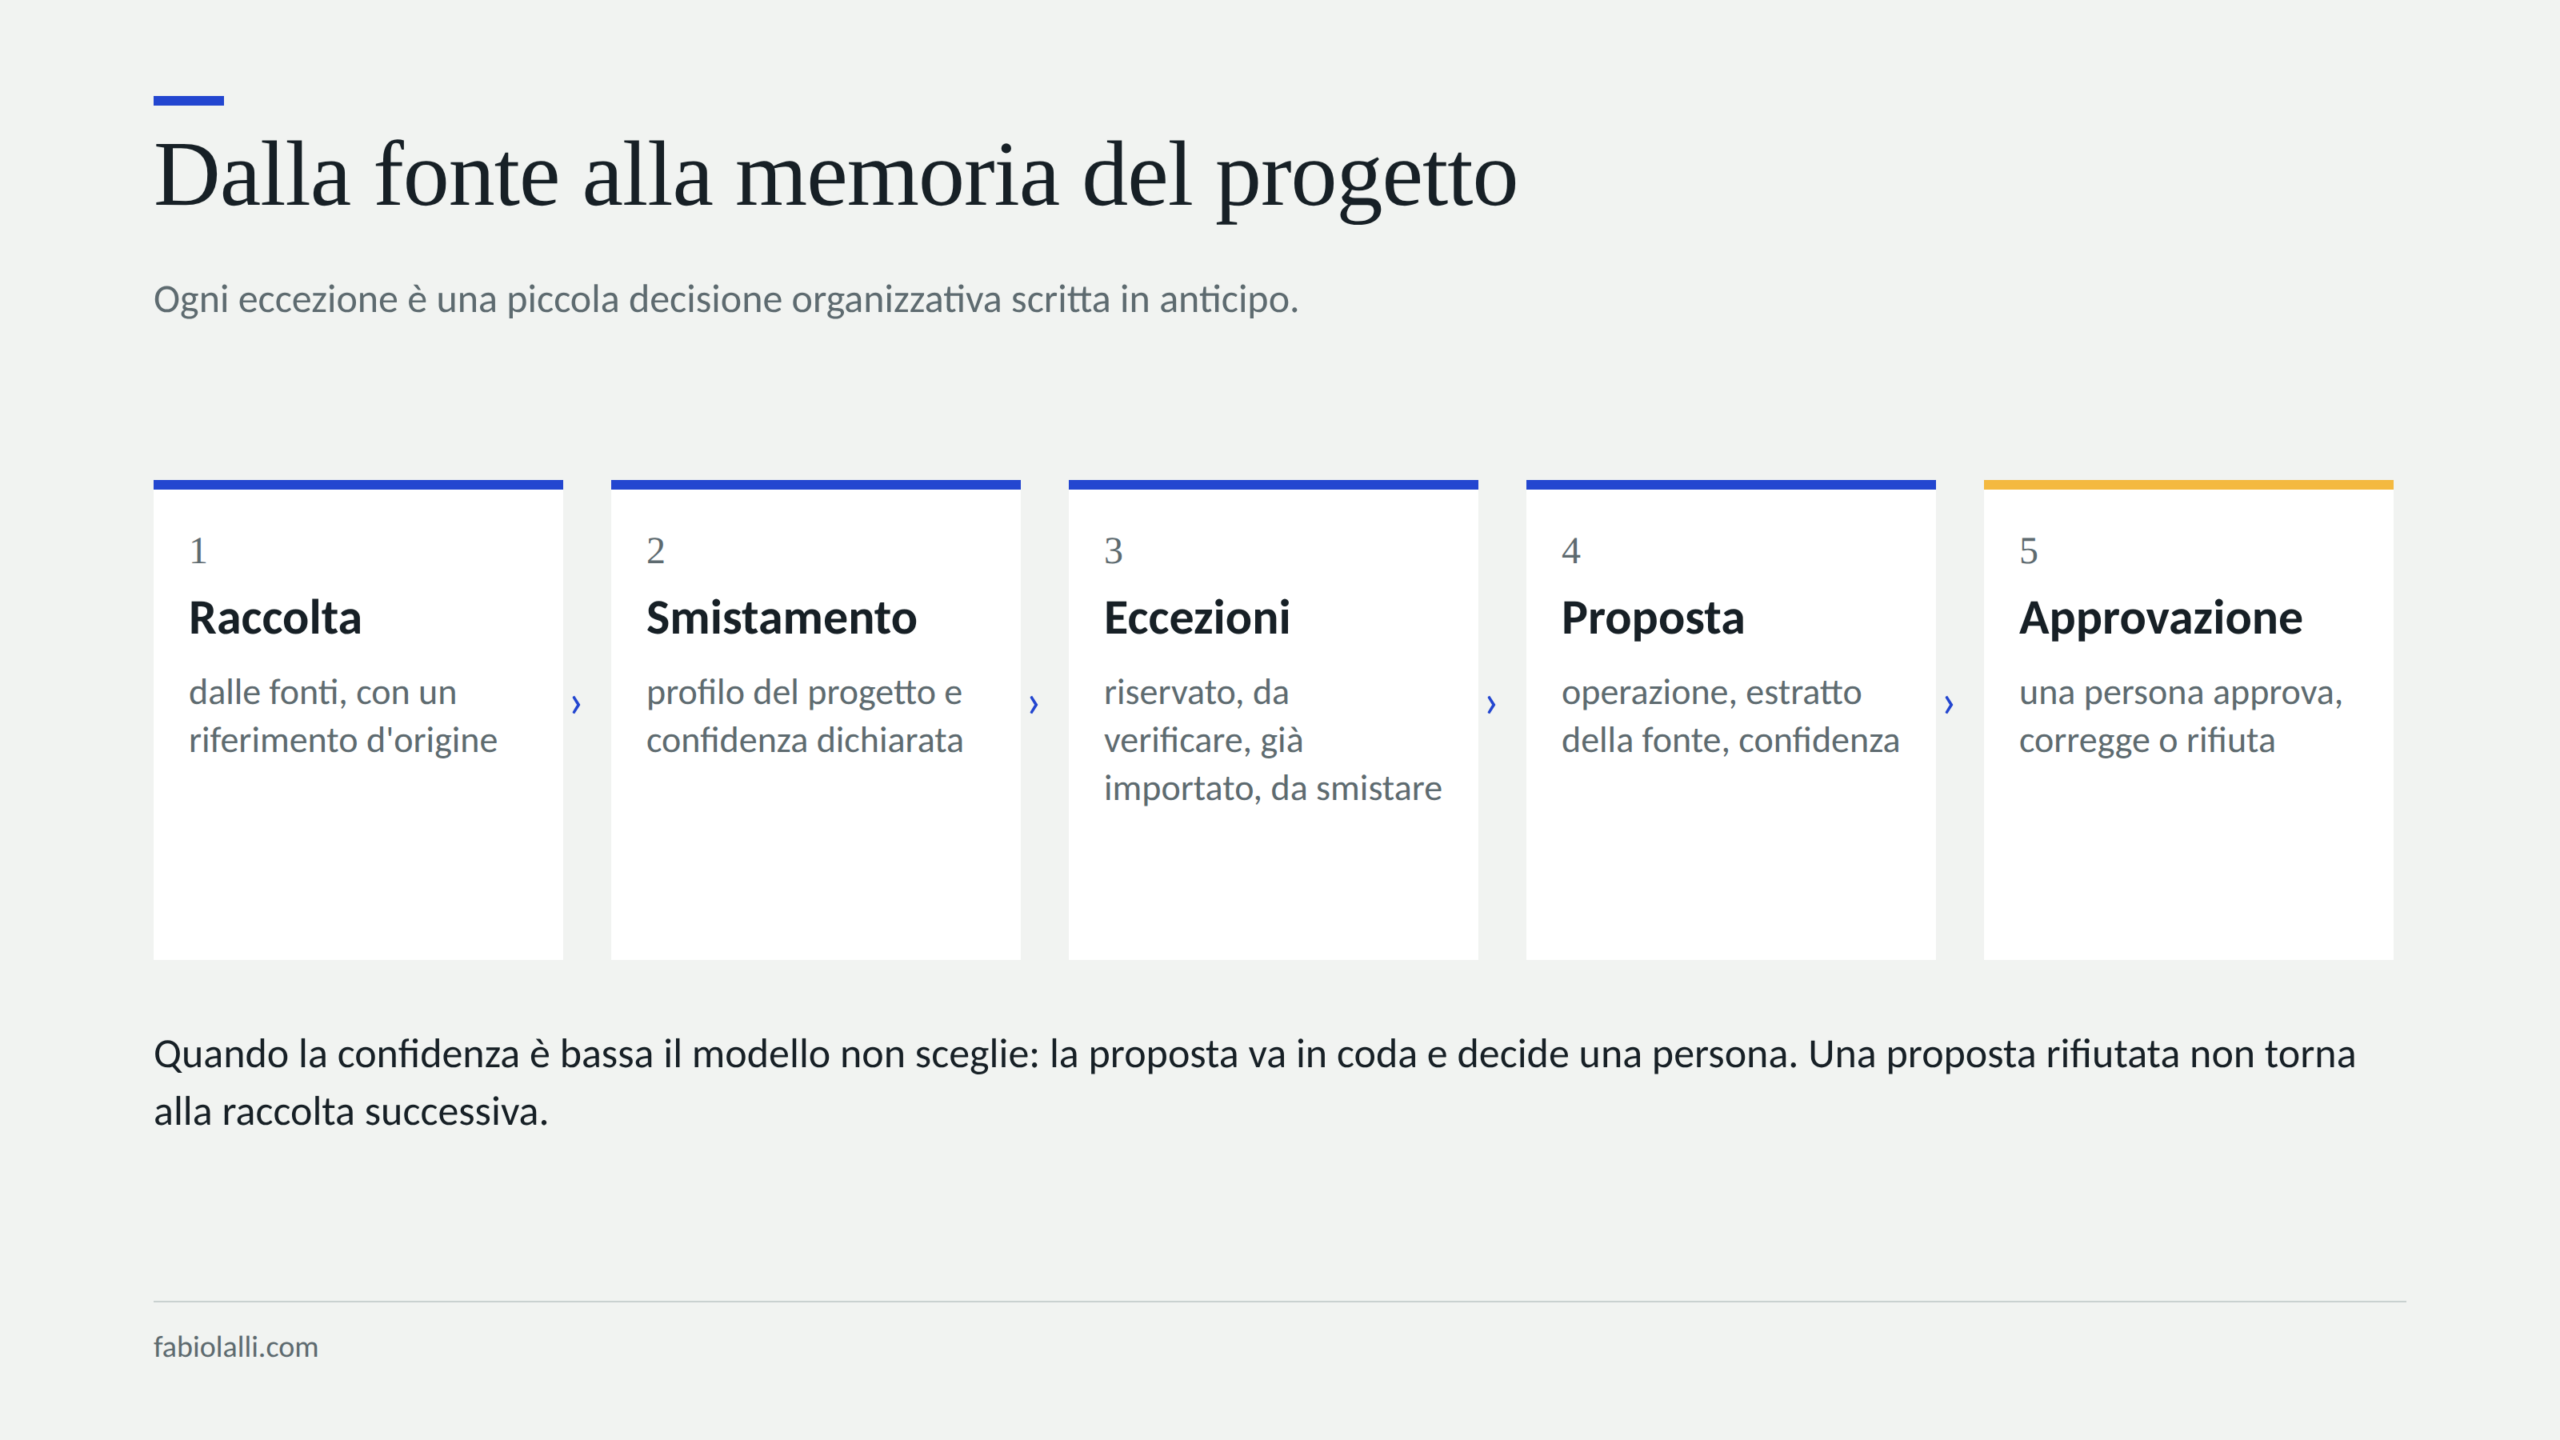
Poi viene lo smistamento, cioè la decisione su dove va un’informazione appena raccolta. Ogni progetto ha un profilo leggibile dal modello: i domini email del cliente e dei partner, le parole chiave e le sigle ricorrenti, le cartelle standard, le convenzioni di nome. Con queste poche righe una mail da un certo dominio, o una registrazione in cui ricorre una sigla, viene attribuita al progetto giusto con un livello di confidenza dichiarato. Quando la confidenza è bassa, o l’informazione potrebbe appartenere a due progetti, il modello non sceglie: la proposta finisce in una coda da smistare e la decisione torna a una persona.

Le eccezioni vanno progettate quanto i casi normali. Un’informazione con cifre economiche viene marcata come riservata e resta visibile solo ai responsabili del progetto. Un’informazione dubbia porta il marcatore da verificare. Un contenuto già importato viene riconosciuto dalla sua origine e non entra una seconda volta. Ognuna di queste regole è una piccola decisione organizzativa scritta in anticipo, e ciascuna toglie al modello un’occasione di improvvisare.

Il caso più delicato sono le collisioni, quando due fonti affermano cose diverse sullo stesso punto. Per gestirle le relazioni tra oggetti sono tipizzate: un collegamento tra due note può essere un riferimento, una conferma, un’integrazione, una divergenza o un consolidamento. Nel progetto pilota due note scritte da persone diverse, a pochi giorni di distanza, si contraddicevano su sei punti. Un sistema ingenuo avrebbe tenuto l’ultima, o le avrebbe fuse in un riassunto. Con le relazioni tipizzate la divergenza diventa un collegamento esplicito e apre un task di verifica assegnato a una persona, che si chiude con una nota di conoscenza: cita entrambe le fonti e dichiara per ciascuna se è stata confermata, integrata o superata su quel punto. Le note originali restano intatte e i loro autori ricevono una notifica.

Le conferme hanno lo stesso trattamento, con il segno opposto. Quando una seconda fonte indipendente dice la stessa cosa della prima, il collegamento di conferma alza il valore di quell’informazione, e chi interroga il progetto sa che quel fatto è sostenuto da due origini e non da una. È il modo in cui la conoscenza di un team acquista peso nel tempo, invece di accumularsi tutta allo stesso livello.

Arricchire i dati e renderli percorribili

Un’informazione raccolta e smistata è ancora un oggetto isolato. Diventa conoscenza quando è collegata a ciò che la circonda: le persone che cita, l’opportunità a cui si riferisce, il documento che commenta, il task che ne è nato, le ore spese per produrla.

L’arricchimento avviene su più piani. Il primo è esplicito: nelle note e nei task gli oggetti si citano con le menzioni, scrivendo @ seguito dal nome di una persona, di un documento o di un’opportunità, e ogni menzione diventa un collegamento. Il secondo è automatico: il sistema rianalizza i testi, riconosce nomi di referenti, opportunità e documenti già presenti nel progetto e genera collegamenti suggeriti, che però restano suggerimenti finché qualcuno non li conferma, e se vengono rifiutati non vengono ricreati. Il terzo è operativo: un task porta con sé la nota da cui è nato, un’ora registrata porta con sé il task o la riunione a cui si riferisce, un’opportunità porta con sé la nota che l’ha fatta emergere.

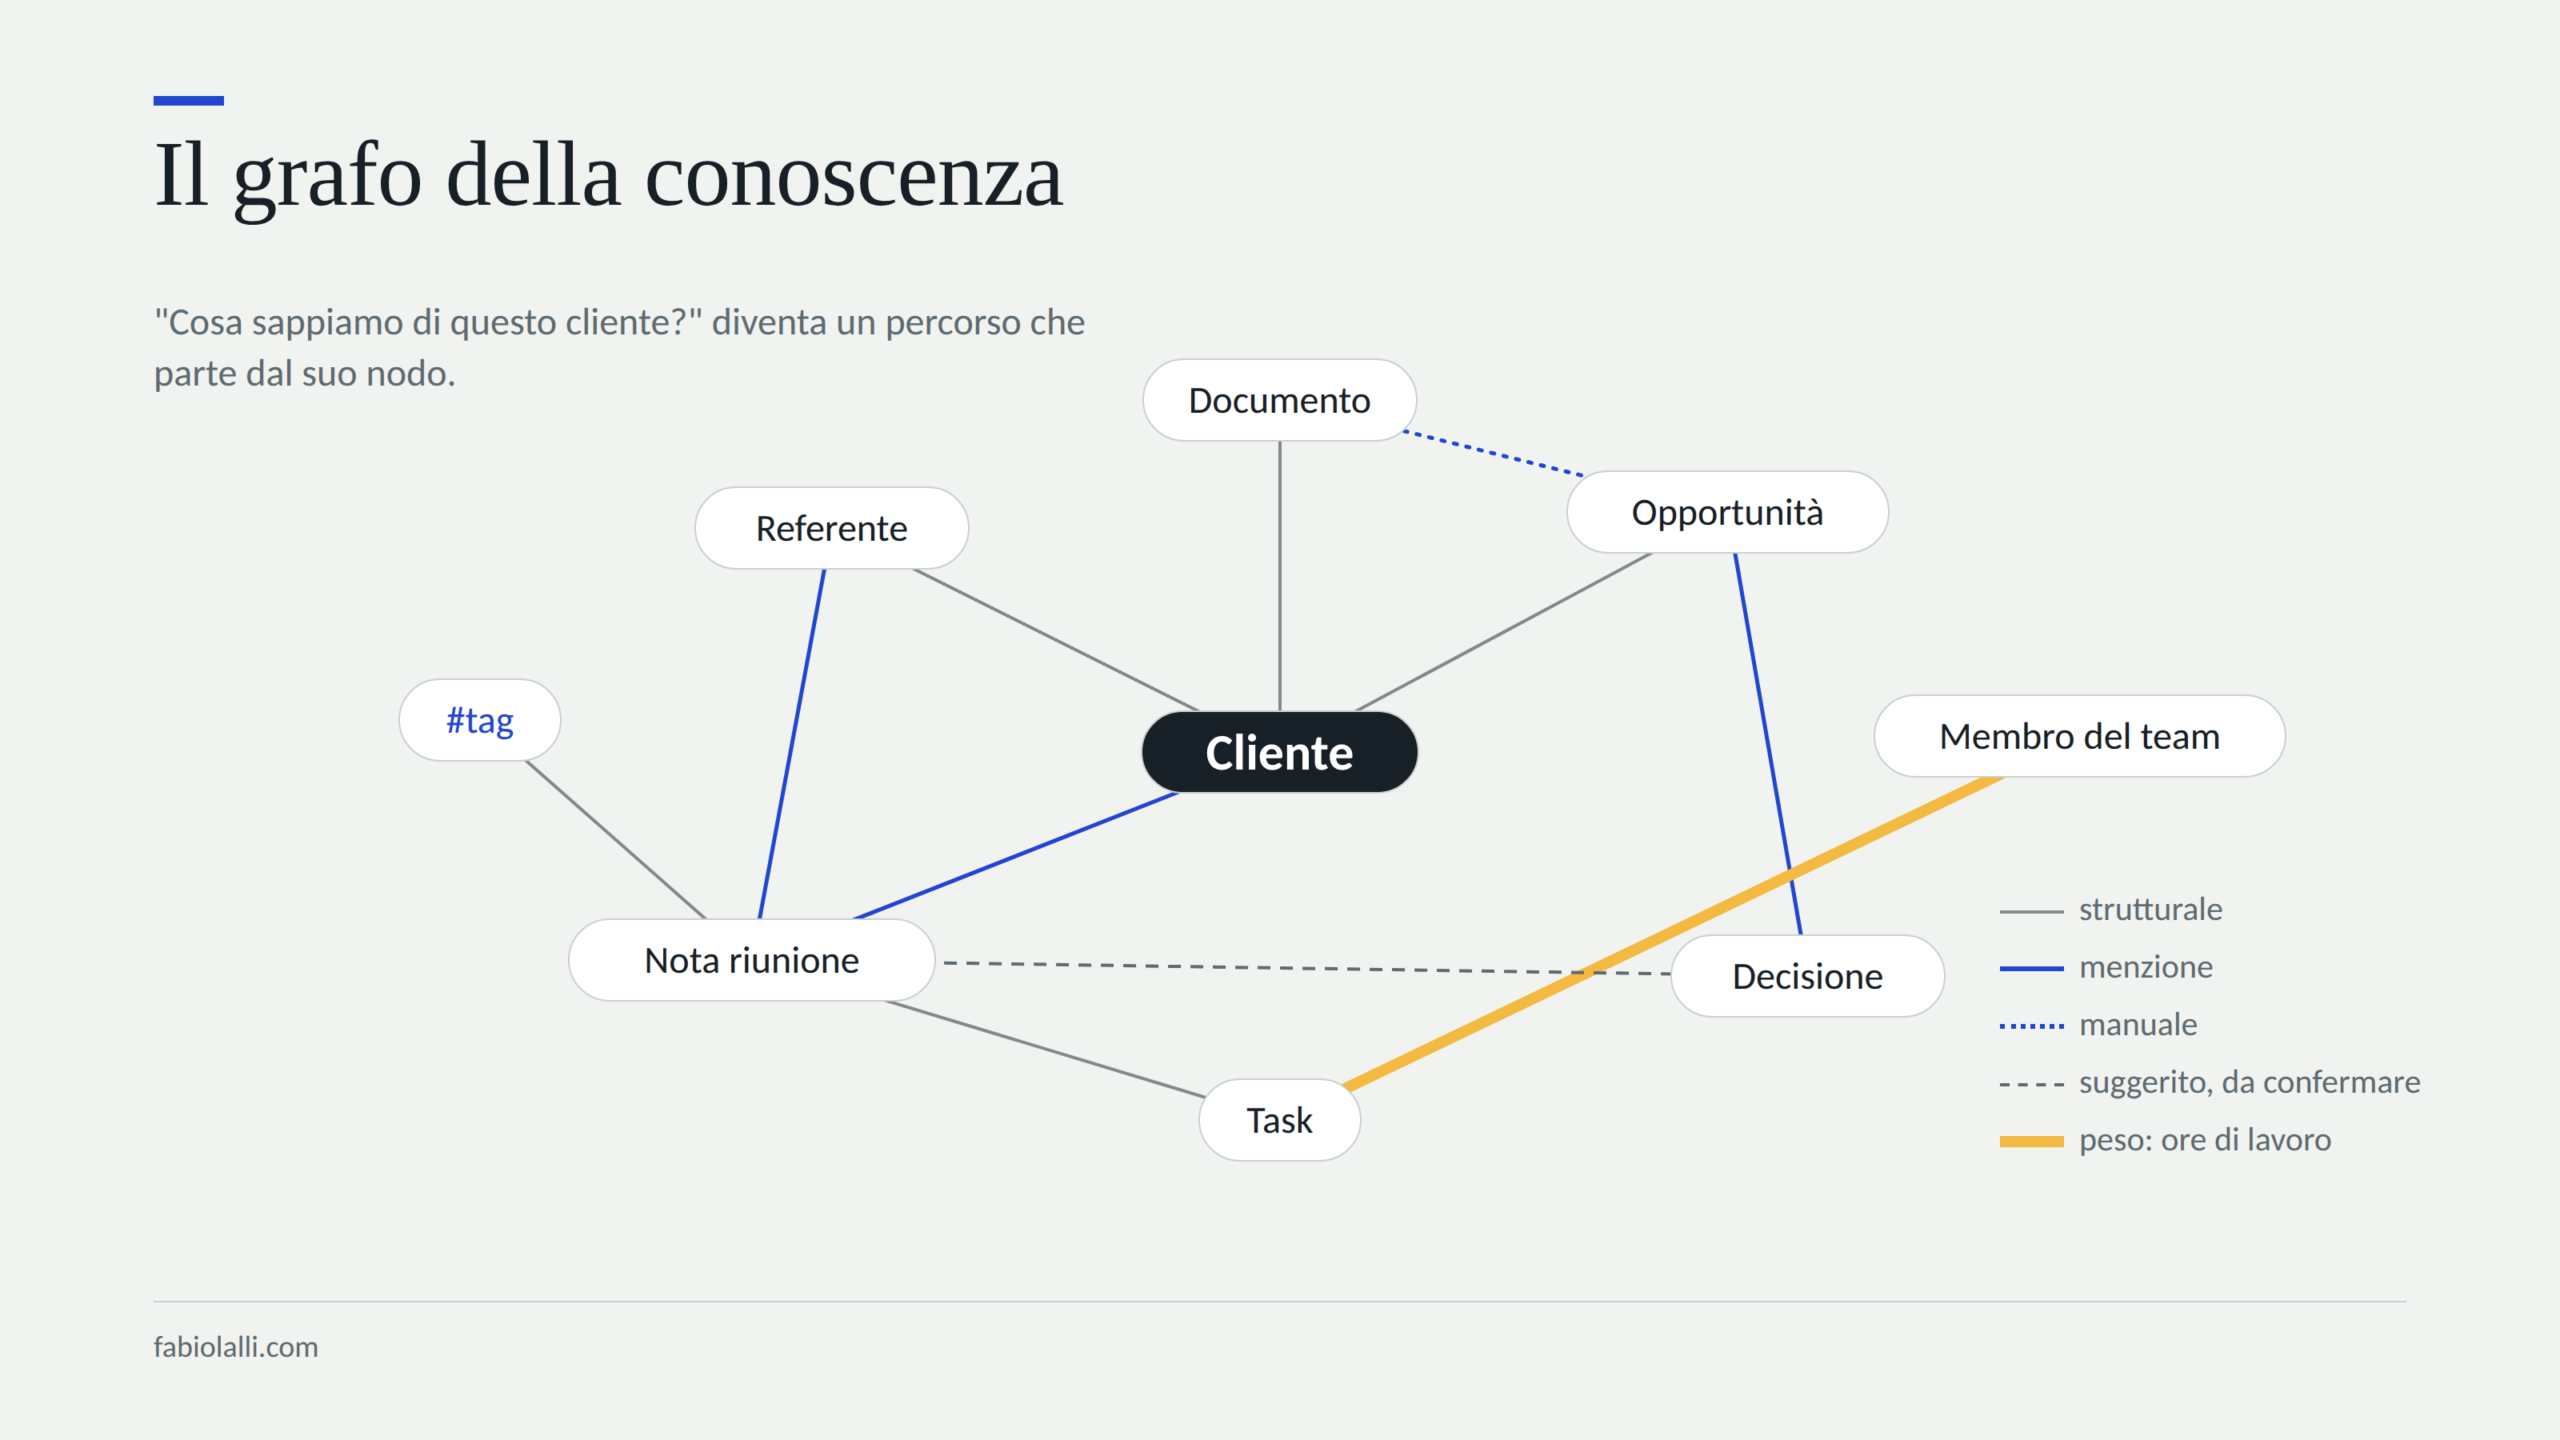
Il risultato è un grafo della conoscenza in cui i nodi sono note, task, documenti, referenti, opportunità, membri del team, cartelle, tag e organizzazioni, e gli archi hanno un’origine dichiarata: strutturale, da menzione, manuale o automatica. Alcuni archi hanno anche un peso, come le ore che una persona ha dedicato a un’attività, così la mappa mostra dove si concentra davvero il lavoro e non solo cosa è collegato a cosa.

Rendere la conoscenza percorribile vuol dire offrire più strade per arrivare alla stessa informazione. Dalla mappa del progetto si parte da un nodo e se ne esplora il vicinato fino a tre passi di distanza. Da ogni oggetto si vedono i collegamenti in uscita e quelli in entrata, cioè chi lo cita. La timeline restituisce la sequenza degli eventi, la ricerca attraversa note, task, documenti, testo estratto e tag di tutti i progetti leggibili. E il modello usa le stesse strade: prima di una riunione con un referente prepara il brief partendo dal suo nodo, raccogliendo le note recenti che lo citano, le opportunità aperte, i task in scadenza e le divergenze ancora da chiudere. Alla domanda “cosa sappiamo di questo cliente” il sistema risponde con un percorso nel grafo che parte dal nodo del cliente.

Quale modello per quali dati

Con la conoscenza centralizzata, strutturata e collegata, la scelta del modello diventa una decisione molto più semplice e molto meno rischiosa, perché il modello non contiene niente. Il cuore del sistema è il livello di conoscenza con il suo server di accesso: il modello è un lettore e un proponente, e si può sostituire senza perdere nulla. Il mio assistente personale si chiama Gideon, come l’intelligenza artificiale che in The Flash mostra a Barry Allen i giornali del futuro. Il mio si accontenta di sapere cosa abbiamo deciso martedì, e se domani cambiassi il modello che lo fa funzionare continuerebbe a saperlo, perché quella memoria non sta dentro di lui.

Il collegamento passa oggi quasi sempre da un server MCP, il protocollo che i principali assistenti usano per parlare con strumenti esterni. Il server del Workspace gira su un dominio proprio, con autenticazione OAuth, ed espone oltre sessanta strumenti: leggere e scrivere note, aprire task, caricare documenti, registrare il tempo di una riunione, interrogare il grafo di un progetto. Lo stesso server serve qualsiasi client compatibile, e il principio da tenere fermo è che il modello opera sempre con i permessi reali della persona che lo sta usando, mai con un’utenza tecnica onnipotente.

Da qui le strade sono sostanzialmente due, e spesso convivono. La prima sono i client dei prodotti noti, Claude, ChatGPT e gli altri assistenti commerciali: offrono i modelli più capaci, connettori già pronti verso posta, calendari e archivi, e un’esperienza che le persone conoscono. Il prezzo è che i dati letti dal modello transitano sui server del fornitore, con le garanzie contrattuali del piano sottoscritto. La seconda sono i client con AI locale, che eseguono modelli aperti su macchine aziendali o su server interni: i dati non escono dal perimetro dell’azienda, i costi sono prevedibili, e in cambio si accettano modelli meno potenti sui compiti più complessi, più lavoro di manutenzione e un’infrastruttura da gestire.

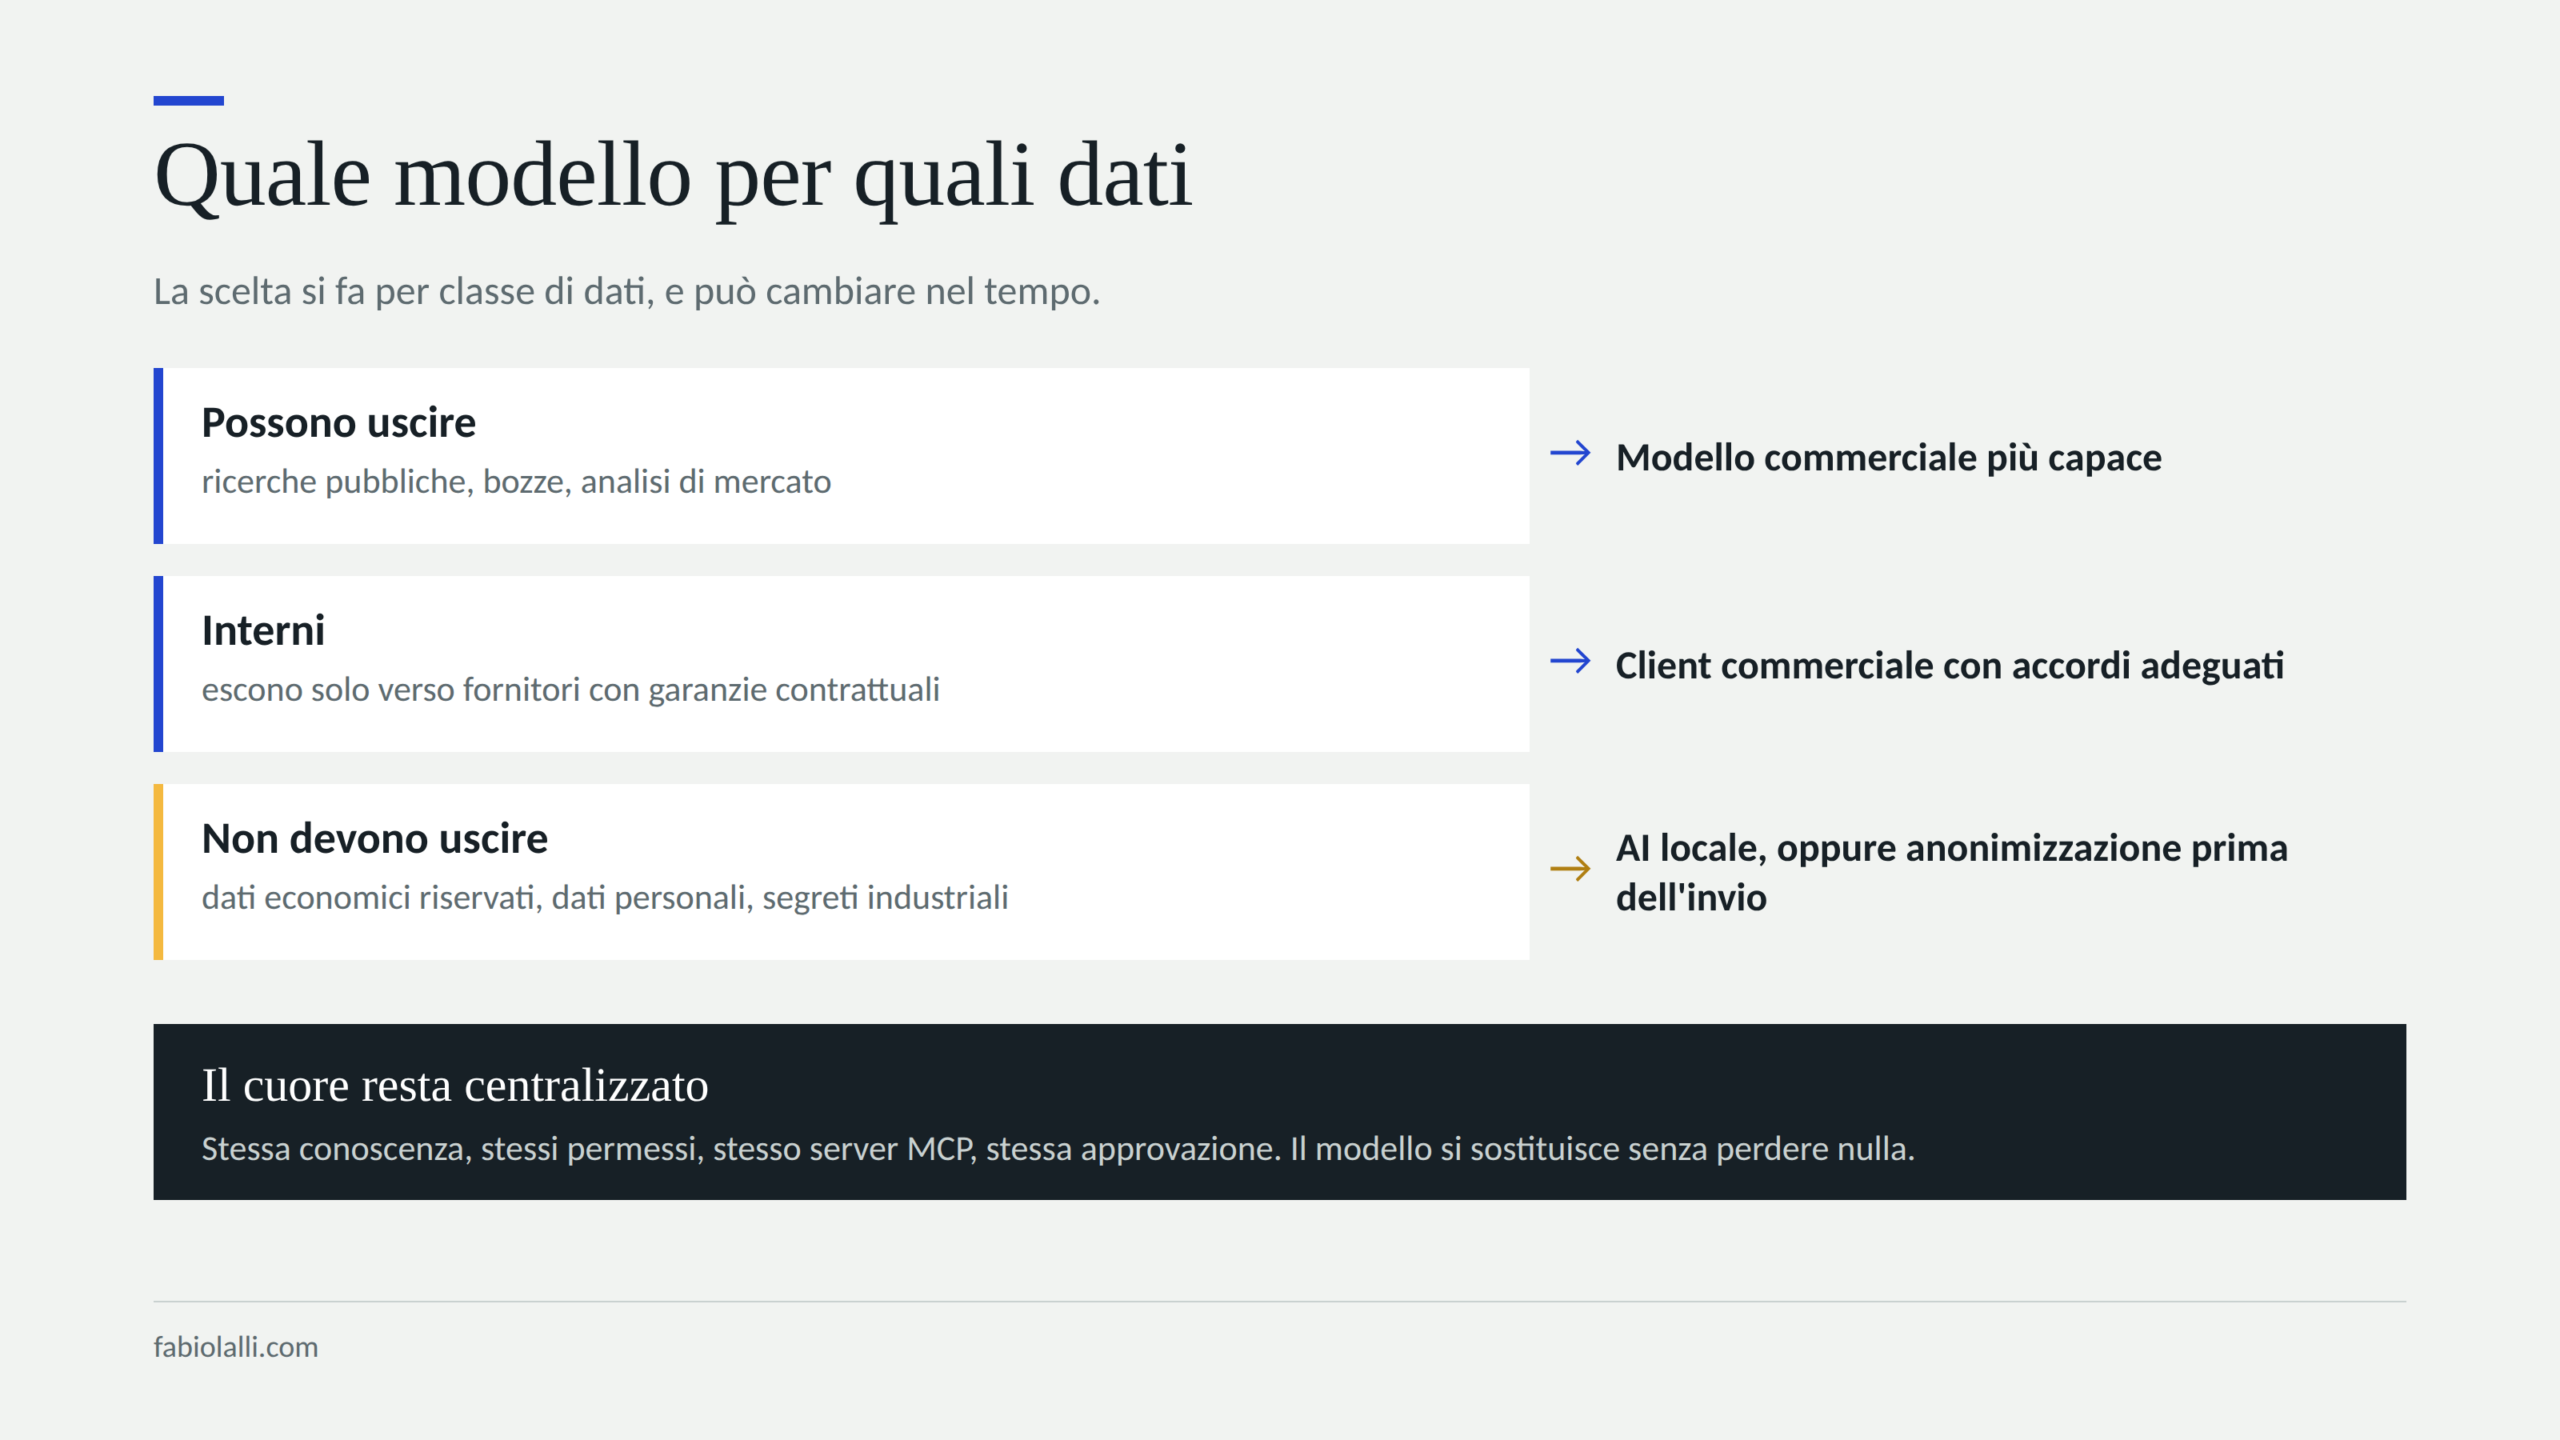
La scelta si fa per classe di dati, e può cambiare nel tempo. Un modo pratico è classificare le informazioni del progetto su tre livelli: dati che possono uscire (ricerche pubbliche, bozze di contenuti, analisi di mercato), dati interni che possono uscire solo verso fornitori con garanzie contrattuali adeguate, dati che non devono uscire per nessun motivo, come informazioni economiche riservate, dati personali sensibili o segreti industriali. Ai primi due livelli si applica il modello più capace disponibile, al terzo un modello locale, oppure un passaggio di anonimizzazione prima dell’invio. Nel Workspace questa classificazione è già parzialmente scritta nell’ontologia, perché le note e i documenti riservati sono marcati come tali, e quel marcatore diventa il criterio naturale per decidere quali oggetti affidare a un client locale.

Il punto fermo, in entrambi i casi, è che il cuore resta centralizzato. Che il modello giri in un data center americano o su un server nel seminterrato, legge la stessa conoscenza, con gli stessi permessi, attraverso lo stesso server, e propone modifiche che passano dalla stessa approvazione. Cambiare fornitore, o affiancarne due, diventa una decisione di costo e di riservatezza, senza progetti di migrazione.

Skill condivise in un catalogo unico

Una skill è il modo in cui si insegna a un assistente a fare una cosa sempre nello stesso modo: istruzioni in testo, riferimenti da consultare al momento giusto, script che verificano ciò che può essere verificato. Il paragone più vicino è il manuale operativo di un nuovo collaboratore, con la differenza che questo manuale viene letto davvero, ogni volta.

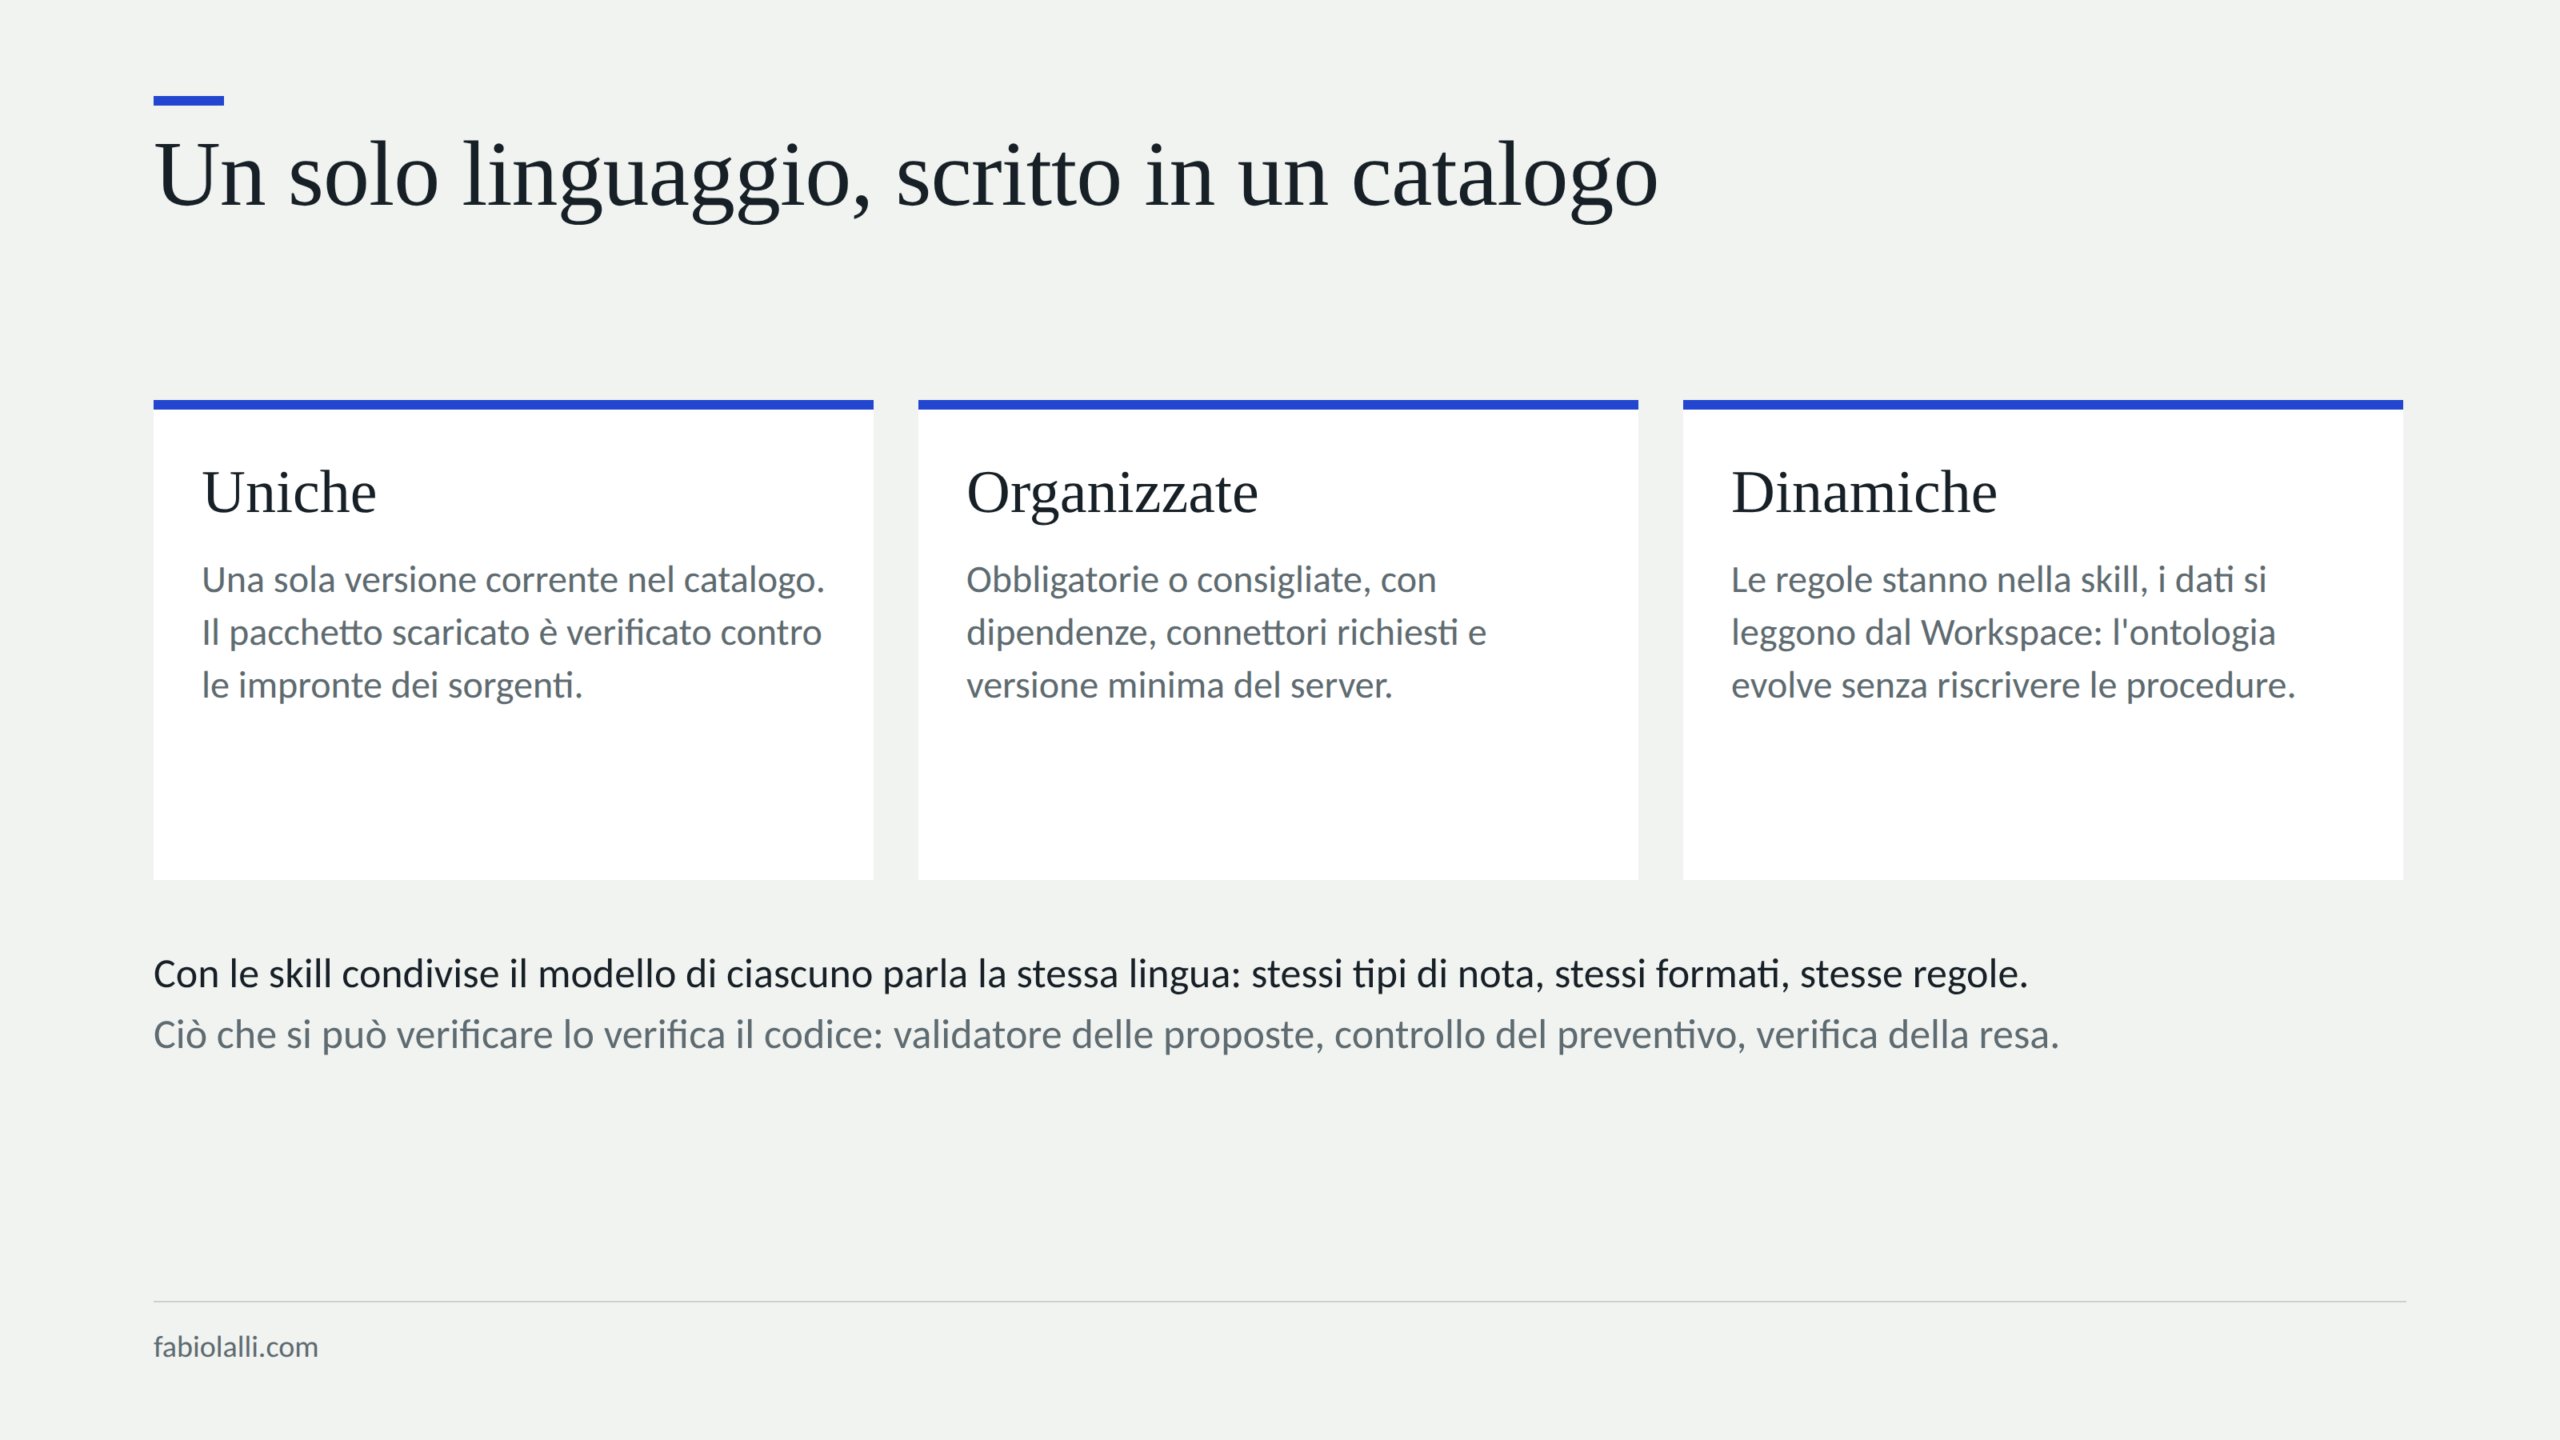
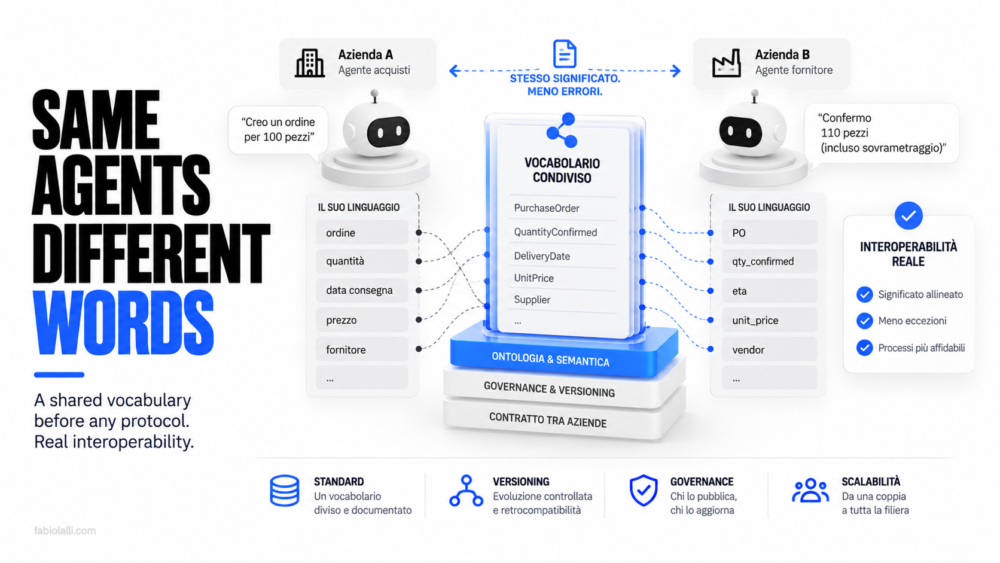
Il loro valore in un team va oltre l’efficienza del singolo. Quando dieci persone usano un LLM senza skill condivise, ciascuno scrive le note a modo suo, chiama le cose con nomi diversi, sceglie tag diversi, struttura le proposte con sezioni diverse, e il modello amplifica queste differenze invece di ridurle. Con le skill condivise il modello di ciascuno parla la stessa lingua: usa gli stessi tipi di nota, propone gli stessi formati, rispetta le stesse regole di stile, chiama un rischio “rischio” e una decisione “decisione”. Le skill sono il veicolo con cui l’ontologia arriva dentro ogni conversazione, senza che nessuno debba ricordarla.

Nel Workspace le skill sono tre e lavorano insieme. La skill di raccolta legge le fonti, smista per progetto, propone note, task, ore, referenti e collegamenti, prepara i brief, gestisce le verifiche. La skill documentale produce i documenti per i clienti da un motore unico: copertina, intestazione, palette e coordinate aziendali sono fisse, cambiano solo contenuti e firma di chi redige, e un controllo di stile automatico intercetta i tic di scrittura prima della consegna. Su questa si appoggia la skill commerciale, che segue una proposta dal brief all’opportunità nel progetto fino al preventivo nel CRM, con uno script che verifica al centesimo che documento e preventivo coincidano.

Conta molto anche il luogo dove le skill vengono scritte. Se vivono nei computer delle persone, dopo tre mesi ne esistono cinque versioni leggermente diverse, ognuna con le sue correzioni locali, e il linguaggio comune si disgrega dalla periferia. Per questo nel Workspace le skill stanno in un catalogo unico, dentro la piattaforma: ogni skill esiste in una sola versione corrente, con le note di rilascio, i connettori di cui ha bisogno, la versione minima del server, le altre skill da cui dipende e uno stato che la rende obbligatoria o consigliata. I sorgenti sono archiviati file per file con la loro impronta crittografica, e il pacchetto che ogni collaboratore scarica viene verificato contro quelle impronte.

Il catalogo rende le skill anche dinamiche nella struttura. Una skill ben scritta separa le regole dai dati: non contiene l’elenco dei tag del progetto né i domini del cliente, li legge dal Workspace nel momento in cui serve, così l’ontologia evolve senza dover riscrivere le procedure. Quando cambia una regola, si pubblica una nuova versione nel catalogo e ogni collaboratore la riceve con le note di rilascio. Il motore documentale è stato riscritto in Python con la sola libreria standard proprio per non legare le skill a un solo assistente: lo stesso pacchetto gira su qualsiasi piattaforma che esegua Python, compresi i client con AI locale.

La lezione tecnica più utile riguarda il confine tra quello che decide il modello e quello che decide il codice. Tutto ciò che si può verificare in modo deterministico va tolto al giudizio del modello. Prima di essere inviato, ogni pacchetto di proposte attraversa un validatore con nove regole. Il preventivo viene ricontrollato da uno script. Il documento passa da una verifica della resa in PDF. Al modello resta il lavoro che sa fare meglio, leggere, collegare e proporre, e il codice garantisce che il risultato rispetti le regole.


Il modello propone, le persone firmano

Il livello che tiene insieme tutti gli altri è una regola di governo molto semplice: niente entra nella memoria del progetto senza che una persona lo approvi. Quando il modello esegue la raccolta settimanale non scrive nulla, prepara un pacchetto di proposte. Ogni proposta dichiara l’operazione (crea una nota, apri un task, registra un’ora, collega due oggetti, apri una verifica), il progetto di destinazione, un estratto della fonte di massimo trecento caratteri con data e autore, un livello di confidenza e, quando serve, un marcatore che la segnala come da verificare o come contenuto economico riservato.

Il responsabile apre il pacchetto, approva, corregge o rifiuta. L’applicazione avviene con i suoi permessi, e se una proposta dipende da un’altra (un collegamento tra due note che nascono nello stesso pacchetto) il sistema le applica nell’ordine giusto. Una proposta rifiutata viene ricordata insieme alla sua origine e non torna alla raccolta successiva, quindi il sistema impara cosa non serve senza bisogno di istruzioni più lunghe.

La ragione di questa rigidità è pratica. Una base di conoscenza inquinata da un modello troppo zelante è peggio di una base vuota, perché nessuno sa più quali informazioni sono state verificate da una persona e quali sono state dedotte. Con le proposte approvate ogni oggetto del progetto ha un’origine e un responsabile, e se tra sei mesi qualcuno chiede perché è stata presa una certa decisione, la risposta porta a una riunione, a una persona, a una data.

Da dove cominciare

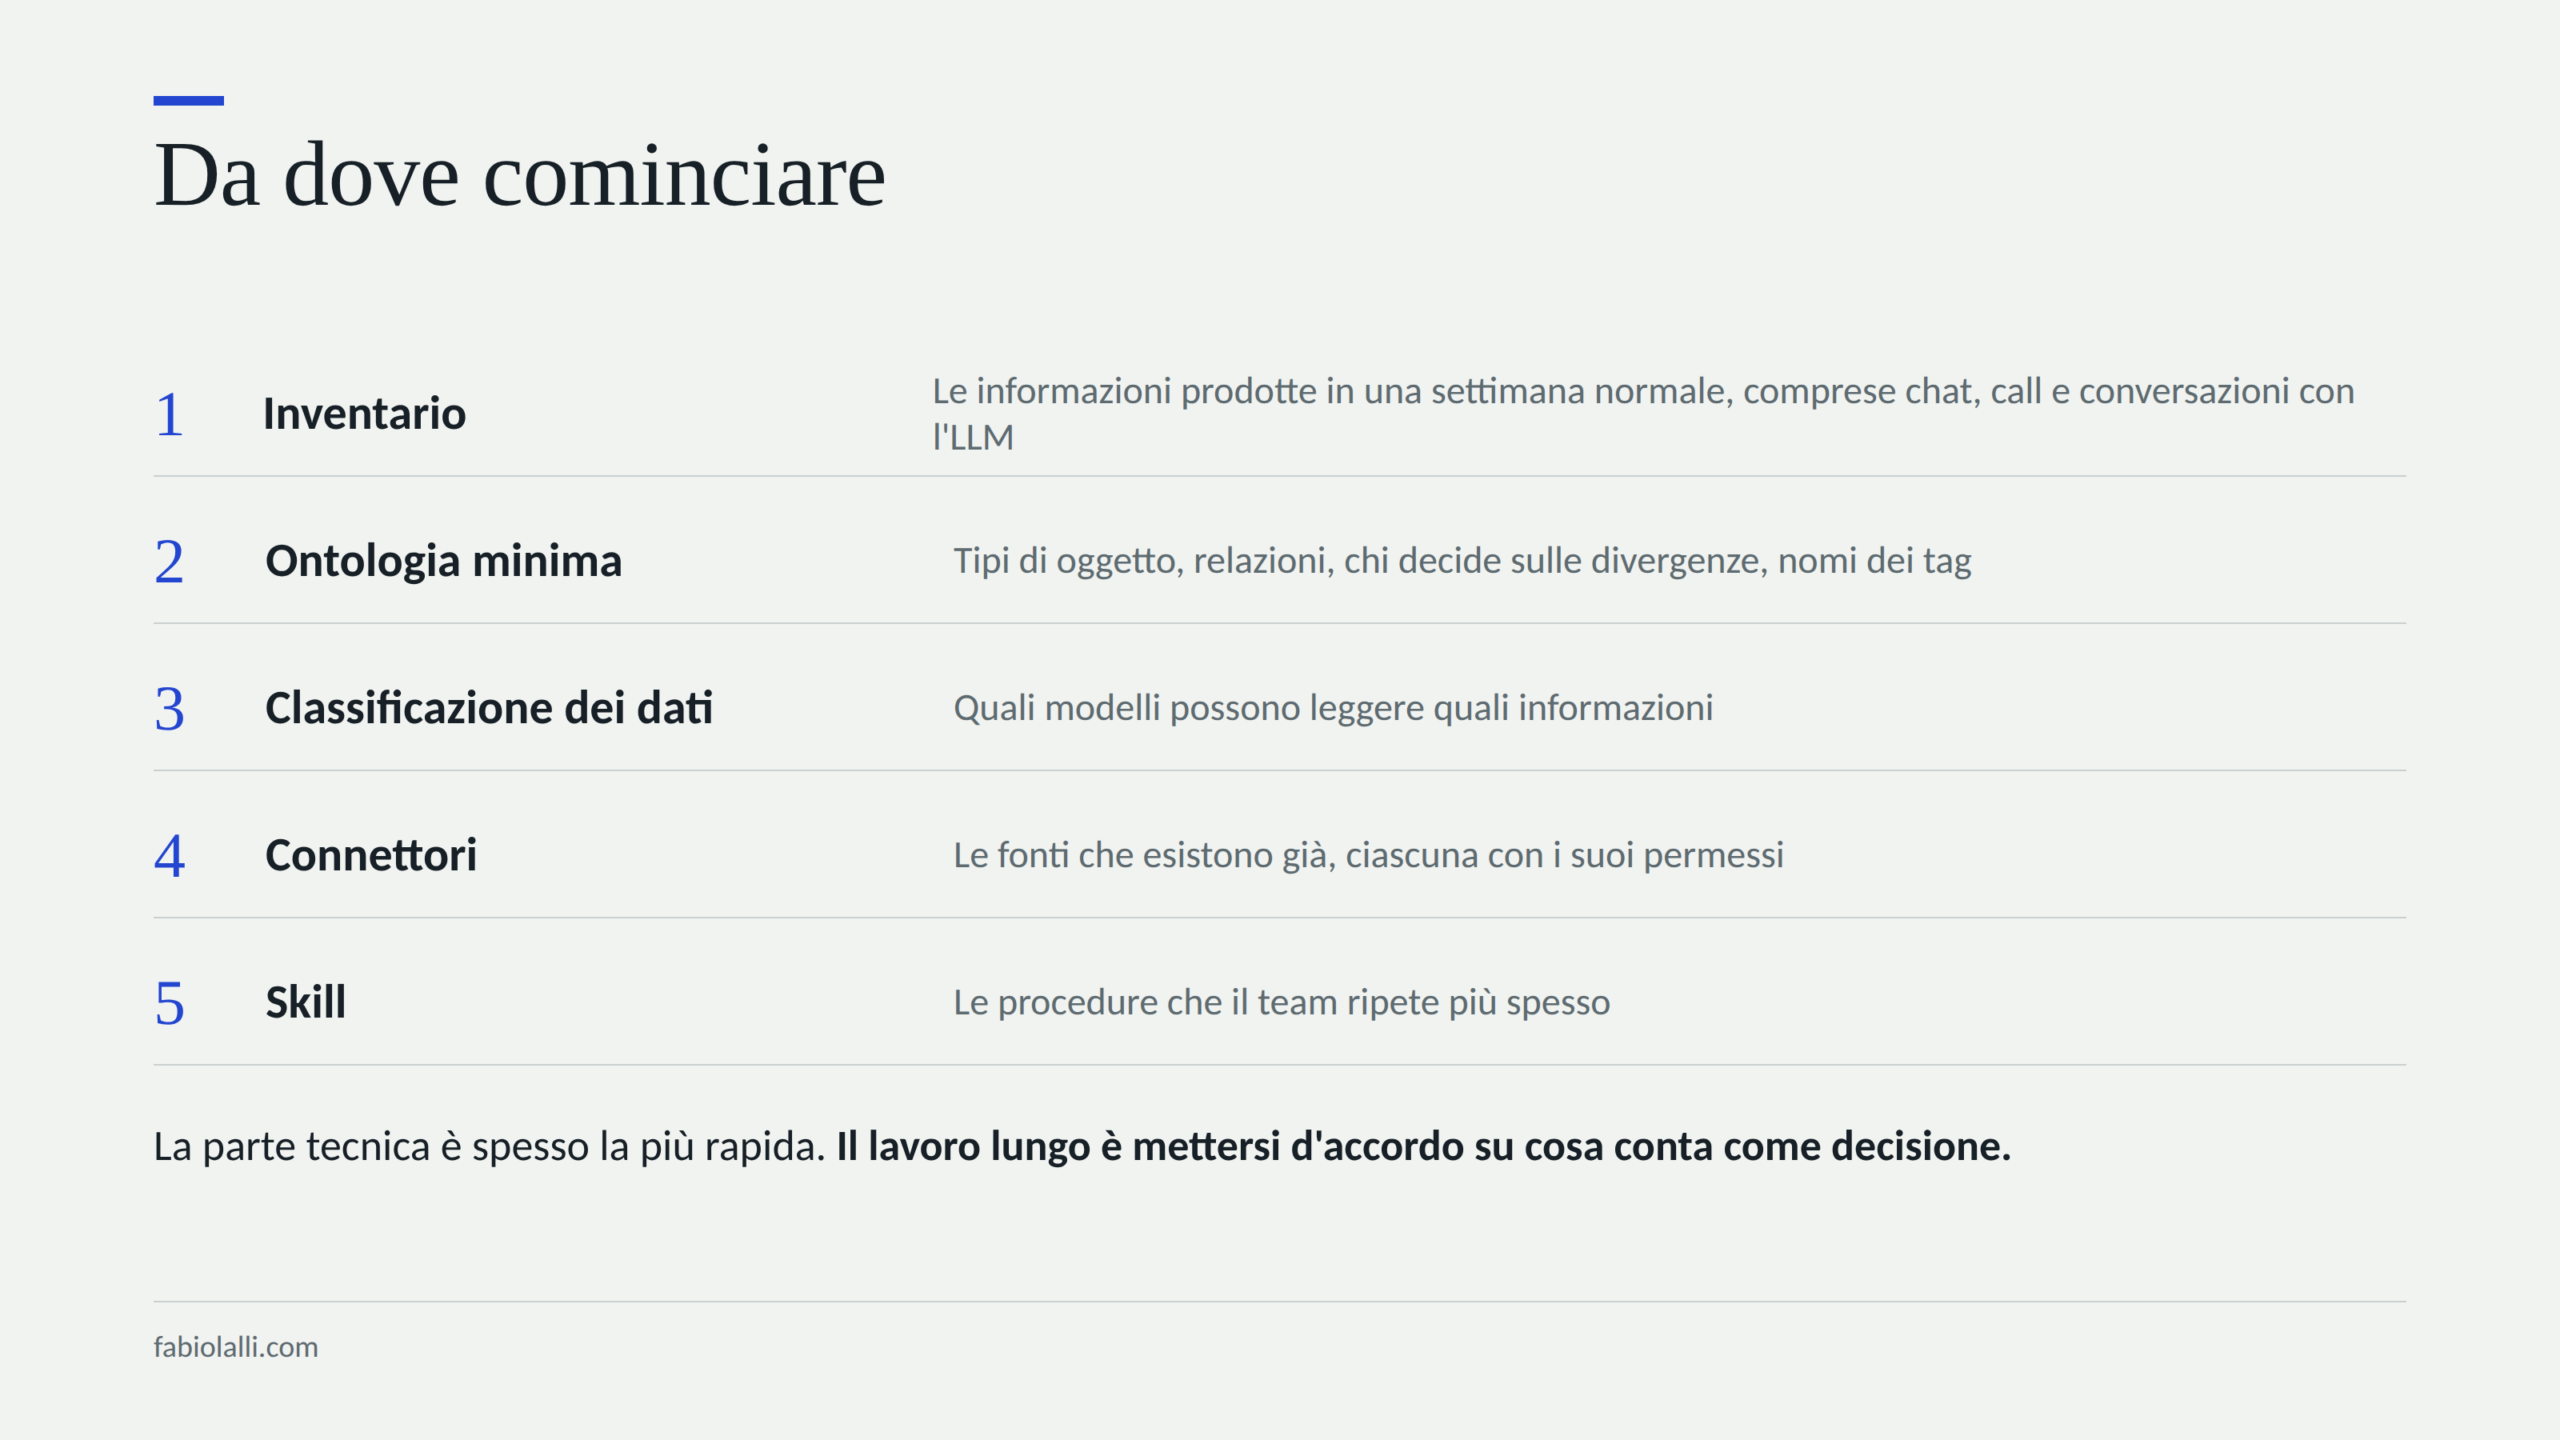
Chi parte da zero dovrebbe cominciare dalla carta e lasciare gli strumenti per dopo. Prima l’inventario delle informazioni che il team produce davvero in una settimana normale, comprese quelle che oggi si perdono nelle chat, nelle call e nelle conversazioni con l’LLM, e del sistema che ne è proprietario. Poi l’ontologia minima: quali tipi di oggetti esistono, quali relazioni servono, chi decide sulle divergenze, come si chiamano i tag. Poi la classificazione dei dati, che dice quali modelli possono leggerli. Infine i connettori e le skill, partendo dalle procedure che il team ripete più spesso e che oggi dipendono dalla memoria di una persona.

La parte tecnica, in molti casi, è la più rapida. Le fonti esistono già, hanno i loro connettori, e spesso basta farle convergere in un punto con un criterio di ingresso. Il lavoro più lungo è organizzativo: mettersi d’accordo su cosa conta come decisione, su chi può chiudere una divergenza, su quali dati non devono uscire dall’azienda e su quali tag hanno diritto di esistere è una conversazione che in molte aziende non è mai stata fatta. Scrivere nero su bianco quali sono gli oggetti della conoscenza di un team, e chi ne risponde, è il primo pezzo di uno spazio intelligente, e viene molto prima della scelta del modello da collegare.


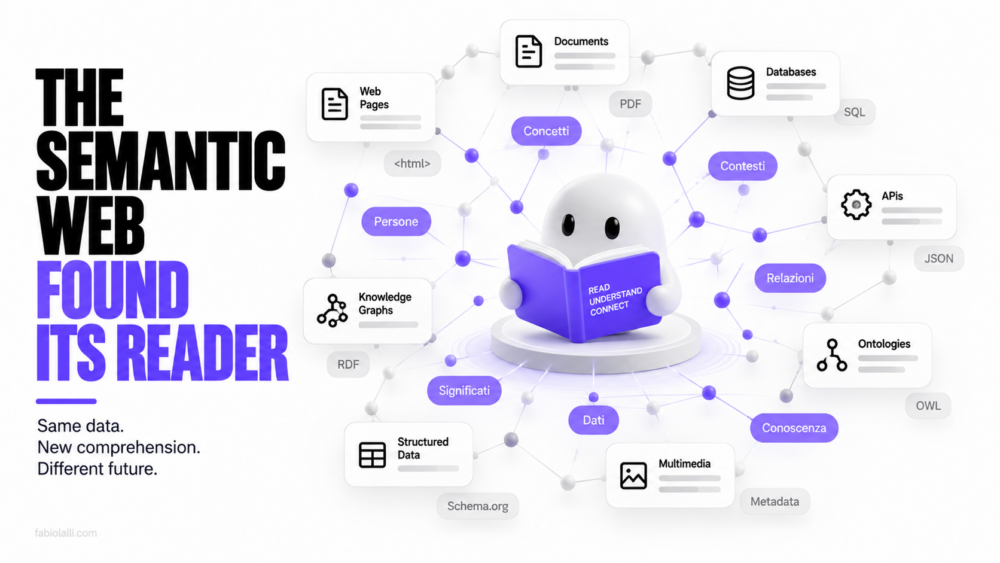
Il web semantico ha aspettato il lettore giusto

Il web semantico ha una data di nascita precisa. Nel maggio del 2001 Tim Berners-Lee firmò con James Hendler e Ora Lassila un articolo su Scientific American in cui descriveva un web fatto di dati leggibili dalle macchine, con agenti software che prenotavano visite mediche incrociando calendari, coperture assicurative e distanze. L’articolo circolò moltissimo, generò standard veri, e la visita medica non la prenotò nessuno.

La scena d’apertura era quasi domestica. Pete e Lucy devono organizzare un ciclo di fisioterapia per la madre, e l’agente di Pete cerca i centri convenzionati con l’assicurazione entro una certa distanza e incastra gli appuntamenti nelle agende dei due fratelli. Quasi nessuno ricorda che quell’agente non capiva una parola di quello che leggeva: funzionava solo perché ogni pagina del web, dagli orari dello studio medico alle condizioni della polizza, era già stata descritta dai suoi autori in un linguaggio formale. Nel 2001 l’agente poteva essere stupido perché il web doveva essere intelligente.

Venticinque anni dopo è andata al contrario: gli agenti hanno imparato a leggere il testo così com’è, il web non è mai stato descritto, e il vocabolario formale che doveva servire a quei software sta tornando nei progetti aziendali con un nome leggermente diverso.

Perché il web semantico non attecchì

Gli strumenti del web semantico furono costruiti sul serio. RDF per esprimere fatti come triple, OWL per definire classi e relazioni, SPARQL per interrogare. Sono tecnologie solide, sopravvissute nei domini dove la semantica vale abbastanza da giustificare la fatica: biomedicina, beni culturali, dati pubblici, editoria scientifica.

Fuori da quei domini non è successo niente, e la ragione è banale quanto decisiva. Annotare costava lavoro umano immediato, il beneficio era differito e andava a qualcun altro, e non esisteva nessuno disposto a pagare quel lavoro. Chi pubblicava una pagina non aveva motivo di descriverne il contenuto in una forma che serviva a un software di cui non conosceva nemmeno l’esistenza.

I motori di ricerca risolsero il problema per la loro strada, estraendo significato dal testo con la statistica invece di chiederlo agli autori, e quella scorciatoia funzionò così bene da togliere ogni urgenza al resto.

Adesso il lettore non è umano

La condizione che mancava era un consumatore che traesse vantaggio dalla struttura e che fosse disposto a pagarla. Quel consumatore adesso c’è, ha un costo marginale per richiesta e appartiene all’azienda che lo fa girare.

Il meccanismo si vede bene dentro un’azienda qualsiasi. Un agente che lavora sulla documentazione interna trova «cliente attivo» nel CRM, dove indica chi ha un contratto aperto, e nella reportistica amministrativa, dove indica chi ha pagato almeno una fattura nell’ultimo anno, e ogni volta deve capire quale dei due sensi vale per la domanda che ha davanti. Lo fa leggendo più contesto, a volte chiedendo, a volte sbagliando, e lo rifà alla richiesta successiva perché quella risoluzione non viene scritta da nessuna parte. Ogni ambiguità non dichiarata si paga di nuovo a ogni lettura, in token e in errori.

È un rovesciamento completo dell’economia del web semantico. Prima il beneficio era esterno e diffuso, e per questo nessuno investiva. Adesso è interno e misurabile sulla bolletta di chi costruisce l’ontologia, e chi la costruisce tiene per sé sia il risparmio sia il vocabolario. Il conto che arriva a fine mese misura l’ambiguità che nessuno aveva mai messo per iscritto, ed è la prima volta che quella misura esiste.

Per questo l’ontologia sta rientrando dalla porta dell’efficienza dopo aver fallito da quella della condivisione. Il ritorno è privato, con grafi aziendali chiusi, vocabolari che nessuno pubblica e mappature bilaterali fra chi ha bisogno di parlarsi, che è esattamente la condizione in cui la traduzione fra ontologie private si paga per coppia. Del progetto originale resta la tecnica e si perde l’idea di un bene comune, che era la parte per cui valeva la pena scriverne su una rivista.

L’unico pezzo che ha funzionato

Una parte di quel progetto ha funzionato, e vale la pena guardarla perché spiega il resto. Schema.org, il vocabolario nato nel 2011 per descrivere pagine, prodotti, eventi, ricette e recensioni, è oggi sui milioni di siti, e nessuno lo ha adottato per amore della semantica.

Lo hanno adottato perché i motori di ricerca hanno offerto un vantaggio immediato e visibile a chi marcava le proprie pagine, sotto forma di risultati arricchiti, stelline, prezzi e tempi di cottura sotto il link. Un responsabile marketing che vede il proprio risultato occupare più spazio in pagina firma quel lavoro senza chiedersi cosa sia un’ontologia.

È lo stesso meccanismo che oggi sta riportando in vita il resto. La struttura si adotta quando produce un beneficio che si vede entro il trimestre a chi sostiene il costo, e il beneficio che si vede entro il trimestre adesso si chiama spesa di inferenza.

Qualcosa di simile sta già succedendo, in scala più piccola, dal lato degli agenti. Quando Anthropic ha pubblicato il Model Context Protocol, alla fine del 2024, ha chiesto a chi espone un servizio di descrivere ogni strumento con un nome, una spiegazione in linguaggio naturale e uno schema formale dei parametri, e migliaia di sviluppatori lo hanno fatto senza discutere, per lo stesso motivo delle stelline sotto i link: se la descrizione è scritta bene l’agente usa lo strumento, altrimenti lo ignora o lo usa male. Rispetto a Schema.org questi schemi descrivono quello che si può fare, i verbi, e lasciano scoperti i sostantivi, cioè cosa sono le cose su cui si agisce, che è proprio la parte di cui si occupa un’ontologia.

Il modello che costruisce le proprie regole

C’è un secondo motivo per cui adesso funziona, e riguarda il costo dell’annotazione. Estrarre entità e relazioni da un corpus, che venticinque anni fa era lavoro manuale da specialisti, oggi lo fa un modello linguistico con una qualità che in molti domini basta.

La circolarità è evidente e va guardata in faccia. Si usa un sistema statistico per produrre lo schema formale che dovrebbe disciplinare i sistemi statistici, e se l’estrazione sbaglia una relazione, quella relazione diventa struttura, e la struttura viene creduta più del testo da cui è stata ricavata proprio perché è strutturata.

Un errore in un documento resta un errore in un documento. Un errore nel grafo diventa una regola, e le regole hanno la proprietà di sopravvivere a chi le ha scritte, come accade a ogni schema che nessuno ha più l’autorità di emendare.

La stessa dinamica vale per le omissioni. Un’estrazione automatica trova quello che somiglia a ciò che ha visto in addestramento, e le relazioni idiosincratiche di una singola azienda, quelle nate da un accordo particolare o da una vicenda societaria, sono proprio quelle che il modello tende a normalizzare in categorie più comuni. Il grafo che ne esce descrive bene un’azienda media del settore e descrive male la tua, che è l’unica per cui serviva.

La provenienza era già negli standard

Lo stack del 2001 conteneva già una risposta a questa circolarità, ed è la parte che si è usata meno. Nel 2013 il W3C ha pubblicato PROV-O, un vocabolario per registrare l’origine di un dato, cioè l’attività che lo ha generato e il soggetto che ne risponde, pensato proprio per i grafi in cui fatti di provenienza diversa finiscono mescolati.

Applicato all’estrazione automatica diventa una regola di igiene facile da enunciare e faticosa da rispettare: ogni relazione che entra nel grafo si porta dietro il passaggio del documento da cui è stata ricavata e la versione del modello che l’ha estratta. Quando una relazione si rivela sbagliata, quella traccia permette di tornare al passaggio e capire se l’errore sta nel testo o nell’estrazione. Permette anche di trovare tutte le altre relazioni nate dalla stessa fonte o dallo stesso modello, che con buona probabilità condividono il difetto.

Un grafo estratto senza provenienza è una scatola nera con l’aspetto dell’ordine, e correggerlo vuol dire intervenire su una relazione alla volta senza sapere quante altre ne condividano la causa. Con la provenienza il grafo si può interrogare anche sulla propria affidabilità, ed è questo che permette di concentrare la verifica dove serve invece di distribuirla ovunque.

Chi valida quando nessuno legge

Qui torna la parte che il web semantico non ha mai risolto e che l’automazione non risolve da sola, perché riguarda la fiducia nello schema più che la sua costruzione. Un’ontologia estratta va verificata da qualcuno che conosca il dominio, e quella verifica non si può distribuire su tutto il corpus, va concentrata dove le conseguenze pesano.

Il criterio che userei è banale: si controlla a mano quello su cui un agente prenderà decisioni con effetti verso l’esterno, contratti, pagamenti, obblighi verso clienti e autorità, e si lascia all’estrazione automatica tutto il resto, accettando che lì la qualità sia buona e non certa. Chiunque prometta una validazione completa su un grafo di milioni di relazioni sta descrivendo un progetto che finirà male.

Con questo pezzo chiudo la serie sull’ontologia. Abbiamo passato venticinque anni a spiegare alle aziende che descrivere i propri dati era un investimento, e non ha funzionato perché il beneficio non aveva un destinatario. Adesso il destinatario esiste, costa, e manda una fattura ogni mese. Non è il modo in cui speravo che arrivasse, ed è il modo in cui sta arrivando.

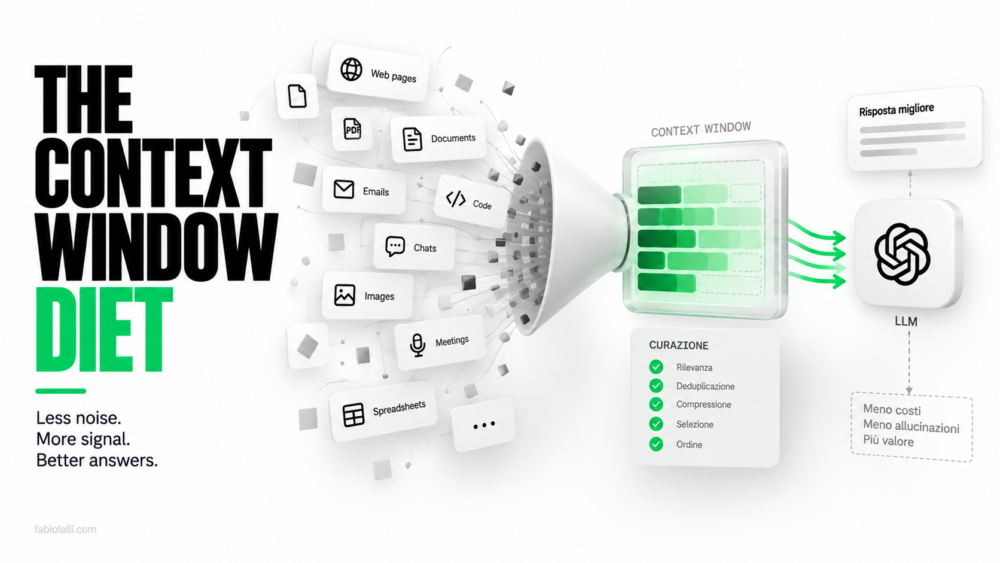
La dieta della finestra di contesto

Quando la finestra di contesto era piccola, il mestiere consisteva nel far stare dentro il necessario. Adesso che ci stanno interi archivi, il riflesso di molti è caricare tutto e lasciare che il modello si arrangi, e la spesa cresce senza che la qualità delle risposte cresca in proporzione.

Una finestra di contesto grande ha risolto un vincolo tecnico e ne ha reso visibile un altro, che riguarda l’attenzione del modello più che la sua capienza.

Il riflesso di caricare tutto

L’abitudine viene dai primi sistemi di recupero, quelli in cui si prendevano i venti frammenti più simili alla domanda e si sperava che la risposta fosse in uno di quelli. Con venti frammenti su un milione di documenti conveniva abbondare, perché il costo di perdersi il pezzo giusto era alto e quello di leggerne qualcuno in più era basso.

Il calcolo cambia quando i frammenti diventano duecento. Il contesto irrilevante non è materiale neutro che il modello scarta senza fatica, è materiale che compete con quello rilevante, e in un testo lungo le informazioni che stanno a metà vengono usate peggio di quelle che stanno agli estremi.

L’effetto della posizione è documentato da tempo. Nel 2023 un gruppo di ricercatori di Stanford guidato da Nelson Liu ha pubblicato Lost in the Middle, uno studio in cui lo stesso documento utile veniva spostato in punti diversi di un contesto lungo, e l’accuratezza dei modelli disegnava una curva a U, alta quando il passaggio giusto stava all’inizio o alla fine e più bassa quando finiva in mezzo. I modelli usciti dopo hanno attenuato quella curva e nessuno ha dimostrato di averla eliminata, per cui più materiale si carica, più aumenta la probabilità che il pezzo decisivo cada proprio nella zona letta peggio.

Più contesto non produce più precisione

Il comportamento si osserva facilmente: prendi una domanda a cui il sistema risponde bene con cinque documenti pertinenti, aggiungi quaranta documenti che parlano dello stesso cliente senza contenere la risposta, e la qualità peggiora. Il modello comincia a citare passaggi vicini al tema e lontani dalla domanda, e quando i documenti si contraddicono fra loro sceglie senza dichiarare di aver scelto.

Chi ha lavorato con archivi reali riconosce lo scenario, perché negli archivi reali la contraddizione è la norma: ci sono tre versioni dello stesso contratto, due delle quali sono bozze mai firmate, e nessuna porta scritto in faccia quale sia quella buona, tanto che la persona esperta la riconosce dal nome del file e dalla cartella in cui sta, informazioni che al modello non arrivano.

Riempire la finestra di contesto solo quando serve

La strada alternativa consiste nel dare all’agente poco materiale e molti modi per chiederne altro. Un indice delle entità, una descrizione di cosa c’è in ciascuna fonte, gli strumenti per interrogarla, e la libertà di fare il secondo giro se il primo non basta.

Anthropic ha chiamato questo approccio contesto just in time, nel testo sul context engineering pubblicato nel 2025, e ha un prezzo che conviene conoscere prima di adottarlo. Ogni giro in più è una chiamata in più, con la sua latenza e i suoi token, e un agente che deve chiedere il materiale funziona solo se sa cosa chiedere: quando l’indice è vago o la descrizione delle fonti è scritta in fretta, l’agente non sa che esiste il documento che gli servirebbe e risponde con quello che ha. La qualità si sposta dal recupero alla descrizione delle fonti, che diventa il testo più letto dell’azienda senza che nessuno lo abbia mai curato come tale.

Il grafo funziona bene in questo schema, perché ti permette di portare nella finestra di contesto solo il perimetro rilevante e di tenere tutto il resto raggiungibile senza essere presente. In una richiesta sui contratti in scadenza entrano l’identificativo del cliente, le entità collegate, i contratti agganciati, e non entra la corrispondenza commerciale degli ultimi tre anni, che pure parla di quel cliente in ogni riga. È lo stesso meccanismo per cui quattro collegamenti costano meno di quaranta documenti, guardato dal lato di cosa entra in finestra.

Il middleware che smista le richieste ai modelli sceglie il modello giusto per ogni richiesta, e qui il criterio è lo stesso applicato al materiale invece che al motore.

Il criterio che uso per decidere cosa entra

La domanda che mi pongo davanti a ogni pezzo di contesto è se la risposta cambierebbe senza. Se la risposta resta uguale, quel materiale sta pagando affitto senza produrre niente, e va spostato dietro uno strumento che l’agente può chiamare se gli serve.

La seconda domanda riguarda la durata. Le istruzioni su come comportarsi valgono per tutta la conversazione e conviene tenerle stabili, i dati di un singolo caso valgono per quella richiesta e conviene farli entrare e uscire. Mescolare le due cose produce contesti che crescono a ogni turno e che a un certo punto contengono il residuo di tre richieste fa.

La terza riguarda chi ha scritto quello che sta entrando. Un documento generato da un altro agente e non verificato da nessuno pesa quanto un documento approvato, e il modello non distingue fra i due. Vale la pena incrociarla con il modo in cui il corpus aziendale si gonfia da solo, perché il materiale che compete con quello buono aumenta a ogni riassunto prodotto per riflesso.

Quando il lavoro dura ore

Un agente che porta avanti un compito lungo, fatto di decine di passaggi, incontra il limite della finestra anche quando ogni singolo passaggio è sobrio, perché la storia della sessione si accumula e ogni turno si porta dietro tutti quelli precedenti. Nello stesso testo Anthropic descrive due modi di gestirla: la compattazione, che a un certo punto riassume la conversazione e la fa ripartire con il riassunto al posto del verbale, e le note strutturate, con l’agente che tiene su un file esterno lo stato del lavoro e le decisioni prese, e le rilegge quando servono invece di portarsele dietro a ogni turno.

Entrambe le tecniche spostano una parte del contesto dentro un testo che nessuno ha verificato. Il riassunto della compattazione decide quale parte della conversazione sopravvive, e lo decide il modello con lo stesso criterio statistico che lo porta a preferire il generico allo specifico, mentre le note sono scritte dall’agente su sé stesso. Il terzo criterio torna qui, applicato al materiale che l’agente produce per proprio uso: un riassunto scritto da un modello entra nella finestra successiva con la stessa autorevolezza di un’istruzione scritta da una persona.

Conviene allora separare nel riassunto le decisioni dalle osservazioni, conservare le prime alla lettera e lasciare comprimere solo le seconde, perché una decisione parafrasata due volte finisce per dire qualcosa di diverso da quello che era stato deciso.

Misurare invece di stimare

Il modo per uscire dalle impressioni è tenere due numeri per ogni tipo di richiesta ricorrente: quanti token entrano nella finestra di contesto e quante risposte risultano corrette su un campione che qualcuno ha verificato a mano. Il primo lo dai già per scontato perché arriva in fattura, il secondo richiede un lavoro che quasi nessuno fa e senza il quale il primo non si può ottimizzare, perché tagliare contesto abbassa sempre il costo e a volte abbassa anche la qualità.

Con i due numeri accanto la prova diventa banale: si toglie una fonte per volta e si guarda cosa succede alle risposte corrette. Nelle configurazioni che ho visto ottimizzare così, la metà del materiale caricato non sposta niente, e il quarto che conta davvero è sempre lo stesso in tutte le richieste dello stesso tipo, il che suggerisce di smettere di recuperarlo dinamicamente e di scriverlo una volta nelle istruzioni.

Gli scarti utili

Una parte di quello che resta fuori vale comunque la pena tenerla a portata. Le eccezioni, i casi che l’anno scorso hanno rotto il processo, le decisioni prese in deroga: sono materiale che non serve quasi mai e che quando serve vale molto più di tutto il resto.

È il tipo di conoscenza che in azienda sta nella testa di due o tre persone e che scompare quando quelle persone cambiano ruolo. Un sistema costruito bene non la carica a ogni richiesta, la rende raggiungibile con una chiamata e la mostra quando il caso somiglia a uno di quelli. È anche la parte che più raramente qualcuno si preoccupa di mettere per iscritto, perché non serve a chi già la sa.

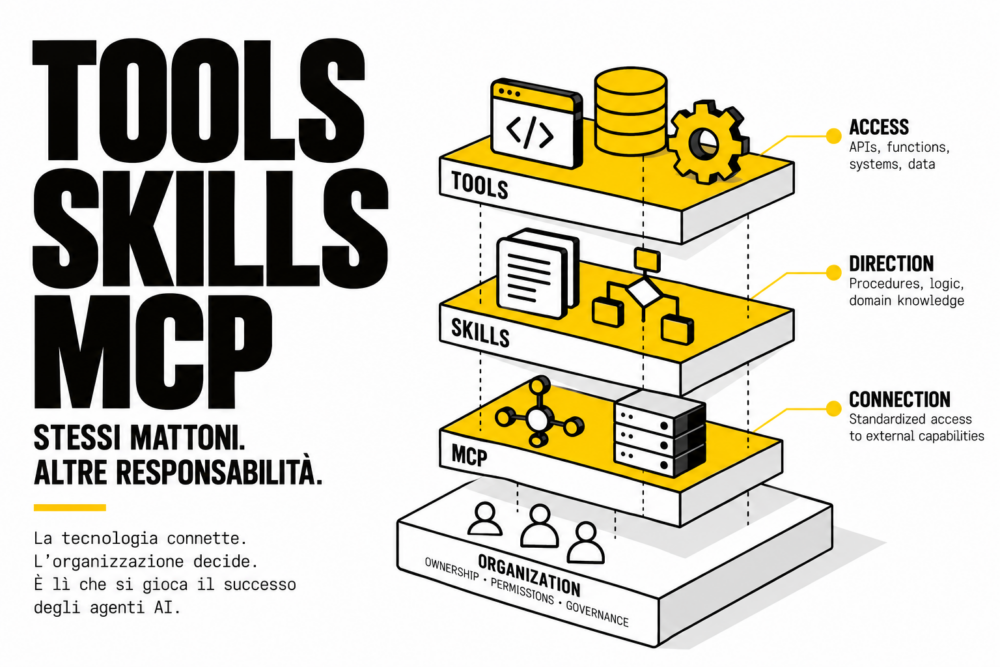
Tool, skill e MCP: prima si disegna l’organizzazione, poi l’agente

Su Medium ho trovato un articolo di Prabhu, che leggo da un po’, Tools vs Skills vs MCP, che mette in una tabella di tre righe i mattoni con cui oggi si costruisce un agente AI: i tool danno accesso, le skill danno direzione, MCP connette a capacità esterne. È una sistemazione utile per chi scrive codice e ha sentito usare le tre parole come sinonimi in una riunione, e la consiglio. Ho però l’impressione che per chi porta gli agenti dentro un’azienda quella tabella vada letta partendo da una colonna che non c’è, quella che dice chi ha deciso la procedura, chi ha concesso il permesso, chi possiede il sistema dall’altra parte del cavo.

Ogni riga della tabella tecnica ha un gemello organizzativo, e il gemello arriva prima. Una skill presuppone una procedura che qualcuno ha deciso e messo per iscritto, un tool presuppone una delega di potere con un perimetro, un server MCP presuppone un confine fra due sistemi che ha già un proprietario. Quando il gemello organizzativo manca la tecnologia non lo crea, lo simula, e la simulazione funziona benissimo finché non succede qualcosa.

Dentro il codice le tre cose si toccano

Conviene partire dal livello tecnico, perché è lì che la tabella semplifica di più. Un tool, nel senso che gli danno le API dei modelli, è una definizione: un nome, una descrizione in linguaggio naturale e uno schema JSON dei parametri. Il modello non esegue niente, produce una richiesta strutturata (chiama questa funzione con questi argomenti) e il runtime che gli sta intorno decide se eseguirla, con quali credenziali e cosa restituire. È la separazione su cui avevo costruito il pezzo sull’harness engineering: fra l’intenzione del modello e l’effetto nel mondo c’è sempre un pezzo di codice che qualcuno ha scritto e che può dire di no.

MCP, pubblicato da Anthropic a fine 2024 e poi adottato dagli altri grandi fornitori, sta un livello sotto i tool. È un protocollo costruito su JSON-RPC 2.0 con cui un’applicazione host apre connessioni verso uno o più server, e ogni server dichiara quali tool mette a disposizione del modello, affiancandoli se serve con risorse da leggere come contesto e con prompt riutilizzabili. Il trasporto può essere locale, un processo lanciato sulla macchina che parla attraverso lo standard input, oppure remoto su HTTP, con l’autorizzazione affidata a OAuth. In pratica MCP è il modo in cui i tool viaggiano: invece di cablare una funzione dentro ogni applicazione la si scrive una volta in un server e la si rende disponibile a qualunque client parli il protocollo.

Le skill sono l’oggetto più recente. Nel formato che Anthropic ha introdotto nell’autunno 2025 e poi aperto come standard, una skill è una cartella con un file SKILL.md, un’intestazione con nome e descrizione seguita da istruzioni in markdown, a cui si possono aggiungere file di riferimento e script eseguibili. Il meccanismo che la distingue da un prompt lungo si chiama progressive disclosure: il modello vede all’inizio solo nome e descrizione di tutte le skill installate e carica il corpo soltanto quando il compito lo richiede, così cento skill costano in contesto poche righe ciascuna finché restano inutilizzate. Una skill può contenere script, quindi porta con sé capacità, e un server MCP può esporre prompt, quindi porta con sé procedure. I confini si sovrappongono, e l’autore lo riconosce.

La colonna che mi convince meno è quella sulla manutenzione, dove MCP risulta «spesso gestito dal provider». Vale per GitHub o per Google Drive. Per il gestionale interno, per il CRM personalizzato da un fornitore che nel frattempo ha chiuso, per il database della produzione, il server MCP lo scrive e lo mantiene l’azienda, e il protocollo standardizza la forma della conversazione senza togliere a nessuno la responsabilità del contenuto.

La procedura di design che l’articolo propone parte da una domanda di capacità (cosa deve saper fare l’agente) e arriva ai sistemi esterni. Funziona per un team di sviluppo che costruisce un assistente per sé stesso. Dentro un’organizzazione la prima domanda riguarda l’autorità, e la capacità viene dopo.

Scrivere una skill obbliga a decidere il criterio

L’esempio dell’articolo è una skill per il rilascio di un’app Flutter in nove passi, dal controllo del branch fino al riepilogo finale. È un buon esempio proprio perché è facile: in un team di sviluppo quella procedura esiste già, spesso codificata in una pipeline di integrazione continua, e trasformarla in skill significa tradurla.

In azienda le procedure che vale la pena delegare a un agente raramente sono così. Come si valuta se un cliente merita una deroga sui tempi di pagamento, quando un reclamo va passato all’ufficio legale: sono decisioni che vivono nella testa di tre persone, ognuna con una versione leggermente diversa, mentre la versione ufficiale sta in un manuale qualità che nessuno apre da anni.

Quando si scrive la skill ci si accorge che manca il criterio, e a quel punto le strade sono due. Può scriverlo chi sta costruendo l’agente, un tecnico o un consulente che non ha l’autorità per decidere come l’azienda tratta i clienti morosi e che, per far funzionare il sistema, finisce per deciderlo lo stesso. Oppure ci si ferma e si chiede a chi ha quell’autorità di mettere il criterio per iscritto, ed è qui che il progetto rallenta, perché scrivere un criterio lo rende discutibile. Nel pezzo su chi delega all’AI il proprio lavoro avevo raccontato come la delega sia più bassa proprio nelle professioni dove il criterio è il patrimonio, e credo che dentro le aziende agisca la stessa dinamica.

Me ne accorgo ogni volta che scrivo le skill che uso per lavorare: la parte che richiede tempo sono sempre le regole, il formato del file si impara in un pomeriggio. La skill con cui preparo i pezzi per questo blog contiene un elenco di cose da evitare costruito correzione dopo correzione nel corso di mesi, e ogni riga è una decisione editoriale che prima stava solo nella mia testa e che adesso posso rileggere e contestare. Vista da fuori, una skill ben scritta è un documento di organizzazione con l’estensione .md.

Il permesso viene prima dello strumento

Un tool, guardato dall’organizzazione, è una delega di potere. createJiraTicket() è innocuo, issueRefund() no, e la differenza non sta nel codice (sono due chiamate HTTP molto simili) ma nel fatto che la seconda sposta denaro per conto di qualcuno.

Chi concede quel potere all’agente, e con quale identità l’agente lo esercita, sono domande che un’azienda sa già porsi per le persone, tanto che esistono procure, limiti di spesa per ruolo e doppie firme sopra una certa soglia. Per gli agenti queste regole di solito non ci sono, e il caso più frequente che incontro è l’agente che eredita le credenziali di chi lo ha configurato, con tutti i suoi permessi, compresi quelli che nessuno gli avrebbe mai delegato consapevolmente. Ogni tool concesso a un agente dovrebbe essere un permesso revocabile, con un titolare che sa di averlo firmato.

Nella guida alle istruzioni per Claude Code raccontavo come un’istruzione scritta nel prompt si pieghi sotto pressione mentre un hook no. Con i permessi succede lo stesso: scrivere nella skill «non emettere rimborsi sopra i 500 euro» esprime un desiderio, far rifiutare la chiamata al server sopra quella soglia stabilisce una regola. Il modello organizzativo decide la soglia e la tecnica la rende inviolabile, in quest’ordine, perché nessun ingegnere dovrebbe stabilire da solo quanta fiducia l’azienda concede a un software.

MCP disegna confini che hanno già un proprietario

Il diagramma dell’articolo mette l’applicazione AI in alto, il server MCP al centro e sotto GitHub, un database e Jira. Da dentro un’azienda ognuna di quelle scatole ha un responsabile, un budget, un fornitore con un contratto e spesso un’opinione precisa su chi può leggere i suoi dati. Scrivere un server MCP per il CRM significa decidere quali parti del CRM diventano leggibili da un agente e in nome di chi, e quella decisione appartiene al responsabile commerciale e al DPO prima che al team IT.

Il server MCP del blog su cui sto scrivendo ne è un esempio piccolo. Impone una sequenza di stati, dalla bozza alla revisione fino all’approvazione e alla programmazione, e rifiuta i salti. Quella sequenza è una decisione organizzativa su chi controlla cosa prima che un testo esca col mio nome, e sta nel server proprio perché non può dipendere dalla buona volontà del modello in una sessione qualsiasi.

C’è poi il livello del significato, che nessun protocollo tocca. Due server MCP possono esporre lo stesso campo «cliente» intendendo cose diverse, uno i clienti attivi e l’altro chiunque abbia mai ricevuto un’offerta, e l’agente li userà entrambi con la stessa sicurezza. Ne ho scritto a proposito dell’interoperabilità fra agenti, dove il vocabolario precede il protocollo, e del modello dati come teoria dell’azienda: MCP standardizza il tubo, e quello che ci scorre dentro porta con sé tutte le ambiguità organizzative che c’erano prima.

Il codice moltiplica il modello organizzativo che trova

Sarebbe sbagliato concludere che la tecnica sia un dettaglio da sistemare a valle. La sequenza che propongo alle aziende con cui lavoro differisce da quella dell’articolo soltanto nell’ordine delle domande, perché parte da chi decide e con quale criterio, passa per i poteri che si delegano e le soglie che li limitano, arriva ai confini fra sistemi e ai loro proprietari. A quel punto si scrivono skill, tool e server, e ognuno diventa la forma eseguibile di una decisione già presa.

Quando la decisione esiste, la tecnica le dà proprietà che sulla carta non ha mai avuto. Scritta in una skill, una procedura diventa versionata, e si può ricostruire quale versione ha guidato un’azione in una certa data; il permesso, quando sta nel server, si può testare e la sua violazione lascia un log; per spostare un confine dichiarato in un server MCP serve una modifica che qualcuno deve approvare. Il manuale qualità non aveva nessuna di queste caratteristiche, ed è per questo che nessuno lo apriva.

C’è anche un effetto di ritorno. Scrivere una skill è il modo più rapido che conosco per scoprire dove un’organizzazione non ha mai deciso niente, perché il modello, a differenza di un collega esperto, non riempie i vuoti con il buon senso del corridoio: li riempie con una media statistica, e la media si vede subito. Da quando ho scritto Pelle Digitale penso alle interfacce fra persone e macchine come ai punti in cui qualcosa di implicito è costretto a diventare esplicito, e gli agenti portano quel passaggio dentro l’organigramma.

Nei prossimi mesi i fornitori renderanno skill e server MCP facili da installare quanto un’app, e molte aziende ne avranno a decine prima di aver deciso chi li governa. Il vantaggio andrà a chi userà questo periodo per fare l’esercizio al contrario, prendendo una procedura alla volta e cercando chi l’ha decisa. Spesso la risposta sarà nessuno, e da lì comincia il progetto.


La tracciabilità di una risposta comincia dal percorso

La tracciabilità di un sistema di ricerca semantica finisce prima di cominciare. Il sistema ti restituisce sei frammenti di documento e una risposta costruita su quei frammenti. Se chiedi come ci è arrivato, ottieni i punteggi di somiglianza. Sono numeri veri, calcolati su vettori, e non dicono niente che un revisore possa usare, perché la somiglianza fra due testi non è una ragione per cui una conclusione è corretta.

Un sistema che attraversa un grafo ti restituisce la stessa risposta con in più l’elenco dei passaggi che ha fatto, e quell’elenco è composto di relazioni che qualcuno ha definito e che qualcuno può contestare.

Una risposta senza itinerario

La differenza si vede quando qualcosa va storto. Nel primo caso la ricostruzione richiede di rifare l’esperimento sperando che il sistema si comporti allo stesso modo, e siccome il recupero dipende da come è stata formulata la domanda, da cosa era indicizzato quel giorno e da quale versione del modello di embedding stava girando, la riproducibilità è una speranza.

Nel secondo caso il percorso è un oggetto discreto, salvabile, confrontabile. Il cliente identificato con un certo codice, l’entità contraente collegata a quel codice, i tre contratti agganciati a quell’entità, la data presa dal campo di quel contratto, il record di origine nel sistema che lo custodisce. Se la risposta è sbagliata, l’errore sta in uno di quei passaggi, e si trova.

La tracciabilità nasce insieme all’esecuzione

Nelle architetture che vedo in giro la tracciabilità viene quasi sempre aggiunta dopo, sotto forma di registrazione delle chiamate e conservazione dei prompt. Funziona finché serve a capire cosa è stato chiesto, e smette di funzionare quando serve a capire perché la risposta era quella.

Con un grafo la traccia non va costruita, esiste come sottoprodotto dell’esecuzione. L’agente che percorre collegamenti lascia dietro di sé l’unica cosa che un revisore possa leggere senza essere un data scientist, cioè una catena di relazioni con nomi in lingua naturale. Quelle relazioni portano con sé anche i limiti di chi le ha disegnate, ed è utile leggerle sapendo che lo schema incorpora una teoria dell’azienda che nel percorso non si vede.

Quando qualcuno chiede come ci sei arrivato

L’AI Act chiede ai sistemi classificati ad alto rischio la registrazione automatica degli eventi lungo tutto il ciclo di vita, e chiede che la documentazione tecnica permetta di comprendere come il sistema produce i propri risultati. Nelle aziende con cui lavoro questi obblighi vengono affrontati come un problema di documentazione, e finiscono su un documento Word che descrive un comportamento atteso.

Un percorso salvato è una risposta diversa allo stesso obbligo, perché descrive il comportamento avvenuto, e dice insieme quali dati sono stati attraversati e con quale titolo, che è la coppia di domande intorno a cui ruota il confine fra significato e permesso. Il documento dice come dovrebbe funzionare, il log del traversal dice come ha funzionato quel martedì alle undici e dodici su quella richiesta.

Vale anche fuori dall’ambito normativo. Il giorno in cui un cliente contesta una fattura calcolata da un sistema automatico, la domanda che ti arriva non riguarda l’architettura, riguarda quel caso.

C’è una differenza pratica fra le due posizioni che si vede nel tempo di risposta. Chi ha il percorso salvato apre il caso, guarda i passaggi, individua il nodo in cui la relazione era sbagliata e risponde in mezza giornata con una spiegazione che la controparte può verificare. Chi ha soltanto i log delle chiamate apre una riunione, coinvolge chi ha costruito il sistema, prova a riprodurre il comportamento su un ambiente che nel frattempo è cambiato, e dopo due settimane produce una ricostruzione plausibile.

Dove il percorso non basta

Sarebbe comodo se tutte le risposte venissero da relazioni modellate, e non è così. Una parte consistente di quello che serve sta dentro testo libero che nessuno strutturerà mai: la clausola negoziata a mano in calce a un allegato, la mail in cui il cliente accetta una proroga, il verbale in cui si decide un’eccezione per quel caso.

Su quel materiale il grafo arriva fino a un certo punto, e la risposta finale la produce comunque un modello che legge prosa. La differenza sta in quanta prosa deve leggere e in quale prosa: un traversal che seleziona tre documenti pertinenti e li passa al modello produce una traccia che dice quali tre documenti, mentre un recupero per somiglianza su tutto l’archivio dice soltanto che quei tre erano i più vicini.

Il percorso quindi non elimina il giudizio del modello, lo circoscrive a un materiale identificato e ispezionabile. È una forma di prova più debole di una catena di relazioni e molto più forte di un punteggio di somiglianza, e per la maggior parte dei casi reali è il livello a cui si può arrivare davvero.

Il costo di ricostruire dopo

Chi ha già vissuto un audit sa che la spesa della tracciabilità non sta nel produrre le prove, sta nel cercarle a posteriori dentro sistemi che non erano stati pensati per essere interrogati in quel modo. Sono settimane di persone brave sottratte al lavoro, e il risultato è comunque una ricostruzione parziale accompagnata da una lettera che spiega i limiti della ricostruzione.

Chi costruisce adesso il proprio grafo per ridurre la spesa di inferenza si porta a casa la tracciabilità come effetto collaterale, e la paga una volta sola. Chi costruisce solo l’indice vettoriale otterrà risposte più economiche di oggi e si troverà con lo stesso problema di prova di sempre, spostato di un livello e reso più difficile dal fatto che adesso in mezzo c’è un modello statistico.

La differenza fra le due scelte non si vede il primo mese. Si vede il giorno in cui qualcuno con l’autorità per farlo ti chiede di dimostrare una cosa che il sistema ha detto sei mesi prima.

Il modello dati è una teoria dell’azienda

Nel modello dati del gestionale che usi il dipendente è agganciato a un centro di costo. È stato deciso quando l’azienda ha comprato quel software, probabilmente da un consulente che doveva far quadrare la contabilità analitica, e da allora nessuno l’ha più toccato perché funzionava.

Adesso su quei dati gira un agente a cui chiedi chi in azienda sa lavorare su un certo tema. L’agente risponde con la lista del centro di costo, perché è l’unica lente che gli hai dato, e le persone che quel tema lo presidiano da un altro reparto restano fuori dalla risposta senza che nessuno se ne accorga.

Il gestionale ha già deciso

L’ontologia aziendale non la scrive un ontologo. Esiste già, distribuita fra lo schema del gestionale, i campi obbligatori del CRM, le voci del piano dei conti e le tassonomie del sistema documentale, e riflette le priorità di chi ha firmato quegli acquisti.

Quasi sempre quelle priorità erano amministrative. Il cliente è la ragione sociale perché la fattura si intesta a una ragione sociale, il progetto è la commessa perché la commessa è l’unità di ricavo, il documento è classificato per anno e tipo perché così lo voleva la conservazione sostitutiva. Sono tutte scelte legittime, e nessuna è stata presa pensando che un giorno qualcuno ci avrebbe fatto ragionare una macchina sopra.

Il risultato è che gli agenti che stiamo mettendo in produzione ereditano la visione del mondo di un ufficio amministrativo di dieci anni fa, e la ereditano senza margine di discussione. Vale anche per chi pensa di partire da zero, perché un’ontologia implicita c’è comunque, e in assenza di decisione è quella del software che si è comprato.

Ogni modello dati è una mappa parziale

Ogni modello dati incorpora una teoria di cosa conta. Se modelli il fatturato per cliente vedi la concentrazione, se lo modelli per prodotto vedi il portafoglio, se lo modelli per persona che ha portato il contratto vedi una dipendenza da singoli individui che gli altri due tagli nascondono. Sono tre grafi diversi costruiti sugli stessi movimenti contabili, e rispondono in modo diverso alla stessa domanda su dove sta il rischio.

Una mappa utile è per costruzione parziale, ed è la parzialità a renderla utilizzabile. Il guaio comincia quando la parzialità sparisce dalla vista e la mappa viene presa per il territorio, che è quello che succede quando fra il modello e chi legge si interpone un sistema che risponde in prosa scorrevole e senza incertezze.

Il guidatore non discute la strada

Una persona che riceve un report strano ha una reazione che una macchina non ha. Alza la testa, dice che quel numero non torna con quello che vede in giro, e va a cercare come è stato costruito. Quella reazione nasce da una conoscenza del territorio che non sta in nessun sistema.

Un agente percorre la mappa che gli hai dato e non sospetta l’esistenza di strade che sulla mappa non compaiono. Non è un limite del modello, è una proprietà di come funziona: un sistema che interroga un grafo può essere valutato sulla correttezza del percorso, mai sulla completezza della mappa, perché la completezza è una proprietà del mondo e nel mondo il sistema non ci entra.

Ne avevo scritto arrivando dall’altro lato, quando mi ero chiesto dove finisce l’ontologia e comincia l’agente: il significato non copre il permesso, e adesso aggiungo che non copre nemmeno la propria incompletezza.

Leggere lo schema come un documento storico

C’è un esercizio che faccio volentieri quando entro in un’azienda che vuole mettere agenti sui propri dati, e costa mezza giornata. Si prende lo schema delle tre o quattro tabelle principali e si legge campo per campo chiedendosi perché quel campo è obbligatorio, chi lo compila, e cosa succedeva prima che esistesse.

Le risposte raccontano una storia precisa. Il campo obbligatorio che nessuno usa da sei anni è rimasto perché serviva a un adempimento abrogato nel frattempo. Il campo note, quello lungo e libero dove sta scritto tutto quello che la struttura non prevedeva, è il posto dove l’azienda ha depositato la propria complessità reale. Il codice cliente che ha due formati diversi a seconda dell’anno segna una migrazione fatta male che qualcuno ricorda ancora con fastidio.

Quel campo note merita attenzione particolare, perché è esattamente il punto in cui l’ontologia formale ha fallito e la conoscenza si è rifugiata. Contiene le eccezioni, gli accordi verbali, i motivi per cui una certa pratica va trattata in modo diverso, e sta lì in prosa libera, illeggibile per una query e perfettamente leggibile per un modello linguistico. Il paradosso è che oggi la parte meno strutturata dell’archivio è anche quella più ricca, ed è la prima che un progetto di modellazione tende a buttare via perché non entra in nessuna colonna.

Chi può emendare la mappa

La domanda operativa è chi ha il potere di cambiare lo schema, e in quasi tutte le aziende che vedo la risposta è che nessuno ce l’ha davvero. Il modello dati sta sotto una licenza software, dentro una personalizzazione fatta da un partner che nel frattempo è stato acquisito, e una modifica strutturale comporta una migrazione che nessuno vuole firmare.

Il rischio concreto non è che il modello sia sbagliato. È che sia congelato, mentre l’azienda intorno cambia e gli agenti continuano a rispondere con le categorie del 2014 usando un linguaggio che sembra attuale. Lo stesso problema si presenta ingrandito quando il vocabolario va concordato con altri, come nel caso della definizione condivisa lungo una filiera, dove a congelarsi sono due schemi invece di uno.

Quando metti un agente su un archivio, la prima domanda da fare non riguarda il modello di linguaggio che userai, riguarda il modello dati che c’è già. Riguarda chi ha scritto lo schema, quando, e per risolvere quale problema di allora. La risposta dice già gran parte di quello che quell’agente potrà e non potrà vedere.

Interoperabilità fra agenti: il vocabolario viene prima del protocollo

L’interoperabilità fra agenti di aziende diverse si rompe in silenzio. Il tuo agente manda un ordine di acquisto, quello del fornitore lo riceve, lo interpreta e conferma, e nessuno dei due ha mai concordato cosa significhi quantità confermata, e per un po’ funziona lo stesso, perché i casi facili sono la maggioranza e le differenze emergono solo sul bordo.

Poi arriva l’ordine in cui la quantità confermata del fornitore include il sovrametraggio di produzione e quella del tuo sistema no, e la differenza viene scoperta in magazzino tre settimane dopo.

L’interoperabilità che funziona per caso

Quando si discute di coordinamento fra agenti si parte quasi sempre dal protocollo, cioè da chi chiama chi, in che ordine, con quale formato di messaggio. È il livello visibile, quello che si disegna sulla lavagna, ed è anche quello che si risolve più in fretta perché esistono standard.

Il livello sotto è il lessico, e non si risolve con un formato. Due sistemi possono scambiarsi JSON perfettamente validi per anni contenendo campi che si chiamano allo stesso modo e significano cose diverse. Dentro una stessa azienda questo accade già, e quando due agenti non sono d’accordo qualcuno deve pur decidere, di solito chi scrive per ultimo il file di orchestrazione.

Fra aziende diverse non c’è nessun file di orchestrazione comune, e nessuno che abbia l’autorità di scriverlo, quindi l’interoperabilità resta appoggiata su assunti impliciti. La ricostruzione del significato che dentro casa si paga in token a ogni chiamata, sul confine fra due aziende si paga in ordini sbagliati.

Il precedente della fattura elettronica

In Italia un esperimento di ontologia imposta lo abbiamo già fatto, e lo abbiamo fatto in grande. La fatturazione elettronica verso la pubblica amministrazione prima, quella fra privati dal 2019, hanno costretto ogni azienda del Paese ad adottare lo stesso tracciato XML, gli stessi codici, le stesse regole di validazione, con un sistema di interscambio al centro che rifiuta quello che non rispetta lo schema.

Il modo in cui è stata vissuta dice molto. Un adempimento da sbrigare, con i costi di consulenza e di aggiornamento dei software che ne sono seguiti, e due anni di mugugni. Nessuno l’ha raccontata come un investimento in semantica condivisa, eppure il risultato è che oggi un dato di fatturazione italiano è leggibile da qualsiasi sistema senza negoziazione preliminare, che è esattamente la condizione che rende economico far lavorare un agente su quei dati.

Quello che lo Stato ha ottenuto con un obbligo, due aziende che vogliono far parlare i propri agenti devono ottenerlo per contratto, e il contratto va scritto prima che i sistemi siano in produzione.

Ogni coppia di sistemi è una traduzione da mantenere

L’alternativa allo standard condiviso è la traduzione, e l’interoperabilità ottenuta così si paga per coppia di interlocutori. Con tre fornitori sono tre mappature da mantenere, con dieci sono dieci, e ciascuna invecchia per conto suo ogni volta che una delle due parti cambia il proprio modello dati senza avvertire.

È il problema che l’EDI ha affrontato negli anni novanta con i tracciati concordati fra grandi committenti e filiera, e che si è risolto solo dove c’era un soggetto abbastanza forte da imporre il proprio formato a tutti gli altri. La grande distribuzione lo ha fatto, l’automotive lo ha fatto, e chi stava a valle si è adeguato perché l’alternativa era uscire dalla fornitura.

Con gli agenti quel soggetto forte esiste ancora, e adesso ha uno strumento in più: chi definisce l’ontologia definisce anche cosa i sistemi degli altri sono in grado di dire.

Chi pubblica il vocabolario e chi lo versiona

Un vocabolario condiviso è un oggetto vivo, e la parte difficile comincia dopo averlo scritto. Qualcuno deve pubblicarlo in un posto raggiungibile, dargli un numero di versione, dichiarare quanto dura la compatibilità all’indietro e avvisare la controparte prima di cambiare il significato di un campo invece che dopo.

Sono pratiche che il mondo del software conosce da vent’anni e che nelle relazioni commerciali fra aziende non esistono quasi mai. Il tracciato di scambio viene concordato all’inizio del rapporto, finisce in un allegato tecnico del contratto, e da quel momento cambia attraverso email fra due persone che si conoscono, fino al giorno in cui una delle due cambia lavoro.

Quella fragilità con gli agenti diventa più cara, perché il sistema che riceve un campo dal significato mutato non si ferma a chiedere. Interpreta, risponde, e procede fino a quando qualcuno a valle nota che i numeri del trimestre non tornano.

Lo standard arriva prima o dopo il danno

Nelle filiere dove il costo di un errore è alto, l’interoperabilità semantica esiste già e sta dentro i capitolati. Nelle altre si scoprirà con il primo incidente serio, un ordine confermato per una quantità che nessuno voleva, una scadenza calcolata su una decorrenza diversa, un pagamento autorizzato su un importo che il sistema di controparte considerava al netto.

Fino a ieri quegli incidenti erano rari perché in mezzo c’era sempre qualcuno che leggeva. Una persona che vede arrivare un numero strano si ferma e telefona, e in quella telefonata avviene la riconciliazione semantica che nessuno ha mai messo per iscritto.

Il lavoro che stiamo togliendo agli agenti umani nella filiera è proprio quello, e non lo stiamo sostituendo con niente. Le aziende che nei prossimi mesi scriveranno il proprio vocabolario lo faranno per risparmiare token, e si troveranno in mano un asset di negoziazione con la filiera che non avevano previsto.

L’entropia dei tuoi dati si paga a token

L’entropia di un archivio aziendale si vede bene prendendo lo stesso contratto in due forme. Nella prima è un PDF scansionato di quaranta pagine, con il tracciato di firma in fondo e la data di scadenza dentro un periodo che comincia a metà della pagina ventidue. Nella seconda è una riga con tre campi, controparte, data di decorrenza, durata in mesi. Un agente a cui chiedi quando scade risponde in entrambi i casi, e nel primo paga una quantità di lavoro che non serve a nessuno.

Quel lavoro ha un nome preso in prestito dalla teoria dell’informazione, entropia, e in azienda si è sempre potuto ignorare perché a sostenerlo erano le persone. Da quando esiste una bolletta, l’ambiguità organizzativa ha un prezzo leggibile, e il disordine dei documenti è la parte di quel prezzo che si misura più in fretta.

Lo stesso contenuto in due forme diverse

Un modello legge sequenze di token, e non ha modo di sapere in anticipo quali porzioni di quelle sequenze contengano la risposta. Nel PDF scansionato deve attraversare le premesse, le definizioni, le clausole di riservatezza e il foro competente prima di arrivare alla durata, e quelle pagine entrano in finestra tutte quante, pagate a peso.

Nella riga con tre campi la struttura ha già fatto il lavoro di selezione. Il significato è nella posizione del dato, non nella prosa che lo circonda, e la posizione costa pochissimo perché è decisa una volta per tutte le righe della tabella.

La differenza fra le due forme non sta nella quantità di informazione, che è la stessa, sta in quanto lavoro serve per estrarla. Un archivio di documenti scritti bene per un lettore umano è un archivio costoso per un lettore che paga a token.

Entropia bassa, volume alto

Vale la pena ricordare cosa succede a monte. La tokenizzazione spezza il testo in unità statistiche, e quelle unità non corrispondono ai concetti: la stessa clausola espressa in italiano burocratico occupa sensibilmente più token della stessa clausola espressa in forma tabellare, e il modello non sa che sta rileggendo per la terza volta una formula che ha già incontrato in altri ottocento contratti dello stesso tipo.

Il boilerplate contrattuale è il caso limite di entropia bassa che costa cara. Ripetitivo fino alla noia, quindi povero di informazione nuova, e allo stesso tempo voluminoso, quindi costoso. L’informazione che cambia da contratto a contratto sta in poche decine di parole sparse in mezzo a decine di migliaia.

Ogni schema è una perdita decisa in anticipo

Qui arriva la parte che mi interessa di più, perché è dove la questione smette di essere tecnica. Modellare significa scegliere quali campi esistono, e un campo che non esiste nello schema diventa invisibile a chiunque interroghi il sistema attraverso quello schema.

Se il modello dati prevede controparte, decorrenza e durata, ma non prevede il rinnovo tacito, l’agente risponderà con sicurezza che il contratto scade il trentuno dicembre, e quel contratto si rinnoverà da solo per altri dodici mesi mentre tutti guardano la data sbagliata. Lo stesso vale per la penale di recesso, per il preavviso differenziato a seconda della parte che recede, per le proroghe negoziate a voce e messe per iscritto in uno scambio di email che nel grafo non entra.

La compressione è la ragione per cui l’ontologia fa risparmiare, e la perdita è il prezzo di quel risparmio. Il problema non è che ci sia una perdita, è che venga decisa da chi disegna lo schema senza che nessun altro se ne accorga. Vale la pena tenerlo accanto alla questione che avevo sollevato su dove finisce l’ontologia e comincia l’agente, perché uno schema definisce insieme cosa si può capire e cosa si può fare.

Il corpus cresce da solo

C’è un fattore nuovo che peggiora il conto, e riguarda chi quei documenti li produce. Da quando in azienda si generano testi con l’AI, il volume di prosa interna aumenta senza che aumenti la quantità di decisioni prese, e quei testi entrano nei repository insieme agli altri.

Ne ho scritto parlando di quella broda di testi che nessuno ha deciso di scrivere, e il collegamento con la bolletta è diretto: ogni verbale generato, ogni riassunto prodotto per riflesso, ogni versione alternativa di un documento salvata perché non si sa mai, aumenta l’entropia del corpus che gli agenti dovranno attraversare. Ti stai facendo pagare due volte lo stesso disordine, una quando lo produci e una quando lo interroghi.

Da dove si comincia a misurare

Il modo pratico per capire quanto stai pagando è partire dalle domande invece che dai dati. Prendi le dieci richieste che in un mese arrivano più spesso a un ufficio, quelle a cui qualcuno risponde aprendo sempre gli stessi tre posti, e per ciascuna conta quanti documenti bisogna attraversare per arrivare alla risposta e quante di quelle pagine contengono davvero il dato.

Il rapporto fra le due quantità è la misura di entropia che serve, e nelle aziende dove ho fatto questo esercizio il risultato oscilla fra il ridicolo e l’imbarazzante, con decine di pagine lette per estrarre un numero, una data e un nome. Un essere umano quel rapporto lo migliora da solo, perché impara dove guardare e salta il resto. Un agente senza struttura ricomincia ogni volta dalla prima pagina.

Da lì la decisione diventa gestibile, perché riguarda un numero finito di campi. Non serve modellare l’azienda, serve modellare le venti entità e le trenta relazioni che stanno dietro a quelle dieci domande, e tutto il resto può aspettare il giorno in cui qualcuno lo chiederà davvero.

Chi sostiene il costo della struttura

Strutturare è lavoro, lo fa qualcuno, e quel qualcuno di solito è lontano da chi riceve il beneficio. L’ufficio che deve compilare tre campi in più al momento della firma non vedrà mai il risparmio sulla spesa di inferenza del trimestre successivo, e nelle organizzazioni dove il costo e il beneficio stanno in due linee di budget diverse questa asimmetria basta a fermare tutto.

Il modo che ho visto funzionare è agganciare la struttura a un momento in cui qualcuno sta già lavorando su quel dato. La data di scadenza la si estrae quando il contratto si firma, non in un progetto di bonifica sei mesi dopo, perché in fase di bonifica costa il doppio e la qualità è peggiore.

Un archivio disordinato ha sempre avuto un costo, pagato in ore di ricerca, in scadenze mancate, in due persone che cercano lo stesso documento senza sapere l’una dell’altra. La differenza di adesso è che quel costo arriva in una forma che la funzione finanza sa leggere, e le cose che la funzione finanza sa leggere prima o poi finiscono in un piano.