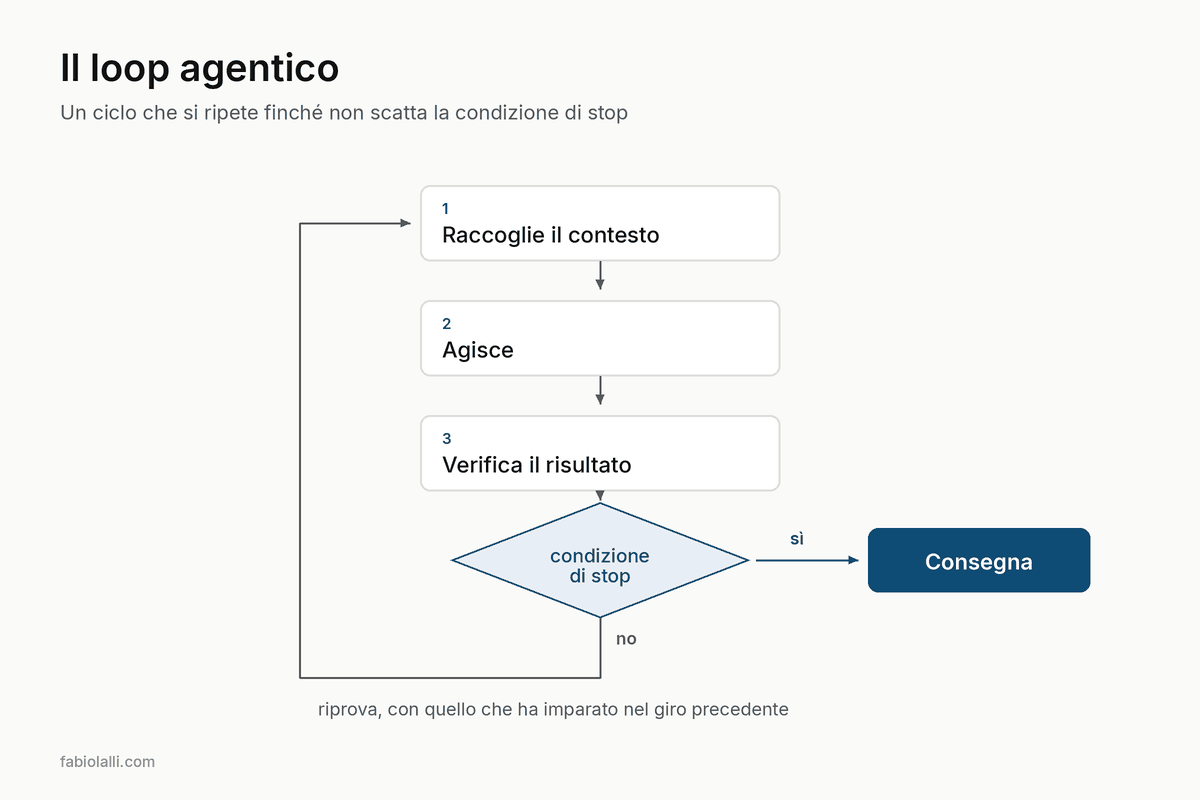
Chiedi a Claude di aggiungere un pulsante di like e parte un loop agentico. Legge il codice, fa la modifica, lancia i test e ti restituisce qualcosa che crede funzioni. Poi tocca a te: apri la pagina, clicchi, guardi la console del browser, e scrivi il prompt successivo. Il collo di bottiglia sei tu, per come è fatto il ciclo: l’agente produce, l’umano controlla, un turno alla volta.
Delba de Oliveira e Michael Segner, del team di Claude Code, hanno messo per iscritto a fine giugno la definizione di loop agentico che usano internamente: «agents repeating cycles of work until a stop condition is met». Agenti che ripetono cicli di lavoro finché non scatta una condizione di stop. È una definizione povera di aggettivi e piena di conseguenze, perché tutto il peso si sposta su una domanda sola, chi scrive quella condizione.
Quattro modi di far girare un agente
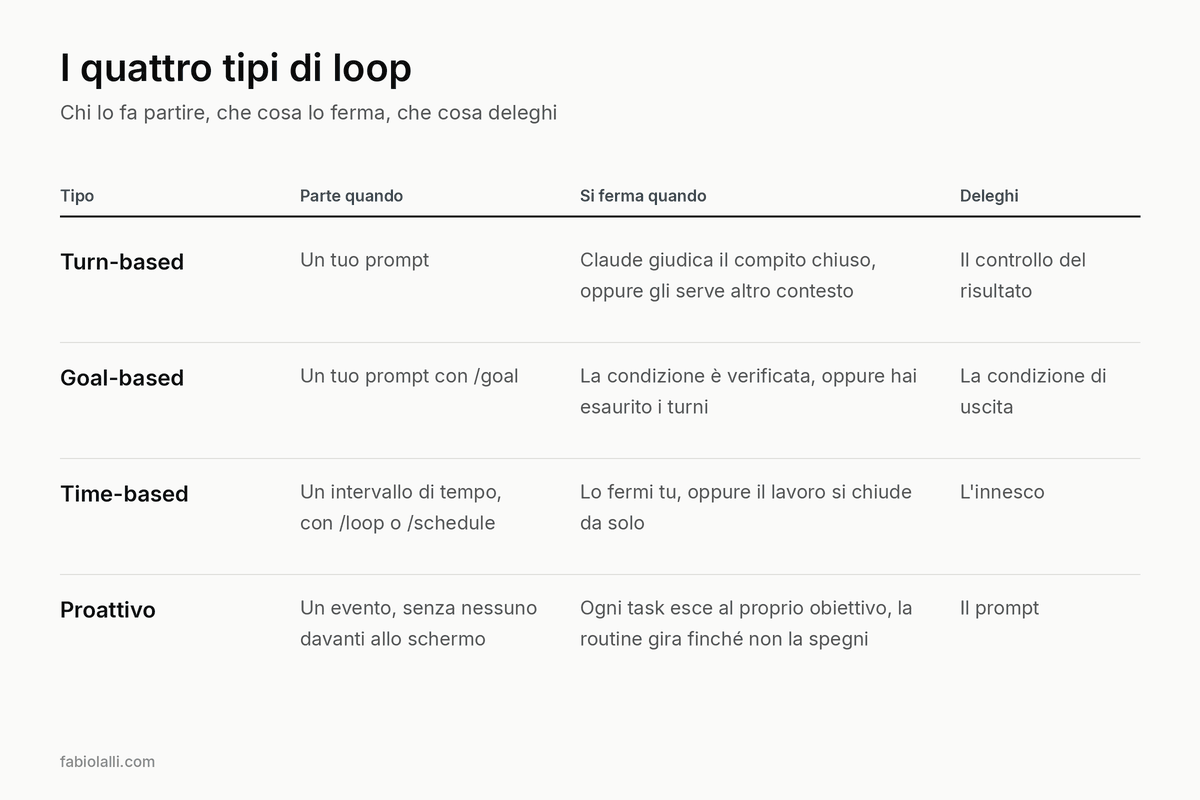
Il turn-based è il loop agentico che usiamo tutti senza chiamarlo così. Parte da un tuo prompt, Claude raccoglie il contesto, agisce, controlla il proprio lavoro e risponde, e si ferma quando giudica il compito chiuso oppure quando gli serve qualcosa che non ha. Quello che deleghi, se lo deleghi, è il controllo del risultato.
Il goal-based nasce quando un turno solo non basta. Con /goal dichiari che cosa significa fatto, e Claude continua a lavorare senza che tu debba rilanciarlo a ogni giro. Ogni volta che prova a fermarsi, un modello valutatore rilegge la conversazione e decide se la condizione regge, e se non regge lo rimanda al lavoro con una motivazione che diventa la guida del turno successivo. Qui deleghi la condizione di uscita, ed è la ragione per cui i criteri deterministici funzionano molto meglio delle formule generiche.
Il time-based serve al lavoro che torna, quello in cui il compito resta identico e cambiano solo gli ingressi: il riassunto dei messaggi del mattino, la pull request che riceve commenti di review e fa fallire la CI. Deleghi l’innesco.
Il proattivo è quello in cui davanti allo schermo non c’è nessuno. Un evento o una pianificazione fanno partire il lavoro, ogni task esce quando raggiunge il proprio obiettivo, la routine continua a girare finché non la spegni. Deleghi il prompt, cioè la parte che fino a ieri consideravamo il mestiere.
I comandi che Anthropic ha rilasciato
/goal imposta una condizione di completamento valida per la sessione, lunga fino a quattromila caratteri. A ogni fine turno un modello piccolo e veloce, Haiku per impostazione predefinita sull’API di Claude, restituisce uno di tre verdetti: soddisfatta, non ancora, impossibile. Il valutatore non esegue comandi e non legge file per conto suo, giudica soltanto quello che Claude ha già portato in conversazione, quindi la condizione va scritta come qualcosa che l’output può dimostrare. Dentro la condizione conviene mettere anche un tetto, «oppure fermati dopo venti turni», altrimenti il loop si allunga oltre quello che ti aspetti. Funziona anche in modalità non interattiva, con claude -p.
/loop rilancia lo stesso prompt a intervalli regolari e gira sul tuo computer, quindi si spegne quando spegni la macchina. /schedule sposta la stessa idea nel cloud e la trasforma in una routine, che continua a lavorare a portatile chiuso. Una routine può partire da una pianificazione oraria, giornaliera, feriale o settimanale, da una chiamata HTTP autenticata a un endpoint dedicato, oppure da un evento GitHub come l’apertura di una pull request o la pubblicazione di una release, con filtri su autore, titolo, branch, etichette. L’intervallo minimo è un’ora. Le routine sono disponibili sui piani a pagamento di Claude, si gestiscono da claude.ai/code/routines e hanno un tetto giornaliero di esecuzioni oltre al consumo ordinario dell’abbonamento.
Intorno a questi due comandi girano altri pezzi. La modalità auto approva le chiamate agli strumenti dentro un turno, e si combina bene con /goal, che invece toglie di mezzo la conferma tra un turno e l’altro. I dynamic workflows, in research preview, permettono a Claude di orchestrare sottoagenti in parallelo. Le skill descrivono i controlli da ripetere. Per chi non apre mai un terminale ci sono gli scheduled task di Cowork, che si configurano dall’interfaccia, girano da remoto anche a computer spento e usano i connettori e le skill già attive.
Il criterio d’uscita vale più del prompt
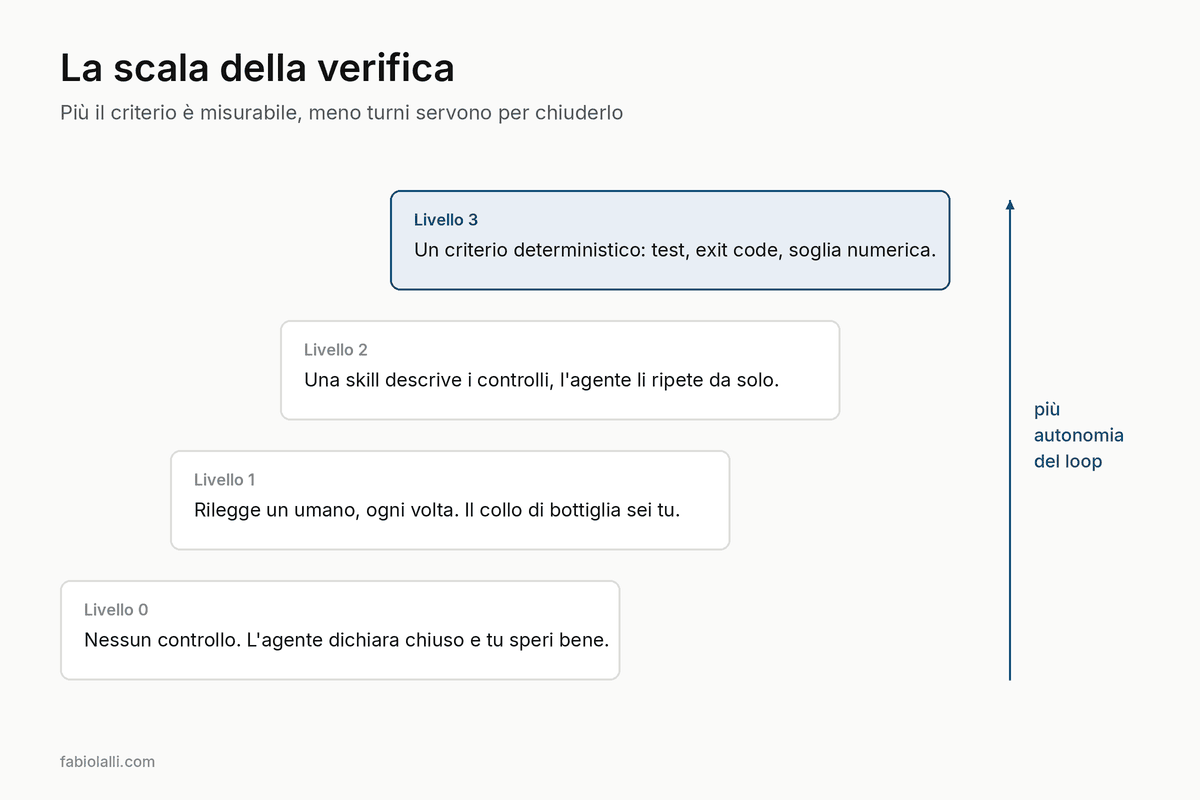
La qualità di un loop dipende dal sistema che gli sta intorno, e il pezzo che pesa di più è la verifica. Il consiglio di Anthropic è codificare in un file di skill i passaggi che oggi fai a mano, così che l’agente possa controllare il proprio lavoro dall’inizio alla fine invece di dichiararlo finito appena la modifica è andata a buon fine: avviare il server, aprire la pagina, cliccare il controllo nuovo, fare uno screenshot prima e dopo, guardare che in console non compaiano errori, misurare le metriche di performance. Più i controlli sono quantitativi, più l’autoverifica diventa semplice.
Nel mio flusso editoriale la condizione di uscita è un exit code. Uno script passa il testo al setaccio cercando i tic di scrittura che non voglio, e finché non esce zero il pezzo non si consegna. È un criterio grezzo, e misurabile, e chiude il loop in molti meno giri di qualunque descrizione a parole di che cosa sia un buon articolo.
Due accorgimenti da rubare. Il primo è affidare la revisione a un secondo agente con contesto pulito, perché chi non ha seguito il ragionamento del primo è meno incline a confermarlo. Il secondo riguarda cosa fare quando un risultato non è all’altezza: correggere il singolo errore serve una volta sola, mentre spostare la correzione dentro la skill la rende valida per tutti i giri successivi. È la differenza tra un loop che migliora e uno che ti fa rimettere a posto la stessa cosa per la terza volta.
Sei loop da accendere questa settimana
La rassegna delle sette è il più facile da accendere: uno scheduled task che legge messaggi, posta e calendario delle ultime ventiquattro ore e consegna un brief prima che tu apra il computer. «Ogni mattina alle 7:00 riassumi Slack, email e calendario delle ultime 24 ore e scrivimi trecento parole con le tre cose che oggi richiedono una mia decisione».
Quando le richieste arrivano su un canale condiviso, la coda si accumula da sola e qualcuno passa la giornata a smistarla. Una routine oraria con un obiettivo esplicito la tiene bassa: «ogni ora controlla il canale delle richieste, e non fermarti finché ogni segnalazione trovata in questo giro non ha un responsabile, una priorità e una risposta».
C’è poi il documento che non esce finché non passa l’audit, il caso in cui il criterio esiste già da qualche parte e nessuno lo aveva mai dato in pasto all’agente: «l’articolo passa lo script di audit con exit code 0 e resta sopra le 1.400 parole, fermati dopo sei tentativi».
Anche il debito accumulato su un sito si può assegnare a un lunedì mattina: «ogni lunedì alle 6:00 controlla i post pubblicati nell’ultimo mese, segnala meta description mancanti, immagini senza testo alternativo e link interni rotti, e prepara le correzioni in bozza».
Sulle pull request funziona meglio l’intervallo, perché quello che cambia sta fuori dal tuo progetto e arriva quando arriva: /loop 10m controlla la mia PR, rispondi ai commenti di review, sistema la CI che fallisce.
L’ultimo parte da un evento invece che da un orario. La pipeline di deploy chiama via HTTP l’endpoint della routine appena il rilascio è in produzione, la routine esegue gli smoke test, cerca regressioni nei log e scrive go o no-go nel canale di release prima che la finestra si chiuda. Lo stesso schema regge sugli alert: il sistema di monitoraggio passa il corpo dell’allarme, l’agente correla lo stack trace con i commit recenti e apre una bozza di pull request con una proposta di correzione, così chi è di turno trova qualcosa su cui lavorare invece di un terminale vuoto.
Per scegliere quale accendere per primo, Anthropic propone un criterio pratico: guarda il lavoro che già fai, prendi un compito in cui sei tu a rallentare tutto, e chiediti quale pezzo puoi passare alla macchina, se sai scrivere il controllo di verifica, se l’obiettivo è già abbastanza chiaro da poter essere giudicato da un altro modello, oppure se il lavoro arriva comunque a scadenze regolari.
Quanto costa tenere acceso un loop
Un loop senza confini è un modo elegante di bruciare token. Il primo controllo è la scelta del pezzo giusto: un compito piccolo non ha bisogno di più agenti, e parecchio lavoro gira benissimo su modelli più economici, tenendo quello più capace per le decisioni di giudizio. Il secondo è la precisione del criterio di uscita, che deve essere specifico abbastanza da far arrivare Claude alla soluzione presto, senza però farlo fermare troppo presto.
Poi ci sono due regole che sembrano banali e non lo sono. Quando una parte del lavoro è deterministica, conviene che sia uno script a farla, perché eseguire uno script costa meno che ragionare ogni volta sugli stessi passaggi. E l’intervallo di una routine va tarato su quanto spesso cambia davvero la cosa che stai guardando, non su quanto ti piacerebbe essere aggiornato. Prima di lanciare un workflow su tutto il perimetro conviene provarlo su una fetta piccola, visto che l’orchestrazione dinamica può generare centinaia di agenti.
Per misurare c’è /usage, che scompone il consumo recente per skill, sottoagenti e connettori, /goal senza argomenti, che mostra turni e token spesi finora, e /workflows, da cui si vede quanto sta consumando ogni agente e si può fermarne uno al volo.
Una routine firma con la tua identità
Qui arriva la parte che in azienda pesa più del risparmio di tempo. Una routine gira come sessione autonoma: durante l’esecuzione non ci sono richieste di permesso, e Claude può usare tutti gli strumenti dei connettori inclusi, comprese le scritture. Quando crei una routine i connettori attivi vengono inclusi tutti per impostazione predefinita, e toglierli è un gesto che conviene fare subito.
Quello che la routine fa attraverso la tua identità appare come fatto da te. I commit e le pull request portano il tuo utente GitHub, i messaggi su Slack e i ticket su Linear passano dai tuoi account collegati. L’ambiente cloud definisce a quali domini la sessione può arrivare, e il testo che accompagna un’attivazione via API viene consegnato all’agente dentro un blocco marcato come dato non affidabile, così il prompt della routine deve dichiarare esplicitamente di volerlo usare prima che quel testo possa orientare il lavoro.
Sono dettagli di configurazione, e insieme disegnano una superficie di responsabilità nuova. Permesso revocabile è la formula che uso da tempo per questa condizione, in cui l’autonomia di un sistema è sempre concessa e sempre ritirabile. Con le routine la domanda operativa diventa chi ha aperto il permesso, quali strumenti ha lasciato dentro, e in quanto tempo qualcuno se ne accorge.
Il livello che stavamo saltando
Per due anni abbiamo lavorato quasi solo sul primo livello, la formulazione del singolo turno, e poi sul secondo, il contesto da mettere davanti al modello. Sopra c’è l’harness, il guscio che decide che cosa l’agente può toccare e con quali permessi. In mezzo sta il livello che stavamo saltando: quante volte l’agente ci riprova, e a quali condizioni ha il diritto di dire che ha finito.
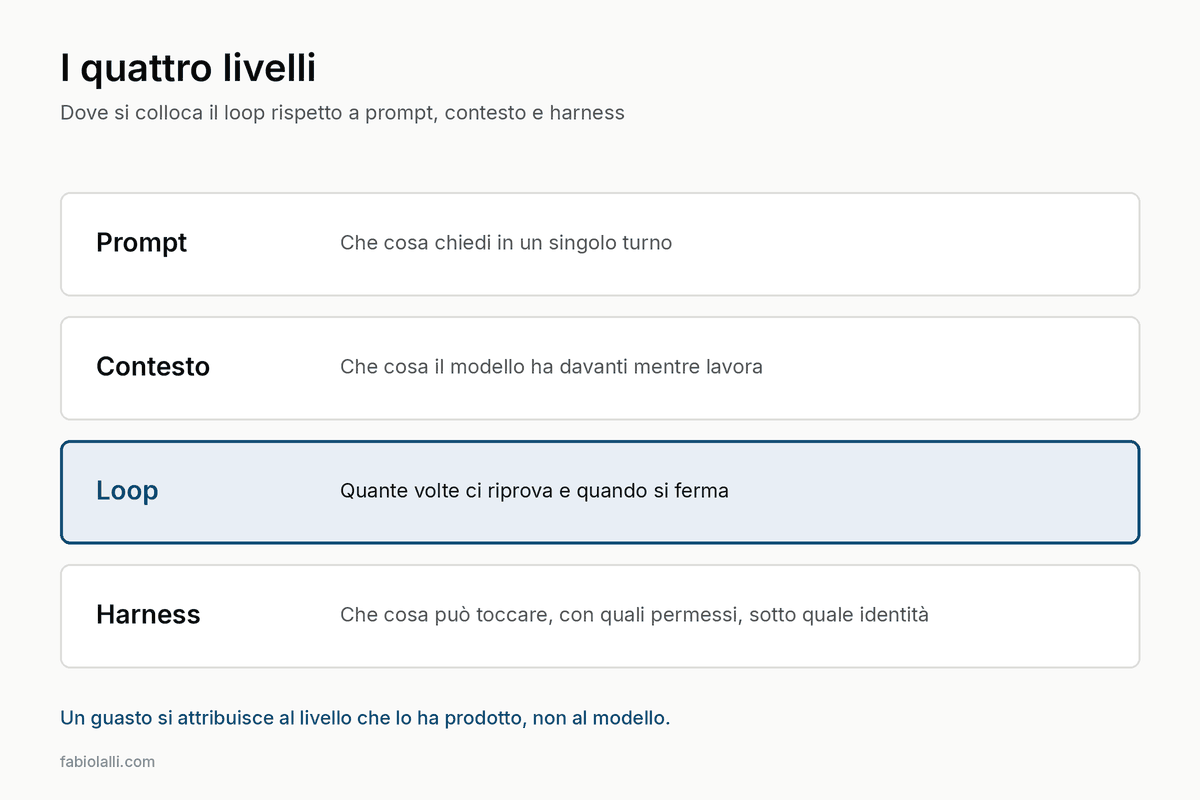
Chi progetta il loop agentico decide dove finisce il lavoro della macchina e dove comincia la responsabilità di una persona. Nei prossimi mesi credo che nelle organizzazioni comparirà un ruolo che oggi non ha ancora un nome: qualcuno che scrive le condizioni di stop, le rivede quando cambia il contesto, e risponde di tutto quello che quelle condizioni lasciano passare.