Company Brain: come si costruisce il “Jarvis” di un’azienda
Progettare uno spazio di lavoro che un LLM sa leggere
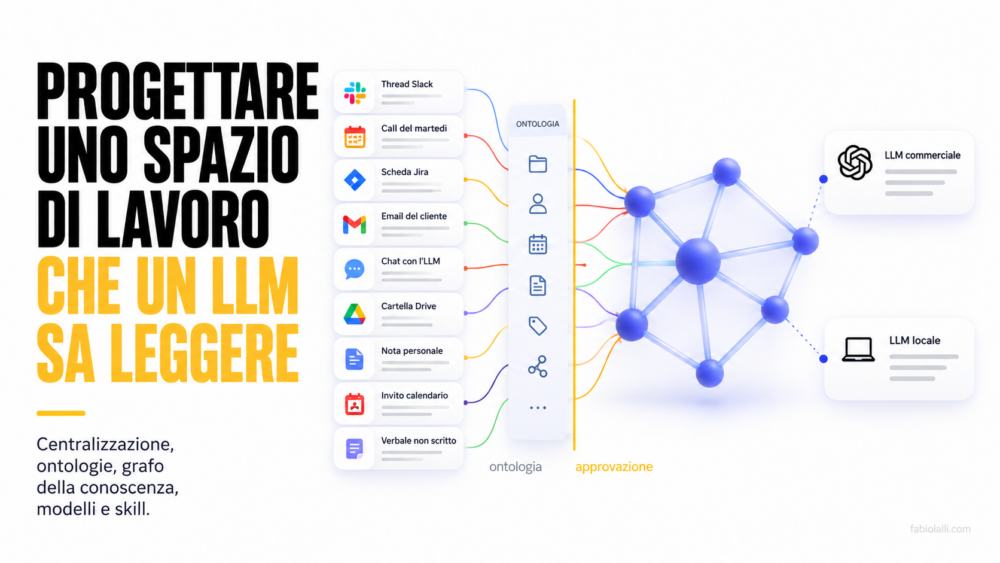
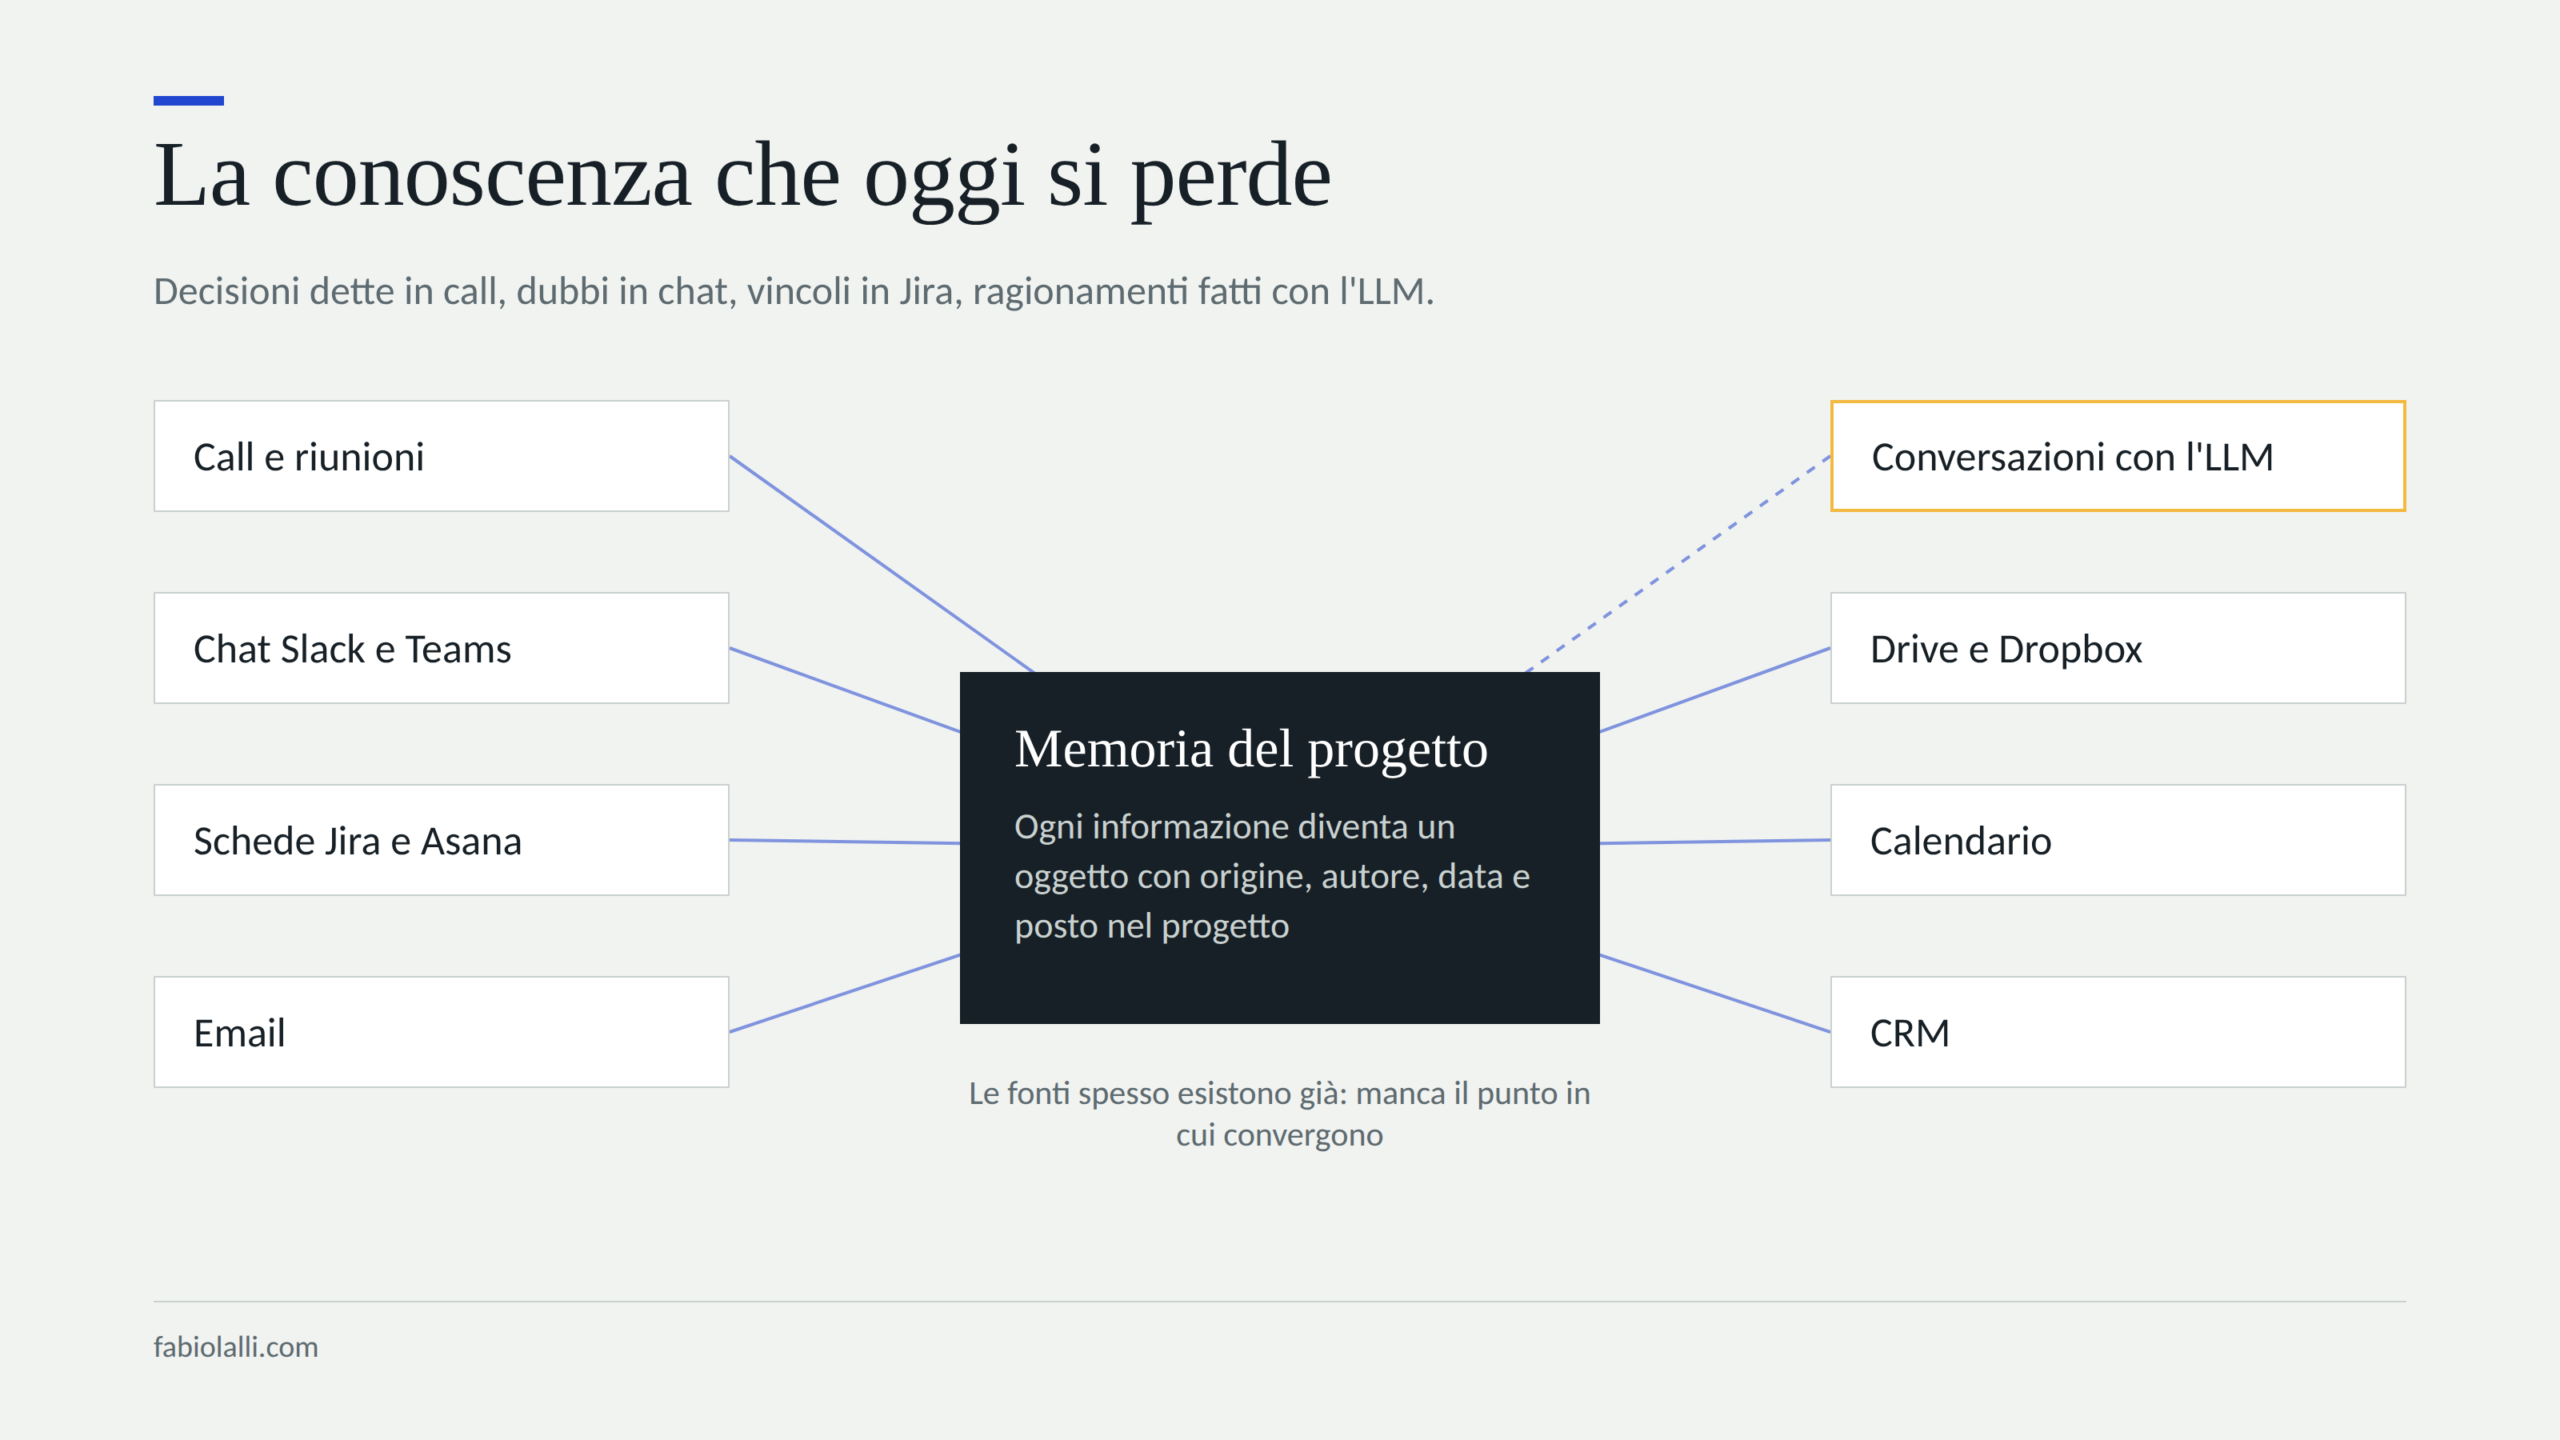
In quasi tutte le aziende che incontro la conoscenza di un progetto vive in sette o otto posti diversi: le registrazioni delle riunioni, le caselle di posta, una cartella condivisa su Drive e un’altra su Dropbox, il calendario, il CRM, i canali Slack o Teams, le schede di Jira o di Asana, le note personali di ciascuno. C’è poi un posto nuovo, che fino a due anni fa non esisteva e oggi contiene una parte rilevante del ragionamento di un team: le conversazioni che ogni persona ha con il proprio assistente AI mentre lavora. Ciascuno di questi posti funziona bene da solo, e nessuno sa dell’esistenza degli altri.
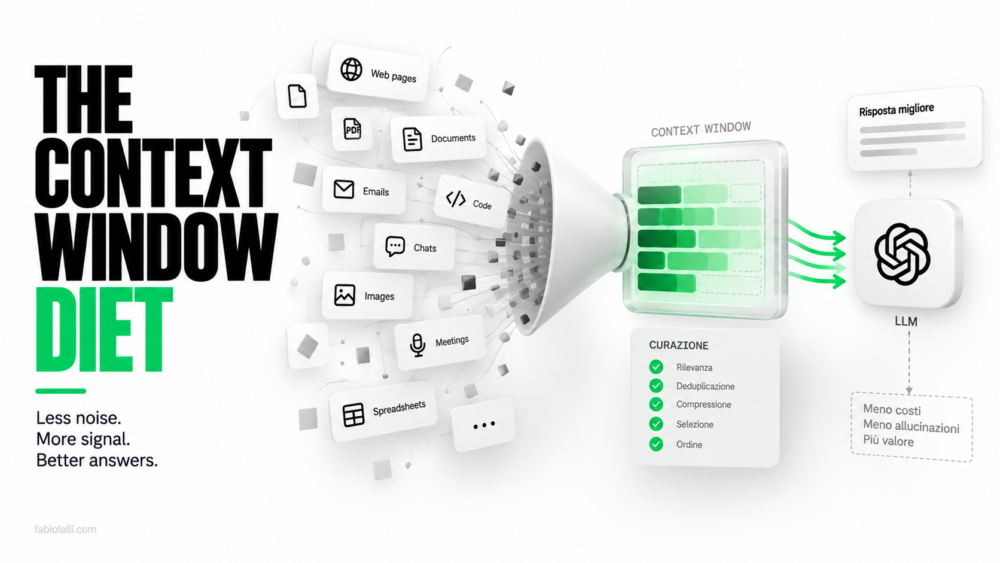
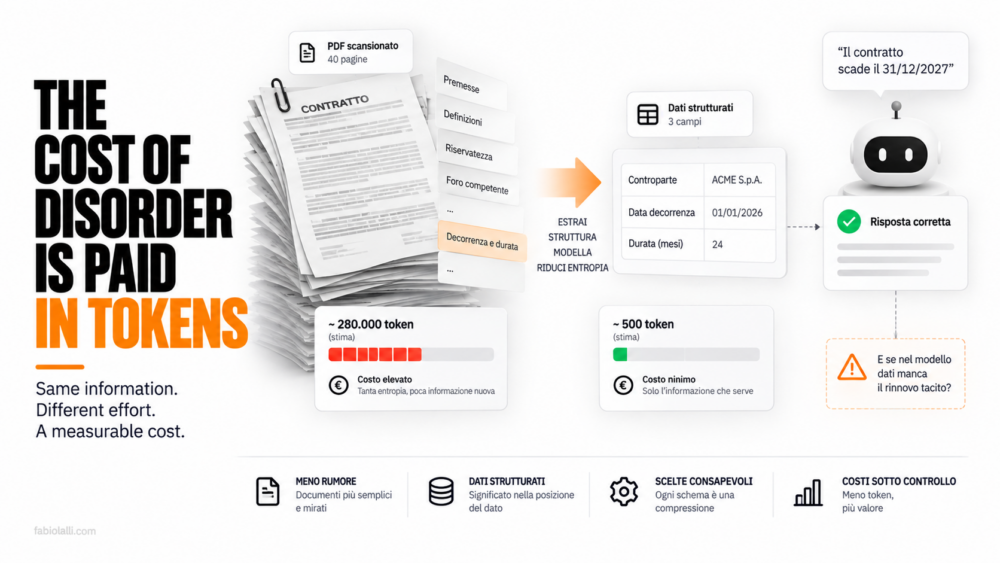
La reazione più diffusa è collegare un LLM a tutte queste fonti e aspettarsi che dal collegamento nasca un’intelligenza del progetto. È l’idea del Jarvis aziendale, che in questi mesi circola con nomi diversi, Company Brain, Brain OS, Company OS: un assistente che sa tutto dell’azienda perché vede tutto. Succede il contrario. Più fonti si collegano senza una struttura che le tenga insieme, più il modello produce risposte plausibili costruite su frammenti, e più diventa difficile capire da dove arriva un’affermazione, chi l’ha verificata e se è ancora vera.
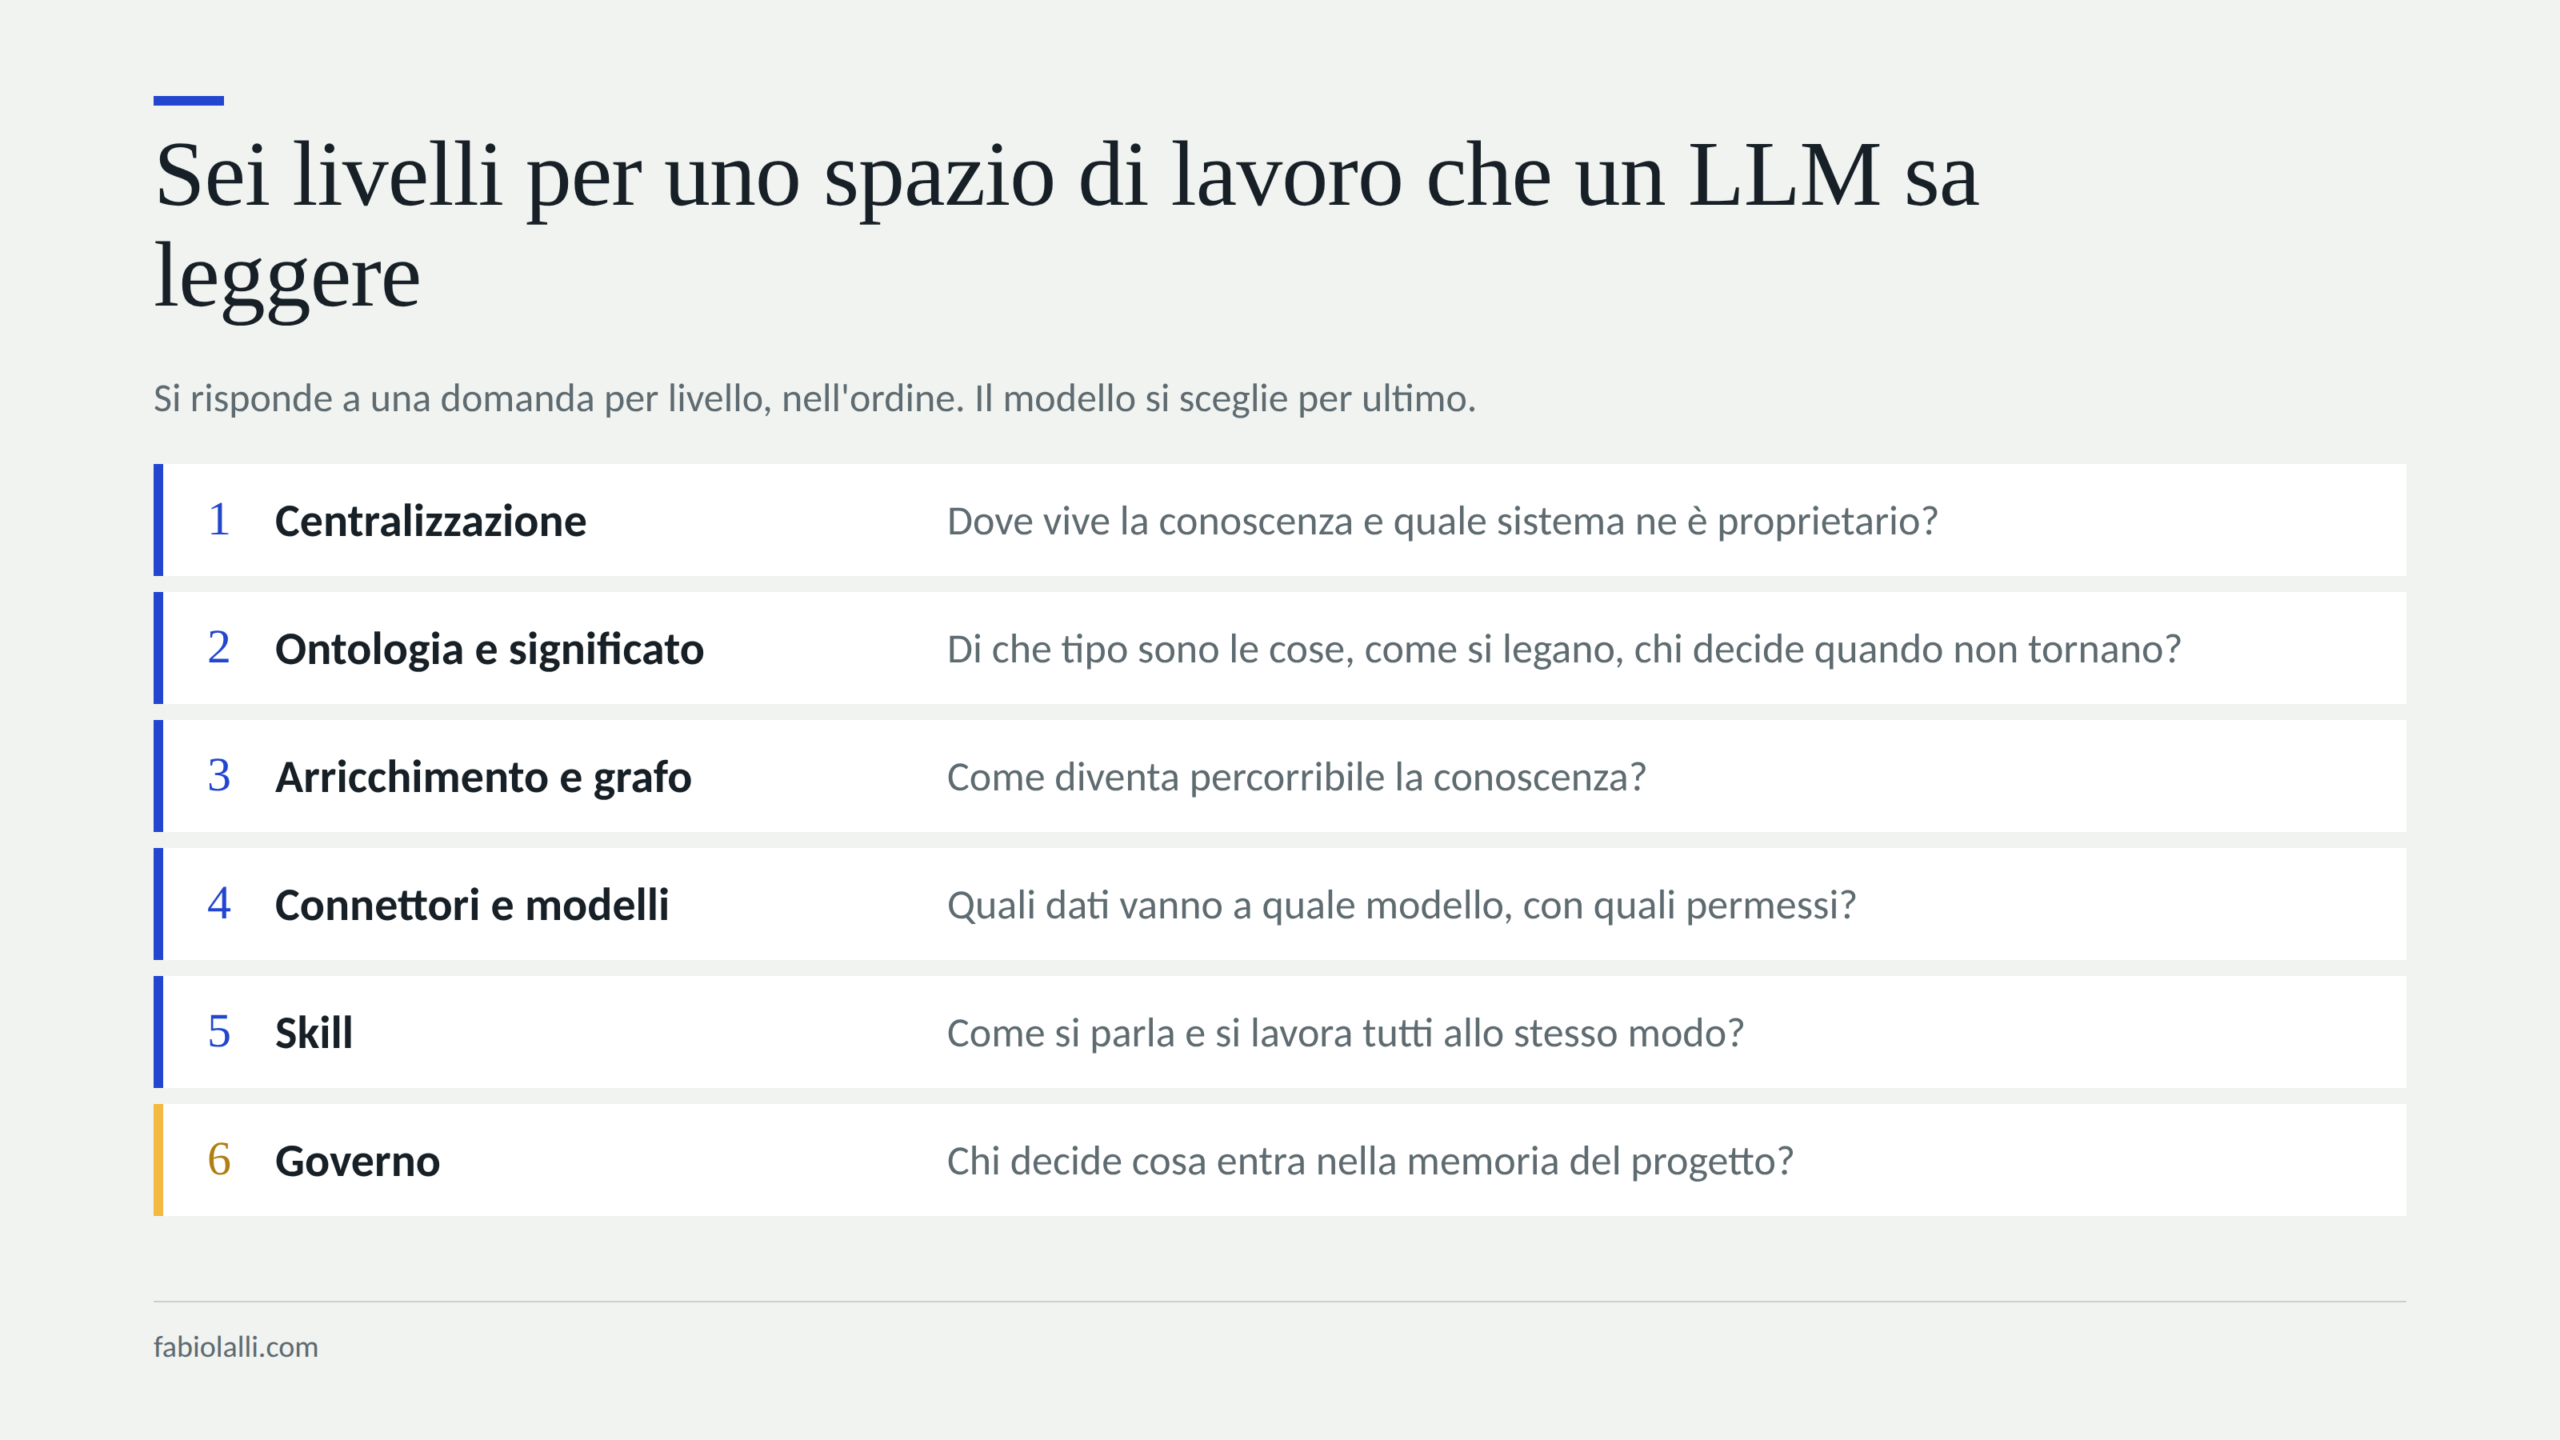
Uno spazio di lavoro intelligente si progetta, e la scelta del modello arriva per ultima. Il metodo che propongo lo divide in sei livelli, ciascuno con una domanda a cui rispondere prima di passare al successivo. Come caso concreto uso il Workspace ICONICO, la piattaforma interna di gestione dei progetti che stiamo costruendo in questi mesi: è ancora giovane, ma ogni scelta descritta qui è già in produzione.
La complessità cambia posto
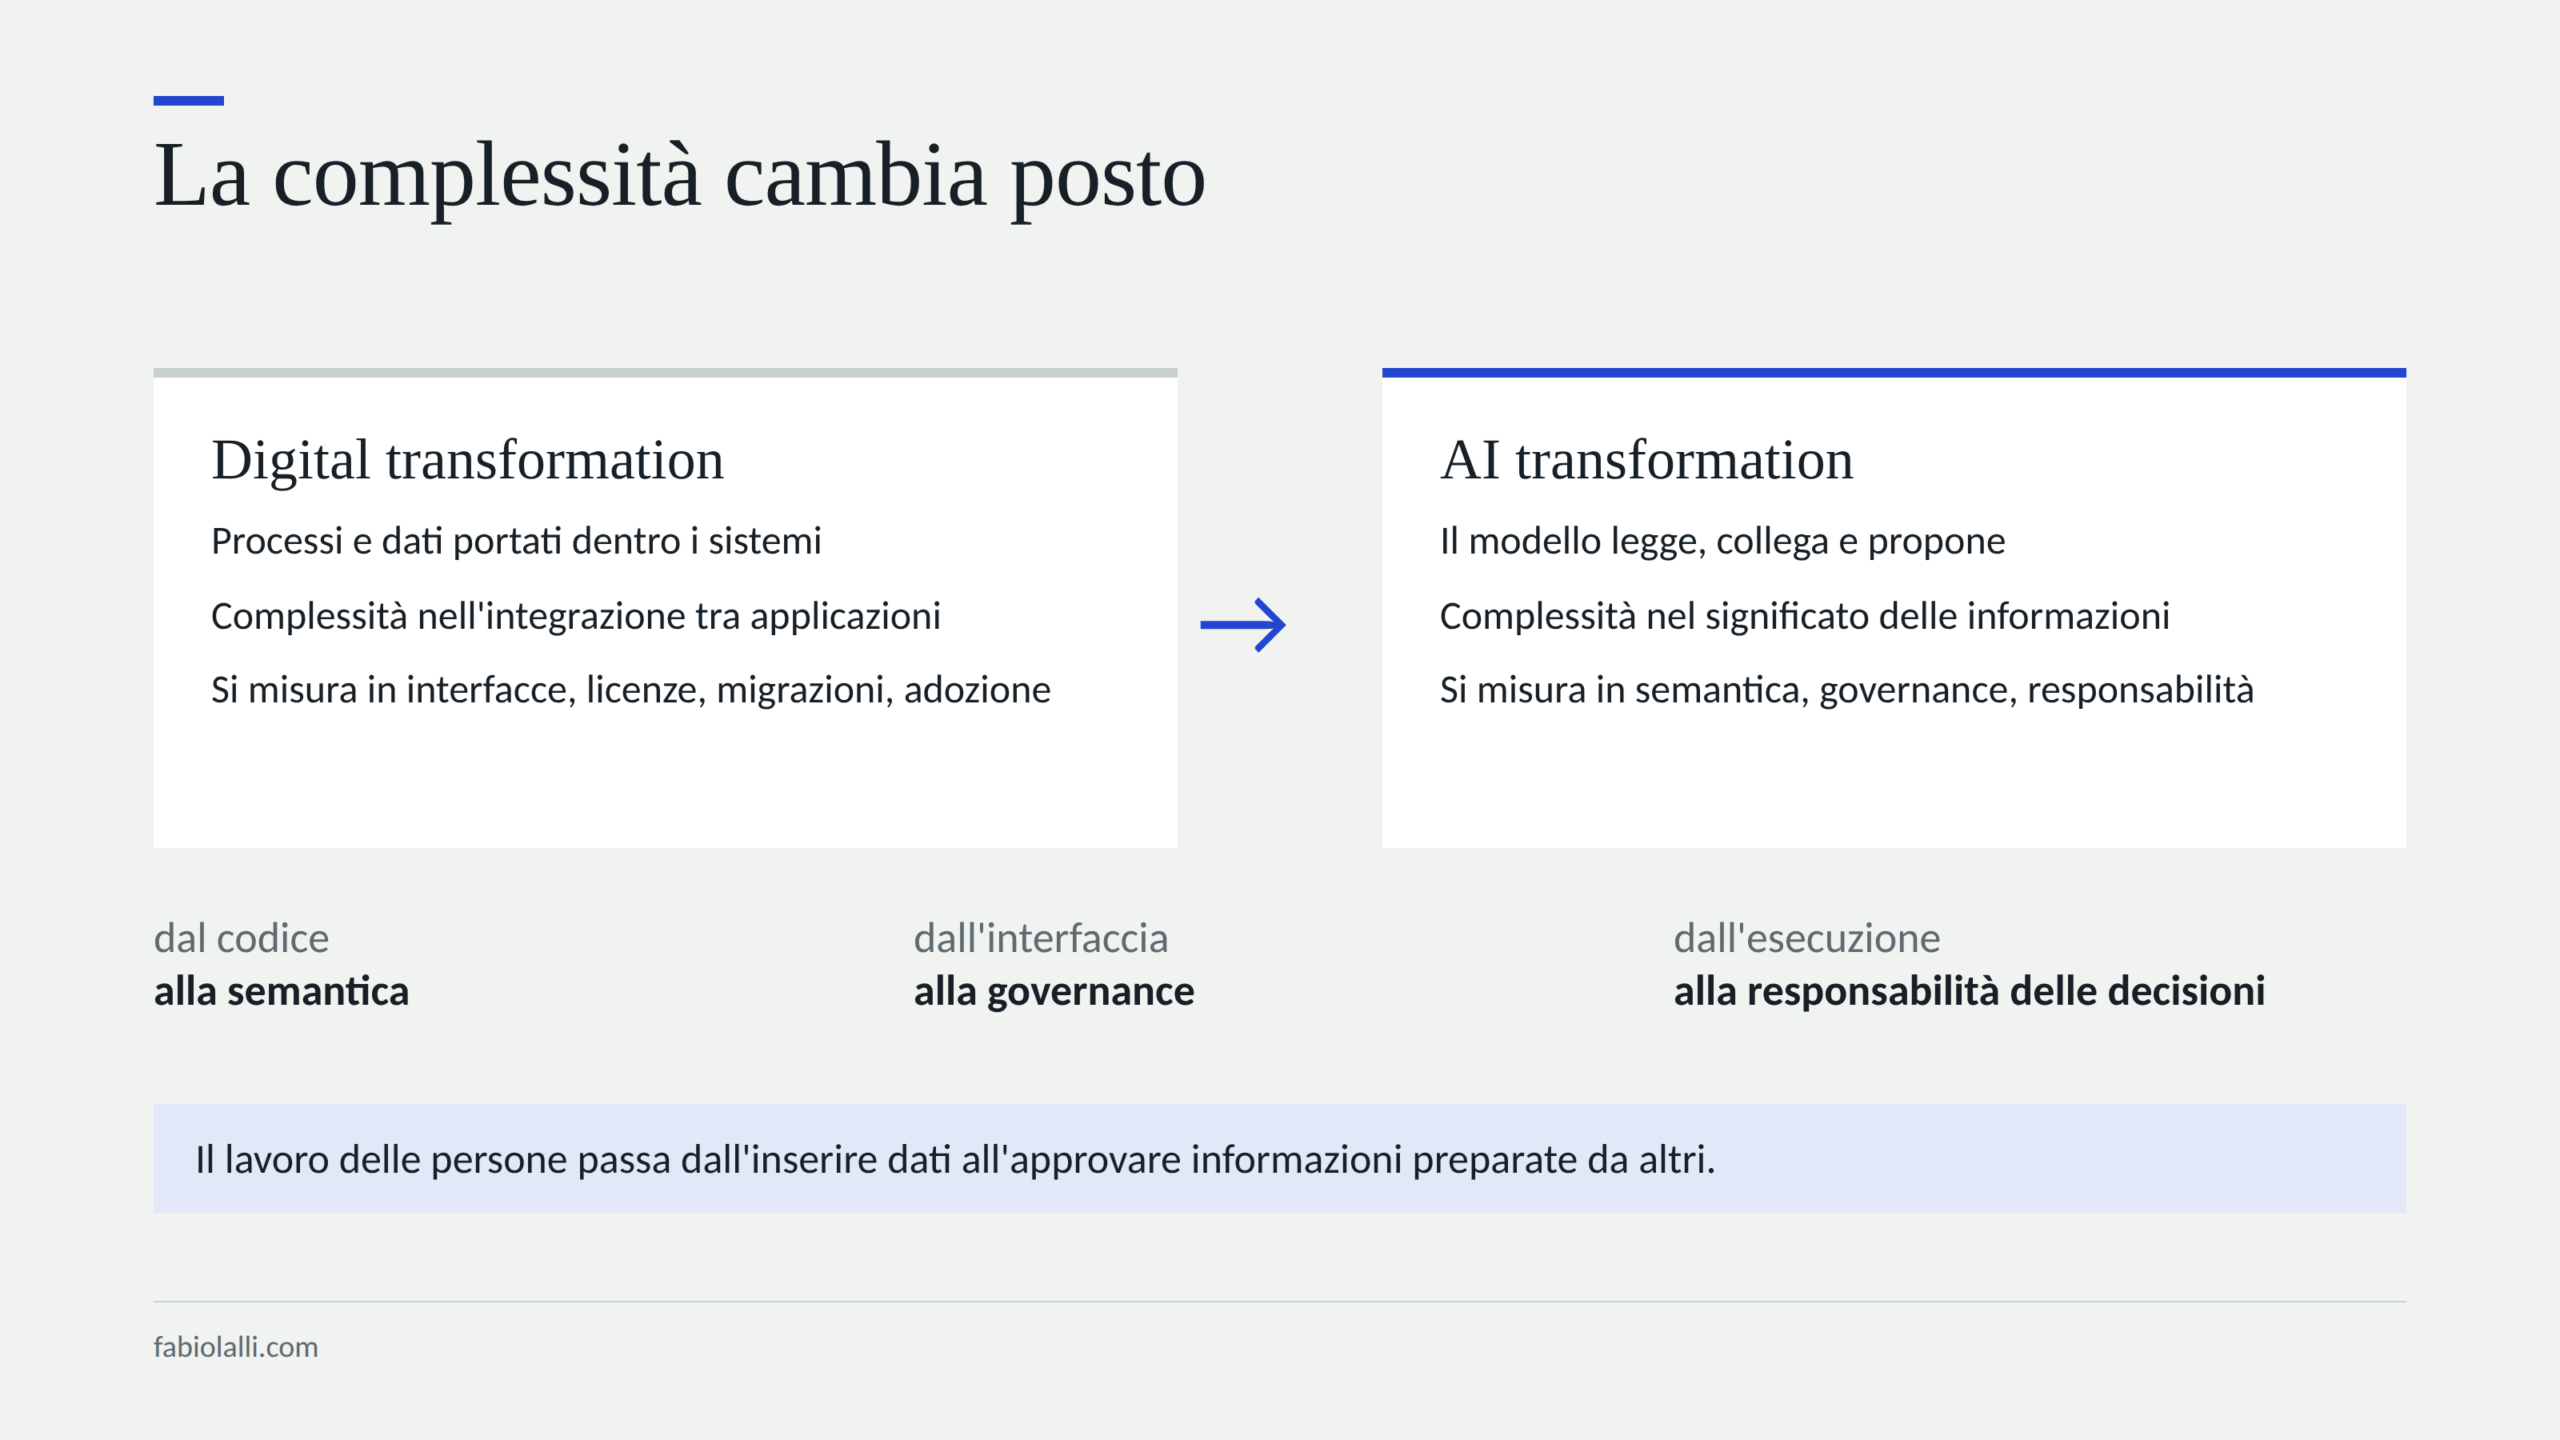
Prima dei livelli conviene chiarire che tipo di trasformazione è questa, perché la si confonde spesso con quella che le aziende hanno attraversato negli ultimi quindici anni. La digital transformation ha portato processi e dati dentro i sistemi: la carta è diventata un modulo, la riunione una videochiamata, l’archivio un drive condiviso, e la complessità stava nell’integrazione tra applicazioni e nell’adozione degli strumenti da parte delle persone. Si misurava in interfacce, licenze, migrazioni, formazione all’uso del software.
La AI transformation sposta la complessità altrove. Gli strumenti in buona parte ci sono già, e i dati anche, solo che sono sparsi e senza significato condiviso. Quando un modello legge, riassume, collega e propone al posto delle persone, il problema smette di essere come si esegue una procedura dentro un’applicazione e diventa cosa significano le informazioni, chi ha titolo per confermarle e cosa succede quando due fonti dicono cose diverse. La complessità passa dal codice alla semantica, dall’interfaccia alla governance, dall’esecuzione delle operazioni alla responsabilità delle decisioni.
Questo ha una conseguenza pratica che molti sottovalutano. Il lavoro di chi usa il sistema cambia natura: meno inserimento di dati, meno ricerca, molte più approvazioni, correzioni e scelte su informazioni preparate da altri. Una persona che prima compilava il verbale di una riunione ora riceve un verbale già scritto, con i task estratti e collegati alle persone giuste, e il suo compito è dire se è corretto. È un lavoro più leggero e più delicato insieme, perché richiede di sapere cosa si sta approvando.
Un posto per ogni informazione
Centralizzare la conoscenza non significa copiare tutto in un unico contenitore. Un archivio dove finiscono i file di tutti è soltanto un altro silo, più grande. Serve un luogo dove un’informazione diventa un oggetto con un’identità, un autore, una data e una posizione nel progetto: una nota di riunione, un task con un assegnatario e una scadenza, un documento con le sue versioni, un referente con il suo ruolo, un’opportunità con il suo stadio, un’ora di lavoro registrata su un’attività.
La regola che evita più problemi è che ogni dato ha un solo sistema proprietario. Nel Workspace ICONICO clienti, contatti e opportunità restano nel CRM aziendale, e la piattaforma non li duplica: tiene un collegamento e una copia del nome per poterlo mostrare, e quando dal progetto nasce un’opportunità è la piattaforma a scriverla nel CRM, con la nota di progetto e l’attività già collegate. Un’anagrafica duplicata produce, dopo pochi mesi, due verità su chi è il decisore di un cliente, e un modello che le legge entrambe sceglie a caso quale citare.
Il vantaggio più sottovalutato della centralizzazione riguarda le informazioni che oggi non arrivano da nessuna parte. Una decisione presa in una call e mai scritta, un dubbio sollevato in un canale Slack e poi dimenticato, un vincolo annotato in una scheda Jira che nessuno del commerciale leggerà, un’email in cui il cliente cambia una priorità rispondendo a un’altra domanda. E poi il ragionamento che una persona fa con il proprio LLM mentre prepara una proposta o analizza un problema, che spesso contiene il passaggio più utile della giornata e svanisce quando si chiude la finestra. Ognuna di queste informazioni, presa da sola, vale poco. Raccolte nel progetto, con la loro origine, diventano la memoria che l’azienda non aveva mai avuto, e smettono di dipendere da chi era presente quel giorno.
Per ottenere questo vantaggio non sempre serve costruire infrastruttura nuova. In molti casi le fonti esistono già, con i loro connettori, e manca soltanto il punto in cui convergono e un criterio per decidere cosa ne entra. Nel Workspace il controllo degli accessi è applicato al livello più basso possibile, con regole a livello di riga su ognuna delle 28 tabelle del database, per cui la stessa domanda posta da due persone con ruoli diversi restituisce risposte diverse: è la condizione per dare a un modello l’accesso a tutto il progetto senza dover filtrare a mano ogni volta.
Il significato viene prima dei dati
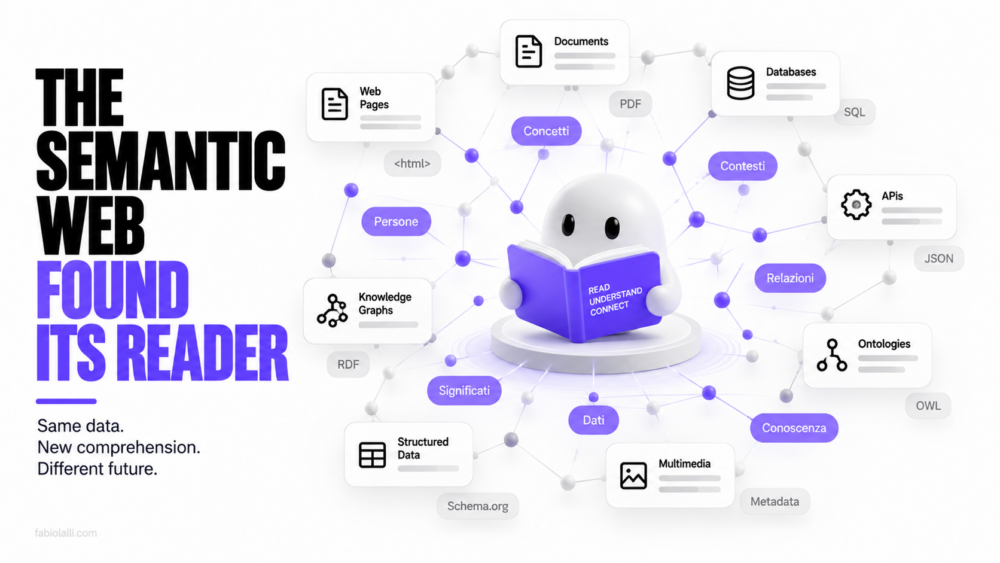
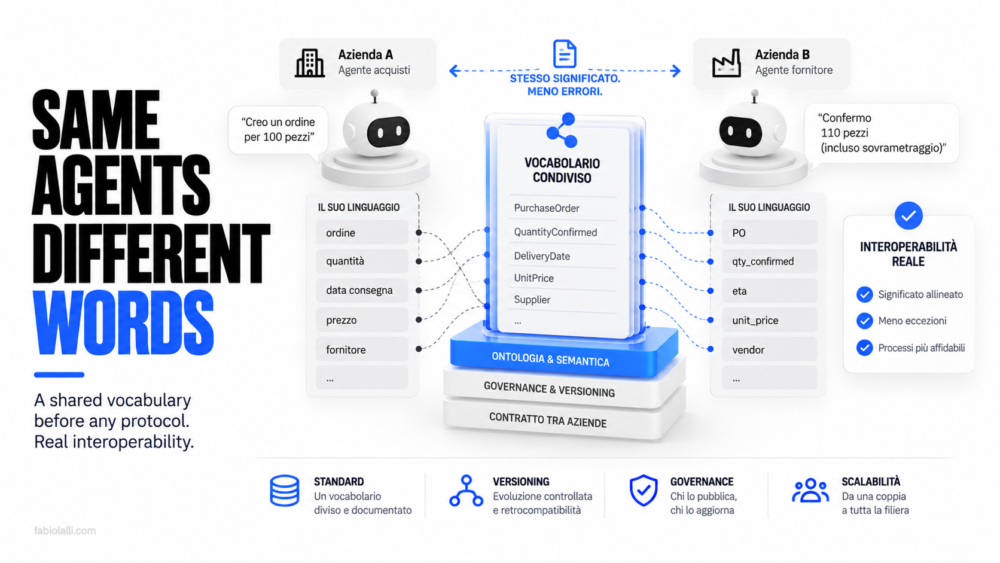
È la parte che quasi tutti saltano, e si capisce: parlare di ontologia in una riunione di direzione fa alzare gli occhi al cielo. Eppure un modello collegato a dati senza tipi e senza relazioni dichiarate ricostruisce da solo il significato delle cose, ogni volta in modo leggermente diverso, e due risposte alla stessa domanda a una settimana di distanza non coincidono. L’ontologia è il punto in cui un’azienda decide cosa significano le sue informazioni, prima che lo decida un modello al suo posto.
Si comincia dai tipi di oggetto. Nel Workspace le note sono appunti, verbali di riunione, decisioni, rischi, insight, feedback, opportunità o conoscenza consolidata, e il tipo cambia il trattamento: una decisione pesa più di un appunto, un rischio genera attenzione, una nota di conoscenza è il risultato di una verifica e non di un’impressione. Anche il vocabolario fa parte dell’ontologia. I tag vengono normalizzati, minuscoli e con il trattino al posto degli spazi, e prima di crearne uno nuovo il sistema lo confronta per somiglianza con quelli esistenti: se esiste già “commerciale-b2b”, la variante “commerciale b2b” non nasce e chi la scrive riceve un avviso, perché il tag è il punto in cui la tassonomia di un’azienda si sfalda più in fretta.
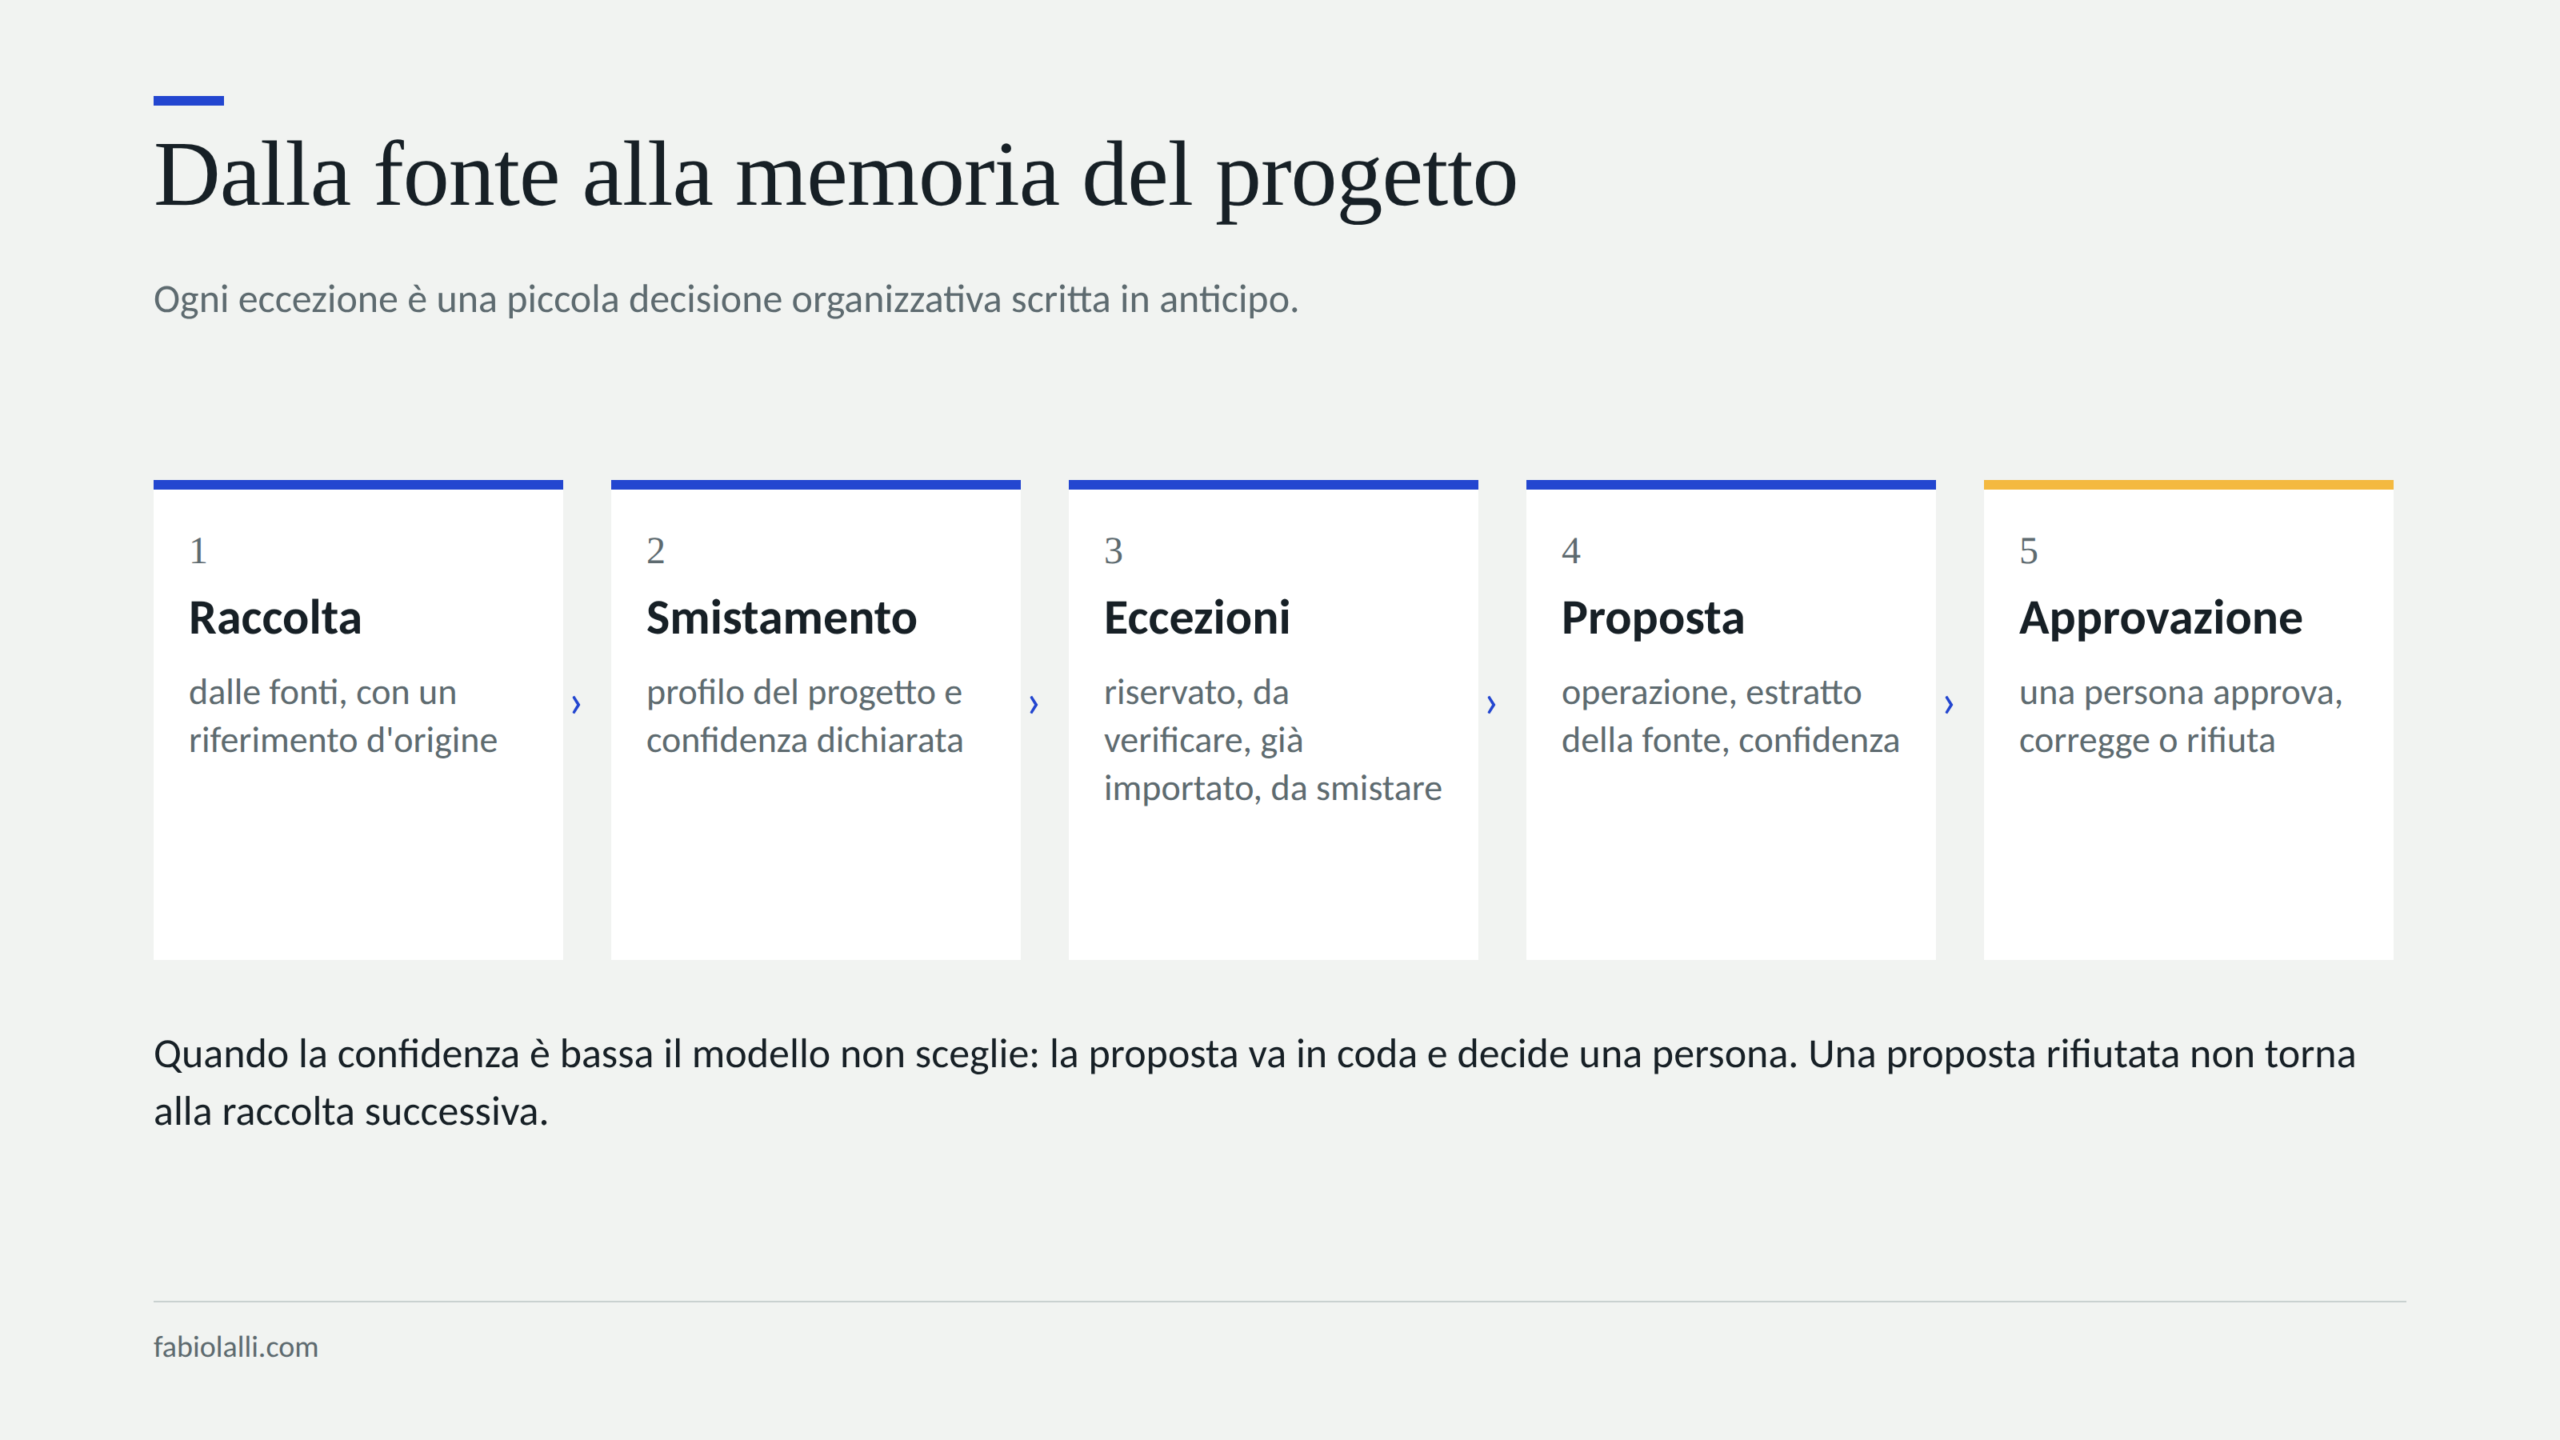
Poi viene lo smistamento, cioè la decisione su dove va un’informazione appena raccolta. Ogni progetto ha un profilo leggibile dal modello: i domini email del cliente e dei partner, le parole chiave e le sigle ricorrenti, le cartelle standard, le convenzioni di nome. Con queste poche righe una mail da un certo dominio, o una registrazione in cui ricorre una sigla, viene attribuita al progetto giusto con un livello di confidenza dichiarato. Quando la confidenza è bassa, o l’informazione potrebbe appartenere a due progetti, il modello non sceglie: la proposta finisce in una coda da smistare e la decisione torna a una persona.
Le eccezioni vanno progettate quanto i casi normali. Un’informazione con cifre economiche viene marcata come riservata e resta visibile solo ai responsabili del progetto. Un’informazione dubbia porta il marcatore da verificare. Un contenuto già importato viene riconosciuto dalla sua origine e non entra una seconda volta. Ognuna di queste regole è una piccola decisione organizzativa scritta in anticipo, e ciascuna toglie al modello un’occasione di improvvisare.
Il caso più delicato sono le collisioni, quando due fonti affermano cose diverse sullo stesso punto. Per gestirle le relazioni tra oggetti sono tipizzate: un collegamento tra due note può essere un riferimento, una conferma, un’integrazione, una divergenza o un consolidamento. Nel progetto pilota due note scritte da persone diverse, a pochi giorni di distanza, si contraddicevano su sei punti. Un sistema ingenuo avrebbe tenuto l’ultima, o le avrebbe fuse in un riassunto. Con le relazioni tipizzate la divergenza diventa un collegamento esplicito e apre un task di verifica assegnato a una persona, che si chiude con una nota di conoscenza: cita entrambe le fonti e dichiara per ciascuna se è stata confermata, integrata o superata su quel punto. Le note originali restano intatte e i loro autori ricevono una notifica.
Le conferme hanno lo stesso trattamento, con il segno opposto. Quando una seconda fonte indipendente dice la stessa cosa della prima, il collegamento di conferma alza il valore di quell’informazione, e chi interroga il progetto sa che quel fatto è sostenuto da due origini e non da una. È il modo in cui la conoscenza di un team acquista peso nel tempo, invece di accumularsi tutta allo stesso livello.
Arricchire i dati e renderli percorribili
Un’informazione raccolta e smistata è ancora un oggetto isolato. Diventa conoscenza quando è collegata a ciò che la circonda: le persone che cita, l’opportunità a cui si riferisce, il documento che commenta, il task che ne è nato, le ore spese per produrla.
L’arricchimento avviene su più piani. Il primo è esplicito: nelle note e nei task gli oggetti si citano con le menzioni, scrivendo @ seguito dal nome di una persona, di un documento o di un’opportunità, e ogni menzione diventa un collegamento. Il secondo è automatico: il sistema rianalizza i testi, riconosce nomi di referenti, opportunità e documenti già presenti nel progetto e genera collegamenti suggeriti, che però restano suggerimenti finché qualcuno non li conferma, e se vengono rifiutati non vengono ricreati. Il terzo è operativo: un task porta con sé la nota da cui è nato, un’ora registrata porta con sé il task o la riunione a cui si riferisce, un’opportunità porta con sé la nota che l’ha fatta emergere.
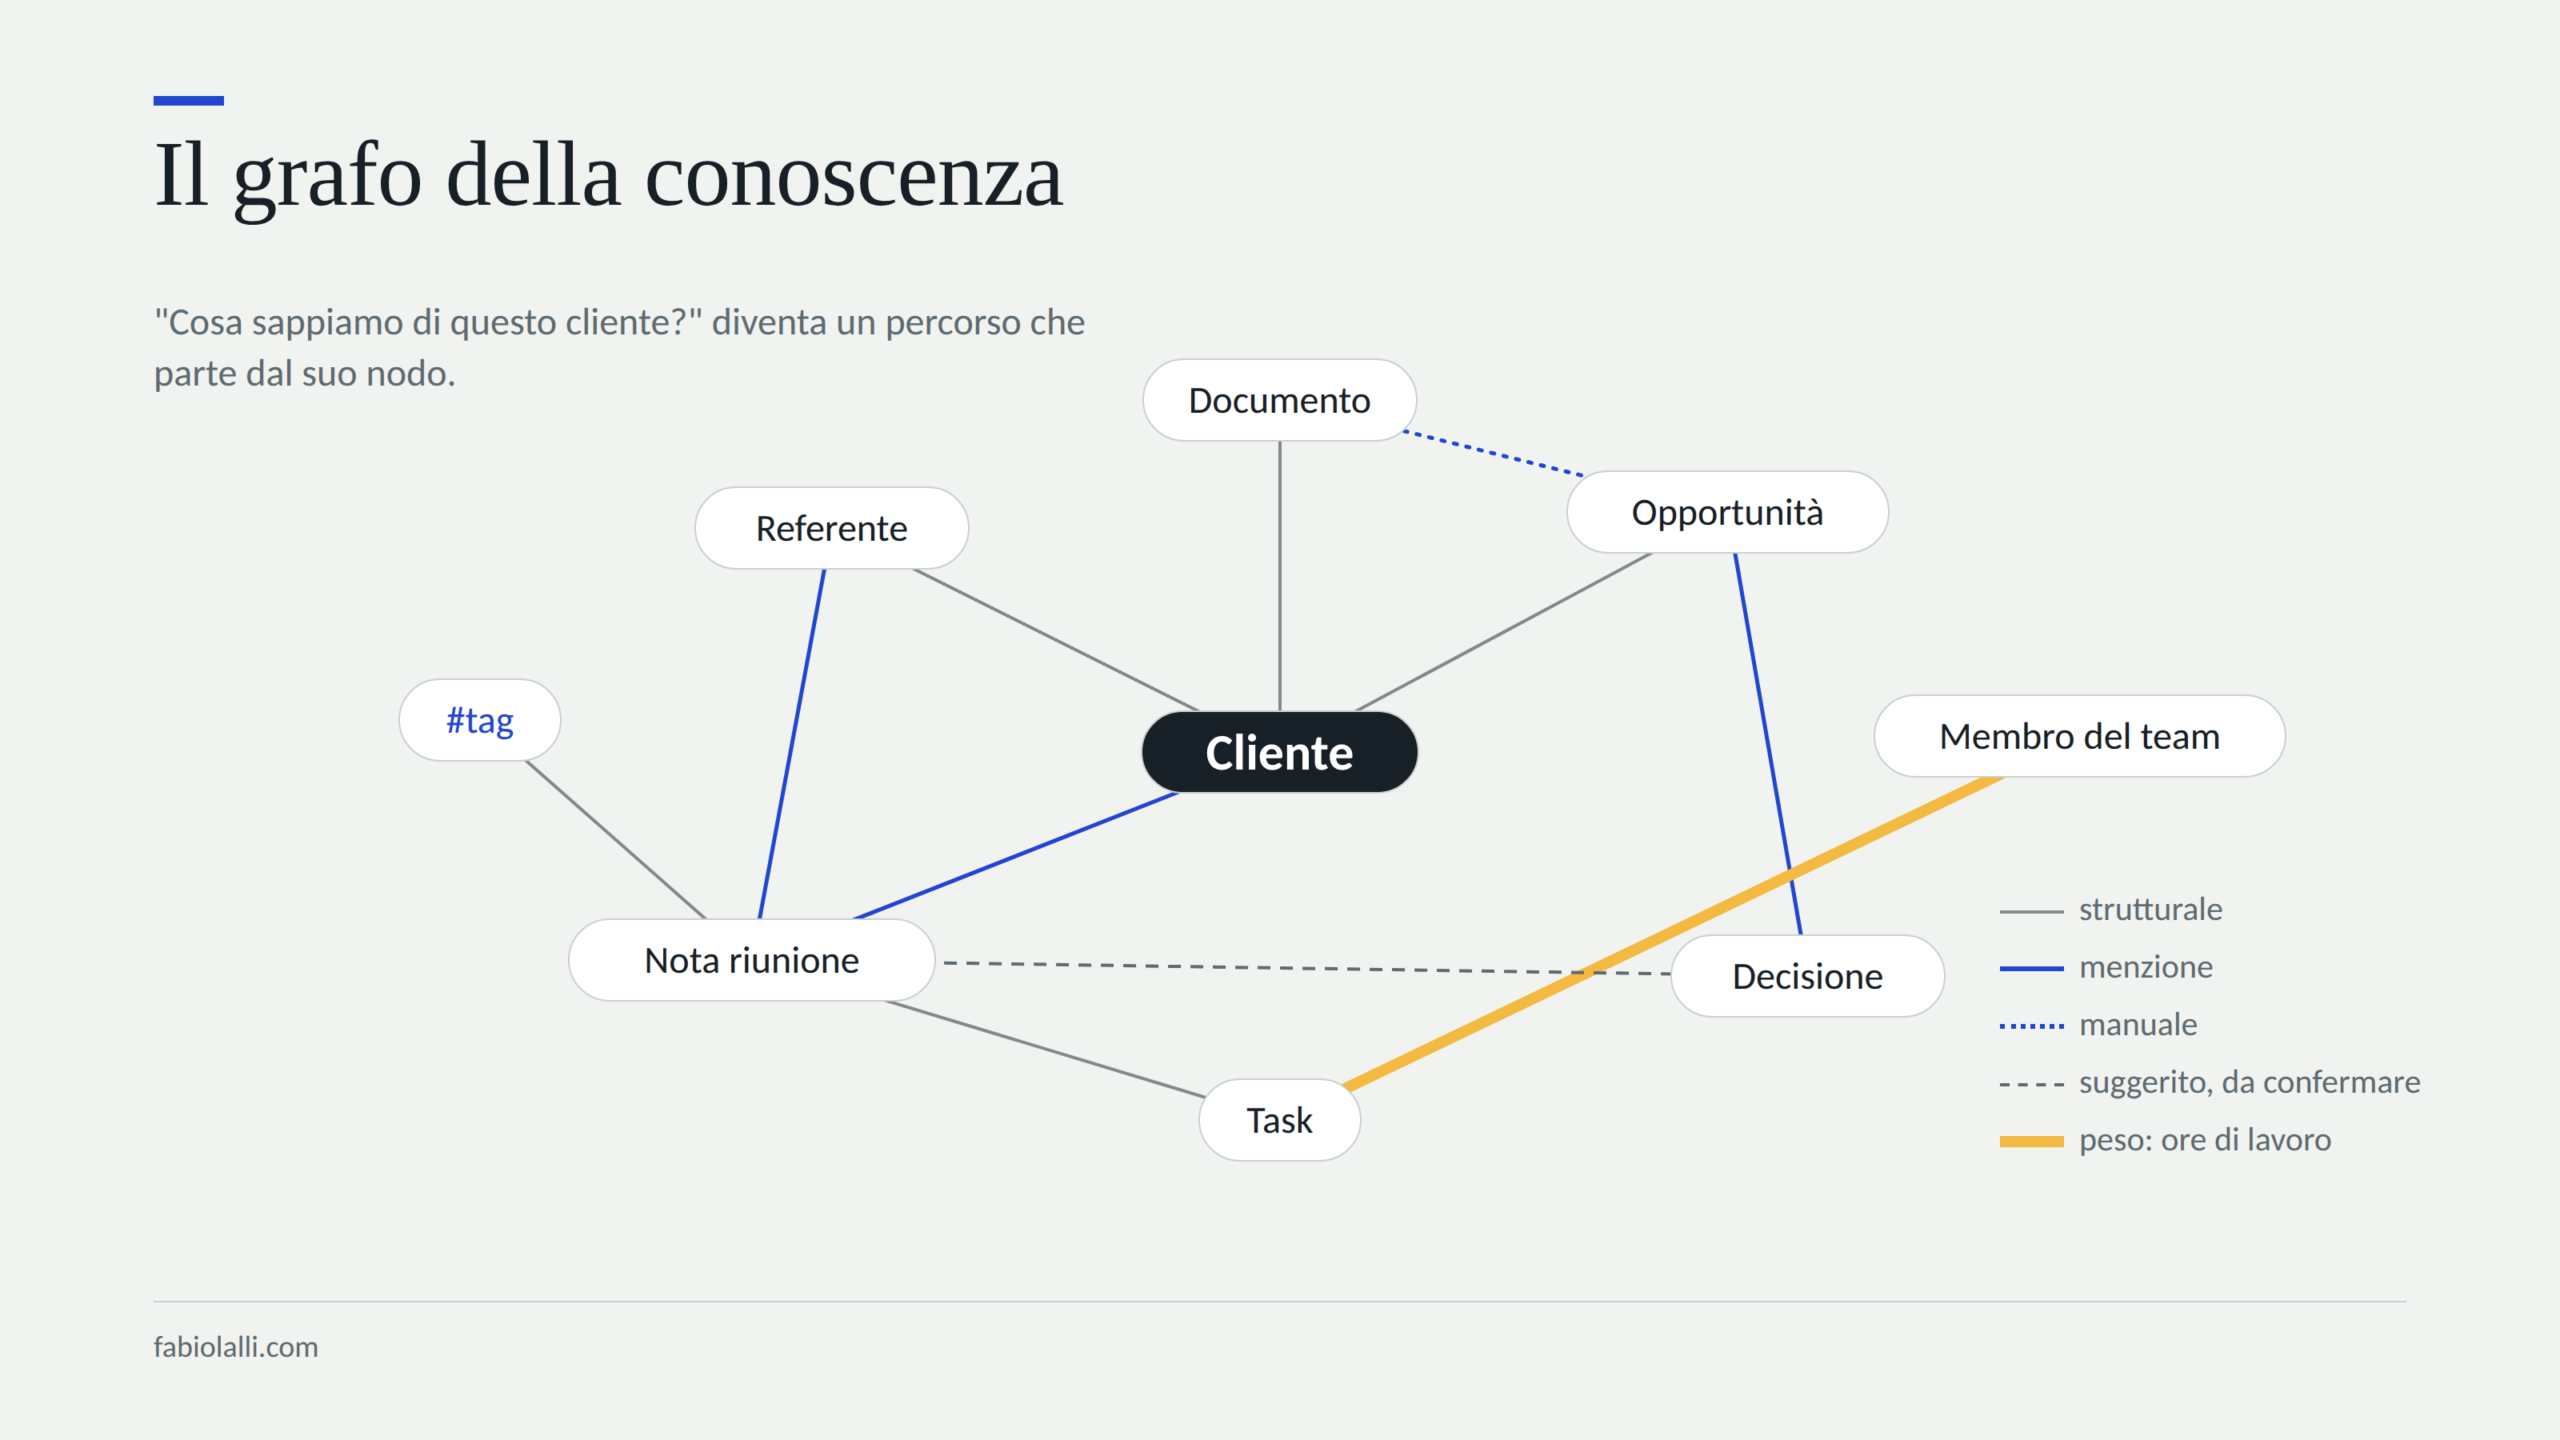
Il risultato è un grafo della conoscenza in cui i nodi sono note, task, documenti, referenti, opportunità, membri del team, cartelle, tag e organizzazioni, e gli archi hanno un’origine dichiarata: strutturale, da menzione, manuale o automatica. Alcuni archi hanno anche un peso, come le ore che una persona ha dedicato a un’attività, così la mappa mostra dove si concentra davvero il lavoro e non solo cosa è collegato a cosa.
Rendere la conoscenza percorribile vuol dire offrire più strade per arrivare alla stessa informazione. Dalla mappa del progetto si parte da un nodo e se ne esplora il vicinato fino a tre passi di distanza. Da ogni oggetto si vedono i collegamenti in uscita e quelli in entrata, cioè chi lo cita. La timeline restituisce la sequenza degli eventi, la ricerca attraversa note, task, documenti, testo estratto e tag di tutti i progetti leggibili. E il modello usa le stesse strade: prima di una riunione con un referente prepara il brief partendo dal suo nodo, raccogliendo le note recenti che lo citano, le opportunità aperte, i task in scadenza e le divergenze ancora da chiudere. Alla domanda “cosa sappiamo di questo cliente” il sistema risponde con un percorso nel grafo che parte dal nodo del cliente.
Quale modello per quali dati
Con la conoscenza centralizzata, strutturata e collegata, la scelta del modello diventa una decisione molto più semplice e molto meno rischiosa, perché il modello non contiene niente. Il cuore del sistema è il livello di conoscenza con il suo server di accesso: il modello è un lettore e un proponente, e si può sostituire senza perdere nulla. Il mio assistente personale si chiama Gideon, come l’intelligenza artificiale che in The Flash mostra a Barry Allen i giornali del futuro. Il mio si accontenta di sapere cosa abbiamo deciso martedì, e se domani cambiassi il modello che lo fa funzionare continuerebbe a saperlo, perché quella memoria non sta dentro di lui.
Il collegamento passa oggi quasi sempre da un server MCP, il protocollo che i principali assistenti usano per parlare con strumenti esterni. Il server del Workspace gira su un dominio proprio, con autenticazione OAuth, ed espone oltre sessanta strumenti: leggere e scrivere note, aprire task, caricare documenti, registrare il tempo di una riunione, interrogare il grafo di un progetto. Lo stesso server serve qualsiasi client compatibile, e il principio da tenere fermo è che il modello opera sempre con i permessi reali della persona che lo sta usando, mai con un’utenza tecnica onnipotente.
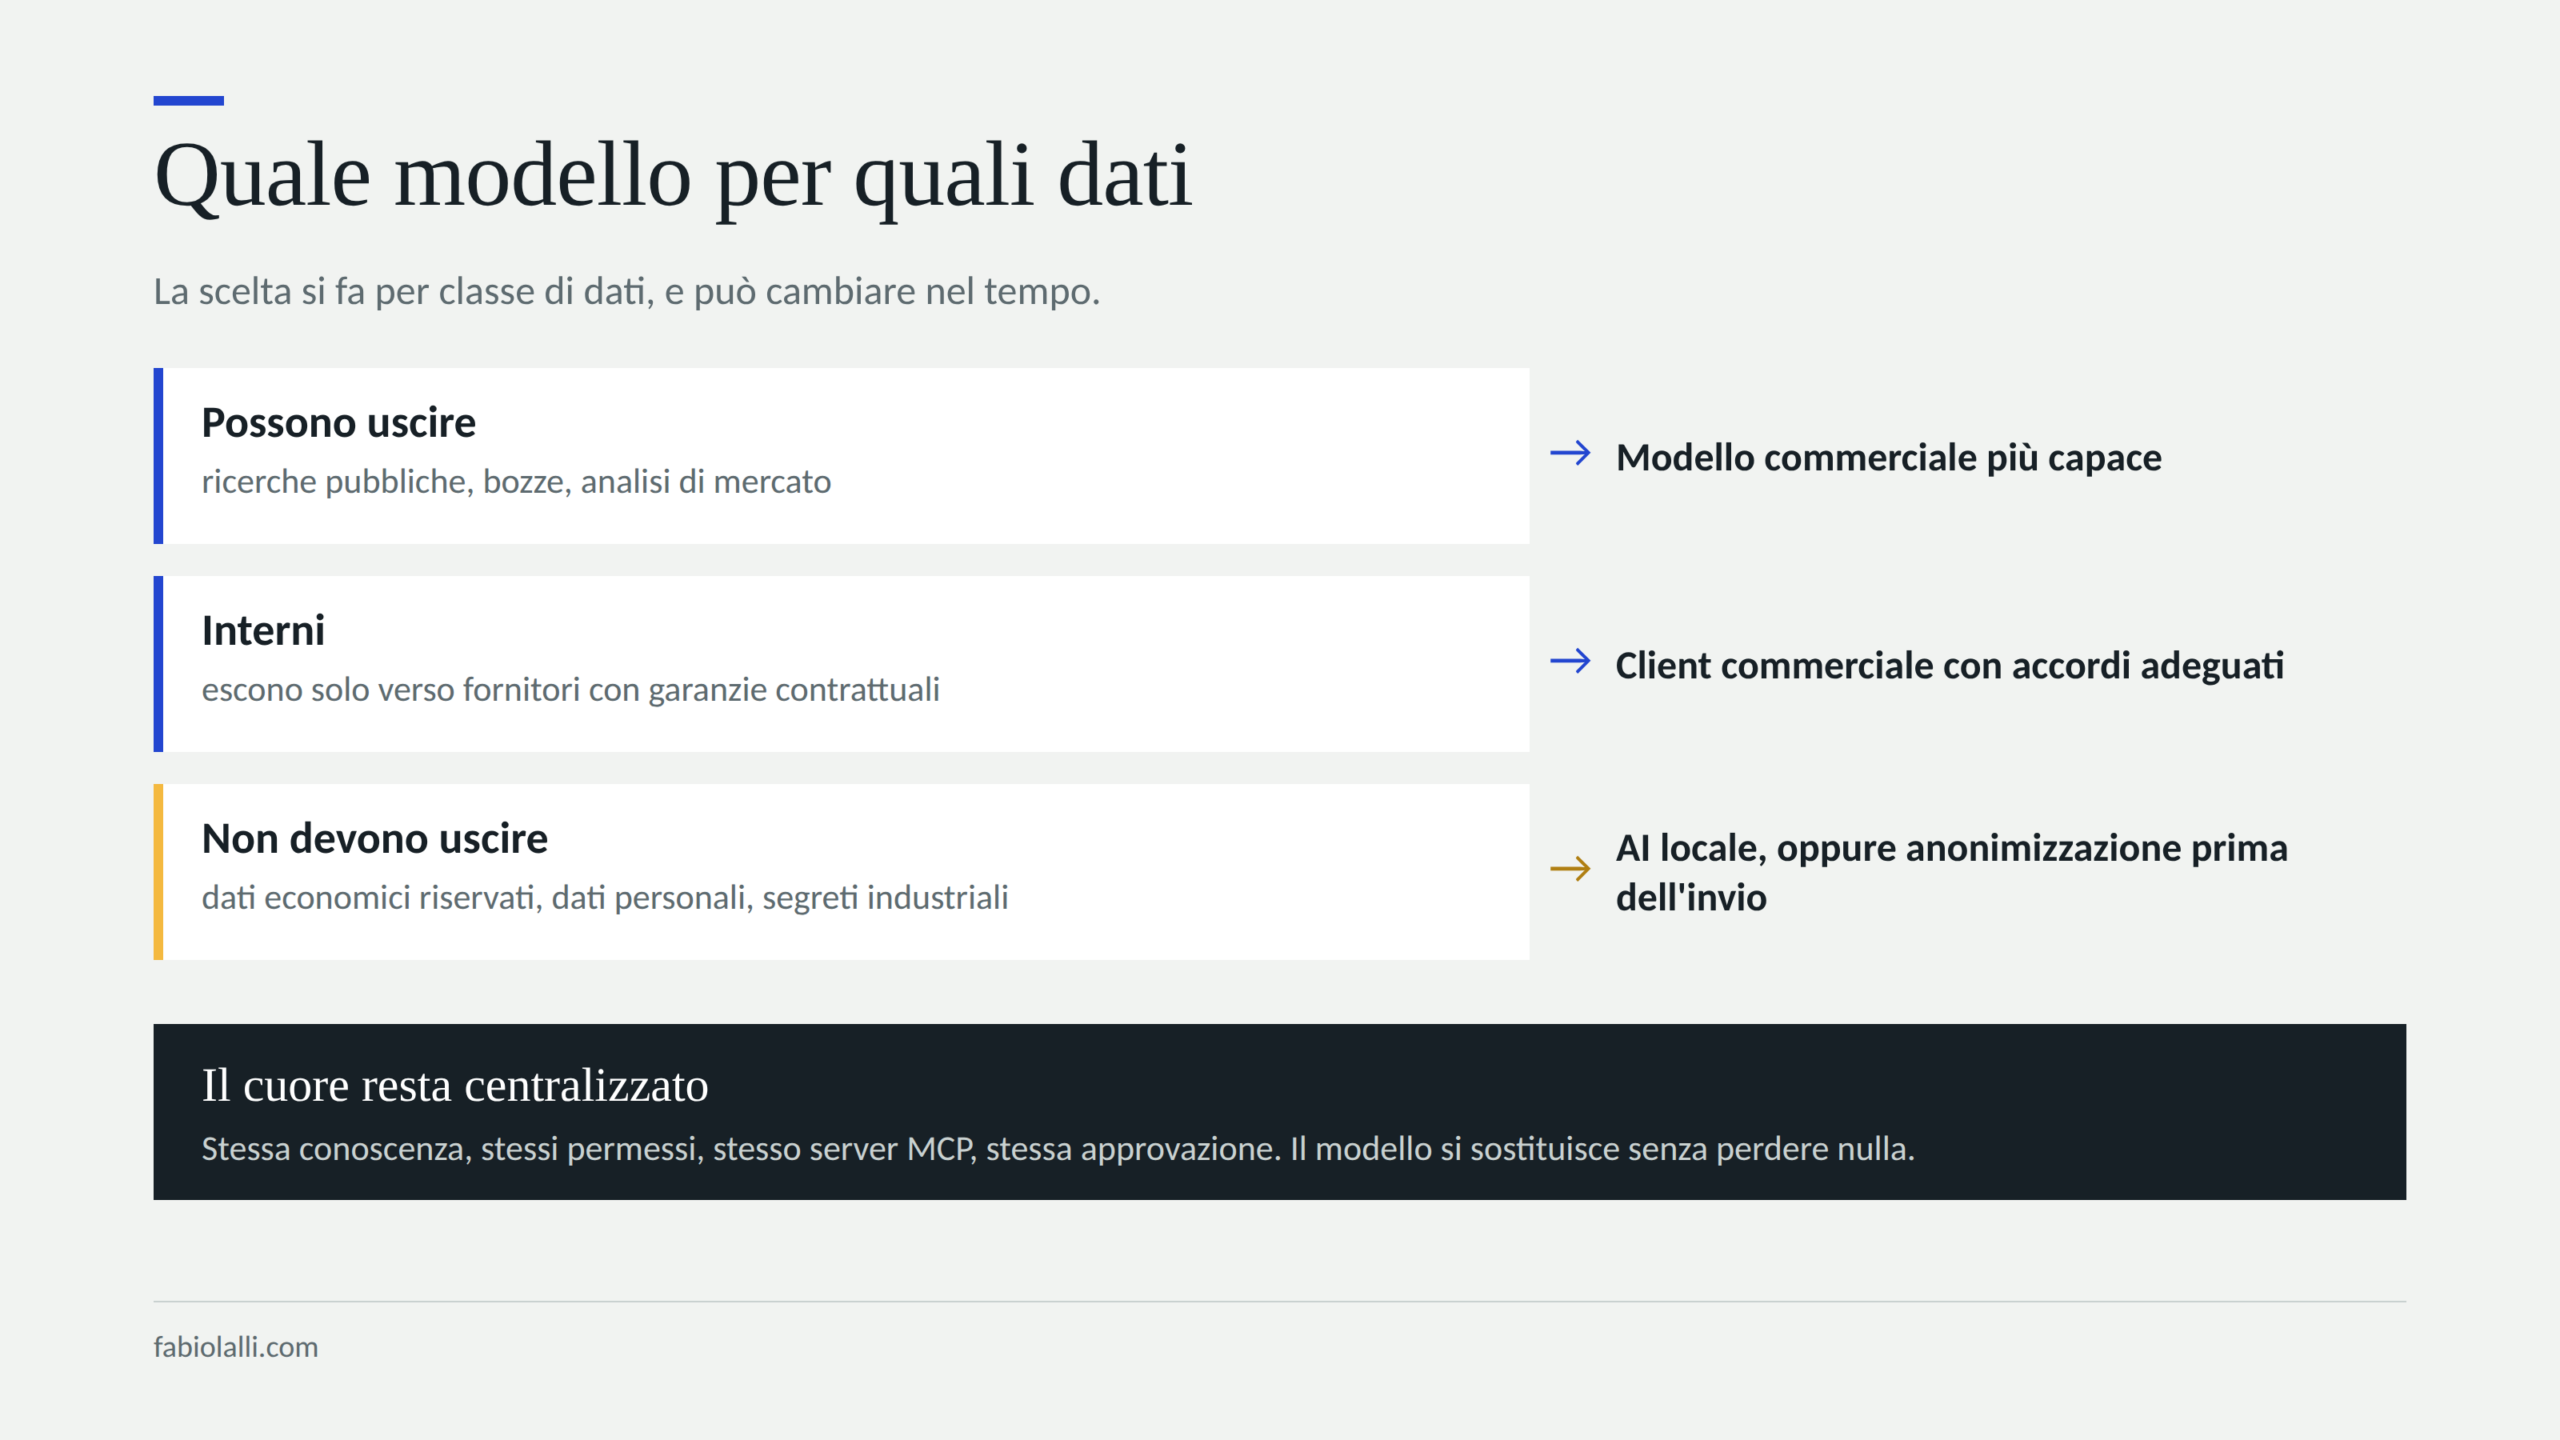
Da qui le strade sono sostanzialmente due, e spesso convivono. La prima sono i client dei prodotti noti, Claude, ChatGPT e gli altri assistenti commerciali: offrono i modelli più capaci, connettori già pronti verso posta, calendari e archivi, e un’esperienza che le persone conoscono. Il prezzo è che i dati letti dal modello transitano sui server del fornitore, con le garanzie contrattuali del piano sottoscritto. La seconda sono i client con AI locale, che eseguono modelli aperti su macchine aziendali o su server interni: i dati non escono dal perimetro dell’azienda, i costi sono prevedibili, e in cambio si accettano modelli meno potenti sui compiti più complessi, più lavoro di manutenzione e un’infrastruttura da gestire.
La scelta si fa per classe di dati, e può cambiare nel tempo. Un modo pratico è classificare le informazioni del progetto su tre livelli: dati che possono uscire (ricerche pubbliche, bozze di contenuti, analisi di mercato), dati interni che possono uscire solo verso fornitori con garanzie contrattuali adeguate, dati che non devono uscire per nessun motivo, come informazioni economiche riservate, dati personali sensibili o segreti industriali. Ai primi due livelli si applica il modello più capace disponibile, al terzo un modello locale, oppure un passaggio di anonimizzazione prima dell’invio. Nel Workspace questa classificazione è già parzialmente scritta nell’ontologia, perché le note e i documenti riservati sono marcati come tali, e quel marcatore diventa il criterio naturale per decidere quali oggetti affidare a un client locale.
Il punto fermo, in entrambi i casi, è che il cuore resta centralizzato. Che il modello giri in un data center americano o su un server nel seminterrato, legge la stessa conoscenza, con gli stessi permessi, attraverso lo stesso server, e propone modifiche che passano dalla stessa approvazione. Cambiare fornitore, o affiancarne due, diventa una decisione di costo e di riservatezza, senza progetti di migrazione.
Skill condivise in un catalogo unico
Una skill è il modo in cui si insegna a un assistente a fare una cosa sempre nello stesso modo: istruzioni in testo, riferimenti da consultare al momento giusto, script che verificano ciò che può essere verificato. Il paragone più vicino è il manuale operativo di un nuovo collaboratore, con la differenza che questo manuale viene letto davvero, ogni volta.
Il loro valore in un team va oltre l’efficienza del singolo. Quando dieci persone usano un LLM senza skill condivise, ciascuno scrive le note a modo suo, chiama le cose con nomi diversi, sceglie tag diversi, struttura le proposte con sezioni diverse, e il modello amplifica queste differenze invece di ridurle. Con le skill condivise il modello di ciascuno parla la stessa lingua: usa gli stessi tipi di nota, propone gli stessi formati, rispetta le stesse regole di stile, chiama un rischio “rischio” e una decisione “decisione”. Le skill sono il veicolo con cui l’ontologia arriva dentro ogni conversazione, senza che nessuno debba ricordarla.
Nel Workspace le skill sono tre e lavorano insieme. La skill di raccolta legge le fonti, smista per progetto, propone note, task, ore, referenti e collegamenti, prepara i brief, gestisce le verifiche. La skill documentale produce i documenti per i clienti da un motore unico: copertina, intestazione, palette e coordinate aziendali sono fisse, cambiano solo contenuti e firma di chi redige, e un controllo di stile automatico intercetta i tic di scrittura prima della consegna. Su questa si appoggia la skill commerciale, che segue una proposta dal brief all’opportunità nel progetto fino al preventivo nel CRM, con uno script che verifica al centesimo che documento e preventivo coincidano.
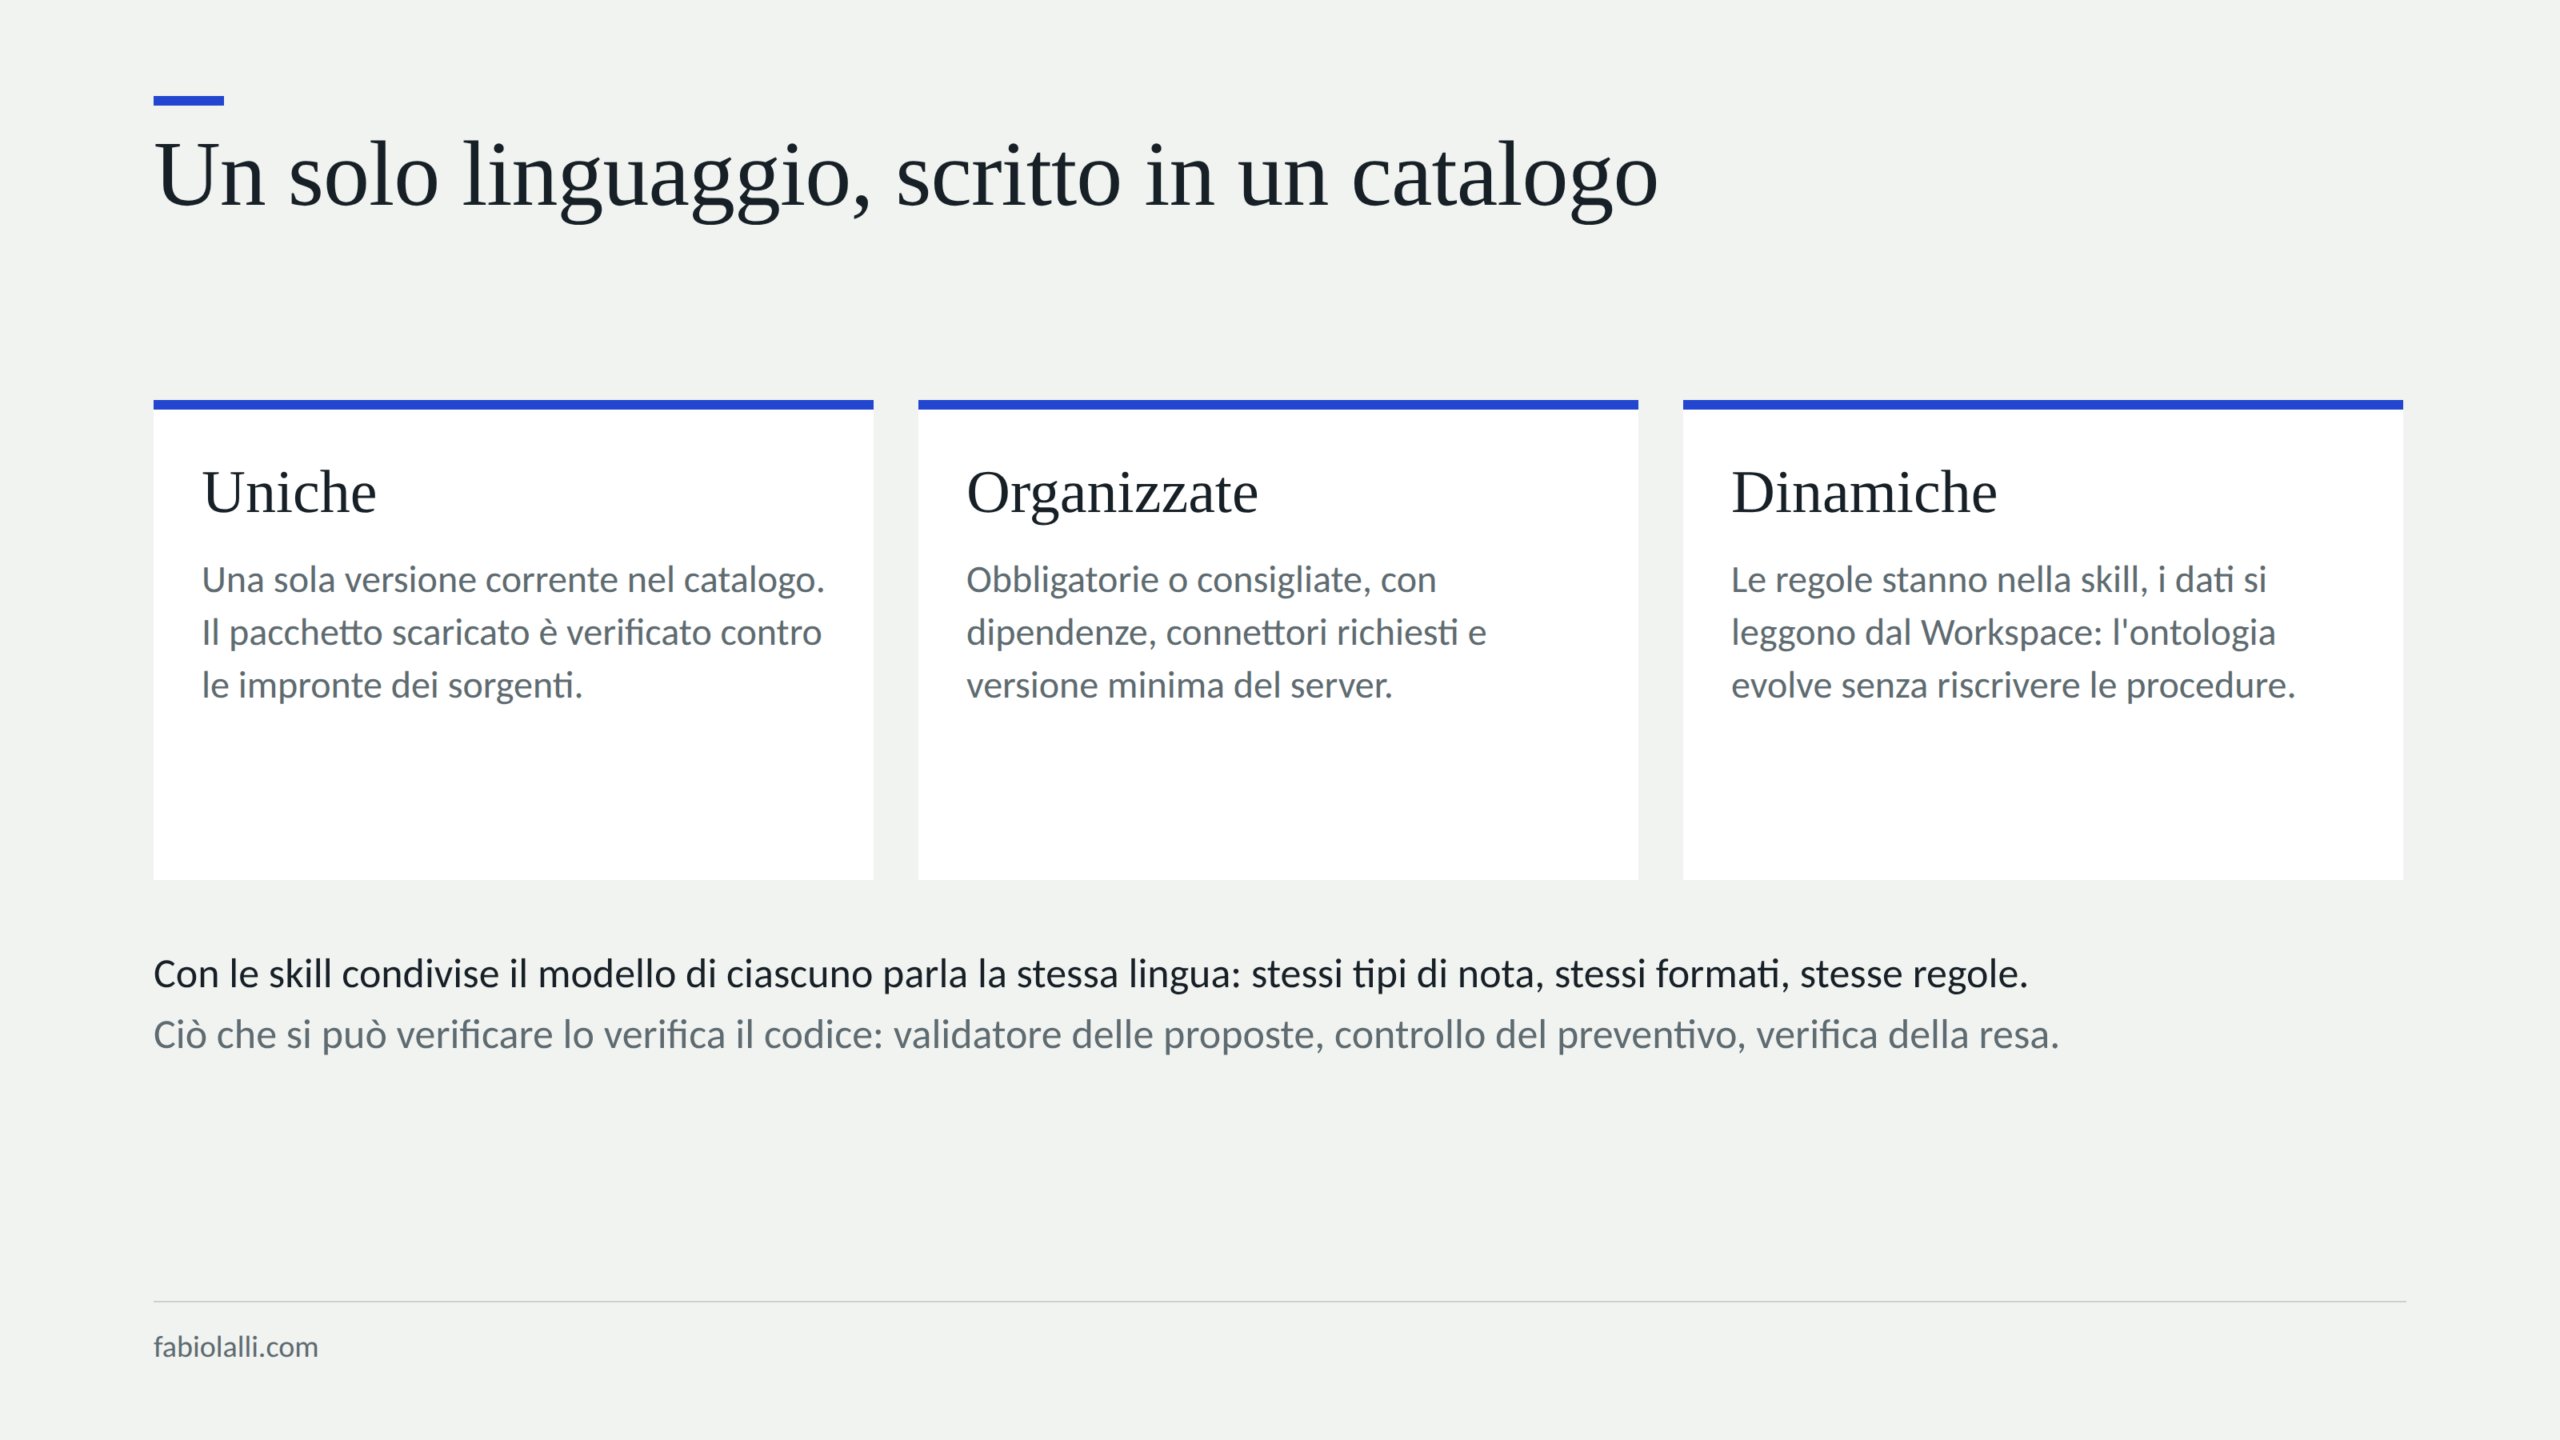
Conta molto anche il luogo dove le skill vengono scritte. Se vivono nei computer delle persone, dopo tre mesi ne esistono cinque versioni leggermente diverse, ognuna con le sue correzioni locali, e il linguaggio comune si disgrega dalla periferia. Per questo nel Workspace le skill stanno in un catalogo unico, dentro la piattaforma: ogni skill esiste in una sola versione corrente, con le note di rilascio, i connettori di cui ha bisogno, la versione minima del server, le altre skill da cui dipende e uno stato che la rende obbligatoria o consigliata. I sorgenti sono archiviati file per file con la loro impronta crittografica, e il pacchetto che ogni collaboratore scarica viene verificato contro quelle impronte.
Il catalogo rende le skill anche dinamiche nella struttura. Una skill ben scritta separa le regole dai dati: non contiene l’elenco dei tag del progetto né i domini del cliente, li legge dal Workspace nel momento in cui serve, così l’ontologia evolve senza dover riscrivere le procedure. Quando cambia una regola, si pubblica una nuova versione nel catalogo e ogni collaboratore la riceve con le note di rilascio. Il motore documentale è stato riscritto in Python con la sola libreria standard proprio per non legare le skill a un solo assistente: lo stesso pacchetto gira su qualsiasi piattaforma che esegua Python, compresi i client con AI locale.
La lezione tecnica più utile riguarda il confine tra quello che decide il modello e quello che decide il codice. Tutto ciò che si può verificare in modo deterministico va tolto al giudizio del modello. Prima di essere inviato, ogni pacchetto di proposte attraversa un validatore con nove regole. Il preventivo viene ricontrollato da uno script. Il documento passa da una verifica della resa in PDF. Al modello resta il lavoro che sa fare meglio, leggere, collegare e proporre, e il codice garantisce che il risultato rispetti le regole.
Il modello propone, le persone firmano
Il livello che tiene insieme tutti gli altri è una regola di governo molto semplice: niente entra nella memoria del progetto senza che una persona lo approvi. Quando il modello esegue la raccolta settimanale non scrive nulla, prepara un pacchetto di proposte. Ogni proposta dichiara l’operazione (crea una nota, apri un task, registra un’ora, collega due oggetti, apri una verifica), il progetto di destinazione, un estratto della fonte di massimo trecento caratteri con data e autore, un livello di confidenza e, quando serve, un marcatore che la segnala come da verificare o come contenuto economico riservato.
Il responsabile apre il pacchetto, approva, corregge o rifiuta. L’applicazione avviene con i suoi permessi, e se una proposta dipende da un’altra (un collegamento tra due note che nascono nello stesso pacchetto) il sistema le applica nell’ordine giusto. Una proposta rifiutata viene ricordata insieme alla sua origine e non torna alla raccolta successiva, quindi il sistema impara cosa non serve senza bisogno di istruzioni più lunghe.
La ragione di questa rigidità è pratica. Una base di conoscenza inquinata da un modello troppo zelante è peggio di una base vuota, perché nessuno sa più quali informazioni sono state verificate da una persona e quali sono state dedotte. Con le proposte approvate ogni oggetto del progetto ha un’origine e un responsabile, e se tra sei mesi qualcuno chiede perché è stata presa una certa decisione, la risposta porta a una riunione, a una persona, a una data.
Da dove cominciare
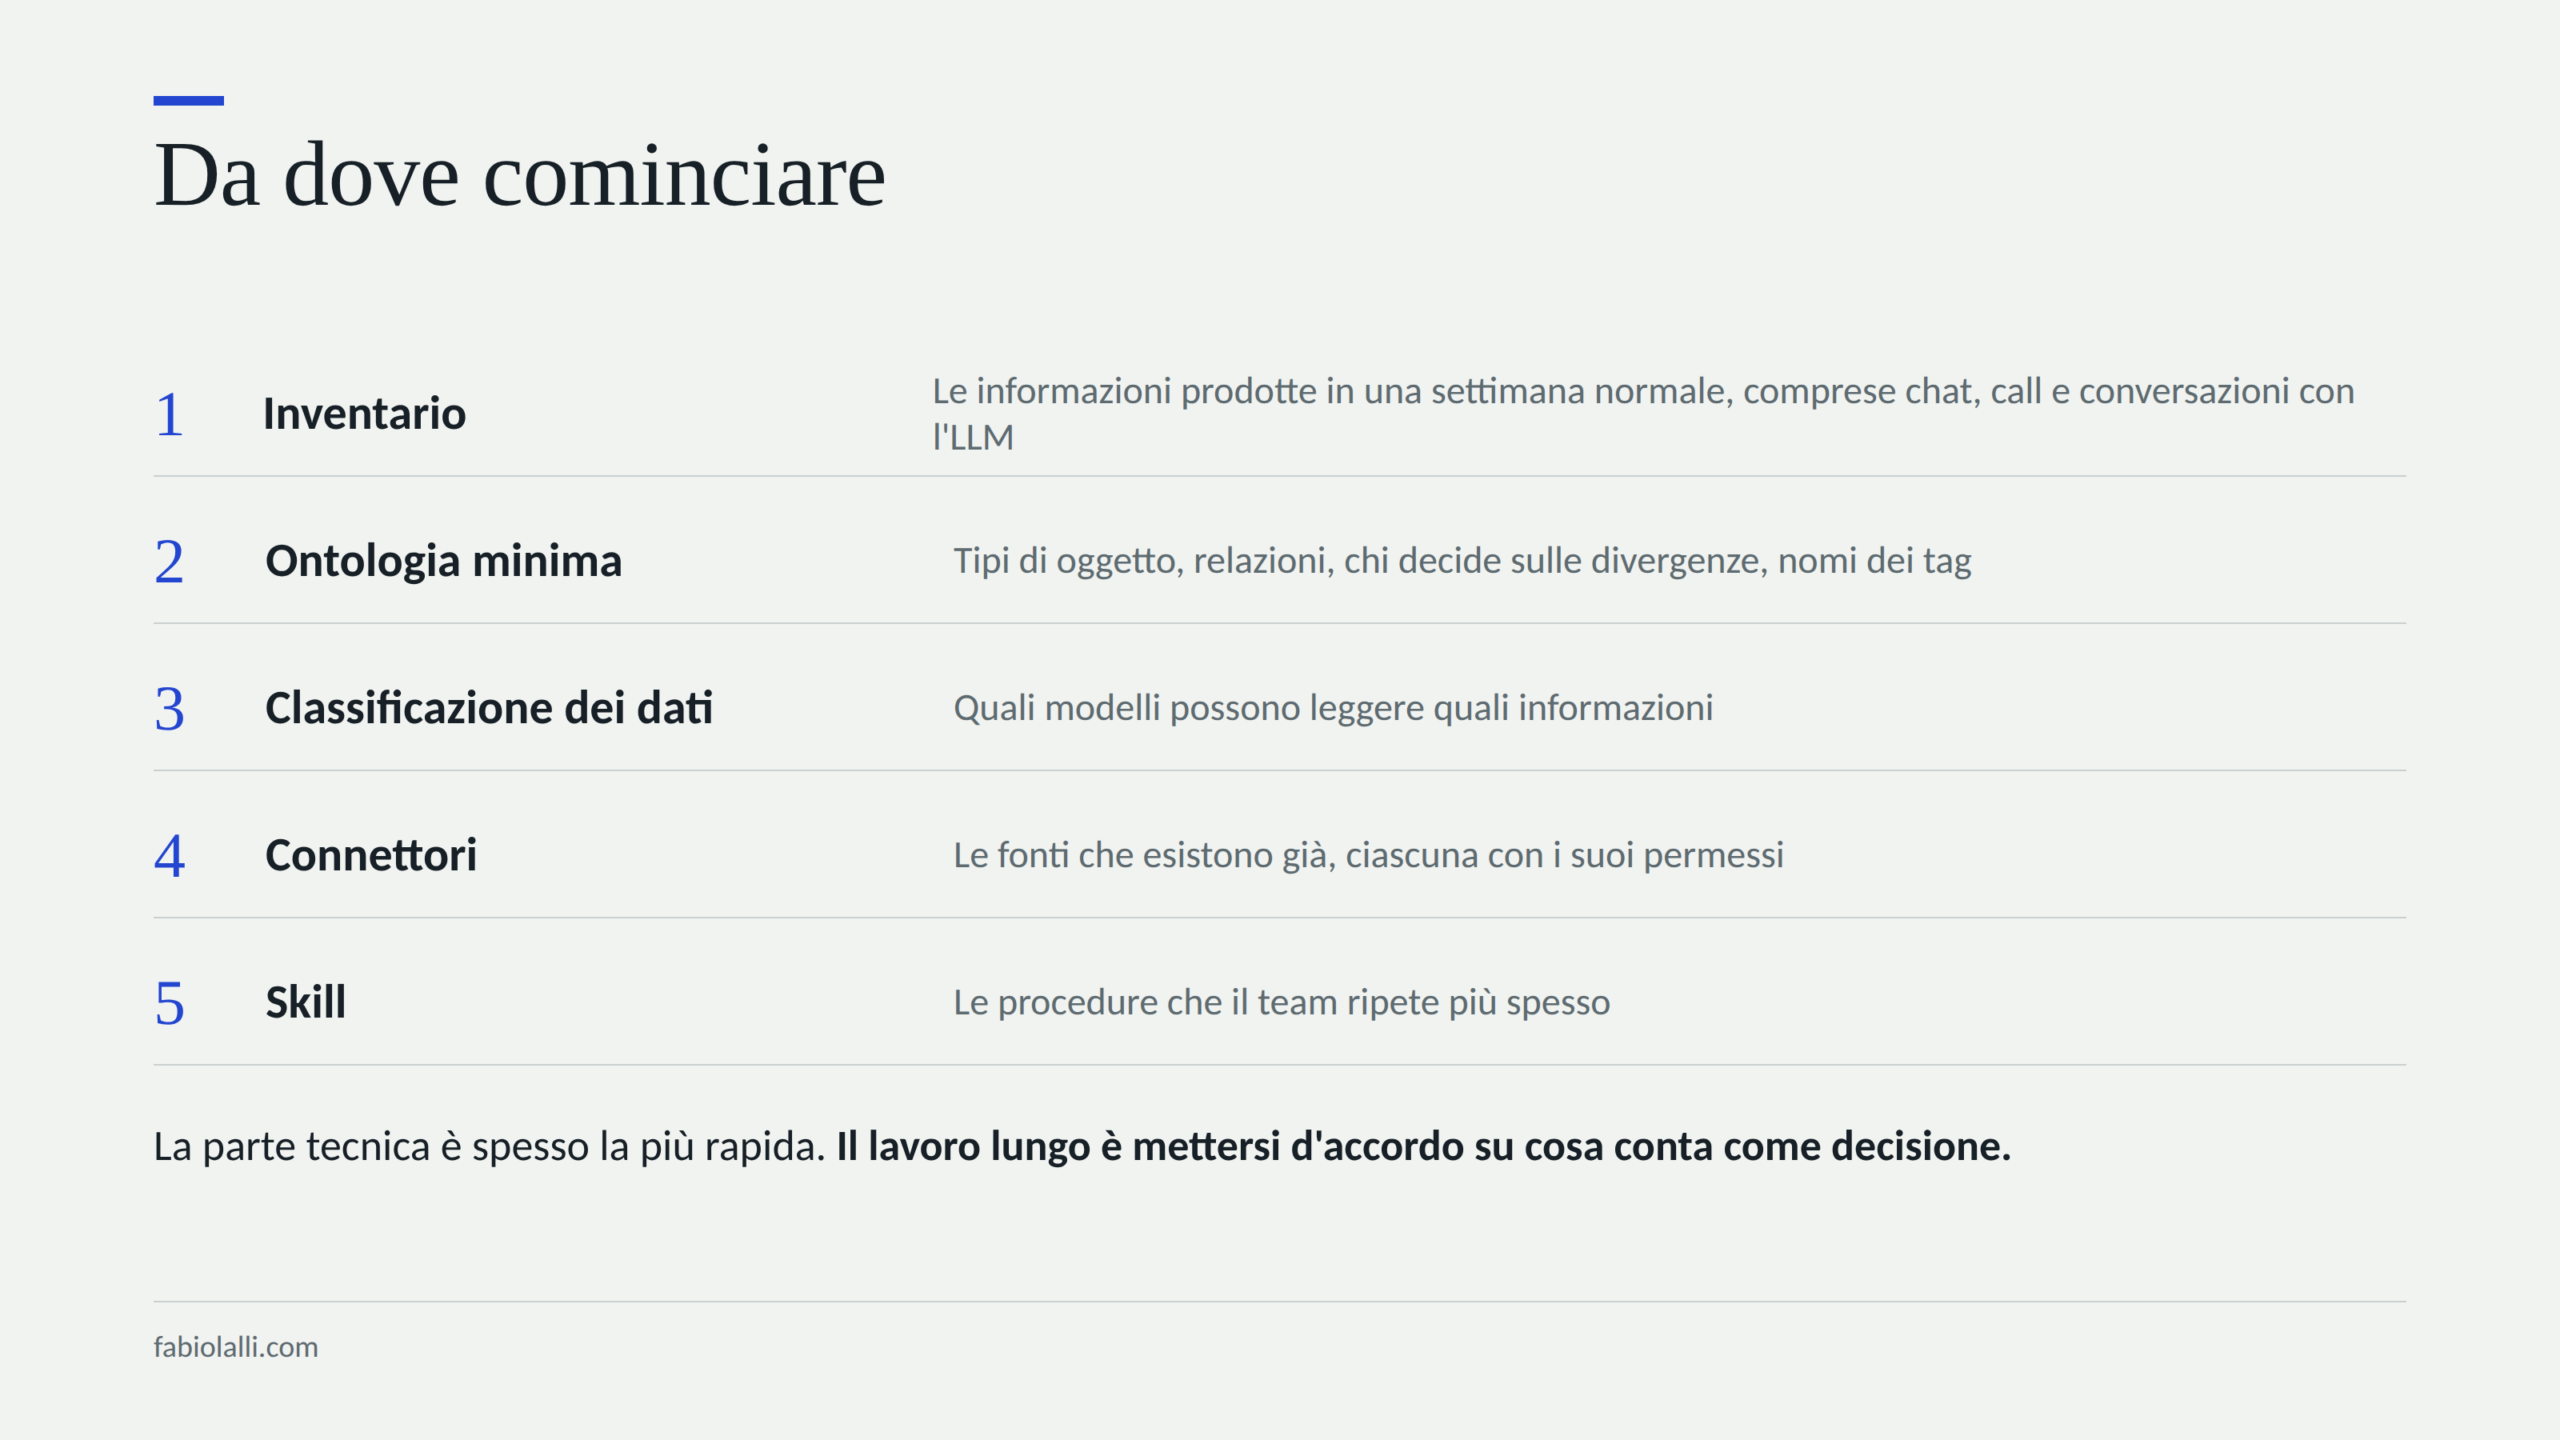
Chi parte da zero dovrebbe cominciare dalla carta e lasciare gli strumenti per dopo. Prima l’inventario delle informazioni che il team produce davvero in una settimana normale, comprese quelle che oggi si perdono nelle chat, nelle call e nelle conversazioni con l’LLM, e del sistema che ne è proprietario. Poi l’ontologia minima: quali tipi di oggetti esistono, quali relazioni servono, chi decide sulle divergenze, come si chiamano i tag. Poi la classificazione dei dati, che dice quali modelli possono leggerli. Infine i connettori e le skill, partendo dalle procedure che il team ripete più spesso e che oggi dipendono dalla memoria di una persona.
La parte tecnica, in molti casi, è la più rapida. Le fonti esistono già, hanno i loro connettori, e spesso basta farle convergere in un punto con un criterio di ingresso. Il lavoro più lungo è organizzativo: mettersi d’accordo su cosa conta come decisione, su chi può chiudere una divergenza, su quali dati non devono uscire dall’azienda e su quali tag hanno diritto di esistere è una conversazione che in molte aziende non è mai stata fatta. Scrivere nero su bianco quali sono gli oggetti della conoscenza di un team, e chi ne risponde, è il primo pezzo di uno spazio intelligente, e viene molto prima della scelta del modello da collegare.