Tool, skill e MCP: prima si disegna l’organizzazione, poi l’agente

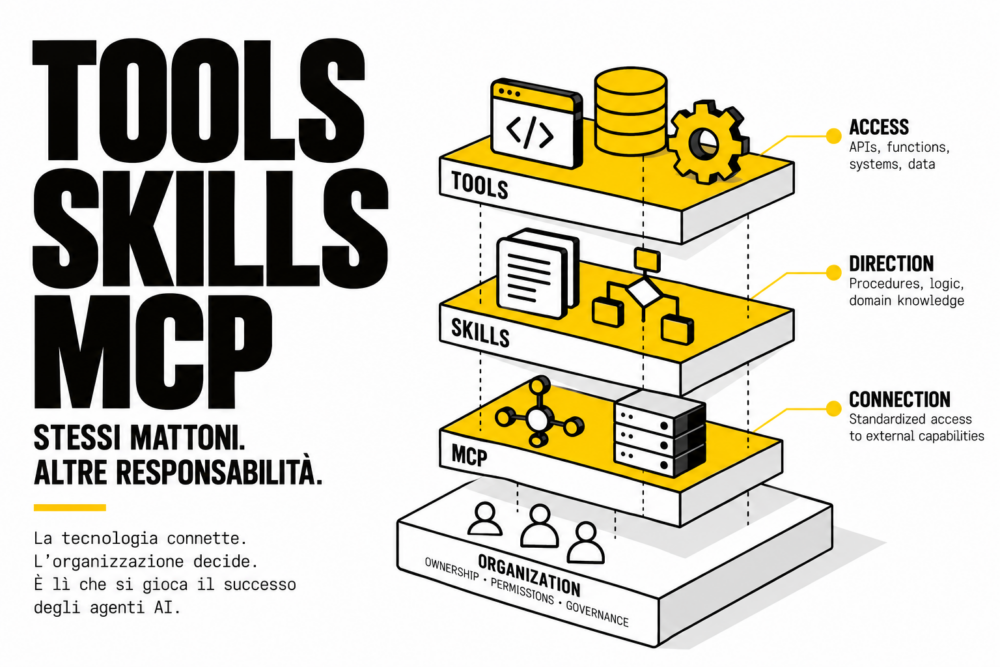
Su Medium ho trovato un articolo di Prabhu, che leggo da un po’, Tools vs Skills vs MCP, che mette in una tabella di tre righe i mattoni con cui oggi si costruisce un agente AI: i tool danno accesso, le skill danno direzione, MCP connette a capacità esterne. È una sistemazione utile per chi scrive codice e ha sentito usare le tre parole come sinonimi in una riunione, e la consiglio. Ho però l’impressione che per chi porta gli agenti dentro un’azienda quella tabella vada letta partendo da una colonna che non c’è, quella che dice chi ha deciso la procedura, chi ha concesso il permesso, chi possiede il sistema dall’altra parte del cavo.

Ogni riga della tabella tecnica ha un gemello organizzativo, e il gemello arriva prima. Una skill presuppone una procedura che qualcuno ha deciso e messo per iscritto, un tool presuppone una delega di potere con un perimetro, un server MCP presuppone un confine fra due sistemi che ha già un proprietario. Quando il gemello organizzativo manca la tecnologia non lo crea, lo simula, e la simulazione funziona benissimo finché non succede qualcosa.

Dentro il codice le tre cose si toccano

Conviene partire dal livello tecnico, perché è lì che la tabella semplifica di più. Un tool, nel senso che gli danno le API dei modelli, è una definizione: un nome, una descrizione in linguaggio naturale e uno schema JSON dei parametri. Il modello non esegue niente, produce una richiesta strutturata (chiama questa funzione con questi argomenti) e il runtime che gli sta intorno decide se eseguirla, con quali credenziali e cosa restituire. È la separazione su cui avevo costruito il pezzo sull’harness engineering: fra l’intenzione del modello e l’effetto nel mondo c’è sempre un pezzo di codice che qualcuno ha scritto e che può dire di no.

MCP, pubblicato da Anthropic a fine 2024 e poi adottato dagli altri grandi fornitori, sta un livello sotto i tool. È un protocollo costruito su JSON-RPC 2.0 con cui un’applicazione host apre connessioni verso uno o più server, e ogni server dichiara quali tool mette a disposizione del modello, affiancandoli se serve con risorse da leggere come contesto e con prompt riutilizzabili. Il trasporto può essere locale, un processo lanciato sulla macchina che parla attraverso lo standard input, oppure remoto su HTTP, con l’autorizzazione affidata a OAuth. In pratica MCP è il modo in cui i tool viaggiano: invece di cablare una funzione dentro ogni applicazione la si scrive una volta in un server e la si rende disponibile a qualunque client parli il protocollo.

Le skill sono l’oggetto più recente. Nel formato che Anthropic ha introdotto nell’autunno 2025 e poi aperto come standard, una skill è una cartella con un file SKILL.md, un’intestazione con nome e descrizione seguita da istruzioni in markdown, a cui si possono aggiungere file di riferimento e script eseguibili. Il meccanismo che la distingue da un prompt lungo si chiama progressive disclosure: il modello vede all’inizio solo nome e descrizione di tutte le skill installate e carica il corpo soltanto quando il compito lo richiede, così cento skill costano in contesto poche righe ciascuna finché restano inutilizzate. Una skill può contenere script, quindi porta con sé capacità, e un server MCP può esporre prompt, quindi porta con sé procedure. I confini si sovrappongono, e l’autore lo riconosce.

La colonna che mi convince meno è quella sulla manutenzione, dove MCP risulta «spesso gestito dal provider». Vale per GitHub o per Google Drive. Per il gestionale interno, per il CRM personalizzato da un fornitore che nel frattempo ha chiuso, per il database della produzione, il server MCP lo scrive e lo mantiene l’azienda, e il protocollo standardizza la forma della conversazione senza togliere a nessuno la responsabilità del contenuto.

La procedura di design che l’articolo propone parte da una domanda di capacità (cosa deve saper fare l’agente) e arriva ai sistemi esterni. Funziona per un team di sviluppo che costruisce un assistente per sé stesso. Dentro un’organizzazione la prima domanda riguarda l’autorità, e la capacità viene dopo.

Scrivere una skill obbliga a decidere il criterio

L’esempio dell’articolo è una skill per il rilascio di un’app Flutter in nove passi, dal controllo del branch fino al riepilogo finale. È un buon esempio proprio perché è facile: in un team di sviluppo quella procedura esiste già, spesso codificata in una pipeline di integrazione continua, e trasformarla in skill significa tradurla.

In azienda le procedure che vale la pena delegare a un agente raramente sono così. Come si valuta se un cliente merita una deroga sui tempi di pagamento, quando un reclamo va passato all’ufficio legale: sono decisioni che vivono nella testa di tre persone, ognuna con una versione leggermente diversa, mentre la versione ufficiale sta in un manuale qualità che nessuno apre da anni.

Quando si scrive la skill ci si accorge che manca il criterio, e a quel punto le strade sono due. Può scriverlo chi sta costruendo l’agente, un tecnico o un consulente che non ha l’autorità per decidere come l’azienda tratta i clienti morosi e che, per far funzionare il sistema, finisce per deciderlo lo stesso. Oppure ci si ferma e si chiede a chi ha quell’autorità di mettere il criterio per iscritto, ed è qui che il progetto rallenta, perché scrivere un criterio lo rende discutibile. Nel pezzo su chi delega all’AI il proprio lavoro avevo raccontato come la delega sia più bassa proprio nelle professioni dove il criterio è il patrimonio, e credo che dentro le aziende agisca la stessa dinamica.

Me ne accorgo ogni volta che scrivo le skill che uso per lavorare: la parte che richiede tempo sono sempre le regole, il formato del file si impara in un pomeriggio. La skill con cui preparo i pezzi per questo blog contiene un elenco di cose da evitare costruito correzione dopo correzione nel corso di mesi, e ogni riga è una decisione editoriale che prima stava solo nella mia testa e che adesso posso rileggere e contestare. Vista da fuori, una skill ben scritta è un documento di organizzazione con l’estensione .md.

Il permesso viene prima dello strumento

Un tool, guardato dall’organizzazione, è una delega di potere. createJiraTicket() è innocuo, issueRefund() no, e la differenza non sta nel codice (sono due chiamate HTTP molto simili) ma nel fatto che la seconda sposta denaro per conto di qualcuno.

Chi concede quel potere all’agente, e con quale identità l’agente lo esercita, sono domande che un’azienda sa già porsi per le persone, tanto che esistono procure, limiti di spesa per ruolo e doppie firme sopra una certa soglia. Per gli agenti queste regole di solito non ci sono, e il caso più frequente che incontro è l’agente che eredita le credenziali di chi lo ha configurato, con tutti i suoi permessi, compresi quelli che nessuno gli avrebbe mai delegato consapevolmente. Ogni tool concesso a un agente dovrebbe essere un permesso revocabile, con un titolare che sa di averlo firmato.

Nella guida alle istruzioni per Claude Code raccontavo come un’istruzione scritta nel prompt si pieghi sotto pressione mentre un hook no. Con i permessi succede lo stesso: scrivere nella skill «non emettere rimborsi sopra i 500 euro» esprime un desiderio, far rifiutare la chiamata al server sopra quella soglia stabilisce una regola. Il modello organizzativo decide la soglia e la tecnica la rende inviolabile, in quest’ordine, perché nessun ingegnere dovrebbe stabilire da solo quanta fiducia l’azienda concede a un software.

MCP disegna confini che hanno già un proprietario

Il diagramma dell’articolo mette l’applicazione AI in alto, il server MCP al centro e sotto GitHub, un database e Jira. Da dentro un’azienda ognuna di quelle scatole ha un responsabile, un budget, un fornitore con un contratto e spesso un’opinione precisa su chi può leggere i suoi dati. Scrivere un server MCP per il CRM significa decidere quali parti del CRM diventano leggibili da un agente e in nome di chi, e quella decisione appartiene al responsabile commerciale e al DPO prima che al team IT.

Il server MCP del blog su cui sto scrivendo ne è un esempio piccolo. Impone una sequenza di stati, dalla bozza alla revisione fino all’approvazione e alla programmazione, e rifiuta i salti. Quella sequenza è una decisione organizzativa su chi controlla cosa prima che un testo esca col mio nome, e sta nel server proprio perché non può dipendere dalla buona volontà del modello in una sessione qualsiasi.

C’è poi il livello del significato, che nessun protocollo tocca. Due server MCP possono esporre lo stesso campo «cliente» intendendo cose diverse, uno i clienti attivi e l’altro chiunque abbia mai ricevuto un’offerta, e l’agente li userà entrambi con la stessa sicurezza. Ne ho scritto a proposito dell’interoperabilità fra agenti, dove il vocabolario precede il protocollo, e del modello dati come teoria dell’azienda: MCP standardizza il tubo, e quello che ci scorre dentro porta con sé tutte le ambiguità organizzative che c’erano prima.

Il codice moltiplica il modello organizzativo che trova

Sarebbe sbagliato concludere che la tecnica sia un dettaglio da sistemare a valle. La sequenza che propongo alle aziende con cui lavoro differisce da quella dell’articolo soltanto nell’ordine delle domande, perché parte da chi decide e con quale criterio, passa per i poteri che si delegano e le soglie che li limitano, arriva ai confini fra sistemi e ai loro proprietari. A quel punto si scrivono skill, tool e server, e ognuno diventa la forma eseguibile di una decisione già presa.

Quando la decisione esiste, la tecnica le dà proprietà che sulla carta non ha mai avuto. Scritta in una skill, una procedura diventa versionata, e si può ricostruire quale versione ha guidato un’azione in una certa data; il permesso, quando sta nel server, si può testare e la sua violazione lascia un log; per spostare un confine dichiarato in un server MCP serve una modifica che qualcuno deve approvare. Il manuale qualità non aveva nessuna di queste caratteristiche, ed è per questo che nessuno lo apriva.

C’è anche un effetto di ritorno. Scrivere una skill è il modo più rapido che conosco per scoprire dove un’organizzazione non ha mai deciso niente, perché il modello, a differenza di un collega esperto, non riempie i vuoti con il buon senso del corridoio: li riempie con una media statistica, e la media si vede subito. Da quando ho scritto Pelle Digitale penso alle interfacce fra persone e macchine come ai punti in cui qualcosa di implicito è costretto a diventare esplicito, e gli agenti portano quel passaggio dentro l’organigramma.

Nei prossimi mesi i fornitori renderanno skill e server MCP facili da installare quanto un’app, e molte aziende ne avranno a decine prima di aver deciso chi li governa. Il vantaggio andrà a chi userà questo periodo per fare l’esercizio al contrario, prendendo una procedura alla volta e cercando chi l’ha decisa. Spesso la risposta sarà nessuno, e da lì comincia il progetto.
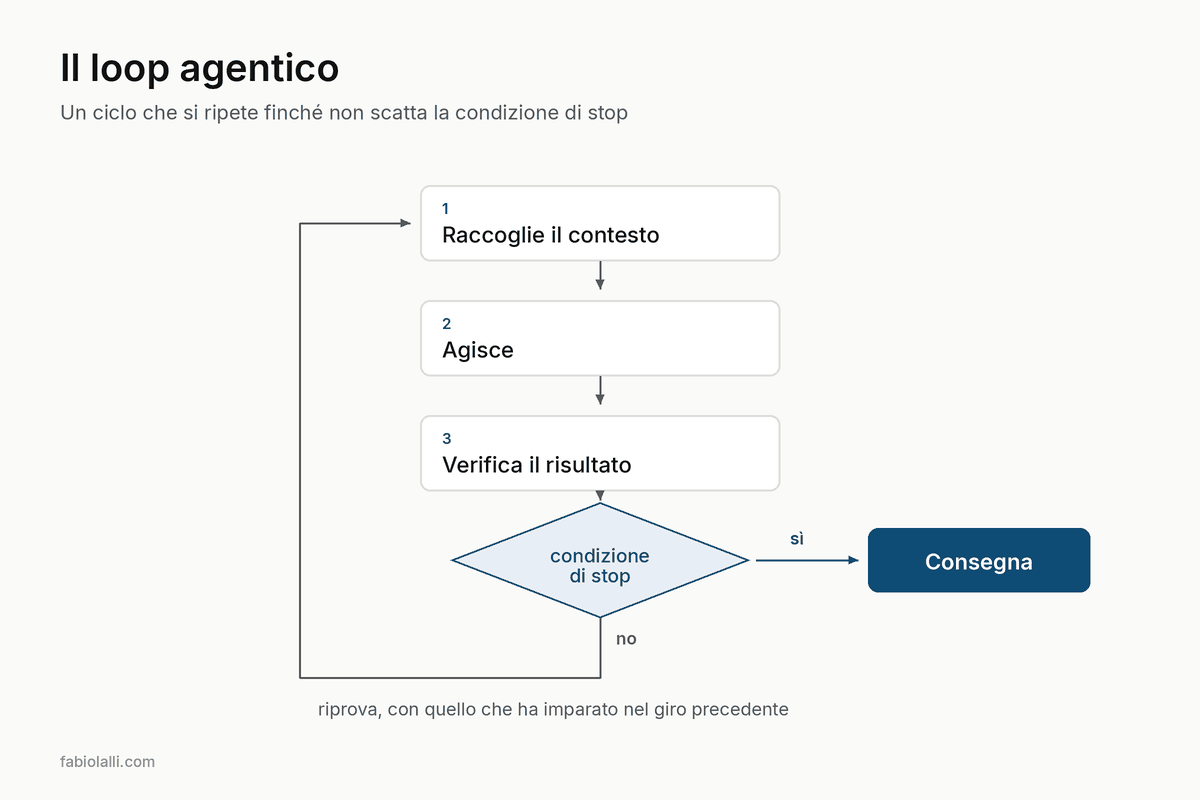
 

Progettare il loop invece di scrivere il prompt successivo

Chiedi a Claude di aggiungere un pulsante di like e parte un loop agentico. Legge il codice, fa la modifica, lancia i test e ti restituisce qualcosa che crede funzioni. Poi tocca a te: apri la pagina, clicchi, guardi la console del browser, e scrivi il prompt successivo. Il collo di bottiglia sei tu, per come è fatto il ciclo: l’agente produce, l’umano controlla, un turno alla volta.

Delba de Oliveira e Michael Segner, del team di Claude Code, hanno messo per iscritto a fine giugno la definizione di loop agentico che usano internamente: «agents repeating cycles of work until a stop condition is met». Agenti che ripetono cicli di lavoro finché non scatta una condizione di stop. È una definizione povera di aggettivi e piena di conseguenze, perché tutto il peso si sposta su una domanda sola, chi scrive quella condizione.


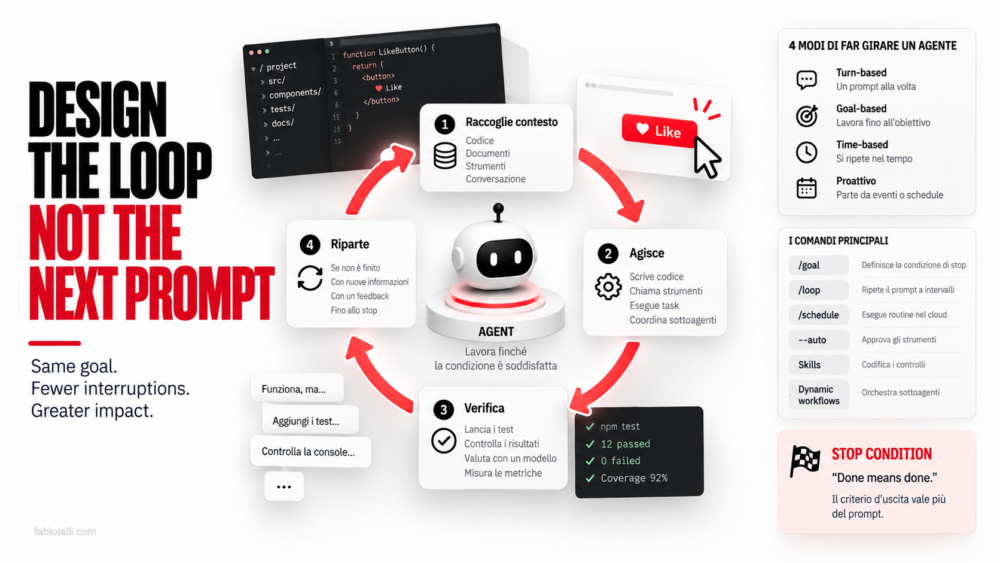
Il ciclo di base: raccoglie contesto, agisce, verifica, e riparte finché la condizione di stop non è soddisfatta.

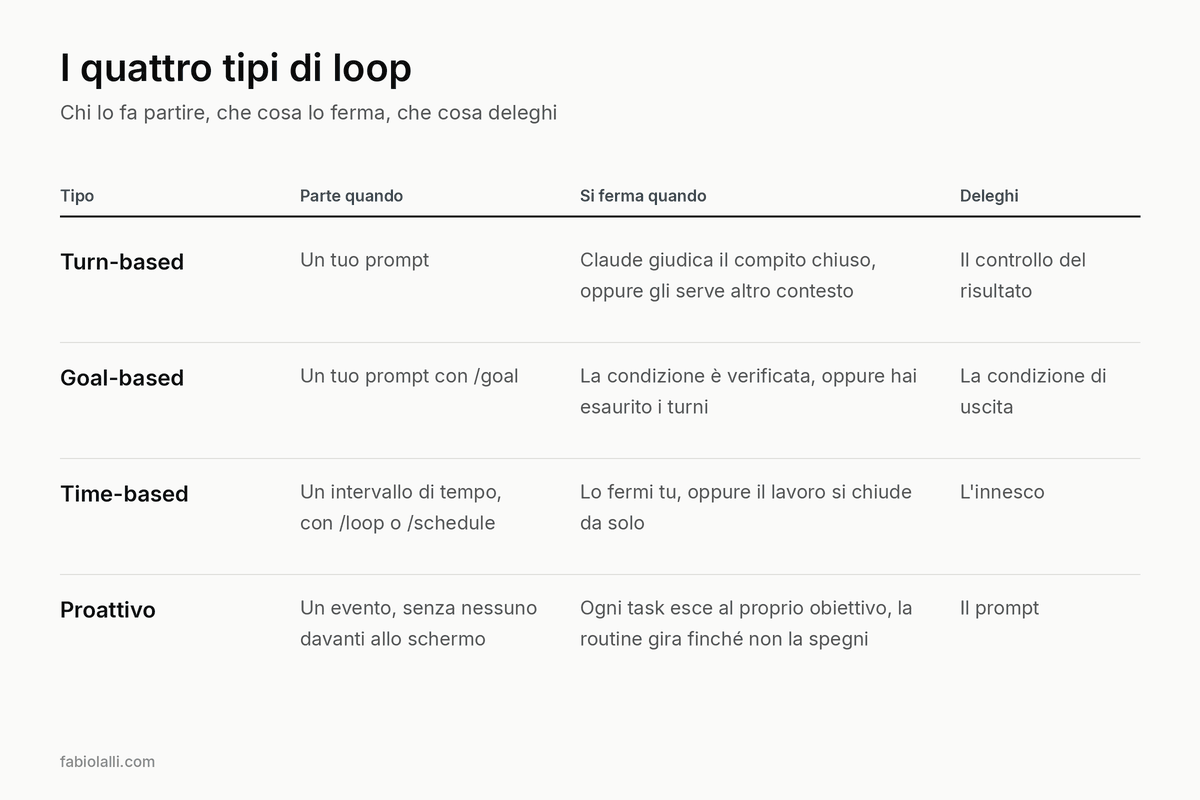
Quattro modi di far girare un agente

Il turn-based è il loop agentico che usiamo tutti senza chiamarlo così. Parte da un tuo prompt, Claude raccoglie il contesto, agisce, controlla il proprio lavoro e risponde, e si ferma quando giudica il compito chiuso oppure quando gli serve qualcosa che non ha. Quello che deleghi, se lo deleghi, è il controllo del risultato.

Il goal-based nasce quando un turno solo non basta. Con /goal dichiari che cosa significa fatto, e Claude continua a lavorare senza che tu debba rilanciarlo a ogni giro. Ogni volta che prova a fermarsi, un modello valutatore rilegge la conversazione e decide se la condizione regge, e se non regge lo rimanda al lavoro con una motivazione che diventa la guida del turno successivo. Qui deleghi la condizione di uscita, ed è la ragione per cui i criteri deterministici funzionano molto meglio delle formule generiche.

Il time-based serve al lavoro che torna, quello in cui il compito resta identico e cambiano solo gli ingressi: il riassunto dei messaggi del mattino, la pull request che riceve commenti di review e fa fallire la CI. Deleghi l’innesco.

Il proattivo è quello in cui davanti allo schermo non c’è nessuno. Un evento o una pianificazione fanno partire il lavoro, ogni task esce quando raggiunge il proprio obiettivo, la routine continua a girare finché non la spegni. Deleghi il prompt, cioè la parte che fino a ieri consideravamo il mestiere.

I comandi che Anthropic ha rilasciato

/goal imposta una condizione di completamento valida per la sessione, lunga fino a quattromila caratteri. A ogni fine turno un modello piccolo e veloce, Haiku per impostazione predefinita sull’API di Claude, restituisce uno di tre verdetti: soddisfatta, non ancora, impossibile. Il valutatore non esegue comandi e non legge file per conto suo, giudica soltanto quello che Claude ha già portato in conversazione, quindi la condizione va scritta come qualcosa che l’output può dimostrare. Dentro la condizione conviene mettere anche un tetto, «oppure fermati dopo venti turni», altrimenti il loop si allunga oltre quello che ti aspetti. Funziona anche in modalità non interattiva, con claude -p.

/loop rilancia lo stesso prompt a intervalli regolari e gira sul tuo computer, quindi si spegne quando spegni la macchina. /schedule sposta la stessa idea nel cloud e la trasforma in una routine, che continua a lavorare a portatile chiuso. Una routine può partire da una pianificazione oraria, giornaliera, feriale o settimanale, da una chiamata HTTP autenticata a un endpoint dedicato, oppure da un evento GitHub come l’apertura di una pull request o la pubblicazione di una release, con filtri su autore, titolo, branch, etichette. L’intervallo minimo è un’ora. Le routine sono disponibili sui piani a pagamento di Claude, si gestiscono da claude.ai/code/routines e hanno un tetto giornaliero di esecuzioni oltre al consumo ordinario dell’abbonamento.

Intorno a questi due comandi girano altri pezzi. La modalità auto approva le chiamate agli strumenti dentro un turno, e si combina bene con /goal, che invece toglie di mezzo la conferma tra un turno e l’altro. I dynamic workflows, in research preview, permettono a Claude di orchestrare sottoagenti in parallelo. Le skill descrivono i controlli da ripetere. Per chi non apre mai un terminale ci sono gli scheduled task di Cowork, che si configurano dall’interfaccia, girano da remoto anche a computer spento e usano i connettori e le skill già attive.

Il criterio d’uscita vale più del prompt

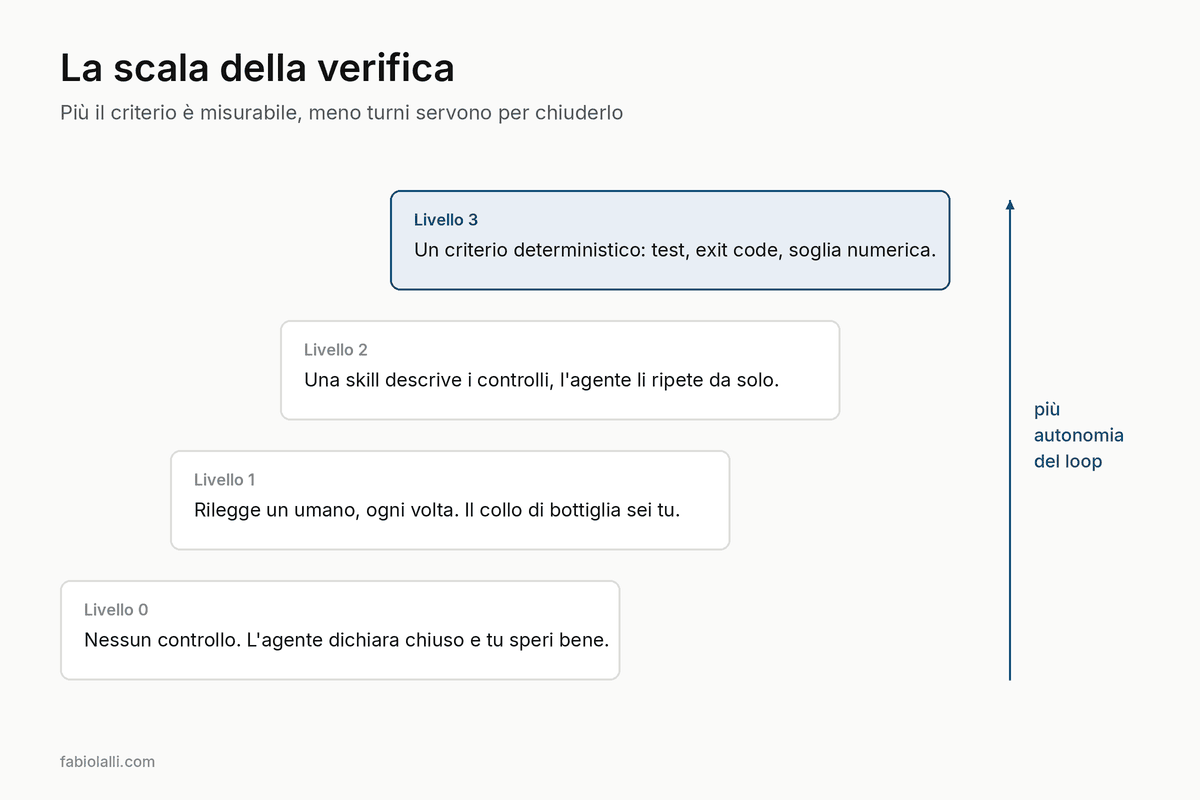
La qualità di un loop dipende dal sistema che gli sta intorno, e il pezzo che pesa di più è la verifica. Il consiglio di Anthropic è codificare in un file di skill i passaggi che oggi fai a mano, così che l’agente possa controllare il proprio lavoro dall’inizio alla fine invece di dichiararlo finito appena la modifica è andata a buon fine: avviare il server, aprire la pagina, cliccare il controllo nuovo, fare uno screenshot prima e dopo, guardare che in console non compaiano errori, misurare le metriche di performance. Più i controlli sono quantitativi, più l’autoverifica diventa semplice.

Nel mio flusso editoriale la condizione di uscita è un exit code. Uno script passa il testo al setaccio cercando i tic di scrittura che non voglio, e finché non esce zero il pezzo non si consegna. È un criterio grezzo, e misurabile, e chiude il loop in molti meno giri di qualunque descrizione a parole di che cosa sia un buon articolo.


Più il criterio d’uscita è misurabile, meno turni servono al loop per chiudersi da solo.

Due accorgimenti da rubare. Il primo è affidare la revisione a un secondo agente con contesto pulito, perché chi non ha seguito il ragionamento del primo è meno incline a confermarlo. Il secondo riguarda cosa fare quando un risultato non è all’altezza: correggere il singolo errore serve una volta sola, mentre spostare la correzione dentro la skill la rende valida per tutti i giri successivi. È la differenza tra un loop che migliora e uno che ti fa rimettere a posto la stessa cosa per la terza volta.

Sei loop da accendere questa settimana

La rassegna delle sette è il più facile da accendere: uno scheduled task che legge messaggi, posta e calendario delle ultime ventiquattro ore e consegna un brief prima che tu apra il computer. «Ogni mattina alle 7:00 riassumi Slack, email e calendario delle ultime 24 ore e scrivimi trecento parole con le tre cose che oggi richiedono una mia decisione».

Quando le richieste arrivano su un canale condiviso, la coda si accumula da sola e qualcuno passa la giornata a smistarla. Una routine oraria con un obiettivo esplicito la tiene bassa: «ogni ora controlla il canale delle richieste, e non fermarti finché ogni segnalazione trovata in questo giro non ha un responsabile, una priorità e una risposta».

C’è poi il documento che non esce finché non passa l’audit, il caso in cui il criterio esiste già da qualche parte e nessuno lo aveva mai dato in pasto all’agente: «l’articolo passa lo script di audit con exit code 0 e resta sopra le 1.400 parole, fermati dopo sei tentativi».

Anche il debito accumulato su un sito si può assegnare a un lunedì mattina: «ogni lunedì alle 6:00 controlla i post pubblicati nell’ultimo mese, segnala meta description mancanti, immagini senza testo alternativo e link interni rotti, e prepara le correzioni in bozza».

Sulle pull request funziona meglio l’intervallo, perché quello che cambia sta fuori dal tuo progetto e arriva quando arriva: /loop 10m controlla la mia PR, rispondi ai commenti di review, sistema la CI che fallisce.

L’ultimo parte da un evento invece che da un orario. La pipeline di deploy chiama via HTTP l’endpoint della routine appena il rilascio è in produzione, la routine esegue gli smoke test, cerca regressioni nei log e scrive go o no-go nel canale di release prima che la finestra si chiuda. Lo stesso schema regge sugli alert: il sistema di monitoraggio passa il corpo dell’allarme, l’agente correla lo stack trace con i commit recenti e apre una bozza di pull request con una proposta di correzione, così chi è di turno trova qualcosa su cui lavorare invece di un terminale vuoto.

Per scegliere quale accendere per primo, Anthropic propone un criterio pratico: guarda il lavoro che già fai, prendi un compito in cui sei tu a rallentare tutto, e chiediti quale pezzo puoi passare alla macchina, se sai scrivere il controllo di verifica, se l’obiettivo è già abbastanza chiaro da poter essere giudicato da un altro modello, oppure se il lavoro arriva comunque a scadenze regolari.

Quanto costa tenere acceso un loop

Un loop senza confini è un modo elegante di bruciare token. Il primo controllo è la scelta del pezzo giusto: un compito piccolo non ha bisogno di più agenti, e parecchio lavoro gira benissimo su modelli più economici, tenendo quello più capace per le decisioni di giudizio. Il secondo è la precisione del criterio di uscita, che deve essere specifico abbastanza da far arrivare Claude alla soluzione presto, senza però farlo fermare troppo presto.

Poi ci sono due regole che sembrano banali e non lo sono. Quando una parte del lavoro è deterministica, conviene che sia uno script a farla, perché eseguire uno script costa meno che ragionare ogni volta sugli stessi passaggi. E l’intervallo di una routine va tarato su quanto spesso cambia davvero la cosa che stai guardando, non su quanto ti piacerebbe essere aggiornato. Prima di lanciare un workflow su tutto il perimetro conviene provarlo su una fetta piccola, visto che l’orchestrazione dinamica può generare centinaia di agenti.

Per misurare c’è /usage, che scompone il consumo recente per skill, sottoagenti e connettori, /goal senza argomenti, che mostra turni e token spesi finora, e /workflows, da cui si vede quanto sta consumando ogni agente e si può fermarne uno al volo.

Una routine firma con la tua identità

Qui arriva la parte che in azienda pesa più del risparmio di tempo. Una routine gira come sessione autonoma: durante l’esecuzione non ci sono richieste di permesso, e Claude può usare tutti gli strumenti dei connettori inclusi, comprese le scritture. Quando crei una routine i connettori attivi vengono inclusi tutti per impostazione predefinita, e toglierli è un gesto che conviene fare subito.

Quello che la routine fa attraverso la tua identità appare come fatto da te. I commit e le pull request portano il tuo utente GitHub, i messaggi su Slack e i ticket su Linear passano dai tuoi account collegati. L’ambiente cloud definisce a quali domini la sessione può arrivare, e il testo che accompagna un’attivazione via API viene consegnato all’agente dentro un blocco marcato come dato non affidabile, così il prompt della routine deve dichiarare esplicitamente di volerlo usare prima che quel testo possa orientare il lavoro.

Sono dettagli di configurazione, e insieme disegnano una superficie di responsabilità nuova. Permesso revocabile è la formula che uso da tempo per questa condizione, in cui l’autonomia di un sistema è sempre concessa e sempre ritirabile. Con le routine la domanda operativa diventa chi ha aperto il permesso, quali strumenti ha lasciato dentro, e in quanto tempo qualcuno se ne accorge.

Il livello che stavamo saltando

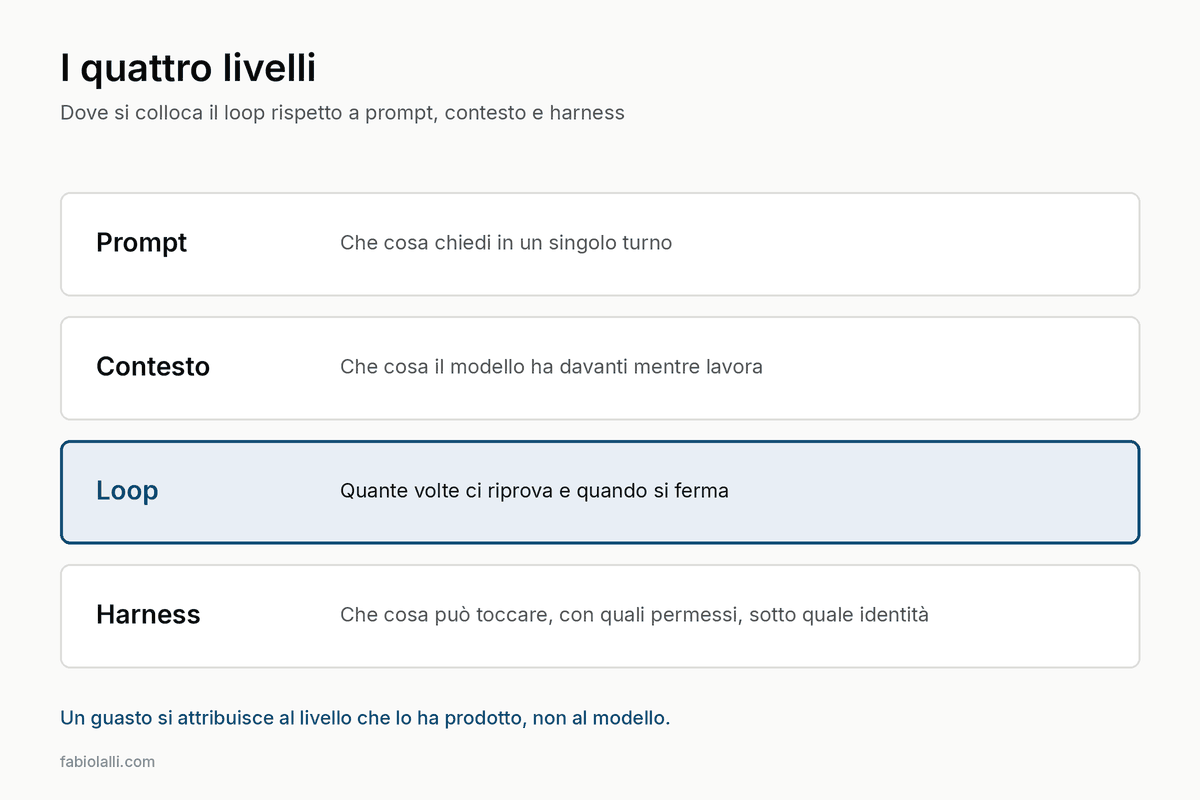
Per due anni abbiamo lavorato quasi solo sul primo livello, la formulazione del singolo turno, e poi sul secondo, il contesto da mettere davanti al modello. Sopra c’è l’harness, il guscio che decide che cosa l’agente può toccare e con quali permessi. In mezzo sta il livello che stavamo saltando: quante volte l’agente ci riprova, e a quali condizioni ha il diritto di dire che ha finito.


Il loop sta sopra il contesto e sotto l’harness: un guasto si attribuisce al livello che lo ha prodotto.

Chi progetta il loop agentico decide dove finisce il lavoro della macchina e dove comincia la responsabilità di una persona. Nei prossimi mesi credo che nelle organizzazioni comparirà un ruolo che oggi non ha ancora un nome: qualcuno che scrive le condizioni di stop, le rivede quando cambia il contesto, e risponde di tutto quello che quelle condizioni lasciano passare.

Il watermark di Claude e il tool open source che lo smonta

Dal 2 agosto 2026 i nuovi modelli Claude lanciati nell’Unione Europea nascono con un watermark incorporato nel testo che generano, e, dove il formato lo consente, con metadati di provenienza firmati secondo lo standard C2PA. È l’attuazione pratica dell’articolo 50(2) del Codice di condotta europeo sull’AI Act, che Anthropic ha firmato insieme ad altri fornitori di modelli generativi: il funzionamento è descritto nella scheda ufficiale sul marking pubblicata dall’azienda.

La rete, come sempre, ha reagito più in fretta della norma. Su LinkedIn circola uno screenshot con toni da comunicato: non sarebbero passate nemmeno ventiquattr’ore da quando è comparsa una skill capace di ripulire i testi da Claude, Gemini e OpenAI, mille stelle su GitHub in un giorno, cento per cento open source. Il progetto si chiama watermarks-remover, ed è il banco di prova giusto per capire quanto valga davvero, oggi, marcare un contenuto generato da intelligenza artificiale.

Due firme, non una

Il watermark di Anthropic si scompone in due meccanismi distinti, e la distinzione conta perché determina anche dove un tool avversario può colpire. Il primo vive dentro il testo stesso: un segnale statistico intessuto nella scelta dei token, invisibile a occhio nudo, che sopravvive al copia e incolla e in parte anche alle modifiche successive. Il secondo vive nei file: metadati C2PA firmati, applicati a formati come SVG, PNG e JPG, pensati per segnalare se un contenuto è stato processato da Claude e se è stato manomesso dopo.

Anthropic stessa, nella sua scheda di trasparenza, elenca i limiti di entrambi i canali con una franchezza che raramente si vede nella comunicazione di prodotto. Un segnale rilevato non prova la paternità intera del contenuto, perché Claude può aver semplicemente tradotto, riassunto o corretto un testo altrui. E l’assenza del segnale non prova il contrario, perché basta un modello precedente all’agosto 2026, una riscrittura pesante, un passaggio troppo corto o una conversione di formato per far sparire la traccia. È dentro questo margine dichiarato, non contro di esso, che si è mosso chi ha scritto watermarks-remover.

Watermark scomposto in tre livelli

Il repository di Guillaume Meyer, con licenza MIT e oltre trecento fork, separa il problema in tre pezzi con garanzie molto diverse tra loro, e qui la differenza tra teoria e pratica diventa concreta. Il primo livello ripulisce i caratteri Unicode invisibili, spazi esotici, marcatori bidirezionali, tag nascosti che alcuni schemi di marcatura usano come vettore. È un’operazione deterministica, verificabile riga per riga, e non tocca una sola parola del testo visibile: puliscono un file di testo o un Markdown senza alterarne il significato.

Il secondo livello attacca invece i watermark statistici, quelli intessuti nella probabilità con cui un modello sceglie un token piuttosto che un altro, come SynthID-Text di Google o gli schemi in stile Kirchenbauer. Qui non esiste scorciatoia: il segnale è distribuito su quasi ogni frase, quindi rimuoverlo richiede una riscrittura pesante, frase per frase, non un rimescolamento di paragrafi. Gli stessi autori del progetto lo scrivono senza infingimenti nel proprio README, ponendo una domanda che è quasi un autogol dichiarato: se il piano è comunque riscrivere il testo con un modello più economico, che senso ha aver pagato prima un modello premium? La riscrittura degrada tono, voce, precisione, e il risultato non può superare il livello del modello usato per riscrivere.

Il terzo livello ripulisce infine i metadati dei file, dalle proprietà nascoste di un DOCX ai chunk EXIF e XMP di un PNG, passando per PDF, SVG, ODT, HTML. Qui però la matrice di copertura pubblicata dal progetto stesso ammette due buchi precisi: la rimozione dei watermark incorporati nei pixel resta fuori portata, e il cosiddetto soft binding C2PA, quel legame che può ricollegare un file a un manifest remoto anche dopo aver ripulito i metadati locali, non viene toccato. Per la marcatura pixel di SynthID esiste solo uno strumento esterno, non incluso nel pacchetto, che ne misura la probabilità di presenza: la rileva, non la cancella.

Il limite che la letteratura conosce da prima

Lo screenshot che circola su LinkedIn parla di “segnali statistici SynthID” gestiti dallo strumento, ed è vero solo a metà: vale per la variante testuale dello schema, descritta da Dathathri e colleghi su Nature nel 2024, non per l’uso più noto di SynthID sulle immagini, dove restare invisibile al watermark resta un’altra storia. La stessa distanza tra rivendicazione social e comportamento reale del codice vale per la cornice temporale: la cronologia delle release, da v0.0.1 a v0.3.2, mostra un lavoro incrementale fatto di hardening della sicurezza, scritture atomiche sui file, limiti di risorse, pipeline CI con firma delle dipendenze. Non è il weekend hack che il post lascia intendere, ed è forse anche per questo che le stelle su GitHub, oggi che scrivo, hanno superato quota tremila: non un picco isolato, un interesse strutturale.

C’è poi un piano più teorico che il caso pratico rende visibile. Zhang e colleghi, in un lavoro presentato all’ICML del 2024, avevano già dimostrato che nessuno schema di watermarking robusto può resistere a un avversario sufficientemente motivato senza pagare un prezzo inaccettabile in termini di qualità del testo. Il costo che gli autori di watermarks-remover ammettono candidamente, quello della riscrittura che impoverisce la prosa, non è un dettaglio implementativo: è la conferma pratica di un risultato che la ricerca aveva già scritto sulla carta, prima ancora che qualcuno lo trasformasse in un tool con trecento fork.

Ne avevo scritto, da un’angolatura diversa, quando affrontavo il tema della realtà sintetica e di quanto sia diventato fragile il confine tra ciò che vediamo e ciò che è stato costruito: lì il problema riguardava le immagini e i deepfake, qui riguarda il testo, ma la domanda di fondo resta identica, chi decide cosa merita fiducia.

L’etica del progetto, dichiarata esplicitamente dagli stessi autori, parla di uso legittimo per la privacy e l’igiene dei propri contenuti, non di frode accademica né di false dichiarazioni di autorialità umana. È una precisazione onesta, ma resta scritta in un file di testo dentro un repository con licenza MIT, dove nessuno controlla davvero chi la legge prima di usare lo strumento. È esattamente qui, nello spazio tra l’intenzione dichiarata e l’uso reale, che la governance deve costruire le proprie fondamenta, non nel codice ma nelle norme, nelle abitudini professionali, nella cultura di chi tratta un contenuto generato come parte di una filiera che merita verifica, non come un dato acquisito.

La trasparenza non vincerà perché un singolo watermark resiste a ogni tentativo di rimozione, quella battaglia l’aveva già persa la ricerca prima ancora che iniziasse. Vincerà se costruiamo un ecosistema di segnali sovrapposti, testo e metadati e strumenti di verifica esterni come l’interfaccia di mediazione tra chi produce e chi legittima un contenuto, capace di alzare il costo della cancellazione anche quando la cancellazione resta tecnicamente possibile. È un lavoro di infrastruttura più che di crittografia, e su questo lavoro vale la pena investire.

Fonti: How Claude marks AI-generated content (Anthropic); watermarks-remover di Guillaume Meyer su GitHub.

Bolt: la guida completa al builder AI che gira dentro il tuo browser

Il 3 ottobre 2024 Eric Simons pubblica un tweet. Nessun budget di marketing, nessuna campagna, un link a un prodotto chiamato bolt.new costruito da una società che l’anno prima faceva ottantamila dollari di ricavi ricorrenti e stava per chiudere. Il primo giorno il prodotto aggiunge 60.000 dollari di ARR. Il secondo giorno altri 80.000, più di quanto StackBlitz avesse raccolto in sette anni di lavoro. In quattro settimane sono quattro milioni, a marzo 2025 quaranta.

Dentro quella storia c’è una lezione che riguarda poco l’AI e molto la pazienza industriale, e c’è la ragione tecnica per cui Bolt resta diverso dai suoi concorrenti. Questa è la terza e ultima guida della serie, dopo Lovable e Replit.

Sette anni di infrastruttura prima del successo improvviso

Simons e Albert Pai fondano StackBlitz nel 2017 per costruire un ambiente di sviluppo dentro il browser. Passano quattro anni su una tecnologia chiamata WebContainers: un kernel scritto in Rust, compilato in WebAssembly, che fa girare Node.js dentro la scheda del browser, senza server remoti. Funziona benissimo. Lo usano Google, Cloudflare, Uber per condividere ambienti di debug, e SvelteKit per i tutorial interattivi. I ricavi restano sotto il milione.

A febbraio 2024 i due prototipano l’idea di generare applicazioni con l’AI dentro quell’ambiente, e la mettono via perché i modelli disponibili non reggono. A giugno ottengono l’accesso anticipato a Claude 3.5 Sonnet di Anthropic, il primo modello capace di sostenere l’esperienza. Ci lavorano da luglio, pubblicano a ottobre. La crescita è tale da saturare temporaneamente la capacità di calcolo di Anthropic, e Dario Amodei la descrive come la più rapida mai vista in un cliente.

A gennaio 2025 StackBlitz raccoglie una Series B guidata da Emergence Capital e GV, con Greylock, Madrona e Conviction, per un totale di 135 milioni raccolti e una valutazione intorno ai 700 milioni. Simons ha definito il lancio un successo improvviso costruito in sette anni.

La cosa che mi interessa di questa vicenda è il rovescio di ciò che si racconta di solito sull’AI. Il modello ha reso possibile il prodotto, e il prodotto è stato possibile perché qualcuno aveva speso quattro anni su un problema che sembrava senza mercato.

Un computer intero dentro la scheda

Quando digiti un prompt su Bolt e premi invio, non parte una macchina virtuale su un cloud da qualche parte. Parte un ambiente Node.js dentro il tuo browser. L’agente scrive il codice, installa i pacchetti, esegue il server di sviluppo, e tu vedi l’anteprima girare mentre le modifiche arrivano. Il codice è editabile direttamente, con un editor derivato da VS Code, e questo rende Bolt il più tecnico dei tre strumenti della serie.

L’architettura ha una conseguenza economica che i concorrenti non hanno. Simons l’ha spiegata a Sacra: quando l’utente lancia un progetto, l’ambiente costa zero all’azienda, perché gira sul computer dell’utente. Bolt dichiara margini lordi intorno al settanta per cento, vicini a quelli di un SaaS tradizionale, ed è profittevole, mentre gli altri accendono container su infrastrutture a noleggio per ogni sessione. In un mercato dove tutti bruciano capitale sull’inferenza, questa è una posizione diversa, e per chi valuta la durabilità di un fornitore conta più di una demo.

Intorno al nucleo l’azienda ha costruito il resto. Bolt Cloud, arrivato ad agosto 2025, aggiunge hosting, database, autenticazione e funzioni serverless. Da allora ogni progetto include database interni illimitati, creati quando servono, con gestione utenti, funzioni edge, storage dei file, e l’integrazione con Supabase resta disponibile per chi la preferisce. C’è l’integrazione con Stripe per incassare pagamenti dalle app costruite, ci sono i domini acquistabili dalla piattaforma, e le analitiche del sito pubblicato.

Bolt ha smesso di inseguire i curiosi

Dopo il lancio, centinaia di migliaia di utenti consumer arrivano a costruire progetti personali, e se ne vanno con la stessa velocità. Simons ha raccontato che quel segmento aveva tassi di abbandono altissimi e costi di uscita prossimi allo zero, quindi l’azienda ha girato il timone verso i team di prodotto e ingegneria dentro le aziende, dove la retention somiglia a quella di un SaaS classico.

Oggi l’enterprise vale circa un quarto dei ricavi, il B2B nel suo complesso sta superando la metà, e Bolt dichiara che il 75 per cento delle Fortune 500 usa la piattaforma. A maggio 2026 è arrivata la partnership con Microsoft Azure e Microsoft 365, che aggiunge il Marketplace Microsoft ai canali di acquisto accanto a quello AWS, il deployment nativo su Azure, e l’integrazione con Teams e Microsoft 365 Copilot.

Questa traiettoria dice qualcosa a chi decide gli acquisti. Uno strumento che nasce per i curiosi e si sposta verso l’impresa smette di ottimizzare per la meraviglia dei primi quindici minuti e comincia a ottimizzare per il rinnovo del contratto, che è il momento in cui la sicurezza e la governance diventano argomenti di vendita invece che note a piè di pagina.

Sono i file a consumare i token

Il piano gratuito dà un milione di token al mese, con un tetto di trecentomila al giorno, progetti pubblici e privati, hosting con il marchio Bolt in vista, e un limite di dieci megabyte sui file caricati. Il piano Pro parte da 25 dollari al mese per dieci milioni di token, toglie il tetto giornaliero, il marchio, e aggiunge dominio personalizzato e condivisione privata. Il piano Teams costa 30 dollari per membro, con fatturazione centralizzata e controlli di accesso. Enterprise va a preventivo. Dal luglio 2025 i token non consumati si riportano al mese successivo, per un massimo di due mesi, e servono un abbonamento attivo per essere usati.

La particolarità sta in cosa mangia i token. Bolt sincronizza l’intero albero dei file del progetto con il modello a ogni messaggio, quindi il consumo non dipende dalla lunghezza della tua domanda, ma dalla dimensione di quello che hai costruito fino a quel momento. Una landing page da cinque file costa poco per prompt. Un’applicazione da cinquanta file costa molto, e continua a costare di più mano a mano che cresce. Gli utenti che spingono un progetto oltre una certa complessità riferiscono singoli prompt da un milione di token, cioè l’intero piano gratuito mensile in una richiesta.

L’effetto pratico è che i primi giorni sembrano economici e gli ultimi sembrano una rapina, quando invece il prezzo unitario non è mai cambiato. Chi lavora bene con Bolt tiene i progetti modulari, usa le modalità di discussione e pianificazione per ragionare senza generare, e parte dai template. I prezzi si verificano su bolt.new/pricing prima di ogni decisione.

La sandbox protegge finché il codice non esce

La sicurezza di Bolt va guardata in due tempi, perché la piattaforma e le applicazioni che produce hanno posture opposte.

Durante la costruzione l’isolamento è buono, forse il migliore della categoria. Il WebContainer è una sandbox del browser, il codice generato non ha un filesystem vero, non ha rete privilegiata, e qualunque server tu avvii è raggiungibile soltanto dalla tua scheda. Finché resti lì dentro, il danno che puoi fare a te stesso è limitato.

Il problema comincia quando quel codice esce. Il deploy va su un host reale, l’app si collega a un progetto Supabase reale, a chiavi Stripe reali, a utenti reali, e a quel punto ogni scelta predefinita che l’agente ha preso durante il prototipo diventa una superficie di attacco. Le forme ricorrenti sono sempre le stesse: tabelle pubblicate senza Row Level Security attiva, quindi leggibili da chiunque possieda la chiave anonima che sta nel bundle JavaScript, chiavi API scritte dentro il codice del frontend e trovate dagli scanner automatici nelle prime ore dopo la pubblicazione, endpoint generati per fare operazioni sui dati senza un controllo su chi possiede quel dato, funzioni serverless senza limiti di frequenza sulle chiamate.

Bolt genera frontend, backend, schema del database e collante tra i servizi nella stessa sessione, e ogni strato è un posto dove un controllo di sicurezza viene saltato perché nessuno lo aveva chiesto nel prompt. Questo lo rende più esposto di uno strumento che genera solo interfacce, come v0. Scansioni indipendenti su oltre mille applicazioni costruite con questi strumenti hanno trovato problemi nella quasi totalità dei casi, con una quota rilevante di falle critiche, e i campioni includevano Bolt insieme a Lovable, Replit e v0, come documenta lo studio di Security Boulevard.

C’è un rischio più recente che vale la pena conoscere. I modelli suggeriscono a volte pacchetti npm che non esistono, e gli attaccanti registrano in anticipo quei nomi con dentro codice malevolo, aspettando che qualcuno installi la dipendenza allucinata. Un controllo delle dipendenze dopo ogni aggiunta smette di essere pignoleria.

Le regole per chi porta la responsabilità in azienda sono poche. Ogni file generato va trattato come se fosse pubblico. Ogni chiave passata dalla piattaforma va considerata compromessa e ruotata. La Row Level Security va attivata e verificata a mano, senza chiedere conferma all’AI che ha scritto il codice, perché il modello vede il file che gli mostri, non il controllo che hai dimenticato altrove. E la verifica va fatta sull’applicazione pubblicata, non sull’anteprima nella sandbox.

Il vecchio agente ha una data di spegnimento

Ad aprile 2026 Bolt ha ritirato il suo agente storico. Dal 13 aprile non è più selezionabile per i nuovi progetti, e dal 3 agosto 2026 i progetti costruiti con la vecchia versione, e i siti che ne derivano, smetteranno di essere accessibili: vengono commutati automaticamente su Claude Agent, che nel frattempo è diventato il motore predefinito della piattaforma. Chi passa a mano perde la cronologia della chat, mentre file e codice restano.

Il modello predefinito oggi è Claude Sonnet 4.6, con Haiku 4.5 per le modifiche rapide e Opus 4.6 per il ragionamento complesso. Si può guidare il contesto del progetto con un file claude.md, la stessa convenzione che chi lavora con Claude Code conosce bene.

Vale la pena fermarsi su questa scadenza, perché è il tipo di evento che nessuna demo racconta. Un fornitore giovane può decidere che una parte della tua storia di lavoro non è più supportata, fissare una data, e migrarti d’ufficio. Il codice resta tuo, ed è la ragione per cui la portabilità va verificata prima di costruirci sopra, non dopo aver ricevuto la mail.

Dove si colloca rispetto a Lovable e Replit

Bolt è lo strumento più vicino allo sviluppatore dei tre. Ti lascia le mani nel codice, supporta più framework, gira interamente nel browser, e il suo modello di costo premia i progetti piccoli e modulari. Lovable arriva prima a un’applicazione web presentabile ed è la più amichevole con chi non scrive codice. Replit è l’ambiente più completo, con terminale, database gestito, deployment sofisticati e app mobili native, ed è la risposta quando il progetto deve girare in produzione da qualche parte.

Chi sceglie Bolt di solito è una persona che sa cosa sta guardando quando apre un file, e vuole che l’AI faccia la parte noiosa. Chi sceglie gli altri due sta comprando qualcosa che assomiglia di più a un servizio completo. Le tre guide stanno insieme nella sezione AI e GenAI.

Il primo progetto

Si parte dal piano gratuito, senza carta di credito, con un milione di token che bastano per capire il meccanismo e costruire qualcosa di piccolo. La prima cosa da fare è restare in modalità discussione o pianificazione finché l’impianto non è chiaro, perché ogni giro di generazione su un progetto già grande costa più del precedente.

Poi si costruisce, tenendo i moduli separati e i file corti, che qui è una scelta economica prima che architetturale. Quando servono dati e autenticazione si usa il database integrato oppure Supabase, e si attiva la Row Level Security prima di mettere qualunque cosa online. Prima di pubblicare si cerca nel bundle compilato ogni traccia di chiavi segrete, si sposta il codice che chiama servizi a pagamento dentro una funzione lato server, e si prova l’applicazione pubblicata come se fosse di qualcun altro.

Dove regge, dove rallenta

Bolt è eccellente per portare in mezz’ora un’idea allo stato di prototipo funzionante, dentro una scheda del browser, senza installare niente. Landing page, strumenti interni, MVP, applicazioni che devono esistere in fretta per essere mostrate a qualcuno: su questo terreno è veloce come pochi, e la portabilità del codice ti lascia una via d’uscita. Dove rallenta è dove rallentano tutti, con l’aggravante del suo modello di costo: quando il progetto cresce, ogni prompt costa di più e l’agente perde il filo del contesto, e la tentazione di continuare a chiedere invece di mettere le mani nel codice diventa la voce più cara della fattura.

Per chi guida la tecnologia in azienda, Bolt è un caso di studio su due livelli. Sul primo è uno strumento che accorcia il ciclo dall’idea al prototipo mantenendo il codice leggibile e trasportabile, e questa è una virtù rara. Sul secondo è la dimostrazione che un’architettura scelta bene sette anni prima decide chi resta in piedi quando il costo dell’inferenza schiaccia i margini di tutti. Il mestiere di chi sa leggere il codice non scompare, si sposta verso la revisione, la sicurezza, e la scelta di quale fornitore meriti la propria dipendenza.

Senza dubbio tra un anno questi strumenti saranno più capaci e i loro margini più chiari. La domanda che resta aperta riguarda la data del 3 agosto: quando un fornitore decide che una parte del tuo lavoro non esiste più, quanto del tuo lavoro sei ancora in grado di portare via?


Riferimenti.

Ufficiali: sito Bolt, piani e prezzi, note di rilascio con il calendario del ritiro del vecchio agente.

Azienda e crescita: la scheda di Contrary Research su Bolt; l’intervista di Sacra a Eric Simons su margini, WebContainers e virata verso il B2B; la scheda Sacra su Bolt.new per finanziamenti e migrazione dell’agente.

La storia del lancio, raccontata da Simons: la puntata di Lenny’s Newsletter.

Sicurezza della categoria: studio Security Boulevard sulle vulnerabilità nelle app vibe coded.

Claude Code orchestra i suoi agenti: dynamic workflows e la riscrittura di Bun

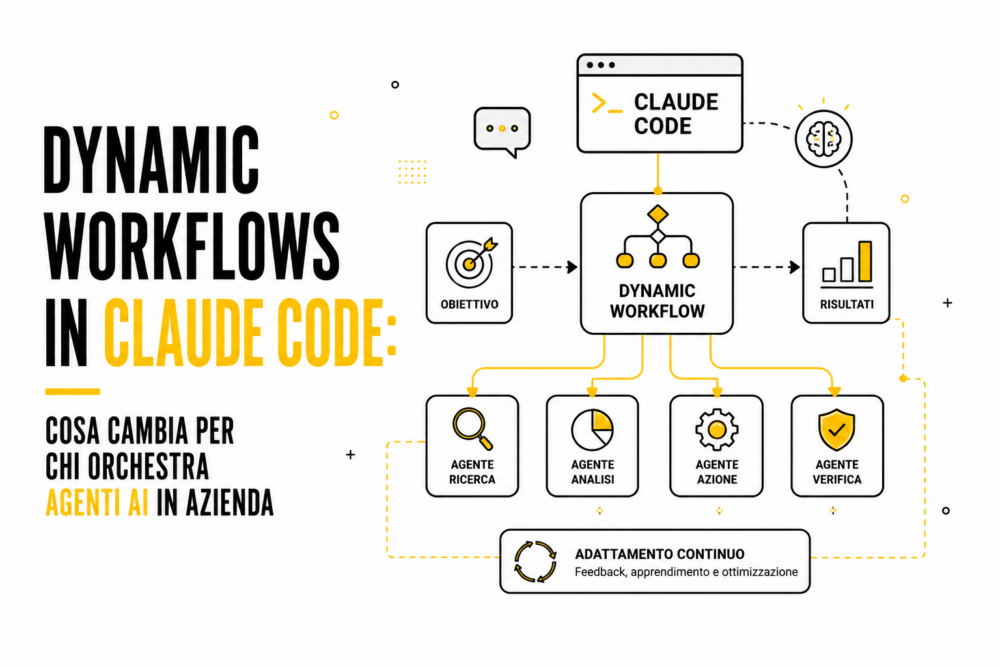
Il 28 maggio 2026 Anthropic ha aperto in research preview i dynamic workflows dentro Claude Code, disponibili su CLI, app desktop, estensione VS Code e via API su Bedrock, Vertex AI e Microsoft Foundry. La meccanica, descritta nel comunicato, è che Claude scrive al volo uno script di orchestrazione e lo esegue lanciando da decine a centinaia di subagent in parallelo nella stessa sessione, verificando il proprio lavoro prima che qualcosa arrivi a te. Per chi guida un’azienda che sta valutando dove mettere l’AI nel proprio stack, la notizia non è il numero di agenti, è cosa cambia nel modo in cui un problema grande viene scomposto e chiuso.

Ci ho ragionato per qualche giorno prima di scriverne, perché la prima reazione, leggendo “centinaia di agenti in parallelo”, è di archiviarlo come l’ennesima demo da keynote. Poi ho guardato il caso che Anthropic mette in cima al post, e il caso è meno comodo di quanto sembri.

Il salto rispetto al singolo agente

Fino a ieri il modello mentale era lineare: un agente legge il contesto, ragiona, agisce, controlla, e quando il compito è troppo grande lo spezzi tu, a mano, in pezzi che la finestra di contesto riesce a tenere. Funziona finché il piano sta in tre o quattro passaggi. Smette di funzionare quando il lavoro tocca migliaia di file, o quando lo stesso problema va affrontato da angoli indipendenti per essere affidabile.

Un dynamic workflow ribalta l’ordine. Claude parte dalla richiesta in linguaggio naturale, pianifica il lavoro e lo scompone in sottocompiti, distribuendoli su subagent che girano in parallelo. I risultati vengono controllati prima di essere ricomposti. Agenti diversi attaccano il problema da prospettive indipendenti, altri agenti provano a smontare quello che i primi hanno trovato, e il ciclo itera finché le risposte convergono. La coordinazione avviene fuori dalla conversazione, in uno script che gira in background, e questo è il dettaglio architetturale che conta: il piano resta in piedi a prescindere da quanto cresce il compito, e un lavoro interrotto riprende da dove si era fermato invece di ripartire da zero.

Pasquale Pillitteri, in una delle prime analisi tecniche italiane, l’ha sintetizzato bene: nessun modello nuovo, nessun plugin, soltanto uno scarto architetturale sottile per cui Claude scrive uno script di orchestrazione in JavaScript a partire dalla richiesta, mentre un runtime separato lo esegue in background.

Bun, ovvero il caso scomodo

L’esempio che Anthropic porta come prova è la riscrittura di Bun, il runtime JavaScript alternativo a Node. Jarred Sumner ha usato i dynamic workflows per portare Bun da Zig a Rust: circa 750.000 righe di Rust, il 99,8% della test suite esistente che passa, undici giorni dal primo commit al merge. Un workflow ha mappato il lifetime Rust corretto per ogni campo di ogni struct nel codice Zig. Quello successivo ha riscritto ogni file .rs come port a comportamento identico del corrispettivo .zig, con centinaia di agenti in parallelo e due reviewer su ciascun file. Un fix loop ha poi guidato build e test fino a farli girare puliti. Dopo il merge, un workflow notturno ha aperto una pull request per ogni copia di dati superflua, lasciando la revisione finale a un umano.

Numeri da capogiro. Solo che la storia ha un’altra metà che il comunicato non racconta, e che vale la pena conoscere prima di firmare un budget su questa promessa.

Quando il branch è apparso a fine aprile, la community degli sviluppatori è esplosa: oltre 700 voti e 500 commenti su Hacker News in poche ore. Sumner stesso, il 5 maggio, scriveva su quel thread che era tutto un’esagerazione, che non c’era nessun impegno a riscrivere, e che c’era un’alta probabilità che il codice venisse buttato via del tutto. Non è andata così, il merge è arrivato il 14 maggio. Però le critiche tecniche restano sul tavolo: alcuni vecchi test sarebbero stati modificati perché la versione Rust li superasse, e l’uso della keyword unsafe da parte di Claude rende meno solida la promessa di sicurezza sulla memoria che il passaggio a Rust dovrebbe garantire. heise riporta che le issue su GitHub hanno iniziato ad accumulare i primi problemi che con la versione Zig non si presentavano.

Tengo insieme le due cose di proposito. Il workflow ha prodotto in undici giorni un risultato che a mano avrebbe richiesto trimestri, ed è una capacità reale. E allo stesso tempo il “99,8% dei test passa” significa qualcosa di diverso se una parte di quei test è stata adattata, e “non ancora in produzione” è una postilla che pesa. Chi valuta questa tecnologia per la propria azienda deve guardare entrambe le metà.

Piani che diventano codice

La regola operativa che emerge dalla documentazione e dall’uso reale è semplice. Se il piano sta in due o tre passaggi che Claude tiene in testa, restano migliori i subagent o le skill. Quando il piano diventa codice, ripetibile, scalabile a centinaia di operazioni indipendenti, allora ha senso un workflow.

I casi d’uso che Anthropic e i suoi clienti early access citano cadono tutti dentro questa logica. Bug hunt su un intero servizio, con verifica indipendente su ogni finding così che il report contenga problemi veri e non rumore. Audit di sicurezza e di ottimizzazione guidati dal profiler. Migrazioni e modernizzazioni che toccano migliaia di file, swap di framework, deprecazioni di API, port da un linguaggio all’altro. E il lavoro critico che vuoi controllato due volte, dove il costo di una risposta sbagliata è alto e quindi metti agenti avversari a provare a rompere il risultato prima che tu lo veda.

Alessio Vallero di Klarna, citato nel comunicato, racconta di aver avuto risultati forti nell’identificare codice morto e opportunità di pulizia che l’analisi statica tradizionale non vedeva. Ken Takao di CyberAgent dice che i workflow riempiono lo spazio tra il lanciare un singolo subagent e il costruire un team di agenti completo, e che il passaggio dal piano all’implementazione scorre senza perdere visibilità. Sono testimonianze di parte, fa parte del gioco di un lancio, ma descrivono un perimetro d’uso coerente: discovery e review su codebase grandi e legacy.

Il conto da tenere d’occhio

Qui arriva l’avvertenza che Anthropic, in modo per certi versi inusuale, mette nero su bianco fin dal lancio. Un dynamic workflow consuma molti più token di una sessione tipica di Claude Code. La raccomandazione esplicita è di partire da un compito circoscritto per farsi un’idea del consumo, prima di lanciarsi su lavori grandi. La prima volta che un workflow si attiva, Claude Code mostra cosa sta per girare e chiede conferma. Gli amministratori di un’organizzazione possono disabilitarlo dalle impostazioni gestite, e sui piani Enterprise è spento di default al lancio.

C’è anche un tetto: i workflow sono limitati a 1.000 subagent. Per attivarli, due strade: chiedere a Claude di creare un workflow, oppure accendere ultracode, l’impostazione specifica di Claude Code che porta l’effort a xhigh e lascia decidere a Claude quando usare un workflow.

Per un CIO italiano la traduzione è questa. La capacità tecnica è notevole e va provata, su un perimetro ristretto e misurabile, con un occhio fisso sul consumo. Il governo della spesa diventa parte integrante della governance dell’AI, non un dettaglio amministrativo, perché uno strumento che lancia centinaia di agenti autonomi su una codebase è potente esattamente quanto è capace di bruciare budget se lasciato senza confini. È la stessa logica di cui scrivo da tempo quando parlo di vendor lock-in nei progetti AI enterprise: la potenza di uno strumento non è mai gratis, e il costo nascosto si paga dopo.

La pianificazione delegata, la verifica no

L’orchestrazione di agenti che si controllano a vicenda è un cambio di postura rispetto a tutto ciò che abbiamo usato finora. Una macchina che genera ipotesi, ne mette altre a confutarle, e consegna solo quello che sopravvive al confronto, assomiglia più a un metodo di lavoro che a un autocomplete sofisticato. In Pelle Digitale ho provato a descrivere la frontiera tra la persona e la macchina come una superficie di mediazione, e questo è un punto preciso lungo quella superficie: il momento in cui smettiamo di guidare l’AI passo per passo e iniziamo a delegarle la pianificazione, tenendo per noi la verifica finale e la responsabilità.

Resta da capire quanto regge fuori dalle demo. Il caso Bun mostra cosa è possibile e, insieme, cosa va verificato a mano dopo. Per le aziende medie italiane, quelle che seguo da vicino nel mio lavoro di advisory, la domanda non è se questa tecnologia funziona, perché in parte funziona già. La domanda è dove conviene puntarla, con quale budget, e con quale presidio umano sul risultato finale.

Senza dubbio è uno degli annunci più densi degli ultimi mesi per chi costruisce software. Quanto di questa capacità arriverà davvero nelle mani di chi sviluppa codice ogni giorno in un’azienda normale dipenderà da chi saprà portarla dentro un perimetro misurabile, con un presidio umano sul risultato. Sono quelle le organizzazioni che ne ricaveranno un vantaggio concreto, mentre le altre resteranno a guardare i casi estremi da comunicato.


Fonte: Anthropic, Introducing dynamic workflows in Claude Code, 28 maggio 2026.

Guidare Claude Code: la guida completa a skill, hook, subagent e regole

Il 18 giugno 2026 Anthropic ha pubblicato una mappa di tutti i modi in cui si può dire a Claude Code come comportarsi. Sono sette, e la cosa interessante non è l’elenco, è che ognuno di quei sette modi risponde a tre domande diverse: quando l’istruzione entra in memoria, se ci resta quando la sessione si allunga, e quanto è vincolante. Lavoro con questi agenti tutti i giorni, e ho imparato che la maggior parte degli errori di configurazione nasce dall’aver messo l’istruzione giusta nel posto sbagliato.

Per chi scrive codice da solo è una questione di efficienza. Per chi porta la responsabilità della tecnologia in un’azienda diventa qualcosa di più, perché la distanza tra un’istruzione e una garanzia è la stessa che separa una buona intenzione da una regola che nessuno può aggirare. Questa guida prova a mettere ordine: cosa sono i sette meccanismi, come si comportano quando la sessione cresce, e dove conviene scrivere ogni tipo di istruzione.

Ogni istruzione ha un costo e un’autorità

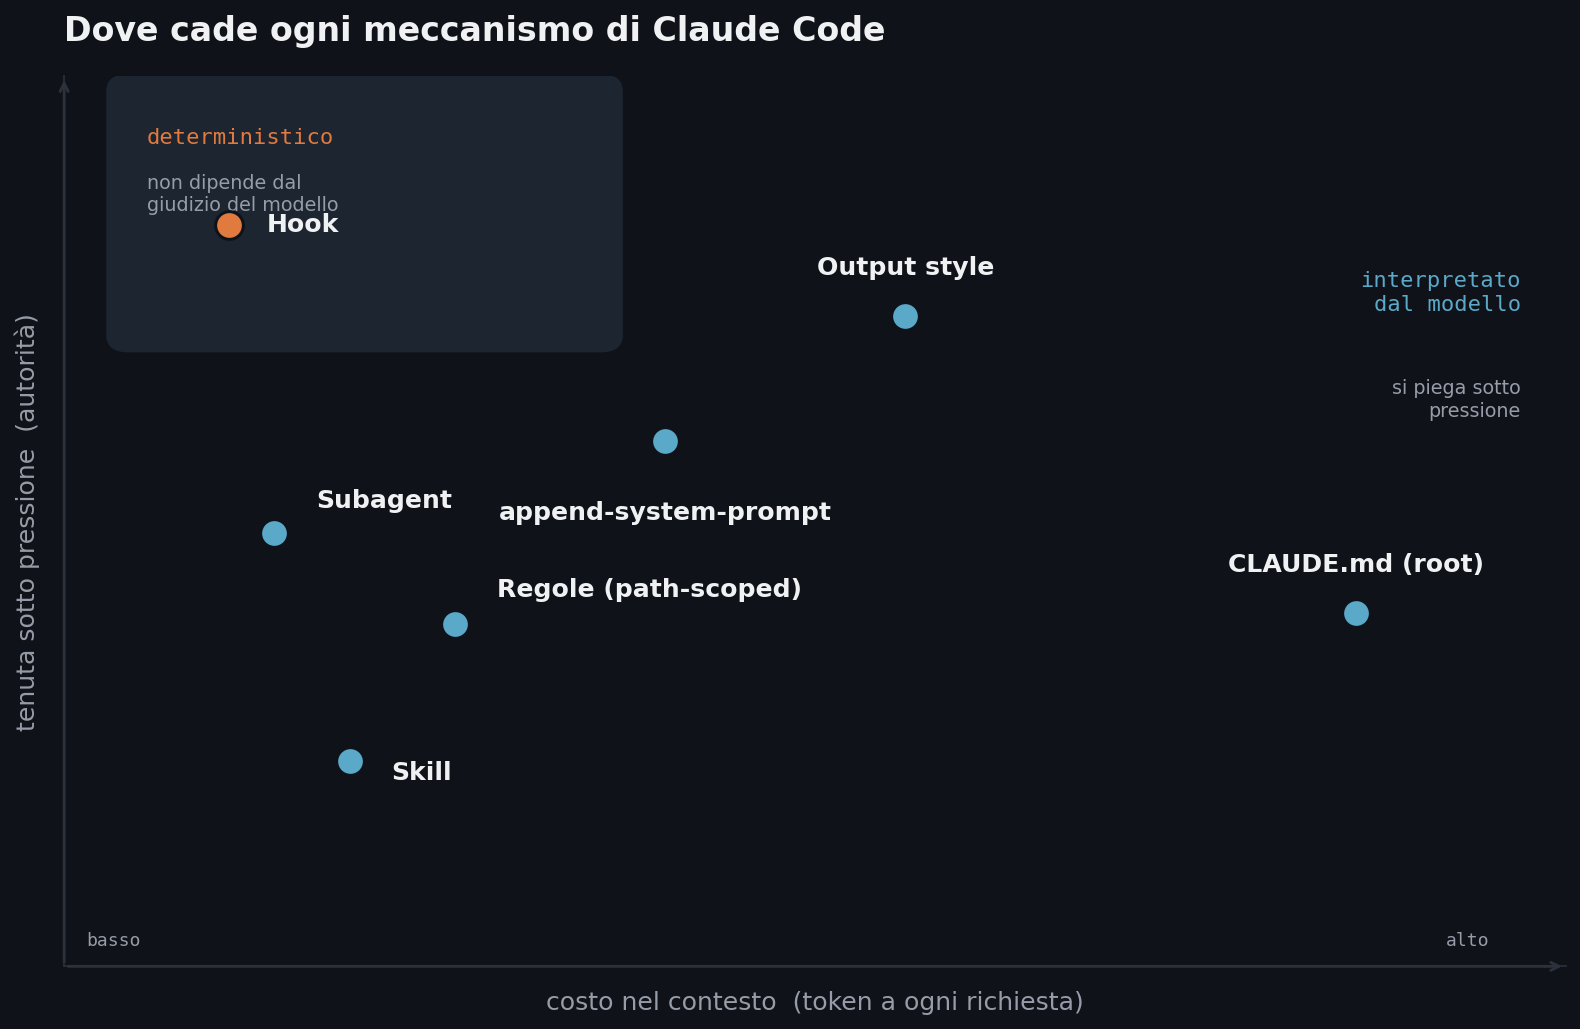
Ogni riga che finisce nella finestra di contesto di Claude occupa spazio e influenza il comportamento, e questi due effetti vanno tenuti insieme. Lo spazio è il costo: token che paghi a ogni richiesta, che l’istruzione serva o no in quel momento. L’autorità è il peso: quanto Claude segue quell’istruzione quando le cose si complicano, in una sessione lunga, in una situazione ambigua, o quando un file letto durante il lavoro contiene istruzioni nascoste che spingono in direzione opposta.

I sette meccanismi si distribuiscono lungo questi due assi. Alcuni costano molto e valgono sempre, altri costano poco perché entrano in scena solo quando servono, altri ancora non vivono affatto nel contesto perché sono codice che gira per conto suo. Sapere dove cade ciascuno è metà del lavoro. L’altra metà è una sola domanda, che torna a ogni scelta: questa cosa deve succedere quando il modello decide di farla, o deve succedere e basta?

CLAUDE.md, il file che Claude rilegge a ogni avvio

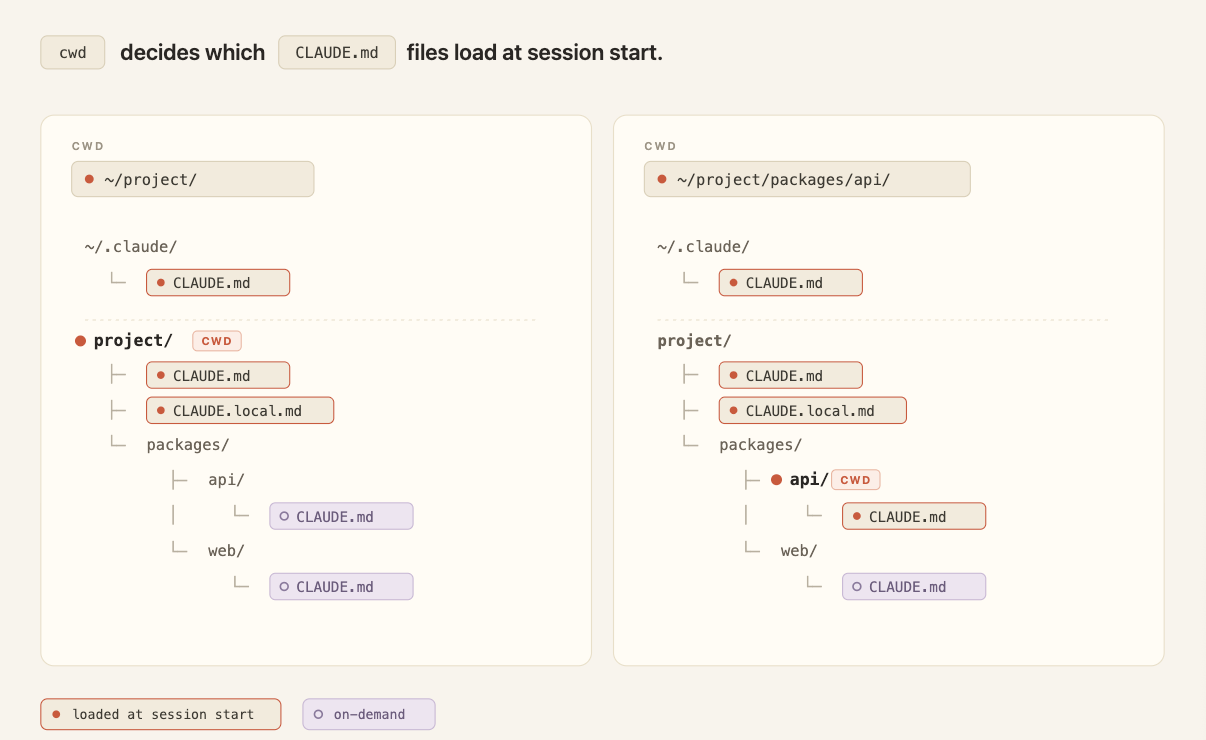
Il CLAUDE.md è un file markdown nella radice del progetto. Si carica all’inizio della sessione e ci resta per tutta la durata. Comandi di build, struttura delle cartelle, organizzazione di un monorepo, convenzioni di codice, norme del team: tutto questo sta bene qui, perché sono fatti che Claude deve avere sempre sottomano.

Ne esistono due tipi, e si comportano in modo opposto. Quello nella radice è sempre presente, sopravvive alle sessioni lunghe, e quando Claude Code comprime la conversazione per liberare spazio lo rilegge da capo. Quelli nelle sottocartelle invece si caricano su richiesta, solo quando Claude legge un file dentro quella cartella. Un app/api/CLAUDE.md non entra all’avvio, entra quando si tocca qualcosa sotto app/api, e sparisce di nuovo finché non si torna lì.

Il problema del file nella radice arriva con la scala. In un repository condiviso cresce come ogni configurazione senza padrone: ogni team aggiunge le sue righe, nessuno cancella niente, e quel testo si carica in ogni sessione di ogni persona, che riguardi il suo lavoro o no. Si pagano token, e si diluisce l’aderenza alle istruzioni che contano.

Il consiglio di Anthropic è di tenerlo sotto le duecento righe, dargli un proprietario, e trattarne le modifiche come si tratta il codice, con una revisione. Pensa a questo file come a un indice: una mappa del progetto che rimanda ad altri file dove Claude trova il dettaglio quando gli serve. Per le regole che devono valere su ogni repository dell’organizzazione, politiche di sicurezza o requisiti di conformità, esiste un CLAUDE.md gestito centralmente, distribuito sulle macchine via MDM, che il singolo non può escludere.

Le regole si caricano solo dove servono

Le regole sono file markdown dentro .claude/rules/, e danno a Claude vincoli o convenzioni precise. Senza un raggio d’azione si comportano come il CLAUDE.md: caricate all’avvio, rimesse dentro dopo ogni compressione, sempre presenti anche quando il compito non le riguarda.

Con il campo paths nell’intestazione cambia il momento del caricamento. Una regola legata a src/api/** resta fuori dal contesto durante una sessione che tocca solo la documentazione, e si carica unicamente quando Claude legge un file dentro quella cartella. L’intestazione si scrive così:

---
paths:
  - "src/api/**"
  - "**/*.handler.ts"
---
Ogni handler API deve validare l'input con Zod prima di processarlo.

Un vincolo legato a un file specifico, tipo le migrazioni che si possono solo aggiungere e mai modificare, sta bene come regola con il suo paths. Conviene preferire una regola con raggio d’azione a un CLAUDE.md annidato quando l’istruzione riguarda un aspetto trasversale, o un tipo di file che compare in più punti del codice ma non ovunque.

Le skill portano dentro la procedura al momento giusto

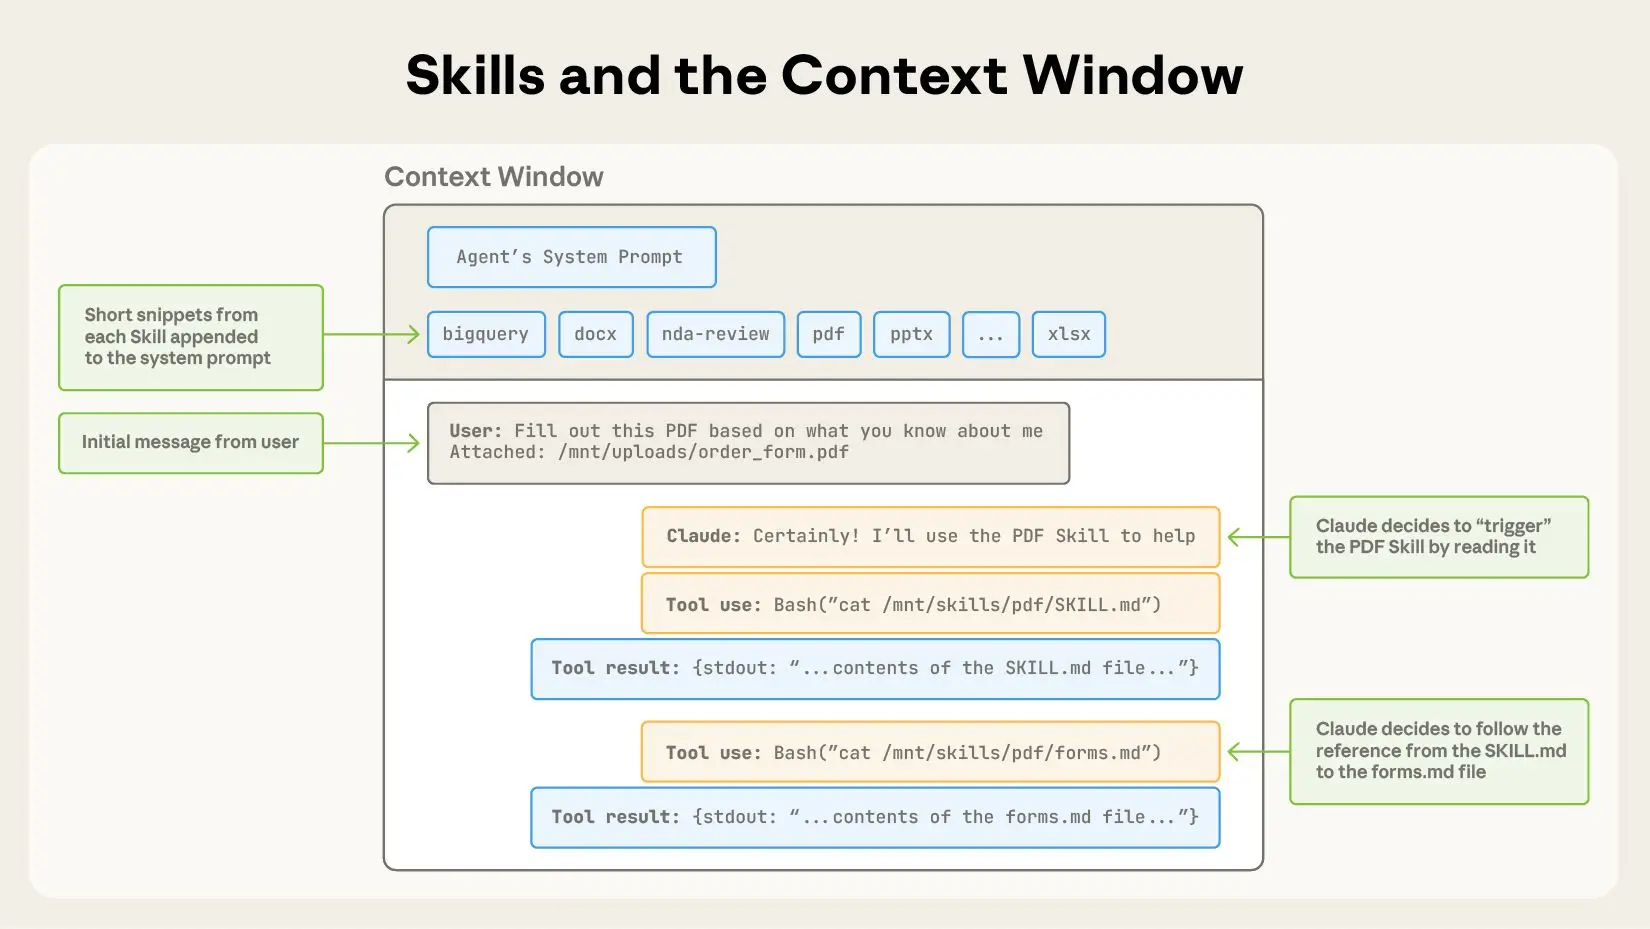
Le skill vivono in .claude/skills/, cartelle che contengono istruzioni, script e risorse, ognuna con un file SKILL.md fatto di nome, descrizione e corpo. All’avvio della sessione si caricano solo il nome e la descrizione. Il corpo entra quando la skill viene invocata, con un comando slash come /code-review oppure perché Claude riconosce che il compito corrisponde a quella descrizione.

/code-review è una skill già inclusa: legge le modifiche correnti e riporta cosa ha trovato senza toccare i file. La skill definisce il copione, e Claude segue lo stesso percorso ogni volta che la richiami. Quando la conversazione viene compressa, le skill già invocate vengono rimesse dentro fino a un tetto di token condiviso tra tutte: se ne hai usate molte nella stessa sessione, le più vecchie cadono per prime.

La regola pratica è corta. Le istruzioni procedurali, un flusso di deploy o una checklist di rilascio, stanno in una skill, non nel CLAUDE.md. Claude Code arriva con le sue skill, ma puoi scriverne di tue, ed è proprio quello che faccio per il lavoro editoriale e di consulenza, impacchettando in una cartella le procedure che ripeto.

Un agente separato per il lavoro che non vuoi leggere

I subagent sono file markdown in .claude/agents/, e definiscono assistenti isolati per compiti laterali. Ogni file ha un’intestazione YAML, nome e descrizione più eventuali campi per il modello e per gli strumenti a cui può accedere, seguita da un corpo che diventa il prompt di sistema di quel subagent.

Somigliano alle skill, perché all’avvio si caricano nome, descrizione ed elenco degli strumenti, mentre il corpo non si attiva da solo: Claude lo chiama tramite lo strumento Agent passandogli un prompt. La differenza vera è l’isolamento. Il corpo del subagent non entra mai nella conversazione principale. Il subagent gira in una finestra di contesto tutta sua, e al termine torna alla sessione madre solo il suo messaggio finale, spesso il risultato aggregato di molti passaggi, più qualche metadato.

Questo schema scala in un modo che vale la pena capire. I subagent si annidano fino a cinque livelli, e i flussi di lavoro dinamici orchestrano da decine a centinaia di agenti in background senza che tu debba specificare ogni dettaglio. Il piano di orchestrazione e i risultati intermedi vivono dentro variabili di script invece che nel contesto di Claude, e questo permette di crescere senza perdere fedeltà alle istruzioni.

L’isolamento è il motivo principale per scegliere un subagent invece di una skill. Lo usi quando un compito laterale, una ricerca profonda o l’analisi di un log ingombrerebbe la conversazione principale con risultati intermedi che non riguarderai più. Usi una skill quando vuoi che la procedura si svolga dentro il thread principale, sotto i tuoi occhi, un passaggio alla volta. La documentazione sui subagent entra nel dettaglio dei campi dell’intestazione e dei permessi sugli strumenti.

Gli hook girano fuori dal contesto

Gli hook sono comandi, endpoint HTTP o prompt che danno un controllo più deterministico sul comportamento di Claude, perché scattano su eventi precisi del suo ciclo di vita: una modifica a un file, una chiamata a uno strumento, l’avvio della sessione. Si registrano nel settings.json, nelle impostazioni gestite, o nell’intestazione di una skill o di un agente.

Ne esistono di cinque tipi: command, HTTP, mcp_tool, prompt e agent. Tutti scattano in modo deterministico, ma i primi tre eseguono codice, mentre prompt e agent usano il giudizio di Claude invece di una regola fissa per decidere l’output. Il costo in contesto è basso, perché la configurazione vive fuori dalla finestra principale. Qualche output può rientrare: l’errore di un hook che blocca un’operazione viene salvato nel contesto, così Claude sa perché la chiamata è stata negata. La maggior parte degli hook invece non lascia traccia, a meno che la configurazione non lo preveda. Se hai salvato la cronologia della chat in un altro file prima della compressione usando l’evento PreCompact, Claude non saprà in quale file l’hai messa.

È qui che gli hook si staccano dal CLAUDE.md, dalle regole e dalle skill. Servono per tutto ciò che deve accadere in modo deterministico: far girare un linter dopo ogni modifica, scrivere su Slack a lavoro finito, bloccare certi comandi prima che partano. Un hook PreToolUse può ispezionare qualunque chiamata a uno strumento e uscire con codice 2 per negarla. Costano poco perché sono codice che l’ambiente esegue, non istruzioni che Claude deve caricare e interpretare.

Output style e system prompt: l’autorità più alta

Gli output style sono file in .claude/output-styles/ che iniettano istruzioni nel prompt di sistema. Non vengono mai compressi, si caricano all’inizio di ogni sessione, e dopo la prima richiesta restano in cache, quindi il costo in contesto è moderato. Stando nel prompt di sistema portano il peso di aderenza più alto tra tutti i metodi visti finora, e vanno usati con misura.

C’è una trappola. Cambiare l’output style sostituisce quello predefinito, a meno che tu non imposti keep-coding-instructions: true nell’intestazione. In Claude Code questo cancella le istruzioni che dicono a Claude di star aiutando con un lavoro di ingegneria del software, e con loro abitudini critiche come quando aggiungere o togliere commenti al codice, come gestire le questioni di sicurezza, l’abitudine a far girare i test prima di dichiarare finito un lavoro. Senza accorgertene, Claude Code diventa un assistente generico invece di un assistente che programma. Prima di scriverne uno tuo, conviene guardare quelli già inclusi: Proactive, Explanatory e Learning coprono i bisogni più comuni.

L’alternativa più leggera è il flag append-system-prompt. Dove modificare un output style può avere effetti larghi e non voluti, il flag è solo additivo: non cambia il ruolo di Claude, gli aggiunge istruzioni. Si passa al momento dell’invocazione e vale solo per quella, non resta come file tra le sessioni. Costa qualche token in più in ingresso, attenuato dalla cache dopo la prima richiesta, ed è la via giusta per standard di codice specifici, formati di output, conoscenza di dominio. Con un avvertimento che vale per tutti i metodi a prompt: più istruzioni infili, meno Claude le segue alla lettera, soprattutto se qualcuna contraddice le altre.

Quando l’istruzione è nel posto sbagliato

Ci sono segnali che dicono che un’istruzione andrebbe spostata altrove. Se ti ritrovi a scrivere “ogni volta che X, fai sempre Y” nel CLAUDE.md, e quel comportamento deve essere affidabile, tipo far girare prettier dopo ogni modifica, quello è un hook nel settings.json. Il modello che sceglie di lanciare un formattatore è un’altra cosa rispetto al formattatore che parte da solo.

Se nel CLAUDE.md compare un “non fare mai questo”, l’istruzione è lo strumento sbagliato. Claude la seguirà quasi sempre, ma sotto pressione, in una sessione lunga, in una situazione ambigua, o per via di un’iniezione di prompt dentro un file aperto durante il compito, il modello può non rispettarla. Una barriera vera è deterministica, e si costruisce con gli hook e i permessi. Un hook PreToolUse ispeziona la chiamata ed esce con codice 2 per bloccarla. Le impostazioni gestite vanno oltre: le distribuisce un amministratore, l’utente non le può sovrascrivere, e sono l’unico modo per imporre una barriera deterministica su tutta l’organizzazione.

Una procedura di trenta righe nel CLAUDE.md va in una skill. Una regola che vale solo per src/api/** va scritta con il suo paths, perché senza è meccanicamente identica a mettere quel testo nel CLAUDE.md, sempre caricata, sempre a consumare token. E le preferenze personali, tipo usare sempre messaggi di commit semantici, vanno nei file a livello utente, che valgono per ogni sessione a prescindere dal repository, non nel file di progetto condiviso con il team.

Un’istruzione non è una garanzia

Tutto questo si riduce a una distinzione che per chi guida la tecnologia conta più di qualunque dettaglio di configurazione. Un’istruzione a prompt, stia nel CLAUDE.md o in una regola o in un output style, è una richiesta che il modello interpreta e quasi sempre rispetta. Una barriera costruita con hook e permessi è un fatto meccanico che non dipende dal giudizio del modello. La prima si piega sotto pressione, la seconda no. Quando in gioco ci sono dati sensibili, ambienti di produzione, o un comando che non deve partire mai, l’unica risposta seria è quella deterministica.

C’è anche un costo che si accumula nel tempo, e somiglia parecchio a quello di cui scrivo da mesi a proposito del debito cognitivo. Un CLAUDE.md senza proprietario cresce, e ogni riga in più si carica in ogni sessione di ogni persona, pesando sul budget di token e annacquando le istruzioni che servono. È un debito di contesto: lo paghi poco alla volta, finché un giorno la finestra è piena di righe che nessuno legge e il modello segue peggio quelle importanti. La cura è la stessa di sempre, un proprietario, una revisione, e la disciplina di spostare ogni istruzione dove il suo costo e la sua autorità corrispondono al compito.

Nei vari testi che scrivo da un po’ ho provato più volte a descrivere l’interfaccia tra la mente e gli strumenti che la estendono, e guidare un agente è proprio quel punto: il momento in cui un’intenzione umana si traduce in qualcosa che una macchina eseguirà al posto tuo. Quando hai qualcuno di questi meccanismi a posto, puoi raccoglierli insieme, skill, subagent, hook e output style, dentro un plugin, e condividere un assetto coerente con il team o tra i progetti.

Senza dubbio nei prossimi mesi questi strumenti diventeranno più semplici e più capaci. La domanda che resta aperta è chi, nella tua organizzazione, possiede la mappa di cosa Claude può e non può fare, e la tiene aggiornata mentre la finestra di contesto si riempie. Se è il genere di mappa che serve disegnare per la tua azienda, è una delle conversazioni che porto al tavolo nel mio lavoro di advisory.


Fonte: Anthropic, Steering Claude Code: CLAUDE.md files, skills, hooks, rules, subagents and more, 18 giugno 2026. Approfondimenti nella documentazione ufficiale su subagent e output style.

Modelli di frontiera: la mappa di chi li costruisce, come sono fatti e quanto costano

Mai prima d’ora un governo aveva staccato la spina a uno dei modelli di frontiera già in mano al pubblico. È successo a giugno, con Fable 5 e Mythos 5 di Anthropic, spenti su ordine dell’amministrazione americana per ragioni di sicurezza nazionale. Sotto la cronaca c’è un fatto più grande di un singolo provider: alcuni di questi sistemi sono diventati abbastanza potenti da essere maneggiati come materiale strategico, al pari di un chip avanzato o di una tecnologia a duplice uso.

La parola gira ovunque, il suo significato molto meno, e per orientarsi conviene partire dall’origine del nome.

Una parola nata nei corridoi della policy

Il termine non viene dal marketing. Nasce a metà 2023, in un paper firmato da ricercatori legati al Future of Humanity Institute, che chiamavano “frontier AI” i modelli fondazionali tanto capaci da poter sviluppare abilità pericolose per la sicurezza pubblica. Da lì è entrato nel vocabolario dei governi, prima fra tutti quello britannico con la sua Frontier AI Taskforce e il summit sulla sicurezza dell’AI di fine 2023.

La definizione ha una caratteristica scomoda, si muove. Frontiera è qualunque cosa stia sul bordo più avanzato delle capacità in un dato momento, il che vuol dire che il modello di punta di oggi sarà il modello mediocre di dopodomani. Accanto a questa lettura mobile ne esiste una più rigida, usata dai regolatori, che fissa una soglia di calcolo: oltre i 10²⁶ FLOP impiegati per l’addestramento scattano obblighi di trasparenza e compliance. Due definizioni che convivono, una basata su cosa il modello sa fare, l’altra su quanta energia è servita a costruirlo.

Sotto il cofano c’è sempre un Transformer

Tolta la scenografia, l’impalcatura è la stessa per tutti. L’architettura di base si chiama Transformer ed è del 2017. Per dare la misura di quanto è cambiato il gioco: addestrare quel primo Transformer costò intorno ai 900 dollari. I modelli di cui parliamo oggi sono figli di quella stessa idea, cresciuta di parecchi ordini di grandezza.

Quasi tutti i modelli di frontiera adottano una variante chiamata mixture-of-experts. Invece di accendere l’intera rete per ogni parola che elaborano, la suddividono in molti moduli specializzati e ne attivano solo una frazione alla volta. È il trucco che permette di avere modelli enormi sulla carta e relativamente economici da far girare nella pratica.

Poi c’è il ciclo di costruzione, diviso in due tempi. Il pre-training è la fase cara, quella in cui il modello divora enormi quantità di testo e codice, immagini e suono, bruciando i milioni di dollari di calcolo. Il post-training viene dopo, costa molto meno, e serve a rendere il modello utile e allineato, insegnandogli a seguire le istruzioni e a comportarsi in modo prevedibile. Gran parte di ciò che percepiamo come “carattere” di un modello si decide in questa seconda fase.

La novità degli ultimi diciotto mesi sono i modelli che ragionano prima di rispondere, generando catene di pensiero interne prima di consegnare l’output. È la leva che ha spinto in alto i punteggi in matematica, programmazione e scienza. Insieme a questo conta la finestra di contesto, quanto materiale il modello riesce a tenere sotto gli occhi in una volta sola. La linea di frontiera si è assestata intorno al milione di token, con qualche eccezione che spinge molto oltre: una startup di Miami ne ha annunciato uno da dodici milioni, e tra i modelli scaricabili Llama 4 Scout arriva a dieci.

Quattro nomi in testa e due spenti dal governo

A metà 2026 il gruppo di testa dei modelli di frontiera è abbastanza leggibile, anche se cambia di mano in continuazione. Claude Opus 4.8, uscito il 28 maggio, guida l’indice di intelligenza di Artificial Analysis. Intorno gli stanno GPT-5.5 di OpenAI, Gemini 3.1 Pro di Google e Grok 4.3 di xAI. Nessuno vince su tutto: chi domina la programmazione arranca sulla scrittura creativa, chi guida sul ragionamento puro costa la metà di un concorrente. La domanda utile non è quale sia il migliore in assoluto, ma quale sia il migliore per un certo lavoro.

Poi c’è la storia di Mythos. Anthropic lo presenta ad aprile come un modello capace di trovare da solo le falle di sicurezza in codice considerato inattaccabile, una capacità giudicata troppo pericolosa per un rilascio aperto. Invece di metterlo in vendita, l’azienda lo affida a un consorzio ristretto, Project Glasswing, una cinquantina di organizzazioni all’inizio, circa centocinquanta a inizio giugno, tra cui Google, Nvidia, Microsoft e Apple. Il 9 giugno arriva la versione commerciale, Fable 5, lo stesso modello con dei filtri che bloccano le richieste nelle aree ad alto rischio come cyber e biologia, dirottandole su Opus 4.8 in meno del cinque per cento delle sessioni. Tre giorni dopo il governo stacca tutto, e il telecom coreano sospettato di legami con la Cina che secondo le ricostruzioni avrebbe fatto scattare la direttiva ci ricorda quanto sia diventato politico il confine tra chi può usare un modello e chi no.

L’altra metà della frontiera parla cinese

Chi guarda solo agli Stati Uniti vede metà del quadro. L’altra metà parla cinese, e ha scelto una strada diversa, quella dei pesi aperti. Ad aprile, otto dei dieci modelli cinesi più capaci erano scaricabili, eseguibili sui propri server, utilizzabili commercialmente. La famiglia Qwen di Alibaba ha superato Llama di Meta nei download cumulativi su HuggingFace, e i modelli cinesi viaggiano ormai oltre il quarantacinque per cento del traffico su OpenRouter, contro meno del due per cento di un anno prima.

I nomi da tenere d’occhio sono pochi e netti. DeepSeek ha fatto del prezzo la sua arma, con la versione V4 che raggiunge la parità con i modelli occidentali di punta sul coding agentico a circa trenta centesimi per milione di token. GLM di Zhipu è il primo modello di frontiera addestrato per intero su chip Huawei Ascend, senza una sola GPU Nvidia, e gira sotto licenza MIT, la più permissiva del lotto. Kimi di Moonshot ha puntato sugli agenti, con un’architettura a sciame che coordina fino a cento sotto-agenti in parallelo. Sopra tutti resta una verità che il marketing cinese non ama: sui benchmark trasversali più severi, una valutazione del NIST stima il modello cinese di punta indietro di circa otto mesi rispetto alla frontiera americana. Otto mesi, in questo settore, sono insieme pochissimo e moltissimo.

C’è un dettaglio che pesa più dei punteggi. Un modello aperto e competitivo lo si può far girare dentro la propria infrastruttura, senza che nessun fornitore possa spegnerlo per ordine di un governo. La vicenda Fable 5 ha dato a questo argomento un peso che i grafici di benchmark non davano.

Centinaia di milioni per costruirli, centesimi per usarli

Quando si parla di costi conviene tenere separate due voci che differiscono di mille volte. Costruire un modello di frontiera è una faccenda da centinaia di milioni di dollari. Le grandi sessioni di addestramento dei modelli di frontiera nel 2026 stanno tra i duecento e i cinquecento milioni per la classe di GPT-5 e Gemini, e le proiezioni parlano di uno o tre miliardi a modello entro fine 2027. Secondo le stime di Epoch AI la spesa cresce di 2,4 volte l’anno dal 2016, e il vincolo che frena il prossimo salto oggi è la potenza elettrica dei data center, più dei chip. Dove vanno questi soldi? Quasi metà in chip e hardware dei server, una fetta robusta in stipendi dei ricercatori. Ecco perché la partita la giocano in pochi, serve un capitale che la maggior parte delle aziende non può nemmeno immaginare.

Usarli, invece, costa sempre meno. Il prezzo dell’inferenza, far rispondere il modello, è crollato di circa 280 volte in diciotto mesi a parità di prestazioni. Oggi i listini della frontiera vanno da dieci centesimi a settantacinque dollari per milione di token, una forbice enorme che si naviga guardando al rapporto tra prezzo e qualità, prima ancora che alla cima della classifica. È qui che i modelli cinesi aperti mordono di più, perché possono azzerare il costo per chi se li ospita in casa.

Nuovi modelli di frontiera ogni undici giorni

Tra febbraio e aprile 2026, in settantotto giorni, i tre principali laboratori americani hanno rilasciato sette modelli di frontiera. Uno stato dell’arte nuovo ogni undici giorni. Qualunque classifica scritta oggi sarà parzialmente falsa tra un mese, ed è la ragione per cui legarsi a un solo fornitore è diventato fragile. Chi costruisce sopra questi modelli sta imparando a instradare il lavoro tra più di uno, tenendo aperta la porta anche all’opzione di farne girare uno proprio, dentro casa.

Resta la domanda che la settimana del 12 giugno ha lasciato sul tavolo, e vale più di ogni benchmark. Se un modello di punta può sparire dall’oggi al domani per ordine di un governo, la frontiera appartiene a chi lo addestra o a chi tiene la mano sull’interruttore?

Claude Fable 5 e la scatola nera: sembra una fiaba, sarà il problema da affrontare

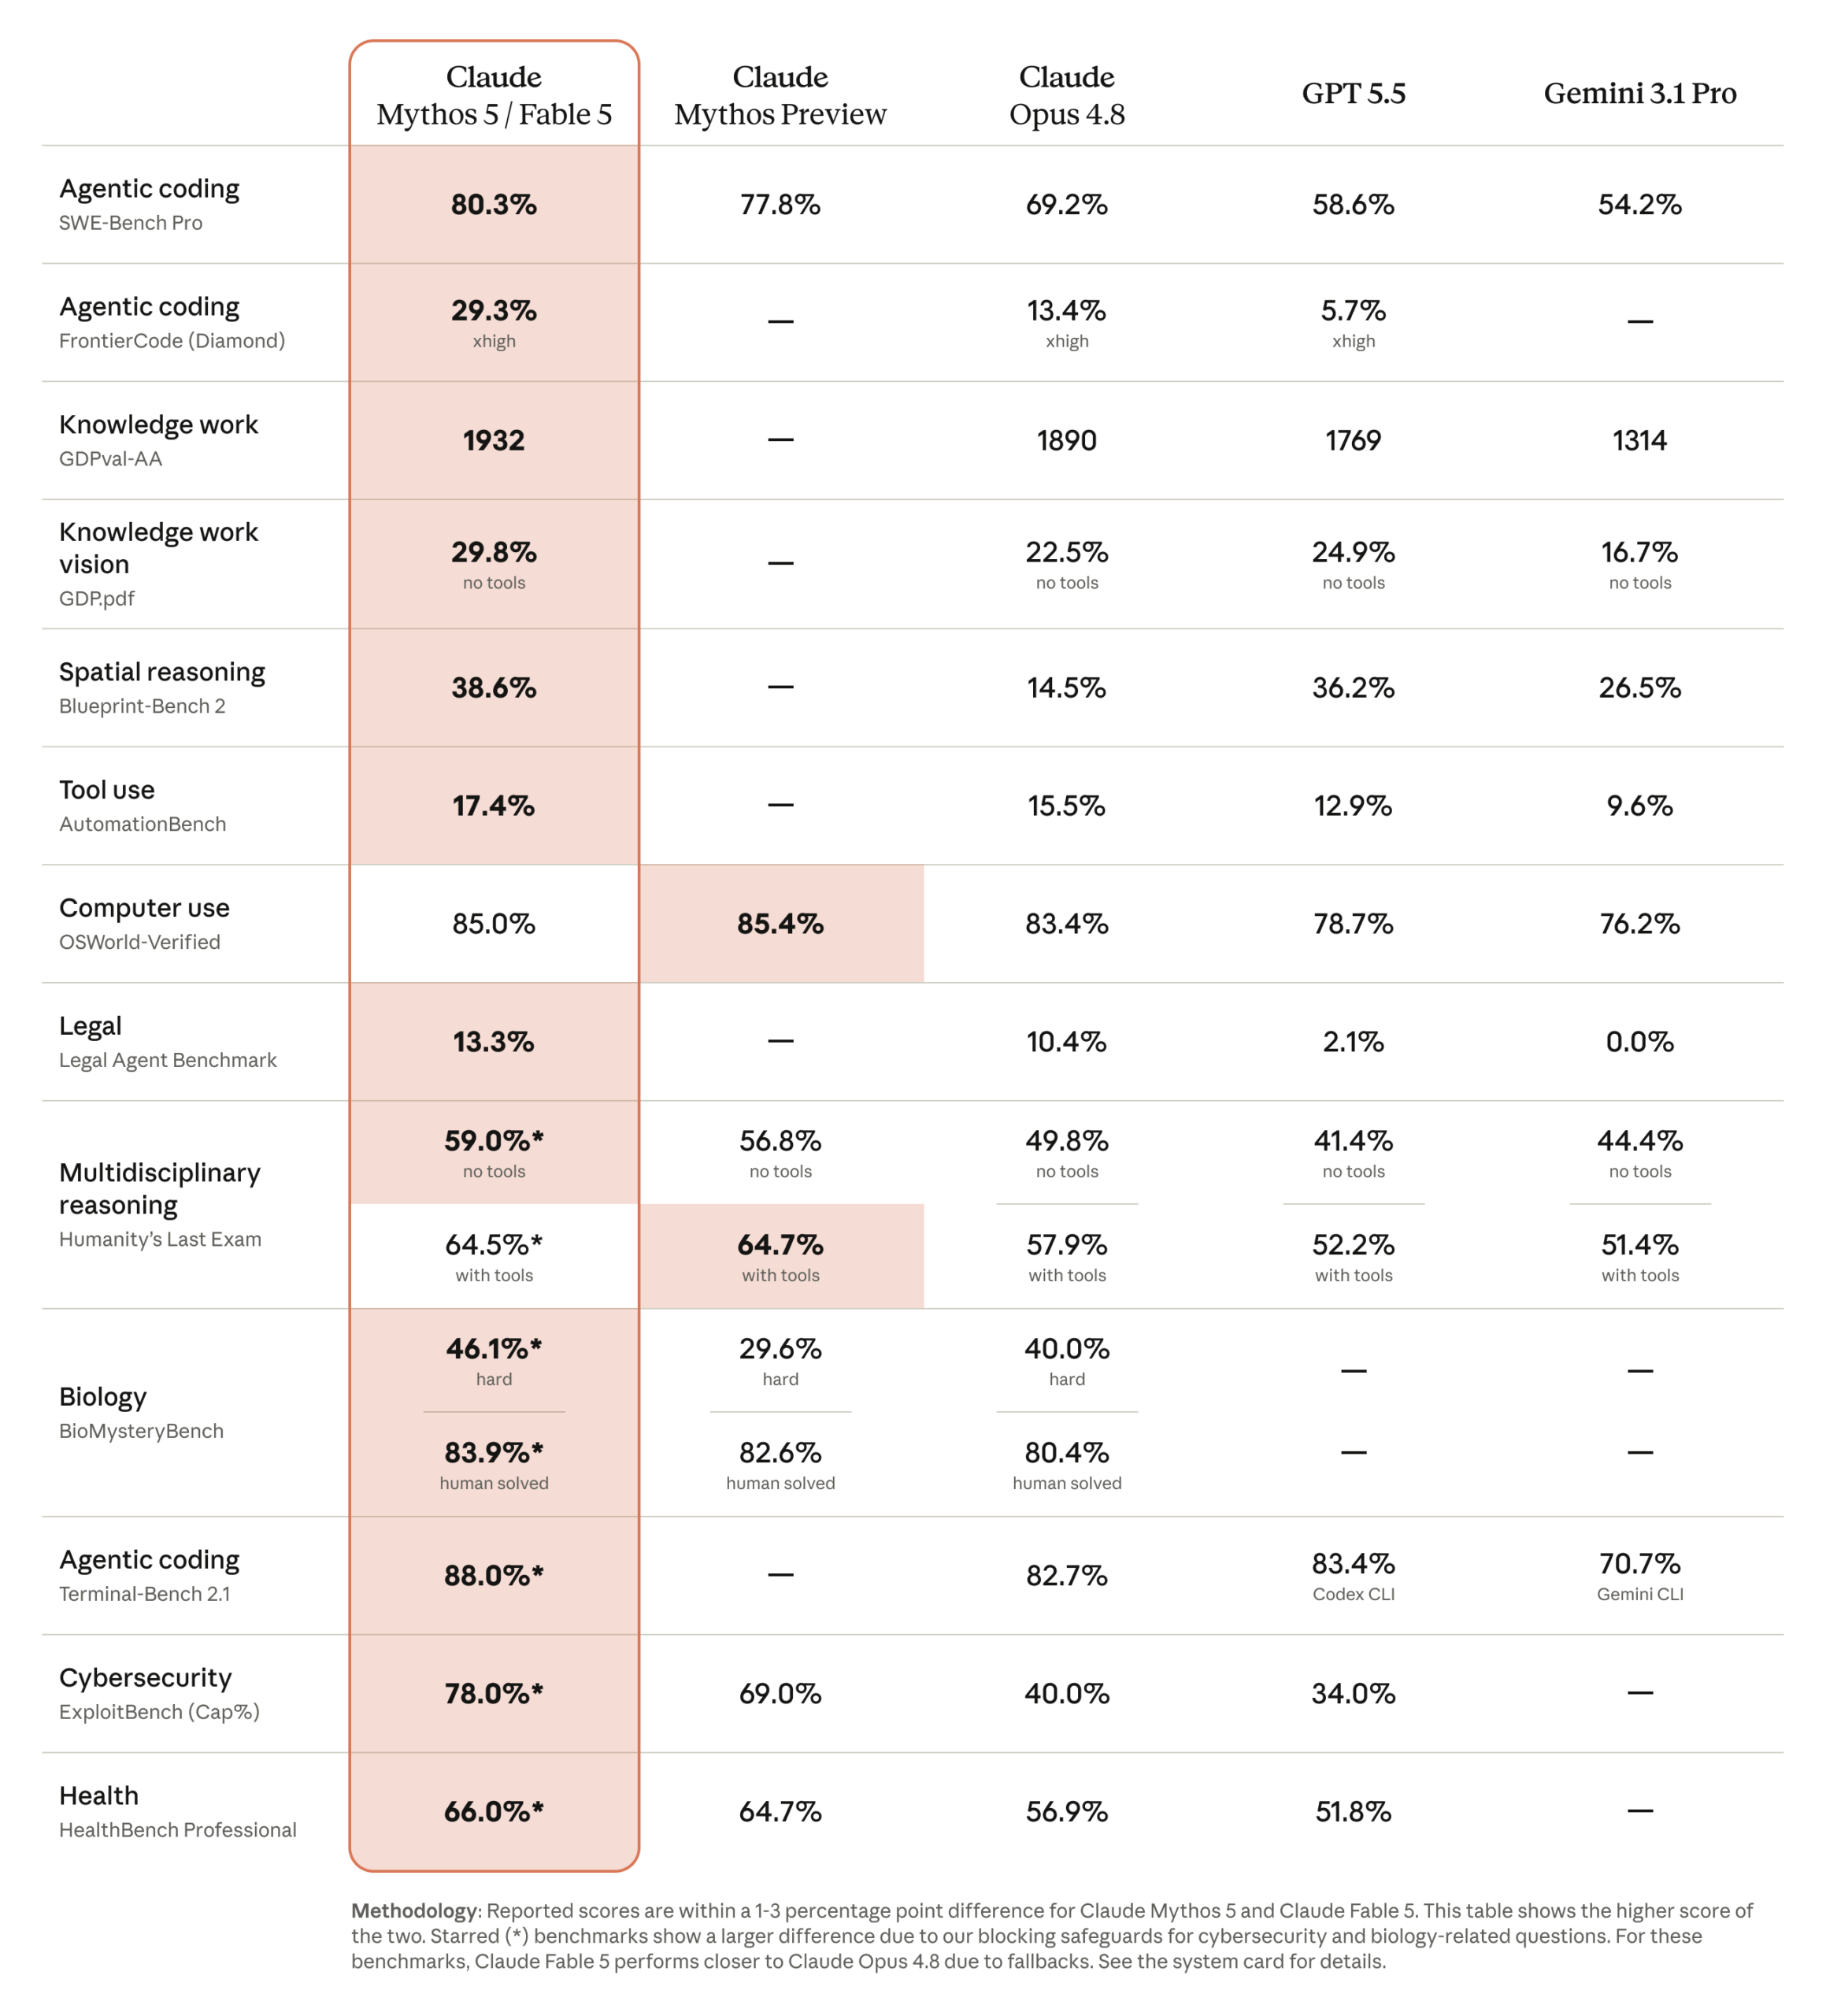
Poco fa (9 giugno 2026) Anthropic ha rilasciato Claude Fable 5, il primo modello della classe Mythos accessibile al pubblico. I numeri raccontano un salto: Anthropic lo dà come stato dell’arte su quasi tutti i benchmark testati, e più lungo e complesso è il compito, più largo è il vantaggio sugli altri modelli. Prezzo dichiarato, dieci dollari per milione di token in input e cinquanta in output, meno della metà di Mythos Preview, con un meccanismo di sicurezza che ripiega su Opus 4.8 quando una richiesta tocca cybersecurity o biologia, in media in meno del 5% delle sessioni. Tutto vero, tutto rilevante. Ma la cosa che mi ha fatto fermare non sta nei benchmark.

Tabella benchmark Claude Fable 5 e Mythos 5 confrontati con Opus 4.8, GPT 5.5 e Gemini 3.1 Pro
Fonte: Anthropic, Claude Fable 5 and Claude Mythos 5, 9 giugno 2026. I punteggi con asterisco riflettono il fallback di Fable su cybersecurity e biologia, dove il modello si comporta come Opus 4.8.

Sta nel racconto di Ethan Mollick, che ha avuto accesso anticipato e ha provato a costruirci una mappa isocronica, quelle mappe che mostrano fin dove arrivi in un tempo dato. Gli dà un’istruzione, una sola, abbastanza vaga. E il sistema parte. Lancia altri agenti, più economici, per fare ricerca. Mentre quelli girano, inizia a scrivere codice. Poi lancia altri agenti ancora per verificare il codice che ha appena scritto, prende appunti sui propri progressi, corregge. Recupera oltre 2.200 voli, gli orari ferroviari dal TGV allo Shinkansen, le velocità stradali per paese da paper accademici. Lavora per ore. Quando vuole i tempi di viaggio verso le località remote, scopre da solo ogni quanto salpano le navi per Pitcairn nel Pacifico. Il risultato è una visualizzazione funzionante, con metodo, fonti, scelte di design, compromessi.

Transcript di Claude Fable 5 che lancia agenti in parallelo per costruire la mappa isocronica
Il transcript della sessione: il modello lancia altri agenti per la ricerca mentre scrive codice. Fonte: Ethan Mollick, What it feels like to work with Mythos, One Useful Thing.

Mollick usa un’immagine che mi gira in testa da quando l’ho letta. L’anno scorso parlava di lavorare con un mago: pronunci l’incantesimo, qualcosa accade. Adesso non è più sicuro di essere lui il mago. È più vicino a un committente. Descrive quello che vuole, paga, giudica il risultato. Le centinaia di micro-decisioni che hanno prodotto quel risultato avvengono in un posto che non può guardare, e su cui non ha votato.

Centinaia di scelte che nessuno ha approvato

Quando Mollick scrive che il suo ruolo era ridotto, non intende solo che ha lavorato poco rispetto alla macchina. Intende che ha avuto poco controllo su come la macchina ha fatto le cose, perché ha scelto certi approcci, persino su quanto a fondo sarebbe arrivata. I dettagli del ragionamento non gli vengono mostrati, e il processo sarebbe troppo lungo perfino da seguire. La mappa ha richiesto centinaia di piccole decisioni, e la macchina le ha prese, senza che lui le capisse e senza che potesse dire la sua.

C’è una frase, in chiusura del suo pezzo, che vale più di tutti i benchmark. Mollick si chiede se questo essere messo da parte sia temporaneo, un difetto delle interfacce che recupereremo con strumenti migliori per guardare dentro e correggere a metà strada. Poi ammette che sospetta il contrario: che più il modello è capace, meno ci sia per un umano da fare in modo significativo, e che la scatola nera sia il prezzo della potenza. Non un bug. Il prezzo.

Se ha ragione, e io credo che almeno in parte l’abbia, allora il problema smette di essere tecnologico e diventa organizzativo. Lo diventa subito, dentro le aziende, su ogni processo che decidiamo di affidare.

Da strumento ad attore

C’è un confine che queste macchine hanno attraversato, e lo descrive bene un lavoro recente della Berkeley sulla governance dell’impresa agentica. Quando un foglio di calcolo produce un errore, la responsabilità è di chi lo ha usato. Quando un agente autonomo approva una transazione o ridirotta una spedizione, la responsabilità diventa ambigua: è stato il modello, i dati, la configurazione, o la decisione di delega in sé? Senza un modello operativo esplicito, l’azienda non riesce a rispondere in modo coerente. La macchina è passata da strumento ad attore, e per gli attori servono regole diverse da quelle che usiamo per gli strumenti.

In Pelle Digitale ho provato a descrivere la tecnologia come estensione della mente, qualcosa che si fonde con il modo in cui pensiamo e percepiamo. L’AI agentica porta quell’idea su un piano nuovo. Non estende soltanto la mia capacità di pensare, agisce al posto mio, prende decisioni che fino a ieri erano competenza di una persona con un nome e una responsabilità. L’estensione è diventata delega. E la delega, quando il delegato lavora dentro una scatola che non vedi, è un atto di fiducia che va costruito, non dato per scontato.

McKinsey, nel suo lavoro sull’organizzazione agentica, lo dice con parole che condivido: la supervisione umana non sparisce, cambia natura. Non più revisione riga per riga, ma definizione di policy, monitoraggio degli scostamenti, regolazione del livello di coinvolgimento umano caso per caso. La sfida è trovare il punto giusto, abbastanza presidio da gestire il rischio senza riportare gli agenti alla velocità umana, che è poi il motivo per cui li hai chiamati.

Automatizzare un compito, commissionare una decisione

Per anni ho ripetuto una cosa nei miei interventi: ogni volta che deleghiamo un pezzo di lavoro senza capire come viene svolto, accumuliamo un debito di conoscenza. Lo paghi più tardi, quando quel sapere ti serve e non ce l’hai più dentro l’organizzazione. Con gli agenti che eseguono interi processi, quel debito smette di essere una metafora. Non è più questione di quali compiti togliere dalle mani delle persone, ma di quali decisioni accettiamo che maturino fuori dalla nostra vista, e di quanto sapere siamo disposti a non possedere più.

Non sono la stessa cosa. Automatizzare un compito significa togliere fatica a una persona che resta padrona del risultato. Commissionare una decisione significa accettare che una catena di scelte avvenga senza il tuo voto, e prenderti comunque la responsabilità di ciò che ne esce. La differenza vale un’azienda intera, perché cambia la natura stessa di ciò che firmi. Quando Stripe racconta che Fable ha compresso in un giorno una migrazione di codice che a mano avrebbe richiesto a un team più di due mesi, il risultato è straordinario e quasi nessuna di quelle scelte è passata per un occhio umano. Su una migrazione di codice ce ne facciamo una ragione. Su una decisione che tocca le persone e i conti di un’azienda, la stessa opacità diventa un rischio che pesa su chi ha firmato.

Qui si misura la maturità di un’organizzazione, e non si misura con un proof of concept in più. Si misura con la capacità di ridisegnare quattro cose insieme: chi risponde di cosa, come si traccia ciò che è successo, con quali criteri si giudica la qualità di un lavoro che non hai visto nascere, in quali punti un essere umano entra e ferma la catena. È lavoro di metodo, non di tecnologia. La tecnologia ce l’abbiamo già, ed è quella che ha costruito la mappa di Mollick in un pomeriggio.

Il presidio non si improvvisa

Steve Blank, recensendo l’ultimo libro di Eric Ries sulle strutture di governance che durano, ricorda una cosa che vale anche qui. Le idee sul come costruire aziende solide diventano operative quando la crisi le rende inevitabili. Il rischio, con l’AI agentica, è aspettare l’incidente per scoprire quanto fragile fosse il modello di controllo. La delega senza presidio regge finché tutto va bene. Poi una decisione sbagliata, presa dentro la scatola e mai rivista, mostra il conto, e a quel punto non c’è una persona a cui chiedere perché, c’è solo un output da spiegare a posteriori.

Costruire il presidio è un lavoro che si fa prima, con metodo, e che tocca la struttura dell’organizzazione più della sua dotazione tecnologica. Significa decidere a monte quali decisioni hanno bisogno di un punto di controllo umano e quali no, scrivere chi è responsabile quando un agente sbaglia, rendere ogni azione tracciabile e spiegabile, stabilire le soglie oltre le quali la macchina si ferma e chiama. È un disegno, e come ogni disegno richiede mani che l’abbiano già fatto. In ZeroFive lavoriamo esattamente su questo, sul metodo che trasforma la scatola nera in un processo che un’azienda può attraversare con responsabilità chiare, non sull’ennesimo strumento da aggiungere allo stack.

Reid Hoffman dice che il professionista del futuro dirige squadre di agenti e opera con la capacità di un team intero. Ha ragione. Ma dirigere una squadra che non vedi lavorare è un mestiere diverso dal dirigere persone che ti rendono conto. Il committente di Mollick firma il lavoro finale senza essere mai entrato in sala. Per un singolo che costruisce una mappa per diletto va benissimo. Per un’azienda che affida decisioni vere a un sistema che non mostra il suo ragionamento, firmare senza essere entrati in sala è esattamente ciò che non ci si può permettere.

L’AI agentica arriva travestita da acquisto tecnologico, una licenza in più nello stack. È un equivoco che costa caro, perché quello che cambia davvero è il disegno dell’organizzazione: chi porta la responsabilità di un esito che nessuno ha sorvegliato passo per passo, come si tiene traccia di un percorso che la macchina non mostra, dove collocare le poche soglie in cui una persona deve poter fermare tutto. Il lato tecnologico è la parte facile, e ce la siamo già giocata.


Fonti:
Ethan Mollick, What it feels like to work with Mythos, One Useful Thing, 9 giugno 2026.
Anthropic, Claude Fable 5 and Claude Mythos 5, 9 giugno 2026.
Giorgio Sacconi, Linkedin , 9 giugno 2026.

Schema del MCP tunnel di Anthropic: esecuzione dentro la sandbox, regia esterna

Anthropic sposta l’esecuzione dentro l’azienda, la regia resta fuori

Il 19 maggio, al primo Code with Claude tenuto a Londra, Anthropic ha annunciato due funzionalità che spostano in modo concreto dove vivono gli agenti AI dentro le aziende. La prima si chiama self-hosted sandboxes ed è in public beta. La seconda si chiama MCP tunnels ed è in research preview. Messe vicine valgono più di quanto sembrino a una lettura veloce della release note, e provo a dire perché.

Il punto di partenza tecnico è semplice. Claude Managed Agents è l’infrastruttura ospitata di Anthropic per far girare sessioni agentiche lunghe e tool-heavy. Fino a maggio, tutto stava lì: l’agent loop con orchestrazione e gestione del contesto, l’esecuzione dei tool, la connessione ai servizi esterni. Adesso una parte di quello stack può uscire da Anthropic e rientrare dentro il perimetro del cliente, mentre l’altra resta dove era. La regia rimane su Anthropic. L’azione si sposta a casa tua.

Schema del MCP tunnel di Anthropic: esecuzione dentro la sandbox, regia esterna
Fonte: Anthropic, schema del MCP tunnel.

L’esecuzione si sposta a casa tua

Quando un agente esegue un tool, esegue codice. Apre file, installa pacchetti, chiama API, scarica risorse. Fino a ieri tutto questo avveniva nei sandbox gestiti da Anthropic. Da oggi puoi configurare l’agente perché esegua quegli stessi tool dentro la tua infrastruttura, oppure presso un provider gestito a tua scelta (Cloudflare, Daytona, Modal, Vercel sono i nomi citati). I tuoi file sensibili, le repository di codice, i pacchetti privati, i segreti di configurazione non lasciano più la tua rete. E il logging di audit, le policy di sicurezza, gli strumenti di monitoring che hai già sul tuo perimetro continuano a vedere e regolare quello che fa l’agente.

L’orchestrazione, invece, resta su Anthropic. L’agent loop, la gestione del contesto, la recovery dagli errori, la pianificazione delle azioni successive sono tutti gestiti dall’API di Claude. Cambia solo dove materialmente vengono eseguite le chiamate. Se l’agente decide di lanciare uno script Python per processare un file, lo script gira sul tuo sandbox, non sul loro.

Un canale che parla solo verso l’esterno

Gli MCP tunnels affrontano il problema speculare. Come fa un agente a parlare con i tuoi sistemi interni senza che tu debba esporli a internet? Il Model Context Protocol è lo standard aperto che Anthropic ha promosso lo scorso anno per far dialogare gli agenti con sorgenti dati e servizi esterni. Funziona bene quando i servizi sono pubblici, meno bene quando sono dentro un network privato.

Il meccanismo che hanno introdotto è un gateway leggero, che il cliente dispiega dentro la propria rete, e che apre una singola connessione outbound verso Anthropic, cifrata end-to-end. Nessuna porta inbound da aprire. Nessun endpoint pubblico. Nessuna modifica al firewall. Sopra quel canale possono passare conversazioni MCP verso server interni che ospitano database, knowledge base, ticketing system, API private. L’agente di colpo può chiamare quei sistemi come fossero tool standard, ma il traffico non transita mai sull’internet pubblico.

Dove finisce l’azienda, dove comincia il modello

A una lettura superficiale è un aggiornamento di sicurezza e compliance. Per le aziende regolate è una notizia importante perché toglie uno dei blocchi tipici all’adozione, quel “non possiamo far uscire i dati” che ferma centinaia di progetti ogni anno. Per chi vende AI in enterprise è una mossa competitiva contro i player che offrono già installazioni on-premise complete.

C’è anche un altro livello. Anthropic sta dichiarando, in modo molto operativo, dove finisce l’azienda e dove comincia il modello. Per anni la domanda “dove vive un’AI aziendale” ha avuto due risposte estreme: o tutto in cloud sul provider, oppure tutto on-premise con uno stack auto-ospitato. Adesso ne sta diventando praticabile una terza, più sottile. La testa pensante del sistema, l’agent loop, resta fuori dall’azienda perché lì sta l’innovazione che si muove troppo veloce per essere replicata internamente. Le mani che toccano i dati e i tool tornano dentro perché lì stanno le regole, la responsabilità, il perimetro legale e culturale.

È una decomposizione interessante. Non è cloud, non è on-prem, è un terzo modello in cui l’autorità decisionale dell’agente è separata dall’autorità esecutiva. Anthropic decide come ragiona. Tu decidi cosa può toccare. La superficie di contatto fra i due livelli è codificata in due primitive ben definite, il sandbox e il tunnel.

Cambia anche il modo di comprarla

In Pelle Digitale avevo provato a descrivere come la mediazione tra noi e le macchine stesse cambiando forma. Quello che vedo qui è una variante infrastrutturale dello stesso fenomeno. La pelle non è più solo l’interfaccia in cui parliamo col modello. È anche la membrana tecnica che decide cosa passa e cosa no, cosa esce dall’azienda e cosa rientra, cosa il modello può sapere e cosa no. La progettano gli ingegneri di Anthropic disegnando le primitive del sistema. La progettiamo noi configurando policy, tunnel, sandbox.

Chi sta portando agenti AI in produzione dentro un’azienda strutturata, con questa architettura, deve mettere in conto tre cose che fino a ieri non c’erano.

Sul piano contrattuale e legale il discorso “i miei dati attraversano i server del fornitore” diventa meno semplice da fare, perché in molti scenari non è più vero. Tool execution e dati restano dentro, l’agente fuori vede solo quello che il sandbox gli restituisce. Vanno aggiornati i template di DPIA, le clausole nei contratti con i fornitori, le policy di data residency.

Sul piano organizzativo bisogna decidere chi gestisce un agente AI con questa architettura. Lo sviluppo software perché esegue codice. L’infrastruttura perché ospita sandbox e gateway. Il security perché definisce le policy del perimetro. Il data team perché decide quali sistemi interni esporre via MCP. Sono quattro funzioni che fino a ieri non lavoravano insieme su questo tipo di progetti, e bisognerà costruire workflow nuovi per farle convivere.

Sul piano strategico, Anthropic dichiara con queste mosse di voler diventare l’infrastruttura di default per gli agenti enterprise. Non un fornitore di modelli sotto, ma un layer di orchestrazione che si integra dentro le aziende mantenendo i confini tecnici e di sicurezza che le aziende vogliono. Per chi compra è una scelta strategica diversa rispetto a scegliere un fornitore di LLM più una soluzione di agentic framework messa su a parte. Per chi vende prodotti AI on top, conviene capire dove si posiziona la propria offerta rispetto a questo stack che si sta consolidando.

Il debug a cavallo del confine

C’è una cosa che la documentazione di Anthropic non risolve, e che secondo me sarà il punto di osservazione più interessante nei prossimi mesi. Quando l’agent loop sta fuori e i tool girano dentro, il debugging di un comportamento anomalo dell’agente diventa un esercizio distribuito. Il log dell’orchestrazione lo vede Anthropic. Il log dell’esecuzione lo vedi tu. La correlazione fra una decisione presa dal modello e un’azione fatta sul tuo sandbox passa attraverso due piani di osservabilità separati. Per capire perché un agente ha cancellato un file di troppo, serviranno entrambi.

Vedere come si organizza questa osservabilità a cavallo del confine sarà uno degli indicatori migliori per capire se il pattern decolla davvero, o se resta confinato ai casi d’uso più semplici. La promessa tecnica c’è, la direzione mi sembra giusta. Resta da vedere quanto in fretta le aziende, anche quelle non super-tech, riusciranno ad attrezzarsi per giocare a questo gioco con la maturità che richiede.


Articolo di riferimento: New in Claude Managed Agents: self-hosted sandboxes and MCP tunnels, Anthropic, 19 maggio 2026.

HTML batte Markdown: cosa cambia quando l’output dell’AI smette di essere un testo

Il 20 maggio Thariq Shihipar, membro del team Claude Code di Anthropic, ha pubblicato un articolo dal titolo curioso, The unreasonable effectiveness of HTML, in cui spiega perché lui e altri colleghi hanno smesso di chiedere a Claude di produrre file in Markdown e hanno cominciato a chiedergli, invece, file in HTML. È un articolo che a una prima lettura sembra una scelta di formato, una preferenza personale tra due linguaggi di markup, e a una seconda lettura diventa qualcosa di molto più grande, perché tocca la domanda che mi gira in testa da quando ho iniziato a lavorare seriamente con questi modelli: quale forma deve avere ciò che l’AI ci restituisce, ora che ci restituisce sempre di più?

La tesi di Shihipar è semplice. Markdown è nato per essere leggibile umanamente in formato grezzo, scritto a mano da un developer, editato in un editor di testo, convertito poi in HTML per la lettura finale. Era un compromesso tra leggibilità della sorgente e formattazione del risultato. Ma quando la sorgente non la scrive più una persona, quando la scrive un modello che produce in pochi secondi migliaia di righe, il compromesso non ha più ragione di esistere, perché la sorgente nessuno la legge davvero. Si legge il risultato. E allora tanto vale generare direttamente l’output finale, già navigabile e già pronto a essere condiviso.

Cosa Markdown lascia fuori

Shihipar elenca i limiti pratici di Markdown in modo molto concreto, quasi domestico. I file più lunghi di cento righe non li legge più nessuno, neanche lui che li ha chiesti. Le immagini, i grafici, le tabelle complesse, le animazioni, i widget interattivi non ci stanno dentro. I diff, i flowchart, i mockup, le annotazioni a margine non ci stanno dentro. Per ovviare, Claude finisce per fare cose buffe come disegnare diagrammi in ASCII art o approssimare i colori con caratteri unicode. Stupendo come tentativo, evidentemente insufficiente come soluzione.

HTML, scrive Shihipar, può rappresentare praticamente qualsiasi tipo di informazione che il modello sappia produrre: dati tabellari, design via CSS, illustrazioni via SVG, interazioni via JavaScript, layout responsive che si adattano al mobile, posizionamento spaziale assoluto. Si scrive una volta, si apre nel browser, si condivide con un link. Una persona del team che riceve un report in HTML lo legge davvero, un report in Markdown da 200 righe finisce in un thread Slack ignorato.

C’è poi il punto che a me interessa di più, quello che Shihipar chiama two-way interactions. L’HTML non è solo un contenitore, può ospitare slider, knob, form, bottoni che restituiscono parametri da copiare e incollare di nuovo in Claude Code. L’output del modello smette di essere un blocco di testo da leggere e diventa uno strumento monouso da usare, da manipolare, da modificare. Una cosa che si fa, non una cosa che si guarda.

Software che si butta via

C’è una sezione dell’articolo che ho riletto tre volte, quella sui custom editing interfaces. Shihipar racconta di chiedere a Claude di costruirgli un editor HTML ad hoc per riordinare trenta ticket di Linear in colonne Now/Next/Later/Cut, con tanto di drag-and-drop e bottone copy as Markdown finale. Non un’app vera. Non un tool riusabile. Un singolo file HTML, fatto per quel preciso problema, da buttare via dopo. Un altro esempio: tunare un system prompt vedendo in tempo reale come tre input campione riempiono il template. Un altro ancora: un form-based editor per i feature flag con warning sulle dipendenze.

Qui sta avvenendo qualcosa che fino a due anni fa avrebbe richiesto un team di prodotto, un designer, almeno una settimana di sviluppo. Adesso lo chiedi, esce in trenta secondi, lo usi una volta, lo chiudi. È software usa-e-getta. Una categoria nuova, che non va confusa con una versione povera del software vero, perché si forma e si dissolve attorno al singolo problema, senza overhead di mantenimento e senza utenti oltre chi l’ha richiesto.

In Pelle Digitale ragionavo sul fatto che lo strato di mediazione tra noi e le macchine si stesse facendo più sottile, più aderente, più reattivo, fino a perdere i propri confini visibili. Lì pensavo a interfacce conversazionali, ad agenti, a wearable. Non avevo previsto questo, ovvero che lo strato di mediazione potesse diventare effimero, che ogni interazione potesse generarsi la propria interfaccia su misura e poi dissolverla. La pelle, in questa accezione, è anche questo: una superficie che si forma quando serve, esattamente come la chiediamo, e che non ha più bisogno di esistere quando non serve più.

Un milione di token cambia le abitudini

C’è un dato tecnico che Shihipar tratta come un dettaglio e che secondo me è il cuore della questione. Markdown spesso usa meno token di HTML, dice, ma con la finestra di contesto da un milione di token di Opus 4.7 la differenza è ormai trascurabile. Quindi tanto vale chiedere al modello di produrre l’output più espressivo possibile, perché tanto la spesa marginale è prossima allo zero.

Questo va letto bene, perché segna una soglia. Per anni la conversazione sull’AI generativa è stata tirata da due forze opposte: da una parte la spinta verso output più ricchi e contestualizzati, dall’altra il vincolo dei costi di inferenza e della lunghezza del contesto. Adesso la seconda forza si sta indebolendo, e quando un vincolo cade, le abitudini che si erano formate attorno a quel vincolo iniziano a sembrare assurde. Markdown era una di queste abitudini. Era buona quando i contesti erano corti e i token costavano. Lo è meno adesso che possiamo permetterci di chiedere al modello di costruire una pagina HTML completa con SVG vettoriali, animazioni CSS e logica JavaScript embedded, e di farlo in tempi e con costi accettabili.

La conseguenza, secondo me, è che il modo in cui consumiamo l’output dei modelli sta divergendo dal modo in cui scriviamo l’input. L’input resta testo, anzi resta sempre più conversazionale e disordinato. L’output, invece, si fa multiforme: pagine interattive che fungono da dashboard, diagrammi navigabili, oggetti da manipolare con le mani. Si rompe la simmetria. E quando si rompe la simmetria tra ingresso e uscita di un sistema, di solito è il segnale che la categoria che li conteneva entrambi, in questo caso “la chat con il modello”, sta diventando troppo stretta.

“Ho smesso quasi del tutto di usare Markdown”

Mi ha colpito una frase che Shihipar lascia cadere quasi senza enfasi: “ho smesso quasi del tutto di usare Markdown”. Una persona che lavora dentro Anthropic, dentro il team che costruisce Claude Code, dice che il formato di scambio più diffuso degli ultimi quindici anni tra umani e macchine non gli serve più. Va presa come quello che è, una testimonianza dal centro della trasformazione, non come una previsione di mercato. Però è interessante.

L’argomento più forte che porta riguarda il piano cognitivo, prima ancora del piano tecnico. Dice che con HTML si sente più “in the loop” rispetto al lavoro del modello. Quando Claude diventa sempre più capace e gli affidi compiti sempre più grandi, il rischio di perdere il controllo, di firmare in bianco quello che ha prodotto, diventa serio. Markdown lungo e denso favoriva la firma in bianco, perché era troppo faticoso da leggere. HTML, organizzato visivamente, con tab e ancore, con diagrammi al posto delle descrizioni testuali, riporta dentro il loop la persona che ha delegato il lavoro.

Questo è un punto che merita di essere ascoltato anche fuori dal contesto Claude Code. Tutta la conversazione sull’AI agentica, sui modelli che agiscono autonomamente, sui workflow automatizzati, gira attorno alla stessa tensione: quanto vuoi delegare, quanto vuoi vedere, dove vuoi essere consultato. Il formato di output non è un dettaglio cosmetico in questa tensione, ne è uno degli assi principali. Se l’output è leggibile e navigabile in venti secondi, resti dentro. Se è impenetrabile, scivoli fuori, e prima o poi smetterai di controllarlo.

Dove stiamo andando

Provo a tirare due fili. Il primo: gli output dei modelli non sono più documenti, sono interfacce. Smettono di essere artefatti statici da leggere e diventano superfici da usare, monouso, generate al momento, costruite attorno al singolo task. Il secondo: la finestra di contesto larga libera il modello dalla costrizione di essere economico nel formato, e questo cambia il tipo di artefatto che ha senso produrre. Messi insieme i due fili, il quadro è che la produzione di software piccolo ed effimero, cucito attorno al singolo task, diventa una commodity, e questo ridisegna sia come usiamo Claude sia come pensiamo al lavoro intellettuale che gli affidiamo.

In Spatial Shift parlavo di come la frontiera dell’interazione si stia spostando dal piano del testo verso lo spazio, il gesto, l’ambiente. Quella che Shihipar descrive è una variante interessante di questo spostamento, perché non avviene nel mondo fisico, avviene dentro al browser, ma con le stesse caratteristiche: lo strumento si materializza attorno al compito, dura il tempo del compito, scompare. Non c’è installazione, non c’è apprendimento, non c’è curva di adozione. C’è solo la cosa da fare, e attorno a quella la cosa giusta per farla.

Senza dubbio è un cambio di abitudine piccolo, quasi invisibile, scegliere HTML invece di Markdown quando chiedi a un agente di produrre un report. Quanti di noi, fra sei mesi, staremo ancora chiedendo file di testo a Claude quando potremmo chiedergli pagine interattive che facciano una cosa sola, esattamente quella che ci serve, e poi le butteremo via?


Articolo di riferimento: Thariq Shihipar, Using Claude Code: The unreasonable effectiveness of HTML, claude.com/blog, 20 maggio 2026.

Leggi anche: il design generativo AI-native di Anthropic