Da prima di agosto ho messo da parte, uno dopo l’altro, gli schemi con cui i grandi fornitori di software aziendale raccontano la loro offerta di intelligenza artificiale, per studiarli: quello di uno dei CRM più diffusi, quello della suite d’ufficio che quasi tutti abbiamo sul portatile, quelli delle piattaforme verticali per la logistica e la distribuzione e così via. Cambiano i nomi, cambiano i colori, a volte i prodotti cambiano nome da un mese all’altro e chi prova a seguirli fatica a capire cosa sia stato annunciato e cosa porta veramente di differente sul mercato.
Messi uno accanto all’altro, però, disegnano la stessa torre, e ognuno a modo suo descrive l’azienda agentica.
In basso ci sono i sistemi dove vive la verità aziendale, sopra di loro uno strato che trasforma i dati in contesto leggibile da un modello, sopra ancora gli agenti che ragionano e agiscono, e in cima un’interfaccia conversazionale dove le persone fanno domande e approvano azioni.
Attorno a tutto, disegnato come una cornice e quasi mai come un piano, l’insieme di servizi che nessuno compra a parte, che spesso vanno decisi e scritti proprio internamente e che, però, tiene in piedi la costruzione: permessi, sicurezza, tracciamento delle azioni, valutazione dei risultati.
La torre descrive bene dove stanno andando le aziende dal mio punto di vista.
Gli schemi lasciano fuori, perché a chi li disegna conviene darlo per scontato, una domanda molto specifica e importante: chi possiede gli strati bassi?
Dove gira il modello, dove viene assemblato il contesto, chi può leggere il registro di quello che gli agenti hanno fatto.
Su questa domanda ho costruito il lavoro di questo ultimo anno da quando ho fondato ZeroFive.AI e che sto portando nei progetti con le aziende, con LocalAI sull’inferenza locale e con Gideon, l’ultimo nato, l’assistente che uso ogni giorno come banco di prova. In questo approfondimento provo a descrivere in modo puntuale e sintetico (nemmeno troppo) l’approccio per intero, senza marchi di fornitori, perché questa architettura dell’azienda agentica vale anche per chi non comprerà mai una licenza da nessuno di loro.
Otto strati dell’azienda agentica, letti dal basso
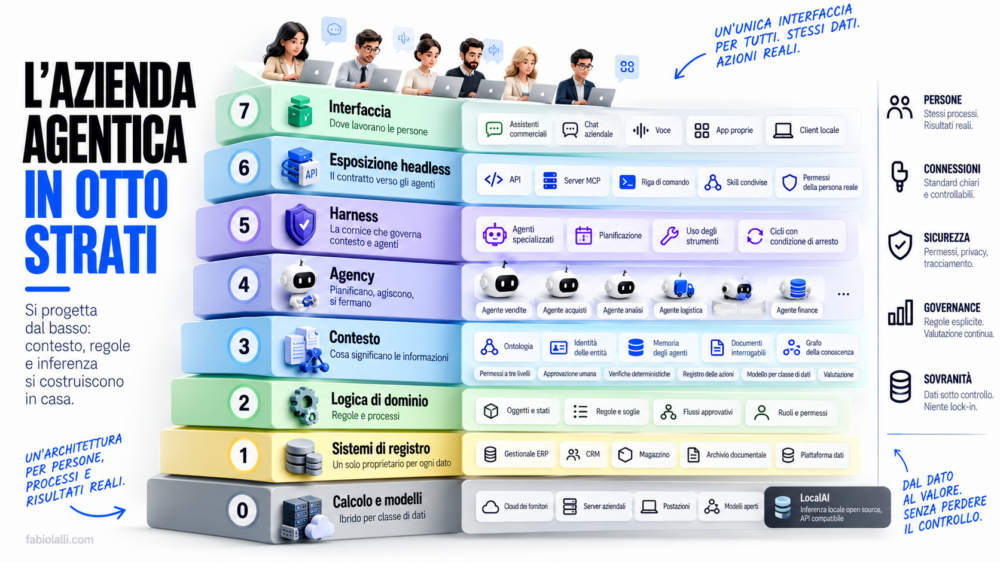
La versione astratta della torre, quella che vale per qualunque azienda agentica, ha 8 strati. Li descrivo partendo dal basso perché è l’ordine in cui andrebbero progettati, anche se quasi tutti i progetti che incontro partono dall’alto, dalla scelta dell’assistente da comprare per i dipendenti, o dal modello o dalla tecnologia in generale.
| Strato | Cosa contiene | Domanda da fare prima di costruirlo |
|---|---|---|
| 0. Calcolo e modelli | dove gira l’inferenza: cloud, server aziendali, postazioni | quali dati possono raggiungere quale modello? |
| 1. Sistemi di registro | gestionale, CRM, archivi documentali, magazzino | per ogni dato, qual è l’unico sistema proprietario? |
| 2. Logica di dominio | oggetti, regole, flussi approvativi, permessi | quali regole oggi stanno solo nella testa di qualcuno? |
| 3. Contesto | identità delle entità, ontologia, memoria degli agenti, testi vettorizzati | cosa significano le informazioni e chi lo decide? |
| 4. Agency | ragionamento, pianificazione, agenti specializzati, cicli di esecuzione | quali compiti si delegano e con quale condizione di arresto? |
| 5. Harness | governo, sicurezza, osservabilità, valutazione, scelta del modello | cosa può fare un agente senza chiedere, e chi lo verifica? |
| 6. Esposizione headless | API, server MCP, riga di comando, skill | quale contratto vede chi sta sopra? |
| 7. Interfaccia | assistenti commerciali, chat aziendali, voce, app proprie | dove lavorano già le persone? |
Lo strato zero è quello che nessuno compra e tutti pagano. Nella torre dei fornitori coincide con il loro cloud e non compare quasi mai nei disegni, eppure decide dove finisce ogni frase che un agente legge, e quanto costa leggerla.
Sopra stanno i sistemi di registro, che le aziende conoscono da trent’anni e che con l’arrivo degli agenti chiedono una sola regola, la più difficile da rispettare: ogni dato ha un solo sistema proprietario, e tutti gli altri lo citano invece di copiarlo. Un’anagrafica cliente duplicata in due posti produce, dopo pochi mesi, due verità su chi decide in quell’azienda, e un modello che le legge entrambe sceglie a caso quale riportare.
La logica di dominio è lo strato che trasforma i dati in processi. Un ordine ha uno stato, uno sconto oltre una certa soglia richiede una firma, un fornitore nuovo passa da una verifica prima di ricevere il primo pagamento. Molte di queste regole vivono nel codice dei gestionali, molte altre in procedure che qualcuno ha scritto anni fa, e una parte consistente solo nell’abitudine di chi fa quel lavoro da tanto tempo. Il modello dati è una teoria dell’azienda, e gli agenti la ereditano così com’è, con le scelte fatte da un consulente dieci anni fa per far quadrare la contabilità analitica.
Il contesto è lo strato dove l’azienda dice a un modello cosa significano le sue informazioni: che “cliente” in amministrazione vuol dire chi ha una fattura aperta e in commerciale chi ha un’opportunità attiva, che due nomi diversi indicano la stessa persona, quale decisione presa in una riunione di marzo ha superato quella di gennaio. Qui stanno l’ontologia, la risoluzione delle identità, la memoria di lungo periodo degli agenti e il testo dei documenti reso interrogabile. Sopra lavora l’agency, cioè la parte che pianifica, sceglie gli strumenti, esegue e controlla il risultato in un ciclo che si ripete finché non scatta una condizione di arresto.
L’harness ha un numero in tabella per comodità, ma nel disegno andrebbe tracciato come una cornice attorno al contesto e agli agenti. È tutto quello che serve a un agente in produzione e che non è il modello: i permessi con cui agisce, le regole che decidono quando deve chiedere, il registro di quello che ha fatto, le verifiche automatiche sui risultati, la scelta di quale modello usare per quale classe di dati.
Sopra ancora c’è l’esposizione headless, che rende disponibile tutto quello che sta sotto senza bisogno di uno schermo, attraverso API, server MCP, riga di comando e skill.
In cima l’interfaccia, che grazie ai due strati precedenti può essere quasi qualunque cosa.
L’interfaccia esce dal centro del progetto
Per vent’anni il software aziendale ha coinciso con il suo schermo. Si comprava una licenza per ogni postazione, si formavano le persone sull’interfaccia, si misurava l’adozione contando quanti accessi faceva ciascuno ogni settimana, e il fornitore teneva il cliente proprio attraverso quell’abitudine visiva: cambiare CRM voleva dire riaddestrare centinaia di persone a cliccare in posti diversi. Il valore stava sopra, nell’interfaccia, e i dati sotto erano il prezzo da pagare per usarla.
Nell’azienda agentica questo rapporto si rovescia. Le persone lavorano dentro l’assistente che preferiscono, un client commerciale, la chat aziendale, la voce in macchina, e chiedono a quell’assistente di andare a prendere le informazioni dove si trovano e di agire per loro conto. In Pelle Digitale avevo provato a descrivere l’interfaccia come il punto di contatto fra la persona e il sistema digitale che la circonda; con gli agenti quel punto si moltiplica e si assottiglia, diventa una superficie che cambia a seconda del momento e del dispositivo, e domani anche dello spazio fisico, come racconto in Spatial Shift. Il prodotto che un’azienda deve costruire verso i propri agenti non è più uno schermo, è un contratto: quali operazioni si possono chiedere, con quali permessi, con quali garanzie sul risultato.
Il Model Context Protocol è oggi la forma più diffusa di quel contratto, e il motivo per cui lo strato sei della tabella è diventato progettabile da un’azienda di medie dimensioni senza un esercito di sviluppatori. Un server MCP espone gli strumenti di un sistema a qualunque client compatibile, e lo stesso server serve il dipendente che usa un assistente commerciale, il collega che preferisce un client locale e l’agente notturno che prepara i report del lunedì. La regola che tengo ferma in ogni progetto riguarda l’identità: il modello opera sempre con i permessi reali della persona che lo sta usando, mai con un’utenza tecnica capace di tutto.
C’è un test semplice per capire a che punto è un’azienda, e lo propongo spesso nelle prime riunioni.
Se domani i dipendenti cambiassero assistente, quanto lavoro andrebbe rifatto?
Quando la logica vive nei prompt salvati dentro il prodotto di un fornitore, nelle sue memorie e nei suoi agenti preconfigurati, va rifatto quasi tutto. Quando vive negli strati dal tre al sei, il cambio è una configurazione, e la scelta dell’assistente torna a essere una decisione su costo e riservatezza.
C’è un lavoro enorme da fare ed è sottovalutato
Nelle dimostrazioni un agente risponde in pochi secondi a una domanda sul portafoglio clienti, prepara una bozza di offerta e propone il prossimo passo commerciale. In produzione lo stesso agente deve sapere che la parola “cliente” ha tre significati in tre uffici, non deve leggere i margini se la persona che lo interroga non è autorizzata a vederli, deve lasciare traccia di quello che ha fatto e deve fermarsi quando la confidenza è bassa. Tutto questo vive in due strati che nelle demo non si vedono, il contesto e l’harness, ed è lì che passa la maggior parte del tempo di un progetto serio.
Sul contesto ho scritto molto in queste settimane, e nelle aziende lo riduco a una regola: il significato va deciso prima che lo decida un modello. Un modello collegato a dati senza tipi e senza relazioni dichiarate ricostruisce da solo il senso delle cose, ogni volta in modo leggermente diverso, e due risposte alla stessa domanda a una settimana di distanza smettono di coincidere. Un’ontologia operativa fissa i tipi di oggetto, le relazioni e le azioni ammesse su ciascuno, e ha un effetto collaterale che i direttori finanziari capiscono subito: riduce i token che un agente spende per orientarsi. Lo stesso vale per la quantità di materiale che si carica nella finestra di contesto, dove il superfluo compete con quello che serve invece di essere scartato.
L’harness è lo strato su cui i fornitori sono più indietro, e lo dicono loro stessi. In almeno uno degli annunci più ambiziosi di quest’autunno, governo e sicurezza compaiono fra le capacità della piattaforma con l’annotazione che sono in parte ancora da costruire. La parte del sistema che decide cosa può fare un agente senza chiedere, chi lo verifica e cosa rimane scritto dopo è quindi la meno matura nelle offerte chiavi in mano, e quella che chi costruisce un’azienda agentica ha più interesse a progettare in casa.
Nei progetti la scrivo prima degli agenti, con quattro famiglie di regole. I permessi sugli strumenti hanno tre livelli, negato, consentito con conferma, consentito senza conferma, e ogni strumento nasce al livello più restrittivo. Le scritture passano da un’approvazione umana: il modello propone, le persone firmano, e nessuna informazione entra nella memoria aziendale senza un responsabile con nome e cognome. Tutto quello che si può verificare in modo deterministico va tolto al giudizio del modello e affidato a uno script, dal totale di un preventivo alla validità di un pacchetto di modifiche. E ogni chiamata lascia una riga in un registro leggibile, con chi l’ha chiesta, quale modello l’ha eseguita e quali dati sono usciti dal perimetro.
Chi possiede gli strati bassi
Ogni volta che un agente lavora, il contesto viene assemblato e spedito al modello. Quel pacchetto contiene il distillato più prezioso che un’azienda produce: il modo in cui classifica i clienti, le decisioni prese e le ragioni per cui sono state prese, le relazioni fra persone, contratti e progetti. Nella torre dei grandi fornitori quel distillato viaggia verso un data center che non controlli, con le garanzie del contratto che hai firmato, a un prezzo calcolato a token che può cambiare alla prossima revisione del listino, su modelli che il fornitore può ritirare con qualche mese di preavviso. Sono condizioni accettabili per molte classi di dati, a patto di conoscerle prima della firma, cosa che capita molto meno spesso di quanto si pensi.
La sovranità di cui parlo con le aziende è una scelta per classe di dati, senza ideologia contro il cloud.
Il metodo che uso divide le informazioni in tre gruppi: quelle che possono uscire liberamente, come ricerche pubbliche e bozze di contenuti, quelle interne che possono uscire solo verso fornitori con garanzie contrattuali adeguate, quelle che non devono uscire per nessun motivo, come i dati economici riservati o i segreti industriali. Ai primi due gruppi si applica il modello più capace disponibile, al terzo un modello che gira dentro il perimetro, oppure un passaggio di anonimizzazione prima dell’invio.
Per molto tempo il terzo gruppo ha avuto poche soluzioni pratiche, perché i modelli aperti erano lontani da quelli commerciali e farli girare richiedeva competenze che un’azienda media non aveva in casa. Oggi lo strato zero si può possedere.
LocalAI, il progetto open source di inferenza locale di cui sono cofondatore e dove seguo il prodotto, nasce esattamente per questo: fa girare modelli aperti su hardware aziendale, dal server nel seminterrato alla workstation di un reparto, ed espone un’interfaccia di programmazione compatibile con quella dei principali fornitori commerciali. Gli strati che stanno sopra non si accorgono del cambio, e un’azienda può affiancare un modello locale a uno commerciale e smistare le chiamate in base alla classe del dato, senza riscrivere né il contesto né gli agenti.
L’azienda agentica che ne esce è ibrida quasi sempre, a mio avviso, e va bene così. Quello che cambia rispetto alla torre comprata intera è la posizione del cuore: ontologia, memoria, regole e registri restano dentro l’azienda, e il modello diventa un lettore che si può sostituire, affiancare o spegnere senza perdere nulla. Cambiare fornitore smette di essere un progetto di migrazione e diventa una riga di configurazione.
“Gideon” come banco di prova
Prima di proporre un’architettura a un’azienda la provo su di me. Gideon è il mio assistente personale, prende il nome dall’intelligenza artificiale di The Flash (Jarvis è troppo abusato ormai, anche io lo chiamavo così), e in questi mesi è diventato il posto dove verifico ogni strato della tabella con dati veri, i miei. Il principio di progettazione è lo stesso che porto nelle aziende: la memoria sta fuori dal modello, e il modello si può cambiare in qualunque momento.
Le funzioni su cui sto lavorando seguono gli strati quasi uno per uno. Gideon fa girare modelli locali e può affiancare modelli esterni quando il compito lo richiede, e già questo sposta la proprietà dello strato zero. Il lavoro parte da cartelle collegate e file caricati, perché la domanda più frequente che una persona fa a un assistente riguarda i propri documenti, e quei documenti devono essere interrogabili senza uscire dalla macchina. I connettori MCP, che sono la sua esposizione verso il resto del mondo, sono divisi in tre famiglie (interni all’assistente, servizi aziendali, servizi di terze parti) e per ciascuno il sistema propone una descrizione di quando usarlo, che l’utente può correggere.
L’harness è la parte dove ho investito di più. Ogni strumento ha i tre livelli di permesso, dal divieto all’esecuzione senza conferma. Una protezione della riservatezza si attiva nel campo dove si scrive la richiesta e lavora anche quando la richiesta va verso un modello esterno, togliendo dal testo quello che non deve uscire. E una pagina sullo stato del sistema mostra i consumi, le chiamate e soprattutto le uscite di dati verso terzi e verso i connettori, perché un’azienda che non sa cosa è uscito ieri non può decidere cosa far uscire domani.
Nessuna di queste funzioni è una scoperta. Ognuna esiste già da qualche parte, sparsa fra prodotti diversi, e quello che manca quasi sempre è la loro composizione in un unico sistema dove il cuore rimane in mano a chi lo usa. Gideon serve a me per capire quanto costa questa composizione, dove si inceppa e quali scelte sopravvivono al passaggio da una persona a un team.
Come accompagno un’azienda dentro lo stack
Il lavoro con le aziende comincia quasi sempre da una richiesta che sta in cima alla torre: quale assistente comprare, come portare gli agenti nel servizio clienti, come far parlare il CRM con la chat aziendale. La prima cosa che faccio è rimettere la torre in piedi, e disegnare con il team la mappa dei suoi otto strati com’è oggi. Per ogni strato scriviamo chi ne è proprietario, quale contratto espone allo strato superiore e se si potrebbe sostituire senza toccare gli altri. Le mappe che ne escono si somigliano spesso: i sistemi di registro esistono e funzionano, la logica di dominio è per metà nel software e per metà nelle persone, il contesto manca, l’harness manca, l’interfaccia è stata già comprata da qualcuno.
Da lì il percorso sale dal basso.
La classificazione dei dati nei tre gruppi viene per prima, perché decide cosa si può fare allo strato zero e quali modelli possono leggere cosa. Poi la regola del sistema proprietario per ogni dato, e un’ontologia minima che fissa i tipi di oggetto, le relazioni e chi decide quando due fonti si contraddicono. Poi l’harness, scritto prima che esista un solo agente in produzione: permessi, approvazioni, verifiche automatiche, registro delle azioni. Solo a quel punto si espongono i sistemi attraverso server MCP con i permessi reali delle persone, si costruiscono le skill condivise che fanno parlare a tutti gli assistenti la stessa lingua aziendale, e si sceglie l’interfaccia, spesso più d’una, guardando dove le persone lavorano già.
In ZeroFive.AI questo percorso è organizzato in cinque fasi, ALIGN, ASSESS, ARCHITECT, ACTIVATE e AMPLIFY (come si vede nell’immagine), con cancelli decisionali fra l’una e l’altra che il cliente deve superare prima di spendere nella fase successiva.
Il rischio legato all’AI si misura nella fase di valutazione e non a sistema già acceso, e nessun caso d’uso entra nel portafoglio senza un confronto scritto con l’alternativa che non usa l’intelligenza artificiale, perché in una parte dei casi uno script ben fatto risolve lo stesso problema a una frazione del costo.
Il “Workspace progetti” per esempio, la piattaforma con cui gestiamo i progetti dei clienti in ICONICO e Zerofive, è il caso che porto come esempio in aula per far vedere come facciamo le cose: molte delle regole descritte qui, dal sistema proprietario per ogni dato all’approvazione umana delle proposte, sono già in produzione al nostro interno, ed è il modo più rapido per mostrare a un’azienda come funzionano prima che decida se costruire le proprie.
C’è poi la parte che nessun diagramma che di solito non si trova, e cioè le persone.
Il corso che sto portando nelle business school e nei percorsi aziendali è costruito su quattro discipline che corrispondono a 4 zone della torre: prompt engineering per l’interfaccia, context engineering per lo strato del contesto, loop engineering per gli agenti, harness engineering per la cornice che li governa.
Un’azienda che compra uno stack senza avere nessuno capace di ragionare su queste quattro zone si ritrova un sistema che funziona finché funziona, e che nessuno sa correggere quando cambia qualcosa e che soprattutto nessuno sa avere potenzialità più avanzate.
Chi vuole capire da dove partire nella propria organizzazione può scrivermi: la prima mappa degli otto strati si costruisce insieme alle persone che conoscono davvero i sistemi, e dice già molto su quali investimenti fatti finora sono riutilizzabili e quali andranno rifatti.
Fondamenta da tenere in casa
Nei prossimi due anni l’interfaccia cambierà più volte.
Gli assistenti di oggi verranno rinominati, accorpati, sostituiti da altri che ancora non conosciamo, e una parte del lavoro passerà dalla chat alla voce e agli ambienti.
Un’azienda agentica che avrà costruito in casa il contesto, l’harness e l’esposizione dei propri sistemi cambierà assistente con la stessa facilità con cui oggi si cambia browser, e sceglierà ogni volta il modello più adatto alla classe di dati che deve trattare.
Chi avrà comprato la torre intera tratterà ogni anno con il fornitore il prezzo di accesso al proprio contesto, cioè alla descrizione più accurata di sé che abbia mai prodotto. La torre la disegneranno i fornitori, ed è giusto che sia così; le fondamenta conviene che ogni azienda le tenga a casa propria.