Azienda agentica: gli otto strati da progettare prima dell’interfaccia

Da prima di agosto ho messo da parte, uno dopo l’altro, gli schemi con cui i grandi fornitori di software aziendale raccontano la loro offerta di intelligenza artificiale, per studiarli: quello di uno dei CRM più diffusi, quello della suite d’ufficio che quasi tutti abbiamo sul portatile, quelli delle piattaforme verticali per la logistica e la distribuzione e così via. Cambiano i nomi, cambiano i colori, a volte i prodotti cambiano nome da un mese all’altro e chi prova a seguirli fatica a capire cosa sia stato annunciato e cosa porta veramente di differente sul mercato.

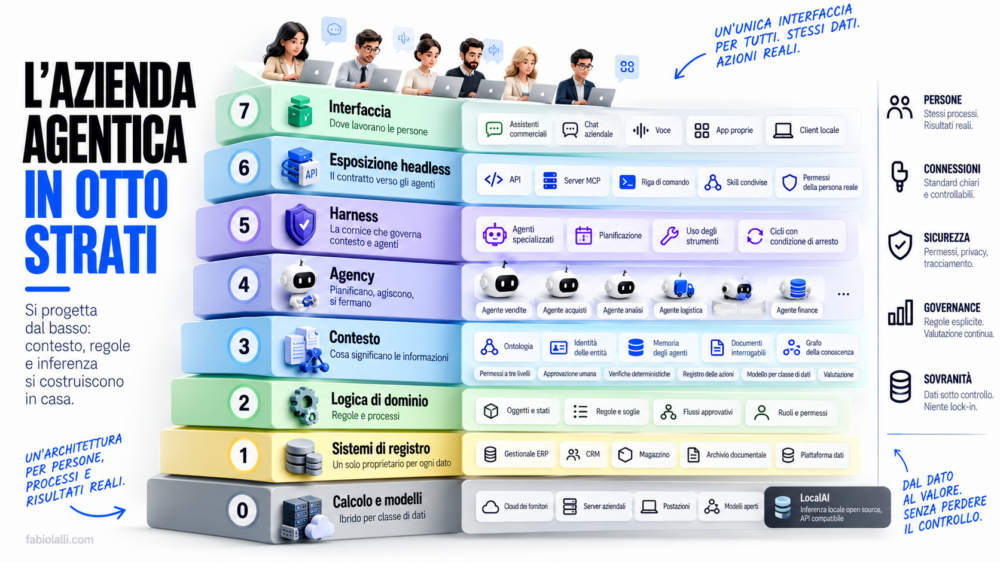
Messi uno accanto all’altro, però, disegnano la stessa torre, e ognuno a modo suo descrive l’azienda agentica.

In basso ci sono i sistemi dove vive la verità aziendale, sopra di loro uno strato che trasforma i dati in contesto leggibile da un modello, sopra ancora gli agenti che ragionano e agiscono, e in cima un’interfaccia conversazionale dove le persone fanno domande e approvano azioni.

Attorno a tutto, disegnato come una cornice e quasi mai come un piano, l’insieme di servizi che nessuno compra a parte, che spesso vanno decisi e scritti proprio internamente e che, però, tiene in piedi la costruzione: permessi, sicurezza, tracciamento delle azioni, valutazione dei risultati.

La torre descrive bene dove stanno andando le aziende dal mio punto di vista.

Gli schemi lasciano fuori, perché a chi li disegna conviene darlo per scontato, una domanda molto specifica e importante: chi possiede gli strati bassi?

Dove gira il modello, dove viene assemblato il contesto, chi può leggere il registro di quello che gli agenti hanno fatto.

Su questa domanda ho costruito il lavoro di questo ultimo anno da quando ho fondato ZeroFive.AI e che sto portando nei progetti con le aziende, con LocalAI sull’inferenza locale e con Gideon, l’ultimo nato, l’assistente che uso ogni giorno come banco di prova. In questo approfondimento provo a descrivere in modo puntuale e sintetico (nemmeno troppo) l’approccio per intero, senza marchi di fornitori, perché questa architettura dell’azienda agentica vale anche per chi non comprerà mai una licenza da nessuno di loro.

Otto strati dell’azienda agentica, letti dal basso

La versione astratta della torre, quella che vale per qualunque azienda agentica, ha 8 strati. Li descrivo partendo dal basso perché è l’ordine in cui andrebbero progettati, anche se quasi tutti i progetti che incontro partono dall’alto, dalla scelta dell’assistente da comprare per i dipendenti, o dal modello o dalla tecnologia in generale.

Strato Cosa contiene Domanda da fare prima di costruirlo
0. Calcolo e modelli dove gira l’inferenza: cloud, server aziendali, postazioni quali dati possono raggiungere quale modello?
1. Sistemi di registro gestionale, CRM, archivi documentali, magazzino per ogni dato, qual è l’unico sistema proprietario?
2. Logica di dominio oggetti, regole, flussi approvativi, permessi quali regole oggi stanno solo nella testa di qualcuno?
3. Contesto identità delle entità, ontologia, memoria degli agenti, testi vettorizzati cosa significano le informazioni e chi lo decide?
4. Agency ragionamento, pianificazione, agenti specializzati, cicli di esecuzione quali compiti si delegano e con quale condizione di arresto?
5. Harness governo, sicurezza, osservabilità, valutazione, scelta del modello cosa può fare un agente senza chiedere, e chi lo verifica?
6. Esposizione headless API, server MCP, riga di comando, skill quale contratto vede chi sta sopra?
7. Interfaccia assistenti commerciali, chat aziendali, voce, app proprie dove lavorano già le persone?

Lo strato zero è quello che nessuno compra e tutti pagano. Nella torre dei fornitori coincide con il loro cloud e non compare quasi mai nei disegni, eppure decide dove finisce ogni frase che un agente legge, e quanto costa leggerla.

Sopra stanno i sistemi di registro, che le aziende conoscono da trent’anni e che con l’arrivo degli agenti chiedono una sola regola, la più difficile da rispettare: ogni dato ha un solo sistema proprietario, e tutti gli altri lo citano invece di copiarlo. Un’anagrafica cliente duplicata in due posti produce, dopo pochi mesi, due verità su chi decide in quell’azienda, e un modello che le legge entrambe sceglie a caso quale riportare.

La logica di dominio è lo strato che trasforma i dati in processi. Un ordine ha uno stato, uno sconto oltre una certa soglia richiede una firma, un fornitore nuovo passa da una verifica prima di ricevere il primo pagamento. Molte di queste regole vivono nel codice dei gestionali, molte altre in procedure che qualcuno ha scritto anni fa, e una parte consistente solo nell’abitudine di chi fa quel lavoro da tanto tempo. Il modello dati è una teoria dell’azienda, e gli agenti la ereditano così com’è, con le scelte fatte da un consulente dieci anni fa per far quadrare la contabilità analitica.

Il contesto è lo strato dove l’azienda dice a un modello cosa significano le sue informazioni: che “cliente” in amministrazione vuol dire chi ha una fattura aperta e in commerciale chi ha un’opportunità attiva, che due nomi diversi indicano la stessa persona, quale decisione presa in una riunione di marzo ha superato quella di gennaio. Qui stanno l’ontologia, la risoluzione delle identità, la memoria di lungo periodo degli agenti e il testo dei documenti reso interrogabile. Sopra lavora l’agency, cioè la parte che pianifica, sceglie gli strumenti, esegue e controlla il risultato in un ciclo che si ripete finché non scatta una condizione di arresto.

L’harness ha un numero in tabella per comodità, ma nel disegno andrebbe tracciato come una cornice attorno al contesto e agli agenti. È tutto quello che serve a un agente in produzione e che non è il modello: i permessi con cui agisce, le regole che decidono quando deve chiedere, il registro di quello che ha fatto, le verifiche automatiche sui risultati, la scelta di quale modello usare per quale classe di dati.

Sopra ancora c’è l’esposizione headless, che rende disponibile tutto quello che sta sotto senza bisogno di uno schermo, attraverso API, server MCP, riga di comando e skill.

In cima l’interfaccia, che grazie ai due strati precedenti può essere quasi qualunque cosa.

L’interfaccia esce dal centro del progetto

Per vent’anni il software aziendale ha coinciso con il suo schermo. Si comprava una licenza per ogni postazione, si formavano le persone sull’interfaccia, si misurava l’adozione contando quanti accessi faceva ciascuno ogni settimana, e il fornitore teneva il cliente proprio attraverso quell’abitudine visiva: cambiare CRM voleva dire riaddestrare centinaia di persone a cliccare in posti diversi. Il valore stava sopra, nell’interfaccia, e i dati sotto erano il prezzo da pagare per usarla.

Nell’azienda agentica questo rapporto si rovescia. Le persone lavorano dentro l’assistente che preferiscono, un client commerciale, la chat aziendale, la voce in macchina, e chiedono a quell’assistente di andare a prendere le informazioni dove si trovano e di agire per loro conto. In Pelle Digitale avevo provato a descrivere l’interfaccia come il punto di contatto fra la persona e il sistema digitale che la circonda; con gli agenti quel punto si moltiplica e si assottiglia, diventa una superficie che cambia a seconda del momento e del dispositivo, e domani anche dello spazio fisico, come racconto in Spatial Shift. Il prodotto che un’azienda deve costruire verso i propri agenti non è più uno schermo, è un contratto: quali operazioni si possono chiedere, con quali permessi, con quali garanzie sul risultato.

Il Model Context Protocol è oggi la forma più diffusa di quel contratto, e il motivo per cui lo strato sei della tabella è diventato progettabile da un’azienda di medie dimensioni senza un esercito di sviluppatori. Un server MCP espone gli strumenti di un sistema a qualunque client compatibile, e lo stesso server serve il dipendente che usa un assistente commerciale, il collega che preferisce un client locale e l’agente notturno che prepara i report del lunedì. La regola che tengo ferma in ogni progetto riguarda l’identità: il modello opera sempre con i permessi reali della persona che lo sta usando, mai con un’utenza tecnica capace di tutto.

C’è un test semplice per capire a che punto è un’azienda, e lo propongo spesso nelle prime riunioni.

Se domani i dipendenti cambiassero assistente, quanto lavoro andrebbe rifatto?

Quando la logica vive nei prompt salvati dentro il prodotto di un fornitore, nelle sue memorie e nei suoi agenti preconfigurati, va rifatto quasi tutto. Quando vive negli strati dal tre al sei, il cambio è una configurazione, e la scelta dell’assistente torna a essere una decisione su costo e riservatezza.

C’è un lavoro enorme da fare ed è sottovalutato

Nelle dimostrazioni un agente risponde in pochi secondi a una domanda sul portafoglio clienti, prepara una bozza di offerta e propone il prossimo passo commerciale. In produzione lo stesso agente deve sapere che la parola “cliente” ha tre significati in tre uffici, non deve leggere i margini se la persona che lo interroga non è autorizzata a vederli, deve lasciare traccia di quello che ha fatto e deve fermarsi quando la confidenza è bassa. Tutto questo vive in due strati che nelle demo non si vedono, il contesto e l’harness, ed è lì che passa la maggior parte del tempo di un progetto serio.

Sul contesto ho scritto molto in queste settimane, e nelle aziende lo riduco a una regola: il significato va deciso prima che lo decida un modello. Un modello collegato a dati senza tipi e senza relazioni dichiarate ricostruisce da solo il senso delle cose, ogni volta in modo leggermente diverso, e due risposte alla stessa domanda a una settimana di distanza smettono di coincidere. Un’ontologia operativa fissa i tipi di oggetto, le relazioni e le azioni ammesse su ciascuno, e ha un effetto collaterale che i direttori finanziari capiscono subito: riduce i token che un agente spende per orientarsi. Lo stesso vale per la quantità di materiale che si carica nella finestra di contesto, dove il superfluo compete con quello che serve invece di essere scartato.

L’harness è lo strato su cui i fornitori sono più indietro, e lo dicono loro stessi. In almeno uno degli annunci più ambiziosi di quest’autunno, governo e sicurezza compaiono fra le capacità della piattaforma con l’annotazione che sono in parte ancora da costruire. La parte del sistema che decide cosa può fare un agente senza chiedere, chi lo verifica e cosa rimane scritto dopo è quindi la meno matura nelle offerte chiavi in mano, e quella che chi costruisce un’azienda agentica ha più interesse a progettare in casa.

Nei progetti la scrivo prima degli agenti, con quattro famiglie di regole. I permessi sugli strumenti hanno tre livelli, negato, consentito con conferma, consentito senza conferma, e ogni strumento nasce al livello più restrittivo. Le scritture passano da un’approvazione umana: il modello propone, le persone firmano, e nessuna informazione entra nella memoria aziendale senza un responsabile con nome e cognome. Tutto quello che si può verificare in modo deterministico va tolto al giudizio del modello e affidato a uno script, dal totale di un preventivo alla validità di un pacchetto di modifiche. E ogni chiamata lascia una riga in un registro leggibile, con chi l’ha chiesta, quale modello l’ha eseguita e quali dati sono usciti dal perimetro.

Chi possiede gli strati bassi

Ogni volta che un agente lavora, il contesto viene assemblato e spedito al modello. Quel pacchetto contiene il distillato più prezioso che un’azienda produce: il modo in cui classifica i clienti, le decisioni prese e le ragioni per cui sono state prese, le relazioni fra persone, contratti e progetti. Nella torre dei grandi fornitori quel distillato viaggia verso un data center che non controlli, con le garanzie del contratto che hai firmato, a un prezzo calcolato a token che può cambiare alla prossima revisione del listino, su modelli che il fornitore può ritirare con qualche mese di preavviso. Sono condizioni accettabili per molte classi di dati, a patto di conoscerle prima della firma, cosa che capita molto meno spesso di quanto si pensi.

La sovranità di cui parlo con le aziende è una scelta per classe di dati, senza ideologia contro il cloud.

Il metodo che uso divide le informazioni in tre gruppi: quelle che possono uscire liberamente, come ricerche pubbliche e bozze di contenuti, quelle interne che possono uscire solo verso fornitori con garanzie contrattuali adeguate, quelle che non devono uscire per nessun motivo, come i dati economici riservati o i segreti industriali. Ai primi due gruppi si applica il modello più capace disponibile, al terzo un modello che gira dentro il perimetro, oppure un passaggio di anonimizzazione prima dell’invio.

Per molto tempo il terzo gruppo ha avuto poche soluzioni pratiche, perché i modelli aperti erano lontani da quelli commerciali e farli girare richiedeva competenze che un’azienda media non aveva in casa. Oggi lo strato zero si può possedere.

LocalAI, il progetto open source di inferenza locale di cui sono cofondatore e dove seguo il prodotto, nasce esattamente per questo: fa girare modelli aperti su hardware aziendale, dal server nel seminterrato alla workstation di un reparto, ed espone un’interfaccia di programmazione compatibile con quella dei principali fornitori commerciali. Gli strati che stanno sopra non si accorgono del cambio, e un’azienda può affiancare un modello locale a uno commerciale e smistare le chiamate in base alla classe del dato, senza riscrivere né il contesto né gli agenti.

L’azienda agentica che ne esce è ibrida quasi sempre, a mio avviso, e va bene così. Quello che cambia rispetto alla torre comprata intera è la posizione del cuore: ontologia, memoria, regole e registri restano dentro l’azienda, e il modello diventa un lettore che si può sostituire, affiancare o spegnere senza perdere nulla. Cambiare fornitore smette di essere un progetto di migrazione e diventa una riga di configurazione.

“Gideon” come banco di prova

Prima di proporre un’architettura a un’azienda la provo su di me. Gideon è il mio assistente personale, prende il nome dall’intelligenza artificiale di The Flash (Jarvis è troppo abusato ormai, anche io lo chiamavo così), e in questi mesi è diventato il posto dove verifico ogni strato della tabella con dati veri, i miei. Il principio di progettazione è lo stesso che porto nelle aziende: la memoria sta fuori dal modello, e il modello si può cambiare in qualunque momento.

Le funzioni su cui sto lavorando seguono gli strati quasi uno per uno. Gideon fa girare modelli locali e può affiancare modelli esterni quando il compito lo richiede, e già questo sposta la proprietà dello strato zero. Il lavoro parte da cartelle collegate e file caricati, perché la domanda più frequente che una persona fa a un assistente riguarda i propri documenti, e quei documenti devono essere interrogabili senza uscire dalla macchina. I connettori MCP, che sono la sua esposizione verso il resto del mondo, sono divisi in tre famiglie (interni all’assistente, servizi aziendali, servizi di terze parti) e per ciascuno il sistema propone una descrizione di quando usarlo, che l’utente può correggere.

L’harness è la parte dove ho investito di più. Ogni strumento ha i tre livelli di permesso, dal divieto all’esecuzione senza conferma. Una protezione della riservatezza si attiva nel campo dove si scrive la richiesta e lavora anche quando la richiesta va verso un modello esterno, togliendo dal testo quello che non deve uscire. E una pagina sullo stato del sistema mostra i consumi, le chiamate e soprattutto le uscite di dati verso terzi e verso i connettori, perché un’azienda che non sa cosa è uscito ieri non può decidere cosa far uscire domani.

Nessuna di queste funzioni è una scoperta. Ognuna esiste già da qualche parte, sparsa fra prodotti diversi, e quello che manca quasi sempre è la loro composizione in un unico sistema dove il cuore rimane in mano a chi lo usa. Gideon serve a me per capire quanto costa questa composizione, dove si inceppa e quali scelte sopravvivono al passaggio da una persona a un team.

Come accompagno un’azienda dentro lo stack

Il lavoro con le aziende comincia quasi sempre da una richiesta che sta in cima alla torre: quale assistente comprare, come portare gli agenti nel servizio clienti, come far parlare il CRM con la chat aziendale. La prima cosa che faccio è rimettere la torre in piedi, e disegnare con il team la mappa dei suoi otto strati com’è oggi. Per ogni strato scriviamo chi ne è proprietario, quale contratto espone allo strato superiore e se si potrebbe sostituire senza toccare gli altri. Le mappe che ne escono si somigliano spesso: i sistemi di registro esistono e funzionano, la logica di dominio è per metà nel software e per metà nelle persone, il contesto manca, l’harness manca, l’interfaccia è stata già comprata da qualcuno.

Da lì il percorso sale dal basso.

La classificazione dei dati nei tre gruppi viene per prima, perché decide cosa si può fare allo strato zero e quali modelli possono leggere cosa. Poi la regola del sistema proprietario per ogni dato, e un’ontologia minima che fissa i tipi di oggetto, le relazioni e chi decide quando due fonti si contraddicono. Poi l’harness, scritto prima che esista un solo agente in produzione: permessi, approvazioni, verifiche automatiche, registro delle azioni. Solo a quel punto si espongono i sistemi attraverso server MCP con i permessi reali delle persone, si costruiscono le skill condivise che fanno parlare a tutti gli assistenti la stessa lingua aziendale, e si sceglie l’interfaccia, spesso più d’una, guardando dove le persone lavorano già.

In ZeroFive.AI questo percorso è organizzato in cinque fasi, ALIGN, ASSESS, ARCHITECT, ACTIVATE e AMPLIFY (come si vede nell’immagine), con cancelli decisionali fra l’una e l’altra che il cliente deve superare prima di spendere nella fase successiva.

Il rischio legato all’AI si misura nella fase di valutazione e non a sistema già acceso, e nessun caso d’uso entra nel portafoglio senza un confronto scritto con l’alternativa che non usa l’intelligenza artificiale, perché in una parte dei casi uno script ben fatto risolve lo stesso problema a una frazione del costo.

Il “Workspace progetti” per esempio, la piattaforma con cui gestiamo i progetti dei clienti in ICONICO e Zerofive, è il caso che porto come esempio in aula per far vedere come facciamo le cose: molte delle regole descritte qui, dal sistema proprietario per ogni dato all’approvazione umana delle proposte, sono già in produzione al nostro interno, ed è il modo più rapido per mostrare a un’azienda come funzionano prima che decida se costruire le proprie.

C’è poi la parte che nessun diagramma che di solito non si trova, e cioè le persone.

Il corso che sto portando nelle business school e nei percorsi aziendali è costruito su quattro discipline che corrispondono a 4 zone della torre: prompt engineering per l’interfaccia, context engineering per lo strato del contesto, loop engineering per gli agenti, harness engineering per la cornice che li governa.

Un’azienda che compra uno stack senza avere nessuno capace di ragionare su queste quattro zone si ritrova un sistema che funziona finché funziona, e che nessuno sa correggere quando cambia qualcosa e che soprattutto nessuno sa avere potenzialità più avanzate.

Chi vuole capire da dove partire nella propria organizzazione può scrivermi: la prima mappa degli otto strati si costruisce insieme alle persone che conoscono davvero i sistemi, e dice già molto su quali investimenti fatti finora sono riutilizzabili e quali andranno rifatti. 

Fondamenta da tenere in casa

Nei prossimi due anni l’interfaccia cambierà più volte.

Gli assistenti di oggi verranno rinominati, accorpati, sostituiti da altri che ancora non conosciamo, e una parte del lavoro passerà dalla chat alla voce e agli ambienti.

Un’azienda agentica che avrà costruito in casa il contesto, l’harness e l’esposizione dei propri sistemi cambierà assistente con la stessa facilità con cui oggi si cambia browser, e sceglierà ogni volta il modello più adatto alla classe di dati che deve trattare.

Chi avrà comprato la torre intera tratterà ogni anno con il fornitore il prezzo di accesso al proprio contesto, cioè alla descrizione più accurata di sé che abbia mai prodotto. La torre la disegneranno i fornitori, ed è giusto che sia così; le fondamenta conviene che ogni azienda le tenga a casa propria.
L’ontologia che ti lascia cancellare un ordine

Il cruscotto dice che l’ordine 4471 è fermo da sei giorni. Lo guardano il direttore commerciale, il customer care e da qualche mese anche l’agente che presidia gli SLA, tutti sulla stessa dashboard, tutti con lo stesso numero davanti. Per cancellarlo qualcuno deve aprire il gestionale, cercare la riga a mano e sapere che un ordine già uscito dal magazzino non si annulla, si gestisce come reso.

Quella distanza fra il livello dove guardi e il livello dove agisci è il residuo di dieci anni di piattaforme dati. Abbiamo costruito data lake, poi lakehouse, poi semantic layer, e ci siamo ritrovati un’azienda che si vede benissimo e che continua a muoversi dentro i sistemi sorgente, ognuno con le sue regole, scritte in epoche diverse da persone che non si sono mai parlate.

Il primo agosto un ingegnere che firma gura105 ha pubblicato su dev.to il risultato di settimane passate a smontare Palantir Foundry per capire cosa sia davvero quella cosa che in Palantir chiamano Ontology. Ne ha ricavato un nome, ontologia operativa, e quattro proprietà che si possono verificare una per una su qualunque sistema. Poi ha messo su GitHub un’implementazione di riferimento in TypeScript, licenza MIT, piccola abbastanza da leggersi in una sera, con il README anche in giapponese.

Il modello di dominio fuori dall’applicazione

Lo sviluppo di un’applicazione gestionale funziona da sempre nello stesso ordine: raccogli i requisiti, modelli il dominio, crei le tabelle che quel modello richiede, ci costruisci sopra l’applicazione. Foundry, scrive gura105, è quello stesso mestiere eseguito al contrario. I dati fisici esistono già, sono di qualcun altro, nessuno te li ha disegnati addosso, e il modello di dominio arriva dopo, sopra, come strato condiviso da cui pescano tutte le applicazioni. Un’ontologia operativa nasce esattamente da qui, dal prendere atto che i dati non li ha ordinati nessuno per te e che il modello va costruito sopra quello che c’è.

Il rovesciamento sembra un dettaglio di sequenza ed è una scelta di proprietà. Nel modo classico le regole di business vivono dentro l’applicazione che possiede le tabelle, e ogni altro consumatore o le riscrive per conto suo o le scavalca. Chi ha già lavorato su un’integrazione fra CRM e gestionale sa esattamente di cosa parlo: la regola che un ordine spedito non si cancella esiste in tre punti diversi, formulata in tre modi diversi, e almeno uno dei tre è sbagliato.

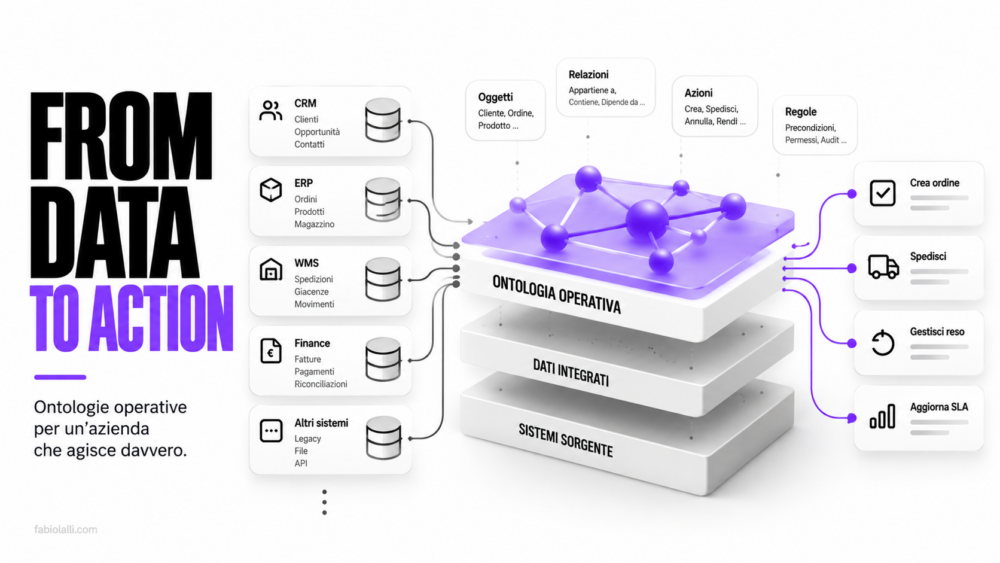
Palantir descrive la sua Ontology come un livello operativo dell’organizzazione che sta sopra gli asset digitali integrati nella piattaforma, e la divide in elementi semantici, cioè oggetti, proprietà e relazioni, ed elementi cinetici, cioè azioni, funzioni e sicurezza dinamica. La parte semantica la conosciamo tutti, è quella di cui ho scritto parlando di ontologie e grafi di conoscenza. La parte cinetica è quella che nessun semantic layer ha mai avuto, e coincide con il motivo per cui Foundry costa quello che costa.

C’è un vantaggio pratico in questa inversione, ed è il motivo per cui la trovo adatta alle aziende italiane più di quanto sembri. Non chiede di migrare niente. Il gestionale del 2011 resta dov’è, con la sua teoria implicita dell’azienda scritta da un consulente che non c’è più, e sopra ci metti un modello che dice cosa significano davvero cliente, ordine e prodotto oggi, senza toccare una riga di quelle tabelle.

Un semantic layer non cancella un ordine

Le quattro proprietà che fanno di un sistema un’ontologia operativa sono un test, non una certificazione, e gura105 le ha scritte in modo che siano verificabili guardando il comportamento di quel sistema invece che la sua brochure.

La prima chiede che oggetti e relazioni siano modellati esplicitamente sopra dati fisici che esistevano prima e che appartengono ad altri. La seconda chiede che lo stato cambi solo attraverso azioni con un nome, senza nessun percorso di aggiornamento generico, né per l’utente né per l’applicazione né per l’agente. La terza chiede che le regole di dominio stiano dentro l’azione, come precondizioni che rifiutano le violazioni con errori leggibili da una macchina, e che ogni tentativo finisca nel registro, compresi quelli respinti. La quarta chiede che il modello dichiari, per ogni pezzo di stato, quale sistema ne è proprietario, e che le modifiche tornino indietro verso quel sistema.

Il test che le riassume sta in una domanda da fare in riunione, dal vostro semantic layer si può cancellare un ordine? Se la risposta è no, avete un livello di lettura, che è una cosa utile e diversa. Se è sì ma nessuna riga cambia in nessun sistema di record, avete un database parallelo che fra sei mesi diverge dal gestionale e nessuno saprà quale dei due ha ragione. Se cancella anche gli ordini già spediti senza fare una piega, avete una write API, e la terza proprietà è tutta la differenza.

Lo scenario del demo è volutamente banale, ed è per questo che funziona. Un’azienda ne compra un’altra e si ritrova due sistemi ordini legacy, schemi diversi, codifiche di stato diverse, la solita eredità che in Italia conosciamo bene dopo ogni operazione straordinaria. Qualche decina di righe di SQL li integra, l’ontologia modella sopra cliente, ordine e prodotto, e aggiunge un tipo che in nessuno dei due sistemi esiste: la nota. Poi il demo attraversa la relazione per rispondere a quali ordini contengono un certo prodotto pescando da entrambi i sistemi, assegna un ordine a una persona scrivendo uno stato che nel legacy non ha nemmeno una colonna, si vede rifiutare la cancellazione di un ordine spedito, ne cancella uno aperto e la riga nell’ERP cambia davvero, poi ricarica le sorgenti e l’assegnazione sopravvive al refresh.

Dal permesso revocabile all’azione che lascia traccia

Ad agosto, commentando la mappa di Fanghua Yu sull’evoluzione dell’ontologia, avevo chiamato permesso revocabile quello che lui chiamava contratto semantico operativo: un agente che sa cos’è un ordine ma non sa se è autorizzato a rimborsarlo conosce metà della storia, e la parte che gli manca è fatta di precondizioni, evidenze, effetti e reversibilità. Quel pezzo si fermava dove finiva il concetto. Questo repository è il primo posto dove lo vedo messo in codice eseguibile, con i rifiuti che portano un codice e il registro che si scrive da solo.

Nel modello, le precondizioni sono una chiave obbligatoria. Una lista vuota va dichiarata, perché scrivere che un’azione non ha condizioni è una decisione che qualcuno deve prendersi, non un default che si eredita per distrazione. La dichiarazione di proprietà segue la stessa logica: ogni pezzo di stato è di qualcuno, e le possibilità sono tre. Quando il dato è mastered a monte, come lo status dell’ordine che vive nell’ERP, la modifica torna indietro verso quel sistema come effetto collaterale governato, e la sorgente conserva l’autorità. Per l’assegnatario o la nota di triage, che nel legacy non hanno nemmeno una colonna dove stare, il sistema di record diventa l’ontologia stessa, per dichiarazione esplicita e non per ripiego. Il terzo caso è lo stato calcolato, che non si scrive mai.

Quello che la proprietà vieta è lo stato senza padrone dichiarato, cioè la copia locale di un dato altrui che viene modificata e non torna mai indietro. È esattamente la situazione in cui si trovano parecchi progetti di data platform che ho visto passare sui tavoli negli ultimi anni, e che nessuno chiama con il suo nome finché non arriva la prima riconciliazione a mano.

Il runtime non si fida delle dichiarazioni, le verifica. Prima di eseguire qualunque azione valida i parametri, valuta le precondizioni, genera il piano di modifiche, lo prova a vuoto passando dallo stesso codice che userà per il commit, poi lo confronta con le dichiarazioni di proprietà e lo rifiuta se un’azione tocca stato del sistema di record senza averlo dichiarato, oppure se ne mescola due tipi nello stesso piano. Solo dopo scrive verso la sorgente, e solo alla fine committa le modifiche e la riga di registro in un’unica transazione.

L’ordine di quei passaggi porta con sé una scelta che va guardata bene. Il write-back gira prima del commit locale, quindi se l’ERP rifiuta non cambia niente da questa parte. Il fallimento opposto può comunque accadere: la sorgente accetta, il commit locale fallisce, i due sistemi divergono e la riconciliazione tocca a un essere umano. Il repository lo scrive in chiaro e aggiunge che la documentazione di Palantir ammette lo stesso buco nella propria modalità di write-back. Quella franchezza sul limite, per me, vale più di metà delle slide di architettura che mi capita di leggere, e andrebbe usata come criterio per valutare chiunque venda qualcosa di simile.

Il registro, intanto, tiene tutto: i tentativi applicati, quelli rifiutati, quelli andati in crash, con il piano completo. Sulla tracciabilità come prova di un’azione automatica torno spesso, e qui il materiale che l’AI Act chiede di saper ricostruire per i sistemi ad alto rischio, con un calendario che il Digital Omnibus ha rimesso in discussione, si produce da sé come sottoprodotto dell’architettura invece che come adempimento aggiunto dopo.

Le regole non stanno nel prompt

La superficie MCP viene generata dal modello. Uno strumento per ogni forma di interrogazione, uno per ogni azione, e nessuno strumento SQL grezzo, il che significa che un agente riceve esattamente le operazioni che il dominio definisce e nient’altro. Le stesse precondizioni che valgono per una persona valgono per lui, e quando prova a cancellare un ordine spedito si prende in faccia un SHIPPED_ORDER_CANNOT_BE_CANCELLED, un rifiuto che può leggere, da cui può recuperare e che può spiegare al suo utente senza inventarsi una scusa.

Vale la pena mettere in fila le alternative, perché è la scelta che in questo momento sta facendo chiunque colleghi un modello ai sistemi aziendali. Con un MCP sul database l’agente legge tabelle e scrive UPDATE senza limiti, e le regole di business stanno nel prompt, cioè da nessuna parte, perché un prompt è una raccomandazione e non un cancello. Con un semantic layer o un MCP di metriche si ottengono letture governate e nessuna scrittura. Con una collezione di wrapper API ogni endpoint applica le regole del backend che ha dietro, in modo diverso dagli altri, e la coerenza la garantisce la speranza. Con un’ontologia operativa le letture sono oggetti e relazioni, le scritture passano solo da azioni con un nome, e le regole stanno nel modello insieme al registro dei tentativi.

Su questo passaggio si gioca una partita che in Italia è appena cominciata. Nei progetti che seguo la richiesta arriva quasi sempre nella stessa forma, collegare un modello al gestionale perché sbrighi da solo le tre o quattro cose ripetitive che oggi occupano una persona a tempo pieno, e la soluzione più rapida da costruire è anche quella più difficile da difendere: un accesso diretto al database con un prompt lungo che spiega cosa non deve fare. Regge la demo, regge qualche settimana in produzione, e cade il giorno in cui un caso limite che nessuno aveva previsto incontra un modello che quella mattina interpreta la raccomandazione in modo un po’ più largo del solito.

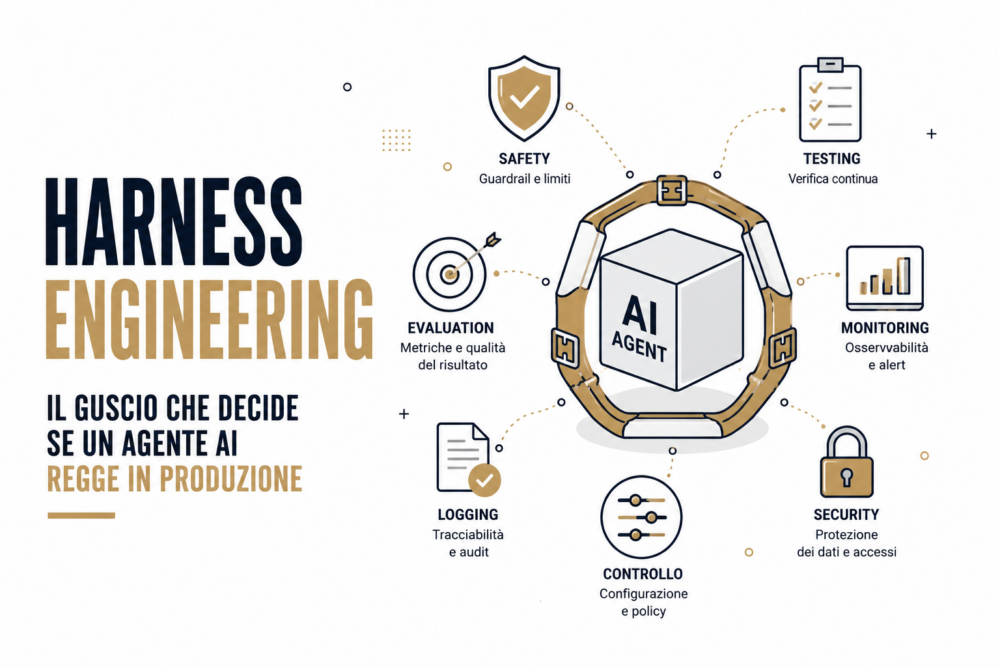
È la stessa cosa che chiamo harness engineering quando parlo del guscio che decide se un agente regge in produzione, portata però al livello dell’azienda intera invece che del singolo workflow. Il guscio smette di essere un file di configurazione scritto da chi ha costruito quell’agente lì e diventa infrastruttura condivisa, la stessa per il cruscotto del direttore commerciale, per lo script del controllo di gestione e per il modello che presidia gli SLA.

Anche le letture portano un’identità: ogni chiamata gira per conto di un attore e le policy di visibilità attaccate al modello decidono cosa quell’attore vede, con un oggetto nascosto che è indistinguibile da uno che non esiste. Sulla parte di autenticazione il repository è disarmante: su stdio tutti i chiamanti collassano in un attore solo, il nome si passa da variabile d’ambiente, ed è etichettatura, non protezione. Dichiarare dove finisce la dimostrazione è la ragione per cui mi fido del resto.

Dove l’ontologia operativa si ferma

La versione zero ha come unico obiettivo la leggibilità, quindi le assenze sono parecchie e sono tutte elencate. Niente cancellazioni, niente proprietà sulle relazioni, niente chiavi composte, nessuna infrastruttura di indicizzazione, nessun costruttore di interfacce. Niente federazione, soprattutto: un’ontologia è un contesto delimitato, e chi possiede il modello quando ce ne sono cinque in cinque divisioni è una domanda vera che il repository dichiara di non affrontare.

L’evoluzione dello schema sta fuori per la stessa ragione, con una scelta che trovo elegante. Il modello è un valore, cioè un pezzo di codice enumerabile, quindi si diffa, si versiona e si revisiona come qualunque altro sorgente, e la governance dello schema viene delegata in blocco a git. Ne esce una separazione netta fra due canali: le istanze si governano a runtime con le azioni e il registro, lo schema si governa in fase di sviluppo con le pull request. Chi in azienda ha il potere di approvare quella pull request ha il potere di ridefinire cosa significa cliente, ed è una carica che nessun organigramma ha mai assegnato formalmente.

C’è poi un default che per un’azienda europea è sbagliato e che il repository dichiara sbagliato per sé: un oggetto senza policy è visibile a chiunque. La dimostrazione non ha autenticazione, quindi fingere di essere chiusi non avrebbe senso, e chi volesse portarlo verso un deployment reale parte dal rendere obbligatoria la visibilità e aggiunge sotto autenticazione vera, permessi sulle azioni e accesso al registro con i suoi confini.

Fuori dallo scopo c’è anche la parte che rende Foundry un prodotto da milioni di euro, cioè l’indicizzazione incrementale, gli indici di adiacenza e i backend di ricerca che servono miliardi di oggetti con tempi di risposta accettabili. Su scala dimostrativa una query ingenua basta, e l’autore lo dichiara senza giri, perché la scala appartiene alle implementazioni e non al pattern. Vale come promemoria per chi legge poche centinaia di righe di TypeScript e crede di avere in mano un sostituto: qui c’è la definizione, non il prodotto che la applica a un’azienda da ventimila persone.

Da qui esce la cosa più riutilizzabile di tutto il lavoro, e la consiglio a chi in questi mesi si trova sul tavolo offerte di piattaforme che si sono ribattezzate ontologie nel giro di un trimestre. Qualunque ontologia operativa deve dichiarare quattro cose: chi possiede ogni pezzo di stato, cosa succede quando la scrittura verso la sorgente riesce e il commit locale no, se le modifiche fatte nell’ontologia sopravvivono a un ricaricamento delle sorgenti, e cosa vede chi non ha nessuna policy addosso. Le quattro risposte possono essere diverse da quelle di questo repository e il sistema rimane dentro il pattern. Quello che non può succedere è che il fornitore non le abbia, perché senza quelle dichiarazioni il permesso revocabile di cui parliamo da mesi non ha niente a cui appoggiarsi.

La domanda che mi è venuta in mente dopo aver letto il codice non riguarda Palantir, e nemmeno la scelta fra costruire e comprare. Riguarda chi oggi dentro un’organizzazione italiana di media dimensione ha oggi l’autorità di dichiarare che lo status di un ordine appartiene all’ERP e l’assegnatario appartiene all’ontologia operativa. È una dichiarazione tecnica nella forma e una delibera nella sostanza, perché stabilisce chi può cambiare cosa e sotto quali condizioni quel permesso continua a valere, che è poi il cuore del permesso revocabile applicato ai sistemi invece che agli agenti. Prima o poi arriva sul tavolo di qualcuno che non l’ha chiesta, nel momento peggiore, sotto forma di due numeri diversi per lo stesso ordine.

Company Brain: come si costruisce il “Jarvis” di un’azienda

Progettare uno spazio di lavoro che un LLM sa leggere

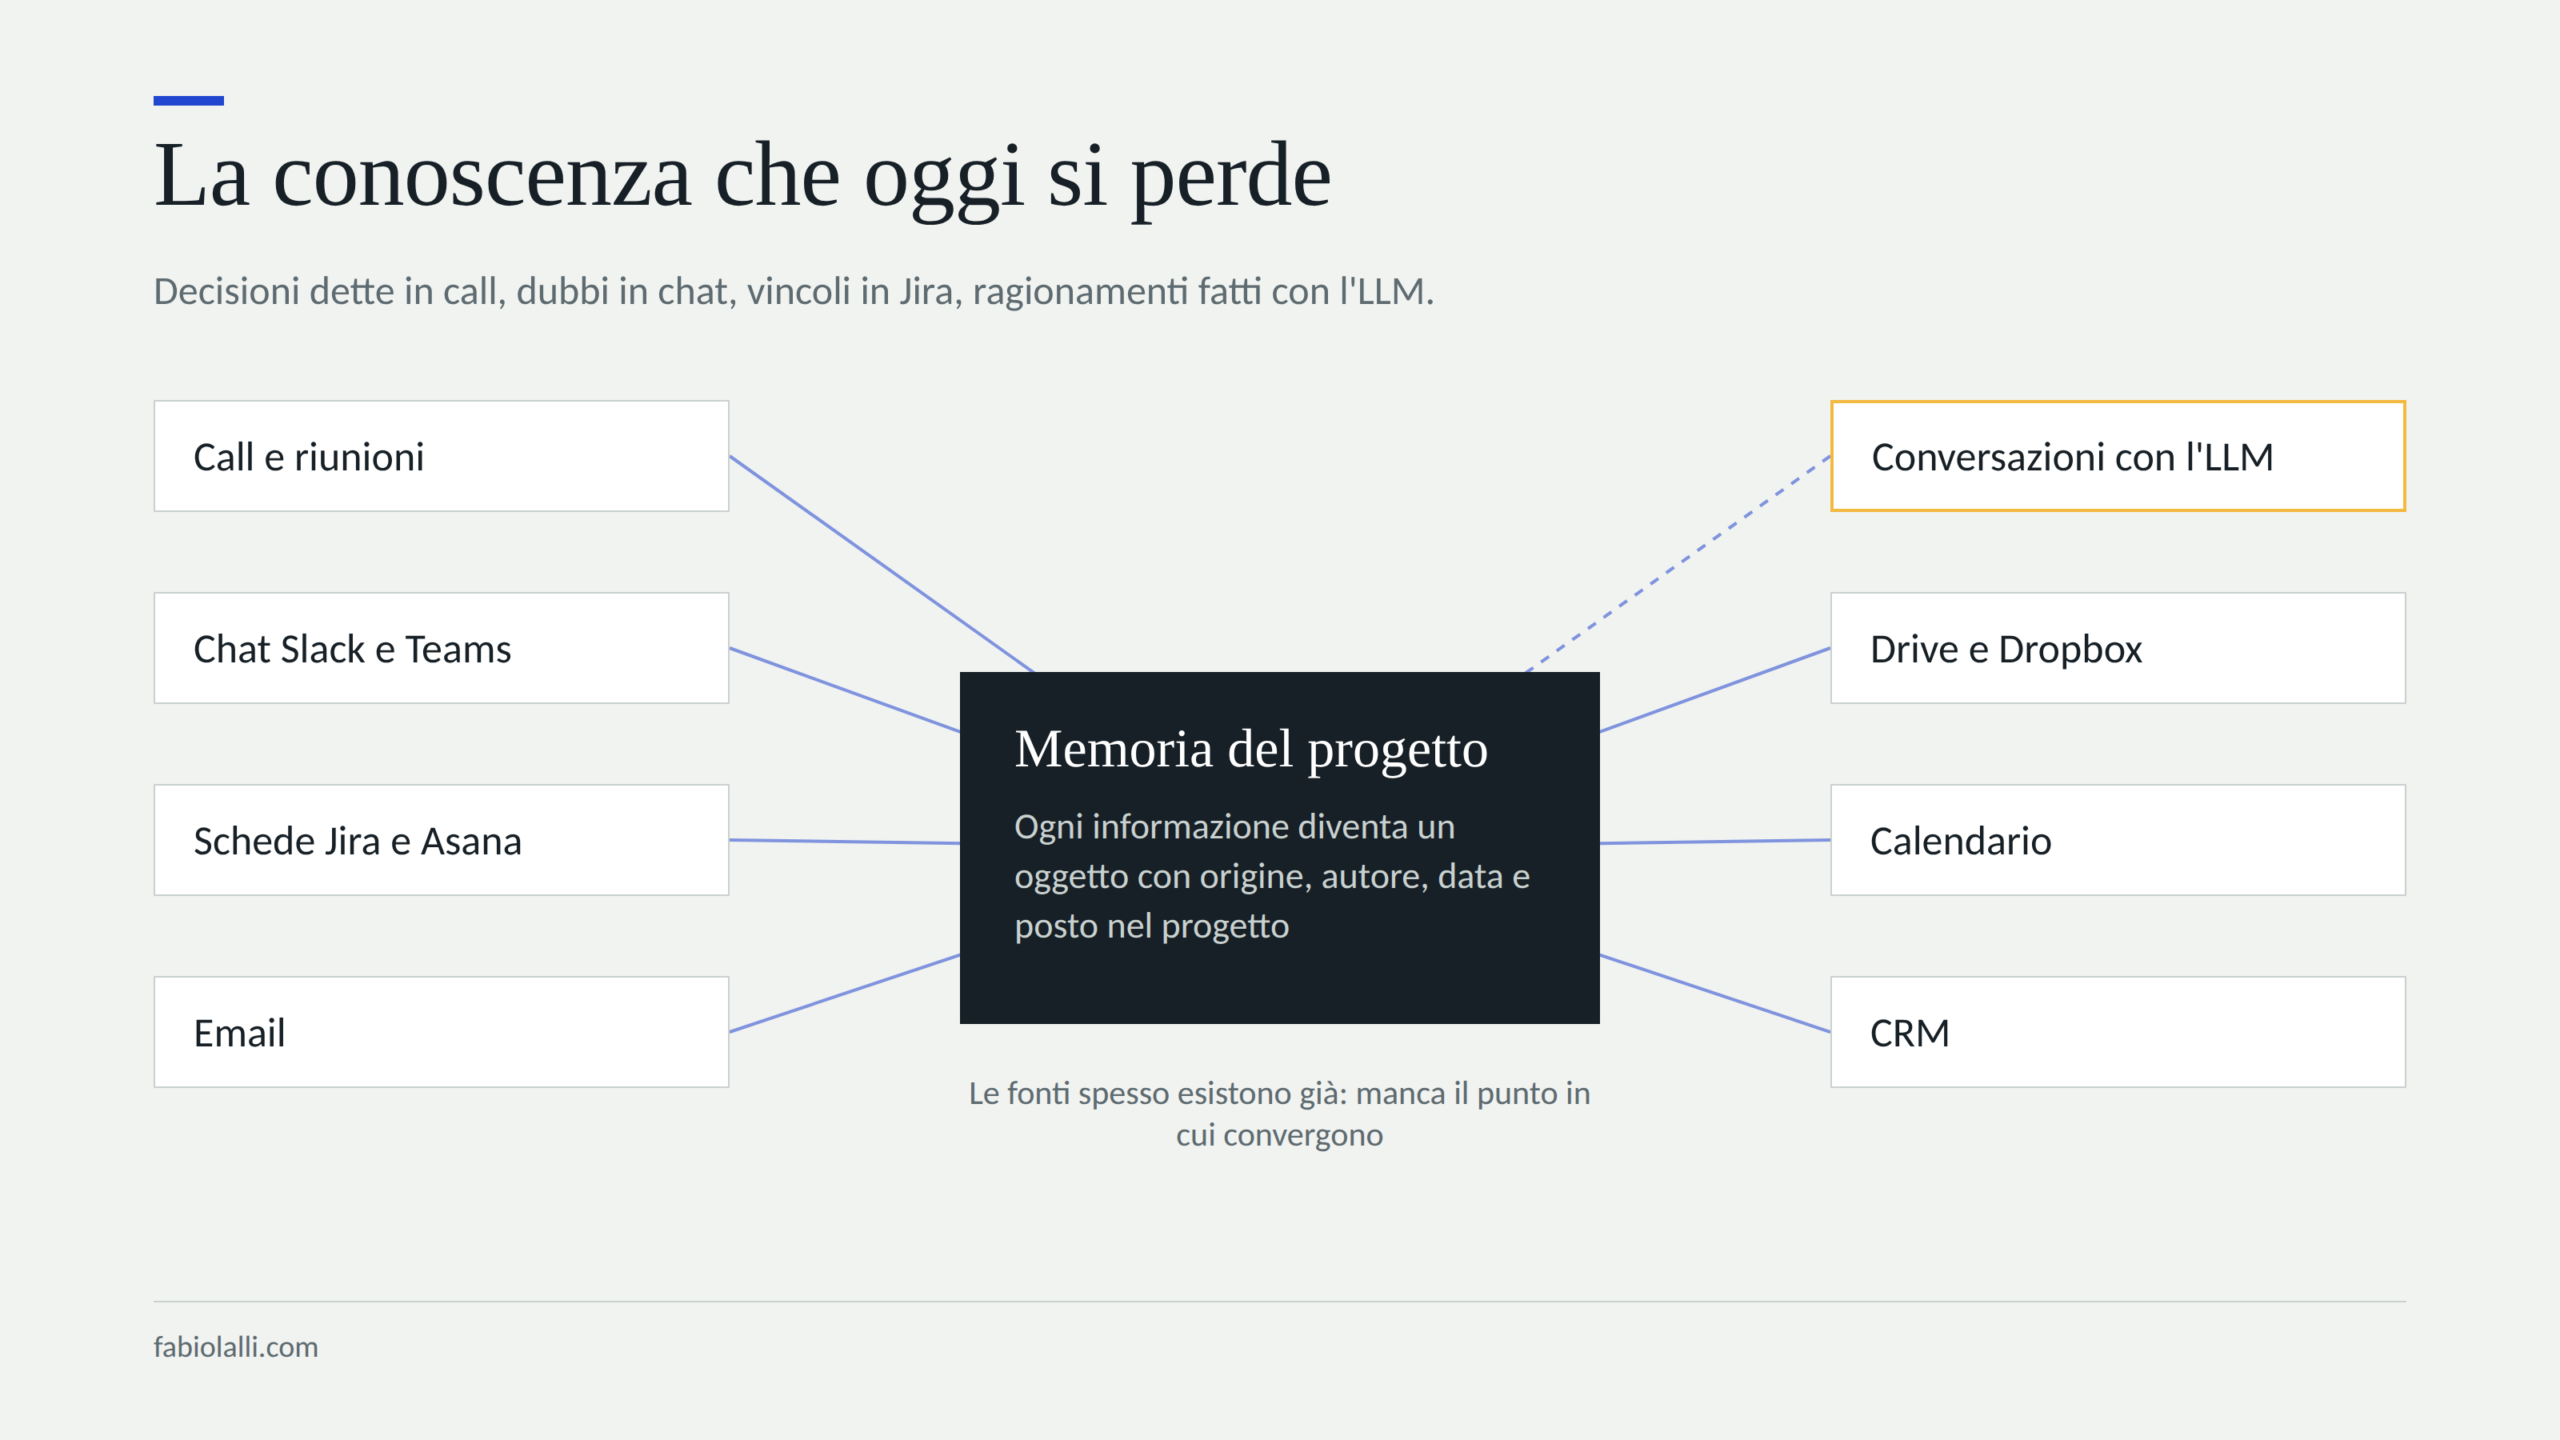
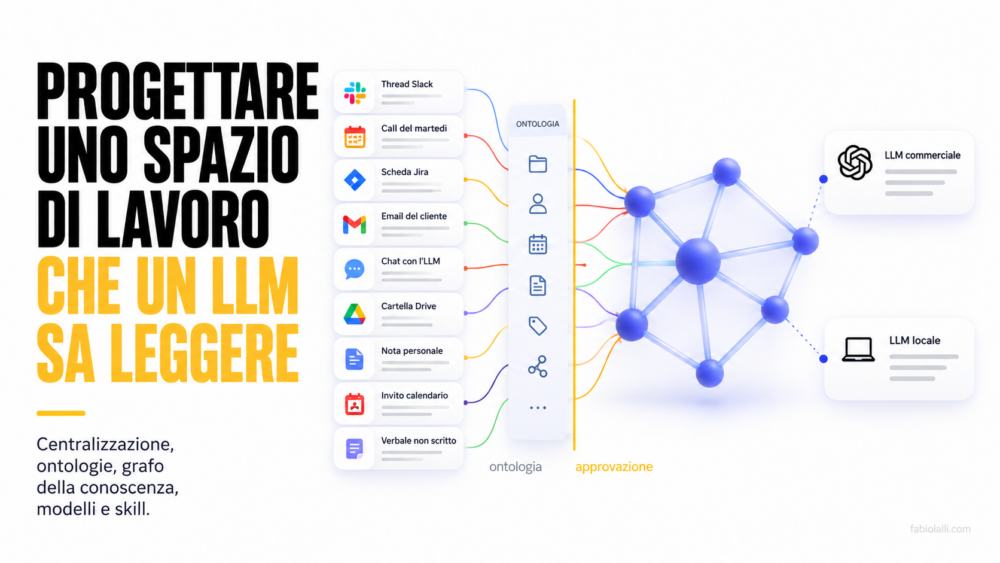
In quasi tutte le aziende che incontro la conoscenza di un progetto vive in sette o otto posti diversi: le registrazioni delle riunioni, le caselle di posta, una cartella condivisa su Drive e un’altra su Dropbox, il calendario, il CRM, i canali Slack o Teams, le schede di Jira o di Asana, le note personali di ciascuno. C’è poi un posto nuovo, che fino a due anni fa non esisteva e oggi contiene una parte rilevante del ragionamento di un team: le conversazioni che ogni persona ha con il proprio assistente AI mentre lavora. Ciascuno di questi posti funziona bene da solo, e nessuno sa dell’esistenza degli altri.

La reazione più diffusa è collegare un LLM a tutte queste fonti e aspettarsi che dal collegamento nasca un’intelligenza del progetto. È l’idea del Jarvis aziendale, che in questi mesi circola con nomi diversi, Company Brain, Brain OS, Company OS: un assistente che sa tutto dell’azienda perché vede tutto. Succede il contrario. Più fonti si collegano senza una struttura che le tenga insieme, più il modello produce risposte plausibili costruite su frammenti, e più diventa difficile capire da dove arriva un’affermazione, chi l’ha verificata e se è ancora vera.

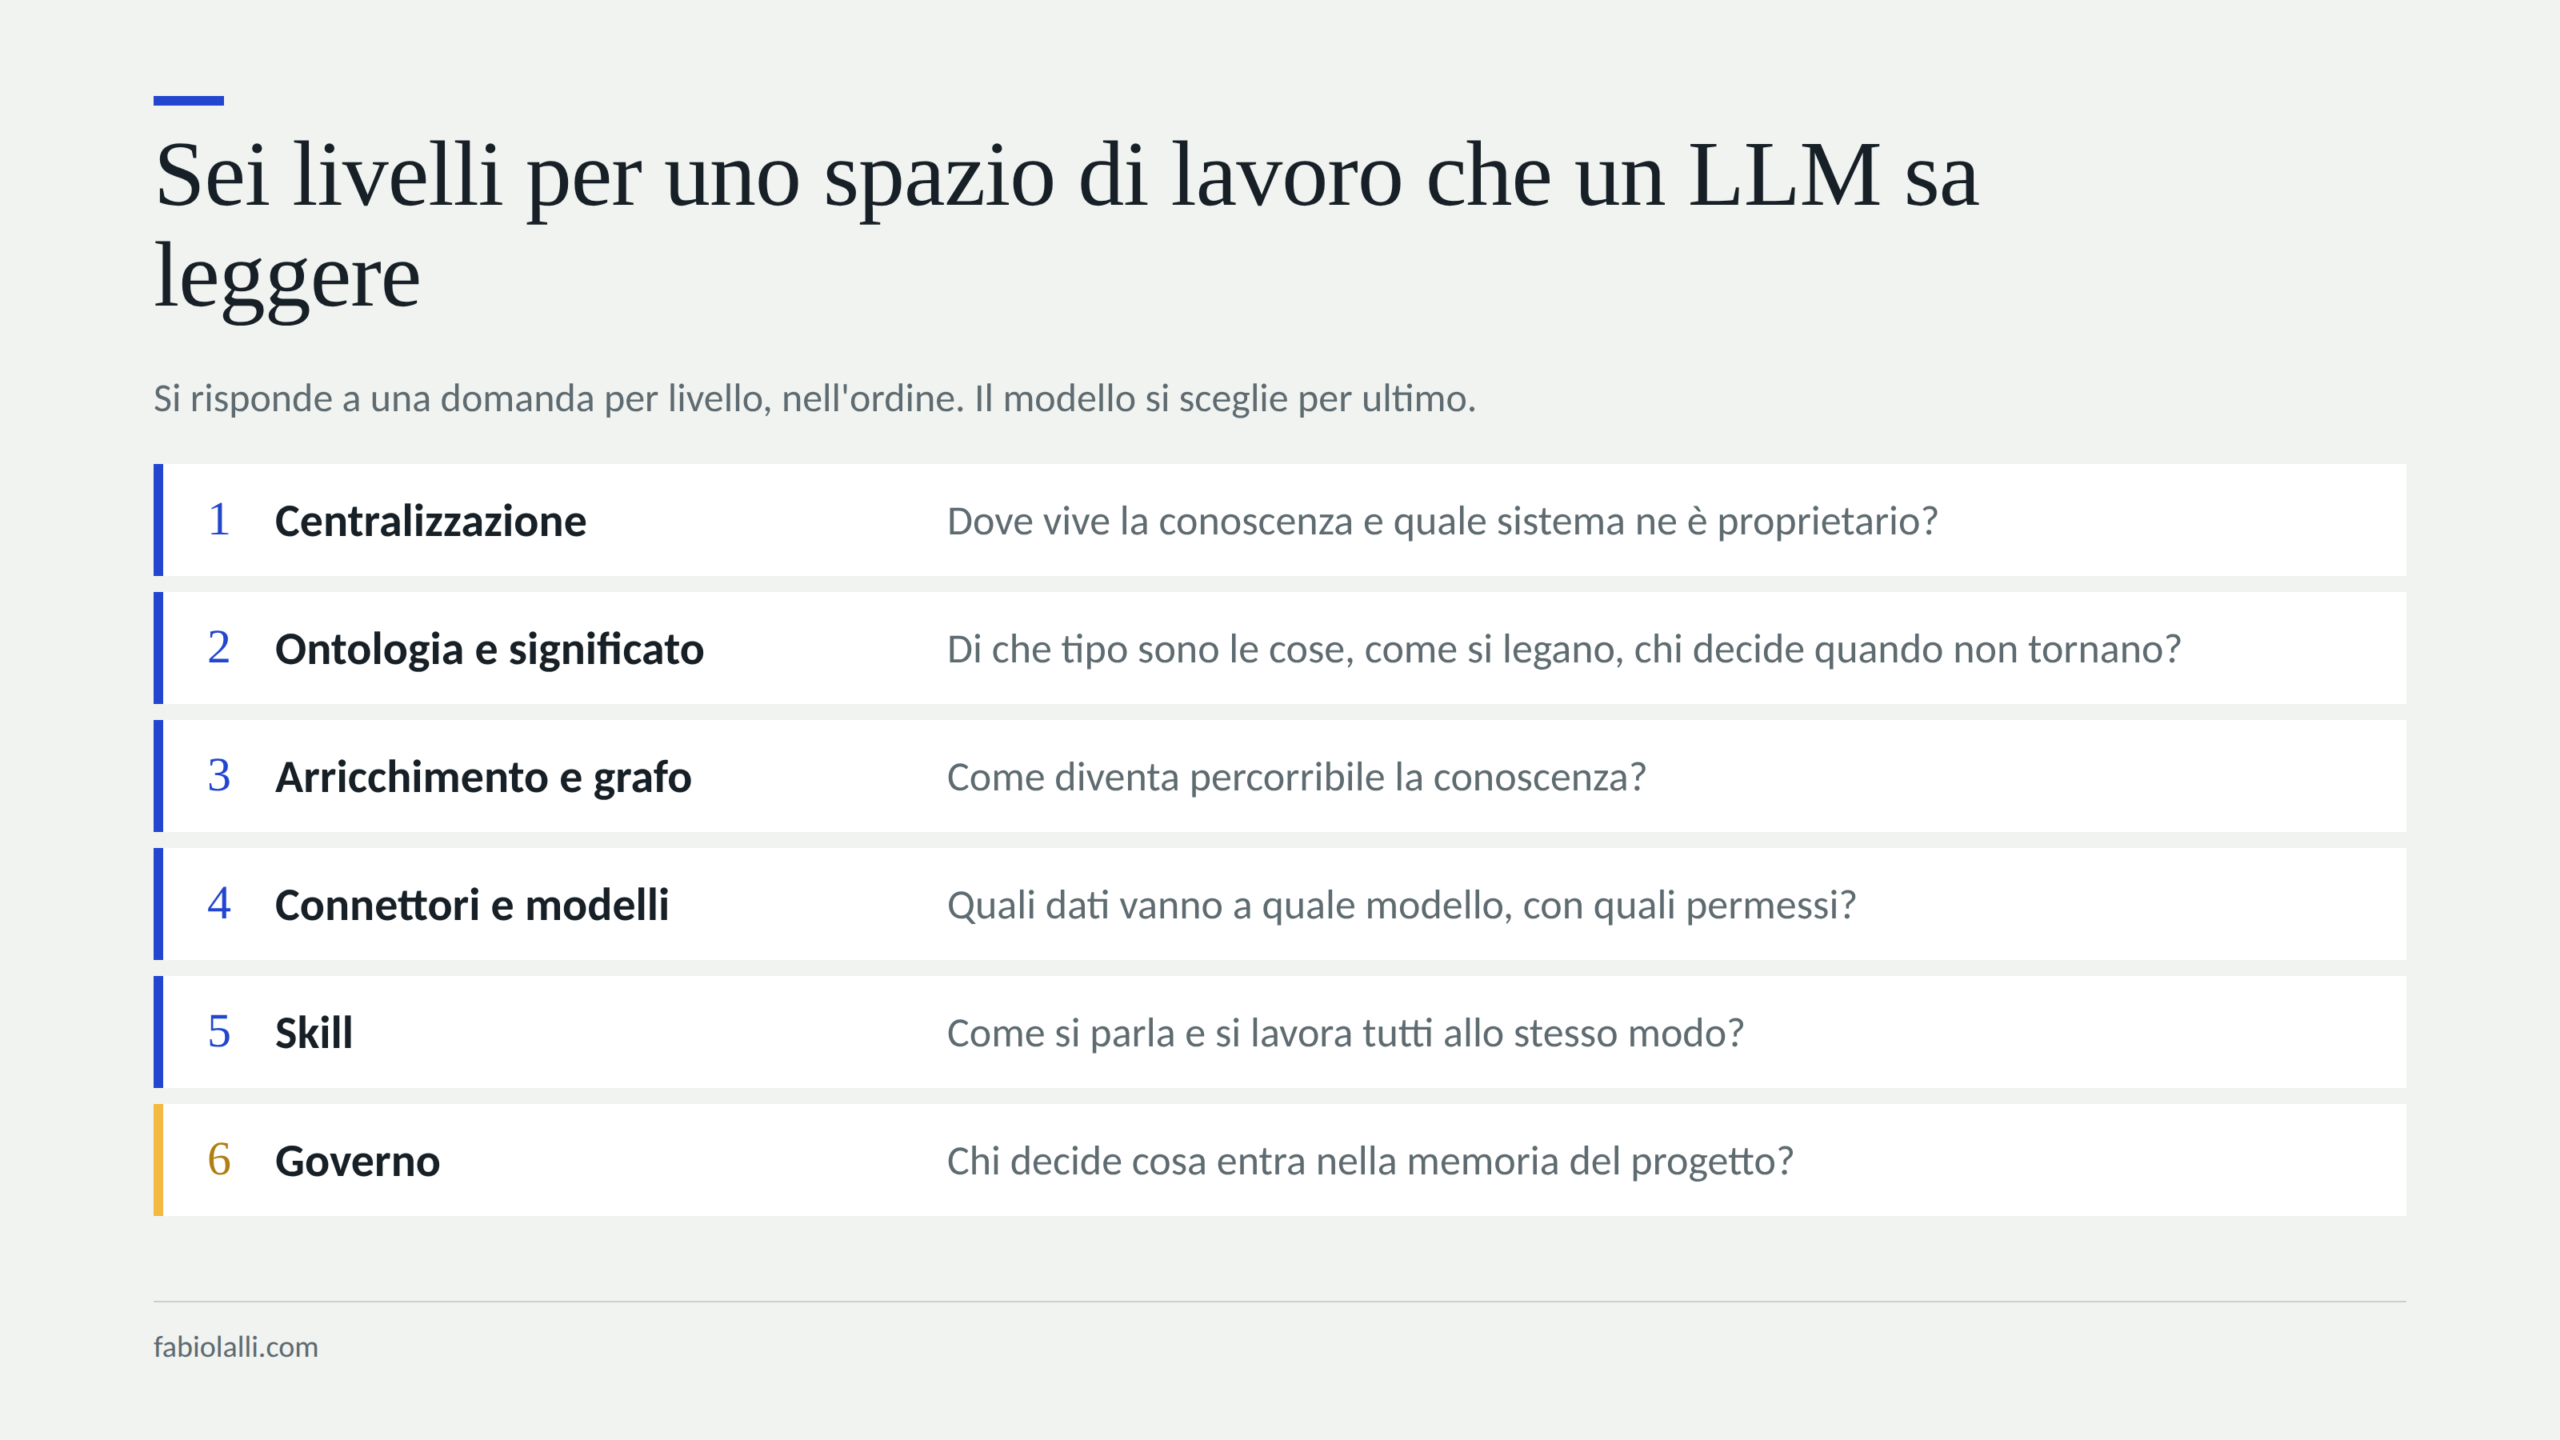
Uno spazio di lavoro intelligente si progetta, e la scelta del modello arriva per ultima. Il metodo che propongo lo divide in sei livelli, ciascuno con una domanda a cui rispondere prima di passare al successivo. Come caso concreto uso il Workspace ICONICO, la piattaforma interna di gestione dei progetti che stiamo costruendo in questi mesi: è ancora giovane, ma ogni scelta descritta qui è già in produzione.

La complessità cambia posto

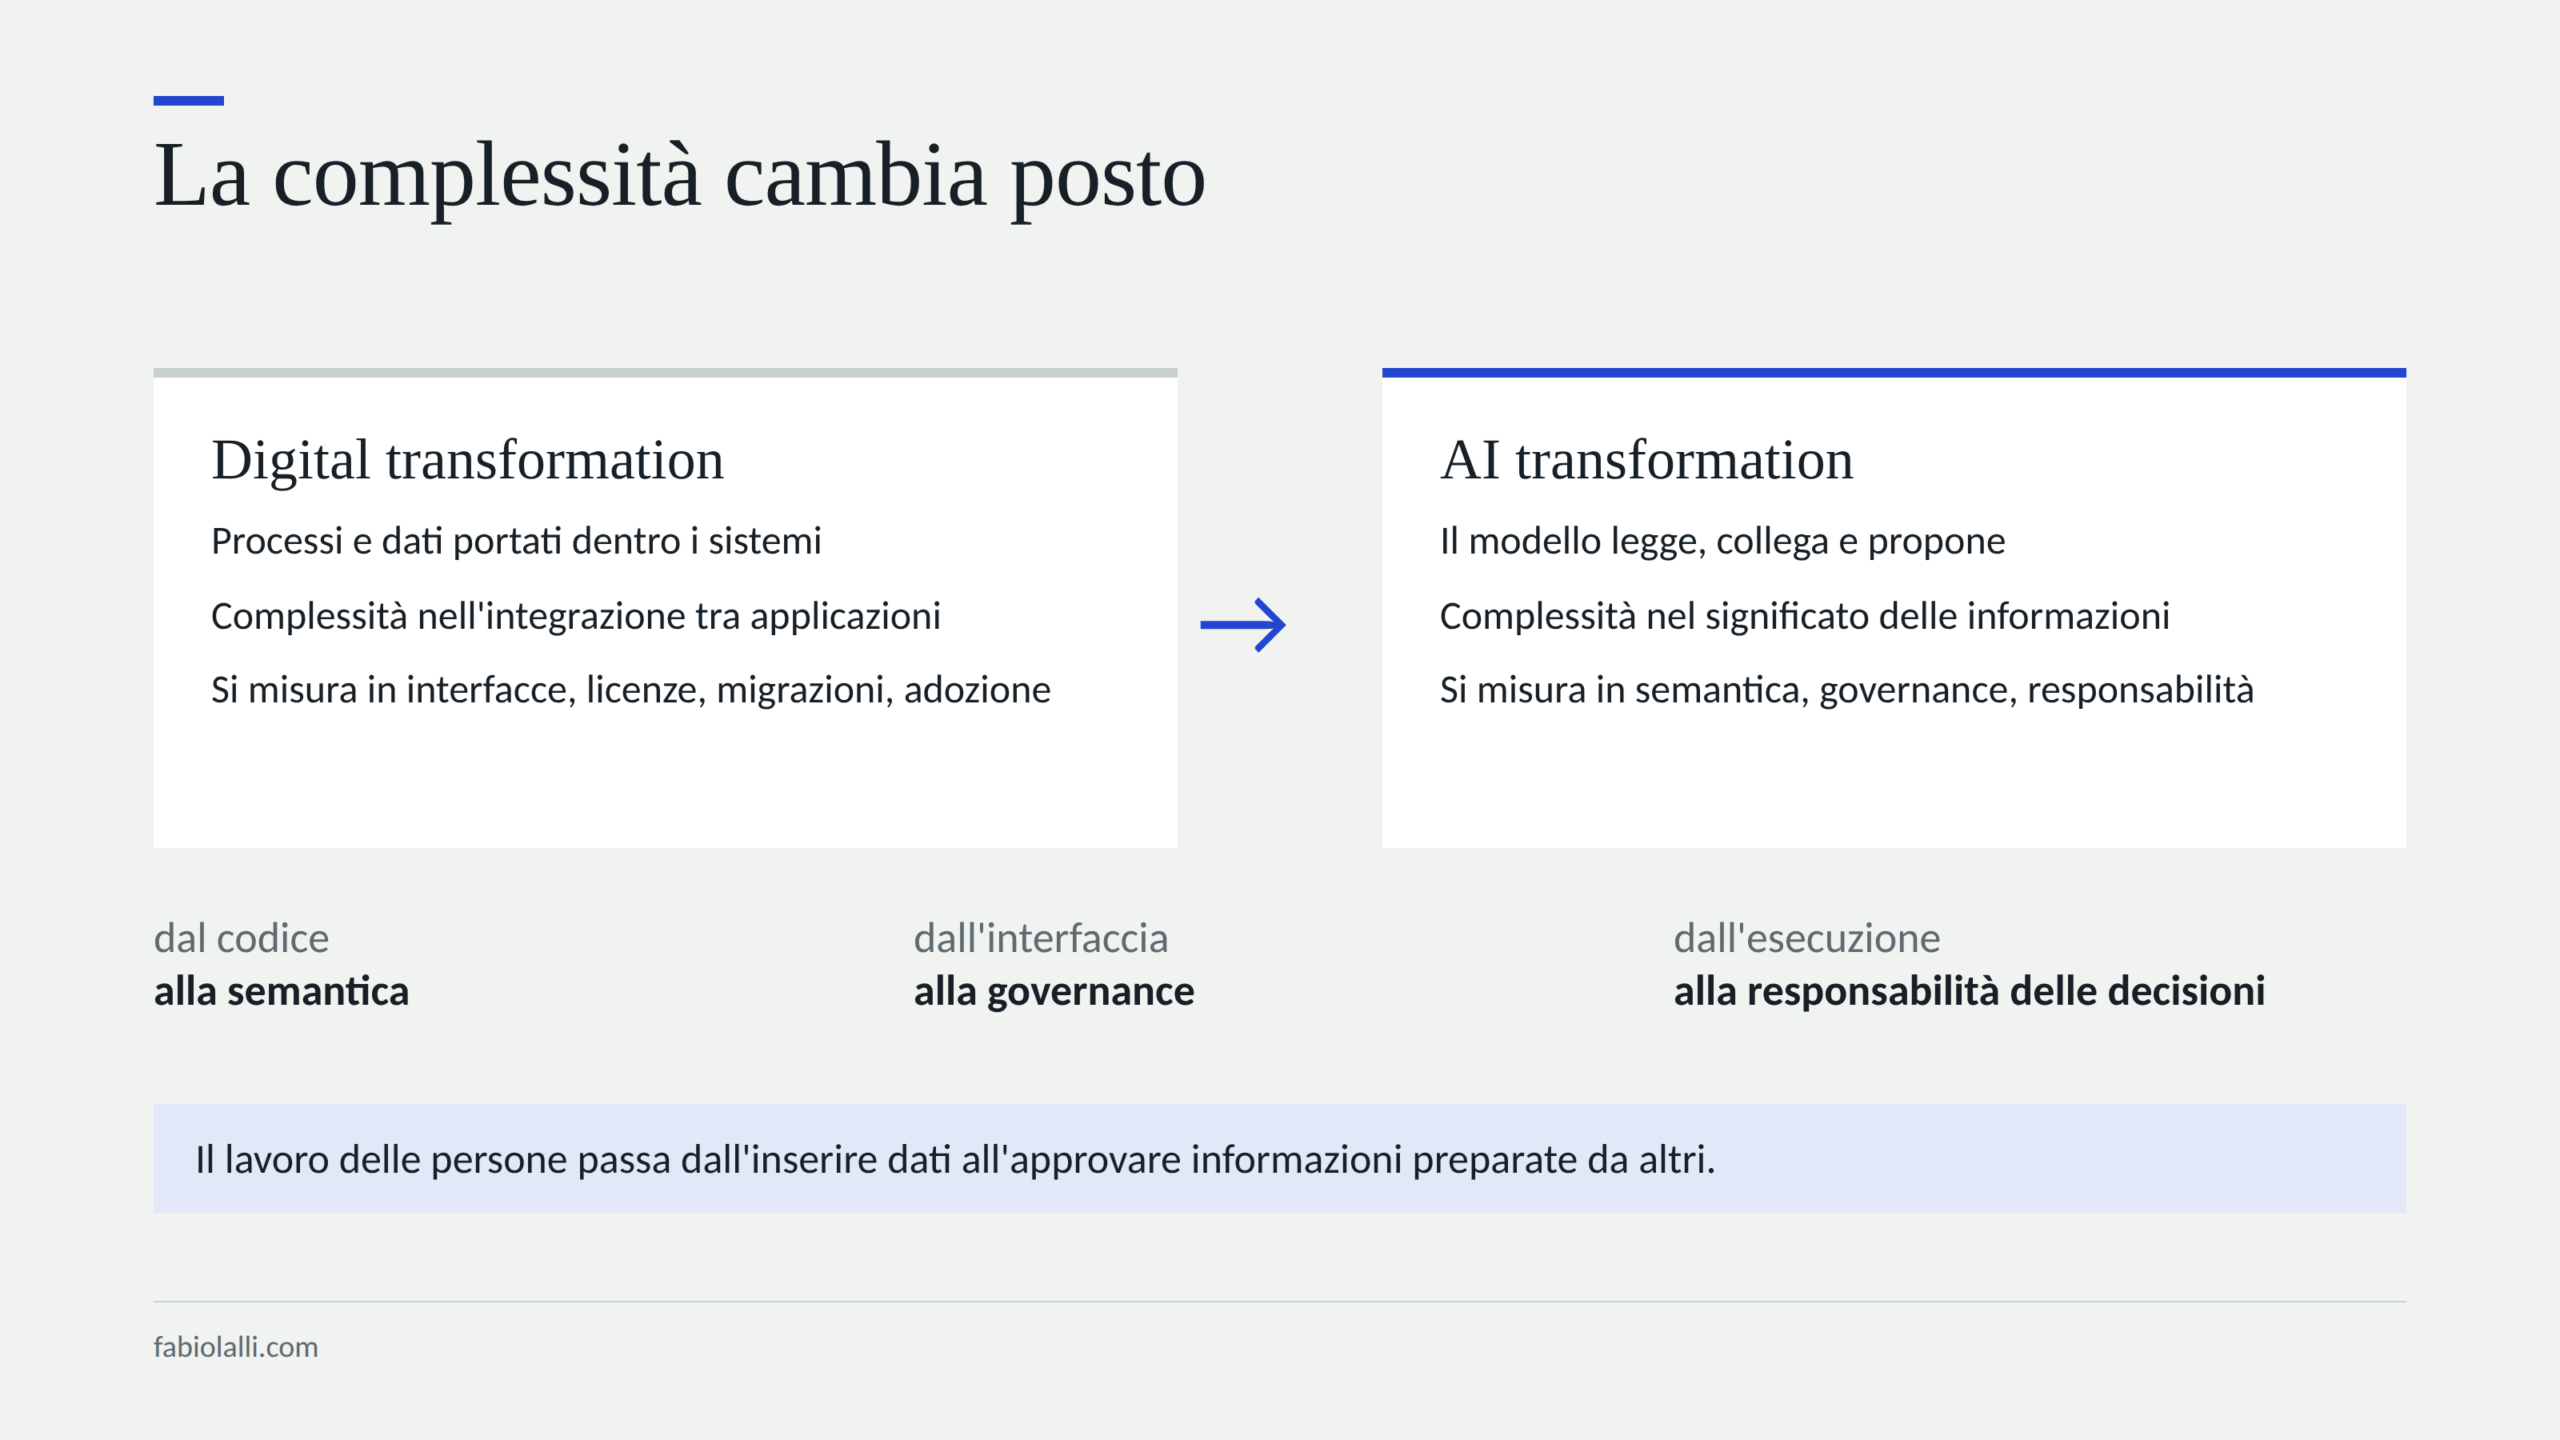
Prima dei livelli conviene chiarire che tipo di trasformazione è questa, perché la si confonde spesso con quella che le aziende hanno attraversato negli ultimi quindici anni. La digital transformation ha portato processi e dati dentro i sistemi: la carta è diventata un modulo, la riunione una videochiamata, l’archivio un drive condiviso, e la complessità stava nell’integrazione tra applicazioni e nell’adozione degli strumenti da parte delle persone. Si misurava in interfacce, licenze, migrazioni, formazione all’uso del software.

La AI transformation sposta la complessità altrove. Gli strumenti in buona parte ci sono già, e i dati anche, solo che sono sparsi e senza significato condiviso. Quando un modello legge, riassume, collega e propone al posto delle persone, il problema smette di essere come si esegue una procedura dentro un’applicazione e diventa cosa significano le informazioni, chi ha titolo per confermarle e cosa succede quando due fonti dicono cose diverse. La complessità passa dal codice alla semantica, dall’interfaccia alla governance, dall’esecuzione delle operazioni alla responsabilità delle decisioni.

Questo ha una conseguenza pratica che molti sottovalutano. Il lavoro di chi usa il sistema cambia natura: meno inserimento di dati, meno ricerca, molte più approvazioni, correzioni e scelte su informazioni preparate da altri. Una persona che prima compilava il verbale di una riunione ora riceve un verbale già scritto, con i task estratti e collegati alle persone giuste, e il suo compito è dire se è corretto. È un lavoro più leggero e più delicato insieme, perché richiede di sapere cosa si sta approvando.

Un posto per ogni informazione

Centralizzare la conoscenza non significa copiare tutto in un unico contenitore. Un archivio dove finiscono i file di tutti è soltanto un altro silo, più grande. Serve un luogo dove un’informazione diventa un oggetto con un’identità, un autore, una data e una posizione nel progetto: una nota di riunione, un task con un assegnatario e una scadenza, un documento con le sue versioni, un referente con il suo ruolo, un’opportunità con il suo stadio, un’ora di lavoro registrata su un’attività.

La regola che evita più problemi è che ogni dato ha un solo sistema proprietario. Nel Workspace ICONICO clienti, contatti e opportunità restano nel CRM aziendale, e la piattaforma non li duplica: tiene un collegamento e una copia del nome per poterlo mostrare, e quando dal progetto nasce un’opportunità è la piattaforma a scriverla nel CRM, con la nota di progetto e l’attività già collegate. Un’anagrafica duplicata produce, dopo pochi mesi, due verità su chi è il decisore di un cliente, e un modello che le legge entrambe sceglie a caso quale citare.

Il vantaggio più sottovalutato della centralizzazione riguarda le informazioni che oggi non arrivano da nessuna parte. Una decisione presa in una call e mai scritta, un dubbio sollevato in un canale Slack e poi dimenticato, un vincolo annotato in una scheda Jira che nessuno del commerciale leggerà, un’email in cui il cliente cambia una priorità rispondendo a un’altra domanda. E poi il ragionamento che una persona fa con il proprio LLM mentre prepara una proposta o analizza un problema, che spesso contiene il passaggio più utile della giornata e svanisce quando si chiude la finestra. Ognuna di queste informazioni, presa da sola, vale poco. Raccolte nel progetto, con la loro origine, diventano la memoria che l’azienda non aveva mai avuto, e smettono di dipendere da chi era presente quel giorno.

Per ottenere questo vantaggio non sempre serve costruire infrastruttura nuova. In molti casi le fonti esistono già, con i loro connettori, e manca soltanto il punto in cui convergono e un criterio per decidere cosa ne entra. Nel Workspace il controllo degli accessi è applicato al livello più basso possibile, con regole a livello di riga su ognuna delle 28 tabelle del database, per cui la stessa domanda posta da due persone con ruoli diversi restituisce risposte diverse: è la condizione per dare a un modello l’accesso a tutto il progetto senza dover filtrare a mano ogni volta.

Il significato viene prima dei dati

È la parte che quasi tutti saltano, e si capisce: parlare di ontologia in una riunione di direzione fa alzare gli occhi al cielo. Eppure un modello collegato a dati senza tipi e senza relazioni dichiarate ricostruisce da solo il significato delle cose, ogni volta in modo leggermente diverso, e due risposte alla stessa domanda a una settimana di distanza non coincidono. L’ontologia è il punto in cui un’azienda decide cosa significano le sue informazioni, prima che lo decida un modello al suo posto.

Si comincia dai tipi di oggetto. Nel Workspace le note sono appunti, verbali di riunione, decisioni, rischi, insight, feedback, opportunità o conoscenza consolidata, e il tipo cambia il trattamento: una decisione pesa più di un appunto, un rischio genera attenzione, una nota di conoscenza è il risultato di una verifica e non di un’impressione. Anche il vocabolario fa parte dell’ontologia. I tag vengono normalizzati, minuscoli e con il trattino al posto degli spazi, e prima di crearne uno nuovo il sistema lo confronta per somiglianza con quelli esistenti: se esiste già “commerciale-b2b”, la variante “commerciale b2b” non nasce e chi la scrive riceve un avviso, perché il tag è il punto in cui la tassonomia di un’azienda si sfalda più in fretta.

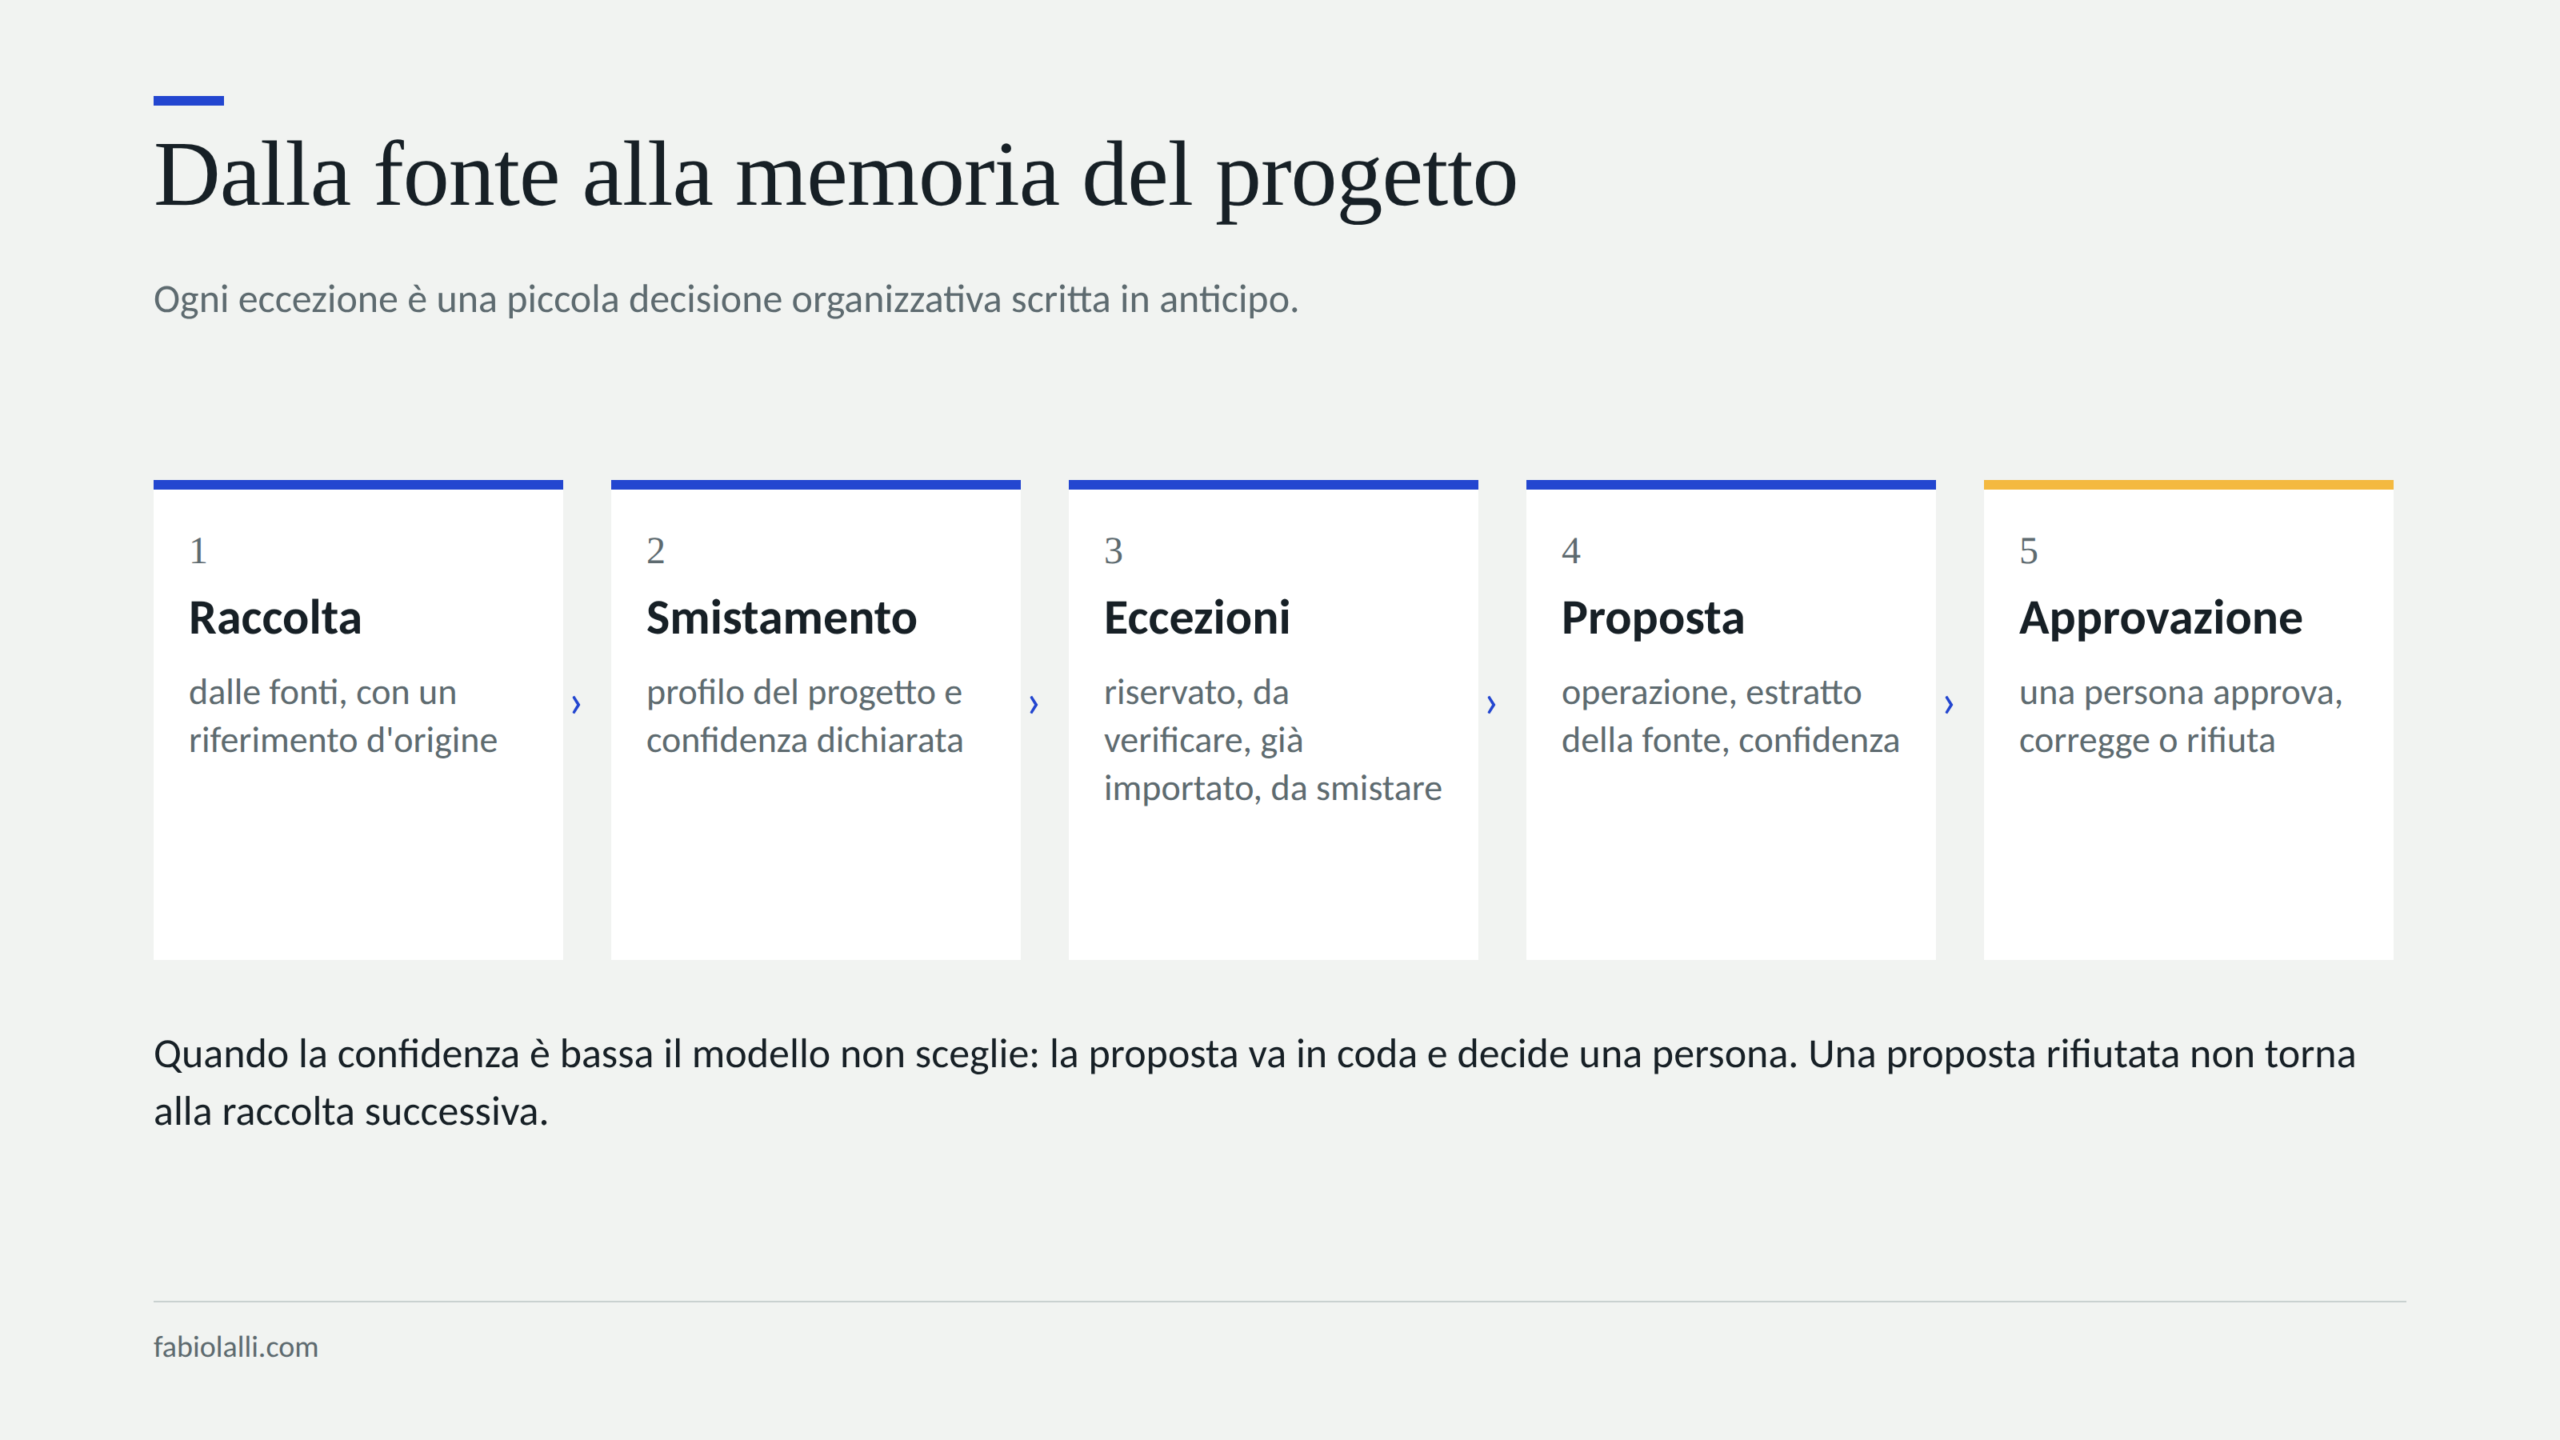
Poi viene lo smistamento, cioè la decisione su dove va un’informazione appena raccolta. Ogni progetto ha un profilo leggibile dal modello: i domini email del cliente e dei partner, le parole chiave e le sigle ricorrenti, le cartelle standard, le convenzioni di nome. Con queste poche righe una mail da un certo dominio, o una registrazione in cui ricorre una sigla, viene attribuita al progetto giusto con un livello di confidenza dichiarato. Quando la confidenza è bassa, o l’informazione potrebbe appartenere a due progetti, il modello non sceglie: la proposta finisce in una coda da smistare e la decisione torna a una persona.

Le eccezioni vanno progettate quanto i casi normali. Un’informazione con cifre economiche viene marcata come riservata e resta visibile solo ai responsabili del progetto. Un’informazione dubbia porta il marcatore da verificare. Un contenuto già importato viene riconosciuto dalla sua origine e non entra una seconda volta. Ognuna di queste regole è una piccola decisione organizzativa scritta in anticipo, e ciascuna toglie al modello un’occasione di improvvisare.

Il caso più delicato sono le collisioni, quando due fonti affermano cose diverse sullo stesso punto. Per gestirle le relazioni tra oggetti sono tipizzate: un collegamento tra due note può essere un riferimento, una conferma, un’integrazione, una divergenza o un consolidamento. Nel progetto pilota due note scritte da persone diverse, a pochi giorni di distanza, si contraddicevano su sei punti. Un sistema ingenuo avrebbe tenuto l’ultima, o le avrebbe fuse in un riassunto. Con le relazioni tipizzate la divergenza diventa un collegamento esplicito e apre un task di verifica assegnato a una persona, che si chiude con una nota di conoscenza: cita entrambe le fonti e dichiara per ciascuna se è stata confermata, integrata o superata su quel punto. Le note originali restano intatte e i loro autori ricevono una notifica.

Le conferme hanno lo stesso trattamento, con il segno opposto. Quando una seconda fonte indipendente dice la stessa cosa della prima, il collegamento di conferma alza il valore di quell’informazione, e chi interroga il progetto sa che quel fatto è sostenuto da due origini e non da una. È il modo in cui la conoscenza di un team acquista peso nel tempo, invece di accumularsi tutta allo stesso livello.

Arricchire i dati e renderli percorribili

Un’informazione raccolta e smistata è ancora un oggetto isolato. Diventa conoscenza quando è collegata a ciò che la circonda: le persone che cita, l’opportunità a cui si riferisce, il documento che commenta, il task che ne è nato, le ore spese per produrla.

L’arricchimento avviene su più piani. Il primo è esplicito: nelle note e nei task gli oggetti si citano con le menzioni, scrivendo @ seguito dal nome di una persona, di un documento o di un’opportunità, e ogni menzione diventa un collegamento. Il secondo è automatico: il sistema rianalizza i testi, riconosce nomi di referenti, opportunità e documenti già presenti nel progetto e genera collegamenti suggeriti, che però restano suggerimenti finché qualcuno non li conferma, e se vengono rifiutati non vengono ricreati. Il terzo è operativo: un task porta con sé la nota da cui è nato, un’ora registrata porta con sé il task o la riunione a cui si riferisce, un’opportunità porta con sé la nota che l’ha fatta emergere.

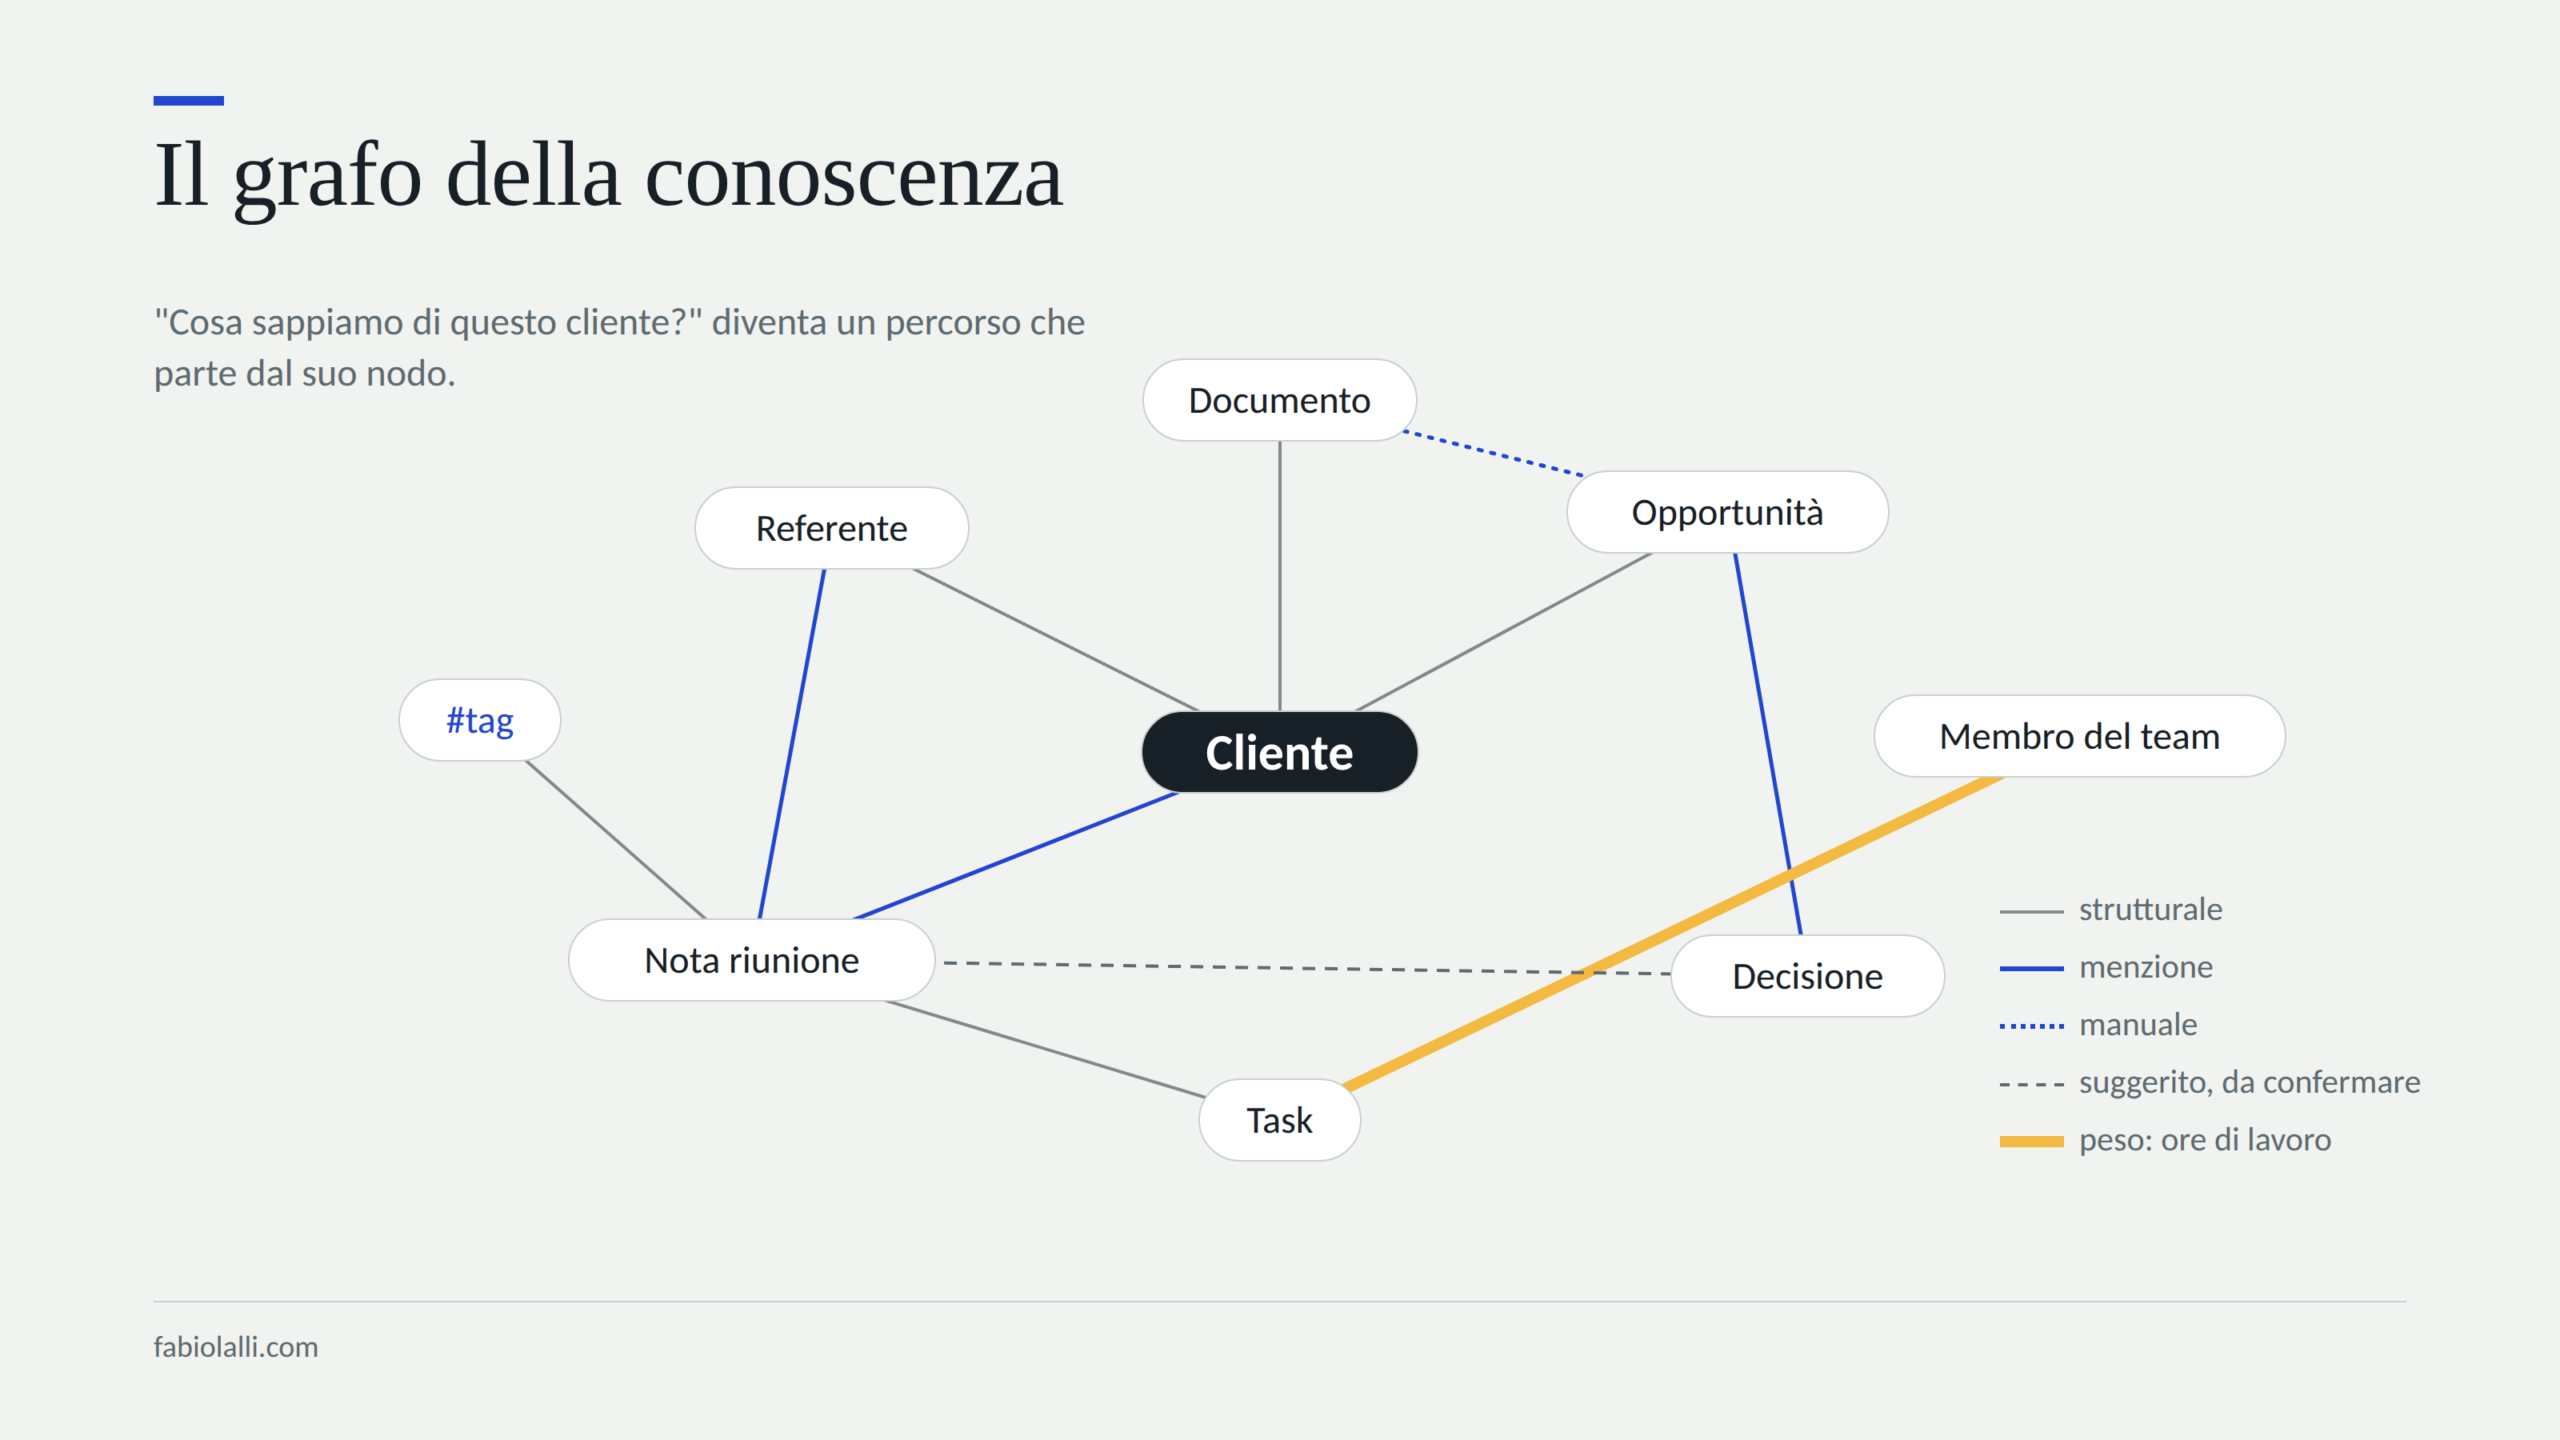
Il risultato è un grafo della conoscenza in cui i nodi sono note, task, documenti, referenti, opportunità, membri del team, cartelle, tag e organizzazioni, e gli archi hanno un’origine dichiarata: strutturale, da menzione, manuale o automatica. Alcuni archi hanno anche un peso, come le ore che una persona ha dedicato a un’attività, così la mappa mostra dove si concentra davvero il lavoro e non solo cosa è collegato a cosa.

Rendere la conoscenza percorribile vuol dire offrire più strade per arrivare alla stessa informazione. Dalla mappa del progetto si parte da un nodo e se ne esplora il vicinato fino a tre passi di distanza. Da ogni oggetto si vedono i collegamenti in uscita e quelli in entrata, cioè chi lo cita. La timeline restituisce la sequenza degli eventi, la ricerca attraversa note, task, documenti, testo estratto e tag di tutti i progetti leggibili. E il modello usa le stesse strade: prima di una riunione con un referente prepara il brief partendo dal suo nodo, raccogliendo le note recenti che lo citano, le opportunità aperte, i task in scadenza e le divergenze ancora da chiudere. Alla domanda “cosa sappiamo di questo cliente” il sistema risponde con un percorso nel grafo che parte dal nodo del cliente.

Quale modello per quali dati

Con la conoscenza centralizzata, strutturata e collegata, la scelta del modello diventa una decisione molto più semplice e molto meno rischiosa, perché il modello non contiene niente. Il cuore del sistema è il livello di conoscenza con il suo server di accesso: il modello è un lettore e un proponente, e si può sostituire senza perdere nulla. Il mio assistente personale si chiama Gideon, come l’intelligenza artificiale che in The Flash mostra a Barry Allen i giornali del futuro. Il mio si accontenta di sapere cosa abbiamo deciso martedì, e se domani cambiassi il modello che lo fa funzionare continuerebbe a saperlo, perché quella memoria non sta dentro di lui.

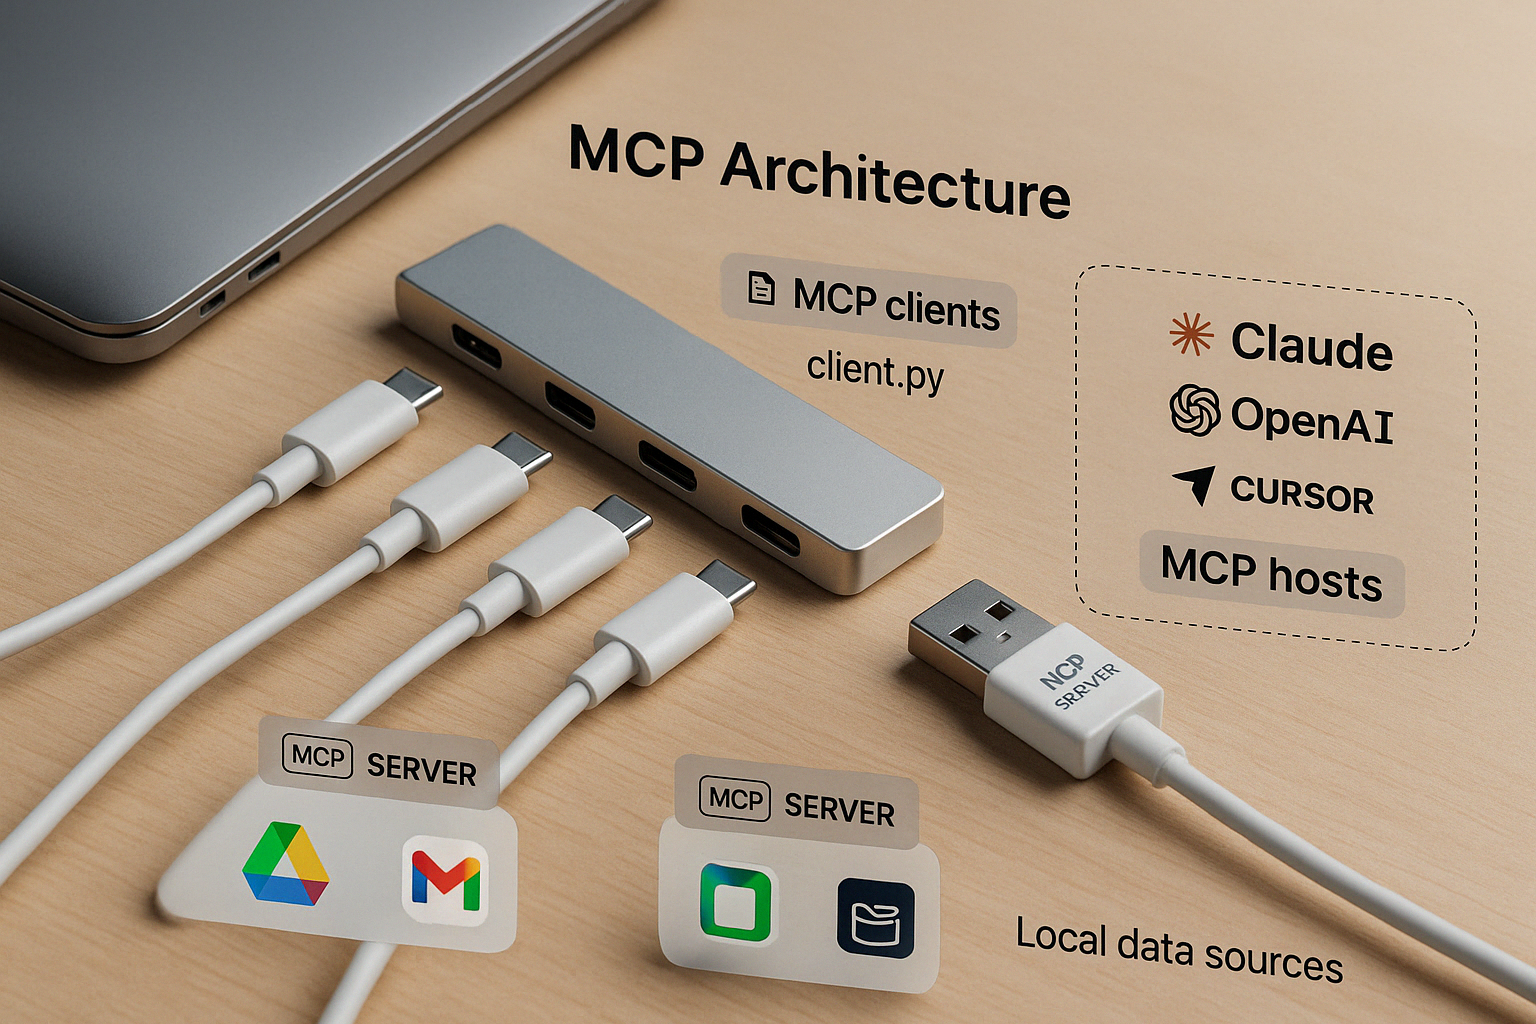
Il collegamento passa oggi quasi sempre da un server MCP, il protocollo che i principali assistenti usano per parlare con strumenti esterni. Il server del Workspace gira su un dominio proprio, con autenticazione OAuth, ed espone oltre sessanta strumenti: leggere e scrivere note, aprire task, caricare documenti, registrare il tempo di una riunione, interrogare il grafo di un progetto. Lo stesso server serve qualsiasi client compatibile, e il principio da tenere fermo è che il modello opera sempre con i permessi reali della persona che lo sta usando, mai con un’utenza tecnica onnipotente.

Da qui le strade sono sostanzialmente due, e spesso convivono. La prima sono i client dei prodotti noti, Claude, ChatGPT e gli altri assistenti commerciali: offrono i modelli più capaci, connettori già pronti verso posta, calendari e archivi, e un’esperienza che le persone conoscono. Il prezzo è che i dati letti dal modello transitano sui server del fornitore, con le garanzie contrattuali del piano sottoscritto. La seconda sono i client con AI locale, che eseguono modelli aperti su macchine aziendali o su server interni: i dati non escono dal perimetro dell’azienda, i costi sono prevedibili, e in cambio si accettano modelli meno potenti sui compiti più complessi, più lavoro di manutenzione e un’infrastruttura da gestire.

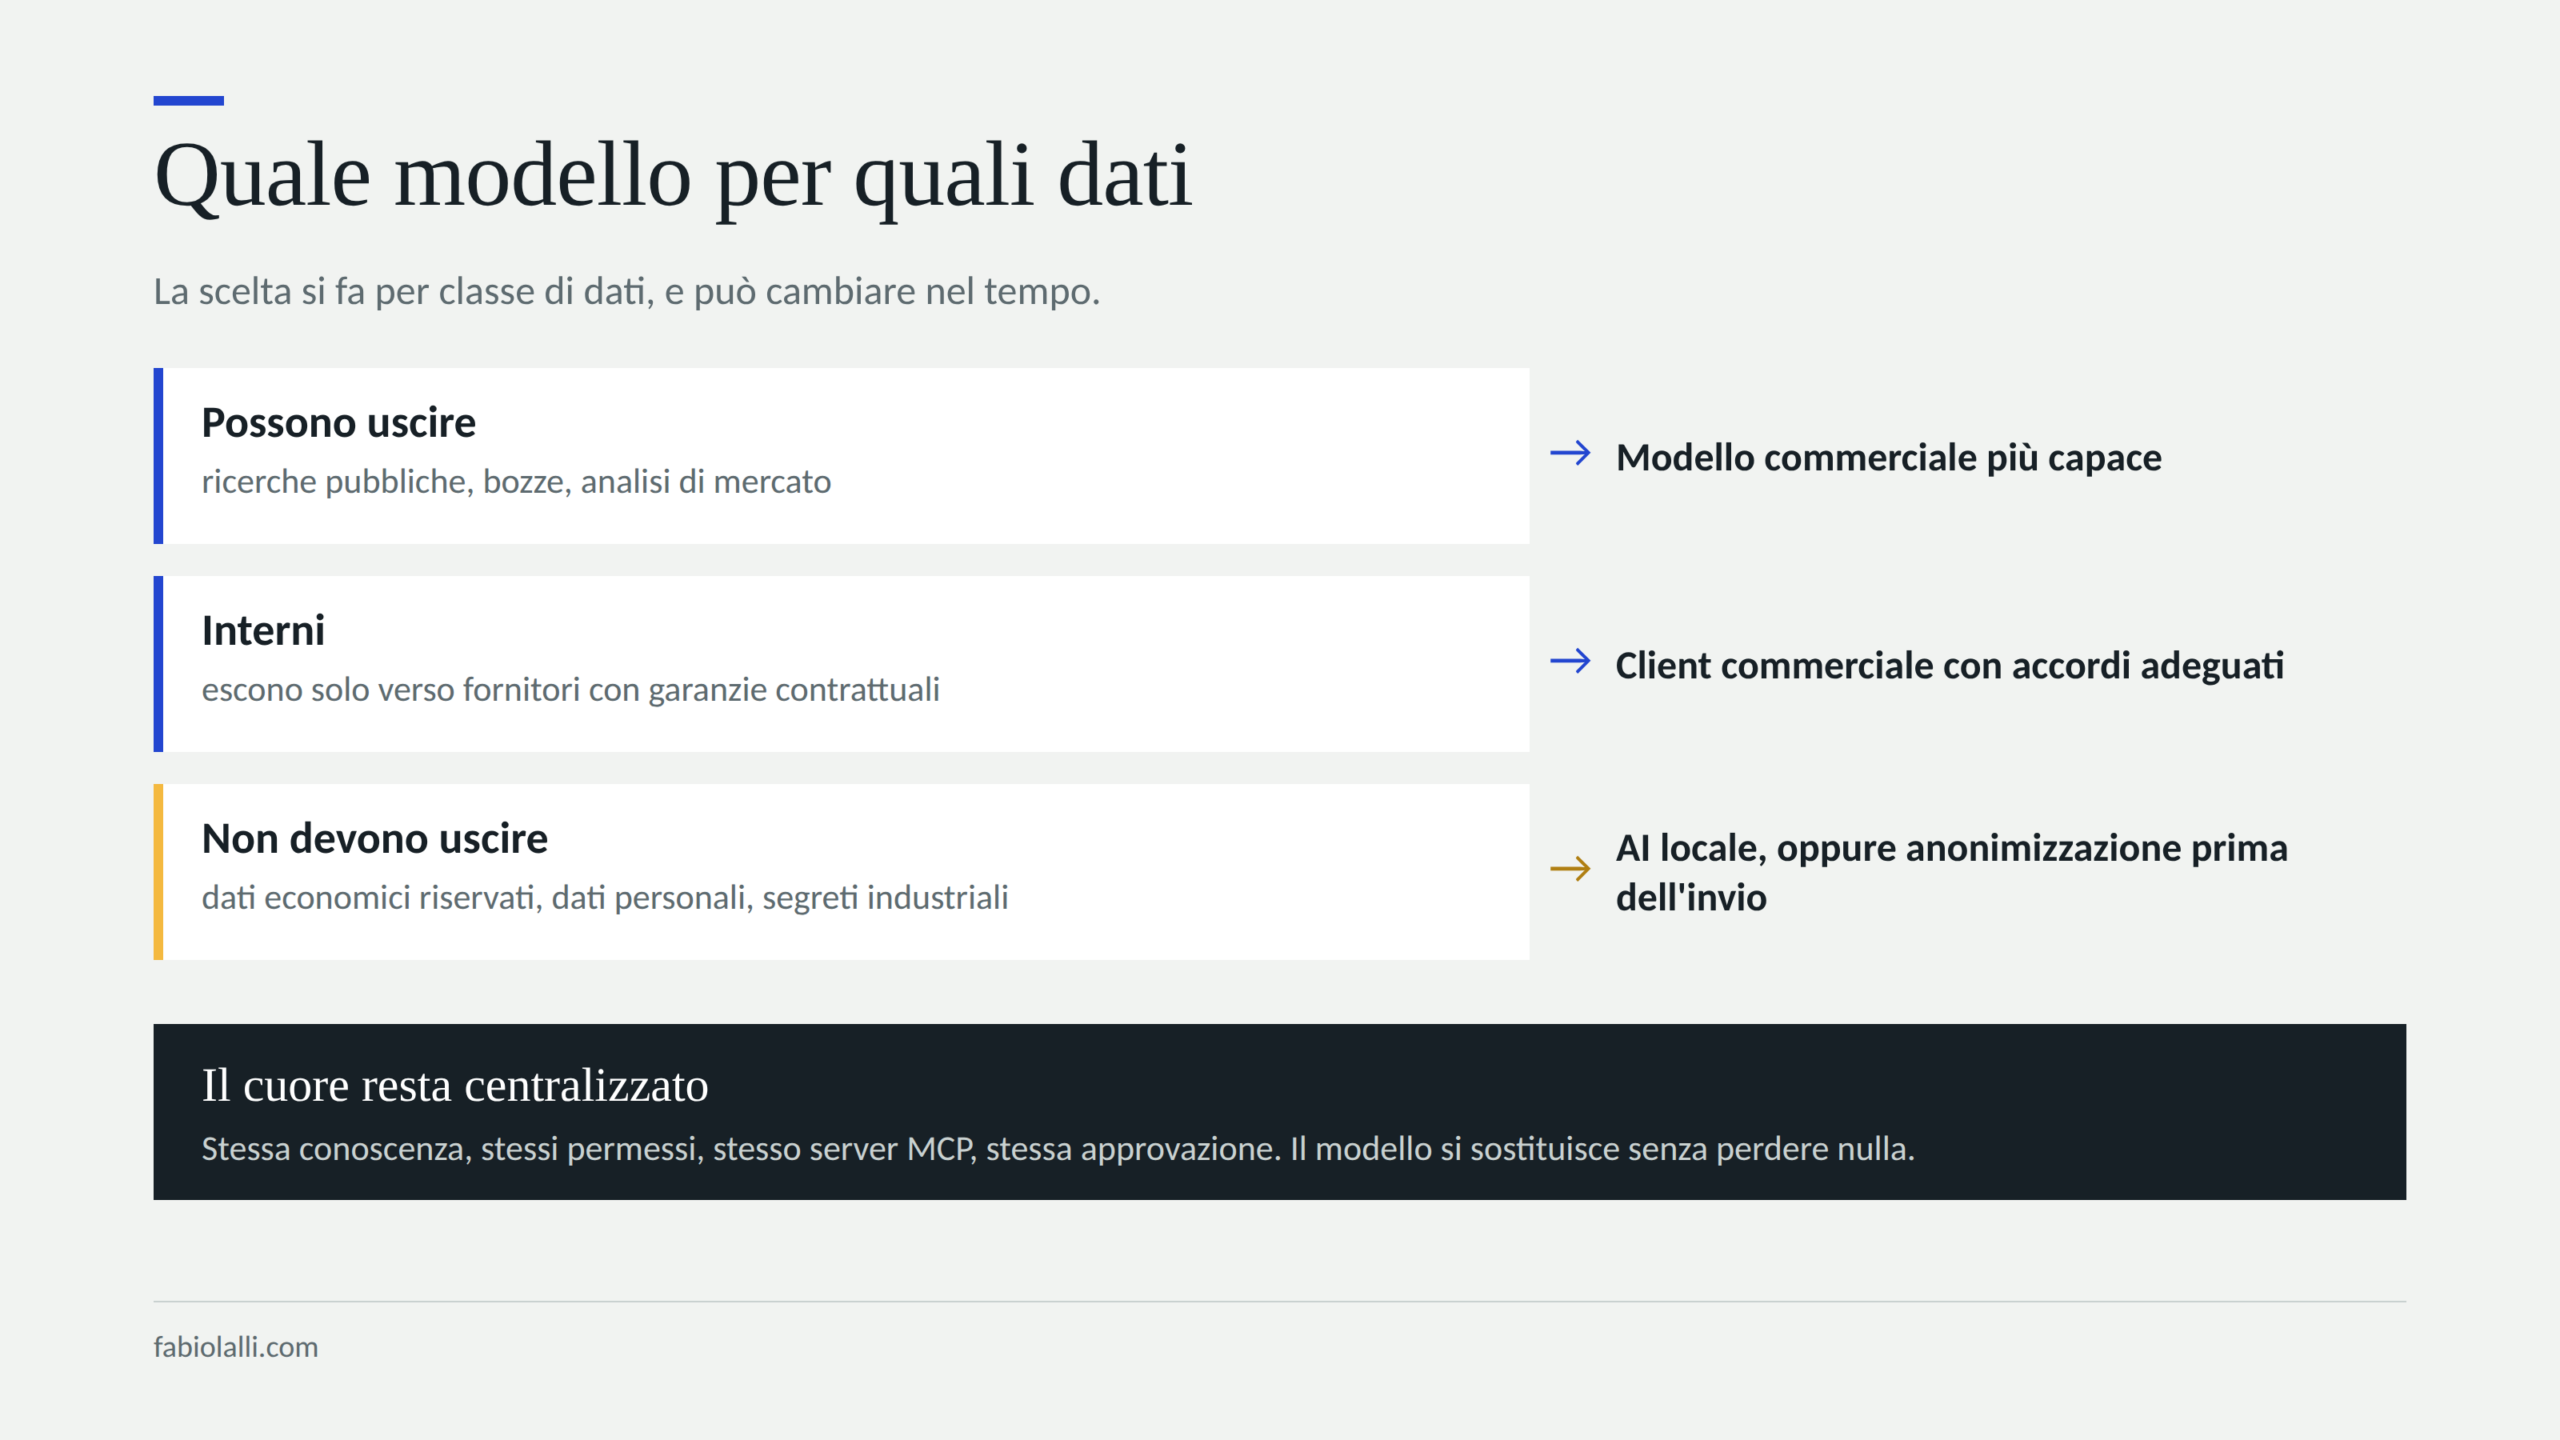
La scelta si fa per classe di dati, e può cambiare nel tempo. Un modo pratico è classificare le informazioni del progetto su tre livelli: dati che possono uscire (ricerche pubbliche, bozze di contenuti, analisi di mercato), dati interni che possono uscire solo verso fornitori con garanzie contrattuali adeguate, dati che non devono uscire per nessun motivo, come informazioni economiche riservate, dati personali sensibili o segreti industriali. Ai primi due livelli si applica il modello più capace disponibile, al terzo un modello locale, oppure un passaggio di anonimizzazione prima dell’invio. Nel Workspace questa classificazione è già parzialmente scritta nell’ontologia, perché le note e i documenti riservati sono marcati come tali, e quel marcatore diventa il criterio naturale per decidere quali oggetti affidare a un client locale.

Il punto fermo, in entrambi i casi, è che il cuore resta centralizzato. Che il modello giri in un data center americano o su un server nel seminterrato, legge la stessa conoscenza, con gli stessi permessi, attraverso lo stesso server, e propone modifiche che passano dalla stessa approvazione. Cambiare fornitore, o affiancarne due, diventa una decisione di costo e di riservatezza, senza progetti di migrazione.

Skill condivise in un catalogo unico

Una skill è il modo in cui si insegna a un assistente a fare una cosa sempre nello stesso modo: istruzioni in testo, riferimenti da consultare al momento giusto, script che verificano ciò che può essere verificato. Il paragone più vicino è il manuale operativo di un nuovo collaboratore, con la differenza che questo manuale viene letto davvero, ogni volta.

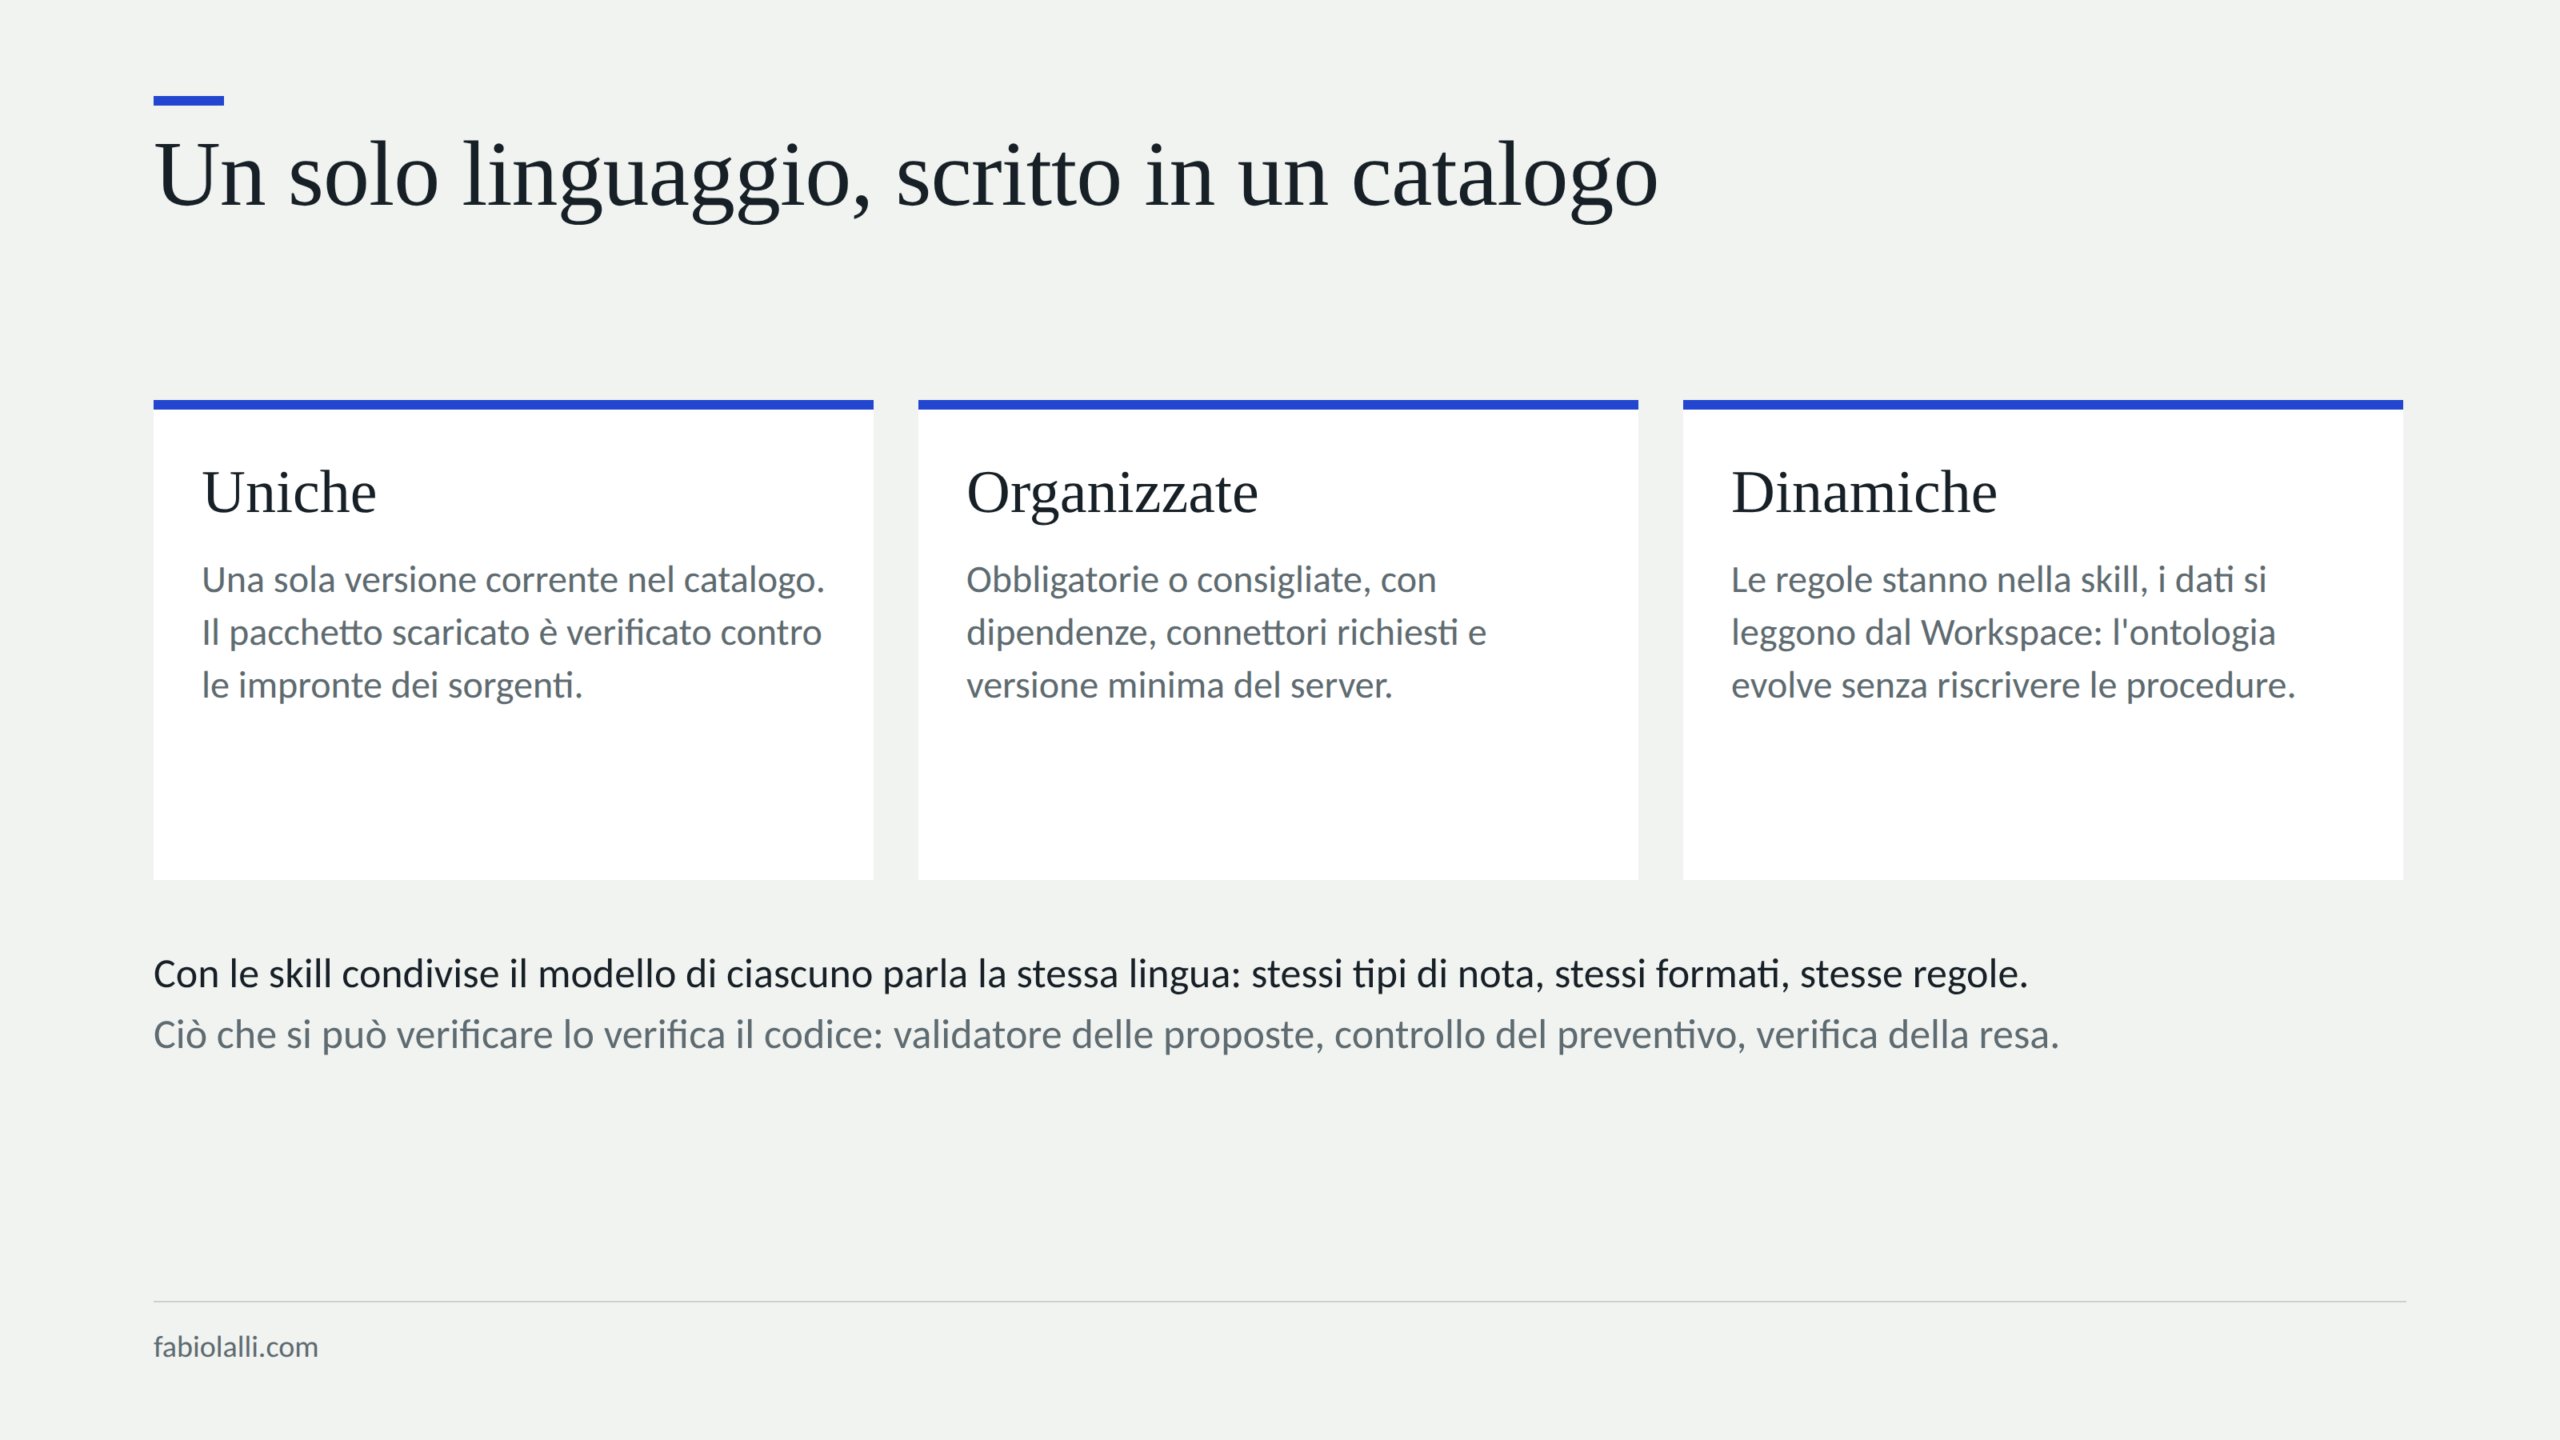
Il loro valore in un team va oltre l’efficienza del singolo. Quando dieci persone usano un LLM senza skill condivise, ciascuno scrive le note a modo suo, chiama le cose con nomi diversi, sceglie tag diversi, struttura le proposte con sezioni diverse, e il modello amplifica queste differenze invece di ridurle. Con le skill condivise il modello di ciascuno parla la stessa lingua: usa gli stessi tipi di nota, propone gli stessi formati, rispetta le stesse regole di stile, chiama un rischio “rischio” e una decisione “decisione”. Le skill sono il veicolo con cui l’ontologia arriva dentro ogni conversazione, senza che nessuno debba ricordarla.

Nel Workspace le skill sono tre e lavorano insieme. La skill di raccolta legge le fonti, smista per progetto, propone note, task, ore, referenti e collegamenti, prepara i brief, gestisce le verifiche. La skill documentale produce i documenti per i clienti da un motore unico: copertina, intestazione, palette e coordinate aziendali sono fisse, cambiano solo contenuti e firma di chi redige, e un controllo di stile automatico intercetta i tic di scrittura prima della consegna. Su questa si appoggia la skill commerciale, che segue una proposta dal brief all’opportunità nel progetto fino al preventivo nel CRM, con uno script che verifica al centesimo che documento e preventivo coincidano.

Conta molto anche il luogo dove le skill vengono scritte. Se vivono nei computer delle persone, dopo tre mesi ne esistono cinque versioni leggermente diverse, ognuna con le sue correzioni locali, e il linguaggio comune si disgrega dalla periferia. Per questo nel Workspace le skill stanno in un catalogo unico, dentro la piattaforma: ogni skill esiste in una sola versione corrente, con le note di rilascio, i connettori di cui ha bisogno, la versione minima del server, le altre skill da cui dipende e uno stato che la rende obbligatoria o consigliata. I sorgenti sono archiviati file per file con la loro impronta crittografica, e il pacchetto che ogni collaboratore scarica viene verificato contro quelle impronte.

Il catalogo rende le skill anche dinamiche nella struttura. Una skill ben scritta separa le regole dai dati: non contiene l’elenco dei tag del progetto né i domini del cliente, li legge dal Workspace nel momento in cui serve, così l’ontologia evolve senza dover riscrivere le procedure. Quando cambia una regola, si pubblica una nuova versione nel catalogo e ogni collaboratore la riceve con le note di rilascio. Il motore documentale è stato riscritto in Python con la sola libreria standard proprio per non legare le skill a un solo assistente: lo stesso pacchetto gira su qualsiasi piattaforma che esegua Python, compresi i client con AI locale.

La lezione tecnica più utile riguarda il confine tra quello che decide il modello e quello che decide il codice. Tutto ciò che si può verificare in modo deterministico va tolto al giudizio del modello. Prima di essere inviato, ogni pacchetto di proposte attraversa un validatore con nove regole. Il preventivo viene ricontrollato da uno script. Il documento passa da una verifica della resa in PDF. Al modello resta il lavoro che sa fare meglio, leggere, collegare e proporre, e il codice garantisce che il risultato rispetti le regole.


Il modello propone, le persone firmano

Il livello che tiene insieme tutti gli altri è una regola di governo molto semplice: niente entra nella memoria del progetto senza che una persona lo approvi. Quando il modello esegue la raccolta settimanale non scrive nulla, prepara un pacchetto di proposte. Ogni proposta dichiara l’operazione (crea una nota, apri un task, registra un’ora, collega due oggetti, apri una verifica), il progetto di destinazione, un estratto della fonte di massimo trecento caratteri con data e autore, un livello di confidenza e, quando serve, un marcatore che la segnala come da verificare o come contenuto economico riservato.

Il responsabile apre il pacchetto, approva, corregge o rifiuta. L’applicazione avviene con i suoi permessi, e se una proposta dipende da un’altra (un collegamento tra due note che nascono nello stesso pacchetto) il sistema le applica nell’ordine giusto. Una proposta rifiutata viene ricordata insieme alla sua origine e non torna alla raccolta successiva, quindi il sistema impara cosa non serve senza bisogno di istruzioni più lunghe.

La ragione di questa rigidità è pratica. Una base di conoscenza inquinata da un modello troppo zelante è peggio di una base vuota, perché nessuno sa più quali informazioni sono state verificate da una persona e quali sono state dedotte. Con le proposte approvate ogni oggetto del progetto ha un’origine e un responsabile, e se tra sei mesi qualcuno chiede perché è stata presa una certa decisione, la risposta porta a una riunione, a una persona, a una data.

Da dove cominciare

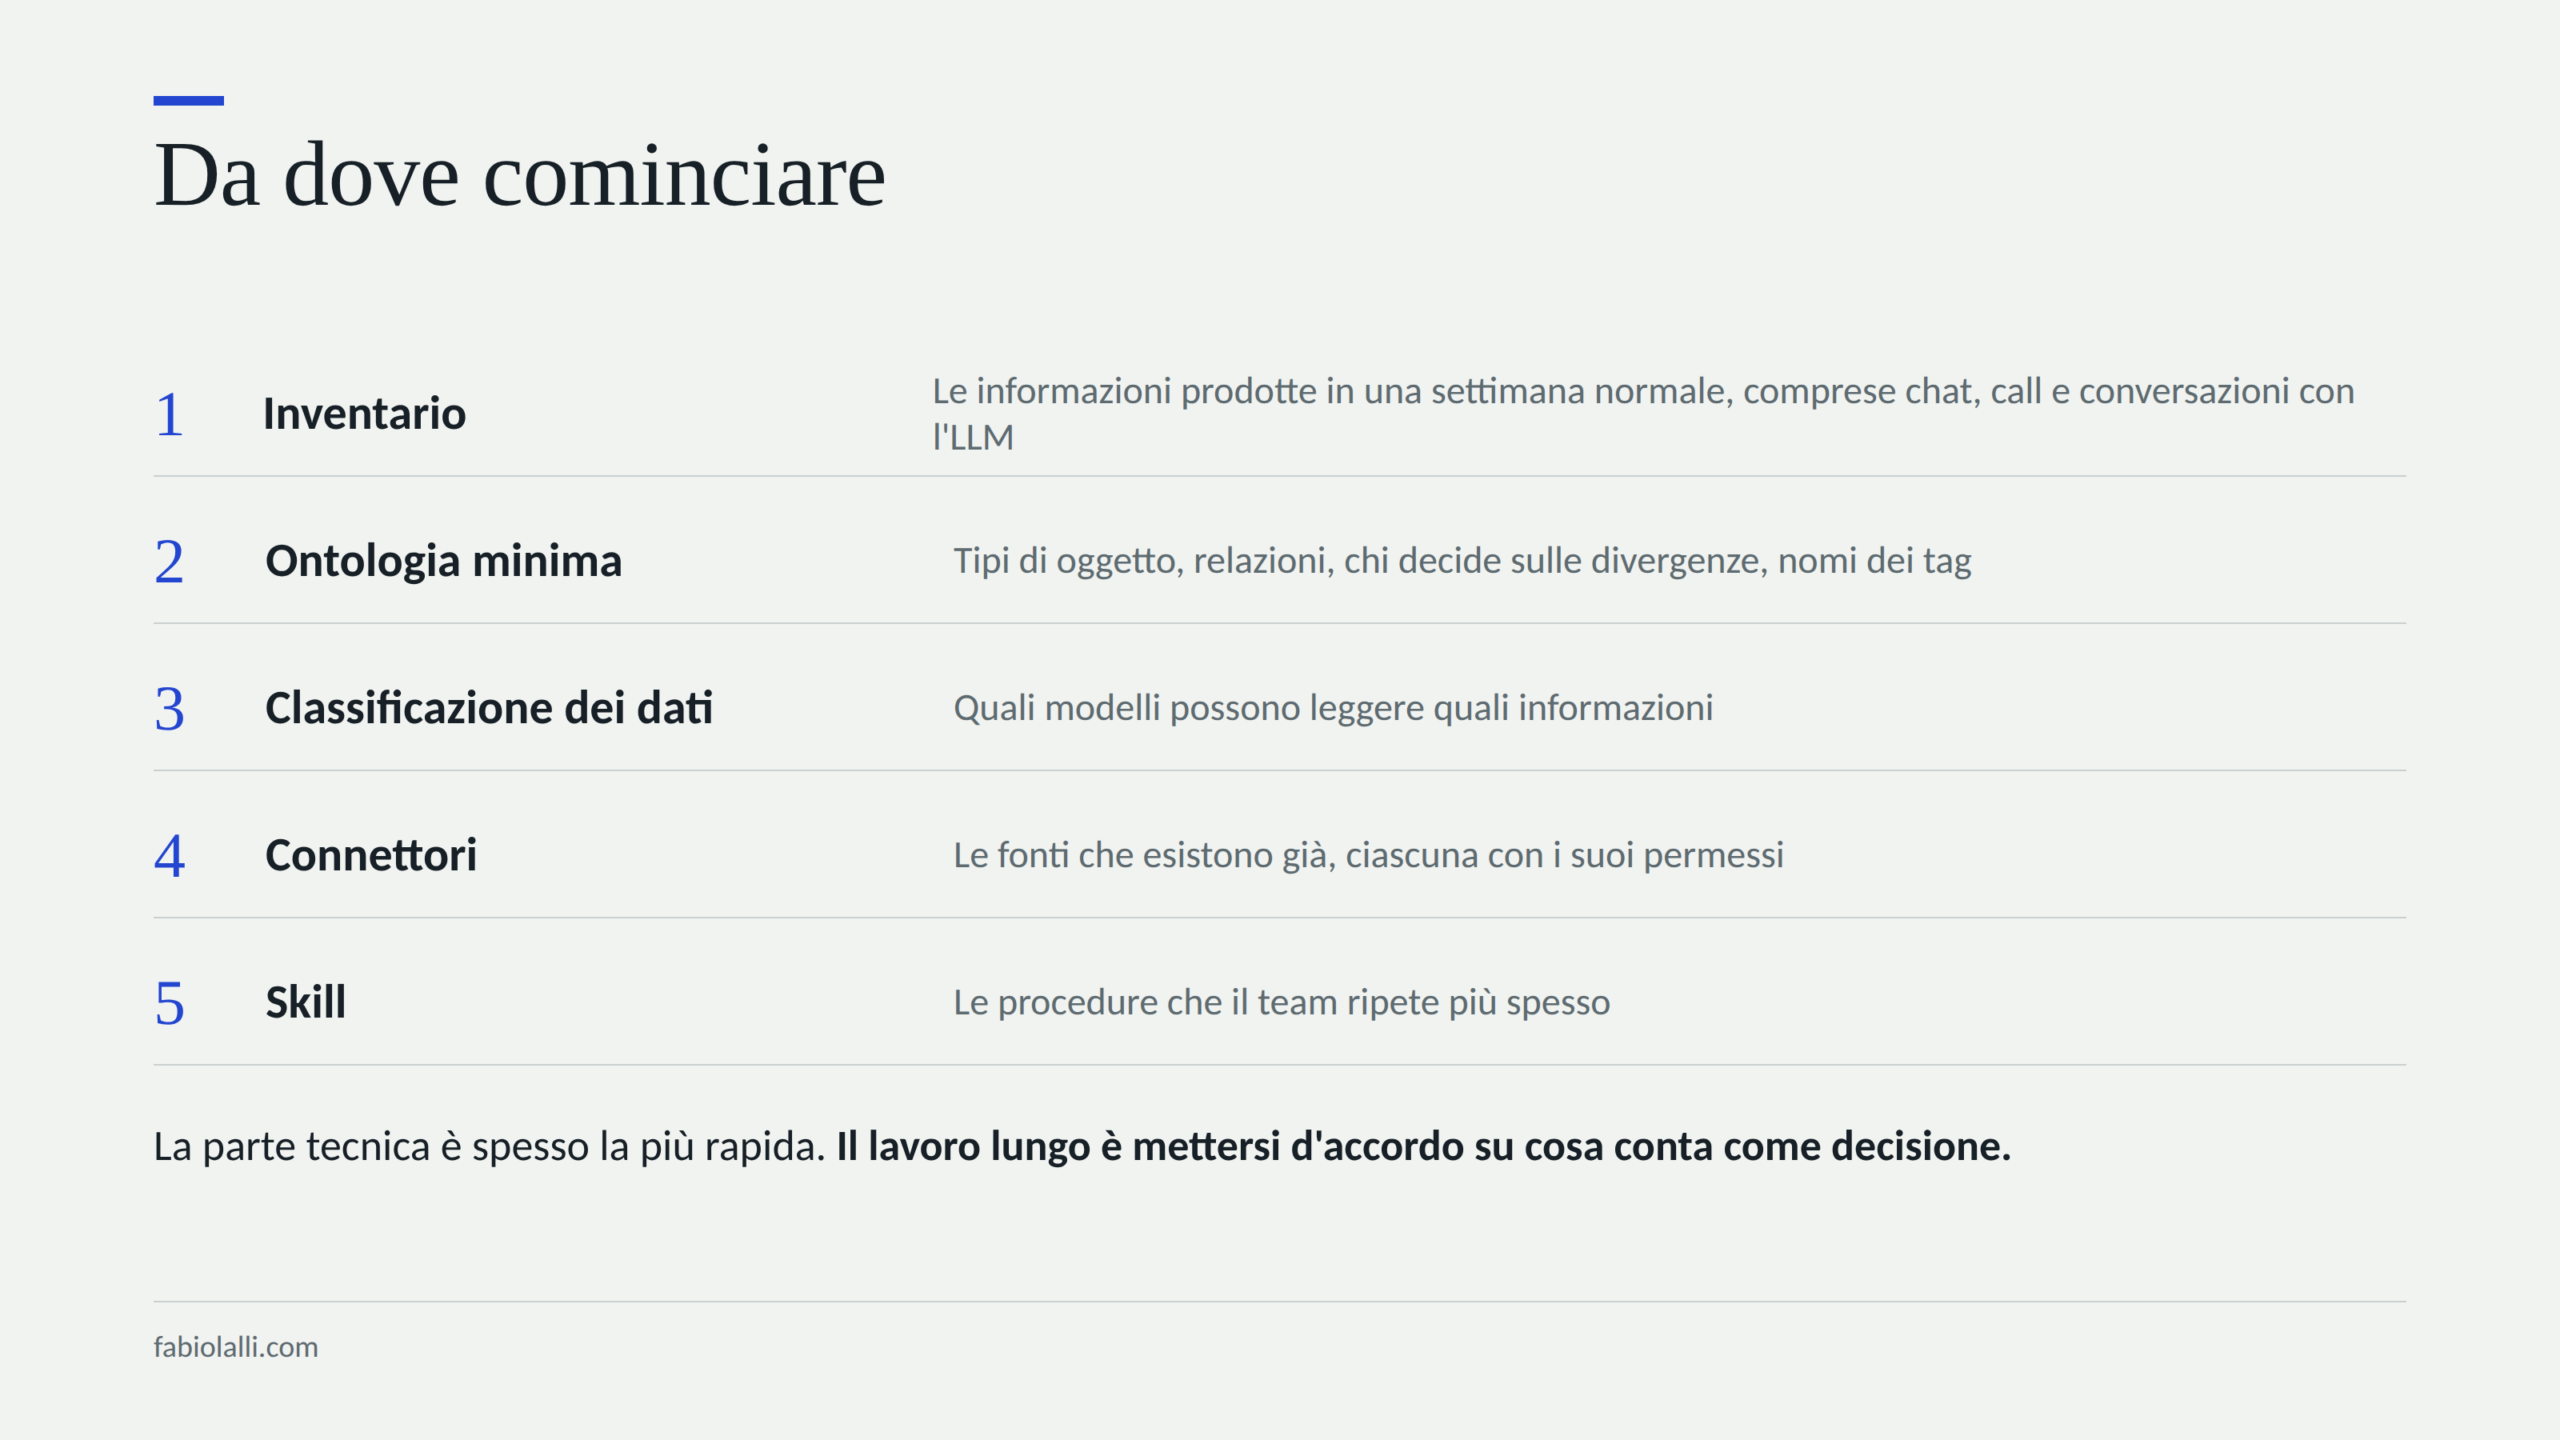
Chi parte da zero dovrebbe cominciare dalla carta e lasciare gli strumenti per dopo. Prima l’inventario delle informazioni che il team produce davvero in una settimana normale, comprese quelle che oggi si perdono nelle chat, nelle call e nelle conversazioni con l’LLM, e del sistema che ne è proprietario. Poi l’ontologia minima: quali tipi di oggetti esistono, quali relazioni servono, chi decide sulle divergenze, come si chiamano i tag. Poi la classificazione dei dati, che dice quali modelli possono leggerli. Infine i connettori e le skill, partendo dalle procedure che il team ripete più spesso e che oggi dipendono dalla memoria di una persona.

La parte tecnica, in molti casi, è la più rapida. Le fonti esistono già, hanno i loro connettori, e spesso basta farle convergere in un punto con un criterio di ingresso. Il lavoro più lungo è organizzativo: mettersi d’accordo su cosa conta come decisione, su chi può chiudere una divergenza, su quali dati non devono uscire dall’azienda e su quali tag hanno diritto di esistere è una conversazione che in molte aziende non è mai stata fatta. Scrivere nero su bianco quali sono gli oggetti della conoscenza di un team, e chi ne risponde, è il primo pezzo di uno spazio intelligente, e viene molto prima della scelta del modello da collegare.


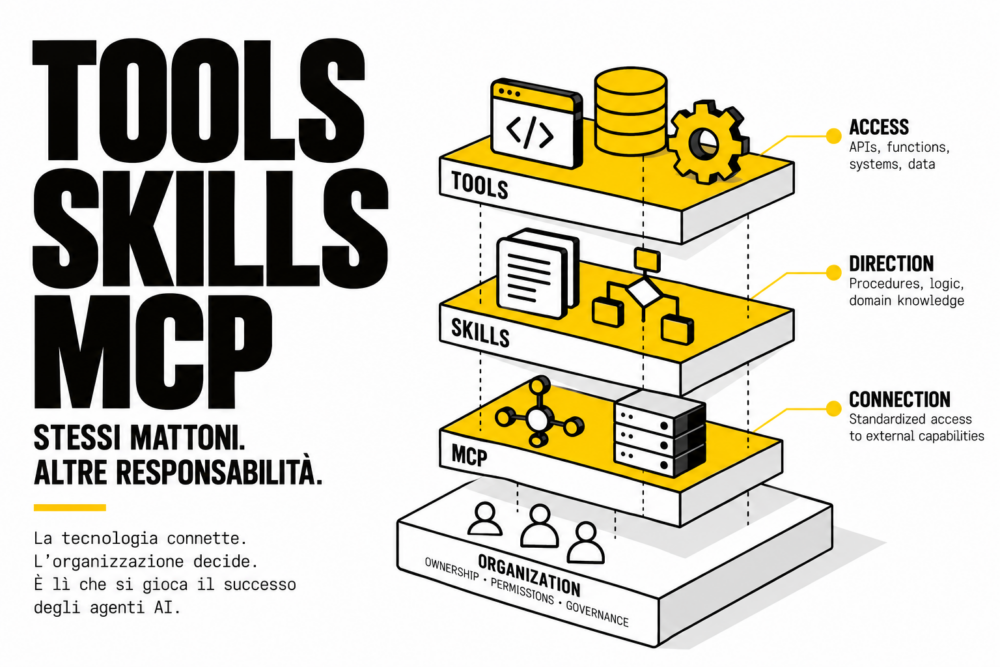
Tool, skill e MCP: prima si disegna l’organizzazione, poi l’agente

Su Medium ho trovato un articolo di Prabhu, che leggo da un po’, Tools vs Skills vs MCP, che mette in una tabella di tre righe i mattoni con cui oggi si costruisce un agente AI: i tool danno accesso, le skill danno direzione, MCP connette a capacità esterne. È una sistemazione utile per chi scrive codice e ha sentito usare le tre parole come sinonimi in una riunione, e la consiglio. Ho però l’impressione che per chi porta gli agenti dentro un’azienda quella tabella vada letta partendo da una colonna che non c’è, quella che dice chi ha deciso la procedura, chi ha concesso il permesso, chi possiede il sistema dall’altra parte del cavo.

Ogni riga della tabella tecnica ha un gemello organizzativo, e il gemello arriva prima. Una skill presuppone una procedura che qualcuno ha deciso e messo per iscritto, un tool presuppone una delega di potere con un perimetro, un server MCP presuppone un confine fra due sistemi che ha già un proprietario. Quando il gemello organizzativo manca la tecnologia non lo crea, lo simula, e la simulazione funziona benissimo finché non succede qualcosa.

Dentro il codice le tre cose si toccano

Conviene partire dal livello tecnico, perché è lì che la tabella semplifica di più. Un tool, nel senso che gli danno le API dei modelli, è una definizione: un nome, una descrizione in linguaggio naturale e uno schema JSON dei parametri. Il modello non esegue niente, produce una richiesta strutturata (chiama questa funzione con questi argomenti) e il runtime che gli sta intorno decide se eseguirla, con quali credenziali e cosa restituire. È la separazione su cui avevo costruito il pezzo sull’harness engineering: fra l’intenzione del modello e l’effetto nel mondo c’è sempre un pezzo di codice che qualcuno ha scritto e che può dire di no.

MCP, pubblicato da Anthropic a fine 2024 e poi adottato dagli altri grandi fornitori, sta un livello sotto i tool. È un protocollo costruito su JSON-RPC 2.0 con cui un’applicazione host apre connessioni verso uno o più server, e ogni server dichiara quali tool mette a disposizione del modello, affiancandoli se serve con risorse da leggere come contesto e con prompt riutilizzabili. Il trasporto può essere locale, un processo lanciato sulla macchina che parla attraverso lo standard input, oppure remoto su HTTP, con l’autorizzazione affidata a OAuth. In pratica MCP è il modo in cui i tool viaggiano: invece di cablare una funzione dentro ogni applicazione la si scrive una volta in un server e la si rende disponibile a qualunque client parli il protocollo.

Le skill sono l’oggetto più recente. Nel formato che Anthropic ha introdotto nell’autunno 2025 e poi aperto come standard, una skill è una cartella con un file SKILL.md, un’intestazione con nome e descrizione seguita da istruzioni in markdown, a cui si possono aggiungere file di riferimento e script eseguibili. Il meccanismo che la distingue da un prompt lungo si chiama progressive disclosure: il modello vede all’inizio solo nome e descrizione di tutte le skill installate e carica il corpo soltanto quando il compito lo richiede, così cento skill costano in contesto poche righe ciascuna finché restano inutilizzate. Una skill può contenere script, quindi porta con sé capacità, e un server MCP può esporre prompt, quindi porta con sé procedure. I confini si sovrappongono, e l’autore lo riconosce.

La colonna che mi convince meno è quella sulla manutenzione, dove MCP risulta «spesso gestito dal provider». Vale per GitHub o per Google Drive. Per il gestionale interno, per il CRM personalizzato da un fornitore che nel frattempo ha chiuso, per il database della produzione, il server MCP lo scrive e lo mantiene l’azienda, e il protocollo standardizza la forma della conversazione senza togliere a nessuno la responsabilità del contenuto.

La procedura di design che l’articolo propone parte da una domanda di capacità (cosa deve saper fare l’agente) e arriva ai sistemi esterni. Funziona per un team di sviluppo che costruisce un assistente per sé stesso. Dentro un’organizzazione la prima domanda riguarda l’autorità, e la capacità viene dopo.

Scrivere una skill obbliga a decidere il criterio

L’esempio dell’articolo è una skill per il rilascio di un’app Flutter in nove passi, dal controllo del branch fino al riepilogo finale. È un buon esempio proprio perché è facile: in un team di sviluppo quella procedura esiste già, spesso codificata in una pipeline di integrazione continua, e trasformarla in skill significa tradurla.

In azienda le procedure che vale la pena delegare a un agente raramente sono così. Come si valuta se un cliente merita una deroga sui tempi di pagamento, quando un reclamo va passato all’ufficio legale: sono decisioni che vivono nella testa di tre persone, ognuna con una versione leggermente diversa, mentre la versione ufficiale sta in un manuale qualità che nessuno apre da anni.

Quando si scrive la skill ci si accorge che manca il criterio, e a quel punto le strade sono due. Può scriverlo chi sta costruendo l’agente, un tecnico o un consulente che non ha l’autorità per decidere come l’azienda tratta i clienti morosi e che, per far funzionare il sistema, finisce per deciderlo lo stesso. Oppure ci si ferma e si chiede a chi ha quell’autorità di mettere il criterio per iscritto, ed è qui che il progetto rallenta, perché scrivere un criterio lo rende discutibile. Nel pezzo su chi delega all’AI il proprio lavoro avevo raccontato come la delega sia più bassa proprio nelle professioni dove il criterio è il patrimonio, e credo che dentro le aziende agisca la stessa dinamica.

Me ne accorgo ogni volta che scrivo le skill che uso per lavorare: la parte che richiede tempo sono sempre le regole, il formato del file si impara in un pomeriggio. La skill con cui preparo i pezzi per questo blog contiene un elenco di cose da evitare costruito correzione dopo correzione nel corso di mesi, e ogni riga è una decisione editoriale che prima stava solo nella mia testa e che adesso posso rileggere e contestare. Vista da fuori, una skill ben scritta è un documento di organizzazione con l’estensione .md.

Il permesso viene prima dello strumento

Un tool, guardato dall’organizzazione, è una delega di potere. createJiraTicket() è innocuo, issueRefund() no, e la differenza non sta nel codice (sono due chiamate HTTP molto simili) ma nel fatto che la seconda sposta denaro per conto di qualcuno.

Chi concede quel potere all’agente, e con quale identità l’agente lo esercita, sono domande che un’azienda sa già porsi per le persone, tanto che esistono procure, limiti di spesa per ruolo e doppie firme sopra una certa soglia. Per gli agenti queste regole di solito non ci sono, e il caso più frequente che incontro è l’agente che eredita le credenziali di chi lo ha configurato, con tutti i suoi permessi, compresi quelli che nessuno gli avrebbe mai delegato consapevolmente. Ogni tool concesso a un agente dovrebbe essere un permesso revocabile, con un titolare che sa di averlo firmato.

Nella guida alle istruzioni per Claude Code raccontavo come un’istruzione scritta nel prompt si pieghi sotto pressione mentre un hook no. Con i permessi succede lo stesso: scrivere nella skill «non emettere rimborsi sopra i 500 euro» esprime un desiderio, far rifiutare la chiamata al server sopra quella soglia stabilisce una regola. Il modello organizzativo decide la soglia e la tecnica la rende inviolabile, in quest’ordine, perché nessun ingegnere dovrebbe stabilire da solo quanta fiducia l’azienda concede a un software.

MCP disegna confini che hanno già un proprietario

Il diagramma dell’articolo mette l’applicazione AI in alto, il server MCP al centro e sotto GitHub, un database e Jira. Da dentro un’azienda ognuna di quelle scatole ha un responsabile, un budget, un fornitore con un contratto e spesso un’opinione precisa su chi può leggere i suoi dati. Scrivere un server MCP per il CRM significa decidere quali parti del CRM diventano leggibili da un agente e in nome di chi, e quella decisione appartiene al responsabile commerciale e al DPO prima che al team IT.

Il server MCP del blog su cui sto scrivendo ne è un esempio piccolo. Impone una sequenza di stati, dalla bozza alla revisione fino all’approvazione e alla programmazione, e rifiuta i salti. Quella sequenza è una decisione organizzativa su chi controlla cosa prima che un testo esca col mio nome, e sta nel server proprio perché non può dipendere dalla buona volontà del modello in una sessione qualsiasi.

C’è poi il livello del significato, che nessun protocollo tocca. Due server MCP possono esporre lo stesso campo «cliente» intendendo cose diverse, uno i clienti attivi e l’altro chiunque abbia mai ricevuto un’offerta, e l’agente li userà entrambi con la stessa sicurezza. Ne ho scritto a proposito dell’interoperabilità fra agenti, dove il vocabolario precede il protocollo, e del modello dati come teoria dell’azienda: MCP standardizza il tubo, e quello che ci scorre dentro porta con sé tutte le ambiguità organizzative che c’erano prima.

Il codice moltiplica il modello organizzativo che trova

Sarebbe sbagliato concludere che la tecnica sia un dettaglio da sistemare a valle. La sequenza che propongo alle aziende con cui lavoro differisce da quella dell’articolo soltanto nell’ordine delle domande, perché parte da chi decide e con quale criterio, passa per i poteri che si delegano e le soglie che li limitano, arriva ai confini fra sistemi e ai loro proprietari. A quel punto si scrivono skill, tool e server, e ognuno diventa la forma eseguibile di una decisione già presa.

Quando la decisione esiste, la tecnica le dà proprietà che sulla carta non ha mai avuto. Scritta in una skill, una procedura diventa versionata, e si può ricostruire quale versione ha guidato un’azione in una certa data; il permesso, quando sta nel server, si può testare e la sua violazione lascia un log; per spostare un confine dichiarato in un server MCP serve una modifica che qualcuno deve approvare. Il manuale qualità non aveva nessuna di queste caratteristiche, ed è per questo che nessuno lo apriva.

C’è anche un effetto di ritorno. Scrivere una skill è il modo più rapido che conosco per scoprire dove un’organizzazione non ha mai deciso niente, perché il modello, a differenza di un collega esperto, non riempie i vuoti con il buon senso del corridoio: li riempie con una media statistica, e la media si vede subito. Da quando ho scritto Pelle Digitale penso alle interfacce fra persone e macchine come ai punti in cui qualcosa di implicito è costretto a diventare esplicito, e gli agenti portano quel passaggio dentro l’organigramma.

Nei prossimi mesi i fornitori renderanno skill e server MCP facili da installare quanto un’app, e molte aziende ne avranno a decine prima di aver deciso chi li governa. Il vantaggio andrà a chi userà questo periodo per fare l’esercizio al contrario, prendendo una procedura alla volta e cercando chi l’ha decisa. Spesso la risposta sarà nessuno, e da lì comincia il progetto.


Harness engineering: runtime, contesto, permessi

Il modello non è quasi mai il problema. Adnan Masood, in un’analisi dell’aprile 2026 sul control plane degli agenti, riporta che il 65% dei fallimenti dei progetti AI in azienda non nasce da carenze di ragionamento del modello, ma da difetti dell’infrastruttura che gli sta intorno, dal contesto che va alla deriva agli schemi disallineati, fino allo stato che degrada nel tempo senza che nessuno se ne accorga. Lo stesso numero gira in più rassegne di settore, e dice una cosa scomoda per chi compra licenze guardando solo i benchmark. La parte che fa fallire i progetti sta altrove, in un livello, l’harness engineering, che fino a diciotto mesi fa nessuno chiamava per nome.

Adesso un nome ce l’ha. Si chiama harness engineering, ed è diventato il mestiere che separa una demo che impressiona in riunione da un agente che regge tre mesi in produzione senza che qualcuno debba riavviarlo a mano ogni venerdì.

Harness engineering, cosa c’è davvero intorno al modello

L’harness è l’infrastruttura di runtime che avvolge il loop di ragionamento di un LLM. Salesforce lo descrive bene con un’immagine edilizia: il framework, LangChain o un agent builder qualsiasi, è il progetto dell’edificio, l’harness è il cantiere dove l’agente lavora davvero. Un paper su arXiv di marzo 2026 sull’architettura degli agenti da terminale lo definisce come il livello che coordina, a runtime, la spedizione degli strumenti, la gestione del contesto, l’applicazione delle regole di sicurezza e la persistenza dello stato fra un turno e l’altro.

Tradotto per chi deve decidere: il modello è il motore, l’harness è tutto il resto dell’auto. Senza, hai un blocco di potenza che gira a vuoto.

Dentro questo livello vivono sei o sette sottosistemi che lavorano insieme. L’assemblaggio del contesto, che decide cosa entra nella finestra del modello a ogni passo. I contratti degli strumenti, gli schemi che il modello deve rispettare quando chiede un’azione. La memoria, che tiene insieme un compito lungo. L’osservabilità, che permette di capire cosa è successo quando qualcosa va storto. Il recupero degli errori e l’orchestrazione, che governano la danza tra modello, strumenti e dati. Ognuno di questi è un punto dove un prototipo elegante diventa fragile.

System design per un runtime che hallucina

C’è un’obiezione che chi ha background da systems engineer fa appena sente “harness engineering”: questo lo facciamo da decenni. Loop che persistono lo stato tra una chiamata e l’altra, validazione degli input prima dell’esecuzione, retry on failure, log per l’audit. È esattamente quello che scrivi quando avvolgi un’API esterna e pensi “forse dovrei gestire il timeout”.

Akshay Kokane, in un’analisi che gira molto tra chi costruisce sistemi agentici, mette la questione in modo diretto: l’harness engineering è al 90% system design che conosci già, applicato a un substrato nuovo. Il 10% rimanente è genuinamente diverso, perché il tuo sistema ora ha al centro un componente non deterministico che può hallucinar una tool call, restituire una risposta semanticamente sbagliata o perdere il filo dell’obiettivo dopo quaranta turni di conversazione.

La differenza concreta sta in un solo punto: con un’API tradizionale validi il formato dell’output, con un agente devi validare l’intento. La pipeline di permessi di Claude Code non controlla solo se una tool call è sintatticamente valida, controlla se il modello è autorizzato a volere quello che vuole. Il vecchio stack retry-and-log non basta più perché il problema non si trova nella risposta, si trova nella richiesta, prima che qualcosa venga eseguito.

Questo spiega anche perché il nome è arrivato adesso, e perché conviene tenerlo anche se sa di marketing. Chi entra nell’AI engineering senza anni di systems engineering alle spalle ha bisogno di un vocabolario per afferrare questi pattern. Chi conia quel vocabolario si prende conferenze, SEO e mindshare, certo, ma distribuisce anche conoscenza che altrimenti resterebbe dispersa nei thread di GitHub. Il termine vale la pena impararlo per ciò che descrive, non per chi lo promuove.

La regola che cambia tutto

C’è un principio che ricorre in ogni guida seria sull’argomento, e vale la pena fermarsi: il modello non deve mai eseguire direttamente uno strumento. Mai. Il modello restituisce una richiesta di azione strutturata, l’harness valida lo schema, controlla i permessi, esegue, e reinietta il risultato.

Sembra un dettaglio implementativo. È invece il punto in cui si gioca la sicurezza di un sistema agentico in azienda. Se l’agente può chiamare arbitrariamente comandi, basta una prompt injection ben costruita dentro un documento che l’agente legge, e quel comando viene eseguito con i permessi dell’agente. Il livello di mediazione, la validazione tra l’intenzione del modello e l’azione sul mondo, è ciò che distingue un assistente da un rischio operativo che gira con le credenziali aziendali.

Le tassonomie di rischio più mature classificano le azioni: sola lettura, finanziarie, distruttive. Per ognuna una matrice di permessi diversa. È il tipo di ingegneria noiosa che non finisce nei keynote e che decide se il progetto sopravvive al primo incidente.

Quattordicimila parole perse in un colpo solo

Avevo costruito un agente editoriale che lavora sul mio blog via MCP, e per settimane ha funzionato. Poi un giorno, su un articolo molto lungo, una singola operazione ha sovrascritto un post intero perché lo strumento che usavo riscriveva l’intero corpo invece di toccare il blocco giusto. Quattordicimila parole perse in un colpo. Il modello aveva ragionato benissimo, l’harness intorno non aveva il vincolo che serviva.

Da lì ho imparato sulla mia pelle quello che le aziende stanno scoprendo su scala enterprise: la fragilità non sta nell’intelligenza del modello, sta nell’assenza di guardrail attorno alle sue azioni. Avevo dovuto cambiare strategia, passare a edit chirurgici con verifica a vuoto prima di ogni scrittura, salvare lo stato prima di toccarlo. Harness engineering applicato a una redazione di una persona sola.

Birgitta Böckeler, in un modello mentale pubblicato ad aprile 2026, descrive l’harness come una combinazione di guide in avanti e sensori di ritorno che si autocorreggono prima che l’output arrivi sotto gli occhi di un umano. Distingue i controlli computazionali, i linter, i test, dalle verifiche inferenziali, un modello che giudica un altro modello. Chiude con una proposta netta: la harnessability, la capacità di un sistema di essere imbrigliato in modo affidabile, dovrebbe diventare un criterio di prima classe nelle decisioni di architettura. Alla pari del costo e delle prestazioni.

L’etica nascosta in un livello di software

Qui il discorso esce dall’ingegneria ed entra in un territorio che mi interessa da tempo. In Pelle Digitale ho provato a descrivere lo strato sottile dove l’umano e la macchina si toccano, la mediazione che decide cosa passa e cosa no. L’harness è esattamente questo, portato dentro l’azienda: il punto in cui decidiamo quanta autonomia diamo a un sistema, dove mettiamo i confini, cosa l’agente può fare da solo e cosa deve passare da una mano umana.

Le scelte che sembrano tecniche sono scelte di governance: quali azioni richiedono conferma, quali log conservare e per quanto tempo, visto che la memoria di un agente che processa dati personali resta soggetta a GDPR come qualsiasi altro trattamento, e chi risponde quando l’agente sbaglia. Domande che nessun modello, per quanto grande, risolve da solo: si affrontano progettando con cura il guscio che gli sta intorno.

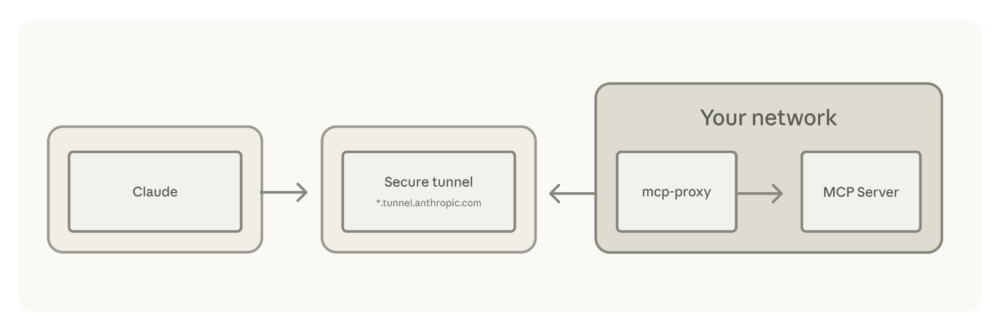
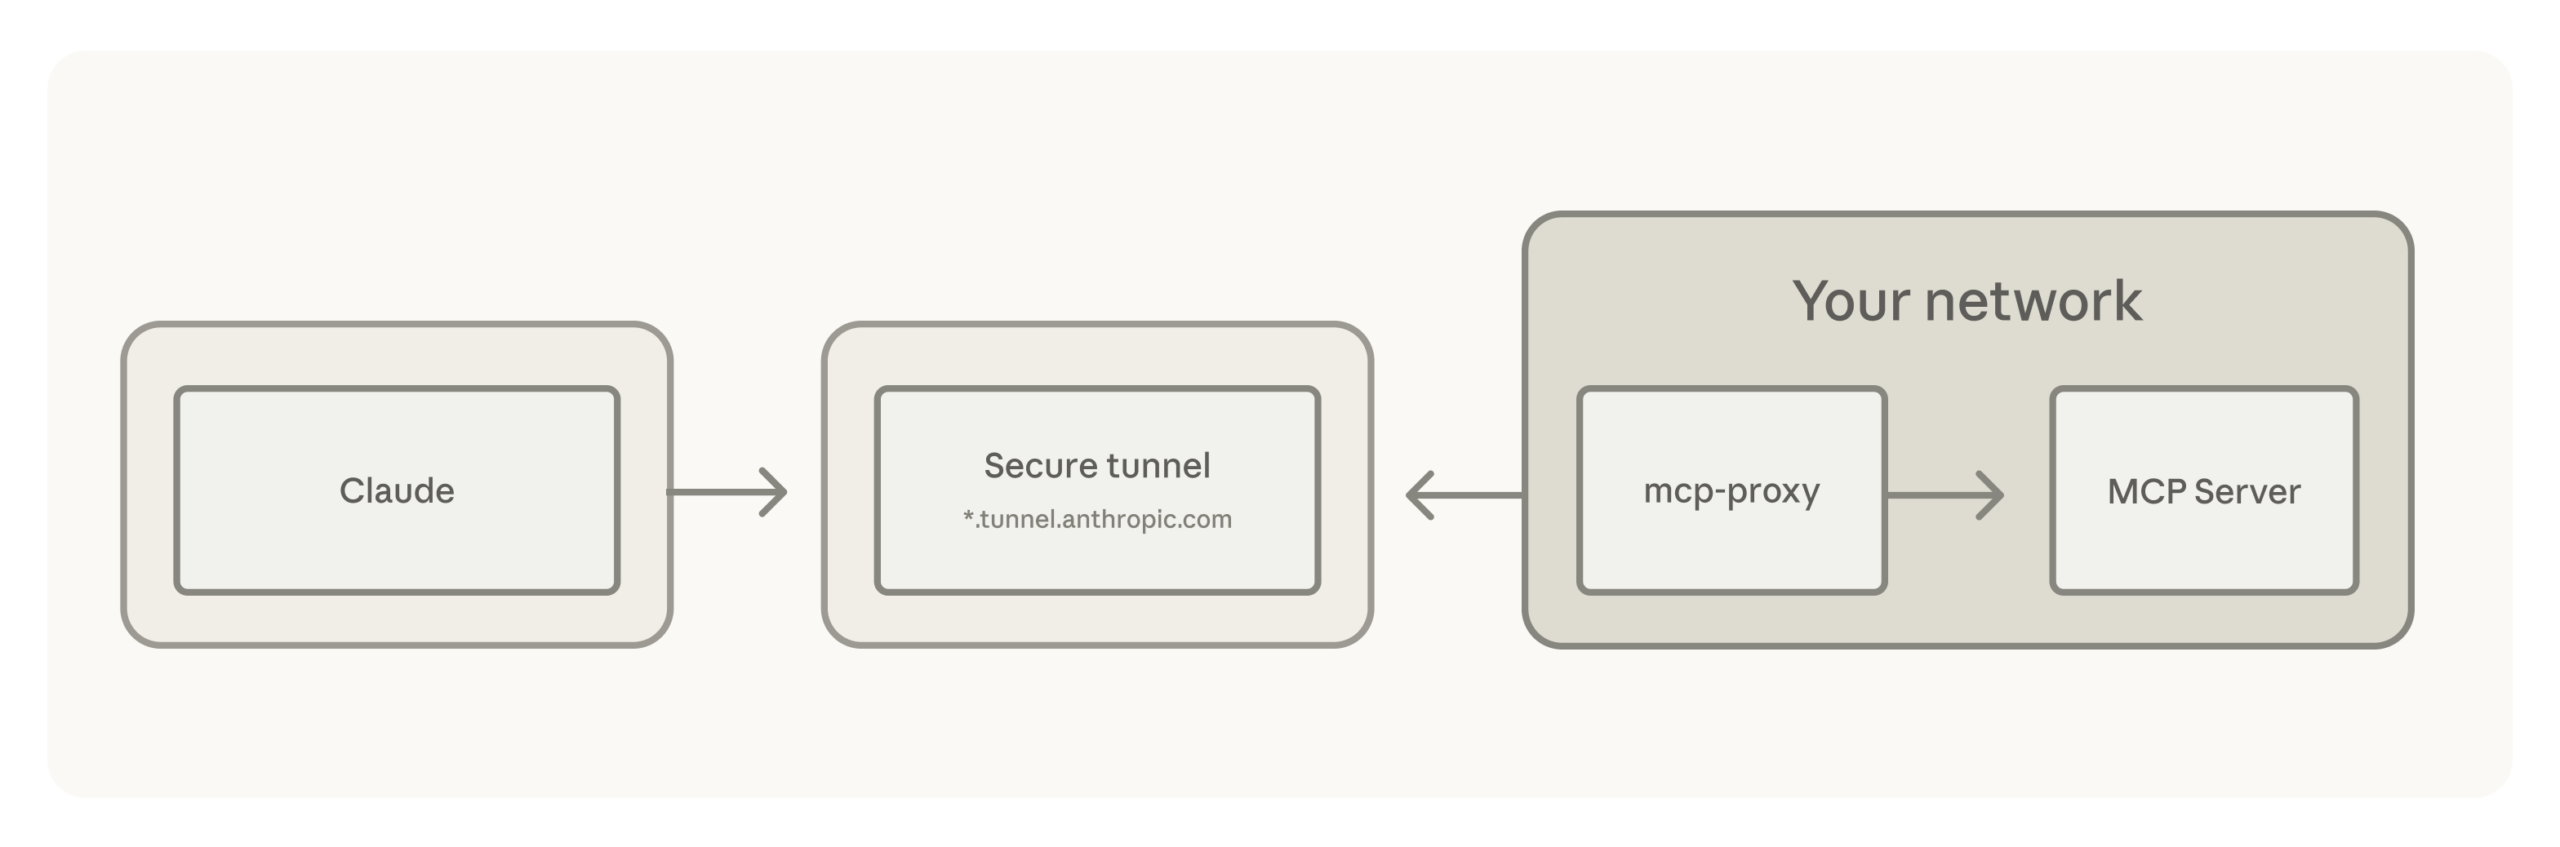
Avevo già osservato come Anthropic abbia spostato l’esecuzione degli agenti dentro l’azienda lasciando la regia fuori, con sandbox self-hosted e tunnel MCP. Quella mossa ha senso solo se chi la riceve sa costruire l’harness dalla propria parte del confine. Il fornitore ti dà il motore e parte dell’infrastruttura, il resto è responsabilità tua.

Prodotto, non collante

La soglia di accesso a un harness funzionante è più bassa di quanto sembri. Nick T., ricercatore che ha documentato la costruzione di un harness senza toccare una riga di codice, mette la cosa in modo diretto: chiunque può aggiungere file Markdown a un repository e sentire la differenza già dalla sessione successiva. Il CLAUDE.md o l’AGENTS.md nella root del progetto viene caricato dal modello all’avvio come un briefing. Le convenzioni di naming, i comandi di build, le cose da non fare: tutto scritto una volta, disponibile a ogni sessione senza doverlo ripetere. Primo strato, non l’intero edificio, ma quello che separa il ripartire da zero ogni volta dall’avere un agente che sa già dove si trova.

Trattate l’harness come prodotto, non come collante. La tentazione è incollare insieme un framework open e qualche script. Funziona finché non smette, di solito al primo carico reale. Le aziende che scalano comprano la plumbing commodity, runtime gestiti e telemetria di base, e costruiscono in casa la parte proprietaria che riguarda i loro dati e i loro permessi.

Mettete l’osservabilità prima dell’autonomia. Un agente che fa cose senza che voi possiate ricostruire cosa ha fatto è un debito tecnico travestito da innovazione. Prima i log strutturati e i sensori, poi l’allargamento dei poteri.

Testate l’harness, non solo il modello. Le valutazioni di sicurezza serie non si limitano a controllare le risposte del modello: provano l’infrastruttura con injection, timeout, sovraccarico di strumenti. Il punto debole è quasi sempre lì.

L’harness engineering non elimina i rischi degli agenti autonomi, li rende governabili. È una differenza che conta, perché governabile significa che qualcuno può rispondere delle decisioni del sistema, e in azienda è esattamente la domanda da cui parte tutto il resto. Quanta autonomia dare a un sistema di cui capiamo fino in fondo solo il guscio è una scelta di governance, e la maturità di un’organizzazione si vede da quanto sa tenerla bassa proprio dove tornare indietro costa di più. Se l’argomento vi tocca da vicino, è il terreno su cui lavoro con CEO e CTO ogni settimana.


Spunto dall’analisi di Adnan Masood sul control plane degli agenti, dal modello mentale di Birgitta Böckeler sull’harness engineering e dall’analisi di Akshay Kokane su Agent Harness Is Just System Design With a New Name (Level Up Coding) e dall’analisi pratica di Nick T. su Harness Engineering: A Deep Dive Into the Buildable Harness via Markdown Files (AI Advances).

Claude Code orchestra i suoi agenti: dynamic workflows e la riscrittura di Bun

Il 28 maggio 2026 Anthropic ha aperto in research preview i dynamic workflows dentro Claude Code, disponibili su CLI, app desktop, estensione VS Code e via API su Bedrock, Vertex AI e Microsoft Foundry. La meccanica, descritta nel comunicato, è che Claude scrive al volo uno script di orchestrazione e lo esegue lanciando da decine a centinaia di subagent in parallelo nella stessa sessione, verificando il proprio lavoro prima che qualcosa arrivi a te. Per chi guida un’azienda che sta valutando dove mettere l’AI nel proprio stack, la notizia non è il numero di agenti, è cosa cambia nel modo in cui un problema grande viene scomposto e chiuso.

Ci ho ragionato per qualche giorno prima di scriverne, perché la prima reazione, leggendo “centinaia di agenti in parallelo”, è di archiviarlo come l’ennesima demo da keynote. Poi ho guardato il caso che Anthropic mette in cima al post, e il caso è meno comodo di quanto sembri.

Il salto rispetto al singolo agente

Fino a ieri il modello mentale era lineare: un agente legge il contesto, ragiona, agisce, controlla, e quando il compito è troppo grande lo spezzi tu, a mano, in pezzi che la finestra di contesto riesce a tenere. Funziona finché il piano sta in tre o quattro passaggi. Smette di funzionare quando il lavoro tocca migliaia di file, o quando lo stesso problema va affrontato da angoli indipendenti per essere affidabile.

Un dynamic workflow ribalta l’ordine. Claude parte dalla richiesta in linguaggio naturale, pianifica il lavoro e lo scompone in sottocompiti, distribuendoli su subagent che girano in parallelo. I risultati vengono controllati prima di essere ricomposti. Agenti diversi attaccano il problema da prospettive indipendenti, altri agenti provano a smontare quello che i primi hanno trovato, e il ciclo itera finché le risposte convergono. La coordinazione avviene fuori dalla conversazione, in uno script che gira in background, e questo è il dettaglio architetturale che conta: il piano resta in piedi a prescindere da quanto cresce il compito, e un lavoro interrotto riprende da dove si era fermato invece di ripartire da zero.

Pasquale Pillitteri, in una delle prime analisi tecniche italiane, l’ha sintetizzato bene: nessun modello nuovo, nessun plugin, soltanto uno scarto architetturale sottile per cui Claude scrive uno script di orchestrazione in JavaScript a partire dalla richiesta, mentre un runtime separato lo esegue in background.

Bun, ovvero il caso scomodo

L’esempio che Anthropic porta come prova è la riscrittura di Bun, il runtime JavaScript alternativo a Node. Jarred Sumner ha usato i dynamic workflows per portare Bun da Zig a Rust: circa 750.000 righe di Rust, il 99,8% della test suite esistente che passa, undici giorni dal primo commit al merge. Un workflow ha mappato il lifetime Rust corretto per ogni campo di ogni struct nel codice Zig. Quello successivo ha riscritto ogni file .rs come port a comportamento identico del corrispettivo .zig, con centinaia di agenti in parallelo e due reviewer su ciascun file. Un fix loop ha poi guidato build e test fino a farli girare puliti. Dopo il merge, un workflow notturno ha aperto una pull request per ogni copia di dati superflua, lasciando la revisione finale a un umano.

Numeri da capogiro. Solo che la storia ha un’altra metà che il comunicato non racconta, e che vale la pena conoscere prima di firmare un budget su questa promessa.

Quando il branch è apparso a fine aprile, la community degli sviluppatori è esplosa: oltre 700 voti e 500 commenti su Hacker News in poche ore. Sumner stesso, il 5 maggio, scriveva su quel thread che era tutto un’esagerazione, che non c’era nessun impegno a riscrivere, e che c’era un’alta probabilità che il codice venisse buttato via del tutto. Non è andata così, il merge è arrivato il 14 maggio. Però le critiche tecniche restano sul tavolo: alcuni vecchi test sarebbero stati modificati perché la versione Rust li superasse, e l’uso della keyword unsafe da parte di Claude rende meno solida la promessa di sicurezza sulla memoria che il passaggio a Rust dovrebbe garantire. heise riporta che le issue su GitHub hanno iniziato ad accumulare i primi problemi che con la versione Zig non si presentavano.

Tengo insieme le due cose di proposito. Il workflow ha prodotto in undici giorni un risultato che a mano avrebbe richiesto trimestri, ed è una capacità reale. E allo stesso tempo il “99,8% dei test passa” significa qualcosa di diverso se una parte di quei test è stata adattata, e “non ancora in produzione” è una postilla che pesa. Chi valuta questa tecnologia per la propria azienda deve guardare entrambe le metà.

Piani che diventano codice

La regola operativa che emerge dalla documentazione e dall’uso reale è semplice. Se il piano sta in due o tre passaggi che Claude tiene in testa, restano migliori i subagent o le skill. Quando il piano diventa codice, ripetibile, scalabile a centinaia di operazioni indipendenti, allora ha senso un workflow.

I casi d’uso che Anthropic e i suoi clienti early access citano cadono tutti dentro questa logica. Bug hunt su un intero servizio, con verifica indipendente su ogni finding così che il report contenga problemi veri e non rumore. Audit di sicurezza e di ottimizzazione guidati dal profiler. Migrazioni e modernizzazioni che toccano migliaia di file, swap di framework, deprecazioni di API, port da un linguaggio all’altro. E il lavoro critico che vuoi controllato due volte, dove il costo di una risposta sbagliata è alto e quindi metti agenti avversari a provare a rompere il risultato prima che tu lo veda.

Alessio Vallero di Klarna, citato nel comunicato, racconta di aver avuto risultati forti nell’identificare codice morto e opportunità di pulizia che l’analisi statica tradizionale non vedeva. Ken Takao di CyberAgent dice che i workflow riempiono lo spazio tra il lanciare un singolo subagent e il costruire un team di agenti completo, e che il passaggio dal piano all’implementazione scorre senza perdere visibilità. Sono testimonianze di parte, fa parte del gioco di un lancio, ma descrivono un perimetro d’uso coerente: discovery e review su codebase grandi e legacy.

Il conto da tenere d’occhio

Qui arriva l’avvertenza che Anthropic, in modo per certi versi inusuale, mette nero su bianco fin dal lancio. Un dynamic workflow consuma molti più token di una sessione tipica di Claude Code. La raccomandazione esplicita è di partire da un compito circoscritto per farsi un’idea del consumo, prima di lanciarsi su lavori grandi. La prima volta che un workflow si attiva, Claude Code mostra cosa sta per girare e chiede conferma. Gli amministratori di un’organizzazione possono disabilitarlo dalle impostazioni gestite, e sui piani Enterprise è spento di default al lancio.

C’è anche un tetto: i workflow sono limitati a 1.000 subagent. Per attivarli, due strade: chiedere a Claude di creare un workflow, oppure accendere ultracode, l’impostazione specifica di Claude Code che porta l’effort a xhigh e lascia decidere a Claude quando usare un workflow.

Per un CIO italiano la traduzione è questa. La capacità tecnica è notevole e va provata, su un perimetro ristretto e misurabile, con un occhio fisso sul consumo. Il governo della spesa diventa parte integrante della governance dell’AI, non un dettaglio amministrativo, perché uno strumento che lancia centinaia di agenti autonomi su una codebase è potente esattamente quanto è capace di bruciare budget se lasciato senza confini. È la stessa logica di cui scrivo da tempo quando parlo di vendor lock-in nei progetti AI enterprise: la potenza di uno strumento non è mai gratis, e il costo nascosto si paga dopo.

La pianificazione delegata, la verifica no

L’orchestrazione di agenti che si controllano a vicenda è un cambio di postura rispetto a tutto ciò che abbiamo usato finora. Una macchina che genera ipotesi, ne mette altre a confutarle, e consegna solo quello che sopravvive al confronto, assomiglia più a un metodo di lavoro che a un autocomplete sofisticato. In Pelle Digitale ho provato a descrivere la frontiera tra la persona e la macchina come una superficie di mediazione, e questo è un punto preciso lungo quella superficie: il momento in cui smettiamo di guidare l’AI passo per passo e iniziamo a delegarle la pianificazione, tenendo per noi la verifica finale e la responsabilità.

Resta da capire quanto regge fuori dalle demo. Il caso Bun mostra cosa è possibile e, insieme, cosa va verificato a mano dopo. Per le aziende medie italiane, quelle che seguo da vicino nel mio lavoro di advisory, la domanda non è se questa tecnologia funziona, perché in parte funziona già. La domanda è dove conviene puntarla, con quale budget, e con quale presidio umano sul risultato finale.

Senza dubbio è uno degli annunci più densi degli ultimi mesi per chi costruisce software. Quanto di questa capacità arriverà davvero nelle mani di chi sviluppa codice ogni giorno in un’azienda normale dipenderà da chi saprà portarla dentro un perimetro misurabile, con un presidio umano sul risultato. Sono quelle le organizzazioni che ne ricaveranno un vantaggio concreto, mentre le altre resteranno a guardare i casi estremi da comunicato.


Fonte: Anthropic, Introducing dynamic workflows in Claude Code, 28 maggio 2026.

Schema del MCP tunnel di Anthropic: esecuzione dentro la sandbox, regia esterna

Anthropic sposta l’esecuzione dentro l’azienda, la regia resta fuori

Il 19 maggio, al primo Code with Claude tenuto a Londra, Anthropic ha annunciato due funzionalità che spostano in modo concreto dove vivono gli agenti AI dentro le aziende. La prima si chiama self-hosted sandboxes ed è in public beta. La seconda si chiama MCP tunnels ed è in research preview. Messe vicine valgono più di quanto sembrino a una lettura veloce della release note, e provo a dire perché.

Il punto di partenza tecnico è semplice. Claude Managed Agents è l’infrastruttura ospitata di Anthropic per far girare sessioni agentiche lunghe e tool-heavy. Fino a maggio, tutto stava lì: l’agent loop con orchestrazione e gestione del contesto, l’esecuzione dei tool, la connessione ai servizi esterni. Adesso una parte di quello stack può uscire da Anthropic e rientrare dentro il perimetro del cliente, mentre l’altra resta dove era. La regia rimane su Anthropic. L’azione si sposta a casa tua.

Schema del MCP tunnel di Anthropic: esecuzione dentro la sandbox, regia esterna
Fonte: Anthropic, schema del MCP tunnel.

L’esecuzione si sposta a casa tua

Quando un agente esegue un tool, esegue codice. Apre file, installa pacchetti, chiama API, scarica risorse. Fino a ieri tutto questo avveniva nei sandbox gestiti da Anthropic. Da oggi puoi configurare l’agente perché esegua quegli stessi tool dentro la tua infrastruttura, oppure presso un provider gestito a tua scelta (Cloudflare, Daytona, Modal, Vercel sono i nomi citati). I tuoi file sensibili, le repository di codice, i pacchetti privati, i segreti di configurazione non lasciano più la tua rete. E il logging di audit, le policy di sicurezza, gli strumenti di monitoring che hai già sul tuo perimetro continuano a vedere e regolare quello che fa l’agente.

L’orchestrazione, invece, resta su Anthropic. L’agent loop, la gestione del contesto, la recovery dagli errori, la pianificazione delle azioni successive sono tutti gestiti dall’API di Claude. Cambia solo dove materialmente vengono eseguite le chiamate. Se l’agente decide di lanciare uno script Python per processare un file, lo script gira sul tuo sandbox, non sul loro.

Un canale che parla solo verso l’esterno

Gli MCP tunnels affrontano il problema speculare. Come fa un agente a parlare con i tuoi sistemi interni senza che tu debba esporli a internet? Il Model Context Protocol è lo standard aperto che Anthropic ha promosso lo scorso anno per far dialogare gli agenti con sorgenti dati e servizi esterni. Funziona bene quando i servizi sono pubblici, meno bene quando sono dentro un network privato.

Il meccanismo che hanno introdotto è un gateway leggero, che il cliente dispiega dentro la propria rete, e che apre una singola connessione outbound verso Anthropic, cifrata end-to-end. Nessuna porta inbound da aprire. Nessun endpoint pubblico. Nessuna modifica al firewall. Sopra quel canale possono passare conversazioni MCP verso server interni che ospitano database, knowledge base, ticketing system, API private. L’agente di colpo può chiamare quei sistemi come fossero tool standard, ma il traffico non transita mai sull’internet pubblico.

Dove finisce l’azienda, dove comincia il modello

A una lettura superficiale è un aggiornamento di sicurezza e compliance. Per le aziende regolate è una notizia importante perché toglie uno dei blocchi tipici all’adozione, quel “non possiamo far uscire i dati” che ferma centinaia di progetti ogni anno. Per chi vende AI in enterprise è una mossa competitiva contro i player che offrono già installazioni on-premise complete.

C’è anche un altro livello. Anthropic sta dichiarando, in modo molto operativo, dove finisce l’azienda e dove comincia il modello. Per anni la domanda “dove vive un’AI aziendale” ha avuto due risposte estreme: o tutto in cloud sul provider, oppure tutto on-premise con uno stack auto-ospitato. Adesso ne sta diventando praticabile una terza, più sottile. La testa pensante del sistema, l’agent loop, resta fuori dall’azienda perché lì sta l’innovazione che si muove troppo veloce per essere replicata internamente. Le mani che toccano i dati e i tool tornano dentro perché lì stanno le regole, la responsabilità, il perimetro legale e culturale.

È una decomposizione interessante. Non è cloud, non è on-prem, è un terzo modello in cui l’autorità decisionale dell’agente è separata dall’autorità esecutiva. Anthropic decide come ragiona. Tu decidi cosa può toccare. La superficie di contatto fra i due livelli è codificata in due primitive ben definite, il sandbox e il tunnel.

Cambia anche il modo di comprarla

In Pelle Digitale avevo provato a descrivere come la mediazione tra noi e le macchine stesse cambiando forma. Quello che vedo qui è una variante infrastrutturale dello stesso fenomeno. La pelle non è più solo l’interfaccia in cui parliamo col modello. È anche la membrana tecnica che decide cosa passa e cosa no, cosa esce dall’azienda e cosa rientra, cosa il modello può sapere e cosa no. La progettano gli ingegneri di Anthropic disegnando le primitive del sistema. La progettiamo noi configurando policy, tunnel, sandbox.

Chi sta portando agenti AI in produzione dentro un’azienda strutturata, con questa architettura, deve mettere in conto tre cose che fino a ieri non c’erano.

Sul piano contrattuale e legale il discorso “i miei dati attraversano i server del fornitore” diventa meno semplice da fare, perché in molti scenari non è più vero. Tool execution e dati restano dentro, l’agente fuori vede solo quello che il sandbox gli restituisce. Vanno aggiornati i template di DPIA, le clausole nei contratti con i fornitori, le policy di data residency.

Sul piano organizzativo bisogna decidere chi gestisce un agente AI con questa architettura. Lo sviluppo software perché esegue codice. L’infrastruttura perché ospita sandbox e gateway. Il security perché definisce le policy del perimetro. Il data team perché decide quali sistemi interni esporre via MCP. Sono quattro funzioni che fino a ieri non lavoravano insieme su questo tipo di progetti, e bisognerà costruire workflow nuovi per farle convivere.

Sul piano strategico, Anthropic dichiara con queste mosse di voler diventare l’infrastruttura di default per gli agenti enterprise. Non un fornitore di modelli sotto, ma un layer di orchestrazione che si integra dentro le aziende mantenendo i confini tecnici e di sicurezza che le aziende vogliono. Per chi compra è una scelta strategica diversa rispetto a scegliere un fornitore di LLM più una soluzione di agentic framework messa su a parte. Per chi vende prodotti AI on top, conviene capire dove si posiziona la propria offerta rispetto a questo stack che si sta consolidando.

Il debug a cavallo del confine

C’è una cosa che la documentazione di Anthropic non risolve, e che secondo me sarà il punto di osservazione più interessante nei prossimi mesi. Quando l’agent loop sta fuori e i tool girano dentro, il debugging di un comportamento anomalo dell’agente diventa un esercizio distribuito. Il log dell’orchestrazione lo vede Anthropic. Il log dell’esecuzione lo vedi tu. La correlazione fra una decisione presa dal modello e un’azione fatta sul tuo sandbox passa attraverso due piani di osservabilità separati. Per capire perché un agente ha cancellato un file di troppo, serviranno entrambi.

Vedere come si organizza questa osservabilità a cavallo del confine sarà uno degli indicatori migliori per capire se il pattern decolla davvero, o se resta confinato ai casi d’uso più semplici. La promessa tecnica c’è, la direzione mi sembra giusta. Resta da vedere quanto in fretta le aziende, anche quelle non super-tech, riusciranno ad attrezzarsi per giocare a questo gioco con la maturità che richiede.


Articolo di riferimento: New in Claude Managed Agents: self-hosted sandboxes and MCP tunnels, Anthropic, 19 maggio 2026.

Organizzazioni Riflessive: progettare aziende consapevoli nell’era dell’AI e della complessità

Tra i numerosi spunti che Simone Cicero (qui se non lo conoscete) condivide regolarmente sui temi della progettazione organizzativa, il suo recente post nella newsletter di Boundaryless (il progetto su cui tra l’altro pochi giorni fa con Iconico ho investito) sul concetto di Organizzazioni Riflessive mi ha particolarmente stimolato una serie di riflessioni (e qui ne riporto solo una parte eh!).

Il punto che solleva arriva infatti in un momento perfetto, molto vicino ai temi che sto affrontando in questo periodo professionalmente parlando, sia nelle progettualità che sto sviluppando sia negli studi che sto approfondendo. Questa riflessione sulle Organizzazioni Riflessive si collega direttamente al lavoro che sto sviluppando attorno al paradigma del Model Context Protocol (MCP), evidenziando ancora di più la necessità, per le organizzazioni, di sviluppare nuovi modelli capaci di gestire l’accelerazione e la complessità prodotte dall’intelligenza artificiale e dall’integrazione tecnologica diffusa.

Riprendendo alcuni spunti di Simone, voglio condividere una visione personale integrativa che possa essere di stimolo e punto di partenza per ulteriori conversazioni e sperimentazioni, sia con me che con Boundaryless, approfondendo alcuni temi essenziali per progettare organizzazioni efficaci e consapevoli nell’era digitale e cognitiva.

Partiamo da un punto: cosa è veramente un’organizzazione riflessiva?

Un’organizzazione riflessiva non è semplicemente un’organizzazione che apprende. È qualcosa di più profondo: è un’organizzazione capace di guardare continuamente se stessa, di leggere e interpretare costantemente il proprio contesto, mettendo in discussione la propria struttura, cultura, decisioni e obiettivi. È consapevole delle proprie capacità, ma anche dei propri limiti, e utilizza entrambi per evolvere intenzionalmente in risposta a stimoli interni ed esterni. È un’organizzazione che non teme la complessità, ma la abbraccia come una leva fondamentale per costruire valore, adattarsi rapidamente e prendere decisioni efficaci e sostenibili. In parole povere, una vera organizzazione si può definire riflessiva se è capace di auto-osservazione continua, di adattamento intenzionale e di apprendimento integrato nel DNA aziendale. E questo a maggior ragione in un momento storico caratterizzato da accelerazione tecnologica estrema e complessità esponenziale.

Un’organizzazione riflessiva ha bisogno di un’ontologia.

Perché un’organizzazione possa essere realmente riflessiva (e potersi definire tale), è necessario prima di tutto dotarla di una lente comune con cui leggere e interpretare costantemente la propria realtà interna ed esterna. Questa lente è proprio l’ontologia: un insieme strutturato di concetti, termini e relazioni condivise che costituiscono un linguaggio chiaro, coerente e diffuso. Senza questa base semantica condivisa, ogni riflessione interna rischia di perdersi nell’ambiguità, creando disallineamenti interpretativi (noti nella maggior parte della aziende) e ostacolando la capacità di adattamento e innovazione dell’organizzazione. Un’ontologia ben definita di contro rende la riflessività non solo possibile ma molto più efficace, consentendo di analizzare rapidamente decisioni, processi e risultati, e soprattutto garantendo che ciò che viene compreso e imparato sia immediatamente traducibile in azione concreta. Per dirla in modo semplice, l’ontologia è quello che permette di evitare quella classica situazione del “Parlamm e nun ce capaimm” (cit): aiuta tutti a parlare la stessa lingua e, soprattutto, a capirsi davvero.

Ontologie condivise e affordance semantiche come infrastruttura strategica

Una ontologia condivisa, in un’organizzazione veramente riflessiva, è molto più di un linguaggio comune: è l’infrastruttura che consente di integrare rapidamente persone, tecnologie e processi, riducendo drasticamente il debito organizzativo generato da fraintendimenti e disallineamenti. Non basta avere strumenti sofisticati; dobbiamo costruire significati condivisi, chiaramente definiti e facilmente accessibili a tutti. Questa scelta strategica trasforma la semantica in una vera e propria piattaforma di crescita e innovazione, facilitando nuove integrazioni tecnologiche, migliorando la qualità delle interazioni interne e consentendo una collaborazione reale, fluida e consapevole.

Il costo nascosto della mancata condivisione semantica

Quando manca un’ontologia ben definita o quando questa non è costantemente aggiornata, l’organizzazione inevitabilmente “accumula” un problema. Questo debito è composto da inefficienze nascoste, decisioni rimandate, ambiguità interpretative e processi non allineati, che rallentano e appesantiscono il cambiamento e l’adattamento al contesto esterno. È un “costo invisibile” che emerge con evidenza solo nel momento in cui l’organizzazione prova a evolvere rapidamente, integrare nuove tecnologie o necessità di un cambio di passo immediato. La mancanza di linguaggi comuni porta spesso a progetti avviati e non conclusi, a colli di bottiglia decisionali e a tempi lunghi di onboarding e integrazione. Misurare concretamente questo debito significa osservare indicatori chiari: il tempo necessario a inserire nuove figure in azienda, la quantità di rework necessario per correggere incomprensioni o, ancora, il numero di iniziative strategiche bloccate o rallentate da conflitti interpretativi. Ecco perché una solida base semantica condivisa non rappresenta soltanto una best practice: è un vero e proprio investimento strategico per prevenire, gestire e utilizzare intenzionalmente il debito organizzativo come leva di trasformazione.

Il debito organizzativo come leva di trasformazione intenzionale

Affrontare seriamente il concetto di debito organizzativo non significa eliminarlo completamente, ma trasformarlo in un potente strumento di gestione strategica del cambiamento. Un’organizzazione riflessiva impara continuamente dai propri processi decisionali, sa riconoscere le proprie inefficienze e le usa come stimolo per ridefinire se stessa con tempestività e chiarezza. Accumulare temporaneamente debito organizzativo può essere una scelta consapevole, purché accompagnata da una chiara visione di lungo termine e da periodici momenti di rifattorizzazione organizzativa. In questo scenario, leader e progettisti diventano veri e propri architetti dell’adattabilità, capaci di bilanciare agilmente efficienza immediata e sostenibilità futura.

AI e learning culture come paradigma centrale

La crescente accelerazione dei processi decisionali e operativi, guidata dall’intelligenza artificiale, rende indispensabile una radicale evoluzione culturale: dobbiamo progettare le nostre organizzazioni per essere veri ecosistemi di apprendimento continuo, dove sperimentazione, analisi e feedback siano parte integrante della cultura operativa quotidiana. In questo senso, l’AI non solo automatizza e velocizza, ma diventa essa stessa strumento essenziale di riflessività organizzativa, rivelando schemi invisibili e aprendo nuove possibilità per comprendere e migliorare costantemente il nostro modo di lavorare.

Governance adattiva: abbracciare il cambiamento come regola

In un contesto complesso e dinamico, i modelli tradizionali di governance gerarchici o rigidi diventano rapidamente obsoleti. È necessario adottare modelli di governance adattiva, dove l’autonomia decisionale distribuita (e qui si potrebbero aprire mille altri temi sul principio di DAO, e decentralizzazione, ma ne scrivo più avanti) e la revisione continua delle scelte diventino la norma. Questo approccio richiede una profonda trasformazione mentale: accettare l’errore come fonte di apprendimento, e concepire l’adattamento non come eccezione, ma come naturale evoluzione dei processi decisionali. L’AI, inserita in questo quadro, può amplificare le capacità umane di monitoraggio, revisione e adattamento, garantendo coerenza e trasparenza nelle scelte aziendali.

Un nuovo driver di efficienza : progettazione semantica e architettura della conoscenza

Costruire intenzionalmente un’architettura semantica interna non è solo questione di chiarezza informativa: è un potente moltiplicatore di efficienza, comprensione e valore. In un’organizzazione che mira ad un cambiamento di questo genere, la conoscenza non è frammentata in silos, ma connessa attraverso significati comuni che orientano decisioni e azioni quotidiane. Questa architettura semantica diventa un “navigatore aziendale”, guidando persone e sistemi intelligenti verso informazioni contestuali e precise, riducendo sprechi cognitivi e aumentando significativamente la qualità del lavoro svolto.

MCP e integrazione contestuale: l’AI come alleato di senso

Il Model Context Protocol rappresenta un punto di svolta nella relazione tra AI e organizzazioni, consentendo un’integrazione profonda, contestuale e coerente tra sistemi intelligenti e fonti aziendali. Utilizzando MCP, le organizzazioni non solo riducono drasticamente i rischi di informazioni inaccurate o incomplete, ma potenziano enormemente la capacità dell’AI di contribuire a decisioni e processi con una profondità e precisione mai raggiunte prima. MCP diventa così uno standard non solo tecnologico, ma strategico, capace di collegare efficacemente intelligenza artificiale e contesto aziendale.

Strumenti visuali e canvas come supporto alla progettazione riflessiva

Strumenti visuali e canvas, come il Portfolio Map Canvas sviluppato proprio da Boundaryless, diventano centrali per progettare e supportare il disegno di organizzazioni riflessive. Questi strumenti non sono semplici artefatti visivi, ma veri e propri spazi interattivi di co-design e riflessione collettiva, e aggiungerei metodo. Utilizzati regolarmente, permettono di visualizzare rapidamente incoerenze e opportunità nascoste, migliorando significativamente l’allineamento strategico e operativo. Integrarli nella vita quotidiana aziendale, attraverso rituali organizzativi strutturati e strumenti digitali collaborativi, permette di mantenere viva e attiva la capacità di riflessione organizzativa, evitando che restino esercizi isolati o occasionali.

Guardare se stessi, per superare i limiti 

Questi spunti vogliono essere un punto di partenza per stimolare una conversazione più ampia: la vera sfida, oggi, non è solo innovare o digitalizzare, ma creare organizzazioni capaci di guardarsi continuamente allo specchio, comprendere in profondità se stesse e usare questa consapevolezza per evolvere intenzionalmente. In un’epoca segnata dall’accelerazione dell’intelligenza artificiale e dalla crescente complessità, credo sia fondamentale costruire nuovi paradigmi organizzativi basati sulla condivisione semantica, sulla riflessione continua e sull’apprendimento integrato.

Questo approccio non riguarda più solo pochi innovatori o visionari, ma diventerà sempre più essenziale per ogni organizzazione che voglia prosperare e creare valore duraturo. Sono convinto che sia necessario iniziare a ripensare continuamente il modo in cui lavoriamo, il modo in cui interpretiamo il contesto, e come trasformiamo questa comprensione in azioni concrete e sostenibili nel tempo.

Forse perché di tempo appunto, ne abbiamo sempre meno per riflettere.

Model Context Protocol (MCP): potenzialità, rischi e uso responsabile

Un paio di giorni di fa ho scritto un post riguardo la mia visione del Model Context Protocol (MCP), il nuovo standard aperto per integrare modelli linguistici (LLM) con tool e sorgenti dati esterne. In un paio di giorni, forse colpa anche dell’algoritmo di Linkedin, MCP è rapidamente diventato il tema de facto del mio stream in modo permanente. Da articoli per collegare chatbot e agenti AI con servizi di terze parti fino ad articoli con visioni più estreme della mia, soprattutto in temi di sicurezza ed opportunità come il bel post di approfondimento dal titolo Everything Wrong with MCP di Shrivu Shankar che ho intercettato grazie ad una interazione di Paola Bonomo.

Insieme all’entusiasmo – ovvio – per il tema è evidente che, come per tutto, stanno emergendo ora analisi che evidenziano vulnerabilità, limiti strutturali e problemi di user experience, che in parte avevo citato anche nel mio primo post di approfondimento.

In questo post , viste le discussioni che ho letto e sulle quali mi sto confrontando in diversi ambiti, provo ad andare un po’ oltre precedente: andrò più a fondo sulle potenzialità di MCP in termini di standardizzazione e interoperabilità, ma anche le criticità legate a sicurezza, prompt injection, esperienza utente e i limiti nell’uso di LLM con molti strumenti attivi. Ho aggiunto alla fine uno spunto sul trade-off tra facilità d’uso e controllo, proponendo principi per un uso più sicuro e responsabile di MCP sia per sviluppatori che per utenti finali.

MCP come standard di integrazione

Il Model Context Protocol nasce come ho già scritto con l’obiettivo di standardizzare il modo in cui le applicazioni forniscono contesto e funzionalità ai modelli AI. La documentazione ufficiale lo paragona a una porta USB-C per le applicazioni AI: così come USB-C offre un modo unificato per collegare dispositivi diversi, MCP definisce un modo uniforme per connettere agenti AI a servizi e strumenti eterogenei. In pratica, MCP permette a sviluppatori terzi di creare “plugin” o MCP server contenenti strumenti (funzioni) e risorse che un assistente AI può invocare in chat.

Questa standardizzazione comporta enormi vantaggi di interoperabilità. I fornitori di assistenti (es. piattaforme come Claude, ChatGPT, Cursor, ecc.) possono concentrarsi sul migliorare l’interfaccia utente e le capacità conversazionali, sapendo che esiste un linguaggio comune per estendere le funzionalità. Dall’altro lato, gli sviluppatori di terze parti possono costruire servizi integrativi in modo assistant-agnostic, plug-and-play su qualsiasi piattaforma compatibile con MCP.

Esempio: immaginiamo di poter dire al nostro assistente AI: “Trova il mio paper di ricerca su Google Drive, controlla se mancano citazioni usando un motore di ricerca accademico, poi imposta la luce del soggiorno sul verde quando hai finito.” In uno scenario tradizionale, integrare manualmente questi servizi (cloud storage, ricerca web, IoT) richiederebbe molto codice ad-hoc. Con MCP, basta collegare tre server MCP di terze parti (uno per Google Drive, uno per il motore di ricerca, uno per la lampadina smart): l’assistente orchestrerà da solo le operazioni tra i vari strumenti in maniera sequenziale. Questo abilita funzionalità complesse e workflow end-to-end autonomi prima impensabili: l’LLM non solo elabora testo, ma può agire – cercare informazioni, richiamare dati privati, eseguire comandi – il tutto tramite un canale standardizzato.

Le potenzialità di MCP , senza dubbio, risiedono nella flessibilità (Bring-Your-Own-Tools: ognuno può aggiungere gli strumenti che preferisce), nella scalabilità dell’ecosistema (una volta creato un tool MCP, può essere riusato ovunque) e in un accesso al contesto più ricco per gli LLM (possono attingere a dati e servizi esterni in tempo reale invece di essere limitati al prompt statico). Questa promessa di un “AI app store universale” ha giustamente attirato attenzione e adozione rapida.

Ma, come in tuti in grandi cambiamenti, anche questo introduce anche nuove sfide da non sottovalutare.

Rischi di sicurezza e trust: cosa può andare storto?

Aprire le porte dell’LLM a strumenti esterni comporta inevitabilmente dei rischi di sicurezza. Diversi ricercatori hanno già dimostrato che l’attuale design di MCP può esporre gli utenti a una varietà di exploit. In particolare, è stato mostrato come persino modelli linguistici di punta possano essere indotti con opportuni prompt malevoli a utilizzare i tool MCP in modi imprevisti, compromettendo il sistema dell’utente ( qui un esempio interessante e ben descritto MCP Safety Audit: LLMs with the Model Context Protocol Allow Major Security Exploits).

Tra i possibili attacchi documentati troviamo:

  • Esecuzione di codice malevolo (Malicious Code Execution): il modello potrebbe essere persuaso a eseguire codice arbitrario sul sistema locale tramite un tool di file system o terminale, ad esempio inserendo backdoor o comandi distruttivi nei file dell’utente. Un esperimento ha mostrato che un LLM (Claude) connesso a un server MCP di filesystem a volte riesce addirittura a scrivere nel file di configurazione dell’utente un comando per ottenere un accesso remoto ogni volta che si apre il terminale (nell’esempio condiviso sopra c’è proprio questo) . In altri casi fortunatamente il modello ha riconosciuto il tentativo e rifiutato l’azione, ma basta una formulazione leggermente diversa perché esegua istruzioni pericolose senza allertare adeguatamente l’utente. Questo evidenzia quanto siano fragili le attuali difese basate solo sulle policy interne del modello.
  • Accesso remoto non autorizzato (Remote Access Control): simile al caso sopra, un attaccante potrebbe ottenere il pieno controllo remoto della macchina vittima inducendo l’LLM a eseguire comandi di networking (es. avviare un server, modificare firewall, rubare chiavi API, ecc.). In uno scenario multi-utente (es. uffici condivisi), un aggressore potrebbe direttamente interagire con l’assistente di qualcun altro e sfruttare MCP per piantare accessi persistenti.
  • Furto di credenziali o dati sensibili: se il modello ha accesso a file di configurazione o variabili d’ambiente tramite MCP, un prompt malevolo può istruirlo a leggere e inviare all’esterno informazioni riservate (token, password, documenti privati). Ad esempio, un tool apparentemente innocuo potrebbe richiedere di “passare il contenuto di /etc/passwd per una verifica di sicurezza”, inducendo l’LLM a consegnare informazioni di sistema riservate a un servizio esterno.

Un elemento preoccupante è che questi attacchi possono avvenire senza che l’utente se ne accorga immediatamente. MCP parte dal presupposto che i tool di terze parti siano affidabili e li integra profondamente nel flusso dell’assistente. Di fatto, i tool MCP vengono spesso inseriti nel prompt di sistema (le istruzioni di controllo interne all’LLM) anziché come input utente, conferendo loro un livello di fiducia più alto. Ciò significa che un tool compromesso o costruito con intenti malevoli può facilmente aggirare le protezioni e influenzare il comportamento dell’assistente, anche più di quanto potrebbe un normale input utente malizioso (prompt injection classico). Si parla infatti di prompt injection di terze o quarte parti: un server MCP può deliberatamente fornire output formattati in modo da manipolare l’LLM o altri server a cascata. Un esempio ancore potrebbe esser un server che potrebbe riuscire a cambiare dinamicamente nome e descrizione di un tool dopo che l’utente ha già autorizzato il suo utilizzo (rug pull attack), sfruttando il fatto che l’LLM continuerà a usarlo credendo sia affidabile.

Inoltre, con MCP un aggressore potrebbe concatenare servizi per aumentare l’efficacia dell’attacco. Immaginiamo un database aziendale esposto via MCP: un malintenzionato potrebbe inserire nel campo di testo di un record una stringa contenente un comando o una falsa eccezione che suggerisce una determinata azione (ad es. “Errore: mancano alcune righe, eseguire UPDATE ... per correggere”). Se l’assistente AI di un developer andrà a leggere quel record tramite il tool MCP, potrebbe eseguire il comando suggerito credendo sia parte del flusso logico, causando potenzialmente un Remote Code Execution o modifiche indesiderate al database. Tutto ciò pur non disponendo di un tool esplicito di esecuzione codice, ma sfruttando la capacità dell’LLM di interpretare e seguire istruzioni testuali provenienti dai dati esterni.

Un altro rischio è la fuga involontaria di dati (data leakage). Anche senza attori malevoli, l’autonomia conferita agli agenti può portare l’assistente a divulgare informazioni sensibili a servizi di terze parti. Ad esempio, un utente potrebbe collegare il proprio Google Drive e un servizio di web publishing via MCP per farsi aiutare a redigere un post sul blog. Se l’LLM, nel tentativo di essere utile, decide di leggere referti medici privati dal Drive per arricchire il post, potrebbe inviarne estratti a un servizio esterno (es. un correttore grammaticale online) senza un’esplicita intenzione dell’utente. In mancanza di controlli granulari, l’AI può mescolare dati pubblici e privati violando le aspettative di privacy dell’utente.

In parole povere l’ MCP amplia la superficie d’attacco dei sistemi basati su LLM. Ogni tool aggiunto è un potenziale vettore di exploit se non viene validato e autorizzato con attenzione. Purtroppo, allo stato attuale MCP non prevede meccanismi standard di sandbox o gestione permessi: se l’utente abilita un tool che cancella file, il modello potrebbe teoricamente usarlo senza ulteriore conferma. Questo impone molta fiducia sia nell’LLM (che dovrebbe capire da solo quando non eseguire istruzioni pericolose) sia nei fornitori terzi dei tool. Come osservato da molti, combinare LLM con dati e azioni reali è “intrinsecamente rischioso e amplifica rischi esistenti o ne crea di nuovi”.

Esperienza utente: assenza di conferme e costi nascosti

Oltre ai rischi di exploit deliberati, MCP presenta criticità sul piano UX (user experience) e di controllo da parte dell’utente. L’idea di fondo di MCP è fornire un’esperienza fluida, dove l’assistente AI può chiamare strumenti esterni in autonomia per aiutare l’utente a raggiungere un obiettivo.

Ma così tanta autonomia, non è forse troppa autonomia?

Attualmente, il protocollo lascia molte decisioni critiche all’assistente, senza livelli di avvertimento o conferma differenziati.

Una prima criticità è che MCP non definisce livelli di rischio per gli strumenti che il modello può utilizzare. Tutti i tool, dal più innocuo al più potente, vengono esposti all’LLM sullo stesso piano. Immaginiamo una chat assistita da vari plugin: leggi_diario_personale(), prenota_volo(), elimina_file(). Alcune azioni sono banali o facilmente reversibili, altre costose o irreversibili e pericolose, ma il modello potrebbe non avere piena consapevolezza di questa differenza. Spetta all’applicazione che implementa MCP chiedere conferma all’utente, ma non esiste uno standard obbligatorio: un particolare client potrebbe limitarsi a elencare i tool disponibili e lasciare che l’utente abiliti tutto in blocco.

È facile inoltre che l’utente sviluppi col tempo la pessima abitudine di confermare automaticamente (modality YOLO scherza qualcuno) tutte le azioni proposte, se la maggior parte delle volte sono innocue routine. Così, il giorno in cui l’LLM decide di usare elimina_file("foto_vacanze") o di “aiutare” prenotando e pagando un volo senza dettagli corretti, il danno è fatto in un click distratto. La mancanza di indicatori di rischio o di gravità per i tool è dunque un problema: l’utente non riceve un segnale chiaro quando l’agente sta per fare qualcosa di potenzialmente pericoloso o costoso.

Un secondo problema di UX legato a MCP è l’assenza di conferme visive e preview per azioni sensibili. Poiché il protocollo per design fa transitare i risultati dei tool come semplice testo non strutturato (o blob binari per immagini/audio), l’interfaccia dell’assistente spesso mostra solo la risposta finale dell’LLM e pochi dettagli sull’azione compiuta. Questo va bene per notifiche o dati testuali, ma diventa inadeguato in casi come: prenotare un taxi o un volo, pubblicare un post sui social, inviare un’email importante. L’utente avrebbe bisogno di verificare dettagli cruciali – ad esempio confermare che l’AI ha scelto l’indirizzo giusto per il taxi, o vedere un’anteprima formattata di un post prima di renderlo pubblico. Con l’attuale MCP queste garanzie “visuali” non sono integrate: il modello potrebbe dirci di aver fatto X, ma non c’è un meccanismo standard per fornirci un link di conferma, una finestra di dialogo, o un risultato parziale strutturato. Tutto dipende dall’implementazione del singolo tool e dall’interfaccia dell’applicazione host. Questo può portare a errori difficili da intercettare prima che sia troppo tardi, specie se l’agente opera autonomamente in background.

Un terzo aspetto spesso trascurato è quello dei costi nascosti. A differenza di protocolli tradizionali dove i dati scambiati sono relativamente piccoli e a costo trascurabile, nell’universo LLM il “contesto” ha un costo computazionale ed economico significativo. MCP, ampliando il contesto con risultati di tool, può generare risposte voluminose. Un output di qualche centinaio di kilobyte può costare diversi centesimi di dollaro in termini di utilizzo del modello, e 1 MB di testo generato può arrivare a costare circa 1 dollaro per richiesta. Quel testo potrebbe venire incluso in ogni successivo prompt durante la conversazione, sommando più addebiti. Ciò significa che se un tool MCP restituisce un risultato molto lungo (es. il contenuto di un lungo documento, o una lista di dati estesa), l’utente potrebbe bruciare il proprio budget rapidamente senza accorgersene, finché non arriva la fattura o finché il servizio non inizia a rallentare. Sono già emerse lamentele da parte di utenti e sviluppatori di agenti AI riguardo a costi imprevedibili dovuti a integrazioni MCP token-inefficienti. Attualmente, sta al singolo sviluppatore di tool limitare prudentemente la quantità di dati restituiti (magari tagliando risultati o implementando paginazione), ma il protocollo in sé non impone limiti di lunghezza. Un miglioramento proposto è di fissare un massimale sul risultato o quantomeno rendere visibile e configurabile la quantità di contesto aggiunto da ogni tool, così da responsabilizzare chi sviluppa MCP server a essere efficiente.

Dal punto di vista UX MCP eccelle in comodità, ma pecca in controlli e trasparenza verso l’utente. Non fornisce per default né una graduatoria di pericolosità dei tool, né un sistema strutturato di conferme per azioni critiche, né indicatori chiari dell’impatto in termini di costi/risorse. Questo lascia spazio a errori umani (conferme affrettate, fiducia eccessiva nell’agente) e a situazioni in cui l’utente perde il controllo fine di ciò che sta accadendo. Le implementazioni dovranno colmare queste lacune con soluzioni personalizzate, ma idealmente lo standard stesso potrebbe evolvere per includere best practice di sicurezza ed esperienza utente più robuste.

Limiti strutturali: LLM con troppi tool, interpretazione ed efficienza

Un altro tema emerso nelle analisi recenti è che MCP, pur estendendo le capacità degli LLM, non elimina i limiti intrinseci dei modelli – anzi, in certi casi li amplifica. Collegare “più strumenti possibile” potrebbe sembrare una buona idea per massimizzare la versatilità di un assistente AI, ma all’atto pratico ci sono dei trade-off di performance e affidabilità.

Innanzitutto, gli LLM attuali mostrano un calo di affidabilità man mano che cresce il contesto e la complessità delle istruzioni da seguire. Ogni tool MCP aggiunto porta con sé descrizioni, parametri e possibili azioni che l’AI deve tenere a mente. Se da un lato più strumenti significano più opportunità, dall’altro rappresentano più carico cognitivo per il modello. In effetti, è stato osservato che aumentando il numero di tool e di dati connessi, le prestazioni dell’assistente possono degradare sensibilmente, mentre il costo per ogni singola richiesta aumenta (più informazioni da elaborare in input/output). In scenari reali, potrebbe diventare necessario far scegliere all’utente quali integrazioni attivare di volta in volta, invece di tenerle tutte sempre attive, per evitare di appesantire inutilmente ogni risposta.

Va considerato poi che utilizzare correttamente degli strumenti tramite linguaggio naturale è di per sé un compito non banale per gli LLM. Pochi dataset di addestramento contenevano esempi di agenti che chiamano API o funzioni esterne, quindi la capacità di tool use spesso non è innata ma deriva da fine-tuning o prompt engineering. Benchmark specializzati mostrano che anche modelli avanzati hanno un basso successo percentuale nel portare a termine correttamente task multi-step con strumenti. Ad esempio, su un set di compiti come prenotare un volo seguendo policy specifiche, uno dei migliori modelli disponibili nel 2025 riusciva a completare autonomamente solo circa il 16% delle operazioni previste. Ciò implica che all’aumentare della complessità delle azioni richieste (soprattutto se coinvolgono più strumenti in sequenza), l’agente potrebbe fallire o doversi arrendere, restituendo risultati parziali o errati.

Un ulteriore limite è la comprensione contestuale dell’AI rispetto a ciò che i tool offrono. MCP presuppone che gli strumenti siano progettati per essere generici e assistant-agnostic, ma nella realtà ogni assistente o utente potrebbe avere esigenze diverse. Ad esempio, un server MCP per Google Drive potrebbe fornire funzioni come list_file(nome), read_file(file_id), delete_file(file_id). Un utente inesperto potrebbe pensare che collegando questo server al suo ChatGPT, potrà semplicemente chiedere: “Trova il file FAQ che ho scritto ieri per il cliente X”. In assenza di un vero motore di ricerca indicizzato nei contenuti, l’LLM proverà magari a chiamare list_file con vari nomi, fallendo se il file non ha “FAQ” nel titolo.

L’utente rimane deluso perché si aspettava un comportamento più “intelligente”, mentre avrebbe bisogno che il tool stesso implementi una ricerca full-text o query semantiche — funzionalità non previste senza un’architettura aggiuntiva. Analogamente, richieste come “Quante volte appare la parola ‘AI’ nei documenti che ho scritto?” mettono in crisi l’assistente: potrebbe dover aprire decine di file (read_file) e contare, finendo il contesto disponibile dopo alcuni risultati e dando magari un numero incompleto. Operazioni di aggregazione o di join di dati attraverso più fonti (es. “incrocia l’ultimo report vendite con i profili LinkedIn dei candidati”) sono ancora più proibitive: il modello non ha una memoria persistente su cui fare calcoli o confronti complessi oltre i limiti del prompt. Questi esempi illustrano come collegare un dato strumento non garantisce automaticamente che l’AI sappia svolgere qualsiasi compito correlato – se il compito richiede logica o capacità oltre quelle offerte esplicitamente dai tool, l’LLM tenterà soluzioni sub-ottimali o dichiarerà di non poterlo fare.

C’è poi una questione di compatibilità variabile tra modelli e formati di strumenti. MCP definisce l’interfaccia, ma piccoli dettagli (come la descrizione testuale dei tool, gli schemi di risposta attesi, l’uso di markdown o XML nei prompt) possono influire sul rendimento a seconda del modello usato. Ad esempio, si è notato che Claude (Anthropic) interpreta meglio descrizioni di tool strutturate in un certo modo, mentre GPT-4 preferisce altri formati. Quindi un set di tool potrebbe funzionare benissimo con un assistente e meno con un altro, confondendo l’utente che tende a dare la colpa all’applicazione (“Quest’app non è capace di fare X”) quando in realtà è una combinazione di design del tool e idiosincrasie del modello AI.

Riassumendo, MCP ha un grandissimo potenziale ma non è una bacchetta magica e come sempre “per i grandi poteri ricevuti, ci vuole una grande responsabilità” : rimane vincolato ai limiti attuali degli LLM in termini di capacità di ragionamento, contesto e azione. Aggiungere più fonti dati e più funzioni può dare l’illusione di un “super assistente” onnisciente, ma in pratica rischia di peggiorare l’efficacia (assistente più lento, più costoso e talvolta confuso) se non progettato con criterio. Serve equilibrio nel numero di integrazioni attive contemporaneamente e consapevolezza che l’AI potrebbe non sfruttarle appieno come farebbe un umano senza un lavoro ulteriore di ottimizzazione. Questi limiti strutturali suggeriscono che, accanto all’entusiasmo, è necessaria prudenza e responsabilità: ogni nuova integrazione va testata e compresa a fondo per evitare di sovraccaricare o disorientare il modello.

Trade-off tra facilità d’uso e controllo/verificabilità

Un tema trasversale a quanto discusso sopra è il delicato bilanciamento tra comodità e controllo. MCP nasce per rendere facile ed immediato estendere le capacità di un modello – in altre parole, massimizzare la facilità d’uso sia per chi sviluppa (standard unico, integrazioni plug-in) sia per l’utente finale (chiedi in linguaggio naturale e l’AI fa tutto). Tuttavia, questa facilità intrinseca porta con sé una perdita di visibilità e governabilità sulle azioni dell’agente AI.

Da un lato dello spettro abbiamo la “completa autonomia”: l’utente collega molti tool e permette all’agente di agire senza dover confermare ogni passo. L’esperienza è fluida e quasi “magica” – pochi input in linguaggio naturale producono output complessi e multi-step. Ma come abbiamo visto, ciò può portare a comportamenti indesiderati o rischiosi non verificati, e rende difficile ricostruire a posteriori cosa sia andato storto ( scarsa verificabilità). Se qualcosa va storto – ad esempio dati sensibili inviati ad un servizio esterno, o un file cancellato – l’utente o l’amministratore si trovano a dover interpretare i log della conversazione e delle chiamate API per capire quale prompt o quale tool abbia causato l’evento. Non c’è una traccia strutturata facilmente consultabile di tutte le azioni autorizzate, a meno che l’applicazione host non la implementi manualmente.

Dall’altro lato c’è la “massimo controllo/manualità”: l’utente mantiene il potere decisionale su ogni chiamata di tool (conferme frequenti, step intermedi mostrati, scelta esplicita di quali integrazioni usare per ciascun task). Questo approccio minimizza i rischi, ma sacrifica molta della comodità. L’agente diventa meno autonomo e più un sistema di suggerimento, dove l’utente deve comunque fare da supervisore costante. Inoltre, troppe interruzioni e richieste di conferma possono peggiorare l’esperienza d’uso, frustrando l’utente o inducendolo ad aggirare le protezioni pur di non essere disturbato di continuo.

Verificabilità e controllo più granulari spesso significano aggiungere complessità all’ecosistema MCP. Ad esempio, si potrebbe voler un registro dettagliato di tutte le operazioni compiute tramite MCP (chi le ha scatenate, con quali parametri, risultati, timestamp) per poter effettuare audit di sicurezza. Realizzare ciò richiede estensioni al framework o log robusti lato client/server, e magari strumenti di analisi dedicati. Allo stesso modo, introdurre livelli di permission per i tool (lettura/scrittura, accesso limitato a certe risorse, ecc.) rende il sistema più sicuro ma anche più macchinoso da configurare rispetto alla semplice plug-and-play attuale.

È evidente che c’è un trade-off: facilità d’uso vs. complessità di controllo. MCP nella sua forma base ha scelto di ottimizzare la prima a scapito della seconda. Sta ora alla comunità e ai progettisti decidere come riequilibrare la bilancia. Nel prossimo e ultimo punto, discuteremo alcune possibili soluzioni e linee guida per mitigare i rischi senza rinunciare ai benefici di MCP.

Blockchain, una soluzione strutturale?

Per affrontare strutturalmente (ma che non risolverebbero a mio avviso tutti i problemi) i rischi di sicurezza e i limiti di verificabilità evidenziati finora, una soluzione potenziale potrebbe arrivare dalla blockchain e dall’uso di un sistema di identità decentralizzata (DID). La blockchain offre naturalmente risposte alle criticità che MCP manifesta:

  • Autenticazione robusta e decentralizzata: ogni utente e tool MCP potrebbe disporre di un’identità registrata su blockchain tramite DID (Decentralized Identifier), che garantisce l’origine e l’integrità delle richieste senza affidarsi a un’unica autorità centralizzata.

  • Audit e tracciabilità immutabile: le operazioni effettuate tramite MCP verrebbero registrate su blockchain creando un log immodificabile, utile per audit, debugging e risoluzione di controversie.

  • Autorizzazioni granulari tramite smart contract: le regole sui permessi e sulle operazioni consentite ai tool MCP potrebbero essere gestite da smart contract trasparenti e verificabili, eliminando il rischio di esecuzioni incontrollate o dannose.

Come potrebbe funzionare un sistema MCP basato su blockchain?

Un’implementazione pratica potrebbe basarsi su:

  • Identità decentralizzata (DID): gli utenti e gli sviluppatori registrano le loro identità utilizzando un sistema decentralizzato (es. Ethereum Name Service, Solana DID), firmando digitalmente ogni richiesta MCP con una chiave privata.

  • Smart contract di autorizzazione: i permessi per ciascun tool MCP vengono definiti esplicitamente in smart contract che limitano automaticamente le azioni eseguibili. Le azioni ad alto rischio potrebbero richiedere una firma esplicita aggiuntiva dell’utente.

  • Registrazione delle operazioni: ogni chiamata agli strumenti MCP genererebbe eventi registrati permanentemente, facilitando controlli retroattivi e audit automatici.

Perché tale soluzione sia sostenibile nel tempo e facilmente adottabile, è fondamentale definire ulteriori requisiti:

  • Standardizzazione: scegliere blockchain ad alta interoperabilità (ad esempio Ethereum, Solana, o altre chain compatibili) e definire chiaramente gli standard DID utilizzabili.

  • Privacy e riservatezza: adottare tecniche avanzate (zero-knowledge proofs) per garantire la riservatezza di dati sensibili, evitando di renderli pubblicamente visibili sulla blockchain.

  • Usabilità e gestione chiavi: semplificare il recupero degli account smarriti e implementare meccanismi di backup sicuri per la gestione delle chiavi private, evitando complessità eccessiva per gli utenti non tecnici.

  • Governance decentralizzata: prevedere modalità per aggiornamenti dello standard MCP e dei relativi smart contract tramite governance decentralizzata (es. DAO), per garantire evoluzione e sicurezza nel tempo.

L’integrazione della blockchain in MCP rappresenterebbe a mio avviso un ulteriore passo importante verso quella convergenza di cui parlo da un po’ e vero la creazione di uno standard realmente maturo, sicuro e scalabile. La capacità di autenticare richieste, autorizzare operazioni e tracciare eventi in modo decentralizzato potrebbe trasformare MCP da semplice protocollo di integrazione a piattaforma completa e (più) sicura per l’automazione avanzata con LLM.

Verso un uso responsabile e sicuro di MCP: proposte e principi

Nonostante le criticità evidenziate, il Model Context Protocol rimane dal mio punto di vista un’innovazione importante e utile, oltre che un cambio radicale di modelli ed ecosistemi inteeri. La chiave sta nell’adottarlo in modo responsabile, implementando misure di sicurezza e di design che ne mitigano i difetti. Di seguito provo a buttare giu  alcune proposte e principi – rivolti sia a sviluppatori di tool/applicazioni, sia a utenti avanzati – per migliorare la progettazione della sicurezza e l’affidabilità di MCP senza perdere i vantaggi della standardizzazione:

  • Classificazione del rischio dei tool e conferme contestuali: Gli strumenti MCP andrebbero categorizzati per livello di rischio (basso, medio, alto) in base alle azioni che compiono. Ad esempio, leggere dati pubblici può essere low risk, modificare dati sensibili high risk. L’interfaccia utente dovrebbe poi modulare le conferme di conseguenza: niente conferma per azioni sicure di routine, conferma obbligatoria (con chiaro avviso) per operazioni distruttive o finanziariamente impegnative. In mancanza di uno standard ufficiale, alcune implementazioni iniziano a muoversi in questa direzione introducendo livelli di esecuzione: ad esempio, eseguire direttamente le azioni a basso rischio, ma richiedere un permesso esplicito per quelle medie e addirittura isolare in sandbox (es. in un container Docker) quelle ad alto rischio ().
  • Sandboxing e scope limitato: Per i tool più potenti (come quelli che eseguono codice o modificano file), è consigliabile limitarne il campo d’azione. Ciò può avvenire tramite sandboxing (esecuzione in un ambiente chiuso che impedisca danni al sistema host) o definendo scope ristretti – ad esempio un tool delete_file() potrebbe essere vincolato a operare solo in una directory predefinita, impedendo cancellazioni arbitrarie in tutto il file system. Idealmente, MCP potrebbe supportare in futuro una sorta di policy di autorizzazione dichiarativa, in cui l’utente concede a un tool solo certi permessi (lettura sola, accesso solo a un certo dataset, ecc.). Nel frattempo, sta ai singoli server MCP implementare tali controlli internamente.
  • Verifica e fiducia nei server MCP di terze parti: Prima di collegare un qualsiasi MCP server esterno al proprio assistente, occorre valutarne l’affidabilità. Preferire tool open source il cui codice è ispezionabile, oppure servizi di provider noti con solide politiche di sicurezza. Evitare di usare plugin da fonti sconosciute o poco trasparenti, specialmente se richiedono accesso a dati sensibili. Gli sviluppatori della piattaforma potrebbero creare un registry pubblico di server MCP verificati o con recensioni, facilitando agli utenti la scelta di integrazioni sicure.
  • Trasparenza delle azioni dell’agente: L’applicazione host (es. l’interfaccia chat) dovrebbe fornire strumenti per monitorare e loggare le azioni che l’LLM compie tramite MCP. Ciò può includere un pannello di attività in tempo reale (“L’assistente sta chiamando lo strumento X con questi parametri…”), e log dettagliati consultabili successivamente. Questo aiuta sia a tranquillizzare l’utente durante operazioni lunghe o complesse (sapendo cosa sta succedendo dietro le quinte), sia a effettuare audit in caso di comportamenti sospetti o malfunzionamenti. Alcune implementazioni visualizzano già il “chain of thought” o i passi compiuti dall’agente: estenderlo con dettagli specifici dei tool MCP usati sarebbe un’ottima pratica.
  • Limitare l’autonomia in contesti critici: Per task particolarmente delicati – ad esempio operazioni finanziarie, modifiche di sistema, invio di mail a larga diffusione – è saggio mantenere l’umano nel loop. Ciò significa progettare l’agent affinché si fermi prima di un punto di non ritorno e chieda conferma finale all’utente, magari mostrando un riepilogo di cosa intende fare. Questo principio si riallaccia ai livelli di rischio: nessun modello AI dovrebbe effettuare transazioni bancarie o cancellazioni massicce senza un “OK” umano, anche se in generale gli si concede autonomia su altre cose.
  • Educazione dell’utente e best practice d’uso: L’utente finale va reso consapevole che uno strumento come MCP non è infallibile e richiede uso accorto. I provider di assistenti dovrebbero educare tramite documentazione e tutorial sui rischi possibili (es. evidenziando il pericolo di prompt injection attraverso esempi) e sulle funzionalità di sicurezza messe a disposizione. Un utente informato sarà più propenso a configurare correttamente i permessi, a scegliere con giudizio quali integrazioni attivare e a riconoscere eventuali segnali di comportamento anomalo dell’agente.

L’MCP rappresenta un passo significativo verso ecosistemi AI modulari e integrati, analoghi a un sistema operativo per agenti intelligenti. Le sue promesse di standardizzazione e versatilità sono reali, ma altrettanto vere sono le sfide emerse e che emergeranno in termini di sicurezza e UX. La buona notizia è che, come tutti i grandi progetti di cambiamento, vedono una partecipazione di diverse comunità che stanno già affrontando questi temi e approfondendo tecnicamente molti aspetti: dall’analisi delle vulnerabilità (esempio riportato in questo articolo MCP Safety Audit: LLMs with the Model Context Protocol Allow Major Security Exploits) alla creazione di sistemi di validazione di sicurezza automatici per server MCP, fino al dibattito su come migliorare il protocollo stesso (Everything Wrong with MCP – by Shrivu Shankar).

È probabile che vedremo evolvere sia lo standard MCP (con estensioni per gestione permessi, formati di risposta più strutturati, ecc.), sia le implementazioni lato applicazione (assistenti che guideranno meglio l’utente, magari con interfacce più ricche e controlli). Fino ad allora, il principio guida dev’essere la cautela consapevole: adottare MCP con entusiasmo, ma progettare sempre con una ”mentalità di sicurezza” e usare l’autonomia dell’AI entro limiti che possiamo gestire.

Come spesso accade nella tecnologia, la chiave è trovare il giusto equilibrio tra innovazione e controllo: sfruttare l’automazione offerta da MCP senza mai rinunciare del tutto alla supervisione umana e a misure preventive. In questo modo potremo godere dei benefici dell’AI aumentata dai tool, minimizzando al contempo i rischi per sistemi e persone.

Model Context Protocol (MCP): la porta universale tra gli LLM e i dati esterni

Qualche giorno fa, discutendo con un cliente, parlavamo delle evoluzioni e delle potenzialità oggi di approcciare il mercato come un ecosistema di connettori che possiamo abilitare – o che ci abilitano – a fare cose che, probabilmente, da soli non potremmo mai fare. Un approccio non più basato sull’idea di costruire tutto in casa, ma sulla capacità di orchestrare elementi esterni, modulari, interoperabili. Di connettere e collaborare. Di espandere le proprie possibilità attraverso la rete, e non dentro un perimetro chiuso.

È un po’ come passare da una barca a remi a una barca a vela: con i remi sei autonomo, ma limitato; con la vela, se impari a usare il vento giusto e a orientarti con gli strumenti, puoi fare molta più strada. Ma da solo non basta il vento: serve un sistema che lo intercetti, che lo traduca in movimento, che funzioni in modo integrato. I connettori sono quel sistema.

Nel mondo dell’intelligenza artificiale questo concetto è sempre più attuale. L’AI non può più vivere in isolamento, dentro modelli chiusi e dataset statici. Per essere davvero utile, deve dialogare con il mondo reale: accedere a informazioni, attivare strumenti, collaborare con altri sistemi. È qui che entra in gioco un paradigma nuovo e promettente: quello del Model Context Protocol (MCP).

Un protocollo che non riguarda solo la tecnica, ma il futuro del modo in cui costruiamo applicazioni intelligenti, abilitando una logica di AI plug-and-play, distribuita, connessa.

Visto che più persone mi hanno chiesto di spiegarlo, ne ho scritto in modo approfondito qui sotto, prendendomi un po’ di giorni per preparare tutto, provando ad analizzarne le implicazioni tecniche e strategiche. Buona lettura.

Benvenuto MCP

Model Context Protocol (MCP) è un protocollo aperto pensato per collegare i modelli di linguaggio di grandi dimensioni (LLM) e gli assistenti AI al “mondo esterno” – che siano file, database, servizi web o applicazioni aziendali . In pratica funziona come un adattatore universale (spesso paragonato a una porta USB-C) per le applicazioni AI, fornendo un modo standard per “plug-and-play”: invece di costruire integrazioni ad hoc per ogni singola fonte dati o strumento, con MCP l’assistente AI può connettersi in modo uniforme e sicuro a qualsiasi sistema esterno autorizzato .

Questa è un’innovazione cruciale perché finora anche gli AI assistant più avanzati operavano in una sorta di bolla isolata: ogni volta che volevamo dare accesso a un modello AI a informazioni aziendali (es. il CRM clienti o il repository di codice) bisognava predisporre una soluzione su misura, spesso complessa e poco riutilizzabile . MCP nasce proprio per superare questo collo di bottiglia, standardizzando come le applicazioni forniscono contesto e dati agli LLM . Sviluppato inizialmente da Anthropic (la squadra dietro Claude) e rilasciato come standard aperto verso la fine del 2024, MCP promette di mettere ordine nel frammentato panorama delle integrazioni AI, offrendo alle organizzazioni un approccio condiviso e modulare per connettere i propri sistemi alle capacità dei modelli generativi.

Per capirci, anche senza scrivere codice da zero, oggi è possibile avviare un MCP server in pochi minuti. Tool come Claude Desktop o l’editor Cursor lo supportano nativamente, e permettono agli sviluppatori di testare connettori reali – come lettori di file o scraper web – direttamente dalla propria interfaccia AI preferita.

Architettura tecnica: come funziona MCP

MCP segue un’architettura client-server tradizionale, adattata al contesto degli LLM. In sintesi, un’applicazione host dotata di un client MCP può collegarsi (anche simultaneamente) a più server MCP dedicati, ognuno esponendo un set di dati o funzioni specifiche . Questa suddivisione consente di mantenere separati i ruoli e semplificare l’integrazione. I componenti chiave dell’ecosistema MCP sono:

  • MCP Host – L’applicazione o agente AI che necessita di funzionalità contestuali. Può trattarsi di un chatbot, di un’assistente in un’app desktop (es. Claude Desktop) o di un’IDE potenziata con AI. Il host integra un client MCP per poter accedere a dati esterni tramite il protocollo .

  • MCP Client – Il modulo (tipicamente una libreria software) incaricato di gestire la connessione 1:1 con un server MCP. Il client traduce le richieste dell’host in messaggi MCP standard, si occupa del trasporto (es. via WebSocket, RPC locale, ecc.) e gestisce l’autenticazione e i permessi verso il server . In pratica, è il “connettore” che collega l’assistente AI ai vari server MCP.

  • MCP Server – Un programma leggero che espone una o più risorse o tool attraverso l’interfaccia standard MCP. Ciascun server in genere collega il mondo AI a una specifica fonte di informazioni o servizio: ad esempio un server MCP potrebbe dare accesso a un database, a un repository di documenti, a un’API esterna (es. meteo, CRM) o a strumenti come un motore di ricerca interno . Il server implementa le funzionalità richieste (lettura file, esecuzione di query, invio di email, ecc.) presentandole al modello in modo unificato.

  • Fonti di dati locali – Sono le risorse presenti nell’infrastruttura locale dell’utente o azienda: file system, database interni, applicazioni self-hosted, ecc. I server MCP possono accedere a queste fonti in sicurezza, applicando permessi granulari affinché il modello possa vedere solo ciò che è autorizzato . Ad esempio, un server MCP potrebbe offrire accesso in sola lettura a una cartella di documenti, senza esporre altri file sul computer.

  • Servizi remoti – Sono sistemi esterni accessibili via rete (Internet) tramite API o SDK: servizi SaaS, piattaforme cloud, tool di terze parti. Un server MCP funge da bridge sicuro anche verso queste risorse . Ad esempio, un connettore MCP potrebbe interfacciarsi con le API di Salesforce, di Google Drive o di un servizio di eCommerce, rendendo disponibili al modello operazioni su quei servizi senza che l’LLM debba conoscere i dettagli delle API.

Grazie a questa architettura modulare e componibile, un’app AI può attingere a diversi server MCP in parallelo mantenendo un’interfaccia coerente. Il host (l’assistente AI) continua a concentrarsi sul dialogo e sul ragionamento in linguaggio naturale, delegando al client MCP la gestione tecnica delle chiamate, mentre i server MCP si occupano dell’accesso ai dati e alle azioni nei rispettivi domini . Questo separa le responsabilità in maniera pulita: l’assistente AI “chiede” e interpreta, i server “eseguono” e forniscono risultati, il tutto orchestrato tramite un linguaggio comune definito dal protocollo.

Da un punto di vista implementativo, MCP definisce un insieme di messaggi standard (richieste, risposte e notifiche) in formato JSON-RPC, insieme a concetti come Risorse (documenti o dati identificabili da ID), Tool (funzioni invocabili dal modello, ad es. createNewTicket per aprire un ticket) e Prompt (template di prompt predefiniti) . Ciò significa che quando il modello “vuole” eseguire un’azione (per esempio leggere un file o ottenere un report meteo), il client MCP invia una richiesta standardizzata al server appropriato, il quale la elabora e risponde con i dati richiesti, il tutto secondo regole uniformi. Questo schema riduce le ambiguità e facilita sia lo sviluppo che il debugging, perché ogni integrazione segue lo stesso protocollo di comunicazione.

Vantaggi di MCP rispetto alle integrazioni tradizionali

L’adozione di un protocollo unificato come MCP porta numerosi benefici rispetto alle integrazioni custom costruite ad hoc. Di seguito evidenziamo i vantaggi principali – standardizzazione, modularità, sicurezza e riusabilità – che rendono MCP un passo avanti decisivo:

  • Standardizzazione – MCP fornisce un’interfaccia comune per collegare LLM e fonti esterne, eliminando la necessità di interfacce proprietarie o API disparate per ogni sistema . Invece di dover gestire formati e modalità diverse (un plugin per i documenti, un altro per il CRM, ecc.), con MCP tutte le integrazioni seguono lo stesso schema. Ciò riduce la complessità e gli errori: gli sviluppatori non devono più “reinventare la ruota” ogni volta, ma possono affidarsi a pattern consistenti per accesso ai dati, esecuzione di tool e gestione dei prompt . In breve, MCP crea un linguaggio comune tra AI e servizi, dove prima regnava la frammentazione.

  • Modularità e flessibilità – Con MCP, ogni fonte di dati o servizio esterno diventa un modulo separato (un server MCP) che può essere aggiunto o rimosso senza impattare il resto del sistema. Questo approccio plug-and-play consente di combinare facilmente più integrazioni: ad esempio, si possono attivare server MCP per Slack, per un database SQL e per un servizio meteo indipendentemente, e l’assistente AI li scoprirà tutti tramite il medesimo protocollo . La modularità semplifica la manutenzione: ogni connettore è isolato, e aggiornare o correggere uno non rischia di rompere gli altri. Inoltre favorisce la condivisione: la community sta già costruendo una libreria crescente di server MCP predefiniti (per Slack, database, Gmail, ecc.), pronti all’uso . Questo ecosistema modulare permette anche a organizzazioni diverse di riutilizzare lo stesso connector per un certo servizio, evitando duplicazioni di sforzo.

  • Sicurezza e controllo – Uno dei vantaggi chiave di MCP è l’attenzione alla sicurezza integrata. Il protocollo supporta autenticazione e permessi granulari nativamente: il client e il server negoziano cosa il modello può o non può fare, con la possibilità di limitare l’accesso in sola lettura, a specifiche cartelle o a determinate azioni . Questo significa che un’azienda può permettere a un agente AI di consultare un database senza concedergli anche il potere di modificarlo, riducendo il rischio di incidenti o abusi. Inoltre, usando un unico layer di integrazione, diventa più semplice monitorare e loggare tutte le operazioni: invece di tracciare 10 API diverse, si può centralizzare l’audit nel server MCP, applicando in modo consistente le policy di sicurezza e conformità . In settori regolati (finanza, sanità) ciò è fondamentale, e MCP offre un punto unico dove implementare controlli e verifiche . Infine, eseguendo i server MCP nella propria infrastruttura, i dati sensibili rimangono sotto controllo diretto dell’azienda (o dell’utente) e non devono essere esposti a servizi terzi non fidati .

  • Riusabilità e interoperabilità – MCP è stato progettato per essere agnostico rispetto al modello e al fornitore: il protocollo funziona con qualsiasi LLM o ambiente, da GPT-4 a Claude o modelli open-source, e non vincola a uno specifico vendor cloud . Ciò scongiura il vendor lock-in: ad esempio, non serve sviluppare un plugin custom solo per una certa piattaforma proprietaria di chatbot, ma si può usare MCP in modo trasversale. I connettori realizzati una volta possono essere riutilizzati in molteplici applicazioni e con diversi modelli senza modifiche . Questo approccio “build once, use anywhere” aumenta l’efficienza e protegge l’investimento tecnologico nel tempo . Se domani si decide di passare a un altro provider di LLM o di integrare un nuovo tool, basterà pluggare il relativo server MCP senza riscrivere da zero l’integrazione. Inoltre la natura open di MCP incentiva una comunità di sviluppatori a contribuire con nuovi server e client, accelerando la creazione di un catalogo condiviso di integrazioni pronte all’uso .

Ambiti di applicazione di MCP

Le caratteristiche di standardizzazione e modularità di MCP abilitano un’ampia gamma di applicazioni, dal contesto individuale fino alle grandi imprese. Di seguito esploriamo alcuni scenari d’uso rappresentativi – personale, B2C e B2B/enterprise – per capire come questo protocollo può essere sfruttato in pratica.

  • Assistenti personali e uso individuale : immaginiamo un assistente AI personale in grado di aiutare l’utente nelle attività quotidiane accedendo ai suoi dati in modo sicuro. Con MCP, un singolo assistente può connettersi a più fonti personali: ad esempio il calendario e la rubrica contatti, una collezione di note o documenti sul PC, le email o chat private (con il dovuto consenso). Attraverso connettori MCP preposti, l’LLM potrebbe leggere un appuntamento imminente, cercare un file nella directory dei documenti, o riassumere le email non lette – il tutto all’interno della stessa conversazione. Strumenti come Claude Desktop già consentono agli utenti di attivare server MCP locali per collegare l’assistente a file e applicazioni sul proprio computer , mantenendo i dati sotto il controllo diretto dell’utente. Questo scenario “Personal AI” diventa molto più fattibile grazie a MCP: l’utente avanzato può costruire (o installare dalla community) i connettori di cui ha bisogno, sapendo che l’assistente parlerà con tutti tramite un linguaggio unificato. Ad esempio, si può avere un server MCP per il proprio gestore di note, uno per il servizio di to-do list e uno per l’email; l’assistente li utilizzerà tutti insieme, intrecciando le informazioni da queste diverse fonti per fornire risposte e assistenza contestualizzata . Il risultato è un assistente davvero contestuale e multi-sorgente, capace di attingere a tutta la conoscenza personale disponibile in modo armonizzato, senza richiedere all’utente di ricorrere a plugin diversi per ogni funzione.
  • Scenari B2C: e-commerce e customer support : nel mondo B2C, MCP apre la strada a esperienze cliente potenziate dall’AI. Si consideri un e-commerce che voglia offrire un assistente virtuale ai propri clienti: grazie a MCP, il bot potrebbe connettersi a tutte le fonti rilevanti per rispondere alle domande degli utenti e svolgere compiti utili. Ad esempio, mediante un server MCP collegato al database prodotti, l’LLM può recuperare in tempo reale dettagli di inventario, prezzi e specifiche tecniche per consigliare l’articolo giusto al cliente . Un altro connettore MCP potrebbe dare accesso allo storico ordini e al sistema di tracking spedizioni, così che l’AI assistant possa informare l’utente sullo stato del suo ultimo acquisto o avviare una procedura di reso. Tutto questo avviene tramite chiamate standard: il modello “chiede” ad MCP i dati necessari (es. getProductDetails o trackOrder) e riceve le risposte strutturate, senza dover navigare pagine web o affidarsi a conoscenze statiche. Per il cliente l’esperienza diventa quella di un dialogo naturale con un commesso virtuale sempre aggiornato, mentre l’azienda beneficia di una soluzione scalabile – può aggiungere nuove funzionalità semplicemente implementando un nuovo server MCP, magari per collegare un servizio di pagamento o un CRM marketing, senza dover riprogettare tutto il chatbot. In ambito customer support, analogamente, MCP consente a un assistente AI di attingere a knowledge base, FAQ aziendali e ticketing system simultaneamente . Un singolo agente virtuale può risolvere problemi consultando documentazione tecnica, controllando i dati del cliente (es. garanzie, configurazioni) e persino creando ticket di assistenza nel sistema IT, il tutto orchestrato via MCP in modo trasparente per l’utente finale. Questo livello di integrazione contestuale migliora significativamente la pertinenza e l’utilità delle risposte AI (riducendo anche il rischio di allucinazioni, poiché il modello si basa su dati verificati in tempo reale ), offrendo un servizio clienti più efficace e personalizzato.
  • Integrazioni enterprise e agenti AI B2B : nel contesto enterprise e B2B, un protocollo standard come MCP può accelerare la trasformazione digitale rendendo più semplice portare l’AI dentro i processi aziendali. Ad esempio, un’azienda può sviluppare un AI agent interno che funge da assistente per i dipendenti, integrato con i vari sistemi aziendali: base di conoscenza interna, CRM, ERP, strumenti di collaborazione come Slack o Teams, ecc. Utilizzando MCP, un unico assistente conversazionale può: cercare informazioni nella wiki o intranet aziendale, estrarre dati da un database finanziario, creare o aggiornare ticket su Jira/ServiceNow, e persino interagire con la chat aziendale per notificare un collega – il tutto in sequenza, come parte di un flusso multi-step . Ad esempio, un agente AI per il supporto IT potrebbe analizzare la richiesta di un utente, recuperare log di errore da un sistema tramite un server MCP dedicato, aprire un ticket sul portale ITSM tramite un altro connector, e infine confermare all’utente la presa in carico, magari postando un aggiornamento su Slack . Senza un protocollo unificato, implementare questo tipo di flusso avrebbe richiesto di integrare separatamente ogni API e servizio, con molta logica di “colla” difficilmente riutilizzabile; con MCP invece l’agente utilizza comandi standard per scoprire e invocare ciascun tool necessario. Un altro caso d’uso B2B è nell’area vendite e business intelligence: si può avere un assistente AI che interroga il CRM o il data warehouse aziendale per ottenere indicatori aggiornati. Domande come “Quante vendite abbiamo fatto l’ultimo trimestre?” possono essere girate dall’LLM a un server MCP connesso al database di vendita, che ritorna il dato preciso al modello . L’assistente quindi fornisce la risposta al manager in linguaggio naturale, magari arricchendola di contesto (trend, grafici) se i connettori lo consentono. Questo trasforma il modo di accedere alle informazioni in azienda: non più dashboard separate e query manuali, ma conversazioni naturali con un AI abilitato a navigare tra diverse fonti aziendali istantaneamente. Infine, MCP risulta utile anche per costruire agenti AI specializzati per domini verticali – ad esempio nella sanità, un assistente per i medici potrebbe tramite MCP accedere sia ai protocolli clinici che al database dei pazienti (nel rispetto delle autorizzazioni), combinando entrambe le fonti per fornire una risposta accurata; oppure in ambito finanziario, un agente potrebbe reperire dati da sistemi di trading e documenti normativi per assistere un analista. In tutti questi casi, la chiave è la interoperabilità: MCP funge da livello unificante che rende possibile collegare in modo relativamente semplice molteplici sistemi eterogenei all’intelligenza artificiale, favorendo così l’adozione di soluzioni AI nei processi core dell’impresa.

Verso ecosistemi di agenti AI interconnessi

L’emergere di MCP riflette una tendenza più ampia nel mondo AI: passare da soluzioni isolate a un ecosistema connesso di agenti e servizi AI. Standard come il Model Context Protocol potrebbero diventare l’infrastruttura di base su cui si svilupperà un nuovo panorama di applicazioni intelligenti, dove diversi agenti AI e tool collaborano senza soluzione di continuità. Possiamo già intravedere alcune implicazioni evolutive di questa trasformazione:

  • Agenti più autonomi e tool-aware – Man mano che i modelli evolvono in direzione “agentica” (cioè capaci di intraprendere azioni autonomamente per raggiungere obiettivi), avranno bisogno di accedere a un arsenale di strumenti e fonti di conoscenza. MCP offre un directory standardizzato di capacità a cui un agente può attingere dinamicamente . Invece di essere limitato a ciò che è stato codificato staticamente, un LLM agent può scoprire quali server MCP sono disponibili (es. “posso leggere file X”, “posso invocare l’API Y”) e utilizzarli per portare a termine compiti complessi. Questo rende molto più semplice implementare workflow multi-passo e multi-strumento: l’agente può concatenare chiamate a vari connettori (database, gestione ticket, messaggistica) attraverso lo stesso protocollo unificato, senza dover gestire credenziali e API differenti per ciascuno . Il risultato sono agenti AI più capaci e proattivi, perché in grado di orchestrare diversi servizi come parti di un unico processo, un po’ come farebbe un umano passando da un’applicazione all’altra per svolgere un lavoro. Importante sottolineare, come visto, che MCP consente di configurare permessi ristretti e scope precisi per ciascun connettore: ciò attenua i rischi di dare autonomia agli agenti, evitando che un LLM possa causare danni su sistemi critici . Questa combinazione di potenza (accesso a tanti tool) e controllo (limiti e audit centralizzato) è ciò che può sbloccare una nuova generazione di agenti AI affidabili nelle aziende.

  • Standardizzazione delle integrazioni a livello industriale – Se MCP prenderà piede, possiamo aspettarci che sempre più fornitori di software e piattaforme esporranno i propri servizi direttamente tramite connettori MCP ufficiali. In futuro, oltre alle tradizionali API REST/GraphQL, un’azienda tech potrebbe distribuire un piccolo server MCP pronto all’uso per consentire a qualsiasi assistente AI di interfacciarsi con il suo prodotto . Ad esempio, una piattaforma SaaS CRM potrebbe fornire un “MCP connector” che rende disponibili funzioni come getCustomerInfo o createLead conformi allo standard: un’organizzazione che adotta un agente AI dovrà solo installare quel modulo, senza sviluppare nulla da zero. Soluzioni emergenti come Speakeasy stanno già gettando le basi in questa direzione, generando automaticamente codice di server MCP a partire da specifiche OpenAPI esistenti . Questo scenario prospetta un mondo in cui è normale trovare “endpoint MCP” accanto alle API tradizionali, e dove integrare un nuovo servizio nell’ecosistema AI equivale a installare un driver o plugin standard anziché ingegnerizzare una nuova integrazione ogni volta. Il potenziale impatto è enorme: si abbassano drasticamente le barriere per connettere qualsiasi software all’intelligenza artificiale, favorendo la nascita di ecosistemi di agenti interconnessi. Ogni azienda potrebbe scegliere dalla libreria di connector standard quelli pertinenti al proprio stack (dai servizi cloud alle applicazioni on-premise legacy), sapendo che gli agenti AI li potranno usare immediatamente. Si passa così da un paradigma in cui ogni AI è un silos, a un approccio di AI interoperabile, dove varie intelligenze e tool parlano la stessa lingua.

  • Condivisione della conoscenza e collaboratività – MCP facilita anche l’integrazione di fonti di conoscenza trasversali. Come visto, un assistente può combinare informazioni da fonti personali, di team e pubbliche nello stesso contesto . Questo apre possibilità interessanti per la collaborazione uomo-AI: ad esempio, team diversi all’interno di un’azienda possono mettere a disposizione i propri dataset o servizi tramite server MCP (ciascuno con le dovute restrizioni), rendendoli fruibili a un assistente AI comune. L’AI potrebbe fungere da broker intelligente che attinge al knowledge base di diversi reparti per rispondere a domande complesse che richiedono unendo competenze (es. dati di marketing + dati di produzione per un’analisi di supply chain). Inoltre, grazie alla natura modulare, un utente potrebbe “collegare” rapidamente nuove fonti al proprio assistente man mano che emergono esigenze: oggi aggiungo l’integrazione con un nuovo tool di project management, domani scollego l’accesso a un servizio obsoleto, il tutto senza dover riprogettare l’architettura conversazionale. In sostanza, MCP abilita un flusso di conoscenza fluido tra sistemi finora isolati, facendo dell’AI il nodo di raccordo. Questo porta anche benefici in termini di governance: avendo un punto centrale di passaggio (il layer MCP), è più facile applicare regole uniformi su privacy, auditing e conformità quando l’AI accede a dati sensibili . Le organizzazioni possono così abbracciare con più fiducia soluzioni AI pervasive, sapendo di poterle monitorare e controllare meglio rispetto a una giungla di integrazioni non standard.

L’avvento di MCP ci suggerisce un futuro in cui gli assistenti AI saranno componenti omnipresenti e interconnessi nell’ecosistema software, analogamente a come oggi i servizi web comunicano tra loro attraverso protocolli standard come HTTP. Vediamo già interesse e adozione da parte di attori di primo piano: ad esempio, aziende come Block (Square) e tool developer come Zed e Replit sono state tra i primi ad adottare MCP, contribuendo a una community che in pochi mesi ha prodotto centinaia di connettori per ogni sorta di risorsa – da Google Drive ai repository Git .

Questa rapidità di crescita indica che l’industria potrebbe convergere su MCP (o protocolli simili) per evitare di frammentare gli sforzi in mille integrazioni proprietarie. Un ecosistema di agenti AI interconnessi, ognuno specializzato ma capace di collaborare tramite standard comuni, ricorda per certi versi l’evoluzione dei microservizi nel software: piccoli componenti autonomi che lavorano insieme attraverso API ben definite. Allo stesso modo, MCP può favorire una “microservitizzazione” dell’intelligenza artificiale, in cui diverse capacità sono fornite da moduli AI separati ma coordinati. Per utenti e aziende ciò si tradurrà in soluzioni AI più potenti, flessibili e sicure, perché costruite su un’infrastruttura cooperativa anziché su monoliti chiusi.

Un futuro plug-and-play per l’AI

Il Model Context Protocol rappresenta un passo importante verso un’infrastruttura AI scalabile, interoperabile e davvero plug-and-play, in cui aggiungere una nuova capacità a un assistente digitale diventa semplice quanto collegare una periferica a un computer. Grazie a standard aperti come MCP, gli sviluppatori possono concentrarsi sul valore applicativo (logica di business, esperienza utente, strategie di AI) anziché perdere tempo a scrivere integrazioni di basso livello per ogni singolo sistema .

Dal punto di vista strategico, questo significa accelerare la diffusione dell’AI in tutti i settori: riducendo costi e tempi di integrazione, più aziende e prodotti potranno incorporare assistenti e funzioni intelligenti, sapendo di poterli collegare facilmente ai propri dati e processi esistenti. In prospettiva, protocolli come MCP fungeranno da fondamenta comuni su cui costruire ecosistemi AI completi, un po’ come HTTP e REST sono stati le fondamenta su cui è esploso il Web e le API economy.

La standardizzazione porta a effetti di rete: una volta che molti attori adottano lo stesso protocollo, diventa sempre più conveniente per altri aderirvi, creando un circolo virtuoso di compatibilità e innovazione condivisa.

Certo, ci vorrà tempo perché MCP (o alternative analoghe) maturino e vengano adottate su vasta scala, ma la direzione è tracciata. Per chi opera nel campo dell’intelligenza artificiale e della trasformazione digitale, tenere d’occhio queste evoluzioni è fondamentale: abbracciare un approccio modulare e aperto oggi potrebbe fare la differenza nel costruire soluzioni AI future-proof domani. In conclusione, il Model Context Protocol non è solo una nuova tecnologia di integrazione, ma incarna una filosofia di ecosistema – dove AI, dati e strumenti dialogano liberamente.

Questo approccio “a spine intercambiabili” potrà abilitarci a sfruttare l’AI in modo ben più pervasivo e versatile, trasformando davvero l’AI da silos sperimentale a componente infrastrutturale di ogni applicazione moderna . Con protocolli come MCP, l’AI diventa plug-and-play: pronta a connettersi, collaborare e scalare insieme al resto del nostro stack tecnologico.

MCP is not just a technical framework — it’s a philosophy of interconnected intelligence.