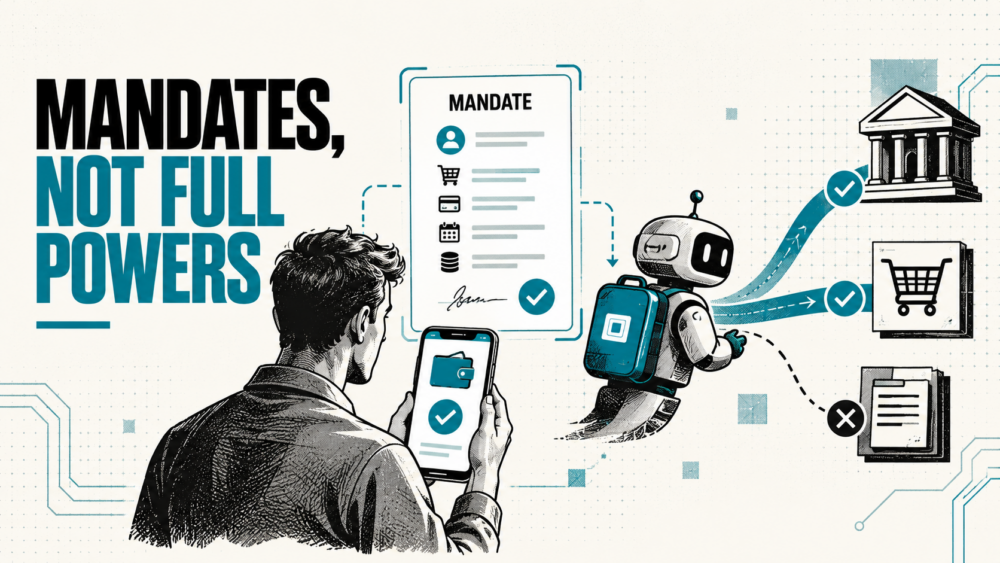
Plenipo e l’EUDI Wallet: dare agli agenti AI un mandato invece dei pieni poteri

Domenica 25 ottobre ho reso pubblico il repository di Plenipo, la libreria che fa approvare dall’EUDI Wallet un mandato per gli agenti AI, e ho pubblicato la versione 0.4 su npm, con licenza Apache 2.0. Il mio vero primo progetto OpenSource, dopo LocalAI.

Nella stessa giornata il primo wallet reale, la Wallet API di walt.id, ha completato tutto il flusso, dalla richiesta del mandato fino alla verifica, e la sandbox è andata online con una vetrina che mostra in diretta cosa succede quando un agente prova a pagare.

In pratica una persona autorizza un agente con un mandato firmato dal proprio wallet, e qualunque servizio, una banca per esempio, verifica quel mandato prima che l’agente agisca. Lo racconto qui perché è un esperimento, con i suoi limiti dichiarati, e perché la domanda da cui nasce mi sembra più grande del codice che ho scritto per rispondere.

Un registro che non dice chi c’è dietro

Tutto parte da un fastidio. Quest’anno, studiando l’EUDI Wallet dentro un progetto di sperimentazione, mi sono messo a guardare come reti di carte e startup statunitensi stanno costruendo i registri degli agenti AI, gli elenchi che servono a un commerciante per riconoscere chi bussa alla sua API. Funzionano, ti dicono quale software ha agito e con quale chiave, ma quasi mai rispondono alla domanda che interessava a me: chi c’è dietro quell’agente, e con quale autorità lo ha mandato a spendere?

Nel frattempo in Europa sta succedendo una cosa che fuori dagli addetti ai lavori si racconta poco. Il regolamento eIDAS 2 chiede a ogni Stato membro di offrire ai cittadini un EUDI Wallet entro la fine del 2026, con dentro il PID, l’identità digitale con valore legale, e il protocollo con cui il wallet presenta le credenziali, OpenID4VP, prevede un meccanismo chiamato transaction data che permette alla persona di approvare in modo vincolante un contenuto mostrato a schermo, con una firma che copre esattamente quei byte.

Ho messo insieme le due cose. Se l’EUDI Wallet sa già firmare quello che leggo, può firmare anche il perimetro dentro cui un agente lavora per me, senza inventare identità nuove né chiavi radice nuove.

Il mandato come oggetto da firmare

Il nome viene da plenipotenziario, chi agisce con pieni poteri per conto di un altro, e il motto del progetto lo rovescia: «Mandates, not full powers». Un mandato Plenipo è un oggetto piccolo e chiuso, con le azioni permesse (pagare bollette, comprare biglietti del treno), i beneficiari ammessi, un tetto per singola operazione e uno complessivo, una data di inizio e una di scadenza, la chiave pubblica dell’agente e il numero massimo di sub-deleghe.

Le regole sono poche e testarde. Ogni mandato ha una scadenza obbligatoria, per default al massimo novanta giorni, e non può durare più del PID che lo ha firmato; se l’agente passa il lavoro a un sub-agente, il figlio può solo stringere il perimetro del padre, e un campo che il sistema non conosce viene rifiutato invece di essere ignorato, perché potrebbe essere un vincolo che qualcuno voleva applicare. La revoca passa da una Token Status List, lo standard IETF che l’EUDI Wallet usa già per sospendere le credenziali, e vale dal controllo successivo.

Ho lavorato molto su un dettaglio che sembra minore: quello che la persona vede deve coincidere con quello che viene applicato. Il mandato viaggia in JSON canonico, il wallet ne firma l’hash, e qualunque differenza fra il testo mostrato e il testo verificato porta al rifiuto. In Pelle Digitale avevo provato a descrivere le interfacce come la superficie dove si negozia la fiducia fra noi e le macchine, e qui quella superficie è una schermata di consenso dell’EUDI Wallet, dove la frase che approvi diventa letteralmente la regola.

Dal PID nell’EUDI Wallet al bonifico rifiutato

Il percorso completo ha diversi passaggi, ma si racconta in poche righe. La piattaforma che ospita l’agente prepara il mandato e lo trasforma in una richiesta OpenID4VP, la persona apre il link o inquadra il QR, il wallet mostra il mandato e risponde con il PID e la firma; del PID, per default, la richiesta chiede soltanto nome e cognome. Da lì l’agente porta con sé la catena, cioè la radice firmata dalla persona più le eventuali deleghe, e firma ogni singola chiamata legandola a quella catena precisa e a un nonce che vale una volta sola.

Dall’altra parte la banca, o qualunque servizio che riceve la richiesta, ricontrolla tutto in un ordine stabilito, dalla radice alle deleghe, dal tempo alla firma dell’invocazione, poi l’ambito e la revoca, e solo alla fine riserva l’importo in modo atomico contro ogni tetto della catena. Se qualcosa non torna arriva un rifiuto con un codice preciso, LIMIT_TOTAL o COUNTERPARTY_NOT_PERMITTED o REVOKED, e il denaro resta dov’è. La libreria si integra come guardia attorno a uno strumento MCP oppure come gateway HTTP davanti a un’API esistente.

Quello che mi ha convinto di più l’ho visto nella sandbox, in uno degli scenari scriptati. Un documento contiene un’istruzione nascosta che prova a far pagare un beneficiario diverso da quello vero, il modello può anche cascarci, e la banca rifiuta comunque, perché quel beneficiario nel mandato non c’è. Ne avevo scritto parlando di tool, skill e MCP: ogni strumento che un agente usa ha un gemello organizzativo, e una delega di potere con una soglia è proprio quel gemello, scritto in una forma che una macchina può verificare.

544 test e nessun audit esterno

Oggi Plenipo è alla versione 0.4, con 544 test nella libreria (compresi vettori di prova e test di fuzzing) e 56 nella sandbox, e una CI che gira su Node 22 e 24 con Postgres e Redis. Ci sono gli store condivisi per chi lavora su più istanze, un gateway HTTP con errori in formato RFC 9457, un registro di audit a catena di hash, l’export verso OPA e Cedar per chi ha già un motore di policy, e la gestione delle chiavi in KMS o HSM.

Sul fronte dei formati ho provato a parlare le lingue che i wallet parleranno. Oltre al tipo proprio di Plenipo c’è una mappatura verso l’e-mandate di TS12, la specifica europea per i pagamenti con il wallet, e un modello sperimentale per le persone giuridiche, dove chi firma per un’azienda presenta anche un’attestazione di ruolo e il mandato non può uscire dai poteri che quel ruolo gli dà.

Il codice ha passato due giri di revisione di sicurezza fatti con agenti AI indipendenti, che hanno trovato 35 problemi, sette gravi, tutti corretti con un test che riproduce l’attacco. Lo scrivo per quello che è: due revisioni automatiche non valgono un audit esterno, che non c’è ancora, e il README avverte di non usare Plenipo per proteggere denaro o dati reali. Wallet, PID provider e banca della sandbox sono simulati, la crittografia no.

Il passo che mi ha fatto più piacere è arrivato domenica, quando la Wallet API 2 di walt.id ha completato il flusso sia con il tipo di mandato di Plenipo sia con un e-mandate TS12 legato al PID. Va detto con precisione, perché chi lavora nei pagamenti lo noterebbe subito: quella seconda modalità serve ai wallet configurabili e ai test, mentre i wallet certificati TS12 legheranno l’e-mandate a un’attestazione della banca del pagatore, un passaggio che dipende dai PSP e che ancora non esiste.

Una scelta che passa dal codice pubblico

Ho deciso di aprire tutto, codice, sandbox e specifiche, con licenza Apache 2.0. Un meccanismo di fiducia che nessuno può leggere chiede esattamente il tipo di fede che vorrebbe eliminare, e chi dovrà accettare un pagamento firmato da un agente deve poter verificare ogni riga prima ancora di sedersi a parlarne.

Con la sandbox pubblica ho voluto rendere il tutto toccabile. Si collega Claude come connettore personalizzato all’endpoint MCP della sandbox, gli si chiede di pagare una bolletta, lui chiede un mandato al wallet di test e restituisce un codice di sei caratteri, e su plenipo.net/demo si vede in tempo reale ogni decisione della banca, con i soldi finti e i controlli veri. È il modo più rapido che ho trovato per spiegare a chi lavora nei pagamenti cosa succede quando l’agente sbaglia, o quando qualcuno prova a farlo sbagliare.

Qualche giorno fa avevo scritto della minimizzazione dei dati come scelta su quanto potere diamo all’AI. Un mandato è la stessa scelta presa dall’altro lato, quanto potere diamo all’agente quando esce a spendere per noi.

Il prossimo passo è un telefono

La sperimentazione adesso deve uscire dal laptop. Il prossimo passo è il wallet di riferimento europeo su emulatore Android, che può dichiarare tipi di transaction data propri ma va modificato per mostrare il mandato nella schermata di consenso, e poi IT-Wallet, dove serve un dialogo con chi gestisce lo schema perché oggi non c’è supporto pubblico per tipi personalizzati.

Lato mercato guardo in due direzioni. Le banche e i PSP, che con TS12 dovranno decidere se e come accettare l’e-mandate per il commercio fatto dagli agenti, e le imprese, dove un amministratore che affida un acquisto a un agente lo deve fare dentro i poteri di firma che ha davvero, con un registro che lo attesti. Su entrambi i fronti mancano ancora pezzi normativi, dagli atti di esecuzione sugli European Business Wallet a una regola comune per le attestazioni SCA, e Plenipo per ora riempie i vuoti con formati propri dichiarati come tali.

Non ho ancora capito quale di queste porte si aprirà per prima, e alcune scelte, il legame fra l’attestazione della banca e il PID per esempio, non spetta a me prenderle da solo. Fra pochi mesi però milioni di europei avranno in tasca un’identità con valore legale, e mi sembra il punto giusto da cui far partire la fiducia verso gli agenti, prima che qualcun altro la definisca altrove con regole che non possiamo leggere.

Dove trovare Plenipo

Chi lavora in una banca, in un PSP o su un wallet e vuole provarlo su un caso concreto mi trova dalla pagina contatti.


Riferimenti: Regolamento (UE) 2024/1183 (eIDAS 2), OpenID4VP 1.0, EUDI TS12.
Azienda agentica: gli otto strati da progettare prima dell’interfaccia

Da prima di agosto ho messo da parte, uno dopo l’altro, gli schemi con cui i grandi fornitori di software aziendale raccontano la loro offerta di intelligenza artificiale, per studiarli: quello di uno dei CRM più diffusi, quello della suite d’ufficio che quasi tutti abbiamo sul portatile, quelli delle piattaforme verticali per la logistica e la distribuzione e così via. Cambiano i nomi, cambiano i colori, a volte i prodotti cambiano nome da un mese all’altro e chi prova a seguirli fatica a capire cosa sia stato annunciato e cosa porta veramente di differente sul mercato.

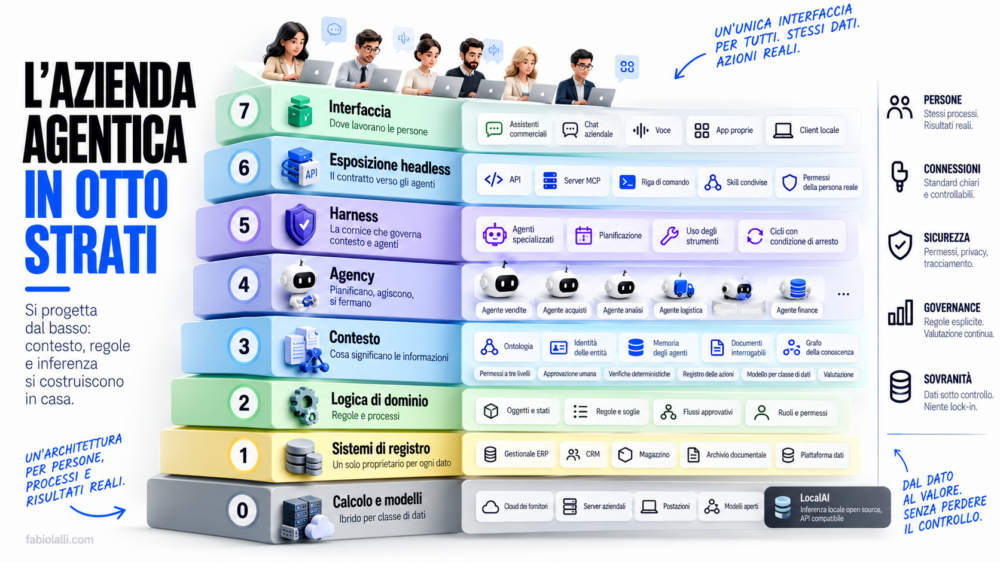
Messi uno accanto all’altro, però, disegnano la stessa torre, e ognuno a modo suo descrive l’azienda agentica.

In basso ci sono i sistemi dove vive la verità aziendale, sopra di loro uno strato che trasforma i dati in contesto leggibile da un modello, sopra ancora gli agenti che ragionano e agiscono, e in cima un’interfaccia conversazionale dove le persone fanno domande e approvano azioni.

Attorno a tutto, disegnato come una cornice e quasi mai come un piano, l’insieme di servizi che nessuno compra a parte, che spesso vanno decisi e scritti proprio internamente e che, però, tiene in piedi la costruzione: permessi, sicurezza, tracciamento delle azioni, valutazione dei risultati.

La torre descrive bene dove stanno andando le aziende dal mio punto di vista.

Gli schemi lasciano fuori, perché a chi li disegna conviene darlo per scontato, una domanda molto specifica e importante: chi possiede gli strati bassi?

Dove gira il modello, dove viene assemblato il contesto, chi può leggere il registro di quello che gli agenti hanno fatto.

Su questa domanda ho costruito il lavoro di questo ultimo anno da quando ho fondato ZeroFive.AI e che sto portando nei progetti con le aziende, con LocalAI sull’inferenza locale e con Gideon, l’ultimo nato, l’assistente che uso ogni giorno come banco di prova. In questo approfondimento provo a descrivere in modo puntuale e sintetico (nemmeno troppo) l’approccio per intero, senza marchi di fornitori, perché questa architettura dell’azienda agentica vale anche per chi non comprerà mai una licenza da nessuno di loro.

Otto strati dell’azienda agentica, letti dal basso

La versione astratta della torre, quella che vale per qualunque azienda agentica, ha 8 strati. Li descrivo partendo dal basso perché è l’ordine in cui andrebbero progettati, anche se quasi tutti i progetti che incontro partono dall’alto, dalla scelta dell’assistente da comprare per i dipendenti, o dal modello o dalla tecnologia in generale.

Strato Cosa contiene Domanda da fare prima di costruirlo
0. Calcolo e modelli dove gira l’inferenza: cloud, server aziendali, postazioni quali dati possono raggiungere quale modello?
1. Sistemi di registro gestionale, CRM, archivi documentali, magazzino per ogni dato, qual è l’unico sistema proprietario?
2. Logica di dominio oggetti, regole, flussi approvativi, permessi quali regole oggi stanno solo nella testa di qualcuno?
3. Contesto identità delle entità, ontologia, memoria degli agenti, testi vettorizzati cosa significano le informazioni e chi lo decide?
4. Agency ragionamento, pianificazione, agenti specializzati, cicli di esecuzione quali compiti si delegano e con quale condizione di arresto?
5. Harness governo, sicurezza, osservabilità, valutazione, scelta del modello cosa può fare un agente senza chiedere, e chi lo verifica?
6. Esposizione headless API, server MCP, riga di comando, skill quale contratto vede chi sta sopra?
7. Interfaccia assistenti commerciali, chat aziendali, voce, app proprie dove lavorano già le persone?

Lo strato zero è quello che nessuno compra e tutti pagano. Nella torre dei fornitori coincide con il loro cloud e non compare quasi mai nei disegni, eppure decide dove finisce ogni frase che un agente legge, e quanto costa leggerla.

Sopra stanno i sistemi di registro, che le aziende conoscono da trent’anni e che con l’arrivo degli agenti chiedono una sola regola, la più difficile da rispettare: ogni dato ha un solo sistema proprietario, e tutti gli altri lo citano invece di copiarlo. Un’anagrafica cliente duplicata in due posti produce, dopo pochi mesi, due verità su chi decide in quell’azienda, e un modello che le legge entrambe sceglie a caso quale riportare.

La logica di dominio è lo strato che trasforma i dati in processi. Un ordine ha uno stato, uno sconto oltre una certa soglia richiede una firma, un fornitore nuovo passa da una verifica prima di ricevere il primo pagamento. Molte di queste regole vivono nel codice dei gestionali, molte altre in procedure che qualcuno ha scritto anni fa, e una parte consistente solo nell’abitudine di chi fa quel lavoro da tanto tempo. Il modello dati è una teoria dell’azienda, e gli agenti la ereditano così com’è, con le scelte fatte da un consulente dieci anni fa per far quadrare la contabilità analitica.

Il contesto è lo strato dove l’azienda dice a un modello cosa significano le sue informazioni: che “cliente” in amministrazione vuol dire chi ha una fattura aperta e in commerciale chi ha un’opportunità attiva, che due nomi diversi indicano la stessa persona, quale decisione presa in una riunione di marzo ha superato quella di gennaio. Qui stanno l’ontologia, la risoluzione delle identità, la memoria di lungo periodo degli agenti e il testo dei documenti reso interrogabile. Sopra lavora l’agency, cioè la parte che pianifica, sceglie gli strumenti, esegue e controlla il risultato in un ciclo che si ripete finché non scatta una condizione di arresto.

L’harness ha un numero in tabella per comodità, ma nel disegno andrebbe tracciato come una cornice attorno al contesto e agli agenti. È tutto quello che serve a un agente in produzione e che non è il modello: i permessi con cui agisce, le regole che decidono quando deve chiedere, il registro di quello che ha fatto, le verifiche automatiche sui risultati, la scelta di quale modello usare per quale classe di dati.

Sopra ancora c’è l’esposizione headless, che rende disponibile tutto quello che sta sotto senza bisogno di uno schermo, attraverso API, server MCP, riga di comando e skill.

In cima l’interfaccia, che grazie ai due strati precedenti può essere quasi qualunque cosa.

L’interfaccia esce dal centro del progetto

Per vent’anni il software aziendale ha coinciso con il suo schermo. Si comprava una licenza per ogni postazione, si formavano le persone sull’interfaccia, si misurava l’adozione contando quanti accessi faceva ciascuno ogni settimana, e il fornitore teneva il cliente proprio attraverso quell’abitudine visiva: cambiare CRM voleva dire riaddestrare centinaia di persone a cliccare in posti diversi. Il valore stava sopra, nell’interfaccia, e i dati sotto erano il prezzo da pagare per usarla.

Nell’azienda agentica questo rapporto si rovescia. Le persone lavorano dentro l’assistente che preferiscono, un client commerciale, la chat aziendale, la voce in macchina, e chiedono a quell’assistente di andare a prendere le informazioni dove si trovano e di agire per loro conto. In Pelle Digitale avevo provato a descrivere l’interfaccia come il punto di contatto fra la persona e il sistema digitale che la circonda; con gli agenti quel punto si moltiplica e si assottiglia, diventa una superficie che cambia a seconda del momento e del dispositivo, e domani anche dello spazio fisico, come racconto in Spatial Shift. Il prodotto che un’azienda deve costruire verso i propri agenti non è più uno schermo, è un contratto: quali operazioni si possono chiedere, con quali permessi, con quali garanzie sul risultato.

Il Model Context Protocol è oggi la forma più diffusa di quel contratto, e il motivo per cui lo strato sei della tabella è diventato progettabile da un’azienda di medie dimensioni senza un esercito di sviluppatori. Un server MCP espone gli strumenti di un sistema a qualunque client compatibile, e lo stesso server serve il dipendente che usa un assistente commerciale, il collega che preferisce un client locale e l’agente notturno che prepara i report del lunedì. La regola che tengo ferma in ogni progetto riguarda l’identità: il modello opera sempre con i permessi reali della persona che lo sta usando, mai con un’utenza tecnica capace di tutto.

C’è un test semplice per capire a che punto è un’azienda, e lo propongo spesso nelle prime riunioni.

Se domani i dipendenti cambiassero assistente, quanto lavoro andrebbe rifatto?

Quando la logica vive nei prompt salvati dentro il prodotto di un fornitore, nelle sue memorie e nei suoi agenti preconfigurati, va rifatto quasi tutto. Quando vive negli strati dal tre al sei, il cambio è una configurazione, e la scelta dell’assistente torna a essere una decisione su costo e riservatezza.

C’è un lavoro enorme da fare ed è sottovalutato

Nelle dimostrazioni un agente risponde in pochi secondi a una domanda sul portafoglio clienti, prepara una bozza di offerta e propone il prossimo passo commerciale. In produzione lo stesso agente deve sapere che la parola “cliente” ha tre significati in tre uffici, non deve leggere i margini se la persona che lo interroga non è autorizzata a vederli, deve lasciare traccia di quello che ha fatto e deve fermarsi quando la confidenza è bassa. Tutto questo vive in due strati che nelle demo non si vedono, il contesto e l’harness, ed è lì che passa la maggior parte del tempo di un progetto serio.

Sul contesto ho scritto molto in queste settimane, e nelle aziende lo riduco a una regola: il significato va deciso prima che lo decida un modello. Un modello collegato a dati senza tipi e senza relazioni dichiarate ricostruisce da solo il senso delle cose, ogni volta in modo leggermente diverso, e due risposte alla stessa domanda a una settimana di distanza smettono di coincidere. Un’ontologia operativa fissa i tipi di oggetto, le relazioni e le azioni ammesse su ciascuno, e ha un effetto collaterale che i direttori finanziari capiscono subito: riduce i token che un agente spende per orientarsi. Lo stesso vale per la quantità di materiale che si carica nella finestra di contesto, dove il superfluo compete con quello che serve invece di essere scartato.

L’harness è lo strato su cui i fornitori sono più indietro, e lo dicono loro stessi. In almeno uno degli annunci più ambiziosi di quest’autunno, governo e sicurezza compaiono fra le capacità della piattaforma con l’annotazione che sono in parte ancora da costruire. La parte del sistema che decide cosa può fare un agente senza chiedere, chi lo verifica e cosa rimane scritto dopo è quindi la meno matura nelle offerte chiavi in mano, e quella che chi costruisce un’azienda agentica ha più interesse a progettare in casa.

Nei progetti la scrivo prima degli agenti, con quattro famiglie di regole. I permessi sugli strumenti hanno tre livelli, negato, consentito con conferma, consentito senza conferma, e ogni strumento nasce al livello più restrittivo. Le scritture passano da un’approvazione umana: il modello propone, le persone firmano, e nessuna informazione entra nella memoria aziendale senza un responsabile con nome e cognome. Tutto quello che si può verificare in modo deterministico va tolto al giudizio del modello e affidato a uno script, dal totale di un preventivo alla validità di un pacchetto di modifiche. E ogni chiamata lascia una riga in un registro leggibile, con chi l’ha chiesta, quale modello l’ha eseguita e quali dati sono usciti dal perimetro.

Chi possiede gli strati bassi

Ogni volta che un agente lavora, il contesto viene assemblato e spedito al modello. Quel pacchetto contiene il distillato più prezioso che un’azienda produce: il modo in cui classifica i clienti, le decisioni prese e le ragioni per cui sono state prese, le relazioni fra persone, contratti e progetti. Nella torre dei grandi fornitori quel distillato viaggia verso un data center che non controlli, con le garanzie del contratto che hai firmato, a un prezzo calcolato a token che può cambiare alla prossima revisione del listino, su modelli che il fornitore può ritirare con qualche mese di preavviso. Sono condizioni accettabili per molte classi di dati, a patto di conoscerle prima della firma, cosa che capita molto meno spesso di quanto si pensi.

La sovranità di cui parlo con le aziende è una scelta per classe di dati, senza ideologia contro il cloud.

Il metodo che uso divide le informazioni in tre gruppi: quelle che possono uscire liberamente, come ricerche pubbliche e bozze di contenuti, quelle interne che possono uscire solo verso fornitori con garanzie contrattuali adeguate, quelle che non devono uscire per nessun motivo, come i dati economici riservati o i segreti industriali. Ai primi due gruppi si applica il modello più capace disponibile, al terzo un modello che gira dentro il perimetro, oppure un passaggio di anonimizzazione prima dell’invio.

Per molto tempo il terzo gruppo ha avuto poche soluzioni pratiche, perché i modelli aperti erano lontani da quelli commerciali e farli girare richiedeva competenze che un’azienda media non aveva in casa. Oggi lo strato zero si può possedere.

LocalAI, il progetto open source di inferenza locale di cui sono cofondatore e dove seguo il prodotto, nasce esattamente per questo: fa girare modelli aperti su hardware aziendale, dal server nel seminterrato alla workstation di un reparto, ed espone un’interfaccia di programmazione compatibile con quella dei principali fornitori commerciali. Gli strati che stanno sopra non si accorgono del cambio, e un’azienda può affiancare un modello locale a uno commerciale e smistare le chiamate in base alla classe del dato, senza riscrivere né il contesto né gli agenti.

L’azienda agentica che ne esce è ibrida quasi sempre, a mio avviso, e va bene così. Quello che cambia rispetto alla torre comprata intera è la posizione del cuore: ontologia, memoria, regole e registri restano dentro l’azienda, e il modello diventa un lettore che si può sostituire, affiancare o spegnere senza perdere nulla. Cambiare fornitore smette di essere un progetto di migrazione e diventa una riga di configurazione.

“Gideon” come banco di prova

Prima di proporre un’architettura a un’azienda la provo su di me. Gideon è il mio assistente personale, prende il nome dall’intelligenza artificiale di The Flash (Jarvis è troppo abusato ormai, anche io lo chiamavo così), e in questi mesi è diventato il posto dove verifico ogni strato della tabella con dati veri, i miei. Il principio di progettazione è lo stesso che porto nelle aziende: la memoria sta fuori dal modello, e il modello si può cambiare in qualunque momento.

Le funzioni su cui sto lavorando seguono gli strati quasi uno per uno. Gideon fa girare modelli locali e può affiancare modelli esterni quando il compito lo richiede, e già questo sposta la proprietà dello strato zero. Il lavoro parte da cartelle collegate e file caricati, perché la domanda più frequente che una persona fa a un assistente riguarda i propri documenti, e quei documenti devono essere interrogabili senza uscire dalla macchina. I connettori MCP, che sono la sua esposizione verso il resto del mondo, sono divisi in tre famiglie (interni all’assistente, servizi aziendali, servizi di terze parti) e per ciascuno il sistema propone una descrizione di quando usarlo, che l’utente può correggere.

L’harness è la parte dove ho investito di più. Ogni strumento ha i tre livelli di permesso, dal divieto all’esecuzione senza conferma. Una protezione della riservatezza si attiva nel campo dove si scrive la richiesta e lavora anche quando la richiesta va verso un modello esterno, togliendo dal testo quello che non deve uscire. E una pagina sullo stato del sistema mostra i consumi, le chiamate e soprattutto le uscite di dati verso terzi e verso i connettori, perché un’azienda che non sa cosa è uscito ieri non può decidere cosa far uscire domani.

Nessuna di queste funzioni è una scoperta. Ognuna esiste già da qualche parte, sparsa fra prodotti diversi, e quello che manca quasi sempre è la loro composizione in un unico sistema dove il cuore rimane in mano a chi lo usa. Gideon serve a me per capire quanto costa questa composizione, dove si inceppa e quali scelte sopravvivono al passaggio da una persona a un team.

Come accompagno un’azienda dentro lo stack

Il lavoro con le aziende comincia quasi sempre da una richiesta che sta in cima alla torre: quale assistente comprare, come portare gli agenti nel servizio clienti, come far parlare il CRM con la chat aziendale. La prima cosa che faccio è rimettere la torre in piedi, e disegnare con il team la mappa dei suoi otto strati com’è oggi. Per ogni strato scriviamo chi ne è proprietario, quale contratto espone allo strato superiore e se si potrebbe sostituire senza toccare gli altri. Le mappe che ne escono si somigliano spesso: i sistemi di registro esistono e funzionano, la logica di dominio è per metà nel software e per metà nelle persone, il contesto manca, l’harness manca, l’interfaccia è stata già comprata da qualcuno.

Da lì il percorso sale dal basso.

La classificazione dei dati nei tre gruppi viene per prima, perché decide cosa si può fare allo strato zero e quali modelli possono leggere cosa. Poi la regola del sistema proprietario per ogni dato, e un’ontologia minima che fissa i tipi di oggetto, le relazioni e chi decide quando due fonti si contraddicono. Poi l’harness, scritto prima che esista un solo agente in produzione: permessi, approvazioni, verifiche automatiche, registro delle azioni. Solo a quel punto si espongono i sistemi attraverso server MCP con i permessi reali delle persone, si costruiscono le skill condivise che fanno parlare a tutti gli assistenti la stessa lingua aziendale, e si sceglie l’interfaccia, spesso più d’una, guardando dove le persone lavorano già.

In ZeroFive.AI questo percorso è organizzato in cinque fasi, ALIGN, ASSESS, ARCHITECT, ACTIVATE e AMPLIFY (come si vede nell’immagine), con cancelli decisionali fra l’una e l’altra che il cliente deve superare prima di spendere nella fase successiva.

Il rischio legato all’AI si misura nella fase di valutazione e non a sistema già acceso, e nessun caso d’uso entra nel portafoglio senza un confronto scritto con l’alternativa che non usa l’intelligenza artificiale, perché in una parte dei casi uno script ben fatto risolve lo stesso problema a una frazione del costo.

Il “Workspace progetti” per esempio, la piattaforma con cui gestiamo i progetti dei clienti in ICONICO e Zerofive, è il caso che porto come esempio in aula per far vedere come facciamo le cose: molte delle regole descritte qui, dal sistema proprietario per ogni dato all’approvazione umana delle proposte, sono già in produzione al nostro interno, ed è il modo più rapido per mostrare a un’azienda come funzionano prima che decida se costruire le proprie.

C’è poi la parte che nessun diagramma che di solito non si trova, e cioè le persone.

Il corso che sto portando nelle business school e nei percorsi aziendali è costruito su quattro discipline che corrispondono a 4 zone della torre: prompt engineering per l’interfaccia, context engineering per lo strato del contesto, loop engineering per gli agenti, harness engineering per la cornice che li governa.

Un’azienda che compra uno stack senza avere nessuno capace di ragionare su queste quattro zone si ritrova un sistema che funziona finché funziona, e che nessuno sa correggere quando cambia qualcosa e che soprattutto nessuno sa avere potenzialità più avanzate.

Chi vuole capire da dove partire nella propria organizzazione può scrivermi: la prima mappa degli otto strati si costruisce insieme alle persone che conoscono davvero i sistemi, e dice già molto su quali investimenti fatti finora sono riutilizzabili e quali andranno rifatti. 

Fondamenta da tenere in casa

Nei prossimi due anni l’interfaccia cambierà più volte.

Gli assistenti di oggi verranno rinominati, accorpati, sostituiti da altri che ancora non conosciamo, e una parte del lavoro passerà dalla chat alla voce e agli ambienti.

Un’azienda agentica che avrà costruito in casa il contesto, l’harness e l’esposizione dei propri sistemi cambierà assistente con la stessa facilità con cui oggi si cambia browser, e sceglierà ogni volta il modello più adatto alla classe di dati che deve trattare.

Chi avrà comprato la torre intera tratterà ogni anno con il fornitore il prezzo di accesso al proprio contesto, cioè alla descrizione più accurata di sé che abbia mai prodotto. La torre la disegneranno i fornitori, ed è giusto che sia così; le fondamenta conviene che ogni azienda le tenga a casa propria.

Chi decide quando due agenti AI non sono d’accordo

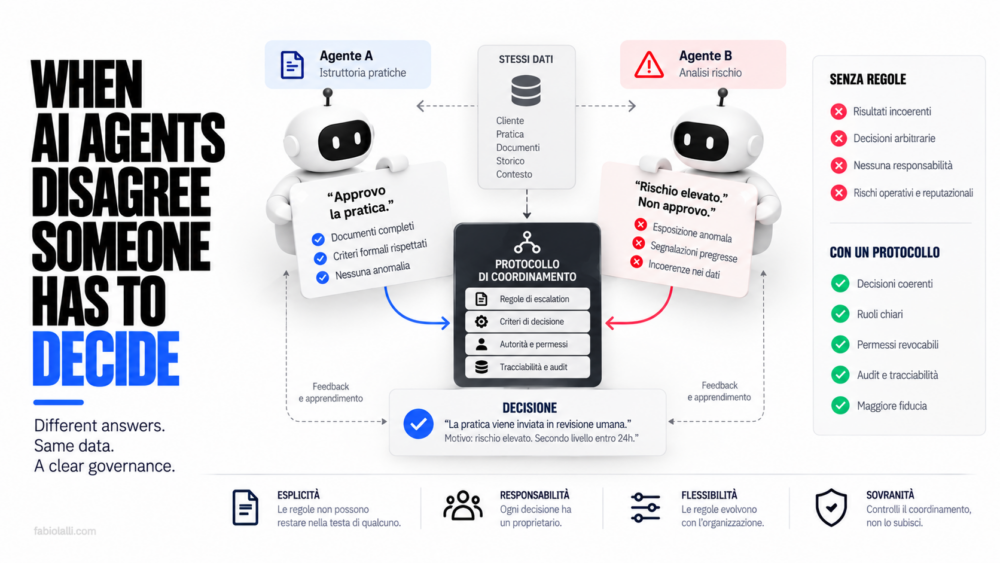
Al tavolo di un cliente, qualche settimana fa, la riunione si è fermata su una domanda che non era tecnica. Avevano due agenti AI quasi pronti, uno che istruisce le pratiche e uno che interroga i sistemi di rischio, e a un certo punto qualcuno ha chiesto cosa succede quando il secondo contraddice il primo. Il silenzio che è seguito non era imbarazzo. Quella regola non stava scritta da nessuna parte nemmeno per le persone che facevano lo stesso identico lavoro il giorno prima, e per quindici anni era bastato così, perché c’era un capo servizio che la teneva in testa e la applicava caso per caso, con criteri che nessuno gli aveva mai chiesto di dettare.

Da un paio d’anni ripeto una cosa che sembra ovvia e nella pratica non lo è mai: mettere più modelli linguistici dentro lo stesso spazio computazionale non produce da sé né i benefici né i rischi. Li produce il modello di coordinamento che gli diamo, e quel modello va scritto, in forma esplicita, con protocolli, criteri, autorità. Attendersi che il valore emerga da solo da un collettivo di macchine è la versione tecnologica della speranza che un’orchestra suoni bene perché i musicisti sono bravi.

La parte scomoda arriva subito dopo: progettare un modello di coordinamento presuppone che da qualche parte, in azienda, ce ne sia già uno leggibile da cui partire, e quasi nessuna organizzazione ce l’ha.

Il collettivo di agenti AI eredita quello che trova

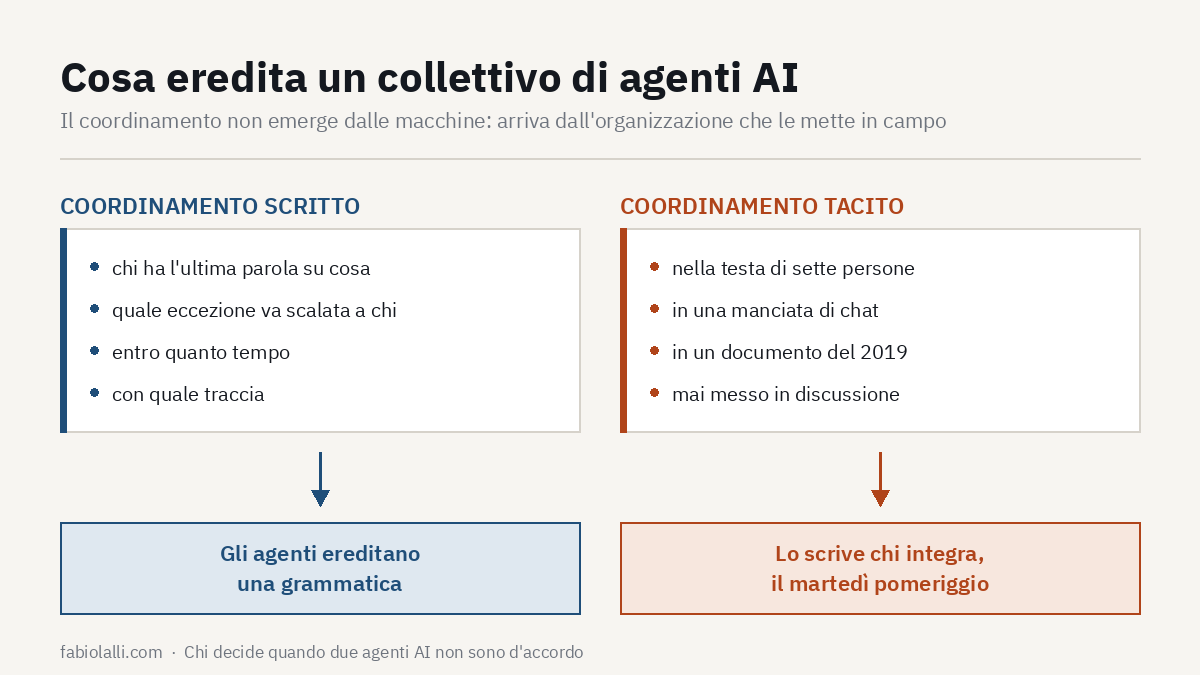
Un sistema di agenti AI messo in produzione dentro un’azienda non arriva su una tabula rasa, si innesta sul modo in cui quell’azienda coordina già le proprie persone. Dove quel modo è esplicito, e capita nelle filiere regolate, nella logistica, in parte della sanità, gli agenti trovano un substrato: chi ha l’ultima parola su cosa, quale eccezione va scalata a chi, entro quanto, con quale traccia. Il collettivo computazionale eredita una grammatica e ci si appoggia.

Dove invece il coordinamento vive nella testa di sette persone anziane e in una manciata di chat, non c’è niente da ereditare. E quel vuoto lo riempie chi integra, il martedì pomeriggio, con la scelta di implementazione che gli sembra più ragionevole in quel momento. È così che il modello di coordinamento di un’impresa finisce dentro un file di orchestrazione senza che nessuno l’abbia mai deliberato, e senza che nessuno se ne accorga finché non arriva la prima contestazione seria.

Avevo affrontato la stessa questione dal lato del significato quando scrivevo di ontologia come infrastruttura invisibile: lì il problema era che un agente non sa cosa vuol dire “cliente attivo” se l’azienda non l’ha mai definito. Qui il problema è gemello e sta un piano sopra, perché anche sapendo cosa significa un ordine bisogna ancora stabilire chi può agire su di esso, e chi può fermare l’altro.

Quando il protocollo fra due uffici non esiste

Di questi progetti il pezzo più utile matura molto prima della messa in produzione, e non ha niente di tecnologico. Provare a scrivere il protocollo di coordinamento fra due agenti AI costringe a scoprire che non esisteva nemmeno fra due uffici.

Nelle sessioni di assessment che conduco succede quasi sempre lo stesso movimento: si parte con la domanda su quale modello usare, si finisce a ricostruire chi ha l’autorità di annullare una decisione presa da qualcun altro, e quanto vale quell’autorità dopo che la decisione è già stata comunicata al cliente. Sono domande di governance che l’azienda si porta dietro irrisolte da anni, tollerabili finché a coordinare erano persone che si conoscono e si telefonano, insostenibili nel momento in cui il coordinamento passa a un collettivo di agenti AI che esegue e basta.

Su questo tema ho una posizione che ripeto da un po’: la vera unità di misura di un agente non è quello che sa fare, è il permesso revocabile sotto cui lo fa. La maturità di un’organizzazione cognitiva si misura sulla capacità di dire, per ciascun agente in circolazione, chi gliel’ha concesso, fino a quando, e con quale gesto glielo si toglie.

La gavetta era il posto dove passava il criterio

C’è una trasformazione che vedo sottovalutata quasi ovunque, e riguarda l’apprendimento. Questi sistemi si sono messi in mezzo fra le persone e la conoscenza di come si fanno le cose, e il primo posto dove si sono infilati sono i compiti di gavetta, quelli che nelle organizzazioni funzionavano da palestra per chi comincia. Una generazione intera rischia di perdere le occasioni di imparare che tutte le precedenti hanno avuto.

Dal mio tavolo si vede bene una cosa in più. La gavetta non serviva solo a formare chi la faceva. Era il momento in cui il criterio implicito veniva tirato fuori dalla testa del senior e messo in parole, malamente, di corsa, davanti a una pratica sbagliata da rifare, e in quell’attrito il criterio si riformulava ogni volta un po’ diverso e un po’ più preciso. Toglila di mezzo e non perdi soltanto il canale di trasmissione verso i giovani, perdi la sola occasione in cui l’azienda si spiegava a voce alta come funziona.

È il debito cognitivo nella sua forma meno visibile: non si accumula quando deleghiamo l’esecuzione, si accumula quando deleghiamo l’occasione di dover spiegare. Sulla superficie di contatto fra noi e le macchine si decide ogni giorno cosa passa e cosa no, e continuo a pensare che la parte da tenere di qua sia proprio quella, il momento in cui qualcuno è costretto a dire perché.

Governare uno strumento, non attendere un’entità

Nelle conversazioni con i board torna spesso l’idea, che si associa di solito a Nick Bostrom, dell’intelligenza artificiale come ultima invenzione che l’umanità dovrà fare, quella che poi risolverà i problemi troppo grandi per noi. È una formula che semplifica parecchio, e soprattutto colloca l’AI in una zona fuori portata, dove le decisioni le prende lei e a noi tocca aspettare l’esito.

Trovo che la cornice messianica, in azienda, faccia un danno preciso e poco spettacolare. Se l’AI è un destino, la cosa sensata da fare è aspettare, magari fare un pilota per dire che ci si sta muovendo, e rimandare. Se invece è uno strumento, la cosa sensata da fare è noiosa e comincia lunedì: scrivere il protocollo, assegnare le autorità, decidere dove gira il calcolo e con quali termini, verificare di poterli revocare. La narrazione dell’entità super intelligente è comoda perché sposta la responsabilità dal consiglio di amministrazione a un futuro indeterminato.

Della sovranità digitale ho parlato spesso come di una questione di infrastruttura, e lo è, ma la sua metà meno raccontata sta qui: sovrano è chi ha scritto le regole con cui i propri agenti AI si parlano e può cambiarle senza chiedere il permesso a un fornitore, molto più di chi si limita a ospitarli dentro il proprio perimetro.

Chi scrive il protocollo

La domanda più fastidiosa arriva alla fine, ed è chi materialmente questo lavoro lo fa. Il vendor porta un default ragionevole, calibrato su mille clienti diversi dal tuo, e non può fare altrimenti. L’integratore chiede le regole all’azienda e si vede consegnare un documento di processo del 2019 mai più aggiornato. All’IT da solo non si può lasciare, perché le regole di coordinamento fra agenti AI sono decisioni di business travestite da configurazione.

Nelle poche organizzazioni dove ho visto funzionare, il protocollo l’hanno scritto le persone che il lavoro lo fanno, sedute in una stanza per settimane, con qualcuno che faceva domande scomode e trascriveva. Costa parecchio e non produce nessuna demo da mostrare in comitato. Ed è l’unica parte del progetto che l’azienda si tiene anche se cambia modello, fornitore e architettura tre volte in cinque anni.

Se davvero l’era agentica ci obbliga a mettere per iscritto come coordiniamo il lavoro, allora l’effetto più duraturo dell’AI in azienda potrebbe non avere niente a che fare con le macchine, e riguardare il fatto che per la prima volta molte imprese saranno costrette a leggere ad alta voce come funzionano davvero. Vediamo quante reggono la lettura.

Il gemello cognitivo lo addestri tu

Alla terza volta esce giusta. L’hai corretto due volte, gli hai detto che quel cliente vuole una cosa e non un’altra, che in quel contesto non si apre mai dal prezzo, che una proposta senza un certo paragrafo non regge. Al terzo tentativo la risposta è esattamente quella che avresti scritto tu, e ti senti efficiente. In quell’istante qualcosa è passato da te al modello, e non era la risposta.

Quello che è passato è la correzione, il motivo per cui hai scartato le prime due, il gusto con cui hai riconosciuto quella buona, la riga che con un cliente non superi. Ci hai messo quindici anni a costruirla, l’hai consegnata in tre scambi.

Il mestiere passa nella correzione

Il modello non impara dalla tua risposta giusta, impara dai tuoi no. La distanza tra quello che ha prodotto e quello che gli hai fatto riscrivere è il segnale più prezioso che gli puoi dare, perché è lì che vive il giudizio, e il giudizio è la parte di te che non trovi scritta da nessuna parte, quella che negli anni ha smesso di essere una regola ed è diventata un istinto.

Sui gemelli digitali ho scritto altrove, pensando ad avatar e identità sintetiche. Questo gemello è più intimo: riproduce un criterio. Chiamiamolo gemello cognitivo. Il modello pubblico ne costruisce uno del tuo modo di decidere a partire dall’attrito, dalle volte in cui gli dici che ha sbagliato e soprattutto perché. A pesare è la sequenza di scelte che ti ha portato a quel documento e non a un altro, la cosa che ti chiede di rendere esplicita a ogni passaggio. I documenti in sé li ha già visti a milioni.

Un clone che non dimentica niente

Un collaboratore giovane impara guardandoti, poi dimentica qualcosa, è uno solo, e in qualche modo ti deve qualcosa: lo stipendio, la riconoscenza, gli anni che gli stai regalando. Il modello non dimentica niente e si copia all’infinito, senza doverti nulla. Nel momento in cui la tua correzione risolve un problema che hanno in milioni, in milioni ricevono il tuo modo di farlo senza sapere che è tuo, e senza che a te torni indietro niente. Un tempo il tuo modo di trattare quel cliente valeva perché lo avevi solo tu, e chi lo voleva veniva da te. Adesso lo stesso modo, una volta entrato nel modello, esce dal rubinetto per chiunque digiti la domanda giusta, allo stesso prezzo dell’abbonamento.

La reciprocità che regge l’apprendistato umano qui salta. È il punto dove di solito il ragionamento si ferma, con un senso di furto e un’aria da resa.

Mentre lo istruisci, ti disalleni

C’è una metà che quasi nessuno dice. Lo stesso gesto che manda fuori il tuo metodo lo consuma dentro. Smetti di scrivere la proposta e correggi quella che ha scritto lui, smetti di tenere in mano il criterio e ti riduci a sorvegliarlo, e ogni volta che deleghi la parte difficile perché tanto poi la sistemi, quella parte in te si assottiglia di un grado.

Tra cinque anni la macchina ha il tuo modo di fare e tu hai perso il tono muscolare per rifarlo senza. Il gemello cognitivo si affina mentre l’originale si spegne. Non è un furto, è un’atrofia. Di questo assottigliamento, del debito cognitivo che si accumula un riassunto accettato alla volta, ho scritto pensando alla metacognizione, all’esercizio di guardare come si pensa proprio mentre si usa il modello. Il segnale è facile da riconoscere: quando ti accorgi che davanti a un foglio bianco, con il modello chiuso, non partiresti più con la sicurezza che avevi due anni fa.

Trattenere tutto è una prigione

La risposta istintiva a tutto questo è nascondere. Tenersi il metodo, non darlo in pasto, lavorare a fari spenti. Strada chiusa, per due motivi. Il primo è che il modello rende peggio esattamente dove ti serve di più, quindi o affami lo strumento o nutri il gemello, e nel mezzo non c’è granché da abitare. Il secondo è più scomodo: l’accumulo come difesa è a sua volta una trappola, i quindici anni di sapere implicito che ti proteggono sono anche quindici anni che non riesci a scalare, a trasferire, a lasciare andare senza sentirti scoperto. È la ragione per cui certi professionisti bravissimi restano piccoli a vita: tutto passa dalle loro mani perché il valore è nelle loro mani, e le mani sono due.

Custodire tutto quello che sai è una prigione con una bella vista. Che prendano è dato, avviene comunque. Quello su cui hai voce sono le condizioni in cui avviene la presa.

La domanda è dove gira il calcolo

Quelle condizioni si giocano su una parola che suona burocratica e invece è molto concreta: giurisdizione. La domanda utile riguarda dove avviene il calcolo, con quali termini, e se quei termini puoi revocarli. Il contenuto che riveli pesa meno del luogo in cui lo riveli.

Sull’accesso ai modelli di frontiera l’ho già chiamato permesso più che proprietà, guardando a un governo capace di spegnere un modello dall’oggi al domani. La stessa logica vale un piano più in basso, sul tuo mestiere. Un’impresa cognitiva che gira sull’infrastruttura di un altro è cognitiva solo nel nome, affitta la stanza in cui si conia la sua stessa intelligenza, e paga l’affitto in giudizio. Un affitto che sale da solo, perché più il modello diventa capace più la tua operatività dipende da lui, e la dipendenza non è mai un buon posto da cui trattare le condizioni.

La sovranità digitale riguarda il contenitore, non l’ansia sul contenuto. Far girare il modello dove le regole le metti tu è una forma di questo, però il principio viene prima dello strumento: chi decide la giurisdizione del calcolo decide anche chi, dentro l’organizzazione, può ancora dire di no.

Il gemello cognitivo lo costruiranno comunque, quella parte non è in discussione. Quello che decidi tu è se la stanza dove lo costruiscono è tua o presa in affitto, e lo decidi adesso, mentre il metodo è ancora tutto dentro di te e non ancora tutto dentro la macchina. Tra qualche mese la proporzione si sposta, e si sposta da sola.

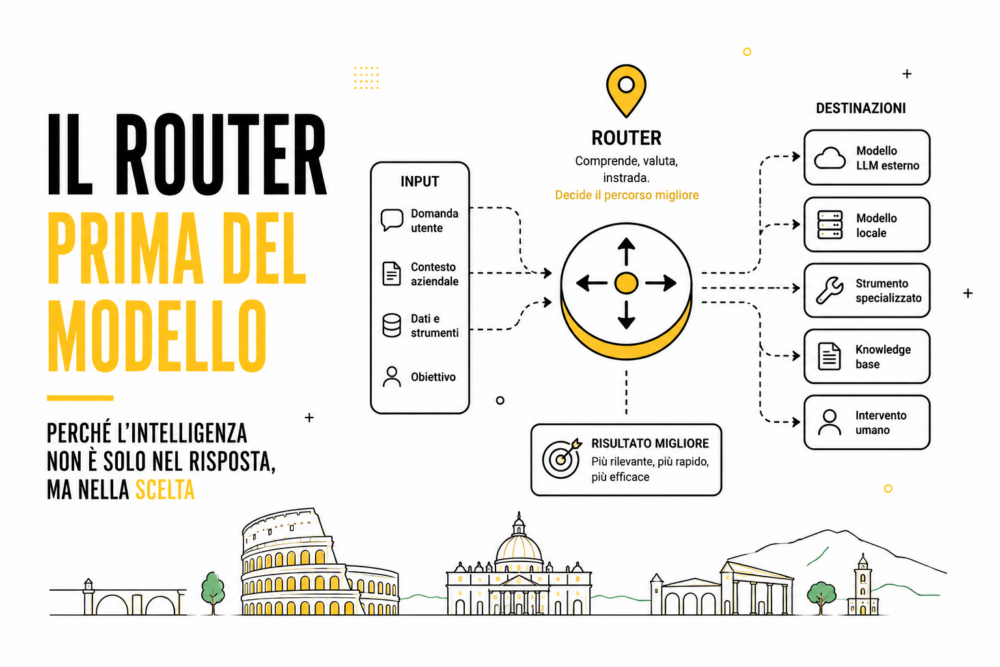
Model router: come funziona il middleware che smista le richieste AI

Tra l’applicazione e i modelli è comparsa una casella che diciotto mesi fa non esisteva. Si chiama model router, intercetta ogni richiesta e decide quale modello deve rispondere prima che la richiesta parta, e nel giro di pochi mesi ha sviluppato un mercato suo, con prodotti commerciali, progetti open source e paper accademici che se la contendono.

Il 2 luglio scrivevo che il router viene prima del modello, riprendendo un’osservazione di Tomasz Tunguz: la logica di instradamento, non il modello scelto per ultimo, determina costi, latenza e chi resta padrone dell’infrastruttura. Quel pezzo era la tesi. Questo è la mappa: come quella casella si costruisce dentro, chi la vende già pronta, e il vincolo che quasi nessuno disegna nel diagramma.

Regole scritte a mano, regole imparate

Le architetture di model router in circolazione si riducono a quattro famiglie, e conoscerle serve perché ognuna sposta il compromesso tra costo, latenza e qualità in un punto diverso.

La più semplice è quella euristica: regole fisse, parole chiave, lunghezza del prompt. Se la richiesta contiene una query SQL, va dritta a un modello da codice, senza che nessun classificatore si accenda. Costa niente e si spiega in una riga, e si rompe appena il traffico esce dai casi previsti da chi ha scritto le regole.

Il gradino successivo è il router appreso, un classificatore leggero, di solito su embedding, che predice quale modello renderà meglio su quella richiesta in base a valutazioni storiche. Qui la qualità del model router dipende interamente dalla qualità dei dati di valutazione con cui è stato addestrato, e questa dipendenza pesa più di qualunque scelta di algoritmo.

Poi ci sono le cascate, che rovesciano la logica: si prova prima il modello economico, un validatore controlla la risposta, e solo se il controllo fallisce la richiesta sale al modello più potente. E infine gli ensemble, dove più modelli lavorano in parallelo sulla stessa richiesta e un giudice algoritmico sintetizza o sceglie. La cascata ottimizza il costo accettando qualche giro in più di latenza, l’ensemble ottimizza la qualità accettando di pagare ogni risposta tre o quattro volte.

Il model router diventa un prodotto da scaffale

Fino a poco fa questa casella la scrivevi in casa. Adesso la compri. OpenRouter ha portato in produzione a giugno Fusion, la versione a scaffale dell’ensemble: la tua richiesta va a un pannello di modelli in parallelo e un giudice fonde le risposte. Sul benchmark di deep research DRACO di Perplexity, un pannello economico composto da Gemini 3 Flash, Kimi K2.6 e DeepSeek V4 Pro ha segnato 64,7%, sopra GPT-5.5 da solo (60,0%) e Opus 4.8 da solo (58,8%), a circa metà del costo della configurazione di punta. Il dato che trovo più istruttivo è un altro, sepolto nello stesso annuncio: fondere Opus 4.8 con sé stesso alza il punteggio da 58,8 a 65,5. È la sintesi a produrre valore, non solo la diversità dei modelli.

Sul versante dei router appresi, Not Diamond vende l’addestramento su misura: carichi i tuoi prompt, i modelli provati e i punteggi delle tue valutazioni, e ne esce un router calibrato sui tuoi criteri, comprese le regole di formattazione o le convenzioni di codice che nessun benchmark pubblico misura. Il prodotto, in pratica, è la trasformazione dei tuoi dati di valutazione in una politica di instradamento.

La via che resta in casa

Chi non vuole un intermediario tra sé e i modelli, per latenza o per riservatezza dei dati, ha alternative open source che nell’ultimo semestre sono maturate in fretta.

NadirClaw è un proxy locale compatibile con l’API OpenAI che parte da un’osservazione empirica: nelle sessioni di sviluppo assistito, il 60-70% dei prompt sono operazioni semplici, letture di file, formattazioni, domande brevi, e non hanno bisogno di un modello premium. Un classificatore su embedding decide in una decina di millisecondi, un motore di ottimizzazione sfronda schemi di strumenti gonfi e array ridondanti prima dell’invio, tagliando il peso in token dal 30 al 70%, e sui benchmark RouterArena il profilo a cascata predefinito segna 0,7358 riducendo la spesa API fino al 70%. Gira sulla tua macchina, con le tue chiavi, e nessuna piattaforma di mezzo può cambiarti le condizioni.

Il fronte accademico spinge un passo oltre. Agent-as-a-Router, il paper dietro il framework ACRouter, parte da una diagnosi precisa: i router statici falliscono per deficit di informazione, decidono una volta e non imparano mai dal risultato. La risposta è un ciclo continuo in cui un orchestratore leggero instrada la richiesta usando lo storico di prestazioni conservato in una memoria interna, e un verificatore valuta l’esito con metriche oggettive, i test unitari sul codice generato per esempio, riscrivendo il risultato nella memoria come esperienza. Il router accumula esperienza fondata sull’esecuzione reale, ed è la stessa architettura del ciclo notturno che descrivevo nel pezzo di luglio, formalizzata e messa alla prova contro modelli di frontiera.

Per chi lavora con l’inferenza dentro il perimetro aziendale, ed è il terreno su cui costruiamo LocalAI, questa famiglia di strumenti è quella che conta: il routing self-hosted è ciò che rende sostenibile l’ibrido, i modelli locali per la maggioranza del traffico, il cloud per ciò che lo giustifica davvero.

Funziona dove il risultato si può misurare

Tutte queste architetture, dalla cascata al ciclo di ACRouter, si reggono su un presupposto che i diagrammi non mostrano: che esista un segnale oggettivo per dire se una risposta è buona. Il codice passa i test o non li passa, il JSON rispetta lo schema o non lo rispetta, la stringa si estrae o no. Dove il segnale è binario, il validatore della cascata sa quando scalare, il verificatore sa cosa scrivere in memoria, e il router impara.

Dove il segnale non c’è, tutto l’impianto si affloscia. Valutare un testo di marketing, un brainstorming aperto, una sintesi il cui pregio è il taglio e non la correttezza: su questi compiti la verifica automatica è debole, e un model router che non sa distinguere una risposta buona da una mediocre instrada alla cieca, con in più il pedaggio di latenza che le catene a cascata e i cicli di validazione si portano dietro per costruzione. Il router aggiunge un premio di complessità allo stack, e non ripara la logica applicativa rotta o il prompting fatto male: sposta i compiti giusti sui modelli giusti, a condizione che qualcuno gli abbia insegnato a riconoscerli.

Il registro dei prompt vale più del modello

Resta la parte che riguarda chi decide, non chi implementa. Il panorama dei modelli cambia ogni settimana, i prezzi per token continuano a scendere, e qualunque scelta di modello fatta oggi sarà rivedibile tra un trimestre. Le due cose che invece restano, e si apprezzano nel tempo, sono i dataset di valutazione interni e lo storico dei prompt con i loro esiti. Sono il carburante di ogni model router appreso, di ogni cascata calibrata, di ogni memoria alla ACRouter, e nessun fornitore può venderteli perché descrivono il tuo lavoro, non il suo.

L’avevo scritto parlando del vantaggio che si accumula in memoria, e il routing ne è la dimostrazione infrastrutturale: un’organizzazione che non registra cosa ha chiesto ai modelli e come è andata non potrà mai instradare bene, con nessuno strumento, comprato o costruito. Il processo di valutazione viene prima del router, come il router viene prima del modello. E mentre l’AI bill shock spinge tutti a cercare la casella magica che abbatte il conto, i dati che servirebbero ad addestrare il vostro model router si stanno raccogliendo adesso, oppure non si stanno raccogliendo affatto. Chi li registra oggi, tra un anno instraderà sulla propria esperienza. Gli altri affitteranno quella di qualcun altro.


Riferimenti: OpenRouter, Surpassing Frontier Performance with Fusion; Zhou et al., Agent-as-a-Router: Agentic Model Routing for Coding Tasks (arXiv); NadirClaw su GitHub; Not Diamond.

AI bill shock: la bolletta dei token è arrivata, come previsto

Il conto è arrivato, e ha pure un nome. Da mesi, tra le chiamate con i clienti e i pezzi che scrivo, ripeto la stessa cosa: il costo dei token non è un dettaglio da smanettoni, è la prossima voce che finisce sul tavolo del CFO. A marzo lo scrivevo su AI4Business, parlando di governo economico dei token come disciplina ancora da costruire. A maggio, qui sul blog, mettevo per iscritto che sarebbe arrivato sotto forma di budget esplosi a fine mese.

Questa settimana CorCom lo ha chiamato AI bill shock, riprendendo un’analisi di Analysys Mason: la spesa a consumo per modelli generativi, Api e agenti autonomi rende i budget aziendali sempre meno prevedibili, al punto da riportare sul tavolo di molti CIO l’idea di possedere un pezzo della propria infrastruttura invece di affittarla sempre. I numeri sotto contano più del titolo. Il budget è solo la parte più visibile: sotto ci sono i dati, la compliance, il controllo dell’infrastruttura su cui gira la tua azienda.

300 aziende, un balzo del 500%

Tra aprile e maggio circa 300 aziende hanno sollevato la questione dei costi legati ai token durante le chiamate agli investitori sui risultati trimestrali, contro le 93 dello stesso periodo dell’anno precedente. Lo racconta AI4Business citando Paul Roetzer e Mike Kaput del Marketing AI Institute. La Royal Bank of Canada ha visto il proprio consumo di token salire del 500% in sei mesi. Cisco descrive i propri volumi come fuori da ogni norma conosciuta.

Amazon, Walmart, Uber, Cisco e Meta, secondo quanto riportato dal Financial Times e ripreso sempre da AI4Business, hanno già introdotto tetti di spesa o indicazioni più severe su quando vale davvero la pena accendere un modello. Uber ha fissato un tetto di 1.500 dollari al mese per dipendente dopo aver esaurito, già ad aprile, l’intero budget AI previsto per il 2026. Amazon ha spento la classifica interna che misurava quanto i dipendenti usassero l’AI, dopo aver scoperto che alcuni ingegneri facevano girare bot autonomi solo per scalare la graduatoria: è il fenomeno che va sotto il nome di tokenmaxxing, la corsa alla vanità mascherata da adozione.

A Workato, azienda da 1.300 dipendenti, la spesa è aumentata di sette volte in un solo giorno quando Anthropic ha spostato l’azienda su un pricing basato sui token, a maggio. Goldman Sachs Research stima che l’uso degli agenti possa moltiplicare per 24 il consumo di token entro il 2030. E sul mercato aperto dei modelli, secondo i dati di OpenRouter ripresi dal Financial Times, i modelli cinesi hanno già superato quelli americani per consumo di token: quando il prezzo diventa il primo criterio di scelta, a vincere è chi costa meno, non chi segna il punteggio più alto sui benchmark.

Il token non misura il lavoro fatto

Più del volume, a ingannare è la natura della metrica. I fornitori fanno pagare i token di output da due a cinque volte più di quelli di input, perché generare una risposta costa computazionalmente più che leggerla: il modello prevede una parola alla volta, in sequenza, mentre l’input lo processa in un solo passaggio. Due flussi di lavoro che sembrano identici per volume possono avere costi molto diversi a seconda di quanto testo producono rispetto a quanto ne ricevono, e quasi nessuna azienda, quando firma il contratto, ci pensa davvero. Un prompt di 1.500 parole, quasi 2mila token, che produce una sintesi di 600 parole, circa 800 token, costa già un paio di centesimi con un modello come Claude 3.5 Sonnet: sembra nulla, finché non lo moltiplichi per centinaia di richieste al giorno e per ogni team che nel frattempo ha acceso un proprio agente senza dirlo a nessuno.

Gli agenti aggravano la cosa, perché a ogni passaggio ritrasmettono l’intero contesto della conversazione: alla decima fase di un compito, il modello rilegge integralmente le prime nove. AI4Business fa un esempio concreto, quello di un assistente per il servizio clienti che accede a una base di conoscenza di 20mila token: per mille richieste al giorno, genera 20 milioni di token quotidiani solo per rileggere sempre gli stessi dati, circa 60 dollari al giorno spesi prima ancora di rispondere a un cliente vero. Se l’agente si blocca in un loop, o richiama più volte lo stesso strumento, il conto sale prima che qualcuno se ne accorga.

L’AI bill shock non è un problema di cassa

Affidare l’inferenza a un fornitore esterno porta con sé più di un conto a consumo: la sua politica dei prezzi, i suoi limiti di utilizzo, le sue scelte su dove vivono i tuoi dati, la sua libertà di cambiare le regole senza preavviso. Il pricing può cambiare le regole da un mese all’altro, come è successo a Workato quando Anthropic l’ha spostata su un modello a consumo. Un fornitore può introdurre un tetto di utilizzo che scopri solo quando lo tocchi, a metà di una sessione di lavoro, come raccontano diversi utenti citati da AI4Business. Un governo può spegnere l’accesso a un modello, come abbiamo visto succedere quest’anno. E quando arriva un audit di conformità, la domanda su dove sia passato un dato aziendale durante l’inferenza, su quale server, sotto quale giurisdizione, spesso non ha una risposta scritta da nessuna parte.

Bain, in un sondaggio su 951 aziende pubblicato a giugno, trova che quasi il 40% di chi ha misurato i risparmi da AI è rimasto sotto il 10%, contro un obiettivo dichiarato dell’11-20%. Michael Heric, uno degli autori della ricerca, spiega che per molte aziende il business case si ferma alla spesa in token e non arriva mai a contare i costi di data engineering, di governance, di conformità che le girano intorno. Il 90%, nonostante tutto, aumenta comunque il budget per l’anno prossimo, prova che nessuno ha ancora imparato a misurare il ritorno dell’AI con lo stesso rigore con cui ne misura il costo.

LocalAI lavora esattamente in questa direzione: porta l’inferenza dentro il perimetro dell’azienda invece di affittarla ogni mese da qualcun altro. I costi non spariscono: cambia chi li governa. Sai dove vivono i dati, sai quanto costa davvero un carico di lavoro perché lo possiedi, e nessuno può cambiarti il prezzo o il tetto di utilizzo a metà mese.

Dall’opex che non controlli al capex che scegli

Analysys Mason legge lo spostamento come l’ennesimo giro di un ciclo che l’informatica ha già visto: dal mainframe centralizzato ai minicomputer distribuiti, dal PC in rete al cloud che ricentralizza tutto, e ora l’AI che riapre la stessa domanda. Comprare calcolo come servizio o possederne una parte? Per chi ha volumi di inferenza stabili, la risposta pratica passa quasi sempre dall’ibrido: hardware proprio per i compiti che non hanno bisogno di un modello di frontiera, server dedicati o cloud privato per il resto, il cloud pubblico riservato a ciò che lo giustifica davvero.

Il TCO a tre anni tra cloud e on-premise, calcolato sui prezzi reali di Claude, GPT, Gemini e DeepSeek, conferma la stessa cosa: nella maggior parte degli scenari aziendali italiani l’on-premise vince con margine quando i volumi sono prevedibili, mentre il cloud resta la scelta giusta per i picchi occasionali e per chi parte da zero. La maggior parte del traffico di un’azienda, del resto, non ha bisogno del modello più caro: ha bisogno di un sistema che decida bene dove instradarlo. Quella logica di instradamento, non il modello scelto per ultimo, è ciò che decide chi resta padrone della propria infrastruttura.

Decide il board, non il reparto IT

Il sondaggio di Bain lo conferma da un altro lato: le aziende che centrano i risparmi attesi sono quelle che hanno trattato l’accesso ai dati, la governance e il ridisegno dei processi come materia da consiglio di amministrazione, non da reparto IT. Vale lo stesso per il bill shock. Un alert di budget o un tetto di spesa imposto dall’alto sposta il sintomo, non la causa.

La prima domanda, in questi casi, non riguarda mai il modello. Riguarda dove vivono i dati, chi decide quanto vale un’ora di inferenza, cosa succede se domani il fornitore cambia le regole: non cambia molto se l’azienda ha cinquanta o cinquemila dipendenti, cambia solo quanto in fretta un budget fuori controllo diventa un problema di tutti, non solo di chi ha acceso l’ultimo agente.

La bolletta continuerà a salire, per tutti. La differenza, da qui in avanti, la fa chi ha già deciso come governarla e chi la scoprirà solo a budget già bruciato.


Fonti: CorCom su Analysys Mason; AI4Business, “La crisi dei token che spaventa i budget aziendali”; AI4Business, “AI, le aziende frenano”; Bain & Company, Automation and AI Pathfinder Survey 2026.

L’Europa e l’AI di frontiera che non controlla

Il 7 luglio la Commissione europea ha presentato un Action Plan su cybersicurezza e intelligenza artificiale. A firmarlo è Henna Virkkunen, che nella nuova Commissione porta una delega dal nome esplicito, sovranità tecnologica, sicurezza e democrazia, e che ha messo in fila un ragionamento semplice, l’AI sta cambiando il significato stesso della sicurezza informatica e l’Europa deve tenere il passo alle vulnerabilità che le nuove tecnologie si portano dietro. Nelle settimane precedenti, a Bruxelles, si leggeva un fatto molto preciso: un modello di frontiera, il Mythos di Anthropic, aveva mostrato di saper individuare vulnerabilità nascoste nel software, e un governo straniero aveva deciso di limitarne l’accesso a chi non è cittadino americano.

Per anni l’Europa ha scritto regole per un’intelligenza artificiale che non costruisce. Questo piano è il primo documento che lo dice ad alta voce, con parole sue: le capacità di frontiera nascono per lo più fuori dai confini dell’Unione, e la loro disponibilità dipende da processi decisi altrove, spesso poco trasparenti. La cybersicurezza, letta così, non è un problema di adempimento, è un problema di sovranità digitale.

Una capacità di valutazione da costruire

La prima mossa concreta è una capacità europea di valutazione dei modelli, che la Commissione vuole creare nel 2027. Servirà a esaminare i modelli di frontiera prima che arrivino sul mercato, anche dal lato della sicurezza informatica, a sostegno del lavoro dell’AI Office, con criteri pubblici per i valutatori indipendenti che vorranno candidarsi.

Sotto l’annuncio c’è un’ammissione. Oggi l’Europa non riesce a valutare da sola i modelli che pretende di regolare. L’AI Act le ha dato il diritto di chiedere che quei modelli vengano esaminati, questo piano riconosce che le manca il muscolo per farlo in proprio.

Il primo pezzo di quel muscolo arriva prima. ENISA, l’agenzia dell’Unione per la cybersicurezza, e il Centro comune di ricerca costruiranno entro fine 2026 una piattaforma europea sicura per mettere alla prova i modelli in ambienti simulati, portando competenza sull’uso sicuro dell’AI agli operatori dei settori critici, dalla finanza alla sanità, dall’energia ai trasporti fino alla pubblica amministrazione.

Quando a decidere l’accesso è un altro

Qui il piano tocca il nervo scoperto. Le capacità di frontiera, scrive la Commissione, si sviluppano quasi tutte fuori dall’Unione, e chi le vuole usare dipende da processi decisi altrove. Conoscerle e potervi accedere non riguarda soltanto la resilienza informatica, riguarda la sovranità tecnologica di un continente.

L’episodio Mythos serve da promemoria. Un modello capace di trovare falle nascoste diventa un’arma se finisce nelle mani sbagliate, uno strumento di difesa se resta in quelle giuste, però la mano che decide chi può usarlo, in quel caso, stava a Washington e non a Bruxelles. È l’idea del permesso revocabile portata su scala geopolitica: quando il permesso di usare una capacità può essere ritirato da qualcun altro, dall’esterno, la tua sovranità sui processi che quella capacità protegge è presa in prestito.

Somiglia alla competenza presa in prestito di cui scrivevo a proposito del nostro rapporto quotidiano con questi modelli, solo che qui il prestito non tocca una singola persona che smette di saper fare una cosa, tocca la capacità di un’intera economia di difendere le proprie infrastrutture.

Dal codice condiviso alla vulnerabilità che resta scoperta

Il secondo pilastro guarda dentro le organizzazioni. Il piano non chiede di aspettare, chiede di usare da subito le capacità di AI già disponibili, compresi i modelli aperti, per trovare e correggere le vulnerabilità più in fretta di prima, e per reagire quando un attacco è già in corso. Da qui a fine 2026 ENISA pubblicherà linee guida e buone pratiche, e aprirà un progetto pilota sulla resilienza del software libero critico, pensato per accelerare la correzione delle falle con l’aiuto dell’AI.

Il codice aperto, in questo disegno, pesa più di una bandiera ideologica. Resta la sola capacità che un’organizzazione può ispezionare riga per riga e far girare sulle proprie macchine, senza chiedere permesso a nessuno e senza che nessuno la spenga da lontano. La stessa falla che un modello di frontiera straniero potrebbe scovare al posto tuo, oggi, un modello aperto che controlli tu può aiutarti a chiuderla domani.

La difesa prima della norma

C’è un contrasto che vale la pena guardare in faccia. Nelle stesse settimane in cui prepara questo piano, l’Europa rallenta il suo stesso codice: il 29 giugno il Consiglio ha dato il via libera definitivo alla semplificazione dell’AI Act, che sposta in avanti gli obblighi sui sistemi ad alto rischio, al dicembre 2027 per quelli autonomi e all’agosto 2028 per quelli dentro i prodotti.

Frenare la regola e costruire la difesa, allo stesso tempo, sembra una contraddizione e invece è una sola mossa. Il baricentro si sposta da ciò che vietiamo prima a ciò che sappiamo fare adesso, dalla conformità alla capacità. È l’ansia da competitività dei rapporti Draghi e Letta tradotta in atti di governo, e cambia il modo in cui un CIO dovrebbe leggere la politica europea sull’AI.

La lettura solo per adempimento non basta più. Ciò che pesa davvero, sui tavoli dove si decide, è lo stesso metro che vale con gli agenti: la reversibilità, cioè il controllo su runtime, contesto e permessi e la rapidità con cui puoi fermare un processo e riportarlo indietro senza danni.

Sovranità digitale, da iniziare adesso

Il piano, in filigrana, detta anche cosa fare senza aspettare né l’agenzia del 2027 né la sfida europea di fine anno. C’è l’igiene di base da rafforzare e la sicurezza da mettere fin dentro la progettazione, come le regole sulla cybersicurezza già chiedono. Conviene poi iniziare a usare i modelli disponibili, anche quelli aperti, per scovare e chiudere le vulnerabilità e per rispondere quando un attacco è già partito. Merita attenzione, da qui a fine anno, la piattaforma di ENISA per la sperimentazione dei modelli, con le linee guida che arriveranno tra il terzo e il quarto trimestre.

E la dipendenza da un singolo modello di frontiera controllato da un altro Stato va trattata per quello che è, un’esposizione nella catena di fornitura che una decisione presa altrove può accendere o spegnere da un giorno all’altro.

L’occasione, per chi in Europa costruisce sicurezza e AI nello stesso posto, prende una forma concreta. Bruxelles lancerà entro fine 2026 una sfida europea per le soluzioni di cybersicurezza basate sull’AI, e sta studiando con la Banca europea per gli investimenti uno strumento pubblico che finanzi i progetti strategici, la frontiera dell’AI compresa. Attorno a una capacità sovrana, che si possa ispezionare e valutare in casa, si sta formando un mercato.

Il piano costruisce la capacità di valutare i modelli e gli strumenti per difendere le reti, e sono due cose che all’Europa mancano da tempo. Resta però, sui tavoli dove lavoro, una domanda a cui non ho ancora una risposta netta: si può davvero essere sovrani su una capacità che non hai costruito e che non riesci a vedere fino in fondo? Finché la risposta non è chiara, la sovranità digitale somiglia più a un cantiere aperto che a un traguardo raggiunto.


Il documento è l’Action Plan on Cybersecurity and Artificial Intelligence presentato dalla Commissione europea il 7 luglio 2026, con il comunicato integrale della Commissione. La struttura in tre pilastri e le scadenze operative sono ricostruite dal servizio di Agence Europe. Il via libera definitivo alla semplificazione dell’AI Act è del Consiglio dell’UE, 29 giugno 2026.

Il router prima del modello

Il 1° luglio Tomasz Tunguz di Theory Ventures ha scritto una cosa semplice che quasi nessuno applica: la maggior parte dei team che costruisce agenti sceglie il modello per primo. Sbaglia ordine, e lo sbaglia sistematicamente, perché il modello è la decisione più visibile e quindi quella su cui si concentra tutta l’attenzione, mentre il pezzo che davvero determina costo e latenza resta invisibile: il router, cioè il codice che decide chi risponde a ogni singola richiesta.

Tunguz lo racconta riferendosi al modo in cui Coinbase ha dimezzato la spesa in AI mentre il consumo di token cresceva, non frenando gli ingegneri con alert di budget ma cambiando i default di instradamento. È un’osservazione operativa, non una teoria, e tocca qualcosa che seguo da mesi lavorando con LocalAI: la sovranità computazionale si gioca sull’architettura, molto più che sulla scelta del modello.

Tre problemi diversi, non uno

Classificatore, router e selettore vengono trattati come sinonimi, e non lo sono. Il classificatore riconosce l’intento: trasforma una richiesta grezza dell’utente in un’operazione concreta, riassumere un repository, scrivere una risposta, lanciare una migrazione. Il router legge quell’etichetta insieme a poche feature, complessità, dimensione del contesto, storico di successo, e decide su quale livello far girare l’operazione. Il selettore, infine, sceglie il modello più economico dentro quel livello che rispetta una soglia di confidenza.

Confonderli è comodo mentre si scrive il primo prototipo, e costa caro dopo: la scelta del modello finisce sepolta dentro il prompt, e diventa impossibile testare due modelli diversi sulla stessa operazione senza riscrivere mezzo sistema. È lo stesso errore di livello che ho descritto parlando dello stack verticale dell’AI: confondere i piani porta a decisioni prese al piano sbagliato.

Il locale è gratis, l’asincrono è economico, il tempo reale costa

E infatti è questa la parte che mi ha fatto fermare a rileggere. Il calcolo locale ha un costo marginale prossimo allo zero, il batch asincrono costa due ordini di grandezza meno dell’inferenza in tempo reale, e la parte di lavoro che ha davvero bisogno di una risposta immediata è sorprendentemente piccola, una volta che il sistema può accodare.

Una bozza di risposta, un riassunto di repository, un memo di due diligence, la valutazione notturna di un batch di tracce: nessuno di questi compiti pretende un secondo di risposta. Pretende di essere fatto bene, non subito.

Ho visto questa stessa dinamica dentro LocalAI, dove la maggioranza del traffico non tecnico regge tranquillamente su modelli piccoli fatti girare in locale, con il cloud che entra in scena solo quando il compito lo richiede davvero. Non è un compromesso al ribasso, è disegno.

Un ciclo che impara mentre dorme

Ecco, e qui il design descritto da Tunguz aggiunge un doppio ritmo di feedback che vale la pena isolare. Un predittore sincrono annota ogni richiesta in ingresso con cinque segnali di rischio, dal contesto di repository mancante alle catene di dipendenze troppo lunghe, fino alle scritture che possono avere conseguenze pesanti se sbagliate, e intercetta così i compiti già noti come difficili prima che falliscano.

Poi, ogni notte, un valutatore batch rilegge le tracce del giorno e aggiorna i pesi del router, mentre il costo di quella valutazione resta vicino allo zero perché gira anch’esso in modalità asincrona. Ed è lì che il sistema scopre i modi di fallire che il predittore non aveva ancora imparato a riconoscere.

Mi sembra la versione infrastrutturale di qualcosa che scrivo da tempo a proposito del vantaggio che un’organizzazione accumula in memoria, non in modello: un sistema che non ha un meccanismo per far rientrare l’esperienza di ieri nelle decisioni di oggi accumula lo stesso tipo di debito, che si parli di persone o di router. L’ho scritto anche a proposito del tokenmaxxing: quel che resta dopo la spesa pesa più del numero speso, che si tratti di token o di traffico instradato.

Da dove si comincia davvero

Nei progetti dove entro a lavorare sull’adozione dell’AI, il primo intervento quasi mai tocca il modello. Tocca l’inventario dei segnali di fallimento: quali richieste arrivano senza contesto sufficiente, quali toccano dati sensibili, quali scritture, se sbagliate, costano care da correggere. Prima si rende visibile quel rischio, poi si decide dove instradarlo.

È un lavoro lento e poco fotogenico rispetto a scegliere l’ultimo modello uscito, e proprio per questo tende a restare indietro nella lista delle priorità. Ma un router costruito senza quella mappa dei rischi impara a fatica, perché non sa cosa sta effettivamente evitando di rompere. Il ciclo notturno di cui scrive Tunguz funziona solo se qualcuno, all’inizio, ha scritto a mano la prima versione grezza di quella mappa.

Chi possiede la logica di instradamento

Se il novanta per cento del traffico può girare su modelli piccoli e locali, la dipendenza da un singolo fornitore cloud smette di essere un fatto tecnico e diventa una scelta di governance, quasi sempre presa per default e non per decisione consapevole.

Progettare intorno al routing, non intorno al modello, sposta il controllo esattamente lì: chi scrive la logica che manda il traffico da una parte o dall’altra decide, di fatto, chi resta padrone dell’infrastruttura. Nella maggior parte delle aziende che conosco quella logica non la possiede nessuno davvero: cresce dentro il notebook di un ingegnere, non dentro un comitato di governance. Ed è lì, non nel modello scelto per ultimo, che si decide chi dipende da chi.


Spunto: Tomasz Tunguz, General Partner at Theory Ventures.

Vendor lock-in AI: l’errore architetturale dei progetti enterprise

Conversazione vera, due settimane fa, con il CTO di un’azienda manifatturiera italiana medio-grande. Loro hanno un sistema AI in produzione da quattordici mesi, costruito sopra le API di OpenAI con function calling, prompt engineerizzati con cura, memoria conversazionale gestita in Pinecone, agente che orchestra cinque tool diversi. Funziona bene, gli utenti sono contenti, il management è soddisfatto. Mi chiama perché ha letto i miei articoli su AI privata e vuole capire se ha senso, per loro, valutare una migrazione verso un setup on-premise con modelli open-weight.

La mia risposta è stata: “Tecnicamente sì, però oggi la migrazione vi costa quanto rifare metà del prodotto da zero”. Lui ha avuto un momento di silenzio, poi ha chiesto: “Come è possibile? Usiamo l’API standard di OpenAI. Mi avevano detto che era portabile”. La risposta a quella domanda è il tema di questo articolo. È un fenomeno che chiamo “vendor lock-in tecnico AI“, e fa fallire più progetti AI enterprise di quanti se ne discutano apertamente.

Il debito tecnico che non si vede

Le aziende che costruiscono prodotti AI sopra API cloud accumulano un debito tecnico di portabilità che non emerge nei primi mesi. Funziona tutto, perché ogni provider rispetta il proprio contratto API. Però sotto la superficie, dozzine di scelte tecniche e operative legano profondamente il prodotto al provider specifico, in modi che diventano evidenti solo quando si prova a cambiare.

Vorrei elencare i punti di lock-in più ricorrenti, in ordine crescente di gravità.

System prompt engineerizzati per quirk specifici del modello. Ogni LLM ha le sue idiosincrasie. Claude reagisce a certe formulazioni in modo diverso da GPT-4. Gemini ha pattern di risposta tutti suoi. Mistral e Llama hanno default culturali diversi. Quando il vostro team di prodotto ha lavorato 6 mesi per perfezionare prompt che funzionano bene sul modello scelto, quei prompt non funzionano più allo stesso modo se cambiate modello. La migrazione richiede re-engineering completo, con cicli di test e regression.

Function calling con sintassi proprietaria. OpenAI ha introdotto il function calling con uno schema specifico. Anthropic ha il suo formato per i tool. Gemini ha un altro ancora. Anche se tutti sono “function calling”, il modo in cui passare gli schemi, gli argomenti, le risposte è leggermente diverso. Codice che orchestra agenti complessi con dieci tool diversi è ricco di queste specificità.

Embedding model legati al provider. Se avete fatto RAG con embeddings di OpenAI ada-002 o text-embedding-3-large, quei vettori non sono compatibili con embeddings di Cohere, Voyage, BGE. Per cambiare modello di embedding, dovete re-indicizzare tutto il corpus documentale, che su grandi volumi richiede tempo e costa risorse.

Vector database con schemi rigidi. Avete usato Pinecone con metadati strutturati in un certo modo, indici composti definiti, filtri configurati. Migrare a Qdrant, Weaviate o Milvus significa rifare lo schema, validare i risultati, magari riadattare le query applicative.

Memoria conversazionale tarata sul modello. I limiti di token, le strategie di summarization, le truncation policies, sono tutti calibrati sul modello specifico. Cambiando modello, la memoria si comporta diversamente, i contesti vengono troncati in modo diverso, le conversazioni perdono coerenza in punti diversi.

Monitoring e observability legati alle API. Avete configurato logging strutturato per le chiamate OpenAI con i loro request ID, latency metrics, cost tracking basato sui loro pricing tier. Cambiare provider significa rifare l’osservabilità.

Skills del team. Il vostro sviluppatore AI senior conosce profondamente l’API OpenAI dopo due anni di lavoro. Conosce le edge case, sa come reagire ai 429, ha intuizione per i prompt che funzionano. Su un provider nuovo, quella conoscenza è azzerata. Servono mesi di learning curve.

Sommato tutto, una migrazione fra provider AI cloud su un’applicazione in produzione di 12+ mesi richiede tipicamente 2-4 mesi di lavoro di team specializzato. Quei mesi sono pieni di rischio: i clienti si lamentano dei comportamenti diversi, qualità delle risposte temporaneamente peggiore, bug che emergono solo in produzione, costi che non rientrano nei piani.

L’astrazione che salva la vita architetturale

C’è una soluzione architetturale ben nota, e si chiama “abstraction layer”. L’idea è semplice: invece di chiamare direttamente le API del provider AI, fate passare ogni interazione attraverso un layer intermedio che espone un’interfaccia stabile compatibile (tipicamente compatibile con OpenAI, perché è lo standard de facto). Il layer si occupa di tradurre nel formato del provider specifico sottostante. Quando volete cambiare provider, cambiate solo il layer, non le applicazioni.

Sembra banale, ma poche aziende lo fanno bene. La maggior parte di quelle che ho visto in advisory ha un’astrazione “leggera” che gestisce solo il routing delle chiamate al LLM, ma non astrae le altre cinque-sei superfici di integrazione (embeddings, vector DB, memoria, tools, logging). Risultato: il giorno della migrazione, scoprono che l’astrazione copre solo il 30% del problema.

L’astrazione completa deve coprire sette superfici, e qui entra il valore di un orchestratore maturo come LocalAI.io, su cui ho investito personalmente come cofondatore.

1. Chat completions. LocalAI espone l’endpoint OpenAI-compatible standard, ci puntate il vostro codice esistente, e il modello sotto può essere Llama, Mistral, Qwen, DeepSeek o anche un OpenAI/Claude pass-through. Cambiate il modello dalla console, le applicazioni continuano a funzionare.

2. Embeddings. Stessa cosa per il modello di embedding. Esponete l’endpoint embedding-compatible OpenAI, dietro c’è il modello che decidete (bge-m3, multilingual-e5, OpenAI ada). Cambiate dietro senza toccare il codice.

3. Function calling. L’orchestratore unifica le specifiche function calling fra provider diversi, traducendo in tempo reale.

4. Vector database. Qui l’astrazione è più sottile: serve un layer applicativo (LangChain, LlamaIndex, o codice custom) che si interfacci con un’API generica di vector DB. Qdrant, Weaviate, Chroma hanno tutti adapter per le librerie principali.

5. Memoria conversazionale. Va gestita in un livello applicativo che non dipenda dal modello specifico. Esistono librerie come mem0 che fanno questo lavoro bene.

6. Monitoring. Centralizzato sull’orchestratore, non sui singoli provider. Tutto il logging passa per il layer, indipendentemente da chi sta servendo le richieste.

7. Cost tracking. Anche qui centralizzato. L’orchestratore conta i token, applica le sue policy di pricing, espone le metriche aggregate.

Con un’astrazione completa di queste sette superfici, una migrazione di provider AI può ridursi a un’ora di lavoro di reconfigurazione, invece di tre mesi di refactor. È una differenza che, su un’applicazione enterprise, si traduce in 50.000-200.000 euro risparmiati ogni volta che cambiate.

Quando vale la pena pagare il costo dell’astrazione

Una nota di onestà. L’abstraction layer ha un costo iniziale. Aggiunge una dipendenza al vostro stack, un piccolo overhead di latenza (5-30ms tipicamente), un componente in più da manutenere. Per startup che stanno facendo POC veloci, è probabilmente overkill, perché il rischio di voler cambiare provider entro 6 mesi è basso e gli investimenti accumulati sono minimi.

Per le aziende enterprise che stanno costruendo un sistema AI destinato a vivere 3-5 anni, l’astrazione vale praticamente sempre l’investimento. Tre situazioni dove l’astrazione è essenziale:

Quando il modello scelto oggi non sarà quello di fra 24 mesi. L’ecosistema AI evolve velocemente. Nel 2024 OpenAI dominava. Nel 2026 Claude, Gemini, Mistral, modelli open-weight sono tutti competitivi su task specifici. Nel 2028 lo scenario sarà ancora diverso. Un’azienda che si lega oggi a un singolo provider si trova a inseguire la concorrenza con due anni di ritardo.

Quando la compliance può cambiare. Una banca italiana che oggi usa Claude potrebbe domani avere requisiti che impongono di portare il modello in casa per AI Act o evoluzioni normative. Se ha un’astrazione, la migrazione è di una settimana. Se non ha, sono 4 mesi.

Quando vi serve usare modelli diversi per task diversi. L’approccio “best model per ogni task” sta diventando standard. Claude per scrittura, GPT per reasoning, DeepSeek per codice, Qwen per estrazione strutturata, Mistral per italiano fluente. Senza astrazione, dovete integrare 5 SDK diversi. Con astrazione, è un parametro nel routing.

L’errore tipico che vedo nei progetti AI enterprise

Per chiudere, vorrei raccontare il pattern di errore più frequente che vedo nei progetti AI enterprise che falliscono. Si svolge sempre nello stesso modo, in tre fasi.

Fase 1: prototipo veloce. Il team prodotto vuole muoversi rapidamente. Chiamano direttamente l’API OpenAI, fanno il POC in due settimane, lo presentano al management. Il management è entusiasta, dà luce verde a una versione di produzione. Decisione presa: usiamo OpenAI come fornitore principale.

Fase 2: produzione e accumulo. Nei 12-18 mesi successivi, il team costruisce features sopra features. System prompt sempre più sofisticati, function calling, RAG con Pinecone, agenti multi-step. Tutto su API OpenAI. Nessuno si pone il problema dell’astrazione perché funziona tutto bene.

Fase 3: il momento di verità. Arriva una di queste situazioni: i costi OpenAI superano i budget previsti, il management chiede di portare l’AI in casa per ragioni di sovranità o compliance, un competitor si vanta di prestazioni migliori con Claude e il management vuole switchare. A questo punto il team scopre che la migrazione costa 3-4 mesi di lavoro e mette a rischio il prodotto. Si rinvia. Si rinvia ancora. Poi qualcuno decide che è meglio non toccare niente, e l’azienda resta legata al provider scelto due anni prima, anche quando non è più la scelta migliore.

Quel pattern, per me, è la singola causa più frequente di stagnazione strategica nei progetti AI enterprise italiani. La soluzione non è tecnicamente difficile (un abstraction layer maturo si setta in due settimane). È una decisione architetturale da fare presto, prima che l’accumulo di lock-in la rende troppo costosa.

Tre azioni concrete per chi sta valutando ora

Per chi sta costruendo o ha appena messo in produzione un sistema AI enterprise, tre azioni che vale la pena valutare nei prossimi 30 giorni.

Audit del lock-in attuale. Mappare quali punti del vostro stack sono legati al provider AI specifico. System prompt, embeddings, function calling, vector DB, memoria, logging, expertise del team. Quantificare quanto tempo costerebbe oggi una migrazione totale a un provider diverso. Se la stima è oltre un mese di lavoro, avete un debito tecnico che vale la pena ridurre.

Introduzione progressiva dell’abstraction layer. Non serve un big-bang refactor. Si può introdurre un’astrazione progressivamente: cominciando dalle chat completions (l’80% del traffico tipico), poi embeddings, poi function calling. In 6-8 settimane è possibile arrivare a un’astrazione completa su un sistema esistente.

Test di portabilità periodici. Anche se non avete intenzione di cambiare provider oggi, fate un esercizio: ogni 6 mesi, provate a far girare una percentuale del traffico (5-10%) su un provider alternativo via l’abstraction layer. Misura due cose: la qualità delle risposte resta accettabile, e l’astrazione regge il routing. Se sì, siete davvero portabili. Se no, scoprite dove sono i punti deboli mentre i costi della migrazione sono ancora bassi.

Per chi vuole approfondire il setup di un’architettura AI sovrana basata su abstraction layer, ho scritto questa serie di articoli: GDPR e LLM, hardware locale, TCO on-premise, scelta del modello open-weight, AI Act checklist, installazione di LocalAI, cloud sovrano italiano. Insieme coprono lo stack completo. Per una conversazione specifica sul vostro contesto, c’è la pagina Advisory.

La domanda finale, quella che cambia il futuro architetturale del vostro sistema AI, è semplice. Se domani il provider che usate oggi raddoppiasse i prezzi, deprecasse il modello che vi serve, o cambiasse i termini commerciali in modo per voi inaccettabile, in quanto tempo sareste in grado di rispondere? Se la risposta è in mesi, avete un problema architetturale che vale la pena affrontare adesso, mentre la migrazione costa ancora poco.

Cloud sovrano italiano: PSN e AI nel 2026

Per chi non l’ha seguita da vicino, la storia del cloud sovrano italiano sembra un dossier infinito. Strategia Cloud Italia annunciata nel 2021, gara da 4,4 miliardi assegnata nel 2022, primi data center operativi a fine 2022, target intermedi PNRR raggiunti nel 2024, oltre 600 pubbliche amministrazioni aderenti a gennaio 2026. È stata una marcia lunga, con qualche zona d’ombra e diverse svolte. Però è arrivata da qualche parte. Nel 2026 il Polo Strategico Nazionale è un’infrastruttura operativa, con quattro data center attivi (Acilia e Pomezia nel Lazio, Rozzano e Santo Stefano Ticino in Lombardia), oltre 576 amministrazioni che lo usano in produzione, contratti che valgono complessivamente 3,6 miliardi di euro estesi fino al 2035.

Per chi si occupa di AI nelle aziende italiane, il PSN non è un argomento da convegno di settore. È diventato un fattore concreto che incide su almeno tre decisioni operative: dove possono girare i modelli AI delle amministrazioni pubbliche italiane, quali fornitori AI possono lavorare con PA e con grandi corporate strategici, e quali architetture AI private possono dirsi davvero “sovrane” per il mercato italiano. Provo a sciogliere il quadro per chi lavora in questi mercati e deve prendere decisioni informate.

Cosa è davvero il Polo Strategico Nazionale

Il PSN è il terzo pilastro della Strategia Cloud Italia, accanto al cloud pubblico qualificato (servizi cloud commerciali certificati per la PA) e al cloud delle amministrazioni stesse. È pensato per ospitare in sicurezza i dati e i servizi “critici e strategici” delle PA italiane, definizione che secondo le linee guida di ACN (Agenzia per la Cybersicurezza Nazionale) include sanità, fiscalità, giustizia, ordine pubblico, difesa, infrastrutture critiche, dati personali su larga scala.

L’infrastruttura è gestita da una società consortile che vede insieme TIM Enterprise (capofila), Leonardo, Cassa Depositi e Prestiti, Sogei. È una struttura mista pubblico-privato che opera sotto vigilanza del Dipartimento per la Trasformazione Digitale e di ACN. Tecnicamente, il PSN offre un’infrastruttura multicloud che integra capacità proprie con quelle di hyperscaler internazionali (AWS, Google Cloud, Microsoft Azure, Oracle) ma con il vincolo critico che i dati sensibili restino fisicamente sul territorio italiano e gestiti da personale italiano sotto giurisdizione italiana.

A gennaio 2026 il PSN ha superato la sua principale milestone PNRR con oltre 600 amministrazioni aderenti, contro le previsioni iniziali del piano economico-finanziario originario. Il target per giugno 2026 è arrivare a 280 PA con migrazioni complete in corso, e una finestra ulteriore di adesione resta aperta fino a febbraio 2027. Numeri che dicono che il progetto è uscito dalla fase di startup e sta entrando in fase di consolidamento.

Perché conta per le aziende che fanno AI

Il PSN non è “solo” un’infrastruttura PA. È un mercato regolato che oggi vale 3,6 miliardi su 13 anni, ed è il canale obbligato per chiunque voglia vendere AI a una pubblica amministrazione italiana sui dati critici o strategici. Tre conseguenze pratiche per le aziende.

Il fornitore AI deve essere qualificato PSN. Se sviluppate una soluzione AI per la sanità pubblica, per l’amministrazione finanziaria, per la giustizia, l’erogazione deve girare in PSN. Significa avere processi di qualificazione, certificazioni di sicurezza, infrastruttura che si integra con lo stack PSN, conformità con le linee guida di ACN. Per startup AI italiane, è una barriera all’ingresso seria. Per chi la supera, è anche una protezione competitiva: i fornitori americani devono ricostruirsi una posizione che voi avete già naturalmente.

Il modello AI deve essere on-premise o in cloud sovrano. Sui dati PSN non possono girare API ChatGPT o Claude. Devono girare modelli che insistono sull’infrastruttura italiana, sotto controllo italiano. Questo apre uno spazio commerciale enorme per soluzioni AI private italiane basate su modelli open-weight (Llama, Mistral, Qwen) installati dentro perimetro PSN. È esattamente il ruolo che soluzioni come LocalAI possono giocare quando sono ben integrate con lo stack PSN.

La data residency cinese o americana è esclusa. Modelli ospitati su server Alibaba in Cina o su AWS regioni americane non passano la qualificazione PSN. Modelli open-weight che girano su infrastruttura italiana, anche se sono Qwen o Llama scaricati gratuitamente, sì. La distinzione è importante: il PSN non vieta i modelli stranieri come tali, vieta il loro hosting su infrastruttura non sovrana.

Cosa significa per il mercato AI italiano nei prossimi 18 mesi

Tre dinamiche operative che vedo emergere già adesso e che dovrebbero accelerare nei prossimi 18 mesi.

Concentrazione di valore sulle aziende AI italiane qualificate. I prossimi bandi PA su AI (assistenza al cittadino, automazione processi amministrativi, gestione documentale, analisi dati epidemiologici) faranno largo riferimento a fornitori qualificati PSN. Le aziende che hanno fatto il percorso di qualificazione raccoglieranno la quasi totalità del mercato PA italiano AI nei prossimi 3-5 anni.

Spinta su soluzioni open-weight italiane. Visto che gli LLM cloud americani sono di fatto esclusi dai progetti PA strategici, l’unica alternativa praticabile sono modelli open-weight gestiti dentro perimetro italiano. Questo crea pressione per stack tecnologici italiani capaci di gestire l’intera filiera, dall’hardware al modello all’orchestrazione. È esattamente l’opportunità su cui aziende come LocalAI stanno costruendo offerta dedicata al mercato italiano.

Effetto traino sul settore privato regolato. Anche se PSN nasce per la PA, le sue logiche di sovranità si stanno propagando ai settori privati regolati. Banche italiane di medie dimensioni stanno cominciando a chiedere ai propri fornitori AI le stesse garanzie di sovranità tecnica che la PA pretende dal PSN. Aziende sanitarie private adottano linee guida di data residency simili. La normativa AI Act, in vigore dal 2 agosto 2026, accelera questa convergenza fra requisiti PA e requisiti enterprise sensibile.

La banca italiana che ha cambiato approccio

Vorrei raccontare una scena reale recente. Lavoro nel 2025 con una banca italiana di medie dimensioni che sta valutando una RFP per un sistema AI di gestione documentale. Tre fornitori in gara: uno italiano con stack open-weight su infrastruttura italiana, uno americano con LLM cloud OpenAI, uno europeo con LLM cloud Mistral in Francia. Il responsabile compliance, dopo aver letto le tre proposte, fa un’osservazione che spiazza il comitato: “Il fornitore italiano costa il 30% in più. Però se domani vogliamo chiedere un parere alla Banca d’Italia sui nostri sistemi AI, possiamo dire che girano su infrastruttura italiana sotto controllo italiano. Con gli altri due, dobbiamo spiegare perché abbiamo accettato un trasferimento dati di fatto, anche se contrattualmente protetto”.

Il fornitore italiano vince. Non sul prezzo, non sulle prestazioni tecniche, ma sull’argomento sovranità che è entrato nei criteri di valutazione. È un esempio puntuale, ma rappresenta una direzione che vedo emergere in modo trasversale nei settori regolati italiani.

Cosa fare se siete una software house italiana

Per le aziende italiane che fanno o vogliono fare AI per la PA o per i settori regolati, ci sono quattro azioni operative che vale la pena pianificare adesso.

Qualificazione PSN. Avviare il percorso di qualificazione, anche se al momento il vostro prodotto AI non è ancora pronto per la PA. La qualificazione richiede tempo (6-18 mesi) e ha costi non trascurabili. Cominciare con anticipo dà un vantaggio competitivo strutturale.

Stack AI sovrano. Costruire la propria offerta AI sopra modelli open-weight (Llama, Mistral, Qwen) gestiti con orchestratori open-source come LocalAI.io. Evitare di costruire prodotti rigidamente legati a OpenAI o Anthropic, perché chiudono porte preziose sul mercato PA e regolato italiano.

Partnership con i grandi player PSN. TIM Enterprise, Leonardo, Sogei, Cassa Depositi e Prestiti sono i grandi player dell’ecosistema. Costruire relazioni commerciali strutturate con loro è la strada più diretta per arrivare nel canale PA.

Posizionamento di marketing chiaro. Comunicare in modo esplicito che la vostra soluzione è “sovrana italiana”, che gira su infrastruttura italiana, che usa modelli che possono essere documentati e auditati. È un argomento di vendita forte oggi, lo sarà ancora di più nei prossimi 24 mesi.

Il punto di equilibrio fra sovranità e pragmatismo

Una nota di realismo. Il cloud sovrano italiano non significa rinunciare alle migliori tecnologie globali. Significa avere la capacità di scegliere quali tecnologie portare in casa, e di farle girare sotto giurisdizione italiana. Mistral è francese, Llama è americano, Qwen è cinese, ma se li usate in versione open-weight nella vostra infrastruttura italiana, state usando tecnologia globale dentro un perimetro sovrano. È la differenza importante che spesso si perde nei dibattiti politici.

Il PSN, per come è costruito, riflette questa logica equilibrata. Non vieta gli hyperscaler globali (AWS, Google Cloud, Microsoft Azure, Oracle sono partner dell’infrastruttura multicloud). Vieta che i dati sensibili italiani siano gestiti da soggetti che non sono sotto giurisdizione italiana. È una differenza tecnica e giuridica importante.

Per le aziende che fanno AI sul mercato italiano, è il punto di equilibrio da capire bene. Costruire la propria offerta AI come “italiana ma globale” è il posizionamento vincente per i prossimi anni: tecnologie aperte e best-of-breed, integrate in un’architettura che ne mantiene il controllo sul territorio italiano.

Per chi sta avviando questo percorso, ho scritto questa serie di articoli che coprono gli aspetti complementari: GDPR e LLM, hardware locale, TCO on-premise, scelta del modello open-weight, AI Act checklist, installazione di LocalAI. Insieme coprono lo stack completo di decisione per chi vuole costruire AI privata sovrana italiana. Per una conversazione specifica sul vostro contesto, c’è la pagina Advisory.

La domanda finale da portarsi nei prossimi mesi è semplice. Se domani il vostro maggior cliente fosse una pubblica amministrazione italiana o una grande corporate regolata, sareste in grado di rispondere alla loro RFP con un’offerta AI tecnicamente competitiva, ma anche giuridicamente sovrana? Se la risposta è no, c’è una decisione architettura da prendere adesso, prima che lo facciano i vostri concorrenti italiani più veloci.