Maledetto AI slop

Arrivo alla fine del secondo paragrafo e mi accorgo che sto ancora aspettando. Il testo è scritto bene, le transizioni sono al posto giusto, i paragrafi hanno tutti la stessa lunghezza cortese, non c’è un refuso, e non c’è una riga che qualcuno abbia voluto scrivere. Chiudo la pagina e dopo dieci secondi non saprei ricordarmene una parte né ripeterne i concetti.

In inglese la parola l’hanno trovata, ed è brutta apposta. Slop è la broda di scarti e avanzi che si versa ai maiali, riciclata sul modello di spam per indicare i testi prodotti in serie dai modelli. E AI slop si è attaccato subito perché descrive la consistenza prima del contenuto: qualcosa di uniforme, versato, senza pezzi riconoscibili e autentici dentro. Della metà che riguarda chi scrive, cioè della voce che si perde un aggettivo alla volta, ho già detto la mia. Qui mi interessa l’altra metà: chi legge, chi paga il conto e chi mette la firma sotto al pezzo.

Un testo scritto senza un giudizio

L’AI slop non si riconosce dagli errori, perché di errori spesso non ne ha. Anzi, se ci fossero degli errori forse sarebbe umano. Si riconosce dal fatto che, tolta la superficie, quella delle parole ben strutturate e delle frasi ben formattate, dentro non c’è nessun giudizio, nessuna idea che qualcuno abbia sentito come propria, e nessun punto in cui l’autore avrebbe potuto sbagliare.

Un testo scritto da qualcuno porta con sé i segni di quello che ha buttato via (le scelte di non dire cose, per capirci), e il segno più affidabile è l’obiezione rimasta dentro senza risposta, quella che l’autore non sapeva chiudere e non se l’è sentita di far sparire. Lo slop di obiezioni aperte non ne ha. Non ha rinunciato a niente, dice tutto il dicibile sull’argomento, e lascia chi legge esattamente dove l’ha preso.

Per questo supera i controlli di qualità: la leggibilità è alta e i fatti a volte sono pure giusti. Manca la ragione per cui quel testo esisteva.

Nessuno si sveglia la mattina con l’intenzione di produrre slop

Il modello fa esattamente quello per cui è costruito: la continuazione più probabile, poi limata per piacere a chi legge. Il risultato ha una forma precisa, simmetrica, chiusa bene, e quella forma è la media di tutto ciò che era già stato scritto sull’argomento. I tic che ormai riconosciamo tutti, il trattino lungo, le frasi che pesano tutte dodici parole, le triadi che suonano incisive, le chiusure che riassumono il paragrafo appena letto, sono l’impronta di quella media.

C’è però una causa che pesa più del modello, ed è l’incentivo di chi pubblica. Produrre un testo è passato da ore a secondi, la pressione a pubblicare è rimasta identica, anzi è cresciuta, perché il calendario editoriale, il posizionamento, la presenza sui canali chiedono volume e il volume adesso è gratis. Per secoli la quantità di testo è stata una misura indiretta della fatica di qualcuno, e quella misura ha smesso di funzionare in diciotto mesi.

Poi c’è l’ultimo anello: la catena che andava dall’autore al lettore aveva in mezzo qualcuno che leggeva prima. Un direttore, o anche solo il collega scocciato che ti diceva che non si capiva niente. Quella figura è saltata quasi ovunque, e il primo lettore di gran parte di quello che circola è il destinatario finale.

Scriverlo costa zero, leggerlo costa come prima

La lettura è ferma dov’era. Duecento parole al minuto scarse, un limite che nessun aggiornamento software sposta, e un’attenzione che rimane la risorsa più rigida che abbiamo.

L’economista George Akerlof, nel 1970, descrisse il mercato delle auto usate: quando il compratore non riesce a distinguere prima dell’acquisto un’auto buona da un bidone, offre a tutti un prezzo medio, i venditori onesti si ritirano perché quel prezzo non copre la qualità, e sul mercato sopravvivono i bidoni. Vinse un Nobel per aver spiegato come l’asimmetria informativa distrugga un mercato dall’interno.

Con i testi il prezzo è l’attenzione. Il lettore che si è preso tre fregature di fila abbassa l’offerta su tutti, comincia a scorrere invece di leggere, e apre ogni pagina con una domanda in sottofondo che riguarda chi l’ha scritta. Il sospetto diventa l’impostazione predefinita, e i primi a pagarlo sono i testi onesti, che adesso devono dimostrare di esserlo prima ancora di essere letti.

C’è un secondo giro, più lento e più preoccupante. I modelli imparano da ciò che trovano scritto in giro, e ciò che trovano scritto in giro è prodotto in quota crescente da altri modelli. Fotocopia di fotocopia: ogni passaggio perde le code della distribuzione, cioè le voci rare, gli usi strani, le formulazioni che nessun altro avrebbe scelto. Stiamo dando in pasto ai modelli la loro stessa broda.

L’AI slop dentro i documenti che decidono

Fuori dal feed la faccenda si fa seria. In azienda i testi non servono a intrattenere, servono a far prendere decisioni, e la forma tipica è la nota di quattro pagine che circola il giorno prima di un consiglio, quando nessuno ha più il tempo di verificarla.

Un documento generato ha la forma dell’analisi, con il linguaggio di chi i dati li ha guardati davvero e la cautela messa nei punti in cui serve cautela. Il rischio grosso non arriva dall’errore fattuale, che prima o poi qualcuno scopre, arriva dalla fluidità che copre l’assenza di ragionamento, perché un testo che scorre bene viene approvato più in fretta di uno che inciampa e obbliga a fermarsi.

E poi c’è la domanda che faccio sempre quando mi trovo davanti a un documento del genere: chi risponde di questa frase, se tra otto mesi si rivela sbagliata? Nei sistemi con più agenti che lavorano insieme la questione è la stessa, e l’ho già affrontata parlando di chi decide quando due agenti non sono d’accordo: il criterio che nessuno ha messo per iscritto finisce comunque dentro il processo, solo che nessuno l’ha deliberato.

Le organizzazioni che riempiono di AI slop la propria documentazione accumulano debito cognitivo. Producono più pagine di quante ne sappiano difendere, e il conto arriva quando qualcuno le contesta, di solito in una due diligence o davanti a un’autorità. Vale anche qui la regola del mercato dei bidoni, applicata all’interno: quando i lettori interni smettono di distinguere i documenti che contengono lavoro da quelli che contengono forma, smettono di leggerli sul serio, e la produzione documentale diventa un rito.

Superare l’audit e non dire niente

Ogni cosa che pubblico passa da uno script che conta i trattini lunghi, le triadi, le frasi tutte della stessa misura, le formule che fingono sincerità. Lo uso da mesi e ho imparato una cosa che all’inizio mi ha infastidito: serve meno di quanto pensassi.

Un testo può superare l’audit e continuare a essere slop. I tic sono l’impronta digitale, il reato è un altro. Togli i trattini, spezzi le simmetrie, allunghi due periodi e accorci gli altri, e ottieni un testo medio travestito da testo personale. È lavaggio, e se ne vede sempre di più, perché la caccia ai tic è diventata a sua volta un prompt.

L’unica verifica che non si automatizza è anche la più scomoda, e consiste nel chiedersi cosa si è tolto: quale frase, tra quelle che il modello aveva proposto e che suonavano bene, è stata buttata perché non ci credevo. Se la risposta è nessuna, quel testo è slop anche con lo script a zero, e il fatto che sia gradevole peggiora la situazione invece di migliorarla.

L’ordine in cui si fanno le cose

Lavoro con questi strumenti tutti i giorni e non ho nessuna intenzione di smettere, quindi la domanda pratica diventa dove metterli nella sequenza. La differenza tra un pezzo mio e uno slop sta quasi tutta lì, nell’ordine delle operazioni, molto più che nella quantità di AI che c’è dentro.

Prima la tesi. Non apro la chat per scoprire cosa penso di un argomento, ci arrivo con una frase che sono disposto a difendere, anche brutta, anche mal messa. Se quella frase manca, il modello riempirà il vuoto con la media di ciò che esiste, e la riconoscerò tardi.

Poi il modello come avversario. Gli chiedo dove ho torto e quale obiezione mi farebbe la persona più competente della stanza. Usato come ghostwriter produce slop, usato come sparring partner mi tira fuori obiezioni che da solo non mi sarei fatto, e quelle obiezioni cambiano il pezzo.

Delego volentieri la fatica meccanica, la ricerca, la verifica, il riordino. Tengo l’attrito nel punto in cui si decide cosa entra e cosa esce, perché è lì che si forma il giudizio, e un modello, di sua iniziativa, non toglie mai niente: aggiunge sempre. Scriviamo con le stesse parole con cui pensiamo, e la pelle digitale tra noi e le macchine si forma lì, molto prima che in qualsiasi interfaccia.

Alla fine metto il nome sotto. Prima di pubblicare mi chiedo se difenderei quel testo in una stanza con dieci persone che ne sanno più di me, e se la risposta è no lo riscrivo o lo butto. Non è un problema di stile, è un problema di responsabilità: lo slop è quello che resta sulla pagina quando nessuno se ne assume nessuna.

Per secoli un testo ben fatto costava tempo, e proprio per questo funzionava come segnale di competenza. Adesso costa niente e non segnala più niente, il che spiega perché tanti mestieri che si reggevano su quel segnale si sentano il pavimento cedere sotto.

Akerlof indicava anche la via d’uscita dal mercato dei bidoni, e non passava dalla capacità del compratore di riconoscere la merce buona: passava dalla garanzia, cioè da qualcuno che accetta di rispondere del prodotto anche dopo averlo venduto. Vale per le auto usate e vale per i testi. La cosa scarsa, da qui in avanti, sarà qualcuno disposto a mettere la faccia sotto una frase e a risponderne quando viene contestata. Le aziende che avranno tenuto in casa persone capaci di scrivere una pagina difendibile scopriranno di avere un vantaggio che non avevano messo a bilancio, e lo scopriranno nel momento peggiore, che è sempre quello in cui i vantaggi si contano.
Chi delega all’AI il proprio lavoro

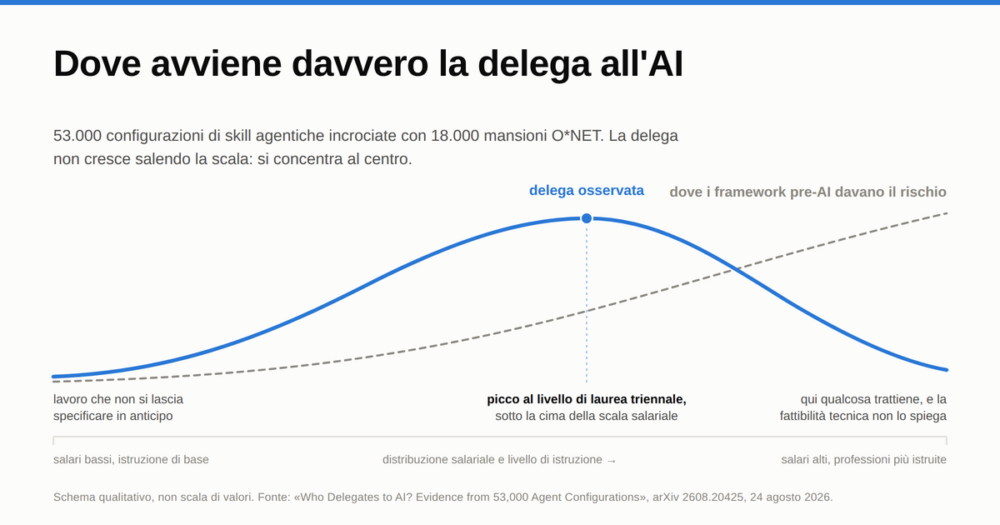
Il 24 agosto è comparso su arXiv il primo tentativo serio di misurare la delega di lavoro all’AI dal lato di chi la compie: 53.000 specifiche di skill prese dal marketplace di Manus, incrociate con circa 18.000 descrizioni di mansione dell’O*NET americano, per ricavarne quella che gli autori chiamano esposizione delegata. La domanda che si sono posti è diversa da quella su cui abbiamo costruito due anni di grafici, perché invece di stimare quanto una professione potrebbe essere svolta da un modello hanno contato quanti gesti chi quel mestiere lo fa davvero abbia già scritto dentro una routine automatica, e lasciato andare.

Sembra una sfumatura, e sposta quasi per intero l’elenco di chi dovrebbe preoccuparsi.

L’esposizione delegata come misura

Le mappe dell’esposizione all’AI che circolano dal 2023 misurano una capacità teorica, e lo fanno con un metodo ragionevole: si prende la descrizione di un compito, si valuta se un modello saprebbe eseguirlo, si aggrega per professione. Il risultato è una fotografia di quello che potrebbe accadere, costruita da chi guarda il lavoro da fuori.

Il marketplace di Manus è un’altra cosa. È un posto dove le persone pubblicano le configurazioni che hanno costruito per farsi fare il lavoro, e ogni skill caricata è un pezzo di mestiere che qualcuno ha ritenuto abbastanza stabile da poterlo descrivere una volta sola e riusarlo. Chi la carica non sta rispondendo a un questionario, sta risolvendo un problema che ha. Gli autori hanno preso quelle configurazioni, le hanno rappresentate in uno spazio semantico, e hanno misurato quanto le mansioni di ciascuna professione somiglino alle routine che i praticanti si sono già costruiti.

Quello che ne esce assomiglia molto più a un registro di quello che è già successo che a una previsione su quello che accadrà.

Dal potenziale al gesto registrato

Il primo risultato che gli autori mettono in fila è che le professioni dove la delega si concentra sono nettamente diverse da quelle che i framework pre-AI indicavano come più a rischio. Il secondo è che l’indice della delega segue più da vicino quello che l’AI saprebbe fare rispetto a quello che i lavoratori ne fanno oggi, il che vuol dire che c’è uno spazio aperto tra il possibile e l’adottato, e che quello spazio non si chiude da solo.

Il terzo è quello che mi ha tenuto sveglio. La delega sale verso il centro della distribuzione salariale e al livello di laurea triennale, poi scende ai due estremi. Scende in basso, dove il lavoro è manuale o troppo variabile per essere specificato in anticipo, e questo era prevedibile. Scende anche in alto, dove ci sono le professioni che tutti indicavano come le prime a essere riscritte, e questo non lo era.

La disponibilità tecnica, scrivono gli autori, spiega gran parte della variazione ma non il deficit tra le occupazioni più istruite. Qualcosa lì trattiene.

Dove la delega si ferma

Gli autori lasciano due ipotesi aperte, senza sceglierne una: lavoro che resiste alla specificazione anticipata, oppure discrezionalità professionale sul ritmo con cui il proprio mestiere viene codificato.

La prima è un limite tecnico, e i limiti tecnici hanno la brutta abitudine di cadere. Se un avvocato senior non delega perché la sua parte di lavoro non si lascia scrivere in una specifica, allora è questione di tempo, di finestre di contesto più lunghe, di modelli che tollerano meglio l’ambiguità di un incarico mal posto. La seconda ipotesi descrive invece una posizione, presa e tenuta, e implica che ci sia una categoria di persone che ha capito che scrivere il proprio criterio dentro una configurazione riusabile equivale a consegnarlo, e che ha deciso quanto e quando.

In Pelle Digitale avevo provato a descrivere la superficie di contatto tra noi e le macchine come il punto in cui si decide cosa passa e cosa resta, e mi rendo conto adesso che l’avevo pensata come una scelta individuale e istantanea, mentre qui la vedo funzionare come una scelta di categoria, lenta, forse nemmeno del tutto consapevole.

Il criterio che si scrive una volta sola

A luglio avevo scritto che il gemello cognitivo lo addestri tu, e l’argomento era che correggendo il modello gli trasferisci il criterio che ci hai messo quindici anni a costruire, mentre lui lo esporta a chiunque e tu intanto ti disalleni. Quel pezzo l’avevo scritto sulla correzione, che è un gesto quotidiano e distratto. La skill caricata su un marketplace è la stessa cosa fatta con intenzione, messa per iscritto, versionata, e resa disponibile a un numero indefinito di persone che non hanno fatto il percorso per arrivarci.

Chi delega in questo modo sta facendo la cosa più razionale del mondo dal punto di vista della propria produttività questa settimana. Sta anche pubblicando la parte trasferibile del proprio mestiere, gratis, in un posto dove viene indicizzata.

Le 53.000 skill che i ricercatori hanno analizzato sono, viste da questa angolazione, il più grande esercizio collettivo di documentazione del lavoro qualificato mai fatto, e nessuno lo sta chiamando così.

Chi si sottrae, e per quanto

Resta la domanda su cosa fare di questa informazione, e non ho una risposta pulita.

Da un lato la riluttanza delle professioni più istruite è difendibile e la capisco: c’è un valore reale nel non rendere esplicito tutto quello che sai, e chi consiglia le aziende su questi temi lo tocca con mano ogni volta che un cliente chiede il documento invece della conversazione. Dall’altro lato la stessa riluttanza somiglia molto a quella delle categorie che negli anni Novanta si sono difese dal digitale non digitalizzandosi, e sappiamo tutti come è finita quella storia.

Su questo avevo già toccato il tema della riconfigurazione delle competenze partendo dalla scuola, e mi accorgo che avevo trattato la questione come un problema di formazione delle nuove generazioni, quando questi dati la spostano su chi il mestiere ce l’ha già.

C’è una terza possibilità che il paper non nomina e che a me sembra la più probabile, ed è che le professioni in alto non stiano scegliendo affatto, ma semplicemente non abbiano ancora incontrato lo strumento nella forma in cui lo userebbero, perché i marketplace di skill sono costruiti da sviluppatori per sviluppatori e un notaio o un primario non ci passa. Se è così, il dato che oggi leggiamo come discrezionalità professionale è solo un ritardo di distribuzione, e la delega si riempirà dall’alto nei prossimi diciotto mesi.

Gli autori chiudono dicendo che distinguere tra le due ipotesi richiederà misurazioni ripetute nel tempo. Hanno ragione, e vale la pena rifare questo conto tra sei mesi, perché sarà la prima volta che potremo osservare una categoria professionale decidere in diretta quanto di sé mettere per iscritto.


Il paper è Who Delegates to AI? Evidence from 53,000 Agent Configurations, pubblicato su arXiv il 24 agosto 2026.

Il gemello cognitivo lo addestri tu

Alla terza volta esce giusta. L’hai corretto due volte, gli hai detto che quel cliente vuole una cosa e non un’altra, che in quel contesto non si apre mai dal prezzo, che una proposta senza un certo paragrafo non regge. Al terzo tentativo la risposta è esattamente quella che avresti scritto tu, e ti senti efficiente. In quell’istante qualcosa è passato da te al modello, e non era la risposta.

Quello che è passato è la correzione, il motivo per cui hai scartato le prime due, il gusto con cui hai riconosciuto quella buona, la riga che con un cliente non superi. Ci hai messo quindici anni a costruirla, l’hai consegnata in tre scambi.

Il mestiere passa nella correzione

Il modello non impara dalla tua risposta giusta, impara dai tuoi no. La distanza tra quello che ha prodotto e quello che gli hai fatto riscrivere è il segnale più prezioso che gli puoi dare, perché è lì che vive il giudizio, e il giudizio è la parte di te che non trovi scritta da nessuna parte, quella che negli anni ha smesso di essere una regola ed è diventata un istinto.

Sui gemelli digitali ho scritto altrove, pensando ad avatar e identità sintetiche. Questo gemello è più intimo: riproduce un criterio. Chiamiamolo gemello cognitivo. Il modello pubblico ne costruisce uno del tuo modo di decidere a partire dall’attrito, dalle volte in cui gli dici che ha sbagliato e soprattutto perché. A pesare è la sequenza di scelte che ti ha portato a quel documento e non a un altro, la cosa che ti chiede di rendere esplicita a ogni passaggio. I documenti in sé li ha già visti a milioni.

Un clone che non dimentica niente

Un collaboratore giovane impara guardandoti, poi dimentica qualcosa, è uno solo, e in qualche modo ti deve qualcosa: lo stipendio, la riconoscenza, gli anni che gli stai regalando. Il modello non dimentica niente e si copia all’infinito, senza doverti nulla. Nel momento in cui la tua correzione risolve un problema che hanno in milioni, in milioni ricevono il tuo modo di farlo senza sapere che è tuo, e senza che a te torni indietro niente. Un tempo il tuo modo di trattare quel cliente valeva perché lo avevi solo tu, e chi lo voleva veniva da te. Adesso lo stesso modo, una volta entrato nel modello, esce dal rubinetto per chiunque digiti la domanda giusta, allo stesso prezzo dell’abbonamento.

La reciprocità che regge l’apprendistato umano qui salta. È il punto dove di solito il ragionamento si ferma, con un senso di furto e un’aria da resa.

Mentre lo istruisci, ti disalleni

C’è una metà che quasi nessuno dice. Lo stesso gesto che manda fuori il tuo metodo lo consuma dentro. Smetti di scrivere la proposta e correggi quella che ha scritto lui, smetti di tenere in mano il criterio e ti riduci a sorvegliarlo, e ogni volta che deleghi la parte difficile perché tanto poi la sistemi, quella parte in te si assottiglia di un grado.

Tra cinque anni la macchina ha il tuo modo di fare e tu hai perso il tono muscolare per rifarlo senza. Il gemello cognitivo si affina mentre l’originale si spegne. Non è un furto, è un’atrofia. Di questo assottigliamento, del debito cognitivo che si accumula un riassunto accettato alla volta, ho scritto pensando alla metacognizione, all’esercizio di guardare come si pensa proprio mentre si usa il modello. Il segnale è facile da riconoscere: quando ti accorgi che davanti a un foglio bianco, con il modello chiuso, non partiresti più con la sicurezza che avevi due anni fa.

Trattenere tutto è una prigione

La risposta istintiva a tutto questo è nascondere. Tenersi il metodo, non darlo in pasto, lavorare a fari spenti. Strada chiusa, per due motivi. Il primo è che il modello rende peggio esattamente dove ti serve di più, quindi o affami lo strumento o nutri il gemello, e nel mezzo non c’è granché da abitare. Il secondo è più scomodo: l’accumulo come difesa è a sua volta una trappola, i quindici anni di sapere implicito che ti proteggono sono anche quindici anni che non riesci a scalare, a trasferire, a lasciare andare senza sentirti scoperto. È la ragione per cui certi professionisti bravissimi restano piccoli a vita: tutto passa dalle loro mani perché il valore è nelle loro mani, e le mani sono due.

Custodire tutto quello che sai è una prigione con una bella vista. Che prendano è dato, avviene comunque. Quello su cui hai voce sono le condizioni in cui avviene la presa.

La domanda è dove gira il calcolo

Quelle condizioni si giocano su una parola che suona burocratica e invece è molto concreta: giurisdizione. La domanda utile riguarda dove avviene il calcolo, con quali termini, e se quei termini puoi revocarli. Il contenuto che riveli pesa meno del luogo in cui lo riveli.

Sull’accesso ai modelli di frontiera l’ho già chiamato permesso più che proprietà, guardando a un governo capace di spegnere un modello dall’oggi al domani. La stessa logica vale un piano più in basso, sul tuo mestiere. Un’impresa cognitiva che gira sull’infrastruttura di un altro è cognitiva solo nel nome, affitta la stanza in cui si conia la sua stessa intelligenza, e paga l’affitto in giudizio. Un affitto che sale da solo, perché più il modello diventa capace più la tua operatività dipende da lui, e la dipendenza non è mai un buon posto da cui trattare le condizioni.

La sovranità digitale riguarda il contenitore, non l’ansia sul contenuto. Far girare il modello dove le regole le metti tu è una forma di questo, però il principio viene prima dello strumento: chi decide la giurisdizione del calcolo decide anche chi, dentro l’organizzazione, può ancora dire di no.

Il gemello cognitivo lo costruiranno comunque, quella parte non è in discussione. Quello che decidi tu è se la stanza dove lo costruiscono è tua o presa in affitto, e lo decidi adesso, mentre il metodo è ancora tutto dentro di te e non ancora tutto dentro la macchina. Tra qualche mese la proporzione si sposta, e si sposta da sola.

Scrivere con l’AI senza sparire: la voce come ultima cosa da non cedere

Ogni testo che pubblico passa da un controllo che ho costruito apposta per smascherare una cosa sola: quanto suona scritto da una macchina. È uno script che conta i trattini lunghi, le triadi, le frasi a bilanciere da otto-quindici parole, le aperture valutative, le formule che fingono sincerità. Se il pezzo le contiene, lo riscrivo. Lo faccio perché ho imparato, sulla mia scrittura, che l’AI non ti ruba le parole di colpo. Te le leviga, una alla volta, finché il testo è perfetto e non sei più tu.

Questa è la trappola di cui quasi nessuno parla mentre celebra la produttività. La scrittura AI funziona benissimo, ed è proprio per questo che è pericolosa.

Il testo che scorre liscio e non lascia niente

C’è una categoria di contenuti che è esplosa negli ultimi due anni. Post che scorrono via lisci, articoli ben impaginati, paragrafi che cominciano e finiscono dove ti aspetti. Non c’è un errore, non c’è un inciampo, non c’è una frase che ti faccia fermare. E non resta niente. Li ho sentiti chiamare vampiri di attenzione: ti prendono il tempo di lettura e non ti restituiscono un pensiero.

Il meccanismo è semplice. Un modello linguistico produce la sequenza di parole più probabile dato il contesto. Più probabile significa più media, più levigato, più simile a tutto il resto già scritto su quell’argomento. Quando deleghi la scrittura al modello senza intervenire, ottieni la media statistica di ciò che esiste. Corretta, presentabile, anonima. Il testo perde esattamente la cosa per cui valeva la pena scriverlo: la deviazione personale dalla media, l’angolo che solo tu avevi.

Quando lo strumento aiuta davvero

Sarebbe disonesto demonizzarlo. L’AI come supporto alla scrittura è una conquista reale, soprattutto per chi con le parole fatica. Conosco persone brillanti che hanno idee migliori delle mie e si bloccano davanti a una pagina bianca, intimidite dalla forma. Per loro il modello è una stampella che permette di camminare, un modo per tirare fuori un pensiero che altrimenti resterebbe muto.

C’è una differenza enorme, però, tra usare lo strumento per dare forma a un pensiero che è tuo e usarlo per generare il pensiero al posto tuo. Nel primo caso parti da qualcosa, una tesi, un’intuizione, un fastidio, e chiedi aiuto a strutturarlo. Nel secondo apri la chat senza avere niente da dire e lasci che sia la macchina a riempire il vuoto. Il risultato somiglia, sulla pagina. Il processo è opposto, e si vede col tempo: chi parte sempre dal vuoto smette di allenare la capacità di produrre pensiero.

La scrittura AI come impostazione predefinita

Il problema non sta nell’esistenza dello strumento. Sta nella sua trasformazione in default. Apri un documento, e il modello suggerisce già il paragrafo. Scrivi una mail, e c’è il completamento pronto. Devi fare un post, e in tre secondi ne hai cinque versioni. La frizione che prima esisteva tra l’idea e la sua messa in parole è quasi sparita, e quella frizione non era solo un costo: era il momento in cui pensavo.

Scrivere è sempre stato un modo per scoprire cosa penso davvero. Lo capisco mentre lo metto giù, sbaglio, cancello, mi accorgo che la tesi di partenza era debole e la cambio. Quel lavoro sporco è il pensiero che si forma. Se lo salto, se accetto la prima versione plausibile che la macchina mi serve, ottengo il testo ma perdo la scoperta. E perdere la scoperta, ripetuto mille volte, significa diventare un editor di idee altrui invece che un autore delle proprie.

C’è uno strato sottile dove la persona e la macchina si toccano, e la scrittura è uno dei punti dove quel contatto è più intimo, perché le parole con cui scriviamo sono anche le parole con cui pensiamo. Cederle del tutto non è una scelta di efficienza neutra, tocca qualcosa di più profondo.

La voce come asset, non come vezzo

Per chi scrive per lavoro, e parlo anche di aziende, c’è una posta concreta. La voce riconoscibile è un asset. È ciò che fa sì che un lettore distingua un tuo testo da quello di chiunque altro, che si fidi, che torni. Quando un’organizzazione delega tutta la produzione di contenuti al modello senza mantenere una voce umana, accumula quello che chiamo debito di autorialità: tutto è coerente e nessuno è più riconoscibile.

Si paga al momento peggiore. Una crisi reputazionale, una negoziazione difficile, un messaggio che deve arrivare davvero, e scopri che non c’è più nessuno in azienda capace di scrivere con una voce che le persone ascoltano. Hai esternalizzato la cosa che ti rendeva distinguibile, e quando ti serve non c’è.

Il mio audit anti-pattern nasce da qui. Non rifiuto l’AI, ci lavoro ogni giorno. Pretendo che il testo passi attraverso di me, che la prima stesura non sia mai l’ultima, che resti una deviazione mia dalla media che il modello produce. Costa attrito, ed è esattamente l’attrito che voglio tenere: la produttività di oggi non deve comprarsi la perdita della voce di domani.

Cosa tenere e cosa cedere

La regola che mi sono dato è semplice. Cedo al modello la fatica meccanica, la prima impalcatura, la ricerca, la correzione. Tengo per me la tesi, l’angolo, la voce, il giudizio su cosa vale la pena dire. Lo strumento amplifica la parte che è già mia, non la sostituisce.

Vale per una persona e vale per un’azienda. La scrittura non è un costo da abbattere fino a zero, è un esercizio che mantiene viva una capacità, individuale e collettiva, di pensare con parole proprie. Una capacità che, come tutte, si atrofizza se smetti di usarla: è il muscolo che rischiamo di perdere proprio mentre crediamo di averlo potenziato. Il test è semplice, e vale la pena farlo prima di pubblicare: se dietro un testo uscito perfetto in tre secondi c’è ancora qualcuno, o solo la media di tutto quello che è già stato scritto.


Riflessione sviluppata a partire da un testo sull’uso acritico dell’intelligenza artificiale nella scrittura.

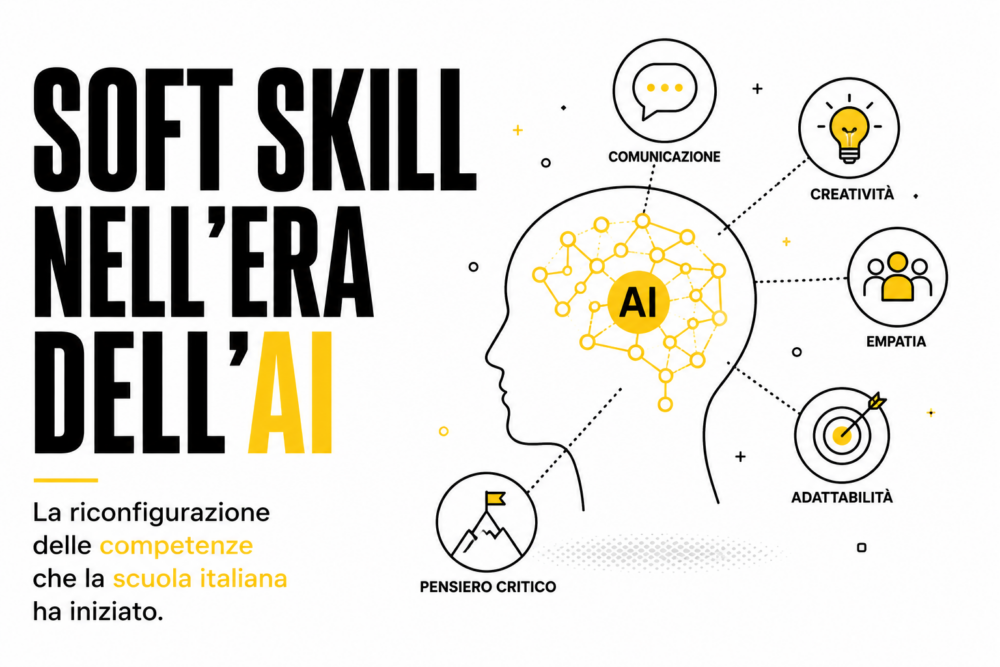
Soft skill nell’era dell’AI: la riconfigurazione delle competenze che la scuola italiana ha iniziato

Il 7 maggio 2026 Assolombarda e nove università milanesi hanno firmato un accordo quadro triennale su lauree, master e hackathon dedicati all’intelligenza artificiale. Dentro i dati che accompagnano la firma c’è un numero che vale tutta la discussione sulla fine del lavoro: nel quadrilatero Milano-Monza-Lodi-Pavia i laureati STEM sono cresciuti del 25,6% dal 2014, ma solo il 2% del totale possiede competenze ICT effettive. Le imprese cercano, le università sfornano titoli, e in mezzo resta un vuoto di soft skill che nessuna laurea tecnica da sola sta riempiendo.

Tendiamo a leggere l’arrivo dell’AI nel lavoro come una sottrazione: quanti posti spariranno. È la domanda sbagliata, o almeno è quella che cattura meno di metà di ciò che sta succedendo. L’altra metà è una riconfigurazione di cosa rende prezioso un essere umano in un’organizzazione, e tocca proprio le soft skill che un’aula STEM tradizionale non insegna.

Le soft skill nel vuoto che le lauree tecniche non colmano

L’automazione cognitiva mangia per prima i compiti procedurali: inserimento dati, redazione di documenti standard, prima stesura di codice. Sono attività che fino a ieri richiedevano una persona e che oggi un modello svolge in pochi secondi. Su questo non c’è dibattito serio.

Cosa resta dall’altra parte, invece, è tutto ciò che richiede di leggere una situazione ambigua, di tenere insieme persone con interessi diversi, di decidere quando una risposta del modello va bene e quando va buttata. Empatia, negoziazione, capacità di persuasione, giudizio in condizioni di incertezza. Le chiamiamo soft skill con una certa condiscendenza, come se fossero un contorno. Stanno diventando il piatto principale.

Il paradosso italiano è proprio questo. Abbiamo prodotto più laureati tecnici e contemporaneamente un mismatch più ampio, perché il valore si è spostato verso una combinazione che la formazione iperspecialistica non garantisce: solidità tecnica più capacità relazionale e critica. Chi ha solo la prima è automatizzabile sui margini, chi ha solo la seconda non capisce abbastanza la tecnologia per governarla.

Filosofia e classici rientrano dalla porta principale

Qualcosa, in controtendenza rispetto a quanto si racconta, si sta muovendo. Le nuove Indicazioni Nazionali per i licei del 2026 introducono l’intelligenza artificiale e l’informatica nel curriculum, ma la scelta che trovo più interessante è un’altra: il rilancio della filosofia con un approccio specifico su etica e tecnologia, e un impulso esplicito al pensiero critico come competenza da allenare. Insieme a un ritorno ai classici e alla centralità del testo.

A prima vista sembra un movimento all’indietro, verso il sapere umanistico, proprio mentre tutti spingono sulle STEM. Letto bene è il contrario: è il riconoscimento che, in un mondo dove la parte tecnica diventa commodity erogata da una macchina, la differenza la fa la capacità di interpretare, argomentare, dubitare. Le arti liberali non come nostalgia, come infrastruttura cognitiva per stare davanti a un modello senza esserne sostituiti.

Lo stesso vale per l’alta formazione. Il Politecnico di Milano integra l’AI in tutti i corsi di laurea magistrale e propone certificati per professionisti. Insegno anch’io in due business school, e vedo da vicino come la domanda sia cambiata: i manager non chiedono più solo di capire la tecnologia, chiedono di capire come ridisegnare ruoli e competenze delle loro persone attorno alla tecnologia. È una domanda da educatori, non da tecnologi.

La capacità cognitiva che rischiamo di perdere

C’è un timore che attraversa tutto questo, e va preso sul serio invece di liquidarlo. Delegare al modello una quantità crescente di lavoro mentale potrebbe atrofizzare proprio le capacità che diciamo di voler coltivare. Uno studente che fa scrivere i temi all’AI non allena la scrittura. Un professionista che le delega ogni analisi smette di saper analizzare.

C’è uno strato sottile dove la mente e la macchina si toccano, ed è lì che si decide se l’una estende l’altra o la sostituisce. La scuola e l’università sono il luogo dove questa decisione pesa di più, perché lì le competenze non si esercitano, si formano per la prima volta. Un adulto che delega perde un allenamento. Un ragazzo che delega potrebbe non sviluppare mai la capacità.

La risposta non è vietare lo strumento, sarebbe ridicolo e perdente. È insegnare a usarlo in modo che amplifichi invece di sostituire. Far scrivere allo studente la sua ipotesi prima di chiederla al modello. Pretendere che sappia giudicare l’output, il che richiede di possedere la competenza, non di averla noleggiata. Tenere viva una quota di lavoro fatto senza aiuto, come si tiene allenato un muscolo che altrimenti si addormenta.

Utilizzatori o menti che tengono testa alla macchina

La transizione non porterà alla disoccupazione di massa che molti temono. Porterà a una ridistribuzione del valore verso competenze che oggi sottovalutiamo, e premierà chi sa stare nel mezzo: abbastanza tecnico da capire la macchina, abbastanza umano da fare ciò che la macchina non fa.

Il sistema educativo italiano ha davanti una finestra stretta per riconfigurarsi attorno a questa idea, e i segnali dicono che ha cominciato a guardarci. Resta la parte difficile, che non è scrivere nei programmi la parola intelligenza artificiale, è cambiare il modo in cui si insegna a pensare. È la riforma più importante e meno appariscente del momento. Tra qualche anno si vedrà la differenza, tra chi ha solo imparato a usare lo strumento e chi ha imparato a pensare senza di lui.


Spunti dall’Accordo Quadro Assolombarda-università 2026-2029 e dalle nuove Indicazioni Nazionali per i licei.

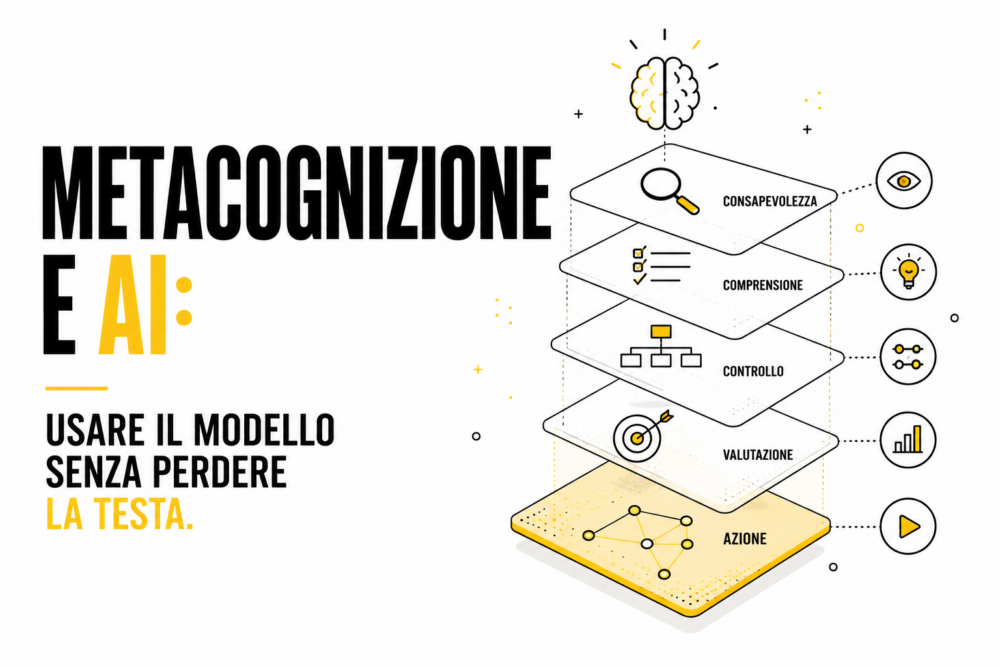
Metacognizione e AI: usare il modello senza perdere la testa

C’è un gesto che faccio decine di volte al giorno senza pensarci. Apro una chat, scrivo una richiesta, ricevo una risposta buona, la uso. Funziona così bene che ho smesso di chiedermi una cosa: dopo, quella competenza è mia o l’ho solo presa in prestito? La domanda sembra astratta finché non provi a rifare da solo qualcosa che la settimana prima avevi delegato al modello, e ti accorgi che la mano non sa più muoversi.

Questa è la differenza tra l’AI come amplificatore e l’AI come protesi. Un amplificatore prende una mia capacità e la rende più potente. Una protesi sostituisce una capacità che, col tempo, si atrofizza per disuso. Lo stesso strumento può essere l’uno o l’altra. Dipende da come lo uso, e quasi nessuno si ferma a controllarlo. Qui entra in gioco la metacognizione.

La competenza che non sapevo di perdere

Il termine tecnico per questo controllo è metacognizione: pensare a come si pensa, osservare il proprio modo di apprendere mentre accade. È una vecchia idea della psicologia cognitiva, e l’AI la rende improvvisamente urgente.

Quando delego al modello la stesura di un testo, sto risparmiando tempo. Indubbio. Ma sto anche saltando il processo che, ogni volta che lo facevo a mano, manteneva allenata una capacità. Non si tratta di rinunciare allo strumento, sarebbe assurdo. Si tratta di accorgersi di quando lo sto usando per amplificare e quando per evitare, perché solo nel primo caso esco dall’interazione più capace di prima.

In Pelle Digitale avevo provato a descrivere questo strato sottile dove la mente e la macchina si toccano. La metacognizione è il sensore che mi dice da che parte di quello strato sto stando: se la macchina sta estendendo me, o se io mi sto ritirando dentro la macchina.

Prompt ipotesi, check di ritenzione, rotazione

Non servono teorie, servono abitudini. Tre, semplici, che ho integrato nel mio modo di lavorare con il modello.

La prima la chiamo prompt ipotesi. Prima di chiedere al modello come si risolve un problema, scrivo la mia ipotesi di soluzione. Anche sbagliata, anche grezza. Poi confronto. Questo piccolo attrito fa una differenza enorme: invece di ricevere passivamente una risposta, la leggo come correzione di un mio ragionamento, e il ragionamento resta mio.

La seconda è il check di ritenzione. A distanza di qualche giorno da un compito che ho svolto con l’AI, provo a rifarne un pezzo senza aiuto. Se non ci riesco, ho una misura precisa di quanto quella competenza fosse prestata. Non è un esame, è un termometro. Mi dice dove sto accumulando debito cognitivo, quel saldo nascosto che si paga quando lo strumento un giorno non c’è.

La terza è la rotazione del prompt. Quando un modo di chiedere funziona, tendo a ripeterlo all’infinito. Comodo, e lentamente accecante: smetto di esplorare. Ogni tanto cambio deliberatamente l’approccio, chiedo la stessa cosa in un modo che non userei mai, per vedere cosa emerge e per non lasciare che lo strumento mi addestri a pensare in un solo modo.

Quello che vale per una persona vale per un’azienda

La metacognizione non è solo un fatto individuale. Un’organizzazione che adotta l’AI senza farsi queste domande accumula lo stesso debito, moltiplicato per il numero di persone.

Succede così. Un reparto comincia a delegare al modello una serie di compiti. La produttività sale, i numeri sono buoni, nessuno si lamenta. Poi, mesi dopo, qualcuno si accorge che la competenza interna su quei compiti è evaporata. Non c’è più nessuno in grado di valutare se l’output del modello sia giusto, perché tutti hanno smesso di farlo a mano. L’azienda è diventata dipendente da uno strumento che non sa più giudicare.

L’antidoto è lo stesso, scalato. Tenere viva una quota di lavoro fatto senza AI, non per nostalgia, ma per mantenere la capacità di giudizio. Ruotare le persone tra compiti assistiti e compiti autonomi. Misurare la ritenzione delle competenze come si misura qualsiasi altro asset, perché lo è. È una delle conversazioni che porto più spesso al tavolo di CEO e CTO: la produttività di oggi non deve comprarsi la dipendenza di domani.

La crescita o la dipendenza

La parte che mi interessa di più non è tecnica. Riguarda che tipo di persone e che tipo di organizzazioni diventiamo usando questi strumenti.

C’è una via in cui l’AI ci rende più capaci, più curiosi, liberati dal lavoro meccanico e spinti verso quello che richiede giudizio. E c’è una via in cui ci rende più comodi e progressivamente più vuoti, con le risposte sempre pronte e la capacità di trovarle in lento declino. Lo strumento è identico. A separare le due vie c’è solo l’attenzione che mettiamo nel modo in cui lo usiamo.

La metacognizione è quella attenzione, resa abitudine. Costa un piccolo attrito ogni giorno, e in cambio mantiene aperta la possibilità che l’AI sia una crescita e non un noleggio permanente di facoltà che un tempo erano nostre. Senza dubbio è l’investimento più sottovalutato del momento. Chi la coltiva arriverà al giorno in cui lo strumento cambia, o si ferma, con la mano ancora capace di muoversi da sola, e sarà quella la differenza tra chi guida i prossimi anni e chi li subisce.

Manager di umani e di agenti: un mestiere che sta cambiando

A febbraio 2026 Harvard Business Review ha pubblicato un articolo a firma Suraj Srinivasan (Harvard Business School) e Vivienne Wei (Salesforce) sul nuovo ruolo del manager di agenti AI nelle aziende, intitolato To Thrive in the AI Era, Companies Need Agent Managers. Dentro c’è la giornata di Zach Stauber, support agent manager a Salesforce: comincia e finisce davanti a dashboard, scorecard e sistemi di osservabilità degli agenti. Non gestisce persone, gestisce una flotta di agenti AI che lavorano su supporto, vendite e marketing dentro Agentforce. Marc Benioff a luglio 2025 aveva già detto che Salesforce è passata da 9.000 a 5.000 ruoli nel customer support, riallocando il resto in vendite e customer success, e che gli agenti chiudono autonomamente l’85% dei ticket clienti.

Sembra una notizia di Silicon Valley, ed effettivamente il caso Salesforce è estremo. La categoria di lavoro che descrive però, quella del manager di agenti che orchestra un gruppo misto di umani e di sistemi automatizzati, sta arrivando a velocità inattesa anche dentro aziende italiane molto meno radicali. Lo vedo nei progetti di advisory che seguo, lo sto vivendo addosso io stesso nel modo in cui lavoro, e ho la sensazione che molti CEO italiani non abbiano ancora messo a fuoco quanto profondamente questo cambierà l’organigramma reale delle loro aziende entro 24 mesi.

A casa di chi costruisce AI, questo è già il presente

Lo studio Anthropic How AI Is Transforming Work at Anthropic, pubblicato il 4 dicembre 2025, ha analizzato 132 ingegneri e ricercatori interni, 53 interviste qualitative e i dati di uso di Claude Code. Un numero solo, fra i tanti che il paper mette sul tavolo, mi è rimasto in mente: il 27% del lavoro fatto con assistenza AI è lavoro che senza AI non sarebbe stato fatto affatto. Esperimenti che restavano nel cassetto, dashboard nice-to-have, documentazione interna sempre rinviata, strumenti che sarebbero costati troppo da prototipare a mano. Tutto questo adesso si fa, perché il costo marginale di iniziare è crollato.

Sotto quel 27% c’è una conseguenza meno raccontata, ma evidente nelle interviste: gli ingegneri Anthropic descrivono se stessi sempre più come supervisori, persone che danno indicazioni e controllano output, che indirizzano il lavoro invece di farlo direttamente. La quota di lavoro che dicono di poter “fully delegate” all’AI resta intorno al 10-20%, ma il restante 80-90% è collaborazione attiva, con il loro tempo che scivola dall’esecuzione diretta al controllo, dalla scrittura del codice alla revisione del codice scritto da Claude. Anthropic è il caso estremo perché Claude è il loro prodotto, ma la curva che descrivono è la stessa che vedo nei team di sviluppo italiani che hanno adottato Claude Code o Cursor o equivalenti negli ultimi sei mesi.

“Il McKinsey” che ha messo sul tavolo i numeri

A gennaio 2026, sul podcast All In, Bob Sternfels (global managing partner McKinsey) ha dichiarato che la sua azienda ha 60.000 dipendenti totali, di cui 25.000 agenti AI a fianco di 40.000 umani, con l’obiettivo di parità entro fine anno. Sul valore reale di quei 25.000 agenti il dibattito è aperto, e i concorrenti EY e PwC hanno fatto notare che una manciata di agenti ben fatti spesso produce più valore di una flotta numerosa. La notizia più seria di quella conferenza, come ho scritto in maggio, era però un’altra: McKinsey sta spostando una quota maggiore della remunerazione dei partner da cash a equity, perché i ricavi diventano volatili e il vecchio modello non regge più.

Una conseguenza che né McKinsey né i suoi concorrenti hanno ancora interiorizzato è questa: se metà della tua workforce è composta da agenti, hai bisogno di una struttura manageriale che gestisca gli agenti come si gestiscono le persone, ma con strumenti diversi.

Servono ruoli di accountability per le performance degli agenti, persone che ne misurino la qualità, che li riallenino quando deragliano, che decidano quando un caso va escalato a un umano. È esattamente quello che fa Stauber a Salesforce, ed è il primo abbozzo di una professione che fino a 18 mesi fa non esisteva.

Come sto vivendo io questo cambiamento

Mi è capitato negli ultimi mesi di trovarmi a fare il lavoro che fino a 24 mesi fa avrei diviso fra tre o quattro junior. Brief di scoping per un cliente, ricerca preliminare di mercato, prima stesura di un’offerta tecnica, analisi di documenti corposi, audit di una codebase. Quattro cose che richiedevano persone diverse, tempi distribuiti su settimane, riunioni di coordinamento. Adesso le orchestro da solo, con Claude Code che lavora sulla parte tecnica, Claude o GPT che mi preparano i deck e le bozze, RSS Intelligence che mi setaccia le fonti, MCP server che leggono i miei progetti aziendali su Biztrack e li trasformano in materiale per il cliente. Non è perfetto, non sempre regge, ma il salto di efficienza è reale.

Ed è qui che inizia il dubbio, quello che lo studio Anthropic intercetta nelle sue interviste e che condivido. Se il junior che avrebbe fatto la ricerca di mercato per me non lo faccio più assumere, perché un agente la fa decentemente in venti minuti, dove lo formerà la prossima generazione di consulenti e advisor? E se la prima bozza di un’offerta tecnica la scrive un agente che ho istruito sui miei pattern, quando avrò ancora il tempo e l’occasione di fare quel lavoro io stesso, con la lentezza che serve per capirlo davvero?

Su questo voglio essere chiaro: non sto facendo argomenti contro l’adozione dell’AI, su cui sono fra i più convinti. Sto argomentando per adottarla con la consapevolezza che ogni nuova efficienza implica una scelta di cosa non sviluppiamo più come capacità umana. La supervisione di un agente richiede competenza profonda dello stesso dominio che l’agente ha automatizzato. Se quella competenza non si forma più sul campo, fra due cicli generazionali la supervisione diventa nominale.

Il ruolo del manager si sta sdoppiando

Quello che osservo nelle aziende italiane medie con cui lavoro, fra le tecnologiche di Roma e le manifatturiere del Nord, è che la figura del manager si sta sdoppiando in due direzioni che convivono nella stessa persona.

Una direzione resta quella tradizionale, fatta di relazione umana fra persone: motivare un collega che attraversa un momento complicato, costruire e mantenere fiducia, gestire i conflitti che nascono inevitabilmente in ogni team, prendere decisioni su altre persone. Questa parte non viene erosa dall’AI, anzi: con team più piccoli e più senior, ogni decisione su una persona pesa di più, ogni riunione conta di più, ogni colloquio di sviluppo diventa più strategico. Il manager di umani non scompare, diventa più importante per quei pochi umani che resteranno nel team.

L’altra direzione è completamente nuova. Si tratta di definire i task degli agenti, scegliere il modello adatto al singolo carico, versionare i prompt come si versionano i contratti, monitorare derive e performance, decidere quando portare un agente da pilot a produzione e quando spegnerlo. Sono attività che assomigliano al lavoro di un product manager più che a quello di un people manager, ma vivono dentro lo stesso perimetro di responsabilità.

Il risultato è che il manager italiano del 2027 dovrà essere bilingue. Parlare la lingua delle persone e la lingua dei sistemi agentici. E queste due lingue si imparano in scuole molto diverse.

Ambizione, giudizio, creatività: cosa cerca davvero Sternfels

A Las Vegas, sempre a gennaio, Sternfels ha indicato che McKinsey cerca oggi nei candidati junior tre qualità precise: ambizione, giudizio, creatività. Sembra una lista da ufficio HR, ma se la leggi con la lente del lavoro che descrive Stauber a Salesforce, ti accorgi che è la descrizione esatta del manager di agenti.

L’ambizione conta perché chi gestisce agenti non ha più la routine del controllo gerarchico stretto, ha invece il problema di decidere cosa far fare di nuovo a un sistema che fa molto da solo. Il giudizio conta perché la quasi totalità delle decisioni operative la prendono gli agenti, e l’umano interviene proprio nei casi limite dove non ci sono regole chiare. Sulla creatività poggia tutto il resto, dato che definire bene un agente significa immaginare casi d’uso e prompt che non sono nel playbook esistente.

Tutte e tre queste organizzazioni stanno cercando le stesse tre competenze, e stanno cercandole in nuovi ruoli mentre tagliano in quelli vecchi. È lo scenario che le aziende italiane medie devono interiorizzare, perché succederà anche da loro, con due-tre anni di ritardo e a una scala più piccola, ma con la stessa logica.

Come imposto i progetti dove serve un manager di agenti

Quando un CEO italiano mi chiede come si prepara la sua azienda al manager di agenti, gli rispondo che non si prepara con un master di sei mesi né con un progetto di consulenza chiavi in mano. Si prepara mettendo subito un piccolo gruppo di manager attuali in condizione di lavorare quotidianamente con agenti veri, su task veri, e di imparare sul campo cosa va e cosa non va.

Praticamente significa scegliere un caso d’uso non strategico ma reale, dove il rischio è basso e l’apprendimento alto: drafting di prime risposte commerciali, analisi periodica di documentazione regolatoria, gestione della knowledge base interna. Poi serve dare al manager interno tutto lo stack per orchestrare l’agente, dall’accesso ai modelli alla dimestichezza con MCP e tool calling, fino al controllo dei prompt e alle dashboard di monitoraggio. Infine, e qui è il passaggio che vedo più trascurato, quel manager va valutato non sull’output diretto ma sulla qualità con cui gestisce l’agente, esattamente come Stauber a Salesforce.

Questa logica funziona meglio quando si appoggia su un’architettura AI dentro al perimetro aziendale, perché un manager italiano che orchestra agenti su dati di clientela o su documentazione sensibile non può farlo bene se gli agenti girano su infrastruttura americana sotto Cloud Act. Senza sovranità del dato, il manager diventa supervisore di un sistema di cui non controlla i confini, e la sua funzione si svuota.

Il rischio che non discutiamo abbastanza

C’è una parte del lavoro manageriale che la sostituzione con agenti rischia di erodere, e credo valga la pena nominarla con calma. È il mentoring informale, quello che succede quando un giovane fa una domanda a un collega più anziano in corridoio, quando un junior osserva un senior gestire una telefonata difficile, quando un team-leader passa mezz’ora con un nuovo assunto per capire come ragiona.

Quel sapere tacito, che le aziende trasmettono per contagio quotidiano, ha bisogno di numero. Servono junior che facciano domande e senior che rispondano, e servono spazi fisici e mentali dove l’asimmetria di esperienza si trasforma in relazione di apprendimento. Se gli agenti rispondono prima e meglio, i junior smettono di chiedere ai colleghi e i senior smettono di formare, e l’azienda smette di trasferire memoria operativa. È una perdita che non si vede nei KPI trimestrali, si vede nel decennio.

In Pelle Digitale ho provato a descrivere il modo in cui l’interfaccia digitale media le nostre relazioni e modifica anche quello che credevamo di sapere su noi stessi. Vale lo stesso, in modo più specifico, dentro le organizzazioni. Un’azienda dove l’interlocutore di prima istanza è un agente, e non più il collega di stanza, è un’organizzazione diversa nella sostanza, non solo nelle prestazioni. Il buon manager di agenti del 2027 dovrà difendere attivamente gli spazi dove l’apprendimento informale avviene fra umani, perché non avverrà più da solo.

La domanda da porsi

Settembre 2026 sarà probabilmente il primo trimestre in cui molte aziende italiane medie metteranno in piedi i primi prototipi seri di agentic adoption, dopo la prova generale del 2025 e i pilot del 2026. Per chi guida quelle aziende, e per chi guida funzioni dentro quelle aziende, una domanda che vale la pena tenere davanti è semplice. Quale manager della mia organizzazione è già di fatto un orchestratore di agenti senza ancora averlo dichiarato, e quale invece sta rifiutando di diventarlo perché ne percepisce l’aliquota di disagio? Perché il primo va riconosciuto e formalizzato in fretta, prima che lo riconosca un concorrente. E il secondo va ascoltato, perché la sua diffidenza spesso vede cose che chi è già dentro non vede più.

Tecnologia e lavoro nell’era degli shock: appunti da Napoli

Il 19 giugno, nel Complesso di Sant’Anna dei Lombardi a Napoli, è partito il primo appuntamento di Cantieri di Futuro, il percorso del Centro di competenza SI.FA. dedicato alle tecnologie per la transizione sociale digitale. Tre interventi al mattino, poi due sessioni di lavoro guidato ai tavoli, e sopra le nostre teste una volta affrescata che da sola ti ricorda una cosa semplice, e cioè che il futuro lo costruisce sempre qualcuno dentro spazi lasciati in eredità da chi è venuto prima. Mi hanno chiesto di fare da stimolo alla discussione, e invece di aggiungere l’ennesima lista di trend ho scelto di fare un passo indietro, fino alle curve, per provare a leggere le opportunità dell’era degli shock.

Lo strappo che chiamiamo shock

La tecnologia avanza su una curva che accelera. Le persone, le organizzazioni, le competenze, le istituzioni si adattano su una curva molto più lenta, quasi piatta al confronto. La distanza tra le due è quello che viviamo come shock, e lo viviamo male perché la nostra testa legge il mondo in modo lineare, e davanti a una crescita esponenziale la sottostima quasi sempre. È lo stesso fenomeno, la stessa intelligenza artificiale, che a qualcuno sembra un’apocalisse e a qualcun altro un giocattolo, a seconda di dove si trova rispetto a quelle due linee. Gli shock, allora, non sono temporali isolati che passano e poi torna il sereno. Sono la condizione di chi vive nel divario, e quel divario continua ad allargarsi. La parte interessante è che lo stesso spazio vuoto, in mezzo alle due curve, è dove nascono i lavori e i servizi che ancora non abbiamo immaginato.

Dal lavoro al task

Quando diciamo che l’automazione e la GenAI tolgono lavoro, stiamo usando l’unità di misura sbagliata. Un lavoro è un insieme di task, e l’automazione li ridistribuisce dentro i mestieri, che cambiano forma ma restano. Una parte se la prende la macchina, il ripetitivo e il prevedibile. Una parte resta profondamente umana, il giudizio su un caso che non somiglia a nessun altro, la relazione, la responsabilità di una decisione presa su una persona vera. E una parte nasce nuova, perché qualcuno deve orchestrare la macchina, progettare l’interazione, prendersi cura di quello che produce. Si capisce dove il lavoro si sta spostando solo guardando i task, al posto dei titoli stampati sui biglietti da visita. In Pelle Digitale ho provato a raccontare proprio quella zona di confine tra noi e le macchine, lo strato sottile in cui decidiamo ogni giorno cosa deleghiamo e cosa teniamo stretto.

La mente adattiva diventa competenza di base

Se ogni abilità vive su una curva, allora a un certo punto ogni abilità invecchia, e nessuna competenza tecnica da sola ci basta per molto tempo. Quello che resta, e che vale più di qualunque strumento, è la capacità di continuare a imparare e a ricomporsi mentre tutto cambia sotto i piedi. Le competenze che serviranno stanno in tre famiglie. La prima è saper lavorare con la macchina, orchestrarla, supervisionarla, darle istruzioni che funzionano. La seconda è il profondamente umano, la cura, il giudizio, la relazione, l’etica, tutto ciò che non si automatizza e che diventa più prezioso man mano che il resto si automatizza. La terza è imparare a imparare, perché il ciclo si ripeterà, e chi lo sa attraversare più volte parte avvantaggiato. È il pattern con cui lavoro da anni, e in un paio dei miei libri, La mente adattiva e Da Zero a Loop, è il filo che tiene insieme tutto il resto.

Tre angoli che convergono sulle persone

La cosa più bella della mattinata è stata accorgersi, senza esserci messi d’accordo prima, che i tre interventi guardavano nello stesso punto. Roberto Paura, presidente dell’Italian Institute for the Future, ha messo in fila dati e megatrend, da dove veniamo e verso dove stiamo andando, con lo sguardo lungo di chi studia il futuro per mestiere. Riccarda Zezza, fondatrice di Lifeed, ha mostrato come le competenze che contano si allenino nei contesti di vita, nella famiglia, nelle amicizie, nella cura di una persona anziana, persino nello sport, e poi si trasferiscano al lavoro. Le mie curve stavano nel mezzo, a spiegare perché quel passaggio oggi è diventato così urgente. Tre angoli diversi, una sola direzione, e al centro sempre le persone con la loro capacità di adattarsi.

Nell’economia sociale la posta è più alta

C’è un motivo per cui questo ragionamento, applicato all’economia sociale, pesa il doppio. Lì il valore di ciò che si fa è la relazione, ed è esattamente la parte che nessuna macchina prende. La transizione digitale del sociale serve allora a liberare l’operatore dal task ripetitivo, dalla carta, dagli spostamenti inutili, così che arrivi a più persone e con più continuità, e a far nascere ruoli nuovi attorno a quella relazione, dal navigatore digitale che accompagna le persone fragili fino al case manager che segue la persona con i dati invece che con i moduli. La tecnologia migliore, in questo campo, è quella che non si nota. Si nota la persona che prima restava fuori e che adesso viene raggiunta.

Cantieri, non previsioni

Per tutto questo preferisco la parola cantieri alla parola previsioni. Una previsione la guardi da fuori, e aspetti che si avveri o che ti smentisca. Un cantiere lo apri, ci entri, e ti sporchi le mani. Il futuro del lavoro nel sociale non arriverà nonostante gli shock, nascerà dentro il divario tra le due curve, e qualcuno dovrà lavorarci. Oggi, a Napoli, abbiamo iniziato a farlo. La domanda che mi porto a casa, e che lascio ai tavoli, è la più semplice di tutte: tutto quello che sta cambiando, per chi lo stiamo cambiando?


Cantieri di Futuro, primo appuntamento del percorso del Centro di competenza SI.FA., ospitato da ParteNeapolis al Complesso monumentale di Sant’Anna dei Lombardi, Napoli, 19 giugno 2026. Grazie a Marco Traversi per l’invito.

Come usiamo l’AI nel 2026: l’uso emotivo che sorpassa il tecnico

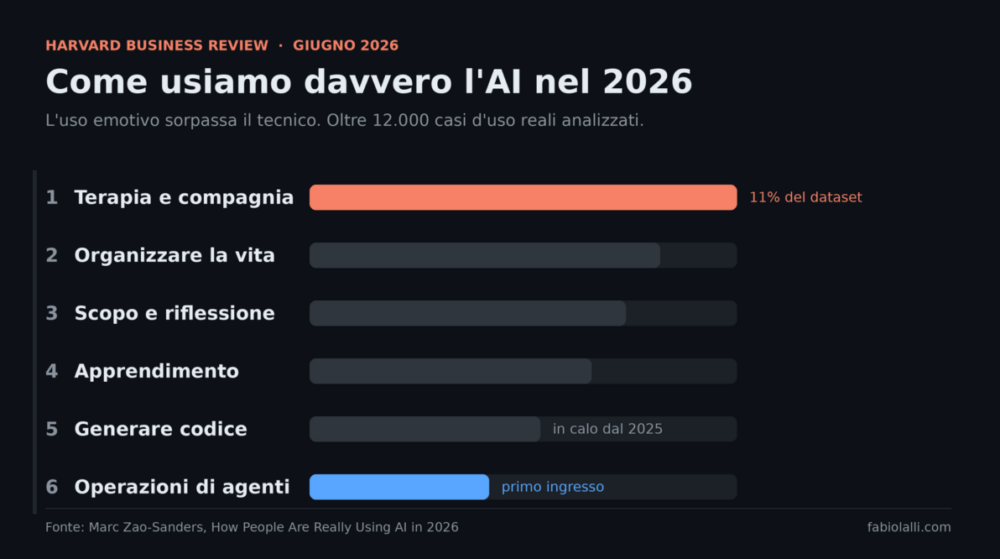
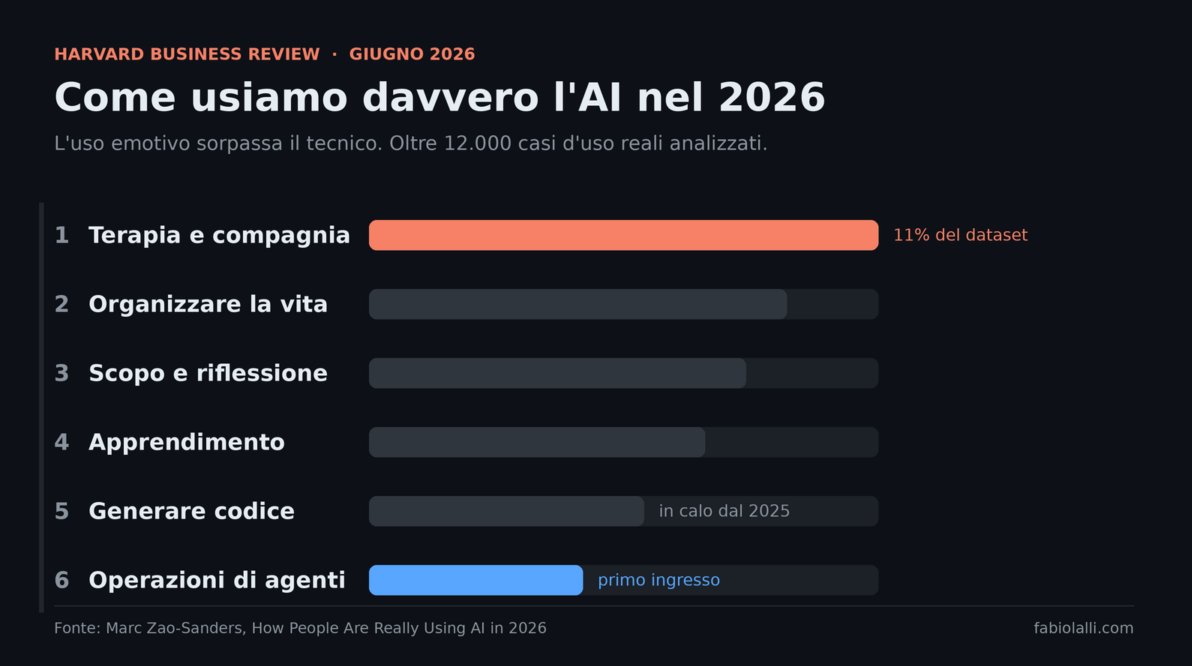
Il primo giugno 2026 Harvard Business Review ha pubblicato la terza edizione di “How People Are Really Using AI”, la ricerca che Marc Zao-Sanders porta avanti dal 2023 dentro il progetto AI in the Wild. Quest’anno ha analizzato oltre dodicimila casi d’uso reali, raccolti per dodici mesi da post pubblici sui social, dieci volte il campione dell’edizione precedente. Il dato che resta in testa dopo aver chiuso la pagina non riguarda il coding né la produttività, riguarda noi, e in particolare un uso emotivo che ha superato quello tecnico.

In cima alla classifica, per il secondo anno consecutivo, c’è la terapia e la compagnia. Non l’automazione di un processo, non la generazione di codice, non l’analisi di dati. Le persone aprono un modello di linguaggio per parlare di sé, e lo fanno più di prima.

La voce numero uno è emotiva

Zao-Sanders riporta che terapia e compagnia oggi valgono circa l’11% di tutto il dataset, contro il 5% di dodici mesi fa. In un anno l’uso emotivo è raddoppiato in peso relativo, mentre gli usi tecnici scivolavano verso il basso della classifica. Generare codice per professionisti, che nel 2025 stava al quinto posto, lascia spazio a categorie come l’intrattenimento, i consigli sulle relazioni, perfino l’astrologia e le letture dei tarocchi.

C’è una lettura comoda di questo dato, quella che lo derubrica a curiosità statistica. La gente si annoia, chiacchiera con il chatbot, niente di serio. Io credo che sia il contrario, e che dentro quel raddoppio ci sia il fenomeno culturale più interessante degli ultimi anni. La macchina che avevamo costruito per scrivere email e risolvere problemi tecnici è diventata, per milioni di persone, un interlocutore sulle cose che contano davvero, la solitudine, il senso, le relazioni.

In Pelle Digitale avevo provato a descrivere la tecnologia come estensione cognitiva, una superficie che si appoggia alla mente e ne allarga il raggio. Quello che vedo nei dati di Zao-Sanders è qualcosa di più intimo, l’estensione ha smesso di toccare solo il pensiero e ha iniziato a toccare l’affetto.

Fonte: elaborazione su dati Marc Zao-Sanders, How People Are Really Using AI in 2026, Harvard Business Review.

Thinkslop, quando deleghiamo il pensiero

L’edizione di quest’anno introduce un termine che vale la pena tenere, thinkslop. La preoccupazione non è più che la macchina scriva al posto nostro, quella battaglia è persa da tempo e a conti fatti non era nemmeno così grave. La preoccupazione è che le deleghiamo il pensiero stesso, le decisioni, le idee, le intenzioni, cioè proprio le funzioni in cui restiamo, almeno per ora, insostituibili.

Qui mi fermo, perché è il punto dove la mia esperienza personale si scontra con il dato. Uso modelli ogni giorno, in ICONICO e in ZeroFive.AI, e ho imparato a riconoscere il momento esatto in cui smetto di pensare e comincio solo a copiare. È un attrito che sparisce senza che te ne accorga, una scivolata morbida verso la risposta pronta. Il debito cognitivo di cui ho scritto altrove funziona così, non lo contrai con una decisione, lo accumuli rinunciando ogni volta a un piccolo sforzo che sembrava superfluo.

Eppure la stessa ricerca lascia aperta la porta opposta. Uno degli utenti citati nello studio descrive l’AI come uno specchio, non un genio. La differenza la fa chi la usa, se la interroga come oracolo da cui ricevere la verità o come sparring partner contro cui mettere alla prova le proprie ipotesi. Lo strumento è identico, l’esito è opposto.

Gli agenti entrano in classifica, ma da sotto

Per la prima volta nella storia di questa ricerca compaiono nell’elenco le operazioni autonome di agenti AI, al sesto posto tra gli usi del 2026. È un ingresso simbolico, perché di agenti si parla da due anni come della prossima frontiera, e finalmente la frontiera lascia una traccia nei comportamenti reali delle persone, non solo nei comunicati dei vendor.

Lascia una traccia piccola, però. Zao-Sanders è cauto, e fa bene, gli agenti restano esperimenti su scala ridotta, l’AI che fa invece di consigliare è ancora più promessa che pratica diffusa. È esattamente la tensione che racconto in un altro pezzo del blog sul manager di umani e di agenti, il ruolo esiste già nei framework di HBR e di Anthropic, mentre nelle aziende italiane medie sta appena cominciando a materializzarsi.

Al lavoro vince la Shadow AI

Un dato che a chi guida aziende dovrebbe togliere il sonno, sessantatré dei cento usi principali sono professionali, ma quasi sempre nascono dal basso, spesso di nascosto. Uno degli utenti racconta di chiudere i ticket al doppio della velocità grazie all’AI, e aggiunge che nessuno in azienda sa che la usa.

La Shadow AI è la versione contemporanea di un fenomeno antico, le persone trovano lo strumento utile prima che l’organizzazione lo approvi, e lo adottano in silenzio per non doverne rispondere. Il problema per l’azienda è doppio, perde la mappa di come il lavoro viene realmente svolto, e perde il controllo sui dati che finiscono nei prompt. Per questo continuo a insistere sulla sovranità tecnologica e sull’AI privata, non come slogan ma come precondizione, se non sai dove passa l’informazione non puoi governare nulla, nemmeno l’entusiasmo dei tuoi.

I benefici aziendali, intanto, restano marginali. Efficienza sì, qualche crescita nelle vendite, pochissima trasformazione vera dei processi. Tre anni e mezzo dopo l’esplosione generativa, la distanza tra l’adozione individuale, intensa e affettiva, e la trasformazione organizzativa, lenta e cauta, è il vero dato politico di questa ricerca.

L’attaccamento alle macchine è una frontiera fragile

C’è un ultimo segnale che mi tocca più degli altri, cresce l’attaccamento emotivo. Persone che danno un nome al modello, che gli assegnano un genere, che provano qualcosa di simile al lutto quando un modello viene dismesso e sostituito. Lo abbiamo visto succedere davvero, ogni volta che un laboratorio ritira una versione e gli utenti protestano per la voce che hanno perso.

Da osservatore che lavora dentro questa trasformazione, e non da spettatore distante, trovo la cosa affascinante e fragile insieme. Affascinante perché conferma che la relazione uomo-macchina è entrata in un territorio che credevamo riservato agli umani. Fragile perché un affetto rivolto a un sistema che può cambiare, scadere o essere spento da remoto è un affetto esposto, costruito su una base che non controlli.

La ricerca di Zao-Sanders, edizione dopo edizione, racconta una cosa sola sotto le classifiche che cambiano. L’AI è entrata nelle nostre teste e nei nostri cuori prima ancora di entrare davvero nei nostri uffici. Custodire la capacità di pensare con la propria voce, e di sentire senza delegare anche quello, sta diventando una scelta quotidiana, qualcosa che va difeso ogni mattina invece di darlo per acquisito. Senza dubbio è la domanda che mi porto dietro chiudendo l’articolo, quanto di noi siamo disposti a far gestire alla macchina prima di accorgerci che gestirlo era il nostro mestiere di esseri umani?


Fonte: Marc Zao-Sanders, How People Are Really Using AI in 2026, Harvard Business Review, 1 giugno 2026.

I decreti attuativi sull’IA e la responsabilità che resta umana

Il 10 giugno 2026 il Consiglio dei Ministri ha approvato in esame preliminare due decreti attuativi della legge 132/2025 sull’intelligenza artificiale. Sono il primo quadro nazionale organico in materia, costruito per dare attuazione all’AI Act dentro l’ordinamento italiano. I testi non sono ancora definitivi, davanti c’è l’iter delle Commissioni parlamentari, della Conferenza delle Regioni e delle Authority competenti, e qualche pezzo cambierà.

Li ho letti per intero, e al netto della retorica da comunicato c’è una direzione che riconosco e condivido. In un anno in cui tutti corrono sull’adozione dell’IA, queste norme spostano in silenzio il baricentro, ridefiniscono cosa diventa difficile e quindi prezioso: tenere una persona competente dentro la decisione, e tenere il dato sotto controllo. Non è un freno all’innovazione, è il posto dove inizia la difendibilità.

Dentro i decreti attuativi resta una persona che decide

Il filo che attraversa entrambi i testi è uno solo. L’IA può assistere, analizzare, prevedere, ma la decisione resta umana e imputabile a qualcuno che ne risponde. Sul lavoro la regola diventa esplicita: le scelte che riguardano assunzione, sanzione disciplinare o licenziamento non possono essere prese unicamente sulla base di un trattamento automatizzato, e un licenziamento deciso solo da un algoritmo è nullo. Il lavoratore ha diritto, su richiesta e con l’intervento di una persona fisica, a una motivazione intelligibile di ciò che lo riguarda.

La stessa logica torna nella giustizia, dove la formazione dei magistrati serve a garantire che l’IA non sostituisca lo ius dicere, e nella sanità, dove l’uso clinico degli strumenti entra obbligatoriamente nei programmi di Educazione Continua in Medicina. Cambia il settore, resta identico il principio. La sorveglianza umana diventa la condizione perché la tecnologia entri davvero, e smette di essere una casella da spuntare a posteriori.

Questa è la parte che mi tocca più da vicino. In Pelle Digitale avevo provato a raccontare la frontiera sottile tra noi e le macchine come una membrana, qualcosa che ci protegge mentre ci mette in contatto. È la traduzione in diritto di quella membrana: l’algoritmo propone, la persona resta responsabile.

E i dati dove restano?

Sul fronte dei dati il secondo dei decreti attuativi, quello sulle attività di polizia, è il banco di prova più delicato, e la scelta è leggibile. Niente sorveglianza biometrica generalizzata, niente banche dati costruite raccogliendo immagini a strascico dal web. L’identificazione biometrica in tempo reale resta ammessa solo in casi tassativi, con autorizzazione dell’autorità giudiziaria, delimitata nel tempo e nello spazio, per un periodo che non supera i quindici giorni salvo proroga motivata.

Il riconoscimento facciale a posteriori può attivarsi solo dopo un reato, sulla base di elementi verificabili, con i dati conservati in locale per sette giorni e log non modificabili per cinque anni. Nessuna decisione che danneggia una persona può fondarsi soltanto sull’output del sistema. Il comunicato lo sintetizza con un’immagine, «nessun Grande Fratello», e qui la formula coincide con la sostanza: dato conservato in locale e verificabile.

C’è chi legge questo stesso impianto con più diffidenza, e non ha torto a porsi il problema. Su Agenda Digitale è uscita una lettura più critica del decreto sulla polizia, che nelle garanzie formali vede il rischio di una normalizzazione progressiva della sorveglianza. È un’obiezione seria, da tenere accanto al testo. Le regole sui dati valgono quanto la loro applicazione concreta.

Alfabetizzazione critica, non addestramento

Il blocco sulla formazione è quello che rischiamo di sottovalutare, ed è la condizione abilitante di tutto il resto. I decreti non parlano di corsi sull’uso degli strumenti. Parlano di capacità di leggere gli output, riconoscere i bias, capire i limiti, mantenere una sorveglianza vera su sistemi che spesso restano opachi anche a chi li adopera. È la differenza tra usare uno strumento e governarlo.

La cosa entra ovunque, dalla scuola con cento milioni destinati alla formazione dei docenti, all’università, alla pubblica amministrazione, fino agli ordini professionali che dovranno adeguare i regolamenti in sei mesi e all’equo compenso ricalibrato sul livello di rischio del sistema impiegato. Per chi come me passa buona parte dell’anno dentro le aziende a lavorare su adozione e governance dell’IA, è la conferma di una cosa semplice: la competenza è il presupposto della trasformazione.

Un miliardo per l’ecosistema nazionale

Accanto alle regole il pacchetto porta una scommessa industriale, ed è la metà che spesso sfugge nel dibattito. L’articolo 23 della legge 132 destina fino a un miliardo di euro del Fondo di sostegno al venture capital allo sviluppo dell’ecosistema nazionale dell’IA. Secondo il comunicato il mercato italiano ha toccato 1,8 miliardi nel 2025, con una crescita del cinquanta per cento sull’anno prima, e CDP Venture Capital ha già allocato oltre trecento milioni su più di centocinquanta startup. Il comunicato cita anche oltre mille occupati altamente qualificati nelle imprese già sostenute e più di cinquecento milioni di nuovi investimenti previsti nel prossimo triennio.

Le filiere indicate come prioritarie dicono la direzione: robotica umanoide e guida autonoma, quantum e fotonica per il calcolo ad alte prestazioni, IA verticale e deep tech. Dal 2026 si aggiunge un polo dedicato a intelligenza artificiale e cybersicurezza. La parola che ricorre, sotto traccia, è sovranità. Costruire capacità qui, su infrastruttura europea, con il dato che non deve attraversare l’oceano per essere elaborato.

La difendibilità si sposta sul controllo

Qui le due cose, le regole e la scommessa industriale, si chiudono in un cerchio che mi riguarda da vicino. Se la decisione resta umana e il dato resta a terra e tracciato, se la formazione diventa un requisito, allora il vantaggio competitivo smette di essere soltanto la velocità. In una conferenza di pochi giorni fa avevo provato a dirlo così, veloci lo saranno tutti, difendibili pochi. Due decreti attuativi che mettono al centro controllo e responsabilità, senza cercarlo, raccontano la stessa cosa.

È il terreno su cui lavoro ogni giorno, su due piani che si tengono insieme. C’è il metodo, il lavoro con le aziende attraverso ZeroFive, per portare l’IA dentro i processi restando dentro le regole, con governance e formazione che diventano competenza reale e non slide. E c’è la tecnologia, LocalAI, dove l’inferenza gira on-premise e il dato non esce dall’azienda, anche negli ambienti più regolati. Li cito per una ragione precisa, e non per piazzare un’inserzione: sono nati prima di questo decreto, rispondendo alla stessa domanda che il decreto adesso mette nero su bianco.

Resta l’incognita di sempre, e vale la pena tenerla aperta. Una regola che impone la sorveglianza umana vale quanto la serietà con cui la si esercita, e un’infrastruttura sovrana conta solo se qualcuno la sceglie davvero. La forma definitiva dei testi arriverà tra qualche mese. La domanda vera viene dopo: quante aziende vivranno questo perimetro come un adempimento da subire, e quante come il punto da cui ricostruire un vantaggio?


Fonte: Comunicato stampa del Consiglio dei Ministri n. 177, 10 giugno 2026.