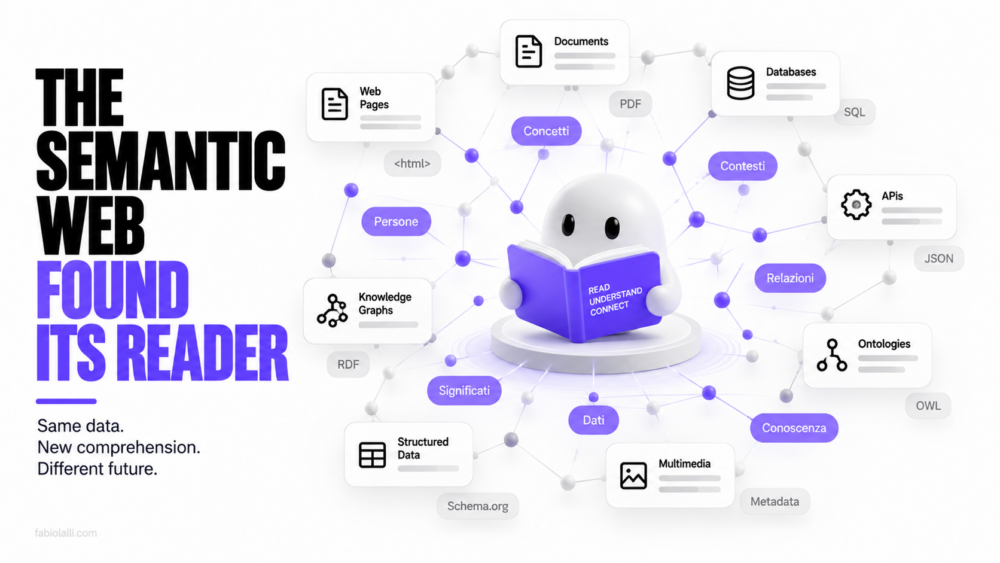
Il web semantico ha aspettato il lettore giusto

Il web semantico ha una data di nascita precisa. Nel maggio del 2001 Tim Berners-Lee firmò con James Hendler e Ora Lassila un articolo su Scientific American in cui descriveva un web fatto di dati leggibili dalle macchine, con agenti software che prenotavano visite mediche incrociando calendari, coperture assicurative e distanze. L’articolo circolò moltissimo, generò standard veri, e la visita medica non la prenotò nessuno.

La scena d’apertura era quasi domestica. Pete e Lucy devono organizzare un ciclo di fisioterapia per la madre, e l’agente di Pete cerca i centri convenzionati con l’assicurazione entro una certa distanza e incastra gli appuntamenti nelle agende dei due fratelli. Quasi nessuno ricorda che quell’agente non capiva una parola di quello che leggeva: funzionava solo perché ogni pagina del web, dagli orari dello studio medico alle condizioni della polizza, era già stata descritta dai suoi autori in un linguaggio formale. Nel 2001 l’agente poteva essere stupido perché il web doveva essere intelligente.

Venticinque anni dopo è andata al contrario: gli agenti hanno imparato a leggere il testo così com’è, il web non è mai stato descritto, e il vocabolario formale che doveva servire a quei software sta tornando nei progetti aziendali con un nome leggermente diverso.

Perché il web semantico non attecchì

Gli strumenti del web semantico furono costruiti sul serio. RDF per esprimere fatti come triple, OWL per definire classi e relazioni, SPARQL per interrogare. Sono tecnologie solide, sopravvissute nei domini dove la semantica vale abbastanza da giustificare la fatica: biomedicina, beni culturali, dati pubblici, editoria scientifica.

Fuori da quei domini non è successo niente, e la ragione è banale quanto decisiva. Annotare costava lavoro umano immediato, il beneficio era differito e andava a qualcun altro, e non esisteva nessuno disposto a pagare quel lavoro. Chi pubblicava una pagina non aveva motivo di descriverne il contenuto in una forma che serviva a un software di cui non conosceva nemmeno l’esistenza.

I motori di ricerca risolsero il problema per la loro strada, estraendo significato dal testo con la statistica invece di chiederlo agli autori, e quella scorciatoia funzionò così bene da togliere ogni urgenza al resto.

Adesso il lettore non è umano

La condizione che mancava era un consumatore che traesse vantaggio dalla struttura e che fosse disposto a pagarla. Quel consumatore adesso c’è, ha un costo marginale per richiesta e appartiene all’azienda che lo fa girare.

Il meccanismo si vede bene dentro un’azienda qualsiasi. Un agente che lavora sulla documentazione interna trova «cliente attivo» nel CRM, dove indica chi ha un contratto aperto, e nella reportistica amministrativa, dove indica chi ha pagato almeno una fattura nell’ultimo anno, e ogni volta deve capire quale dei due sensi vale per la domanda che ha davanti. Lo fa leggendo più contesto, a volte chiedendo, a volte sbagliando, e lo rifà alla richiesta successiva perché quella risoluzione non viene scritta da nessuna parte. Ogni ambiguità non dichiarata si paga di nuovo a ogni lettura, in token e in errori.

È un rovesciamento completo dell’economia del web semantico. Prima il beneficio era esterno e diffuso, e per questo nessuno investiva. Adesso è interno e misurabile sulla bolletta di chi costruisce l’ontologia, e chi la costruisce tiene per sé sia il risparmio sia il vocabolario. Il conto che arriva a fine mese misura l’ambiguità che nessuno aveva mai messo per iscritto, ed è la prima volta che quella misura esiste.

Per questo l’ontologia sta rientrando dalla porta dell’efficienza dopo aver fallito da quella della condivisione. Il ritorno è privato, con grafi aziendali chiusi, vocabolari che nessuno pubblica e mappature bilaterali fra chi ha bisogno di parlarsi, che è esattamente la condizione in cui la traduzione fra ontologie private si paga per coppia. Del progetto originale resta la tecnica e si perde l’idea di un bene comune, che era la parte per cui valeva la pena scriverne su una rivista.

L’unico pezzo che ha funzionato

Una parte di quel progetto ha funzionato, e vale la pena guardarla perché spiega il resto. Schema.org, il vocabolario nato nel 2011 per descrivere pagine, prodotti, eventi, ricette e recensioni, è oggi sui milioni di siti, e nessuno lo ha adottato per amore della semantica.

Lo hanno adottato perché i motori di ricerca hanno offerto un vantaggio immediato e visibile a chi marcava le proprie pagine, sotto forma di risultati arricchiti, stelline, prezzi e tempi di cottura sotto il link. Un responsabile marketing che vede il proprio risultato occupare più spazio in pagina firma quel lavoro senza chiedersi cosa sia un’ontologia.

È lo stesso meccanismo che oggi sta riportando in vita il resto. La struttura si adotta quando produce un beneficio che si vede entro il trimestre a chi sostiene il costo, e il beneficio che si vede entro il trimestre adesso si chiama spesa di inferenza.

Qualcosa di simile sta già succedendo, in scala più piccola, dal lato degli agenti. Quando Anthropic ha pubblicato il Model Context Protocol, alla fine del 2024, ha chiesto a chi espone un servizio di descrivere ogni strumento con un nome, una spiegazione in linguaggio naturale e uno schema formale dei parametri, e migliaia di sviluppatori lo hanno fatto senza discutere, per lo stesso motivo delle stelline sotto i link: se la descrizione è scritta bene l’agente usa lo strumento, altrimenti lo ignora o lo usa male. Rispetto a Schema.org questi schemi descrivono quello che si può fare, i verbi, e lasciano scoperti i sostantivi, cioè cosa sono le cose su cui si agisce, che è proprio la parte di cui si occupa un’ontologia.

Il modello che costruisce le proprie regole

C’è un secondo motivo per cui adesso funziona, e riguarda il costo dell’annotazione. Estrarre entità e relazioni da un corpus, che venticinque anni fa era lavoro manuale da specialisti, oggi lo fa un modello linguistico con una qualità che in molti domini basta.

La circolarità è evidente e va guardata in faccia. Si usa un sistema statistico per produrre lo schema formale che dovrebbe disciplinare i sistemi statistici, e se l’estrazione sbaglia una relazione, quella relazione diventa struttura, e la struttura viene creduta più del testo da cui è stata ricavata proprio perché è strutturata.

Un errore in un documento resta un errore in un documento. Un errore nel grafo diventa una regola, e le regole hanno la proprietà di sopravvivere a chi le ha scritte, come accade a ogni schema che nessuno ha più l’autorità di emendare.

La stessa dinamica vale per le omissioni. Un’estrazione automatica trova quello che somiglia a ciò che ha visto in addestramento, e le relazioni idiosincratiche di una singola azienda, quelle nate da un accordo particolare o da una vicenda societaria, sono proprio quelle che il modello tende a normalizzare in categorie più comuni. Il grafo che ne esce descrive bene un’azienda media del settore e descrive male la tua, che è l’unica per cui serviva.

La provenienza era già negli standard

Lo stack del 2001 conteneva già una risposta a questa circolarità, ed è la parte che si è usata meno. Nel 2013 il W3C ha pubblicato PROV-O, un vocabolario per registrare l’origine di un dato, cioè l’attività che lo ha generato e il soggetto che ne risponde, pensato proprio per i grafi in cui fatti di provenienza diversa finiscono mescolati.

Applicato all’estrazione automatica diventa una regola di igiene facile da enunciare e faticosa da rispettare: ogni relazione che entra nel grafo si porta dietro il passaggio del documento da cui è stata ricavata e la versione del modello che l’ha estratta. Quando una relazione si rivela sbagliata, quella traccia permette di tornare al passaggio e capire se l’errore sta nel testo o nell’estrazione. Permette anche di trovare tutte le altre relazioni nate dalla stessa fonte o dallo stesso modello, che con buona probabilità condividono il difetto.

Un grafo estratto senza provenienza è una scatola nera con l’aspetto dell’ordine, e correggerlo vuol dire intervenire su una relazione alla volta senza sapere quante altre ne condividano la causa. Con la provenienza il grafo si può interrogare anche sulla propria affidabilità, ed è questo che permette di concentrare la verifica dove serve invece di distribuirla ovunque.

Chi valida quando nessuno legge

Qui torna la parte che il web semantico non ha mai risolto e che l’automazione non risolve da sola, perché riguarda la fiducia nello schema più che la sua costruzione. Un’ontologia estratta va verificata da qualcuno che conosca il dominio, e quella verifica non si può distribuire su tutto il corpus, va concentrata dove le conseguenze pesano.

Il criterio che userei è banale: si controlla a mano quello su cui un agente prenderà decisioni con effetti verso l’esterno, contratti, pagamenti, obblighi verso clienti e autorità, e si lascia all’estrazione automatica tutto il resto, accettando che lì la qualità sia buona e non certa. Chiunque prometta una validazione completa su un grafo di milioni di relazioni sta descrivendo un progetto che finirà male.

Con questo pezzo chiudo la serie sull’ontologia. Abbiamo passato venticinque anni a spiegare alle aziende che descrivere i propri dati era un investimento, e non ha funzionato perché il beneficio non aveva un destinatario. Adesso il destinatario esiste, costa, e manda una fattura ogni mese. Non è il modo in cui speravo che arrivasse, ed è il modo in cui sta arrivando.
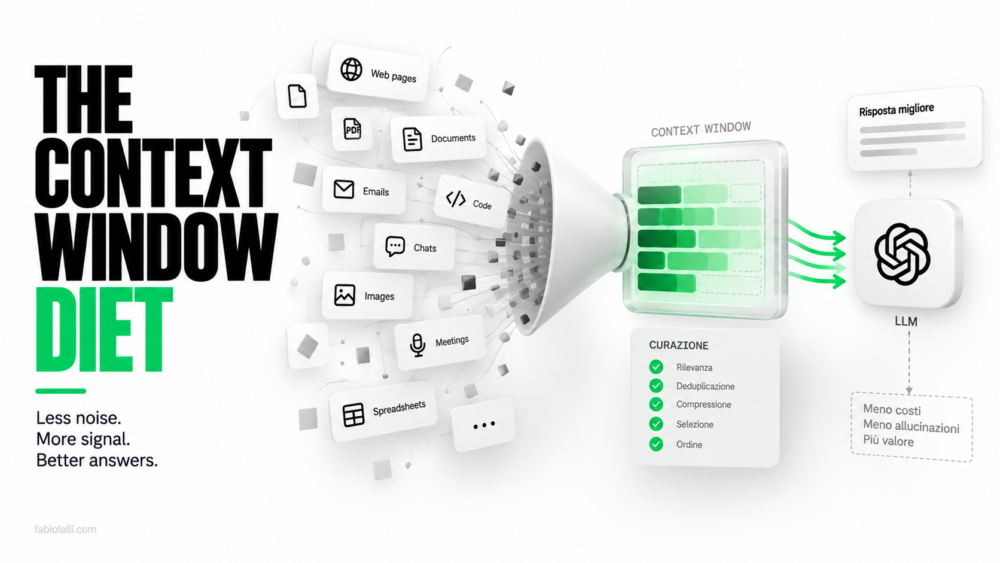
La dieta della finestra di contesto

Quando la finestra di contesto era piccola, il mestiere consisteva nel far stare dentro il necessario. Adesso che ci stanno interi archivi, il riflesso di molti è caricare tutto e lasciare che il modello si arrangi, e la spesa cresce senza che la qualità delle risposte cresca in proporzione.

Una finestra di contesto grande ha risolto un vincolo tecnico e ne ha reso visibile un altro, che riguarda l’attenzione del modello più che la sua capienza.

Il riflesso di caricare tutto

L’abitudine viene dai primi sistemi di recupero, quelli in cui si prendevano i venti frammenti più simili alla domanda e si sperava che la risposta fosse in uno di quelli. Con venti frammenti su un milione di documenti conveniva abbondare, perché il costo di perdersi il pezzo giusto era alto e quello di leggerne qualcuno in più era basso.

Il calcolo cambia quando i frammenti diventano duecento. Il contesto irrilevante non è materiale neutro che il modello scarta senza fatica, è materiale che compete con quello rilevante, e in un testo lungo le informazioni che stanno a metà vengono usate peggio di quelle che stanno agli estremi.

L’effetto della posizione è documentato da tempo. Nel 2023 un gruppo di ricercatori di Stanford guidato da Nelson Liu ha pubblicato Lost in the Middle, uno studio in cui lo stesso documento utile veniva spostato in punti diversi di un contesto lungo, e l’accuratezza dei modelli disegnava una curva a U, alta quando il passaggio giusto stava all’inizio o alla fine e più bassa quando finiva in mezzo. I modelli usciti dopo hanno attenuato quella curva e nessuno ha dimostrato di averla eliminata, per cui più materiale si carica, più aumenta la probabilità che il pezzo decisivo cada proprio nella zona letta peggio.

Più contesto non produce più precisione

Il comportamento si osserva facilmente: prendi una domanda a cui il sistema risponde bene con cinque documenti pertinenti, aggiungi quaranta documenti che parlano dello stesso cliente senza contenere la risposta, e la qualità peggiora. Il modello comincia a citare passaggi vicini al tema e lontani dalla domanda, e quando i documenti si contraddicono fra loro sceglie senza dichiarare di aver scelto.

Chi ha lavorato con archivi reali riconosce lo scenario, perché negli archivi reali la contraddizione è la norma: ci sono tre versioni dello stesso contratto, due delle quali sono bozze mai firmate, e nessuna porta scritto in faccia quale sia quella buona, tanto che la persona esperta la riconosce dal nome del file e dalla cartella in cui sta, informazioni che al modello non arrivano.

Riempire la finestra di contesto solo quando serve

La strada alternativa consiste nel dare all’agente poco materiale e molti modi per chiederne altro. Un indice delle entità, una descrizione di cosa c’è in ciascuna fonte, gli strumenti per interrogarla, e la libertà di fare il secondo giro se il primo non basta.

Anthropic ha chiamato questo approccio contesto just in time, nel testo sul context engineering pubblicato nel 2025, e ha un prezzo che conviene conoscere prima di adottarlo. Ogni giro in più è una chiamata in più, con la sua latenza e i suoi token, e un agente che deve chiedere il materiale funziona solo se sa cosa chiedere: quando l’indice è vago o la descrizione delle fonti è scritta in fretta, l’agente non sa che esiste il documento che gli servirebbe e risponde con quello che ha. La qualità si sposta dal recupero alla descrizione delle fonti, che diventa il testo più letto dell’azienda senza che nessuno lo abbia mai curato come tale.

Il grafo funziona bene in questo schema, perché ti permette di portare nella finestra di contesto solo il perimetro rilevante e di tenere tutto il resto raggiungibile senza essere presente. In una richiesta sui contratti in scadenza entrano l’identificativo del cliente, le entità collegate, i contratti agganciati, e non entra la corrispondenza commerciale degli ultimi tre anni, che pure parla di quel cliente in ogni riga. È lo stesso meccanismo per cui quattro collegamenti costano meno di quaranta documenti, guardato dal lato di cosa entra in finestra.

Il middleware che smista le richieste ai modelli sceglie il modello giusto per ogni richiesta, e qui il criterio è lo stesso applicato al materiale invece che al motore.

Il criterio che uso per decidere cosa entra

La domanda che mi pongo davanti a ogni pezzo di contesto è se la risposta cambierebbe senza. Se la risposta resta uguale, quel materiale sta pagando affitto senza produrre niente, e va spostato dietro uno strumento che l’agente può chiamare se gli serve.

La seconda domanda riguarda la durata. Le istruzioni su come comportarsi valgono per tutta la conversazione e conviene tenerle stabili, i dati di un singolo caso valgono per quella richiesta e conviene farli entrare e uscire. Mescolare le due cose produce contesti che crescono a ogni turno e che a un certo punto contengono il residuo di tre richieste fa.

La terza riguarda chi ha scritto quello che sta entrando. Un documento generato da un altro agente e non verificato da nessuno pesa quanto un documento approvato, e il modello non distingue fra i due. Vale la pena incrociarla con il modo in cui il corpus aziendale si gonfia da solo, perché il materiale che compete con quello buono aumenta a ogni riassunto prodotto per riflesso.

Quando il lavoro dura ore

Un agente che porta avanti un compito lungo, fatto di decine di passaggi, incontra il limite della finestra anche quando ogni singolo passaggio è sobrio, perché la storia della sessione si accumula e ogni turno si porta dietro tutti quelli precedenti. Nello stesso testo Anthropic descrive due modi di gestirla: la compattazione, che a un certo punto riassume la conversazione e la fa ripartire con il riassunto al posto del verbale, e le note strutturate, con l’agente che tiene su un file esterno lo stato del lavoro e le decisioni prese, e le rilegge quando servono invece di portarsele dietro a ogni turno.

Entrambe le tecniche spostano una parte del contesto dentro un testo che nessuno ha verificato. Il riassunto della compattazione decide quale parte della conversazione sopravvive, e lo decide il modello con lo stesso criterio statistico che lo porta a preferire il generico allo specifico, mentre le note sono scritte dall’agente su sé stesso. Il terzo criterio torna qui, applicato al materiale che l’agente produce per proprio uso: un riassunto scritto da un modello entra nella finestra successiva con la stessa autorevolezza di un’istruzione scritta da una persona.

Conviene allora separare nel riassunto le decisioni dalle osservazioni, conservare le prime alla lettera e lasciare comprimere solo le seconde, perché una decisione parafrasata due volte finisce per dire qualcosa di diverso da quello che era stato deciso.

Misurare invece di stimare

Il modo per uscire dalle impressioni è tenere due numeri per ogni tipo di richiesta ricorrente: quanti token entrano nella finestra di contesto e quante risposte risultano corrette su un campione che qualcuno ha verificato a mano. Il primo lo dai già per scontato perché arriva in fattura, il secondo richiede un lavoro che quasi nessuno fa e senza il quale il primo non si può ottimizzare, perché tagliare contesto abbassa sempre il costo e a volte abbassa anche la qualità.

Con i due numeri accanto la prova diventa banale: si toglie una fonte per volta e si guarda cosa succede alle risposte corrette. Nelle configurazioni che ho visto ottimizzare così, la metà del materiale caricato non sposta niente, e il quarto che conta davvero è sempre lo stesso in tutte le richieste dello stesso tipo, il che suggerisce di smettere di recuperarlo dinamicamente e di scriverlo una volta nelle istruzioni.

Gli scarti utili

Una parte di quello che resta fuori vale comunque la pena tenerla a portata. Le eccezioni, i casi che l’anno scorso hanno rotto il processo, le decisioni prese in deroga: sono materiale che non serve quasi mai e che quando serve vale molto più di tutto il resto.

È il tipo di conoscenza che in azienda sta nella testa di due o tre persone e che scompare quando quelle persone cambiano ruolo. Un sistema costruito bene non la carica a ogni richiesta, la rende raggiungibile con una chiamata e la mostra quando il caso somiglia a uno di quelli. È anche la parte che più raramente qualcuno si preoccupa di mettere per iscritto, perché non serve a chi già la sa.

L’entropia dei tuoi dati si paga a token

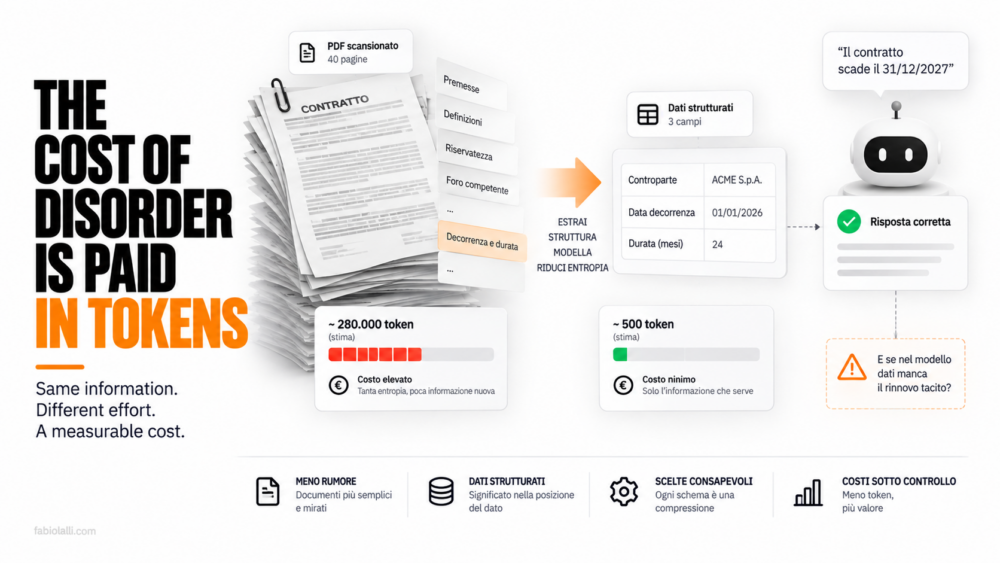
L’entropia di un archivio aziendale si vede bene prendendo lo stesso contratto in due forme. Nella prima è un PDF scansionato di quaranta pagine, con il tracciato di firma in fondo e la data di scadenza dentro un periodo che comincia a metà della pagina ventidue. Nella seconda è una riga con tre campi, controparte, data di decorrenza, durata in mesi. Un agente a cui chiedi quando scade risponde in entrambi i casi, e nel primo paga una quantità di lavoro che non serve a nessuno.

Quel lavoro ha un nome preso in prestito dalla teoria dell’informazione, entropia, e in azienda si è sempre potuto ignorare perché a sostenerlo erano le persone. Da quando esiste una bolletta, l’ambiguità organizzativa ha un prezzo leggibile, e il disordine dei documenti è la parte di quel prezzo che si misura più in fretta.

Lo stesso contenuto in due forme diverse

Un modello legge sequenze di token, e non ha modo di sapere in anticipo quali porzioni di quelle sequenze contengano la risposta. Nel PDF scansionato deve attraversare le premesse, le definizioni, le clausole di riservatezza e il foro competente prima di arrivare alla durata, e quelle pagine entrano in finestra tutte quante, pagate a peso.

Nella riga con tre campi la struttura ha già fatto il lavoro di selezione. Il significato è nella posizione del dato, non nella prosa che lo circonda, e la posizione costa pochissimo perché è decisa una volta per tutte le righe della tabella.

La differenza fra le due forme non sta nella quantità di informazione, che è la stessa, sta in quanto lavoro serve per estrarla. Un archivio di documenti scritti bene per un lettore umano è un archivio costoso per un lettore che paga a token.

Entropia bassa, volume alto

Vale la pena ricordare cosa succede a monte. La tokenizzazione spezza il testo in unità statistiche, e quelle unità non corrispondono ai concetti: la stessa clausola espressa in italiano burocratico occupa sensibilmente più token della stessa clausola espressa in forma tabellare, e il modello non sa che sta rileggendo per la terza volta una formula che ha già incontrato in altri ottocento contratti dello stesso tipo.

Il boilerplate contrattuale è il caso limite di entropia bassa che costa cara. Ripetitivo fino alla noia, quindi povero di informazione nuova, e allo stesso tempo voluminoso, quindi costoso. L’informazione che cambia da contratto a contratto sta in poche decine di parole sparse in mezzo a decine di migliaia.

Ogni schema è una perdita decisa in anticipo

Qui arriva la parte che mi interessa di più, perché è dove la questione smette di essere tecnica. Modellare significa scegliere quali campi esistono, e un campo che non esiste nello schema diventa invisibile a chiunque interroghi il sistema attraverso quello schema.

Se il modello dati prevede controparte, decorrenza e durata, ma non prevede il rinnovo tacito, l’agente risponderà con sicurezza che il contratto scade il trentuno dicembre, e quel contratto si rinnoverà da solo per altri dodici mesi mentre tutti guardano la data sbagliata. Lo stesso vale per la penale di recesso, per il preavviso differenziato a seconda della parte che recede, per le proroghe negoziate a voce e messe per iscritto in uno scambio di email che nel grafo non entra.

La compressione è la ragione per cui l’ontologia fa risparmiare, e la perdita è il prezzo di quel risparmio. Il problema non è che ci sia una perdita, è che venga decisa da chi disegna lo schema senza che nessun altro se ne accorga. Vale la pena tenerlo accanto alla questione che avevo sollevato su dove finisce l’ontologia e comincia l’agente, perché uno schema definisce insieme cosa si può capire e cosa si può fare.

Il corpus cresce da solo

C’è un fattore nuovo che peggiora il conto, e riguarda chi quei documenti li produce. Da quando in azienda si generano testi con l’AI, il volume di prosa interna aumenta senza che aumenti la quantità di decisioni prese, e quei testi entrano nei repository insieme agli altri.

Ne ho scritto parlando di quella broda di testi che nessuno ha deciso di scrivere, e il collegamento con la bolletta è diretto: ogni verbale generato, ogni riassunto prodotto per riflesso, ogni versione alternativa di un documento salvata perché non si sa mai, aumenta l’entropia del corpus che gli agenti dovranno attraversare. Ti stai facendo pagare due volte lo stesso disordine, una quando lo produci e una quando lo interroghi.

Da dove si comincia a misurare

Il modo pratico per capire quanto stai pagando è partire dalle domande invece che dai dati. Prendi le dieci richieste che in un mese arrivano più spesso a un ufficio, quelle a cui qualcuno risponde aprendo sempre gli stessi tre posti, e per ciascuna conta quanti documenti bisogna attraversare per arrivare alla risposta e quante di quelle pagine contengono davvero il dato.

Il rapporto fra le due quantità è la misura di entropia che serve, e nelle aziende dove ho fatto questo esercizio il risultato oscilla fra il ridicolo e l’imbarazzante, con decine di pagine lette per estrarre un numero, una data e un nome. Un essere umano quel rapporto lo migliora da solo, perché impara dove guardare e salta il resto. Un agente senza struttura ricomincia ogni volta dalla prima pagina.

Da lì la decisione diventa gestibile, perché riguarda un numero finito di campi. Non serve modellare l’azienda, serve modellare le venti entità e le trenta relazioni che stanno dietro a quelle dieci domande, e tutto il resto può aspettare il giorno in cui qualcuno lo chiederà davvero.

Chi sostiene il costo della struttura

Strutturare è lavoro, lo fa qualcuno, e quel qualcuno di solito è lontano da chi riceve il beneficio. L’ufficio che deve compilare tre campi in più al momento della firma non vedrà mai il risparmio sulla spesa di inferenza del trimestre successivo, e nelle organizzazioni dove il costo e il beneficio stanno in due linee di budget diverse questa asimmetria basta a fermare tutto.

Il modo che ho visto funzionare è agganciare la struttura a un momento in cui qualcuno sta già lavorando su quel dato. La data di scadenza la si estrae quando il contratto si firma, non in un progetto di bonifica sei mesi dopo, perché in fase di bonifica costa il doppio e la qualità è peggiore.

Un archivio disordinato ha sempre avuto un costo, pagato in ore di ricerca, in scadenze mancate, in due persone che cercano lo stesso documento senza sapere l’una dell’altra. La differenza di adesso è che quel costo arriva in una forma che la funzione finanza sa leggere, e le cose che la funzione finanza sa leggere prima o poi finiscono in un piano.

Quanto ti costa un’ontologia che non hai scritto

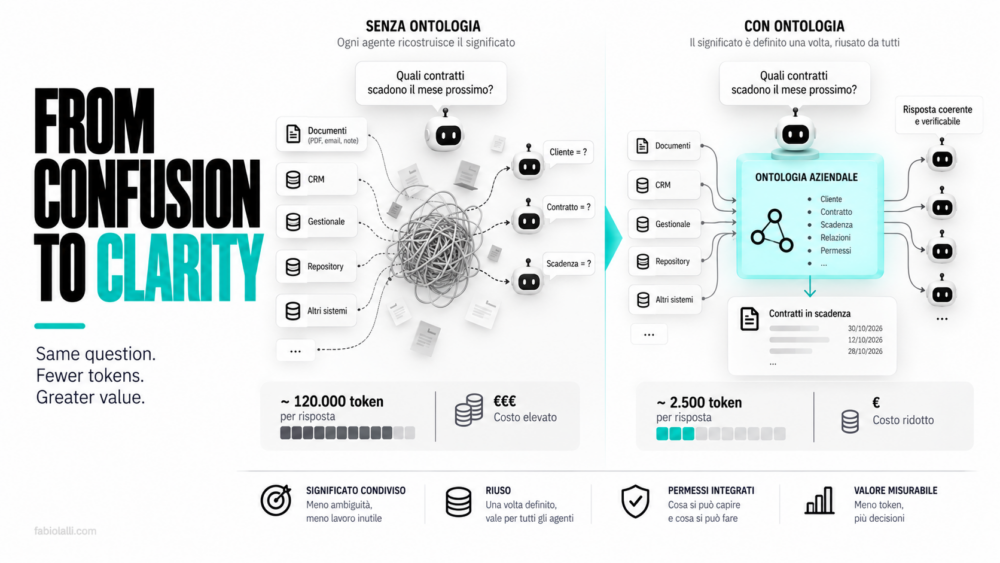
«Quali contratti scadono il mese prossimo?» è una domanda a cui un agente risponde due volte. La prima volta ricostruisce l’ontologia implicita della tua azienda, cosa intendi per cliente, per contratto e per scadenza, la seconda cerca la risposta vera. Solo la seconda parte produce qualcosa che ti serve, la prima la paghi in token a ogni chiamata, e alla chiamata successiva ricomincia da capo.

Lo argomenta un post che gira su LinkedIn in questi giorni, scritto da chi costruisce sistemi multi-agente e si è accorto di bruciare i limiti di token non tanto sul lavoro richiesto, quanto sul preambolo: agenti che si spiegano a vicenda cosa significano le parole dell’azienda. L’ontologia, che per vent’anni è stata materia da convegno di knowledge management, ricompare come voce di costo.

Il conto dell’ambiguità arriva a ogni chiamata

Cliente vuol dire entità legale, account di fatturazione o capogruppo, e scadenza vuol dire fine del contratto o termine ultimo per disdire? In azienda si risponde in modo diverso a seconda di chi fa la domanda e in quale ufficio lavora, e nessuno ha mai avuto un motivo abbastanza forte per fissare quelle definizioni per iscritto.

Il costo di quell’ambiguità c’è sempre stato, distribuito in modo così fine da risultare invisibile: due dashboard che danno numeri diversi, la riunione del venerdì per decidere quale dei due si porta al consiglio, il commerciale che considera cliente il gruppo mentre l’amministrazione considera cliente la singola ragione sociale. Nessuna di queste voci è mai finita su una riga di bilancio.

Con gli agenti quel costo diventa misurato. Ogni esecuzione paga la ricostruzione del significato, la paga per ciascun agente coinvolto, e la paga una terza volta quando due agenti arrivano a interpretazioni diverse e devono riconciliarle fra loro. Fai il conto con numeri inventati ma coerenti: una routine che gira dieci volte al giorno, tre agenti che ogni volta ricostruiscono lo stesso perimetro di significato, trenta giorni, e arrivi a novecento ricostruzioni mensili della stessa definizione, che sarebbe bastato scrivere una volta sola.

Un’ontologia implicita ce l’hai già

Non avere un’ontologia non vuol dire non averne una, vuol dire averne una per agente, scritta senza deliberazione da chi ha toccato per ultimo il prompt di sistema o la pipeline di retrieval. Uno sviluppatore che decide come filtrare la tabella dei clienti sta prendendo una decisione commerciale, e nessuno gliel’ha chiesto.

È lo stesso meccanismo che ho descritto parlando di chi scrive il protocollo quando due agenti non sono d’accordo: dove l’organizzazione non ha deliberato niente, la deliberazione avviene lo stesso, dentro un file di configurazione, per mano di qualcuno che stava lavorando ad altro e aveva bisogno di andare avanti.

Scrivere l’ontologia serve soprattutto a spostare quella decisione dove appartiene. La definizione di cliente riguarda chi vende e chi firma i contratti, dovrebbe arrivare all’agente già stabilita, e dovrebbe essere la stessa per il report al consiglio e per la routine notturna che manda i solleciti.

Quattro passaggi invece di quaranta documenti

Un’organizzazione è uno spazio di ricerca enorme. La risposta sui contratti in scadenza sta sparsa fra il CRM, il repository contrattuale e il sistema di fatturazione, e un agente che parta da zero ha davanti a sé migliaia di documenti che nominano quel cliente senza dire niente di utile sulla sua scadenza.

Un knowledge graph costruisce la rete stradale fra quei sistemi: cliente, entità contraente, contratto, data di scadenza, record di origine. L’ontologia stabilisce cosa significano quelle relazioni, il grafo collega le entità reali e punta ai record dove sta il dettaglio. I documenti restano dove sono, nei sistemi che li hanno generati, e l’agente autorizzato percorre quattro collegamenti invece di aprire tutto quello che contiene la parola cliente.

Il risparmio nasce dal riuso, e vale la pena dirlo perché è facile aspettarsi troppo. Le definizioni all’agente gliele devi comunque passare, occupano comunque spazio in finestra, e il vantaggio sta nel passarle una volta nella forma decisa dall’azienda invece di farle dedurre a ogni giro da quello che capita sotto mano. Sposti un lavoro di inferenza che oggi avviene a runtime, ogni volta uguale e ogni volta un po’ diverso, dentro un artefatto deciso una volta e conservato.

L’informazione in azienda abbonda, la finestra di contesto no. Buona parte del lavoro serio sugli agenti gira intorno a questo vincolo, e il grafo lo affronta dall’esterno, riducendo le chiamate di retrieval e il contesto irrilevante che finisce in finestra a ogni giro.

In Pelle Digitale ho descritto la superficie sottile che ci separa dalle macchine e decide cosa passa. Dentro un’azienda quella superficie prende una forma burocratica, ed è l’ontologia a stabilire cosa un agente può vedere del modo in cui lavori, in quale ordine e con quale grado di dettaglio.

Costo per risposta corretta, manutenzione inclusa

L’autore del post chiude con il criterio che userebbe per decidere se la struttura vale la spesa: costo per risposta corretta su compiti ripetuti, manutenzione compresa. Il criterio mi pare solido, e ha un presupposto scomodo.

Per misurare il costo per risposta corretta devi sapere quali sono le risposte corrette. Serve un insieme di casi con la risposta nota, tenuto aggiornato, contro cui far girare il sistema ogni volta che cambia qualcosa. Quasi nessuna azienda ce l’ha, quasi nessuno lo mette a budget, perché non produce niente che si possa mostrare in una demo. Il progetto ontologia e il progetto valutazione sono lo stesso progetto, e il secondo è quello che salta quando il budget si stringe. Scrivendo del middleware che smista le richieste ai modelli ero arrivato allo stesso punto da un’altra direzione: i dati di valutazione interni valgono più del modello che scegli.

La manutenzione è l’altra metà del conto. Un’ontologia che nessuno aggiorna quando cambia la struttura societaria, quando si acquisisce un ramo d’azienda, quando il contratto tipo viene riscritto, comincia a produrre risposte sicure e sbagliate. Un agente senza ontologia brucia token e resta nel dubbio, e nel dubbio chiede. Un agente con un’ontologia vecchia costa pochissimo e non chiede niente a nessuno.

Perché l’aggiornamento avvenga davvero serve che qualcuno lo debba fare, con nome e cognome, e che il momento in cui farlo sia agganciato a processi che in azienda esistono già: la delibera che approva un’acquisizione, la riscrittura del contratto quadro, il cambio di ragione sociale registrato in anagrafica. Un’ontologia mantenuta da un gruppo di lavoro che si riunisce quando riesce dura un paio di trimestri, poi resta lì a rispondere con le categorie di due anni prima mentre tutti si fidano.

Sapere cosa significa non basta per agire

Ad agosto, leggendo la mappa di Fanghua Yu sull’evoluzione dell’ontologia dalla semantica formale agli agenti, mi ero fermato su dove finisce l’ontologia e comincia l’agente: sapere cosa significa un ordine non dice niente su chi sia autorizzato ad agire su quell’ordine oggi, e su chi possa revocare quel permesso domani mattina.

Le due cose conviene costruirle insieme. Il grafo che fa risparmiare token è lo stesso che delimita il perimetro, perché un agente che percorre collegamenti invece di rovistare fra i documenti rende quei collegamenti il posto naturale dove scrivere chi passa e chi si ferma. Chi costruisce l’ontologia per la bolletta e rimanda il permesso a una fase successiva si ritrova con una rete di strade senza caselli, percorribile da qualsiasi agente sia stato collegato quella settimana.

La bolletta dell’inferenza sta diventando il primo strumento che mette un prezzo sull’ambiguità organizzativa, e lo fa in fondo al mese, su una riga sola, senza distinguere fra quanto hai speso per rispondere e quanto per capire la domanda. Le aziende che spenderanno meno saranno quelle che avevano già scritto cosa intendono per cliente prima che arrivassero gli agenti a chiederlo, dieci volte al giorno, ognuno per conto proprio.


Spunto: un post su LinkedIn dedicato alle ontologie come leva di risparmio sui token nei sistemi multi-agente, che rimanda alla raccolta The Knowledge Graph Guys.

AI bill shock: la bolletta dei token è arrivata, come previsto

Il conto è arrivato, e ha pure un nome. Da mesi, tra le chiamate con i clienti e i pezzi che scrivo, ripeto la stessa cosa: il costo dei token non è un dettaglio da smanettoni, è la prossima voce che finisce sul tavolo del CFO. A marzo lo scrivevo su AI4Business, parlando di governo economico dei token come disciplina ancora da costruire. A maggio, qui sul blog, mettevo per iscritto che sarebbe arrivato sotto forma di budget esplosi a fine mese.

Questa settimana CorCom lo ha chiamato AI bill shock, riprendendo un’analisi di Analysys Mason: la spesa a consumo per modelli generativi, Api e agenti autonomi rende i budget aziendali sempre meno prevedibili, al punto da riportare sul tavolo di molti CIO l’idea di possedere un pezzo della propria infrastruttura invece di affittarla sempre. I numeri sotto contano più del titolo. Il budget è solo la parte più visibile: sotto ci sono i dati, la compliance, il controllo dell’infrastruttura su cui gira la tua azienda.

300 aziende, un balzo del 500%

Tra aprile e maggio circa 300 aziende hanno sollevato la questione dei costi legati ai token durante le chiamate agli investitori sui risultati trimestrali, contro le 93 dello stesso periodo dell’anno precedente. Lo racconta AI4Business citando Paul Roetzer e Mike Kaput del Marketing AI Institute. La Royal Bank of Canada ha visto il proprio consumo di token salire del 500% in sei mesi. Cisco descrive i propri volumi come fuori da ogni norma conosciuta.

Amazon, Walmart, Uber, Cisco e Meta, secondo quanto riportato dal Financial Times e ripreso sempre da AI4Business, hanno già introdotto tetti di spesa o indicazioni più severe su quando vale davvero la pena accendere un modello. Uber ha fissato un tetto di 1.500 dollari al mese per dipendente dopo aver esaurito, già ad aprile, l’intero budget AI previsto per il 2026. Amazon ha spento la classifica interna che misurava quanto i dipendenti usassero l’AI, dopo aver scoperto che alcuni ingegneri facevano girare bot autonomi solo per scalare la graduatoria: è il fenomeno che va sotto il nome di tokenmaxxing, la corsa alla vanità mascherata da adozione.

A Workato, azienda da 1.300 dipendenti, la spesa è aumentata di sette volte in un solo giorno quando Anthropic ha spostato l’azienda su un pricing basato sui token, a maggio. Goldman Sachs Research stima che l’uso degli agenti possa moltiplicare per 24 il consumo di token entro il 2030. E sul mercato aperto dei modelli, secondo i dati di OpenRouter ripresi dal Financial Times, i modelli cinesi hanno già superato quelli americani per consumo di token: quando il prezzo diventa il primo criterio di scelta, a vincere è chi costa meno, non chi segna il punteggio più alto sui benchmark.

Il token non misura il lavoro fatto

Più del volume, a ingannare è la natura della metrica. I fornitori fanno pagare i token di output da due a cinque volte più di quelli di input, perché generare una risposta costa computazionalmente più che leggerla: il modello prevede una parola alla volta, in sequenza, mentre l’input lo processa in un solo passaggio. Due flussi di lavoro che sembrano identici per volume possono avere costi molto diversi a seconda di quanto testo producono rispetto a quanto ne ricevono, e quasi nessuna azienda, quando firma il contratto, ci pensa davvero. Un prompt di 1.500 parole, quasi 2mila token, che produce una sintesi di 600 parole, circa 800 token, costa già un paio di centesimi con un modello come Claude 3.5 Sonnet: sembra nulla, finché non lo moltiplichi per centinaia di richieste al giorno e per ogni team che nel frattempo ha acceso un proprio agente senza dirlo a nessuno.

Gli agenti aggravano la cosa, perché a ogni passaggio ritrasmettono l’intero contesto della conversazione: alla decima fase di un compito, il modello rilegge integralmente le prime nove. AI4Business fa un esempio concreto, quello di un assistente per il servizio clienti che accede a una base di conoscenza di 20mila token: per mille richieste al giorno, genera 20 milioni di token quotidiani solo per rileggere sempre gli stessi dati, circa 60 dollari al giorno spesi prima ancora di rispondere a un cliente vero. Se l’agente si blocca in un loop, o richiama più volte lo stesso strumento, il conto sale prima che qualcuno se ne accorga.

L’AI bill shock non è un problema di cassa

Affidare l’inferenza a un fornitore esterno porta con sé più di un conto a consumo: la sua politica dei prezzi, i suoi limiti di utilizzo, le sue scelte su dove vivono i tuoi dati, la sua libertà di cambiare le regole senza preavviso. Il pricing può cambiare le regole da un mese all’altro, come è successo a Workato quando Anthropic l’ha spostata su un modello a consumo. Un fornitore può introdurre un tetto di utilizzo che scopri solo quando lo tocchi, a metà di una sessione di lavoro, come raccontano diversi utenti citati da AI4Business. Un governo può spegnere l’accesso a un modello, come abbiamo visto succedere quest’anno. E quando arriva un audit di conformità, la domanda su dove sia passato un dato aziendale durante l’inferenza, su quale server, sotto quale giurisdizione, spesso non ha una risposta scritta da nessuna parte.

Bain, in un sondaggio su 951 aziende pubblicato a giugno, trova che quasi il 40% di chi ha misurato i risparmi da AI è rimasto sotto il 10%, contro un obiettivo dichiarato dell’11-20%. Michael Heric, uno degli autori della ricerca, spiega che per molte aziende il business case si ferma alla spesa in token e non arriva mai a contare i costi di data engineering, di governance, di conformità che le girano intorno. Il 90%, nonostante tutto, aumenta comunque il budget per l’anno prossimo, prova che nessuno ha ancora imparato a misurare il ritorno dell’AI con lo stesso rigore con cui ne misura il costo.

LocalAI lavora esattamente in questa direzione: porta l’inferenza dentro il perimetro dell’azienda invece di affittarla ogni mese da qualcun altro. I costi non spariscono: cambia chi li governa. Sai dove vivono i dati, sai quanto costa davvero un carico di lavoro perché lo possiedi, e nessuno può cambiarti il prezzo o il tetto di utilizzo a metà mese.

Dall’opex che non controlli al capex che scegli

Analysys Mason legge lo spostamento come l’ennesimo giro di un ciclo che l’informatica ha già visto: dal mainframe centralizzato ai minicomputer distribuiti, dal PC in rete al cloud che ricentralizza tutto, e ora l’AI che riapre la stessa domanda. Comprare calcolo come servizio o possederne una parte? Per chi ha volumi di inferenza stabili, la risposta pratica passa quasi sempre dall’ibrido: hardware proprio per i compiti che non hanno bisogno di un modello di frontiera, server dedicati o cloud privato per il resto, il cloud pubblico riservato a ciò che lo giustifica davvero.

Il TCO a tre anni tra cloud e on-premise, calcolato sui prezzi reali di Claude, GPT, Gemini e DeepSeek, conferma la stessa cosa: nella maggior parte degli scenari aziendali italiani l’on-premise vince con margine quando i volumi sono prevedibili, mentre il cloud resta la scelta giusta per i picchi occasionali e per chi parte da zero. La maggior parte del traffico di un’azienda, del resto, non ha bisogno del modello più caro: ha bisogno di un sistema che decida bene dove instradarlo. Quella logica di instradamento, non il modello scelto per ultimo, è ciò che decide chi resta padrone della propria infrastruttura.

Decide il board, non il reparto IT

Il sondaggio di Bain lo conferma da un altro lato: le aziende che centrano i risparmi attesi sono quelle che hanno trattato l’accesso ai dati, la governance e il ridisegno dei processi come materia da consiglio di amministrazione, non da reparto IT. Vale lo stesso per il bill shock. Un alert di budget o un tetto di spesa imposto dall’alto sposta il sintomo, non la causa.

La prima domanda, in questi casi, non riguarda mai il modello. Riguarda dove vivono i dati, chi decide quanto vale un’ora di inferenza, cosa succede se domani il fornitore cambia le regole: non cambia molto se l’azienda ha cinquanta o cinquemila dipendenti, cambia solo quanto in fretta un budget fuori controllo diventa un problema di tutti, non solo di chi ha acceso l’ultimo agente.

La bolletta continuerà a salire, per tutti. La differenza, da qui in avanti, la fa chi ha già deciso come governarla e chi la scoprirà solo a budget già bruciato.


Fonti: CorCom su Analysys Mason; AI4Business, “La crisi dei token che spaventa i budget aziendali”; AI4Business, “AI, le aziende frenano”; Bain & Company, Automation and AI Pathfinder Survey 2026.

Prompt-Chaining: tagliare (il prompt) l’elefante a pezzi e ragionare per passi

Negli ultimi mesi ho seguito e condiviso con attenzione il lavoro di  Nicola Mattina, che attraverso l’implementazione del progetto #Serena (di cui vi parlerò ancora), sta esplorando in modo sperimentale continuo l’interazione uomo-macchina: il prompt chaining.

I suoi post, in particolare uno degli ultimi che riporto qui, mi hanno spinto a riflettere sul fatto che il prompt chaining non è solo una tecnica per “istruire meglio” l’AI, ma può diventare una vera e propria architettura cognitiva. Un modo per strutturare il pensiero delle (e con le) macchine, in modo simile a come strutturiamo il nostro.

Da questo spunto nascono le seguenti righe che condivido qui sotto, ad integrazione del lavoro di Nicola, ossia una breve riflessione sulle potenzialità del prompt chaining, in particolare nella progettazione di contenuti educativi, ma con uno sguardo più ampio su cosa può rappresentare per chi, come molti di noi, lavora con strumenti generativi in contesti strategici o formativi.

Prima di tutto cos’è il Prompt Chaining

In parole semplici, prompt chaining significa collegare insieme più prompt in sequenza, facendo sì che l’output di un prompt diventi l’input del successivo . Invece di chiedere a un modello linguistico di svolgere un compito complesso tutto in una volta, lo si scompone in passi più piccoli e gestibili, rendendo più efficiente l’elaborazione, l’accuratezza ed il consumo sottostante che viene impiegato per elaborare la richiesta.

Per capirci, come succederebbe nella relazione umana, invece di dire ad un copywriter “Scrivimi l’articolo sull’AI” creando la condizione per cui l’interlocutore deve decidere a cosa dare priorità, su quali argomenti soffermarsi e ottimizzare il tempo a disposizione, si chiede qualcosa di più specifico, più nel dettaglio, progressivamente sempre più in profondità, raffinando il concetto.

Ogni prompt nella catena dei prompt si concentra su un sotto-compito specifico, mantenendo il contesto e guidando il modello passo dopo passo . Questo processo iterativo permette all’AI di affrontare compiti complessi in modo più efficace, migliorando accuratezza e coerenza delle risposte .

“Eh, ma Chat è stupido…”

Quando mi sento dire “Eh ma Chat è stupido, mi risponde con testi banali“, spesso rispondo che è normale perchè cosicome esistono principi di LIFO, FIFO e via dicendo, nell’ai più che mai esiste anche il MIMO ossia Merd-In Merd-Out (o come direbbero i fighi Shit-in Shit Out).

Se chiediamo all’AI di scrivere un intero report in un solo prompt, otterremo con molta probabilità un risultato superficiale, disorganizzato o incoerente. Perché? Perché il modello deve fare tutto in una volta sola: strutturare, scrivere, sintetizzare, scegliere priorità, tono e contenuti, senza una guida chiara. È come chiedere a qualcuno di cucinare una cena gourmet mentre corre una maratona. Serve ordine, energia e tempo – ma se tutto viene concentrato in un colpo solo, il risultato ne risente.

Con il prompt chaining, invece, possiamo scomporre il compito in step successivi. Prima chiediamo un elenco dei punti chiave, poi sviluppiamo ciascun punto in un paragrafo, infine rivediamo e affiniamo il testo. Ogni fase prepara la successiva, mantenendo un filo logico chiaro. Questo approccio non solo aiuta l’IA a produrre contenuti migliori, ma ottimizza anche il modo in cui consuma le sue risorse.

Ogni interazione con un modello AI, infatti, utilizza dei token: piccole unità che rappresentano parole, punteggiatura e spazi. Ogni prompt e ogni risposta consumano token, e ogni modello ha un limite massimo oltre il quale inizia a “dimenticare” o a perdere contesto: è la cosiddetta finestra di contesto. Se proviamo a incastrare troppa roba in un solo prompt, superiamo questo limite e il modello rischia di produrre un risultato povero o scollegato.

Qui si nota una differenza concreta tra chi usa la versione Free di ChatGPT (basata su GPT-3.5, con un limite di circa 4.000 token, cioè poche pagine di testo complessivo) e chi ha attivato la versione Plus, che usa GPT-4-turbo, in grado di gestire fino a 128.000 token – l’equivalente di un libro intero. Con GPT-4, quindi, possiamo costruire catene di prompt molto più lunghe, mantenendo la coerenza del discorso e una memoria estesa.

È come viaggiare con un’auto che ha un serbatoio piccolo (GPT-3.5) o con una che può contenere molta più benzina (GPT-4): entrambe ti portano a destinazione, ma nel primo caso dovrai fermarti spesso e ridurre il carico, nel secondo puoi affrontare tragitti più lunghi, con meno compromessi e migliori prestazioni.

Oltre l’ingegneria dei prompt

Il prompt chaining non è solo un modo “furbo” di scrivere prompt, ma si avvicina a una forma di architettura cognitiva. In pratica stiamo progettando la struttura del ragionamento dell’IA. Come un architetto progetta l’organizzazione di un edificio, chi utilizza il prompt chaining progetta come l’IA suddivide e affronta un problema. Ricorda il modo in cui noi umani affrontiamo compiti complessi: li dividiamo in step, li risolviamo uno per uno, e infine uniamo tutto. Allo stesso modo, il chaining fa sì che il modello di AI “pensi ad alta voce” attraverso passaggi intermedi, mimando un processo cognitivo umano .

Non a caso, ricercatori e sviluppatori vedono queste catene di prompt come elementi di agenti AI più evoluti. In diversi studi e articoli si nota che aggiungere flussi di controllo interni come il prompt chaining ai modelli linguistici porta a una nuova generazione di “agenti” IA, capaci di ragionare e interagire in modo più strutturato . In altre parole, concatenare prompt è un modo per orchestrare la cognizione dell’AI: stiamo dando al modello un percorso da seguire, un po’ come una scaletta mentale. Questo approccio apre le porte a sistemi AI più affidabili e “pensanti”, anziché limitarsi a mere scatole nere che sputano fuori una risposta senza farci capire il come e il perché.

Scomporre i problemi per soluzioni migliori

“Perché spezzettare un compito aiuta l’AI a produrre risultati migliori?” mi chiedono spesso in aula. I motivi sono intuitivi. Innanzitutto, ogni parte del problema riceve attenzione dedicata: affrontando un passo alla volta, il modello può dedicare più risorse cognitive a ciascun aspetto, senza essere sopraffatto dalla complessità generale . Questo porta a risposte più complete e approfondite su ogni sotto-tema, migliorandone la qualità complessiva .

In secondo luogo, il prompt chaining aumenta la coerenza e il mantenimento del contesto: ogni prompt successivo eredita le informazioni dai precedenti, evitando che l’AI “dimentichi” dettagli importanti lungo il percorso . Questo è cruciale, ad esempio, quando si crea una narrazione o un progetto articolato, perché garantisce che tutte le parti “parlino la stessa lingua” e si integrino bene.

Un altro vantaggio è la maggiore trasparenza del ragionamento. Richiedendo all’AI di mostrare passo dopo passo il processo (ad esempio elencando ragionamenti o calcoli intermedi), diventa più facile per noi umani seguire il filo logico e capire come si è arrivati a una certa conclusione. Questa tracciabilità (tema che affronterò in modo dedicato in un altro post) non solo aumenta la fiducia nell’output — possiamo vedere perché l’AI suggerisce X invece di Y — ma ci consente anche di individuare eventuali errori logici in itinere.

Infatti, suddividendo il problema, possiamo correggere il tiro a metà strada se notiamo che l’AI sta deviando: il chaining facilita l’isolamento di quale passo ha generato un errore, semplificando interventi e debug. È lo stesso principio su cui si basano i nuovi modelli di AI avanzati, come GPT-4 o Claude Opus, che stanno iniziando a integrare forme esplicite di reasoning interno, strutturato in catene di pensiero (chain-of-thought reasoning), per spiegare le decisioni che prendono. Il prompt chaining è oggi uno strumento manuale per ottenere ciò che i modelli di domani inizieranno a fare da soli: pensare per passaggi visibili e controllabili (e quindi revisionabili).

Infine, questo approccio metodologico aiuta a mitigare i limiti pratici dei modelli. I modelli linguistici hanno una finestra di contesto limitata (una quantità massima di testo che possono gestire alla volta); fornire tutte le istruzioni in un unico prompt lungo può essere inefficace o impossibile. Con una catena di prompt, in sinstesi, si alimenta gradualmente l’informazione restando nei limiti, senza perdere il contesto e allo stesso tempo, si riduce il rischio di allucinazioni fuori tema, mantenendo il modello concentrato su un sub-compito alla volta e reintegrando il contesto ad ogni passo.

Praticamente in questo modo abbiamo una AI sempre “sul pezzo” e le facciamo evitare divagazioni fantasiose.

Progettare un corso con l’AI passo dopo passo

Per rendere concreto tutto questo, immaginiamo di utilizzare il prompt chaining per un compito manageriale comune: progettare un corso di formazione o creare contenuti didattici strutturati.

Invece di chiedere subito all’AI “Scrivi il programma dettagliato di un corso su X”, potremmo procedere per fasi:

  1. Definire l’obiettivo e il pubblico: In un primo prompt, chiediamo al modello di delineare gli obiettivi formativi del corso X e di identificare il pubblico target (es. principianti, livello avanzato, ecc.). Questo stabilisce il contesto e la direzione generale.

  2. Creare un elenco di moduli/lezioni: Con gli obiettivi chiari, un secondo prompt potrebbe chiedere una struttura a moduli o lezioni chiave del corso. L’AI proporrà, ad esempio, 5-10 moduli tematici in sequenza logica.

  3. Dettagliare i contenuti di ciascun modulo: Per ogni modulo individuato, possiamo generare a catena un ulteriore prompt che ne chiede i dettagli: concetti da coprire, esempi pratici, esercitazioni o casi di studio da includere.

  4. Sviluppare materiali o approfondimenti: Una volta approvata la struttura, ulteriori prompt possono concentrarsi sulla creazione di contenuti specifici – ad esempio, “Genera una dispensa introduttiva per il Modulo 1” o “Suggerisci 3 domande quiz per verificare l’apprendimento nel Modulo 2”. Così, gradualmente, si popola l’intero corso.

  5. Revisione e rifinitura: Infine, si può usare un prompt conclusivo per fare un check generale, ad esempio “Rivedi il syllabus completo del corso e verifica che il linguaggio sia adatto a [pubblico target] e coerente in tutti i moduli”. Oppure chiedere un riepilogo executive da presentare al team.

Ad ogni passo, l’output dell’AI alimenta il passo successivo. Il risultato finale è molto più ricco e strutturato di quello ottenibile con un singolo prompt generico. Chi ha sperimentato questo approccio nota che “pensare in catene, anziché tentare il colpo grosso con un solo prompt di quelli da fanta-guru-brillante, ha segnato un punto di svolta e ha raggiunto un goal in modo più preciso” . In altre parole, il prompt chaining aiuta l’AI a seguire un filo logico simile a come lo seguirebbe un istruttore umano, con il vantaggio di poter generare rapidamente contenuti per ogni punto del programma.

Questo approccio non è utile solo per corsi ovviamete: qualunque progetto che richieda output complessi e ben organizzati (dai piani strategici, alla stesura di rapporti articolati, fino alla ricerca di mercato) può trarre beneficio da una suddivisione in prompt sequenziali. Il bello è che il controllo rimane all’utente umano: possiamo intervenire tra uno step e l’altro, aggiustare il tiro o inserire input aggiuntivi, guidando l’IA come faremmo con un collaboratore umano.

Ma non è lo stesso che chiedere “approfondisci”?

Una domanda legittima è: “Ma non è la stessa cosa di quando scrivo un prompt generico e poi chiedo all’AI di approfondire o usare Deep Research”. La risposta è no, non è la stessa cosa — né per approccio, né per controllo, né per qualità del ragionamento.

Quando chiediamo a un’AI “approfondisci questo punto” o “fammi un elenco di motivi”, stiamo delegando completamente al modello la scelta di cosa approfondire, in che ordine e con quale criterio. L’AI fa del suo meglio in base al contesto ricevuto, ma decide lei come interpretare la richiesta e cosa restituire. È un approccio reattivo, utile ma passivo.

Nel prompt chaining, invece, è l’utente a guidare attivamente e intenzionalmente il processo: decide in anticipo i passi, li struttura in modo progressivo e ne controlla coerenza e profondità. Ogni sotto-domanda è pensata come parte di un flusso, e l’output di ciascun passaggio è validato prima di passare al successivo. In altre parole, il chaining costruisce un ragionamento architettato, mentre l’approccio a “prompt singolo + follow-up” si limita a inseguire l’output, senza reale regia.

Questo è il punto di contatto e insieme di differenziazione rispetto ai nuovi modelli con reasoning interno automatizzato, che iniziano a generare da soli le domande intermedie, gli step di verifica o gli scratchpad (una specie di taccuino mentale in cui “annotano” i passaggi logici). In quel caso l’AI sta simulando un flusso cognitivo autonomo, ma resta comunque opaco all’utente se non viene esplicitato. Il prompt chaining, invece, porta alla luce il processo, lo rende trasparente, ispezionabile e — cosa non da poco — intervenibile.

Chiedere “approfondisci” è come affidare un tema all’AI e sperare che interpreti bene la traccia. Il prompt chaining è come costruire insieme all’AI una scaletta, definire ogni paragrafo e correggere lungo il percorso. È la differenza tra reattività e progettualità.

Strumenti e casi emergenti

Il concetto di prompt chaining si è diffuso così rapidamente che sono nati strumenti e framework dedicati. La libreria open-source LangChain ne è un esempio e permette agli sviluppatori di creare facilmente pipeline di prompt collegate, integrando anche memoria esterna e chiamate a strumenti, per costruire agenti AI sofisticati. Esistono anche altre piattaforme più user friendly come Voiceflow e altre soluzioni no-code che offrono interfacce visuali per orchestrare conversazioni multi-turno e flussi di prompt, così che anche chi non programma possa progettare l’interazione step-by-step.

All’inizio del boom di ChatGPT, alcuni esperimenti come AutoGPT hanno mostrato il potenziale di un’AI che autonomamente insegue un obiettivo tramite una sequenza di azioni e sottocompiti. In pratica AutoGPT crea i propri prompt in catena per raggiungere un fine assegnato, simulando un agente quasi “autonomo”. Questi esempi, seppur embrionali, dimostrano la potenza dell’idea: spezzando i problemi e pianificando i passi, l’AI può affrontare anche compiti molto articolati. Non sorprende che aziende come OpenAI, Microsoft e altri stiano investendo in queste direzioni, integrando meccanismi di chaining e ragionamento nei loro sistemi .

Stiamo assistendo ai primi passi di una nuova orchestrazione cognitiva, dove l’intelligenza artificiale non è più vincolata a rispondere istantaneamente a un singolo prompt, ma può elaborare un piano d’azione interno prima di fornire la soluzione. Questo è un cambio di prospettiva entusiasmante, perché avvicina l’operato dell’AI a un processo decisionale più umano e strategico.

Perché oggi tutti dovrebbero interessarsene?

Da un punto di vista manageriale e business, il prompt chaining offre risultati più affidabili e raffinati dalle AI, il che può tradursi in decisioni migliori e contenuti di qualità superiore. Ad esempio, nei team di L&D (Learning & Development) o di content marketing, utilizzare l’AI in modalità “a catena” permette di sviluppare corsi, tutorial, documentazione o white paper in maniera organizzata e coerente, riducendo il lavoro di editing successivo. Si passa da un’AI percepita come scatola magica imprevedibile a un’AI vista come collaboratore logico: un assistente che segue un processo, su cui possiamo intervenire in itinere. Ciò aumenta la fiducia nell’utilizzo e ne amplifica il valore nell’operatività quotidiana.

La trasparenza fornita dai passi intermedi è preziosa per la governance dell’AI in azienda: poter spiegare come una macchina ha elaborato un output (grazie ai ragionamenti esposti nella chain) può essere fondamentale per conformità, auditing o semplicemente per convincere gli stakeholder dell’affidabilità di una soluzione AI. In ambito educativo o formativo, come già notato, l’approccio step-by-step “alla insegnante” migliora l’attenzione ai dettagli e l’efficacia pedagogica . Insomma, il prompt chaining unisce il pensiero analitico umano con la velocità di calcolo dell’IA, offrendo il meglio di entrambi i mondi.

Verso un futuro di AI più “umana”

Il prompt chaining rappresenta uno step avanti: da semplici richieste isolate a una collaborazione più strutturata uomo-macchina. Questa metodologia deve farci notare che l’AI può (e deve) essere guidata a pensare per passi, e che spesso la chiave per risultati straordinari sta nel porre le giuste domande nell’ordine giusto. È un campo in rapido sviluppo, con implicazioni che vanno oltre la tecnologia e toccano l’organizzazione del lavoro e la progettazione di conoscenza.