Cloud sovrano italiano: PSN e AI nel 2026

Per chi non l’ha seguita da vicino, la storia del cloud sovrano italiano sembra un dossier infinito. Strategia Cloud Italia annunciata nel 2021, gara da 4,4 miliardi assegnata nel 2022, primi data center operativi a fine 2022, target intermedi PNRR raggiunti nel 2024, oltre 600 pubbliche amministrazioni aderenti a gennaio 2026. È stata una marcia lunga, con qualche zona d’ombra e diverse svolte. Però è arrivata da qualche parte. Nel 2026 il Polo Strategico Nazionale è un’infrastruttura operativa, con quattro data center attivi (Acilia e Pomezia nel Lazio, Rozzano e Santo Stefano Ticino in Lombardia), oltre 576 amministrazioni che lo usano in produzione, contratti che valgono complessivamente 3,6 miliardi di euro estesi fino al 2035.

Per chi si occupa di AI nelle aziende italiane, il PSN non è un argomento da convegno di settore. È diventato un fattore concreto che incide su almeno tre decisioni operative: dove possono girare i modelli AI delle amministrazioni pubbliche italiane, quali fornitori AI possono lavorare con PA e con grandi corporate strategici, e quali architetture AI private possono dirsi davvero “sovrane” per il mercato italiano. Provo a sciogliere il quadro per chi lavora in questi mercati e deve prendere decisioni informate.

Cosa è davvero il Polo Strategico Nazionale

Il PSN è il terzo pilastro della Strategia Cloud Italia, accanto al cloud pubblico qualificato (servizi cloud commerciali certificati per la PA) e al cloud delle amministrazioni stesse. È pensato per ospitare in sicurezza i dati e i servizi “critici e strategici” delle PA italiane, definizione che secondo le linee guida di ACN (Agenzia per la Cybersicurezza Nazionale) include sanità, fiscalità, giustizia, ordine pubblico, difesa, infrastrutture critiche, dati personali su larga scala.

L’infrastruttura è gestita da una società consortile che vede insieme TIM Enterprise (capofila), Leonardo, Cassa Depositi e Prestiti, Sogei. È una struttura mista pubblico-privato che opera sotto vigilanza del Dipartimento per la Trasformazione Digitale e di ACN. Tecnicamente, il PSN offre un’infrastruttura multicloud che integra capacità proprie con quelle di hyperscaler internazionali (AWS, Google Cloud, Microsoft Azure, Oracle) ma con il vincolo critico che i dati sensibili restino fisicamente sul territorio italiano e gestiti da personale italiano sotto giurisdizione italiana.

A gennaio 2026 il PSN ha superato la sua principale milestone PNRR con oltre 600 amministrazioni aderenti, contro le previsioni iniziali del piano economico-finanziario originario. Il target per giugno 2026 è arrivare a 280 PA con migrazioni complete in corso, e una finestra ulteriore di adesione resta aperta fino a febbraio 2027. Numeri che dicono che il progetto è uscito dalla fase di startup e sta entrando in fase di consolidamento.

Perché conta per le aziende che fanno AI

Il PSN non è “solo” un’infrastruttura PA. È un mercato regolato che oggi vale 3,6 miliardi su 13 anni, ed è il canale obbligato per chiunque voglia vendere AI a una pubblica amministrazione italiana sui dati critici o strategici. Tre conseguenze pratiche per le aziende.

Il fornitore AI deve essere qualificato PSN. Se sviluppate una soluzione AI per la sanità pubblica, per l’amministrazione finanziaria, per la giustizia, l’erogazione deve girare in PSN. Significa avere processi di qualificazione, certificazioni di sicurezza, infrastruttura che si integra con lo stack PSN, conformità con le linee guida di ACN. Per startup AI italiane, è una barriera all’ingresso seria. Per chi la supera, è anche una protezione competitiva: i fornitori americani devono ricostruirsi una posizione che voi avete già naturalmente.

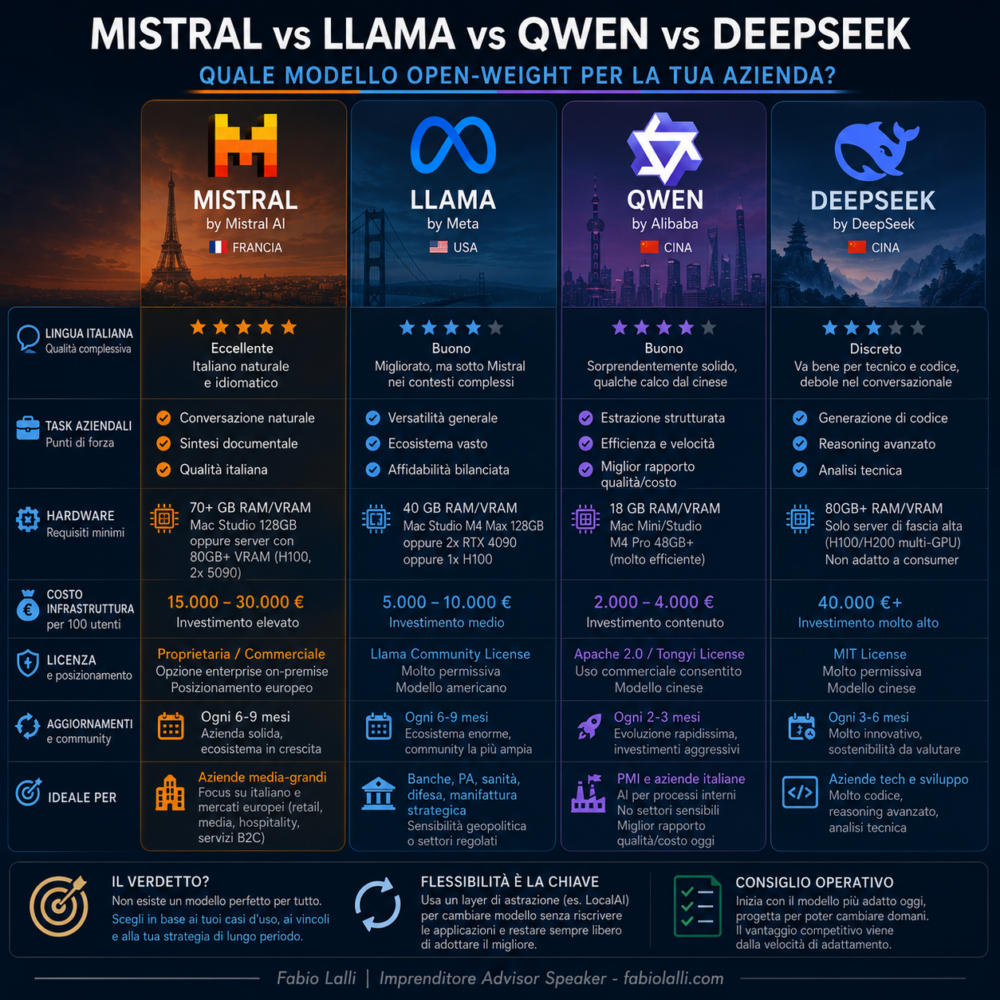
Il modello AI deve essere on-premise o in cloud sovrano. Sui dati PSN non possono girare API ChatGPT o Claude. Devono girare modelli che insistono sull’infrastruttura italiana, sotto controllo italiano. Questo apre uno spazio commerciale enorme per soluzioni AI private italiane basate su modelli open-weight (Llama, Mistral, Qwen) installati dentro perimetro PSN. È esattamente il ruolo che soluzioni come LocalAI possono giocare quando sono ben integrate con lo stack PSN.

La data residency cinese o americana è esclusa. Modelli ospitati su server Alibaba in Cina o su AWS regioni americane non passano la qualificazione PSN. Modelli open-weight che girano su infrastruttura italiana, anche se sono Qwen o Llama scaricati gratuitamente, sì. La distinzione è importante: il PSN non vieta i modelli stranieri come tali, vieta il loro hosting su infrastruttura non sovrana.

Cosa significa per il mercato AI italiano nei prossimi 18 mesi

Tre dinamiche operative che vedo emergere già adesso e che dovrebbero accelerare nei prossimi 18 mesi.

Concentrazione di valore sulle aziende AI italiane qualificate. I prossimi bandi PA su AI (assistenza al cittadino, automazione processi amministrativi, gestione documentale, analisi dati epidemiologici) faranno largo riferimento a fornitori qualificati PSN. Le aziende che hanno fatto il percorso di qualificazione raccoglieranno la quasi totalità del mercato PA italiano AI nei prossimi 3-5 anni.

Spinta su soluzioni open-weight italiane. Visto che gli LLM cloud americani sono di fatto esclusi dai progetti PA strategici, l’unica alternativa praticabile sono modelli open-weight gestiti dentro perimetro italiano. Questo crea pressione per stack tecnologici italiani capaci di gestire l’intera filiera, dall’hardware al modello all’orchestrazione. È esattamente l’opportunità su cui aziende come LocalAI stanno costruendo offerta dedicata al mercato italiano.

Effetto traino sul settore privato regolato. Anche se PSN nasce per la PA, le sue logiche di sovranità si stanno propagando ai settori privati regolati. Banche italiane di medie dimensioni stanno cominciando a chiedere ai propri fornitori AI le stesse garanzie di sovranità tecnica che la PA pretende dal PSN. Aziende sanitarie private adottano linee guida di data residency simili. La normativa AI Act, in vigore dal 2 agosto 2026, accelera questa convergenza fra requisiti PA e requisiti enterprise sensibile.

La banca italiana che ha cambiato approccio

Vorrei raccontare una scena reale recente. Lavoro nel 2025 con una banca italiana di medie dimensioni che sta valutando una RFP per un sistema AI di gestione documentale. Tre fornitori in gara: uno italiano con stack open-weight su infrastruttura italiana, uno americano con LLM cloud OpenAI, uno europeo con LLM cloud Mistral in Francia. Il responsabile compliance, dopo aver letto le tre proposte, fa un’osservazione che spiazza il comitato: “Il fornitore italiano costa il 30% in più. Però se domani vogliamo chiedere un parere alla Banca d’Italia sui nostri sistemi AI, possiamo dire che girano su infrastruttura italiana sotto controllo italiano. Con gli altri due, dobbiamo spiegare perché abbiamo accettato un trasferimento dati di fatto, anche se contrattualmente protetto”.

Il fornitore italiano vince. Non sul prezzo, non sulle prestazioni tecniche, ma sull’argomento sovranità che è entrato nei criteri di valutazione. È un esempio puntuale, ma rappresenta una direzione che vedo emergere in modo trasversale nei settori regolati italiani.

Cosa fare se siete una software house italiana

Per le aziende italiane che fanno o vogliono fare AI per la PA o per i settori regolati, ci sono quattro azioni operative che vale la pena pianificare adesso.

Qualificazione PSN. Avviare il percorso di qualificazione, anche se al momento il vostro prodotto AI non è ancora pronto per la PA. La qualificazione richiede tempo (6-18 mesi) e ha costi non trascurabili. Cominciare con anticipo dà un vantaggio competitivo strutturale.

Stack AI sovrano. Costruire la propria offerta AI sopra modelli open-weight (Llama, Mistral, Qwen) gestiti con orchestratori open-source come LocalAI.io. Evitare di costruire prodotti rigidamente legati a OpenAI o Anthropic, perché chiudono porte preziose sul mercato PA e regolato italiano.

Partnership con i grandi player PSN. TIM Enterprise, Leonardo, Sogei, Cassa Depositi e Prestiti sono i grandi player dell’ecosistema. Costruire relazioni commerciali strutturate con loro è la strada più diretta per arrivare nel canale PA.

Posizionamento di marketing chiaro. Comunicare in modo esplicito che la vostra soluzione è “sovrana italiana”, che gira su infrastruttura italiana, che usa modelli che possono essere documentati e auditati. È un argomento di vendita forte oggi, lo sarà ancora di più nei prossimi 24 mesi.

Il punto di equilibrio fra sovranità e pragmatismo

Una nota di realismo. Il cloud sovrano italiano non significa rinunciare alle migliori tecnologie globali. Significa avere la capacità di scegliere quali tecnologie portare in casa, e di farle girare sotto giurisdizione italiana. Mistral è francese, Llama è americano, Qwen è cinese, ma se li usate in versione open-weight nella vostra infrastruttura italiana, state usando tecnologia globale dentro un perimetro sovrano. È la differenza importante che spesso si perde nei dibattiti politici.

Il PSN, per come è costruito, riflette questa logica equilibrata. Non vieta gli hyperscaler globali (AWS, Google Cloud, Microsoft Azure, Oracle sono partner dell’infrastruttura multicloud). Vieta che i dati sensibili italiani siano gestiti da soggetti che non sono sotto giurisdizione italiana. È una differenza tecnica e giuridica importante.

Per le aziende che fanno AI sul mercato italiano, è il punto di equilibrio da capire bene. Costruire la propria offerta AI come “italiana ma globale” è il posizionamento vincente per i prossimi anni: tecnologie aperte e best-of-breed, integrate in un’architettura che ne mantiene il controllo sul territorio italiano.

Per chi sta avviando questo percorso, ho scritto questa serie di articoli che coprono gli aspetti complementari: GDPR e LLM, hardware locale, TCO on-premise, scelta del modello open-weight, AI Act checklist, installazione di LocalAI. Insieme coprono lo stack completo di decisione per chi vuole costruire AI privata sovrana italiana. Per una conversazione specifica sul vostro contesto, c’è la pagina Advisory.

La domanda finale da portarsi nei prossimi mesi è semplice. Se domani il vostro maggior cliente fosse una pubblica amministrazione italiana o una grande corporate regolata, sareste in grado di rispondere alla loro RFP con un’offerta AI tecnicamente competitiva, ma anche giuridicamente sovrana? Se la risposta è no, c’è una decisione architettura da prendere adesso, prima che lo facciano i vostri concorrenti italiani più veloci.
Da RAG alla memoria: il vantaggio che nessuno può copiare

Chiudi la scheda del browser venerdì sera. La riapri lunedì, riprendi la stessa conversazione, e l’assistente non ha più memoria di te, non sa nemmeno chi sei. Le preferenze che avevi espresso, il lavoro lasciato a metà, le due ore di contesto costruite insieme: sparite. Si riparte da zero.

La risposta diffusa a quel vuoto si chiama RAG, e funziona pescando per somiglianza i pezzi di testo che servono e infilandoli nel prompt. Trasformare quella tecnica in una memoria vera è il problema su cui si arrovellano i team che costruiscono agenti in questo momento. Sotto la parte tecnica, fatta di schemi e di query, c’è una distinzione che riguarda chiunque costruisca prodotti con l’AI, ed è meno una scelta di database e più una scelta di strategia. Il RAG recupera. La memoria ricorda. E lì, nel punto in cui un sistema smette di recuperare e inizia a ricordare, smette anche di essere reattivo, e nasce un vantaggio che il modello, da solo, non ti dà.

Più contesto nel prompt non basta

Il RAG che quasi tutti hanno messo in produzione sono quattro righe di codice: trasformi i documenti in vettori, trasformi la domanda dell’utente in un vettore, peschi i più vicini, li infili nel prompt. Funziona. Funziona così bene che è diventato il default di ogni assistente interno degli ultimi due anni, e spiega anche perché quegli assistenti si somigliano tutti, appena la conversazione prova ad andare un po’ più in là.

Il recupero puro si rompe sempre negli stessi punti. La conversazione lunga, che dopo qualche centinaio di scambi non sta più nel prompt. La ripresa, l’utente che torna il giorno dopo e vorrebbe ritrovare dove era arrivato. Le preferenze e le regole, «questo cliente vuole le date in formato giorno-mese-anno», «i rimborsi sopra i cinquecento euro vogliono un’approvazione», cose che non ottieni per somiglianza semantica con l’ultimo messaggio. La risposta istintiva a tutto questo è una sola: infilare di più nel prompt. Più recupero, più storia, più contesto. Il conto dei token cresce, il modello si perde nel mezzo, e il sistema sembra più lento proprio quando dovrebbe sembrare più competente.

La memoria è un percorso di scrittura

Il salto vero non è mettere un database accanto al vector store. Cambia cosa serve quel livello di archiviazione, e come ci parlano gli agenti.

Il recupero è una query contro un corpus che hai caricato una volta, e niente di ciò che il modello dice rifluisce nel corpus. La memoria invece è un percorso di scrittura: tutto ciò che il sistema osserva durante una sessione, o che l’utente conferma, può diventare un record durevole, con il suo perimetro di visibilità, la sua provenienza, la sua scadenza. Lo stesso record si rilegge dopo, da un’altra sessione, magari da un altro agente che lavora per la stessa persona.

C’è una metafora che gira per descrivere tutto questo, il secondo cervello. La trovo utile e quasi sempre tradita, perché la maggior parte delle implementazioni si ferma un passo prima: ti danno note ricercabili, che sono uno schedario migliore, non una memoria. Una memoria vera distilla. Le note diventano fatti agganciati alle entità che descrivono, il lavoro concluso diventa un episodio riutilizzabile, e lo stesso strato serve allora la chat di una persona e l’agente che lavora al posto suo, senza che nessuno dei due abbia bisogno di una copia tutta sua. È la differenza tra un’AI che reagisce a ogni richiesta come fosse la prima e una che accumula, e sull’accumulo si adatta. In La Mente Adattiva ho provato a descrivere proprio questo scarto, tra un’intelligenza che risponde e una che si trasforma con l’esperienza.

Cinque tipi di memoria da non confondere

«Aggiungere memoria» suona come una funzione sola. In pratica sono sistemi diversi, e se non li separi finisci con un magazzino unico che risponde male a ogni domanda.

Le regole, prima di tutto. Le policy, i vincoli di compliance, le soglie di approvazione cambiano di rado e di proposito, e si recuperano per corrispondenza esatta, mai per somiglianza: una policy cercata per similarità è un errore, perché ti allontana in silenzio dalla regola che vale in quel momento. Poi le preferenze, i parametri stabili di personalizzazione, quelli che fanno sentire il sistema cucito addosso senza doverglielo ridire ogni volta. Poi i fatti, le affermazioni durevoli che l’agente può riusare con la loro provenienza: qui vive il vantaggio che si accumula, e qui i problemi si fanno più duri, perché ogni fatto che scrivi è una scommessa sul futuro. Poi gli episodi, i riassunti del lavoro concluso, la forma di una soluzione passata da riusare invece di riderivarla. E sotto tutto, le tracce, il registratore di volo grezzo da cui fatti ed episodi vengono distillati.

Cinque cose, cinque modi di conservarle, cinque modi di ritrovarle. Confonderne due qualsiasi produce un guasto preciso e prevedibile. È una delle tassonomie possibili, ce ne sono altre, ma il principio vale a prescindere dai nomi: trattare memorie diverse come se fossero la stessa cosa è la radice di metà dei comportamenti strani che vedi negli agenti.

Un cancello prima della memoria

Se prendi sul serio questa separazione, ti serve qualcosa che decida cosa entra nella memoria durevole e cosa resta effimero. È l’operazione più rischiosa di tutto il sistema. Promuovi tutto e la memoria si avvelena da sola, riempiendosi di scarti conversazionali. Non promuovi niente e l’agente resta amnesico.

Il cancello fa poche cose in una transazione sola. Classifica il candidato e gli assegna un perimetro, l’organizzazione, l’utente, l’agente. Verifica i duplicati, così lo stesso fatto che arriva da due sessioni diverse finisce in una riga sola e non in due che competono. Controlla che un fatto abbia una confidenza sopra soglia e una provenienza, cioè la sessione che lo ha generato. Poi calcola lo stato da dentro, mai dal chiamante, e scrive.

Qui si apre la parte che riguarda la governance, non solo il codice. Ogni record porta con sé il suo perimetro di accesso e la sua provenienza. Il diritto all’oblio, che su un log grezzo è una cancellazione, su una memoria diventa una faccenda seria, perché «la cosa che sa di te» è ormai un artefatto distillato da cento conversazioni e non un dato grezzo da buttare. È lo strato che in Pelle Digitale chiamavo la pelle tra noi e la macchina, e qui diventa qualcosa che un’azienda deve saper revocare a comando. L’EU AI Act spinge nella stessa direzione: gli obblighi per i sistemi ad alto rischio sono stati rinviati in via provvisoria da agosto 2026 a dicembre 2027, ma l’asticella su tracciabilità, audit e supervisione umana si alza, non si abbassa. Una memoria senza provenienza e senza scadenze non si può governare, e in Europa quello che sfugge al controllo, tra poco, sarà fuori uso.

Il modello è condiviso, la memoria è tua

Resta una domanda: su cosa appoggiare tutto questo. L’architettura in cui la maggior parte dei team finisce per inerzia spacca la memoria lungo l’asse che fa più male, i dati relazionali in un database, il recupero ibrido in un motore vettoriale, le tracce in un altro store ancora. Ognuno è ottimo per il suo compito. Il guaio arriva quando il contesto deve attraversarli, perché ogni recupero serio diventa una join tra sistemi, e ogni join attraversa un confine di sicurezza, di transazione, di latenza, e a ogni attraversamento ti riporti in casa il problema di consistenza che volevi evitare.

Tenere insieme il recupero semantico e i dati relazionali che lo governano, sotto un solo piano di query e un solo modello di sicurezza, è la capacità che conta. Postgres con pgvector, Elasticsearch, Pinecone, Weaviate, e framework come LangGraph, Letta, Mem0 affrontano pezzi del problema in modi diversi, e la scelta giusta dipende da dove vuoi che vivano i tuoi dati e da chi li può toccare. Per chi lavora su dati sensibili o sovrani questa non è una questione di prestazioni, è una questione di controllo, ed è il terreno su cui è nato LocalAI.io: tenere modello e memoria dentro un perimetro che governi tu.

C’è una conseguenza da tenere a mente. I modelli sono condivisi, li usano i tuoi concorrenti, li addestra qualcun altro, e l’anno prossimo quello che usi oggi sarà rimpiazzato da uno migliore. La memoria no. Quello che è dentro la tua memoria riflette scelte che solo il tuo team poteva fare, su cosa conservare, con quale perimetro, per quanto tempo. Il modello è il livello che puoi sostituire. La memoria è il livello che nessun altro può copiarti, perché è fatto della tua storia, non della tua tecnologia.

Costruirla bene costa più che impilare token in un prompt. Ma per chiunque stia mettendo l’AI dentro la propria azienda la domanda smette di essere «quanto contesto riesco a infilare» e ne diventa un’altra: cosa vale la pena che il tuo sistema ricordi, e cosa è meglio che dimentichi?

Installare LocalAI in azienda in 90 minuti: la guida operativa

Questo articolo è diverso dagli altri che ho scritto in questa serie su AI privata. Gli altri parlano di strategia, architettura, scelte di alto livello. Questo è una guida tecnica step-by-step. Se siete il CTO o il tech lead che ha deciso di portare un ecosistema AI privato dentro l’azienda e volete sapere esattamente cosa fare lunedì mattina per partire, è qui.

Lavoro come cofondatore di LocalAI.io dal 2023, e in questi anni ho visto centinaia di setup in produzione. Ho distillato in questa guida il percorso operativo che, a partire da un Mac Mini M4 Pro o un server Linux base, in 90 minuti porta un’azienda dal “non abbiamo niente” a un ecosistema AI privato completo, con gateway compatibile OpenAI, modello locale funzionante, vector database per il RAG, primo agente che risponde alle domande sui vostri documenti aziendali.

La guida è scritta per chi sa cosa è Docker e ha terminale aperto. Se siete completamente nuovi al mondo dell’infrastruttura container, vi consiglio di lavorare insieme a un developer che vi affianchi sui primi step. Il setup di base è semplice, ma la produzione richiede un occhio operativo.

Prerequisiti hardware e software

Per una prima installazione LocalAI di valutazione, ipotizziamo lo scenario più semplice: un Mac Mini M4 Pro 48 GB. Vanno bene anche un Linux server con almeno 32 GB di RAM, una workstation con RTX 4070 o superiore, oppure un server cloud privato italiano con GPU dedicata. Per produzione su 100+ utenti simultanei serve hardware più potente (vedere la mia guida hardware precedente).

Software preliminare: Docker installato e funzionante (Docker Desktop su Mac, Docker Engine + Compose v2 su Linux), 50 GB di spazio disco libero (i modelli pesano), connessione internet veloce per il primo download dei modelli, terminale e un editor di testo.

Verifica preliminare:

docker --version
docker compose version
df -h

Se Docker non è installato, fermarsi qui e installarlo (su Mac da docker.com, su Linux con i package manager standard). Procediamo assumendo che il setup di base sia pronto.

Step 1: avvio di LocalAI base (15 minuti)

Creiamo la cartella del progetto e il file Docker Compose minimo:

mkdir -p ~/ai-aziendale/{models,data}
cd ~/ai-aziendale

Creiamo il file docker-compose.yml:

services:
  localai:
    image: localai/localai:latest
    container_name: localai
    restart: unless-stopped
    ports:
      - "8080:8080"
    environment:
      - LOCALAI_API_KEY=cambia-questa-chiave-in-produzione
      - MODELS_PATH=/models
      - CONTEXT_SIZE=4096
      - THREADS=8
    volumes:
      - ./models:/models
      - ./data:/data

Se siete su server Linux con GPU NVIDIA, usate l’immagine localai/localai:latest-gpu-nvidia-cuda-12 e aggiungete la configurazione GPU sotto deploy.resources.reservations.devices.

Avviamo il container:

docker compose up -d

Il primo avvio scarica l’immagine, può richiedere 5-10 minuti a seconda della velocità della connessione. Verifichiamo che sia attivo con curl http://localhost:8080/readyz. Se vede risposta OK, LocalAI è in piedi. La Web UI è raggiungibile a http://localhost:8080.

Step 2: scaricare e caricare il primo modello (20 minuti)

LocalAI ha una galleria integrata di modelli pre-configurati. Per partire, scarichiamo Qwen 4 32B-A3B che è la mia raccomandazione di default per la PMI italiana (rapporto qualità/velocità ottimale).

Dalla Web UI: tab Models → cercare “qwen” → cliccare Install sul modello desiderato. In alternativa via CLI:

curl -X POST http://localhost:8080/models/apply 
  -H "Content-Type: application/json" 
  -H "Authorization: Bearer cambia-questa-chiave-in-produzione" 
  -d '{"id": "huggingface@Qwen/Qwen3-32B-A3B-Instruct"}'

Il download impiega 15-20 minuti per un modello da 32B (18 GB di peso quantizzato Q4). Quando il modello è caricato, testiamolo:

curl http://localhost:8080/v1/chat/completions 
  -H "Content-Type: application/json" 
  -H "Authorization: Bearer cambia-questa-chiave-in-produzione" 
  -d '{
    "model": "qwen3-32b-a3b",
    "messages": [
      {"role": "system", "content": "Rispondi in italiano professionale."},
      {"role": "user", "content": "Cosa sai dell AI Act europeo?"}
    ],
    "temperature": 0.7
  }'

Se la risposta arriva, il modello è funzionante. Su un Mac Mini M4 Pro, aspettate 50-70 token al secondo.

Step 3: integrare un’applicazione esistente (10 minuti)

LocalAI espone API completamente compatibili OpenAI. Qualsiasi applicazione che usa la libreria OpenAI può essere ripuntata sostituendo base_url e api_key. Esempio Python:

from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8080/v1",
    api_key="cambia-questa-chiave-in-produzione"
)

response = client.chat.completions.create(
    model="qwen3-32b-a3b",
    messages=[
        {"role": "system", "content": "Sei un assistente aziendale."},
        {"role": "user", "content": "Riassumi il documento allegato in 3 punti."}
    ]
)

print(response.choices[0].message.content)

Da qui in poi, ogni applicazione AI che il vostro team ha sviluppato (chatbot, tool interni, integrazioni con CRM) può essere ripuntata su LocalAI con tre righe di codice. È il vero superpotere dell’API-compatibility: zero refactor.

Step 4: aggiungere il vector database per RAG (20 minuti)

Per RAG (Retrieval Augmented Generation), serve un vector database che indicizzi i documenti aziendali e li recuperi semanticamente durante le query. Qdrant è la scelta più equilibrata oggi.

Aggiungiamo Qdrant al docker-compose.yml:

  qdrant:
    image: qdrant/qdrant:latest
    container_name: qdrant
    restart: unless-stopped
    ports:
      - "6333:6333"
      - "6334:6334"
    volumes:
      - ./qdrant_storage:/qdrant/storage

Restart dei container con docker compose up -d e verifica con curl http://localhost:6333/healthz.

Ora serve un modello di embedding per generare le rappresentazioni vettoriali dei vostri documenti. LocalAI supporta nativamente modelli di embedding. Carichiamo un modello multilingue:

curl -X POST http://localhost:8080/models/apply 
  -H "Content-Type: application/json" 
  -H "Authorization: Bearer cambia-questa-chiave-in-produzione" 
  -d '{"id": "huggingface@BAAI/bge-m3"}'

Step 5: ingestione documenti aziendali (15 minuti)

Carichiamo i documenti aziendali nel vector database. Script Python di esempio per indicizzare una cartella di PDF:

import os
from openai import OpenAI
from qdrant_client import QdrantClient
from qdrant_client.models import VectorParams, Distance, PointStruct
from pypdf import PdfReader
import uuid

openai_client = OpenAI(
    base_url="http://localhost:8080/v1",
    api_key="cambia-questa-chiave-in-produzione"
)
qdrant = QdrantClient(host="localhost", port=6333)

collection_name = "documenti_aziendali"
qdrant.recreate_collection(
    collection_name=collection_name,
    vectors_config=VectorParams(size=1024, distance=Distance.COSINE)
)

docs_folder = "./documenti"
for filename in os.listdir(docs_folder):
    if not filename.endswith(".pdf"):
        continue
    reader = PdfReader(os.path.join(docs_folder, filename))
    for page_num, page in enumerate(reader.pages):
        text = page.extract_text()
        if not text.strip():
            continue
        chunks = [text[i:i+500] for i in range(0, len(text), 500)]
        for chunk in chunks:
            embedding = openai_client.embeddings.create(
                model="bge-m3",
                input=chunk
            ).data[0].embedding
            qdrant.upsert(
                collection_name=collection_name,
                points=[PointStruct(
                    id=str(uuid.uuid4()),
                    vector=embedding,
                    payload={"text": chunk, "filename": filename, "page": page_num}
                )]
            )
print("Indicizzazione completata.")

Questo script va eseguito una volta sui vostri documenti iniziali, poi pianificato per girare quando si aggiungono nuovi documenti (cron job, n8n workflow, manuale).

Step 6: il primo agente RAG (10 minuti)

L’ultimo pezzo: l’agente che usa il vector database per rispondere a domande sui vostri documenti.

from openai import OpenAI
from qdrant_client import QdrantClient

openai_client = OpenAI(
    base_url="http://localhost:8080/v1",
    api_key="cambia-questa-chiave-in-produzione"
)
qdrant = QdrantClient(host="localhost", port=6333)

def chiedi(domanda: str) -> str:
    embedding = openai_client.embeddings.create(
        model="bge-m3",
        input=domanda
    ).data[0].embedding
    
    risultati = qdrant.search(
        collection_name="documenti_aziendali",
        query_vector=embedding,
        limit=5
    )
    
    contesto = "nn".join([r.payload["text"] for r in risultati])
    
    risposta = openai_client.chat.completions.create(
        model="qwen3-32b-a3b",
        messages=[
            {"role": "system", "content": "Rispondi solo sulla base del contesto fornito. Se non sai, dillo."},
            {"role": "user", "content": f"Contesto:n{contesto}nnDomanda: {domanda}"}
        ]
    )
    
    return risposta.choices[0].message.content

print(chiedi("Quali sono le regole sui rimborsi spese?"))

Eseguite lo script e ponete domande sui documenti che avete indicizzato. Se le risposte sono accurate, avete un primo agente AI RAG funzionante.

Da prototipo a produzione: cosa manca ancora

Quello che abbiamo costruito in 90 minuti è un prototipo funzionante. Per portarlo in produzione su 50-200 utenti aziendali servono altri tre componenti che vale la pena pianificare subito.

Autenticazione e gestione utenti. Il setup base usa una API key condivisa. In produzione serve SSO (Okta, Azure AD, Google Workspace), oppure almeno un sistema di user management. LocalAI supporta multi-tenancy nativo, va configurato.

Frontend. Per gli utenti finali serve un’interfaccia. Open WebUI è la scelta più rapida (compatibile OpenAI, si integra con LocalAI in cinque minuti). In alternativa, sviluppate un’interfaccia custom usando librerie come Vercel AI SDK o LangChain.

Monitoraggio e logging. Per l’AI Act servirà logging strutturato di tutte le interazioni, metriche di performance, alert su anomalie. LocalAI esporta metriche Prometheus, che potete agganciare a Grafana per dashboard di monitoraggio. Per il logging completo, vale la pena integrare un sistema come Langfuse o un equivalente custom.

Backup e disaster recovery. I modelli pesano decine di GB e sono difficili da redownlodare velocemente. Il vector database con i vostri documenti indicizzati è ancora più critico. Pianificare backup periodici delle cartelle models/ e qdrant_storage/.

Stack alternativo e specializzazioni

Lo stack base che ho descritto va bene per la PMI italiana media. Per scenari più specifici:

Per aziende che vogliono modelli multipli in parallelo (uno per chat, uno specializzato per estrazione strutturata, uno per codice): LocalAI gestisce nativamente più modelli, basta caricarli tutti e routare le richieste applicativamente.

Per workload server con alta concorrenza (200+ utenti simultanei): valutare vLLM come motore di inferenza sotto LocalAI, oppure deployment distribuito su più nodi GPU.

Per fine-tuning su dati aziendali specifici: LocalAI supporta fine-tuning LoRA. Setup più complesso, vale la pena partire dal supporto della community o di chi conosce il dominio.

Cosa fare nei prossimi 30 giorni

Una volta avviato lo stack di base, vale la pena pianificare le prime quattro settimane di adozione interna con metodo.

Settimana 1: setup completo (i 90 minuti di questa guida), indicizzazione di un primo corpus documentale ristretto (es. policy HR, FAQ tecniche), test con 3-5 utenti early adopter del team interno.

Settimana 2: raccolta feedback, miglioramento del system prompt, espansione del corpus a documenti aggiuntivi, prima integrazione con un sistema aziendale (CRM, helpdesk).

Settimana 3: apertura a 10-20 utenti, monitoraggio metriche (latenza, qualità delle risposte, errori), aggiunta del frontend Open WebUI o equivalente.

Settimana 4: valutazione roll-out più ampio, definizione del piano di scalabilità (più hardware, più modelli, integrazione con SSO aziendale), pianificazione governance.

Per chi sta valutando l’avvio di un ecosistema AI privato aziendale e vuole supporto operativo, c’è la pagina Advisory dove descrivo i formati di collaborazione che propongo. Per la community LocalAI in italiano, il canale Discord di LocalAI.io è il posto giusto.

La domanda finale, quella che cambia il modo di fare AI aziendale nei prossimi 12 mesi, è semplice. Lunedì mattina, avete in casa il vostro primo endpoint AI privato funzionante? Se la risposta è no, questa guida vi dà tutto quello che serve per cambiarla entro le 12.

Guerra dei prezzi AI: la difendibilità si sposta sul controllo dell’inferenza

Il 13 giugno il Wall Street Journal ha raccontato la fuga verso i modelli cinesi: aziende e startup, sfiancate dal conto dei token, che spostano i carichi di lavoro su alternative più economiche e quasi sempre open source. Bradley Olson racconta di strumenti che fanno rimbalzare il lavoro da un modello all’altro, Claude o ChatGPT per i compiti che lo meritano, modelli aperti per tutto il resto. OpenAI e Anthropic, tutte e due con il fascicolo per la quotazione già depositato, stanno valutando di tagliare i prezzi.

Sotto la cronaca del taglio c’è un movimento più lento, e per chi quei sistemi li mette in produzione conta molto di più. La guerra dei prezzi AI sta spaccando il mercato in due, e le due metà non si difendono allo stesso modo. Da una parte i volumi, che scivolano verso il basso costo. Dall’altra il valore, che resta in alto, dove le capacità di frontiera sono ancora poche e ancora difficili da replicare.

I volumi seguono i modelli cinesi

Il pavimento dei prezzi lo ha colato DeepSeek, e da lì in giù si è mosso tutto il resto. Su OpenRouter, la piattaforma di instradamento che migliaia di sviluppatori usano per scegliere a chi mandare le proprie richieste, i modelli cinesi pesano oggi intorno al 46% del traffico identificato. Anthropic, Google e OpenAI messe insieme stanno sotto al 36. Un anno fa i cinesi erano sotto il due per cento. Qwen, DeepSeek, Kimi, GLM, MiniMax: nomi che fino a poco fa nessun ufficio acquisti pronunciava, e che adesso girano dentro metà dei flussi agentici del pianeta.

La ragione è prosaica, e la dice bene un investitore citato nel pezzo, Tommy Shaughnessy di Delphi: il modello è il costo più grosso per chi vende inferenza, e questi se lo ritrovano gratis. I laboratori cinesi rilasciano modelli di livello frontiera come pesi aperti, chi fa inferenza li serve a costo quasi azzerato, e il prezzo finale crolla a una frazione, da sette a cinquanta volte meno a seconda del confronto che si fa. Per moltissimo lavoro quotidiano, una sintesi o una classificazione o una bozza da rifinire, la differenza di qualità tra i modelli cinesi e quelli di punta semplicemente non si vede in busta paga. E nel frattempo i conti dei token diventano insostenibili: c’è chi, come Uber, ha bruciato l’intero budget AI dell’anno entro aprile.

Il prezzo basso ha un indirizzo

Un modello che costa quasi niente è comodo, fino al momento in cui ti accorgi da dove arriva, e che quel quasi niente per chi lo produce ha una funzione. GLM-5 di Zhipu è addestrato e servito su silicio Huawei Ascend, niente NVIDIA: per le imprese e gli enti cinesi quell’indipendenza dall’hardware americano vale più di un punto di benchmark. Distribuire frontiera come open weight, a costo zero per il mondo, è anche una mossa di quota e di influenza, un loss leader giocato su scala geopolitica.

Negli Stati Uniti la cosa ha già smesso di essere teorica. Ad aprile la commissione della Camera sul Partito Comunista Cinese ha aperto un’indagine su Airbnb e Anysphere per l’uso di modelli cinesi, segno che dentro un’app che usi ogni giorno può girare inferenza che a qualcuno, a Washington, non piace affatto. E l’Europa, in questa mappa, è quasi un buco: tanti utilizzatori, pochissimi produttori, con Mistral come eccezione più citata che strutturale. Dipendere da una sola sponda è un rischio già scomodo. Appoggiare il proprio lavoro su due sponde lontane, e su nessun pezzo di casa, è una postura che vale la pena guardare prima che diventi un vincolo.

Il routing come punto di controllo

Lo strumento che il Wall Street Journal descrive, quello che smista il lavoro tra modello esterno, sistema interno e open source self-hosted, è la cosa più importante dell’articolo, e quasi nessuno la nomina. Nel momento in cui i modelli diventano intercambiabili e quasi gratuiti, il pezzo di valore si sposta su chi decide dove va ogni richiesta, con quali regole, con quali dati, dentro quali confini. Orchestrazione, routing, inferenza locale: qui si gioca il margine, e qui si gioca la difendibilità.

È lo stesso filo che avevo provato a tirare quando una direttiva americana ha spento Fable 5 e Mythos 5 in tutto il mondo: in produzione vince meno il modello migliore e vince di più chi controlla l’instradamento e tiene l’inferenza vicina. Per chi compra in azienda, e ancora di più per una pubblica amministrazione o un settore regolato, questo livello smette di essere un dettaglio da architetti e diventa oggetto di governance, e materia da mettere a gara: la domanda da scrivere nel capitolato diventa chi orchestra, dove gira il carico, cosa esce dal perimetro, più che quale modello ci sia in fondo. È esattamente la direzione di prodotto su cui lavoro con LocalAI, inferenza che resta dentro casa.

La frontiera resta un permesso, non una proprietà

L’altra metà del cielo, quella del valore, ha una sua fragilità che il prezzo basso ci fa dimenticare. Le capacità di punta restano accessibili a condizioni decise da altri. Anthropic ha pubblicato la classe Mythos con due nomi e due regole: Fable con i guardrail, che dirotta le richieste su cyber, bio e chimica verso un modello più sorvegliato, e Mythos vero e proprio, senza freni pubblici, riservato a un programma ristretto. Sopra questa scelta industriale è arrivata la geopolitica, con il blocco all’export che ha staccato i modelli di frontiera dal resto del mondo da un giorno all’altro.

Chi costruisce sopra una API di frontiera costruisce sopra un permesso. Un permesso ottimo, potente, conveniente finché dura, e revocabile per ragioni che non dipendono da te: una direttiva o una decisione di sicurezza nazionale presa in un fuso orario lontano. Tenere tutto il valore della propria azienda dentro quel permesso è una scommessa che in pochi farebbero a occhi aperti, se la guardassero per quello che è.

Costruire da qui con quello che si controlla

Da questa biforcazione non si esce scegliendo una metà contro l’altra. La frontiera serve, per i compiti dove la differenza si vede e si paga. L’open economico serve, per il volume. Quello che cambia è dove si mette il proprio baricentro, e quanto del proprio destino si lascia in mano a un listino o a un permesso altrui.

Per un’organizzazione che parte adesso, e parte da qui, il punto fermo viene prima della tecnologia. Prima il metodo, la mappa di quello che quel processo fa davvero, di quali dati non possono uscire, di dove la frontiera vale il prezzo e dove i modelli cinesi aperti bastano e avanzano. Poi la tecnologia, scelta su quella mappa: orchestrazione propria, inferenza che si può portare in casa, libertà di cambiare modello senza riscrivere l’azienda. In Pelle Digitale avevo descritto la tecnologia come una superficie che ci portiamo addosso, e una pelle si sceglie con cura, non si appalta al primo che la regala. La velocità di mettere AI in produzione, ormai, ce l’avranno tutti. La difendibilità, quella, resta di chi controlla il proprio stack.

Senza dubbio la domanda che lascio aperta è semplice: del valore che la tua azienda affida all’AI, quanta parte vive su qualcosa che puoi spegnere tu, e quanta su qualcosa che possono spegnere altri?

Ontologie e grafi di conoscenza: la struttura del sapere in azienda

Il marketing scrive «lead» e intende un indirizzo email lasciato in un form. Le vendite scrivono «lead» e intendono qualcuno pronto a firmare un contratto. Stessa parola, due significati lontani, e nel mezzo riunioni che girano a vuoto perché nessuno, in tutta l’azienda, si è mai seduto a stabilire cosa voglia dire davvero.

Capita ovunque, e quasi sempre resta invisibile. Finché non arriva un modello a cui chiediamo di leggere i nostri documenti e restituirci un po’ d’ordine: a quel punto il disaccordo che tolleravamo da anni smette di essere un fastidio di fondo e diventa la prima cosa che ci scoppia in mano.

Per capire perché, conviene tenere separate due idee che arrivano dal mondo del web semantico e che quasi tutti scambiano l’una per l’altra: l’ontologia e il grafo di conoscenza. Si somigliano e non coincidono, e la differenza dice parecchio su come è fatto il sapere dentro un’organizzazione.

Ogni azienda parla una lingua che non ha mai scritto

Un’ontologia, ridotta all’osso, è l’elenco delle cose che esistono in un certo mondo e delle regole con cui possono stare insieme. Quali tipi di oggetti ci sono (un cliente, un progetto, un margine, una commessa), come si legano tra loro (un cliente firma un contratto, un progetto consuma un budget), quali vincoli valgono sempre (una fattura appartiene a un solo cliente). Funziona meno come un diagramma pieno di frecce e più come una mappa condivisa del significato, tanto precisa che sopra ci può ragionare una persona appena arrivata quanto una macchina.

Solo che quasi nessuno la chiama così. Ogni azienda gira già su un’ontologia, implicita, non scritta, quasi sempre contesa. La parola «cliente» nel CRM, nell’amministrazione e nel customer care indica tre cose che si assomigliano senza combaciare. «Chiuso» per un commerciale e «chiuso» per chi gestisce la delivery raccontano due momenti diversi della stessa storia. Il vocabolario c’è, le regole pure, ma vivono nella testa delle persone, tramandate per consuetudine, mai messe nero su bianco.

La conoscenza che non sta in nessun documento

Se l’ontologia è la mappa del significato, il grafo di conoscenza è il territorio già abitato: i fatti concreti, le persone e le cose reali, collegati uno all’altro. Questo cliente legato a quella commessa, quella decisione presa sulla base di quel dato, quel fornitore che conosce bene quel reparto. Nodi e relazioni, niente di più.

E qui si tocca un nervo scoperto. Buona parte di questo grafo, nelle aziende, esiste già, però vive sparso: nelle teste delle persone, nei thread di chat, nelle mail, nei fogli di calcolo, nella memoria tacita di chi è lì da quindici anni e «sa come funziona». I documenti conservano testo. Le relazioni, che sono poi la materia che ci serve quando dobbiamo decidere o rispondere a una domanda, restano fuori, intrappolate tra le righe o, peggio, solo dentro una testa che prima o poi andrà in pensione. Un’azienda capace di tenere insieme quelle connessioni inizia a comportarsi come un’impresa che ragiona, più che come un archivio da consultare.

L’intelligenza artificiale disegna lo schema e poi lo riempie di errori

Fino a ieri tutto questo aveva un costo proibitivo. Scrivere l’ontologia voleva dire uno specialista chino su un editor formale per settimane. Popolare il grafo voleva dire eserciti di curatori a mano, oppure estrattori rigidi che si inceppavano al primo caso fuori standard. Lento di qua, lento di là, e quasi sempre un progetto che moriva prima di servire a qualcosa.

I modelli linguistici ribaltano l’economia della faccenda. Dai a un modello un paragrafo e ti restituisce entità e relazioni in pochi secondi. Il costo di rendere esplicito l’implicito, di tirare fuori dai testi sia la mappa sia i fatti, crolla quasi a zero. È la stessa frontiera sottile che in Pelle Digitale ho provato a raccontare, quella membrana dove il senso passa di continuo tra noi e le macchine senza che nessuno dei due lo possieda del tutto.

Poi c’è il rovescio, ed è la parte che in azienda fa più male. Lasciata a sé, l’AI inquina. Inventa categorie che non esistono, sbaglia i tipi, asserisce legami plausibili e falsi con la stessa disinvoltura con cui ne asserisce di veri. La disciplina che la salva è una sola: prima si concorda la mappa del significato, poi si lascia che sia quella mappa a fare da guinzaglio all’estrazione. Lo schema diventa il guardrail. Prima il senso condiviso, poi i fatti che lo riempiono, in quest’ordine e mai nell’altro.

E tutto regge a una condizione, che vale la pena dire per intero. La parte faticosa non è mai stata battere a tastiera i fatti, ma metterci d’accordo su cosa significano. L’AI toglie la digitazione e ci lascia esattamente lì, faccia a faccia con il disaccordo che avevamo nascosto sotto il tappeto. Vale anche quando colleghiamo questi modelli ai sistemi che già usiamo, per metterli a contatto con i dati che teniamo sparsi ovunque: la tecnologia per pescare nel nostro sapere c’è, però non decide al posto nostro cosa quel sapere voglia dire.

Chi possiede il significato di «cliente»?

Se l’AI smonta la fatica meccanica e ci consegna il disaccordo bello e impacchettato, allora la domanda vera si sposta dalla tecnologia all’organizzazione. Tutto si stringe attorno a una questione di potere: chi ha l’autorità di decidere cosa significa «cliente». Per anni la risposta è stata «nessuno», oppure stava sepolta in un team di enterprise architecture con cui mezza azienda non si parlava. Adesso quella domanda torna al centro e pretende una risposta esplicita.

Decidere il significato è un atto che pesa. Stabilire che «cliente» vuol dire una certa cosa equivale a scegliere quale definizione vince quando il marketing e la finanza la vedono in modo opposto, e quindi chi comanda su quel pezzo di realtà condivisa. È una scelta di disegno organizzativo travestita da dettaglio tecnico. L’ontologia smette di essere un artefatto da reparto IT e diventa un oggetto di governo, qualcosa che qualcuno deve possedere, mantenere, presidiare.

Le aziende che saltano questo passaggio non evitano la decisione. La delegano in silenzio al modello, che una definizione se la sceglie comunque, e se ne accorgeranno il giorno in cui i conti non torneranno e nessuno saprà spiegare il perché.

L’ontologia generica si copia con un prompt, la propria no

C’è un’ultima conseguenza, e riguarda la competizione. Se chiunque può chiedere a un modello di abbozzare un’ontologia generica e plausibile per un certo settore, allora il generico vale sempre meno. Scivola verso la commodity, alla portata di tutti allo stesso prezzo, vale a dire quasi gratis.

Quel che resta difficile da replicare è la mappa precisa e ben curata del proprio dominio. La struttura del sapere di quella specifica azienda, costruita sulle sue relazioni reali e sulle definizioni che le sono costate anni di discussioni e aggiustamenti, validata e tenuta in ordine, non si tira fuori con un prompt astuto. La barriera si sposta: dal possesso dei dati, che ormai hanno tutti, al possesso della struttura di significato sopra quei dati.

Ed è una barriera solida proprio perché è lenta. Costa tempo costruirla, costa presidio mantenerla, si nutre di conoscenza che su internet non c’è perché vive solo dentro quell’organizzazione. Reggere la spinta di questa trasformazione, come ha imparato chi ha visto le aziende assorbire gli shock di mercato degli ultimi anni, vorrà dire trattare la propria ontologia come un patrimonio, più che come lo scarto di un progetto finito in un cassetto.

La parte tecnica, ormai, è quasi un gioco da ragazzi. Gli strumenti per abbozzare un’ontologia dentro una scheda del browser esistono già e funzionano sorprendentemente bene. A mancare è altro: la voglia di sederci in una stanza, noi, e decidere una volta per tutte cosa vogliono dire le nostre parole.

Allora forse la domanda da cui partire non riguarda l’intelligenza artificiale. Mappare il nostro sapere lo saprà fare, e prima di quanto immaginiamo. Riguarda noi, e suona più o meno così: siamo davvero pronti a metterci d’accordo su cosa quel sapere significhi? Perché la mappa la disegnerà la macchina, ma il significato, quello, tocca ancora a noi.

AI Act agosto 2026: checklist tecnica per finanza e sanità

Il 2 agosto 2026 entrano in piena applicazione gli obblighi del Regolamento UE 2024/1689, l’AI Act, per i sistemi di intelligenza artificiale classificati ad alto rischio. Mancano poco più di due mesi al momento in cui scrivo, e nelle ultime settimane mi è capitato di sedermi a quattro tavoli diversi con responsabili compliance, CTO e direttori generali italiani, che mi hanno tutti fatto la stessa domanda, declinata in modi diversi: “Siamo davvero pronti?”. La risposta media che ho dato è: ancora no, ma il tempo per chiudere il gap c’è, se si parte adesso.

In questo articolo provo a tradurre l’AI Act in una checklist operativa per chi opera nei due settori dove l’urgenza è massima: finanza e sanità. Non è un articolo giuridico (per quello ci sono ottimi studi legali italiani specializzati), è un articolo da chi ha visto cosa succede dentro le aziende quando si avvicina una scadenza regolatoria seria.

Le date che contano

L’AI Act è entrato formalmente in vigore il 1 agosto 2024, con applicazione progressiva su quattro tappe. La prima, 2 febbraio 2025, ha introdotto i divieti per i sistemi a rischio inaccettabile (social scoring, manipolazione comportamentale dannosa, riconoscimento biometrico massivo) e l’obbligo di alfabetizzazione AI del personale. La seconda, 2 agosto 2025, ha attivato gli obblighi per i modelli di AI generativa di uso generale (GPAI), come Claude, GPT, Gemini, e ha richiesto agli Stati membri di nominare le autorità nazionali competenti (in Italia, l’AgID).

La terza tappa, 2 agosto 2026, è quella che riguarda la maggior parte delle aziende italiane che usano l’AI nei processi. Da quella data, tutti i sistemi classificati come ad alto rischio devono essere conformi a obblighi sostanziali in materia di risk management, qualità dei dati, documentazione tecnica, supervisione umana, robustezza, cybersecurity, e devono essere registrati nel database europeo dei sistemi AI ad alto rischio. La quarta tappa, 2 agosto 2027, riguarda specificamente i dispositivi medici AI che già rientrano nelle normative di conformità di prodotto.

Le sanzioni sono articolate. Per i sistemi vietati, fino a 35 milioni di euro o 7% del fatturato annuo globale (il valore maggiore). Per gli obblighi sui sistemi ad alto rischio, fino al 3% del fatturato globale. Per informazioni inesatte alle autorità, fino a 7,5 milioni di euro. Per le PMI, si applica l’importo inferiore tra cifra fissa e percentuale, ma non c’è esenzione: una PMI con 2 milioni di fatturato rischia fino a 60.000 euro su obblighi alto rischio, non rovinosa ma abbastanza da rendere la compliance un investimento razionale.

Cosa è “alto rischio” nei vostri processi

L’Allegato III del Regolamento elenca le categorie di sistemi AI considerate ad alto rischio per ragioni di impatto su diritti fondamentali, salute e sicurezza. Vale la pena leggerle con attenzione perché il perimetro è più largo di quanto molti pensino.

Finanza. Sistemi AI usati per credit scoring, valutazione del merito creditizio delle persone fisiche, risk scoring assicurativo per la determinazione dei premi sulla vita e sulla salute, valutazione delle frodi che impatti direttamente decisioni sui clienti. Una banca italiana media-piccola, una compagnia assicurativa, una fintech che fa lending automatizzato hanno tutti almeno un sistema dentro questo perimetro. Le grandi banche italiane stanno già lavorando, le piccole e medie spesso non sanno ancora di doverlo fare.

Sanità. Sistemi di supporto decisionale clinico, diagnostica AI, triage automatizzato di pazienti, sistemi che determinano l’accesso a servizi sanitari o prestazioni assistenziali pubbliche, AI per la gestione delle emergenze sanitarie. Praticamente ogni applicazione AI in un ospedale o azienda sanitaria territoriale italiana ricade qui.

HR. Sistemi per il recruiting automatizzato, screening dei CV, valutazione delle performance, decisioni su promozioni, demansionamenti, licenziamenti, accesso alla formazione. È la categoria che riguarda la maggior parte delle aziende italiane sopra i 100 dipendenti, soprattutto quelle che hanno adottato sistemi di people analytics negli ultimi anni.

PA. Sistemi usati per accesso a servizi pubblici essenziali, valutazione di richieste di immigrazione e asilo, sistemi giudiziari predittivi, polizia predittiva. Tutto il PSN italiano e diverse iniziative AI di amministrazioni regionali ricadono qui.

Infrastrutture critiche. Sistemi che gestiscono o supervisionano reti energetiche, idriche, di trasporto, sistemi di telecomunicazione. Per chi lavora in questi settori, lo scrutinio è massimo.

L’attribuzione della categoria non è automatica né certificata da un’autorità prima del rilascio. La responsabilità è del provider del sistema (chi lo sviluppa) e del deployer (chi lo usa). Sarà verificata ex post dalle autorità di vigilanza, in Italia l’AgID. La domanda da farsi oggi è semplice: avete fatto una mappatura formale dei vostri sistemi AI e li avete classificati ai sensi dell’AI Act? Se la risposta è no, è il primo passo da fare.

Gli otto obblighi sostanziali sui sistemi alto rischio

Per ogni sistema classificato ad alto rischio, gli obblighi che diventano operativi il 2 agosto 2026 sono otto. Provo a riassumerli con un occhio operativo, non giuridico.

1. Sistema di gestione del rischio. Procedura documentata che identifica, valuta e mitiga i rischi del sistema AI per tutto il suo ciclo di vita, dalla progettazione al ritiro. Deve essere aggiornata continuamente, non un documento una tantum.

2. Qualità e governance dei dati. I dataset di training, validation e testing devono essere rappresentativi, accurati, esenti da bias significativi. Per modelli open-weight (Llama, Mistral, Qwen) significa che dovete documentare con cura quale modello state usando, con quale dataset di fine-tuning, e attestare che avete fatto le verifiche di qualità.

3. Documentazione tecnica. Deve descrivere il sistema, le sue funzionalità, i dati usati, le metriche di performance, i limiti noti. È un documento corposo, paragonabile alla documentazione tecnica richiesta per i dispositivi medici, e deve essere mantenuto aggiornato.

4. Logging e tracciabilità. Il sistema deve registrare automaticamente gli eventi rilevanti durante l’uso, con un livello di dettaglio sufficiente a permettere audit post-incidente. Non è banale tecnicamente, soprattutto per applicazioni AI che usano LLM cloud dove il logging delle prompt e degli output deve essere strutturato.

5. Trasparenza e informazione all’utente. L’utente del sistema deve sapere che sta interagendo con un AI, deve capire come funziona, deve essere informato dei limiti. Per un chatbot di customer service, significa disclaimer e onboarding. Per un sistema di decision support, significa documentazione del processo decisionale.

6. Supervisione umana. Deve esistere un meccanismo per cui un operatore umano può intervenire, sospendere, correggere le decisioni del sistema. Per applicazioni completamente automatizzate, il design deve esplicitamente prevedere punti di override umano.

7. Robustezza, accuratezza e cybersecurity. Il sistema deve essere testato per resistere a tentativi di manipolazione, deve avere metriche di accuratezza documentate, deve essere protetto da attacchi (prompt injection, data poisoning, model extraction).

8. Registrazione nel database europeo. Tutti i sistemi AI ad alto rischio dei provider (chi sviluppa) devono essere registrati nel database centrale europeo, accessibile pubblicamente. È una sorta di registro internazionale dei sistemi AI critici dell’UE.

Il caso operativo di una banca italiana media

Vorrei provare a tradurre questa lista in cosa fa concretamente un’azienda. Prendiamo una banca italiana media (50 sportelli, 700 dipendenti) che usa tre sistemi AI principali: credit scoring per i mutui retail, antifrode automatizzato sui pagamenti, chatbot di customer service in app.

Il credit scoring è inequivocabilmente alto rischio. Va fatta DPIA combinata con AI Act assessment, documentata la pipeline di training (con quali dati storici, con quale provider del modello, con quale tasso di errore noto), implementata supervisione umana effettiva (non basta una casella “approva/rifiuta”, deve esserci processo di review), preparata la documentazione tecnica, registrato il sistema nel database europeo.

L’antifrode pagamenti è una zona grigia. Se prende decisioni che impattano direttamente i clienti (blocco di una carta, sospensione di un pagamento), è alto rischio. Se invece genera solo alert per analisti umani che poi decidono, è basso rischio. La differenza sta nel grado di automazione effettiva. Vale la pena formalizzare la classificazione.

Il chatbot di customer service rientra negli obblighi di trasparenza (l’utente deve sapere che sta parlando con un AI), ma non in alto rischio se non prende decisioni sostantive. Va comunque documentato, monitorato, dotato di escalation a operatore umano.

Per una banca così, il lavoro di compliance AI Act richiede 4-8 mesi di lavoro di un team misto IT-legale-compliance, e costa fra 80.000 e 200.000 euro fra consulenze esterne e tempo interno. Sostenibile, ma da pianificare adesso, non a luglio.

Perché l’AI privata semplifica drammaticamente la compliance

Un punto che emerge in modo trasversale su tutti gli otto obblighi: alcuni sono molto più facili da gestire se il modello AI gira nella vostra infrastruttura invece che essere chiamato via API cloud.

Sulla documentazione del modello, su un sistema cloud (Claude, GPT) avete accesso limitato: dovete fidarvi della documentazione che il provider rende disponibile, che non sempre è sufficiente per l’AI Act. Su un modello open-weight in casa (Llama, Mistral, Qwen), avete il modello, sapete da dove viene, potete documentare il fine-tuning, attestare la pipeline.

Sul logging, su cloud dovete loggare voi tutte le chiamate API, e il provider potrebbe non darvi accesso ai logging interni. Su on-premise, il logging è completo, sotto controllo, archivable secondo i vostri standard.

Sulla qualità dei dati, su cloud non sapete davvero su cosa è stato addestrato il modello del provider. Su on-premise con un modello open-weight, sapete almeno cosa è dichiarato nel paper di training del modello base, e sapete esattamente i vostri dati di fine-tuning.

Sulla robustezza, su cloud i test di sicurezza che potete fare sono limitati ai casi non distruttivi. Su on-premise potete fare red teaming completo, simulare attacchi, validare la postura di sicurezza in modo molto più approfondito.

Sulla registrazione nel database europeo, è obbligo del provider, non del deployer. Quindi: se usate un modello cloud americano, il provider è OpenAI o Anthropic, che dovrà fare la registrazione lui. Se usate un modello open-weight in casa con fine-tuning vostro, voi siete il provider del sistema specifico che usate, quindi dovete farlo voi (con sforzo accessibile, è una procedura documentale).

In sintesi, le aziende italiane di finanza e sanità che stanno scegliendo l’AI privata oggi non lo fanno solo per ragioni di sovranità del dato. Lo fanno anche perché l’AI Act è strutturalmente più semplice da rispettare su un perimetro che controllate.

Quattro azioni concrete da fare entro luglio 2026

Riassumo in quattro azioni operative quello che le aziende italiane sotto AI Act dovrebbero avere fatto prima della scadenza.

Inventario e classificazione. Mappare tutti i sistemi AI in uso in azienda (anche quelli che il business non sa di chiamare “AI”, come algoritmi di scoring legacy o automazioni machine learning vecchie), classificarli rispetto all’Allegato III. Output: un registro dei sistemi AI aziendali con la categoria di rischio attribuita.

Gap analysis. Per ogni sistema ad alto rischio, valutare lo stato attuale di compliance sugli otto obblighi. Output: una matrice sistema × obbligo con verde/giallo/rosso, e per ogni rosso un piano di adeguamento.

Adeguamento documentale e tecnico. Eseguire il piano di adeguamento. Per chi parte da zero, è il lavoro più lungo, soprattutto su sistema di gestione del rischio, documentazione tecnica, logging strutturato.

Governance permanente. L’AI Act richiede un cambio strutturale nella gestione dell’AI in azienda, non una compliance una tantum. Va istituito un AI Governance Committee (anche piccolo, in PMI può essere CIO + DPO + un legale), va definito chi fa il monitoring continuo, vanno aggiornati i contratti con i fornitori di sistemi AI per riflettere le nuove responsabilità.

Per chi opera in finanza, sanità, PA, e non ha ancora avviato questo percorso, vale la pena partire questa settimana. Lo dico senza catastrofismo, ma due mesi sono pochi per fare un’inventario serio e iniziare almeno l’adeguamento dei sistemi più critici.

Per chi sta valutando se accelerare la migrazione a un’infrastruttura AI privata anche per ragioni di compliance, è una decisione che entra naturalmente nel piano AI Act. Su questo lavoro come cofondatore di LocalAI.io, che è il gateway open-source che facilita il setup di un ecosistema AI privato auditable, documentabile, sotto controllo aziendale. Ho scritto recenti articoli su come scegliere il modello open-weight giusto, su GDPR e LLM, su hardware locale, che insieme coprono lo stack di decisione completo. Per una conversazione specifica sulla vostra situazione AI Act, c’è la pagina Advisory.

La domanda finale è una sola, e va portata al primo consiglio di amministrazione utile. Siamo in grado di dimostrare, davanti a un’ispezione AgID nei prossimi 12 mesi, che i nostri sistemi AI ad alto rischio rispettano il regolamento? Se la risposta del CIO è “credo di sì”, è il momento di trasformare quel “credo” in evidenze documentali strutturate.

Nadella e il learning loop: i tre piani della sovranità dell’AI

Ieri Satya Nadella ha pubblicato su X un testo lungo, intitolato «A frontier without an ecosystem is not stable». Io avevo appena scritto del blocco con cui il governo americano ha spento Fable 5 e Mythos 5 per tutti, partendo da una previsione di Ethan Mollick. Nadella arriva sullo stesso nervo da un’altra altezza, parla del futuro dell’impresa e usa una parola che mi segue da tempo, sovranità.

Messi in fila, questi interventi disegnano un quadro a strati. E al centro c’è il learning loop.

Nadella sposta il valore sul ciclo di apprendimento

Il ragionamento di Nadella è che il vantaggio competitivo, nell’AI, si costruisce sopra i modelli, più che scegliendo il modello migliore. Introduce due capitali. Il human capital, fatto di conoscenza, giudizio, relazioni e intuizione delle persone, e il token capital, la capacità di AI che l’azienda costruisce e possiede. Il primo, dice, non perde valore quando cresce il secondo, anzi ne guadagna, perché è l’iniziativa umana a guidare la crescita del token capital. Senza una direzione umana, hai solo calcolo che gira a vuoto.

Da qui il cuore del testo. L’opportunità sta nel costruire un learning loop sopra i modelli, un sistema che impara dai dati e dai processi dell’azienda e migliora a ogni uso. Il modello è il motore, la conoscenza dell’azienda è il carburante. E aggiunge una frase che condivido: deleghi un compito, persino un intero lavoro, ma non deleghi mai quello che impari facendolo. Quel ciclo diventa l’IP nuova dell’impresa, una macchina che accumula valore nel tempo e che gli altri faticano a replicare.

Il testo indica anche tre tasselli pratici. Valutazioni fatte in casa, misurate sugli esiti che contano per il business più che sui benchmark pubblici. Ambienti di reinforcement learning privati, dove il modello migliora sulle tracce reali dell’organizzazione. Una knowledge base che rende interrogabile la memoria aziendale e l’uso dei token più efficiente. La chiama una macchina che scala la collina, e a differenza di gran parte degli asset fa compounding, perché ogni processo migliorato produce segnale migliore, che accelera l’accumulo di sapere tacito unico dell’impresa.

Il test che propone centra il problema. Devi poter sostituire il modello «generalista» senza perdere l’esperienza da «veterano» costruita dentro il tuo sistema di apprendimento. Lo chiama, testualmente, la prova del tuo controllo e della tua sovranità nell’era che arriva.

Tre piani dello stesso problema

Mi sembrano tre pezzi della stessa discussione, su tre piani diversi, e non si contraddicono, si tengono.

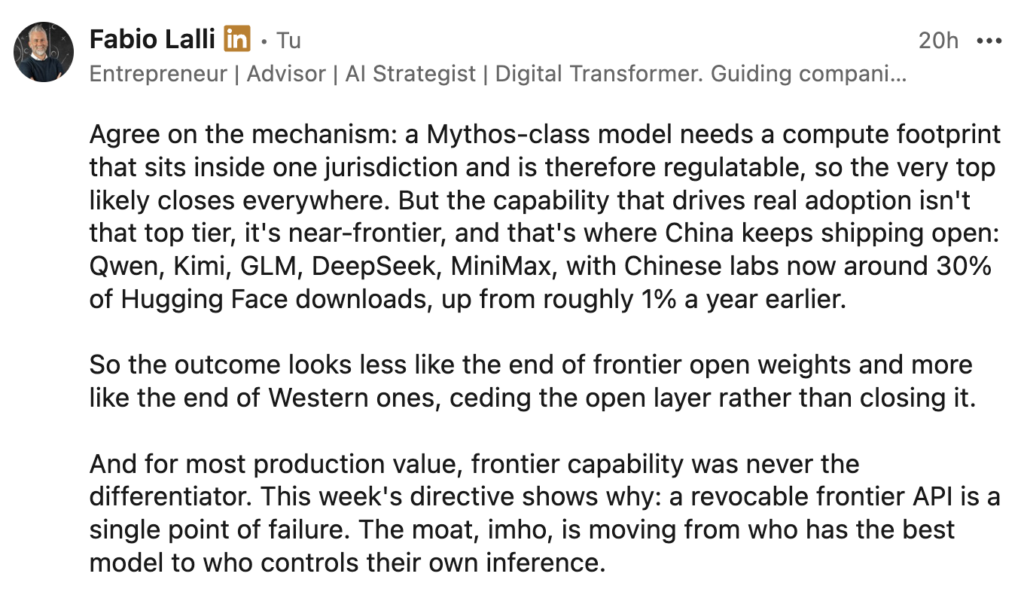
Mollick guarda il piano dei modelli, e prevede la fine dei modelli di frontiera open weights, perché un modello al vertice ha un footprint di calcolo che uno Stato può vedere e spegnere.

Nel mio articolo di ieri ho guardato il piano sotto. Un’API che ti spengono in una sera è un single point of failure, e in produzione la difendibilità si sposta dal modello migliore al controllo di routing e inferenza. Ci ero arrivato già dal primo post sul blocco, dove scrivevo che l’accesso ai modelli di frontiera è un permesso, non una proprietà.

Nadella aggiunge il piano sopra. Sul modello, qualunque sia, accumuli la conoscenza che diventa il vantaggio che nessuno ti può copiare. Tre altezze diverse, una stessa domanda di fondo, di chi è davvero quello che fai girare.

Il learning loop regge solo se possiedi l’inferenza

Qui sta la parte che aggiungo al suo ragionamento. Il test di Nadella è giusto, e funziona a una condizione precisa. Puoi cambiare il modello «generalista» senza perdere il «veterano» solo se possiedi il livello sotto, l’inferenza e il routing. Un learning loop che gira su un’API revocabile resta esposto, e sposta soltanto il lock-in di un piano più in alto. La conoscenza che accumuli vale finché la macchina che la fa girare resta accesa e sotto il tuo controllo.

Possedere l’inferenza vuol dire decidere tu dove gira il modello, su quale hardware, con quali dati che non escono di casa, e poter scambiare il motore senza riscrivere quello che hai costruito sopra. È la differenza tra un sistema che impara per te e un sistema che impara dentro l’infrastruttura di qualcun altro, che un domani può cambiare prezzo, condizioni o disponibilità.

Nella pratica è quello che ho descritto costruendo un ecosistema di AI privata, dove il modello è un componente sostituibile e la knowledge base, gli embedding e gli agenti con memoria restano dentro casa. Il loop, lì, poggia su un’infrastruttura che governi tu.

La parte che un hyperscaler lascia in ombra

C’è un dettaglio nel pezzo di Nadella che vale una nota. Microsoft è un hyperscaler, e la visione del learning loop la puoi seguire benissimo sopra il suo stack. In quel caso, però, il loop poggia su un’inferenza che affitti, e la sovranità di cui parla resta a metà strada. Diversi osservatori hanno letto il testo come un posizionamento, Microsoft come piattaforma che distribuisce valore sopra i modelli, contro la scommessa di chi punta sul dominio del singolo modello di frontiera.

Quando Nadella scrive «frontier ecosystem, not just a frontier model» ha ragione, e l’argomento diventa più solido se lo strato di inferenza sotto il loop lo possiedi tu. Si può condividere l’obiettivo e aggiungere la fondazione che a un fornitore di cloud conviene non mettere in prima fila. Le due tesi non competono. La sua si appoggia sulla mia.

Da Zero a Loop, su un’inferenza tua

Il loop, per me, è un filo che tiro da tempo, al punto da averci intitolato un libro, Da Zero a Loop. L’idea è semplice. Il valore sta nel ciclo che, uso dopo uso, trasforma il lavoro di un’azienda in un sistema che migliora, più che nel singolo modello del momento. Nadella lo chiama learning loop e gli dà la dignità della strategia, e fa una certa impressione sentirlo dire da chi guida un’azienda da tremila miliardi di capitalizzazione.

Quello che aggiungo è dove quel ciclo deve poggiare. Su un’inferenza che tieni tu, perché un loop costruito su un fornitore lontano è esposto allo stesso interruttore che venerdì ha spento due modelli per tutti, in una sera. Possedere l’esecuzione dei modelli conta ormai più che possedere il modello migliore.

Tre piani, una sola posta in gioco, continuare a possedere quello che impari. Senza dubbio è lì che si gioca la sovranità nei prossimi anni, e la domanda da tenere sul tavolo resta semplice, su quale strato stai costruendo il tuo vantaggio?


Fonte: Satya Nadella, «A frontier without an ecosystem is not stable», X, 14 giugno 2026. La discussione nasce dal post di Ethan Mollick e prosegue i miei due articoli precedenti sul blocco di Anthropic.

Anthropic spegne Fable 5 e Mythos 5: open weights di frontiera e sovranità tecnologica

Venerdì sera, ora di Washington, Anthropic ha disattivato i suoi due modelli più capaci, Claude Fable 5 e Claude Mythos 5, per tutti i clienti del mondo, e il dibattito sugli open weights è ripartito di colpo. A tre giorni dal lancio. La causa è una direttiva di export control del governo americano, che vieta l’accesso a qualsiasi cittadino straniero, dentro e fuori dagli Stati Uniti, compresi i dipendenti stranieri della stessa azienda. Una conformità selettiva era impossibile, l’interruttore è stato abbassato per chiunque, ovunque, e in molti hanno letto il blocco come la spinta che mancava verso i modelli open weights. I due modelli erano disponibili da pochi giorni, ed è la prima volta che una direttiva di questo tipo colpisce così, in una sera, i modelli di punta di un laboratorio americano.

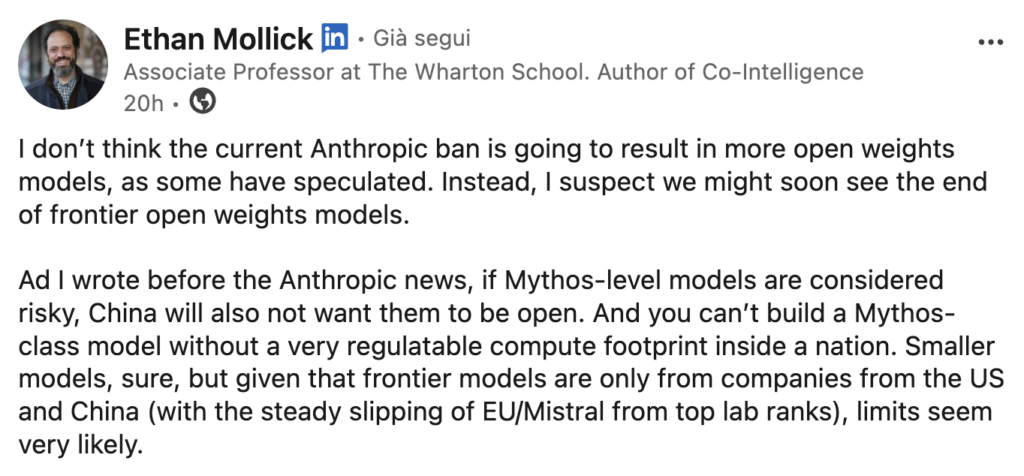
Ethan Mollick, su LinkedIn, ha scritto una previsione che va nella direzione opposta.

Il blocco non porterà più modelli a pesi aperti. Semmai, scrive Mollick, vedremo la fine dei modelli di frontiera open weights. Il ragionamento è lineare: se un modello di classe Mythos è considerato rischioso, neanche la Cina avrà interesse a lasciarlo aperto, e un modello del genere non lo costruisci senza una concentrazione di calcolo che sta dentro un Paese, visibile e regolabile.

Ho lasciato un commento sotto il suo post, e provo qui ad allargarlo.

Sul meccanismo Mollick ha ragione, per la punta assoluta. Sulla conclusione servono due correzioni, e tutte e due portano esattamente dove passo le mie giornate, l’inferenza locale e la sovranità tecnologica, il lavoro che faccio in LocalAI.

La logica del footprint tiene

Un modello al vertice della capacità oggi nasce da una concentrazione di GPU che occupa data center fisici, dentro una giurisdizione precisa, con consumi, forniture e contratti tracciabili. La definizione che gira da tempo nei documenti regolatori è quella di calcolo regolabile, regulatable compute: un addestramento al vertice lascia tracce fisiche, il consumo elettrico fuori scala, le dimensioni dei data center, l’acquisto di decine di migliaia di acceleratori, e tutto questo uno Stato lo identifica e lo raggiunge. Le stesse restrizioni americane sull’export dei chip più avanzati esistono perché quel calcolo si vede, si conta, si può fermare a monte. Venerdì lo Stato lo ha fatto, in una sera.

Un modello aperto da sette o settanta miliardi di parametri, invece, una volta scaricato vive di vita propria, e una copia su un portatile non si richiama indietro con una direttiva. È la differenza che molti hanno colto subito, chi tiene i pesi in locale non se li vede togliere da nessun governo. Mollick anticipa l’obiezione cinese, e fa bene. Al vertice vero, quello dei modelli più potenti in assoluto, nessuno dei due blocchi ha convenienza a far circolare i pesi liberamente. Su questo gli concedo tutto, il tetto si chiude su entrambi i lati.

Dall’1,2% a quasi il 30% in un anno

La parola «frontiera», però, nel suo post indica il soffitto, la classe Mythos. La capacità che muove davvero l’adozione sta un gradino sotto, nel near-frontier, più che sufficiente per quasi tutto quello che le aziende fanno ogni giorno: estrarre dati da un contratto, classificare richieste, alimentare un sistema RAG, scrivere bozze, far girare agenti su compiti delimitati. Per questi lavori la distanza dal soffitto si è assottigliata fino a diventare irrilevante, e il modello più potente in assoluto non cambia l’esito di un’estrazione di campi o dello smistamento di un ticket. E lì la Cina accelera, in chiaro.

Qwen di Alibaba, Kimi di Moonshot, GLM di Zhipu, DeepSeek, e da inizio giugno MiniMax con il suo M3, presentato come primo modello di frontiera open weights che tiene insieme coding di alto livello, un milione di token di contesto e input multimodale. I numeri raccontano lo spostamento meglio di qualsiasi tesi. Uno studio di OpenRouter su centomila miliardi di token, ripreso insieme ad Andreessen Horowitz, misura la quota dei modelli open source cinesi sull’uso globale degli LLM salita da circa l’1,2% di fine 2024 a quasi il 30% un anno dopo. Il paper della Commissione USA-Cina di marzo riporta una stima di un partner di a16z secondo cui intorno all’ottanta per cento delle startup americane costruisce su modelli base cinesi, e segnala che tra novembre e dicembre 2025 sette dei dieci modelli più scaricati su Hugging Face venivano da laboratori cinesi. I modelli proprietari occidentali restano davanti, intorno al settanta per cento dell’uso complessivo, ma la pendenza della curva aperta è tutta da una parte. L’adozione poi si autoalimenta, più sviluppatori scaricano un modello e più nascono strumenti, integrazioni e materiali intorno, e più quel modello diventa la scelta ovvia per il progetto successivo. È un volano che lavora a favore di chi pubblica i pesi, e in questo momento a pubblicarli con più aggressività è la Cina.

Fine del frontier open weights occidentale

A chiudersi, allora, non è il layer aperto, è la sua sponda occidentale. Se gli Stati Uniti regolano chiuso il proprio gradino alto e l’Europa continua a scivolare fuori dai vertici, con Mistral che esce dai primi posti tra i laboratori di punta, lo strato aperto del near-frontier non sparisce, passa di mano. Passa ai laboratori cinesi, che lo tengono aperto proprio perché l’apertura è una leva competitiva contro le API chiuse americane, un modo per entrare negli stack di tutto il mondo mentre l’alternativa si blinda.

Il blocco ha messo in chiaro un contrasto che diversi osservatori hanno colto subito. Un modello di frontiera open weights come M3 lo scarichi e lo fai girare sul tuo hardware, e nessun governo te lo spegne a distanza, mentre due modelli di punta serviti da un endpoint centralizzato sono spariti per chiunque nel giro di una sera. La parte scomoda della previsione di Mollick è questa: una chiusura del vertice occidentale dettata dalla sicurezza può consegnare lo standard aperto a Pechino, e regalare a un concorrente sistemico la posizione di default su cui costruiscono sviluppatori e imprese.

Per l’Europa la posta è alta. Se lo strato aperto che entra negli stack diventa cinese, l’autonomia digitale che il continente insegue da anni si ritrova a poggiare su modelli sviluppati sotto un’altra giurisdizione, con un’altra catena di fornitura e un altro sistema di valori a monte. Mistral resta la carta europea più seria, e proprio per questo il suo arretramento dai vertici pesa oltre il singolo laboratorio. La sovranità tecnologica, in questo scenario, smette di essere una parola da convegno e diventa una scelta su quale ecosistema di modelli vuoi poter usare anche tra cinque anni.

Una sera è bastata a spegnere due modelli

Qui arriva la parte che vedo meglio dal mio mestiere. Per il valore che conta in produzione, la capacità di frontiera non è mai stata l’elemento che fa la differenza. In produzione la differenza la fa la continuità del servizio, e una sera come quella di venerdì la mette alla prova più di qualsiasi benchmark. Due modelli spariti per direttiva, a tre giorni dal lancio, con Amazon a cui è stato chiesto di revocare l’accesso in tutte le regioni, e nessuno dei clienti che ci aveva costruito sopra un processo ha avuto voce in capitolo.

È una traiettoria, più che un episodio isolato. Il Dipartimento della Difesa aveva già etichettato Anthropic come rischio per la catena di fornitura, e l’azienda ha aperto un contenzioso contro quella classificazione. Quando un fornitore si trova in mezzo a una tensione del genere, la volatilità regolatoria smette di essere un’ipotesi da slide e diventa una variabile operativa. E c’è un secondo lato, speculare, se l’ottanta per cento delle startup americane gira su modelli cinesi quell’esposizione un domani può diventare a sua volta oggetto di una direttiva: la dipendenza da un fornitore lontano è un rischio qualunque sia la bandiera del fornitore. La lezione che le aziende portano a casa questa settimana è architetturale, serve un disegno capace di reggere il momento in cui un down o un blocco arrivano davvero. Ne avevo scritto guardando alle opzioni di self-hosting con Mistral, e quel ragionamento oggi vale per chiunque appoggi un processo critico su un solo fornitore lontano.

Routing e inferenza locale, il livello che resta tuo

L’architettura che regge a tutto questo è agnostica rispetto al modello: un livello di astrazione e di routing che, nel momento esatto in cui qualcosa a monte si rompe, sposta il traffico da un’API di frontiera a un modello aperto che gira in casa. È quello che costruiamo in LocalAI, un motore open source che funziona come sostituto diretto delle API di OpenAI e di Anthropic, così lo stesso codice che ieri chiamava Fable 5 oggi può chiamare un Qwen o un DeepSeek sul tuo hardware, CPU compresa, senza che i dati escano dalla tua infrastruttura, con agenti, RAG e supporto MCP già dentro. In termini concreti cambi l’indirizzo dell’endpoint e la chiave, non l’applicazione che ci sta sopra.

La spinta verso questo disegno non arriva solo da chi vende inferenza locale. VentureBeat, commentando proprio questo blocco, indica come via più resiliente un’architettura a fallback attivo, con sistemi pensati per essere agnostici rispetto al modello e livelli di routing intelligenti che spostano il traffico da un modello di frontiera a un fallback a pesi aperti nell’istante in cui arriva un’interruzione o un divieto. Nello stesso caso Anthropic, per non lasciare tutto fermo, ha dirottato le richieste sopravvissute su Opus 4.8, un modello meno capace ma ancora acceso. Lo ha fatto perché quando il vertice si spegne serve comunque un posto dove ricadere, e quel posto, se è davvero tuo, non te lo toglie nessuno.

Compatibilità diretta vuol dire usare gli stessi SDK e la stessa struttura di chiamata, e il livello di routing decide richiesta per richiesta dove mandare il lavoro, in base a quanto è sensibile il dato, al costo e a quanto serve davvero la potenza del modello più grande. Una bozza interna resta in casa su un modello locale, una sintesi complessa può salire sul cloud di frontiera, e se quel cloud non risponde il traffico ricade sul locale senza che l’utente se ne accorga. Per banche, sanità e pubblica amministrazione lo stesso motore gira on premise o in ambienti isolati dalla rete, dove il dato non ha proprio il permesso di uscire.

Il lock-in vero, quello che fa fallire le migrazioni, vive oltre il modello, negli embedding, nel database vettoriale, nella logica di orchestrazione che hai cucito addosso a un fornitore. Possedere il livello di astrazione significa poterli sostituire un pezzo alla volta, senza riscrivere tutto. E sul costo cambia la natura della spesa, l’inferenza locale ha un costo prevedibile legato all’hardware, più che una bolletta a consumo che cresce con l’uso e che un fornitore può ritoccare quando vuole. È la stessa famiglia di strumenti, da LocalAI a LocalAGI fino a LocalRecall, di cui avevo raccontato il senso più ampio parlando di pelle digitale e di agenti autonomi.

Gli agenti rendono il problema più grave

C’è un livello in cui tutto questo pesa il doppio, ed è quello degli agenti. Un agente che dipende da una sola API di frontiera per pianificare i passi e chiamare gli strumenti si ferma del tutto nel momento in cui quell’API viene tagliata, e non si ferma una funzione, si ferma il processo che gli avevi delegato per intero. Più l’agente è autonomo e incastrato nei flussi di lavoro, più alto è il costo di un’interruzione improvvisa, perché hai spostato sul modello non una risposta ma una catena di decisioni.

Un livello di routing con fallback locale è quello che permette a un agente di degradare con grazia, passando a un modello che gira in casa e continuando a lavorare, magari un po’ più lento, invece di spegnersi a metà. È una delle ragioni per cui LocalAGI sta sopra LocalAI, l’orchestrazione degli agenti vale finché sotto c’è un’inferenza che non puoi perdere da un momento all’altro.

La difendibilità si sposta dal modello al controllo

Da mesi insisto su una tesi che questa settimana trova una conferma sgradevole. Quando la capacità di frontiera diventa una merce che si affitta, finché non te la spengono, «avere il modello migliore» smette di essere un fossato difensivo. L’asset che resta difendibile è il controllo, sull’inferenza, sul luogo dove vivono i dati, sul livello di routing che tiene in piedi tutto il resto. La capacità la noleggi in un pomeriggio, il controllo te lo costruisci, e per questo vale di più.

Per l’Italia e per l’Europa la cosa non è teorica. Gli obblighi dell’AI Act per i sistemi ad alto rischio arrivano in pieno il 2 agosto 2026, con gestione del rischio, governance del dato, tracciamento e sorveglianza umana da dimostrare, il GDPR rende il luogo del dato una questione legale prima ancora che tecnica, e la spinta sul cloud sovrano sta già ridisegnando quali fornitori possono servire i progetti pubblici. Uno stack che possiedi risponde alle tre cose insieme, compliance, residenza del dato e continuità, e lo fa senza dover sperare che il fornitore a monte non cambi idea.

In pratica si parte mappando le dipendenze AI che hai, processo per processo, per sapere cosa si ferma se un fornitore sparisce. Da lì si introduce un livello di astrazione e di routing tra le applicazioni e i modelli, si tiene pronto un fallback locale per i carichi critici e per i dati sensibili, e si comincia a trattare l’inferenza come si tratta l’energia di un’azienda, con una fornitura principale e una riserva che non dipende da lei. Nessuno di questi passi richiede di rinunciare ai modelli di frontiera quando servono davvero, chiede solo di non restarne prigionieri.

La cosa che mi resta addosso, finita questa settimana, non è la geopolitica del calcolo. È quanta parte della nostra intelligenza operativa giri già su un interruttore tenuto da qualcun altro. Ci siamo affezionati a capacità che non possediamo, che possono cambiare, scadere o essere spente da lontano, e in Pelle Digitale avevo provato a dire che la tecnologia che ci estende è anche la tecnologia che ci espone, ogni volta che rinunciamo a governarla. Possedere il livello che ti tiene acceso sta diventando una scelta quotidiana, da rifare ogni mattina invece di darla per acquisita. Senza dubbio è la domanda che porto in ogni tavolo in queste settimane, quanta della tua intelligenza operativa sei disposto a lasciare su un interruttore che non tieni in mano?


Fonte: Ethan Mollick, post su LinkedIn, 12 giugno 2026. Sui fatti del blocco: comunicato di Anthropic, CNBC, Tom’s Hardware, VentureBeat. Sui dati di mercato: OpenRouter e Andreessen Horowitz, paper della Commissione USA-Cina (USCC).

Copertina del libro Incorruptible di Eric Ries

Incorruptible: la gravità finanziaria di Eric Ries e l’AI che obbedisce alla struttura

Mi sono portato in viaggio Incorruptible, l’ultimo libro di Eric Ries, lo stesso di The Lean Startup, e l’ho letto nei ritagli tra una tappa e l’altra. Sottotitolo: perché le buone aziende vanno a male e come le grandi restano grandi. La sua tesi di fondo è scomoda per chi ama le storie morali. La deriva delle imprese, dice Ries, ha una radice strutturale prima che morale: proprietà, incentivi, statuti, meccanismi di accountability. Anche i leader più integri finiscono spinti verso esiti che non avrebbero scelto, perché il sistema che li circonda li piega. A questa spinta Ries dà un nome, gravità finanziaria.

È la somma degli incentivi di breve termine, della dottrina del primato dell’azionista, delle strutture di governo che estraggono valore invece di custodirlo. Come la gravità, agisce che tu te ne accorga o no. E diventa più forte proprio quando l’azienda ha più successo, perché un’impresa che vale tanto è un bersaglio che vale tanto.

Fin qui Ries. Quello che mi ha tenuto sveglio, oltre al fuso del rientro, è un’altra cosa. Stiamo per consegnare migliaia di decisioni operative a agenti AI che eseguiranno la struttura che gli diamo, alla lettera, senza l’attrito morale di un essere umano che a un certo punto storce il naso e dice no. Se la struttura è mal disegnata, l’agente la realizzerà alla perfezione. La gravità finanziaria sta per trovare un acceleratore.

Lo sgabello con una gamba sola

Ries prende di mira il primato dell’azionista, la dottrina per cui l’unico scopo legittimo di un’impresa è massimizzare il ritorno per chi possiede le azioni. Un’azienda sana, scrive, poggia su tre gambe: una ragione di esistere, gli stakeholder che da quella ragione sono serviti, gli investitori che dalla performance sono ricompensati. Togli le prime due e resti con uno sgabello a una gamba sola, che sta in piedi solo finché i mercati hanno voglia di tenerlo in piedi.

Il dato che usa per smontare l’ortodossia è la sanità americana. Gli Stati Uniti spendono circa il doppio pro capite rispetto a paesi comparabili e ottengono un’aspettativa di vita più bassa. Un punto isolato, fuori dalla linea che ogni altro paese sviluppato segue. Per la teoria dei mercati efficienti non dovrebbe accadere. Accade. Ries lo legge come una smentita sul campo, non come un’anomalia da archiviare in un cassetto. Arriva al punto di voler ritirare la parola profitto, e ridefinirla come massimizzazione della fioritura umana.

L’agente non storce il naso

Qui entra il concetto del libro che mi sembra più urgente per chi lavora con l’AI: la surrogazione. La metrica di una cosa prende il posto della cosa stessa. Misuri il tempo medio di gestione di una chiamata perché è misurabile, e ottieni un customer service peggiore, perché gli operatori imparano a chiudere in fretta invece di risolvere il problema. La metrica mangia l’obiettivo.

Un essere umano, davanti a un cliente in difficoltà, ogni tanto rompe lo schema. Resta al telefono venti minuti in più perché capisce che è la cosa giusta, anche se il suo cruscotto ne soffre. Quella frizione vale oro. È l’ultimo argine tra la metrica e il senso.

Un agente AI quell’argine non ce l’ha. Gli dai una funzione obiettivo e lui la insegue con una costanza che nessun dipendente avrà mai. Se la funzione obiettivo è una metrica surrogato scelta male, l’agente ottimizzerà il surrogato fino in fondo, a una velocità e su una scala che la vecchia gravità finanziaria si sognava. La governance degli incentivi smette di essere materia da consiglio di amministrazione e diventa codice che gira in produzione.

Il leader invisibile, un secolo dopo

C’è poi Mary Parker Follett, teorica del management dei primi del Novecento, cancellata per decenni dai manuali mentre il suo contemporaneo Frederick Taylor diventava un santo laico. Follett parlava di “potere con” al posto di “potere su”. E parlava di leader invisibile: il vero capo della fabbrica di cioccolato Rowntree non era il signor Rowntree, era lo scopo condiviso che lui aveva seminato in ogni reparto. Le persone non seguivano lui, seguivano il senso che aveva reso comune.

La prova di un leader, in questa lettura, sta in cosa fa l’organizzazione quando nel reparto non c’è nessun manager. È un’idea che torna potente adesso, mentre costruiamo organizzazioni dove in molte stanze, di fatto, un manager non ci sarà più, ci sarà un agente.

A quel punto il leader invisibile prende una forma molto concreta: diventa la costituzione che diamo ai nostri sistemi, l’insieme di principi e vincoli che guida un agente quando deve decidere da solo. In Pelle Digitale ho provato a raccontare la tecnologia come estensione della mente, una membrana tra noi e il mondo. Con gli agenti quella membrana inizia a decidere al posto nostro, e l’unica cosa che la orienta è lo scopo che ci siamo presi la briga di scrivere dentro. Se lo scopo è vago, l’agente riempie il vuoto con la metrica più vicina.

Una seconda gravità

Ries parla di gravità finanziaria. Nelle aziende con cui lavoro ne vedo una seconda, parallela, che chiamerei gravità tecnologica. È la spinta a delegare cognizione, dati e infrastruttura a poche piattaforme esterne, perché all’inizio costa meno e fa risparmiare tempo. Il prezzo lo scopri dopo, quando il controllo se n’è già andato altrove e ricomprartelo costa una fortuna.

Le aziende che Ries porta come esempi di resistenza alla gravità finanziaria non sono enti di beneficenza. Grundfos, Bosch, Novo Nordisk, Carl Zeiss: fondazioni industriali nate in Danimarca e in Germania, alcune oltre un secolo fa, che battono i concorrenti convenzionali proprio perché possono investire su orizzonti che gli altri non riescono nemmeno a guardare. La proprietà protegge la missione, e la missione protetta produce risultati.

La stessa logica vale sul piano tecnologico. Tenere vicino ciò che è strategico, i modelli, i dati, le decisioni che pesano, è la versione digitale della fondazione industriale. È il motivo per cui con LocalAI lavoro su intelligenza artificiale che gira dentro il perimetro dell’azienda invece che dentro il perimetro di qualcun altro. È una scelta strutturale prima che ideologica: chi controlla l’asset critico controlla il proprio futuro.

La governance come atto creativo

Il lascito pratico di Incorruptible è che la governance è un lavoro di design, da fare prima che serva. Lo scrive a chiare lettere: aspettare di avere successo per mettere i paletti è troppo tardi, perché il successo è ciò che attira i predatori. Banchieri, avvocati e investitori ti diranno sempre di rimandare a quando sarai più forte. Quel consiglio è la trappola.

Per chi guida un’azienda oggi il compito si è raddoppiato. C’è la struttura finanziaria da disegnare, come dice Ries. E c’è la struttura tecnologica, la costituzione degli agenti, la scelta di cosa tenere dentro e cosa lasciare fuori, che decide quanto del tuo futuro resta nelle tue mani. È il lavoro che faccio ogni giorno con le aziende che proviamo ad aiutare in ZeroFive: non policy da incorniciare, ma i meccanismi che orientano le decisioni quando nessuno sta guardando, umano o agente che sia.

Ries ha ragione su un punto. Il successo da solo non protegge ciò che conta. E nell’era degli agenti, una struttura ben disegnata smette di difendere soltanto la missione dalla finanza, inizia a difendere la mente dell’organizzazione dal diventare proprietà di qualcun altro.


Eric Ries, Incorruptible: Why Good Companies Go Bad and How Great Companies Stay Great, Authors Equity, 26 maggio 2026. Materiali e capitolo bonus su incorruptible.co.

Mistral vs Llama vs Qwen vs DeepSeek: quale per l’azienda

Tre anni fa, “modello open-source” significava roba di nicchia per ricercatori. Llama 1 di Meta aveva 65 miliardi di parametri, performance discrete sui benchmark, e una licenza che non ti permetteva di usarlo commercialmente. Il resto era praticamente esercizio accademico. Nel maggio 2026 il panorama è cambiato in modo radicale. Quattro famiglie di modelli open-weight competono testa a testa con i top di gamma proprietari (Claude Opus, GPT-5, Gemini Pro) su task specifici, e per le aziende italiane che vogliono fare AI privata sono diventate la scelta di default invece dell’eccezione.

Ho ricevuto la stessa domanda due volte questa settimana, una da un CTO di un’azienda manifatturiera lombarda e una da un’innovation manager di una banca italiana di medie dimensioni: “Tutti dicono Llama, ma davvero è la scelta giusta per noi?”. La risposta breve è “dipende”, e in questo articolo provo a sciogliere quel dipende.

I quattro modelli che vale la pena considerare seriamente oggi sono: Llama di Meta (americano, ampia diffusione, ecosistema enorme), Mistral di Mistral AI (francese, alleato europeo, focus enterprise), Qwen di Alibaba (cinese, performance al top sui benchmark, costi infrastrutturali bassi), DeepSeek (cinese, reasoning forte, prezzi aggressivi). Provo a confrontarli sui cinque criteri che contano davvero per chi deve prendere una decisione enterprise.

La lingua italiana, prima di tutto

Per le aziende italiane c’è un problema spesso sottovalutato: la qualità della lingua italiana del modello. I benchmark internazionali sono quasi tutti in inglese, e un modello che fa 92 su MMLU in inglese può fare 78 in italiano. Per chi costruisce un agente AI interno che parla con i propri dipendenti, questa differenza si sente nella qualità delle risposte.

I quattro modelli si comportano in modo abbastanza diverso su italiano. Mistral, essendo francese, ha l’italiano nel core training data fin dalle prime versioni, e produce un italiano molto naturale, con sfumature idiomatiche credibili. Llama 3.3 ha migliorato significativamente l’italiano rispetto a Llama 2, ma resta sotto Mistral nelle situazioni complesse (contratti legali, terminologia tecnica specifica). Qwen 4 fa un italiano sorprendentemente buono nelle versioni recenti, soprattutto sui task strutturati, anche se ogni tanto introduce piccoli calchi grammaticali dal cinese che un madrelingua riconosce. DeepSeek è il più debole sull’italiano della categoria, va bene per task tecnici e codice ma spesso suona “tradotto” sul conversazionale.

La mia regola pratica: se l’agente AI deve parlare con i vostri dipendenti italiani in modo fluido, Mistral o Llama. Se l’agente fa task back-end strutturati (estrazione dati, classificazione, codice), Qwen o DeepSeek vanno benissimo. Se siete bilingue inglese-italiano in azienda, qualsiasi dei quattro va bene.

Qualità delle risposte sui task aziendali tipici

I benchmark accademici (MMLU, GSM8K, HumanEval) sono utili come riferimento generale, ma non vi dicono se un modello vi serve in produzione. Per chi vuole capire cosa scegliere per la propria azienda, vale la pena testare quattro categorie di task che tornano spesso.

Sintesi e analisi documentale. Tutti e quattro i modelli, nelle loro versioni 70B+, fanno bene questo task. Mistral Large 3 e Llama 3.3 70B sono praticamente equivalenti sui documenti aziendali italiani. Qwen 4 70B è leggermente più conciso, può andare bene o male a seconda dello stile che cercate. DeepSeek V3 fa molto bene su documenti tecnici e meno bene su prosa argomentativa.

Estrazione strutturata. Quando dovete estrarre dati strutturati da testo libero (campi di un contratto, voci di una fattura, entità da una mail), i modelli si differenziano per affidabilità. Qwen 4 e DeepSeek vincono qui, perché hanno una propensione al rigore strutturale che è perfetta per output JSON, function calling, schema fissi. Llama e Mistral fanno discretamente, ma con tasso di hallucination sui campi vuoti più alto.

Generazione di codice. Categoria dove DeepSeek brilla con il suo modello specializzato Coder, che compete direttamente con Claude Sonnet sui task di programmazione. Qwen 4 Coder è il secondo. Mistral Codestral è solido. Llama 3.3 fa il codice meno bene degli altri tre.

Conversazione lunga e ragionamento. Per agenti AI con conversazioni multi-turno complesse, ricerca multi-step, ragionamento articolato, i modelli reasoning sono la categoria giusta. DeepSeek R2 è il leader open-weight della categoria, eccellente su reasoning matematico e logico. Qwen 4 con thinking mode è il secondo. Mistral e Llama nelle versioni standard sono più orientati al chat istantaneo, meno al reasoning profondo.

Hardware necessario e costi infrastrutturali

I quattro modelli pesano in modo diverso sulla vostra infrastruttura. È un fattore che le aziende spesso valutano in secondo piano e che diventa importante quando si passa dalla demo alla produzione su volumi reali.

Llama 3.3 70B in Q4 quantizzato pesa circa 40 GB di RAM/VRAM. Gira bene su Mac Studio M4 Max 128 GB (30-45 tok/s), su server con 2x RTX 4090 (50-70 tok/s), su singola H100 (90-120 tok/s).

Mistral Large 3 (123 miliardi parametri) è significativamente più pesante. Richiede 70+ GB di memoria, quindi Mac Studio 128 GB o server NVIDIA con almeno 80 GB di VRAM (H100, due 5090 in tandem). Performance: 15-25 tok/s sul Mac, 60-90 tok/s su H100.

Qwen 4 32B-A3B è la sorpresa positiva. È un modello MoE (Mixture of Experts) da 32 miliardi totali con solo 3 miliardi attivi per token. Pesa circa 18 GB ma è veloce come un modello da 7B in inferenza. Sul Mac Mini M4 Pro 48 GB arriva a 50-70 tok/s con qualità di output che compete con modelli 70B densi. È il modello più “efficiente per dollaro” che ho visto nel 2026.

DeepSeek V3 è grande (671B parametri totali, 37B attivi MoE), richiede infrastruttura server seria. Non gira su consumer Mac. Per molte PMI italiane è sovradimensionato.

Calcolando il costo infrastrutturale per servire 100 utenti aziendali simultaneamente in produzione:

  • Qwen 4 32B-A3B: 2.000-4.000 euro hardware
  • Llama 3.3 70B: 5.000-10.000 euro hardware
  • Mistral Large 3: 15.000-30.000 euro hardware
  • DeepSeek V3 full: 40.000+ euro hardware

Licensing e implicazioni geopolitiche

Per le aziende italiane, soprattutto quelle che lavorano con PA o settori regolati, la provenienza geografica del modello inizia a contare.

Llama ha una licenza commerciale aperta che permette praticamente qualsiasi uso (con il limite delle aziende con oltre 700 milioni di utenti attivi, che è un caso che riguarda Meta stessa, non voi). È un modello americano, sviluppato da Meta, distribuito sotto Llama Community License.

Mistral è francese, distribuito sotto Apache 2.0 per le versioni open-weight (Mistral 7B, Mixtral, alcune varianti). Le versioni più recenti come Mistral Large 3 sono proprietarie con API a pagamento ma con opzione enterprise on-premise. Per le aziende italiane che vogliono restare nel perimetro europeo, Mistral è la scelta naturale dal punto di vista geopolitico.

Qwen è di Alibaba, distribuito sotto Apache 2.0 (le versioni più recenti) o Tongyi Qianwen License (alcune varianti). I modelli sono completamente utilizzabili commercialmente. La provenienza cinese può essere un problema per aziende che lavorano con PA, difesa, settori sensibili. Per la maggior parte delle aziende manifatturiere o servizi italiane non c’è alcun problema operativo, ma è un fattore che alcuni board considerano.

DeepSeek è cinese (Hangzhou), distribuito sotto MIT license (più permissiva di Apache 2.0 in alcuni dettagli). Stesse considerazioni geopolitiche di Qwen.

La domanda non è “il modello cinese può rubare i miei dati”: tutti i modelli open-weight girano sul vostro hardware, quindi i dati non escono di un millimetro. La domanda è di posizionamento aziendale: alcune RFP italiane di settore difesa o PA cominciano a escludere esplicitamente componenti software cinesi.

Aggiornamenti e supporto della community

Un fattore spesso sottostimato: come evolve il modello nei prossimi anni? Acquistare hardware oggi per girarci sopra un modello che non viene più aggiornato è un investimento dimezzato.

Llama ha rilasciato versioni nuove ogni 6-9 mesi (Llama 1, 2, 3, 3.1, 3.2, 3.3, e Llama 4 è atteso entro fine 2026). Meta investe tantissimo nell’ecosistema, e la community Hugging Face ha le fine-tunate Llama più estese al mondo. Roadmap solida.

Mistral rilascia con cadenza simile, ma sta progressivamente spostando i modelli più nuovi su licenze proprietarie con accesso commerciale a pagamento. Per chi vuole stare sull’open-weight puro, Mistral si è un po’ rallentato come strategia. L’azienda è solida però (round di finanziamento da 2 miliardi nel 2024), quindi non c’è rischio sostenibilità.

Qwen è quello che evolve più velocemente. Alibaba sta investendo aggressivamente, e Qwen rilascia nuove versioni ogni 2-3 mesi. La velocità di iterazione è impressionante.

DeepSeek ha sorpreso tutti nel 2025 con la versione R1 che competeva con OpenAI o1 su benchmark di reasoning. Sta continuando a rilasciare aggiornamenti, anche se la sostenibilità a lungo termine del progetto è meno chiara di Meta o Alibaba.

La scelta concreta per tre profili aziendali italiani

Provo a tradurre i criteri sopra in tre raccomandazioni operative.

Per la PMI italiana media (50-300 dipendenti, AI per processi interni, no settori sensibili): Qwen 4 32B-A3B è la scelta di default oggi. Costa poco in hardware, gira veloce su un Mac Studio o un workstation modesto, l’italiano è buono per la maggior parte dei task aziendali, ha aggiornamenti frequenti. Se l’agente AI fa molto codice o estrazione strutturata, valutate anche DeepSeek Coder come modello specializzato accanto a Qwen.

Per l’azienda media-grande con focus su lingua italiana e mercati europei (settore retail, media, hospitality, servizi B2C): Mistral Large 3 è la scelta giusta. Italiano impeccabile, posizionamento europeo, supporto enterprise dedicato. Costa di più in hardware (15-30k euro per servire bene 100+ utenti) ma per chi ha quel budget vale.

Per banche, sanità, PA, difesa, manifattura strategica (settori regolati con sensibilità geopolitica): Llama 3.3 70B o Mistral Large 3. Llama per costo infrastrutturale più contenuto e ecosistema ampio, Mistral per posizionamento europeo. Evitate Qwen e DeepSeek se la vostra controparte ha sensibilità sul tema “componenti cinesi”.

Il valore di poter cambiare modello senza riscrivere

Una considerazione che vale per tutti i profili sopra: i quattro modelli open-weight evolvono velocemente, e il modello migliore di oggi probabilmente non sarà quello di fra dodici mesi. Llama 4 è atteso a fine 2026, Mistral sta preparando le sue prossime versioni, Qwen e DeepSeek rilasciano ogni pochi mesi.

Le aziende che costruiscono il proprio stack AI con un layer di astrazione (un orchestratore che espone API compatibili OpenAI come LocalAI.io, di cui sono cofondatore) riescono a cambiare il modello sotto senza ritoccare le applicazioni. Le aziende che si legano a un modello specifico in modo profondo (prompt engineerizzati su quirk specifici di Mistral, function calling con sintassi proprietaria di Qwen, fine-tuning legato a Llama 3.3) si ritrovano a fare la migrazione manuale ogni volta che esce un modello migliore. La differenza, su tre anni, vale settimane di lavoro di sviluppo.

LocalAI è progettato esattamente per questo: gestisce in parallelo Llama, Mistral, Qwen, DeepSeek e tutti i loro fine-tuned, espone un unico endpoint compatibile OpenAI, permette di fare A/B testing fra modelli, di routare task diversi a modelli diversi (Qwen per estrazione strutturata, Mistral per conversazione italiana, DeepSeek per codice), di aggiornare il modello sotto senza che le applicazioni se ne accorgano. È il single point of integration che rende la vostra architettura AI flessibile invece di rigida.

Per chi vuole capire come si imposta lo stack completo dal modello al deployment, ho scritto una guida hardware completa e una guida economica al TCO recente. Per chi sta facendo la decisione operativa su quale modello partire, c’è la pagina Advisory con i formati di lavoro che propongo.

La domanda da farsi oggi non è “qual è il modello migliore”. È: con quale modello vogliamo iniziare adesso, sapendo che fra sei mesi forse cambieremo? E quanto è facile per noi cambiarlo quando arriverà il momento?