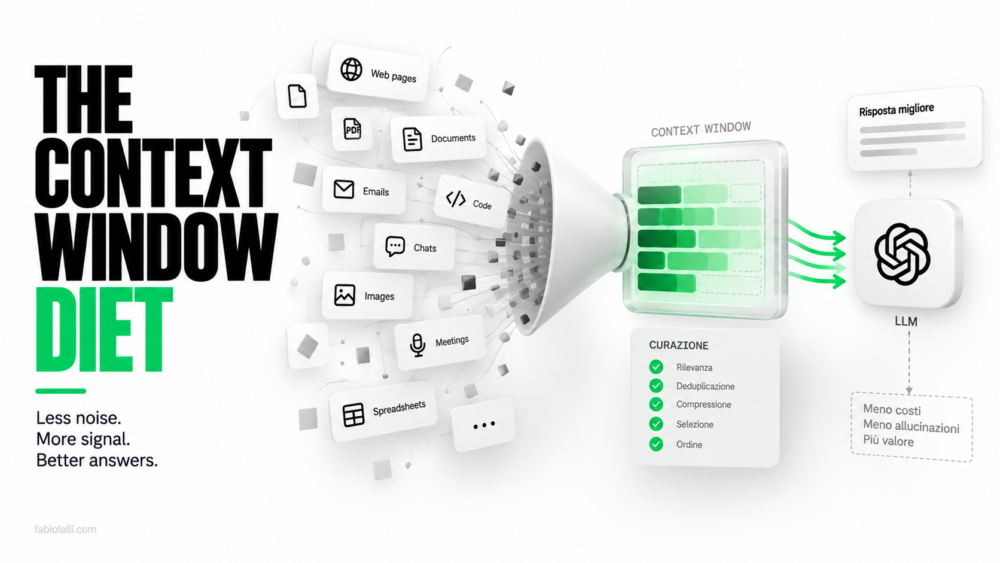
La dieta della finestra di contesto
Quando la finestra di contesto era piccola, il mestiere consisteva nel far stare dentro il necessario. Adesso che ci stanno interi archivi, il riflesso di molti è caricare tutto e lasciare che il modello si arrangi, e la spesa cresce senza che la qualità delle risposte cresca in proporzione.
Una finestra di contesto grande ha risolto un vincolo tecnico e ne ha reso visibile un altro, che riguarda l’attenzione del modello più che la sua capienza.
Il riflesso di caricare tutto
L’abitudine viene dai primi sistemi di recupero, quelli in cui si prendevano i venti frammenti più simili alla domanda e si sperava che la risposta fosse in uno di quelli. Con venti frammenti su un milione di documenti conveniva abbondare, perché il costo di perdersi il pezzo giusto era alto e quello di leggerne qualcuno in più era basso.
Il calcolo cambia quando i frammenti diventano duecento. Il contesto irrilevante non è materiale neutro che il modello scarta senza fatica, è materiale che compete con quello rilevante, e in un testo lungo le informazioni che stanno a metà vengono usate peggio di quelle che stanno agli estremi.
L’effetto della posizione è documentato da tempo. Nel 2023 un gruppo di ricercatori di Stanford guidato da Nelson Liu ha pubblicato Lost in the Middle, uno studio in cui lo stesso documento utile veniva spostato in punti diversi di un contesto lungo, e l’accuratezza dei modelli disegnava una curva a U, alta quando il passaggio giusto stava all’inizio o alla fine e più bassa quando finiva in mezzo. I modelli usciti dopo hanno attenuato quella curva e nessuno ha dimostrato di averla eliminata, per cui più materiale si carica, più aumenta la probabilità che il pezzo decisivo cada proprio nella zona letta peggio.
Più contesto non produce più precisione
Il comportamento si osserva facilmente: prendi una domanda a cui il sistema risponde bene con cinque documenti pertinenti, aggiungi quaranta documenti che parlano dello stesso cliente senza contenere la risposta, e la qualità peggiora. Il modello comincia a citare passaggi vicini al tema e lontani dalla domanda, e quando i documenti si contraddicono fra loro sceglie senza dichiarare di aver scelto.
Chi ha lavorato con archivi reali riconosce lo scenario, perché negli archivi reali la contraddizione è la norma: ci sono tre versioni dello stesso contratto, due delle quali sono bozze mai firmate, e nessuna porta scritto in faccia quale sia quella buona, tanto che la persona esperta la riconosce dal nome del file e dalla cartella in cui sta, informazioni che al modello non arrivano.
Riempire la finestra di contesto solo quando serve
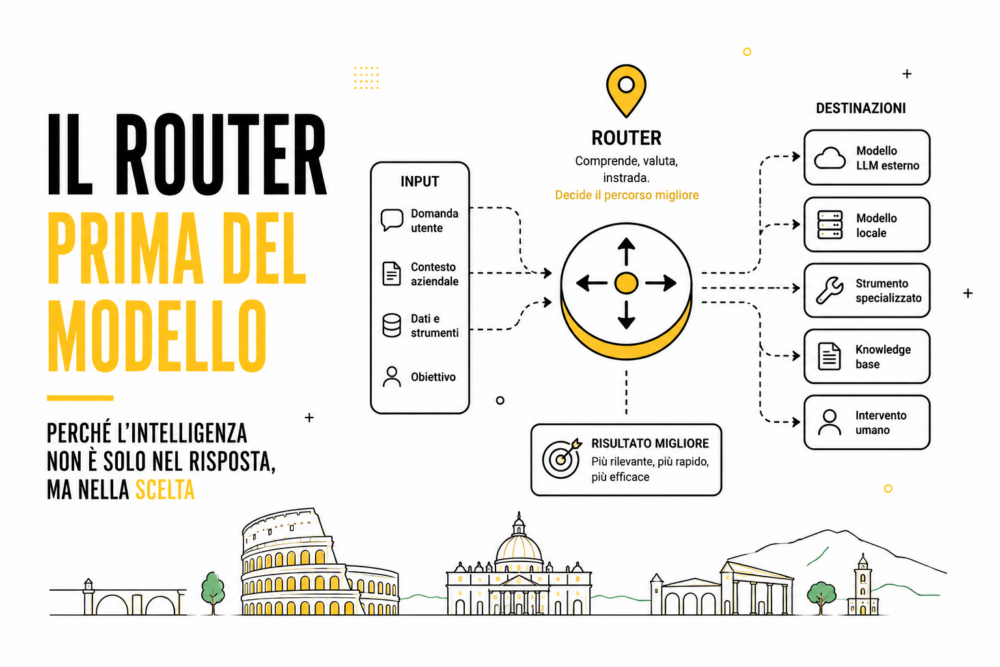
La strada alternativa consiste nel dare all’agente poco materiale e molti modi per chiederne altro. Un indice delle entità, una descrizione di cosa c’è in ciascuna fonte, gli strumenti per interrogarla, e la libertà di fare il secondo giro se il primo non basta.
Anthropic ha chiamato questo approccio contesto just in time, nel testo sul context engineering pubblicato nel 2025, e ha un prezzo che conviene conoscere prima di adottarlo. Ogni giro in più è una chiamata in più, con la sua latenza e i suoi token, e un agente che deve chiedere il materiale funziona solo se sa cosa chiedere: quando l’indice è vago o la descrizione delle fonti è scritta in fretta, l’agente non sa che esiste il documento che gli servirebbe e risponde con quello che ha. La qualità si sposta dal recupero alla descrizione delle fonti, che diventa il testo più letto dell’azienda senza che nessuno lo abbia mai curato come tale.
Il grafo funziona bene in questo schema, perché ti permette di portare nella finestra di contesto solo il perimetro rilevante e di tenere tutto il resto raggiungibile senza essere presente. In una richiesta sui contratti in scadenza entrano l’identificativo del cliente, le entità collegate, i contratti agganciati, e non entra la corrispondenza commerciale degli ultimi tre anni, che pure parla di quel cliente in ogni riga. È lo stesso meccanismo per cui quattro collegamenti costano meno di quaranta documenti, guardato dal lato di cosa entra in finestra.
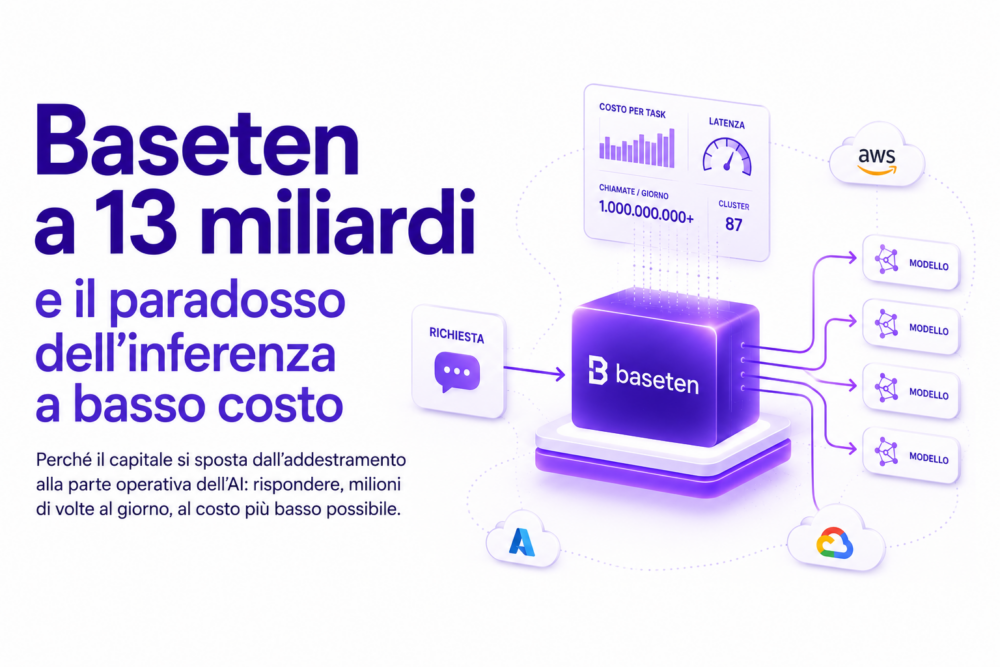
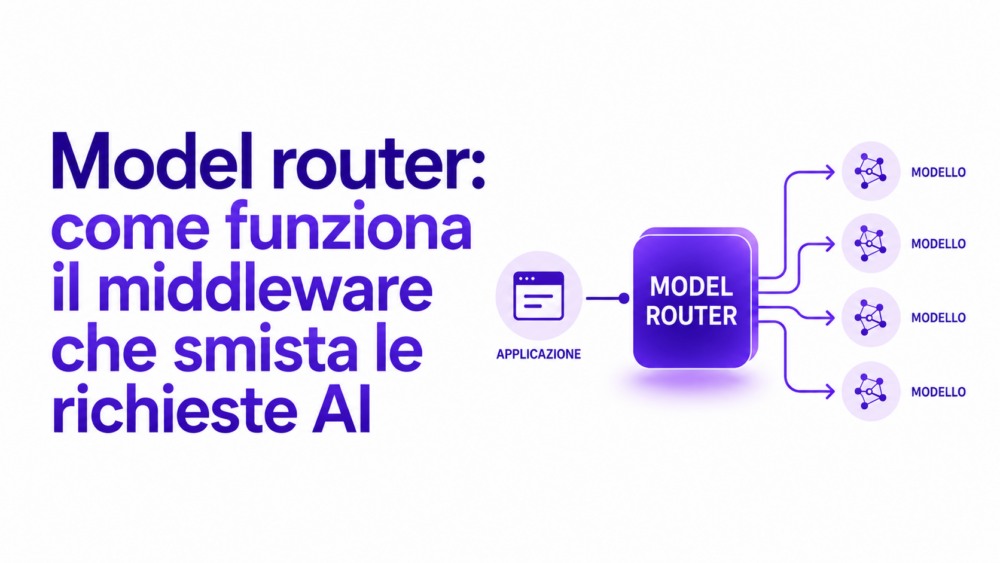
Il middleware che smista le richieste ai modelli sceglie il modello giusto per ogni richiesta, e qui il criterio è lo stesso applicato al materiale invece che al motore.
Il criterio che uso per decidere cosa entra
La domanda che mi pongo davanti a ogni pezzo di contesto è se la risposta cambierebbe senza. Se la risposta resta uguale, quel materiale sta pagando affitto senza produrre niente, e va spostato dietro uno strumento che l’agente può chiamare se gli serve.
La seconda domanda riguarda la durata. Le istruzioni su come comportarsi valgono per tutta la conversazione e conviene tenerle stabili, i dati di un singolo caso valgono per quella richiesta e conviene farli entrare e uscire. Mescolare le due cose produce contesti che crescono a ogni turno e che a un certo punto contengono il residuo di tre richieste fa.
La terza riguarda chi ha scritto quello che sta entrando. Un documento generato da un altro agente e non verificato da nessuno pesa quanto un documento approvato, e il modello non distingue fra i due. Vale la pena incrociarla con il modo in cui il corpus aziendale si gonfia da solo, perché il materiale che compete con quello buono aumenta a ogni riassunto prodotto per riflesso.
Quando il lavoro dura ore
Un agente che porta avanti un compito lungo, fatto di decine di passaggi, incontra il limite della finestra anche quando ogni singolo passaggio è sobrio, perché la storia della sessione si accumula e ogni turno si porta dietro tutti quelli precedenti. Nello stesso testo Anthropic descrive due modi di gestirla: la compattazione, che a un certo punto riassume la conversazione e la fa ripartire con il riassunto al posto del verbale, e le note strutturate, con l’agente che tiene su un file esterno lo stato del lavoro e le decisioni prese, e le rilegge quando servono invece di portarsele dietro a ogni turno.
Entrambe le tecniche spostano una parte del contesto dentro un testo che nessuno ha verificato. Il riassunto della compattazione decide quale parte della conversazione sopravvive, e lo decide il modello con lo stesso criterio statistico che lo porta a preferire il generico allo specifico, mentre le note sono scritte dall’agente su sé stesso. Il terzo criterio torna qui, applicato al materiale che l’agente produce per proprio uso: un riassunto scritto da un modello entra nella finestra successiva con la stessa autorevolezza di un’istruzione scritta da una persona.
Conviene allora separare nel riassunto le decisioni dalle osservazioni, conservare le prime alla lettera e lasciare comprimere solo le seconde, perché una decisione parafrasata due volte finisce per dire qualcosa di diverso da quello che era stato deciso.
Misurare invece di stimare
Il modo per uscire dalle impressioni è tenere due numeri per ogni tipo di richiesta ricorrente: quanti token entrano nella finestra di contesto e quante risposte risultano corrette su un campione che qualcuno ha verificato a mano. Il primo lo dai già per scontato perché arriva in fattura, il secondo richiede un lavoro che quasi nessuno fa e senza il quale il primo non si può ottimizzare, perché tagliare contesto abbassa sempre il costo e a volte abbassa anche la qualità.
Con i due numeri accanto la prova diventa banale: si toglie una fonte per volta e si guarda cosa succede alle risposte corrette. Nelle configurazioni che ho visto ottimizzare così, la metà del materiale caricato non sposta niente, e il quarto che conta davvero è sempre lo stesso in tutte le richieste dello stesso tipo, il che suggerisce di smettere di recuperarlo dinamicamente e di scriverlo una volta nelle istruzioni.
Gli scarti utili
Una parte di quello che resta fuori vale comunque la pena tenerla a portata. Le eccezioni, i casi che l’anno scorso hanno rotto il processo, le decisioni prese in deroga: sono materiale che non serve quasi mai e che quando serve vale molto più di tutto il resto.
È il tipo di conoscenza che in azienda sta nella testa di due o tre persone e che scompare quando quelle persone cambiano ruolo. Un sistema costruito bene non la carica a ogni richiesta, la rende raggiungibile con una chiamata e la mostra quando il caso somiglia a uno di quelli. È anche la parte che più raramente qualcuno si preoccupa di mettere per iscritto, perché non serve a chi già la sa.

 Per mesi ho visto ripetersi la stessa scena: entusiasmo enorme sull’
