Manus AI, la guida completa per le aziende: agente, costi, governance

Cosa significa “agente autonomo” davvero

Per capire Manus AI c’è una distinzione che sembra banale e invece fa tutta la differenza. ChatGPT, Claude, Gemini sono assistenti conversazionali: il ciclo è prompt-risposta, e chi guida il processo resta sempre l’utente, che decompone il problema, lancia richieste in sequenza, ricompone i risultati a mano. Manus rompe questo schema. Riceve un brief in linguaggio naturale, costruisce un piano di esecuzione visibile, e parte da solo, pianifica i passi, apre un browser, esegue ricerche, scarica file, esegue codice, salva risultati, consegna un artefatto finale.

A raccontarlo così sembra una sfumatura semantica, in pratica è un cambio di paradigma, ed è la prima cosa da mettere a fuoco su Manus AI. La documentazione ufficiale di Manus parla di “virtual colleague with its own computer”, e l’immagine rende. L’agente vive in una sandbox Linux Ubuntu completa, con shell, file system persistente, browser Chromium, interpreti Python e Node.js, e può perfino esporre servizi web all’esterno. La parte tecnica più interessante, raccontata in dettaglio dal post di E2B che fornisce l’infrastruttura, è che ogni sessione gira su microVM Firecracker, le stesse macchine virtuali leggere sviluppate da AWS per Lambda. Il risultato pratico è che l’agente può lavorare per decine di minuti, anche un’ora, mantenendo lo stato tra un passo e l’altro, persino quando il dispositivo dell’utente è spento.

Questo cambia il modo in cui si chiede a Manus di fare qualcosa. Un prompt per ChatGPT richiede precisione sulla forma della risposta, perché il modello deve restituire un testo subito. Un brief per Manus richiede precisione sull’obiettivo finale e sui criteri di successo, perché il modello prenderà decine di micro-decisioni autonome durante l’esecuzione, senza poter chiedere conferma a ogni passaggio. È una scrittura più vicina a quella che useresti per un consulente esterno che riceve un brief e torna dopo due giorni con il dossier, non a quella che useresti per un assistente in chat. Tengo questa analogia per tutta la guida, perché è la chiave mentale che fa funzionare lo strumento.

Le due modalità e il pannello “Manus’s Computer”

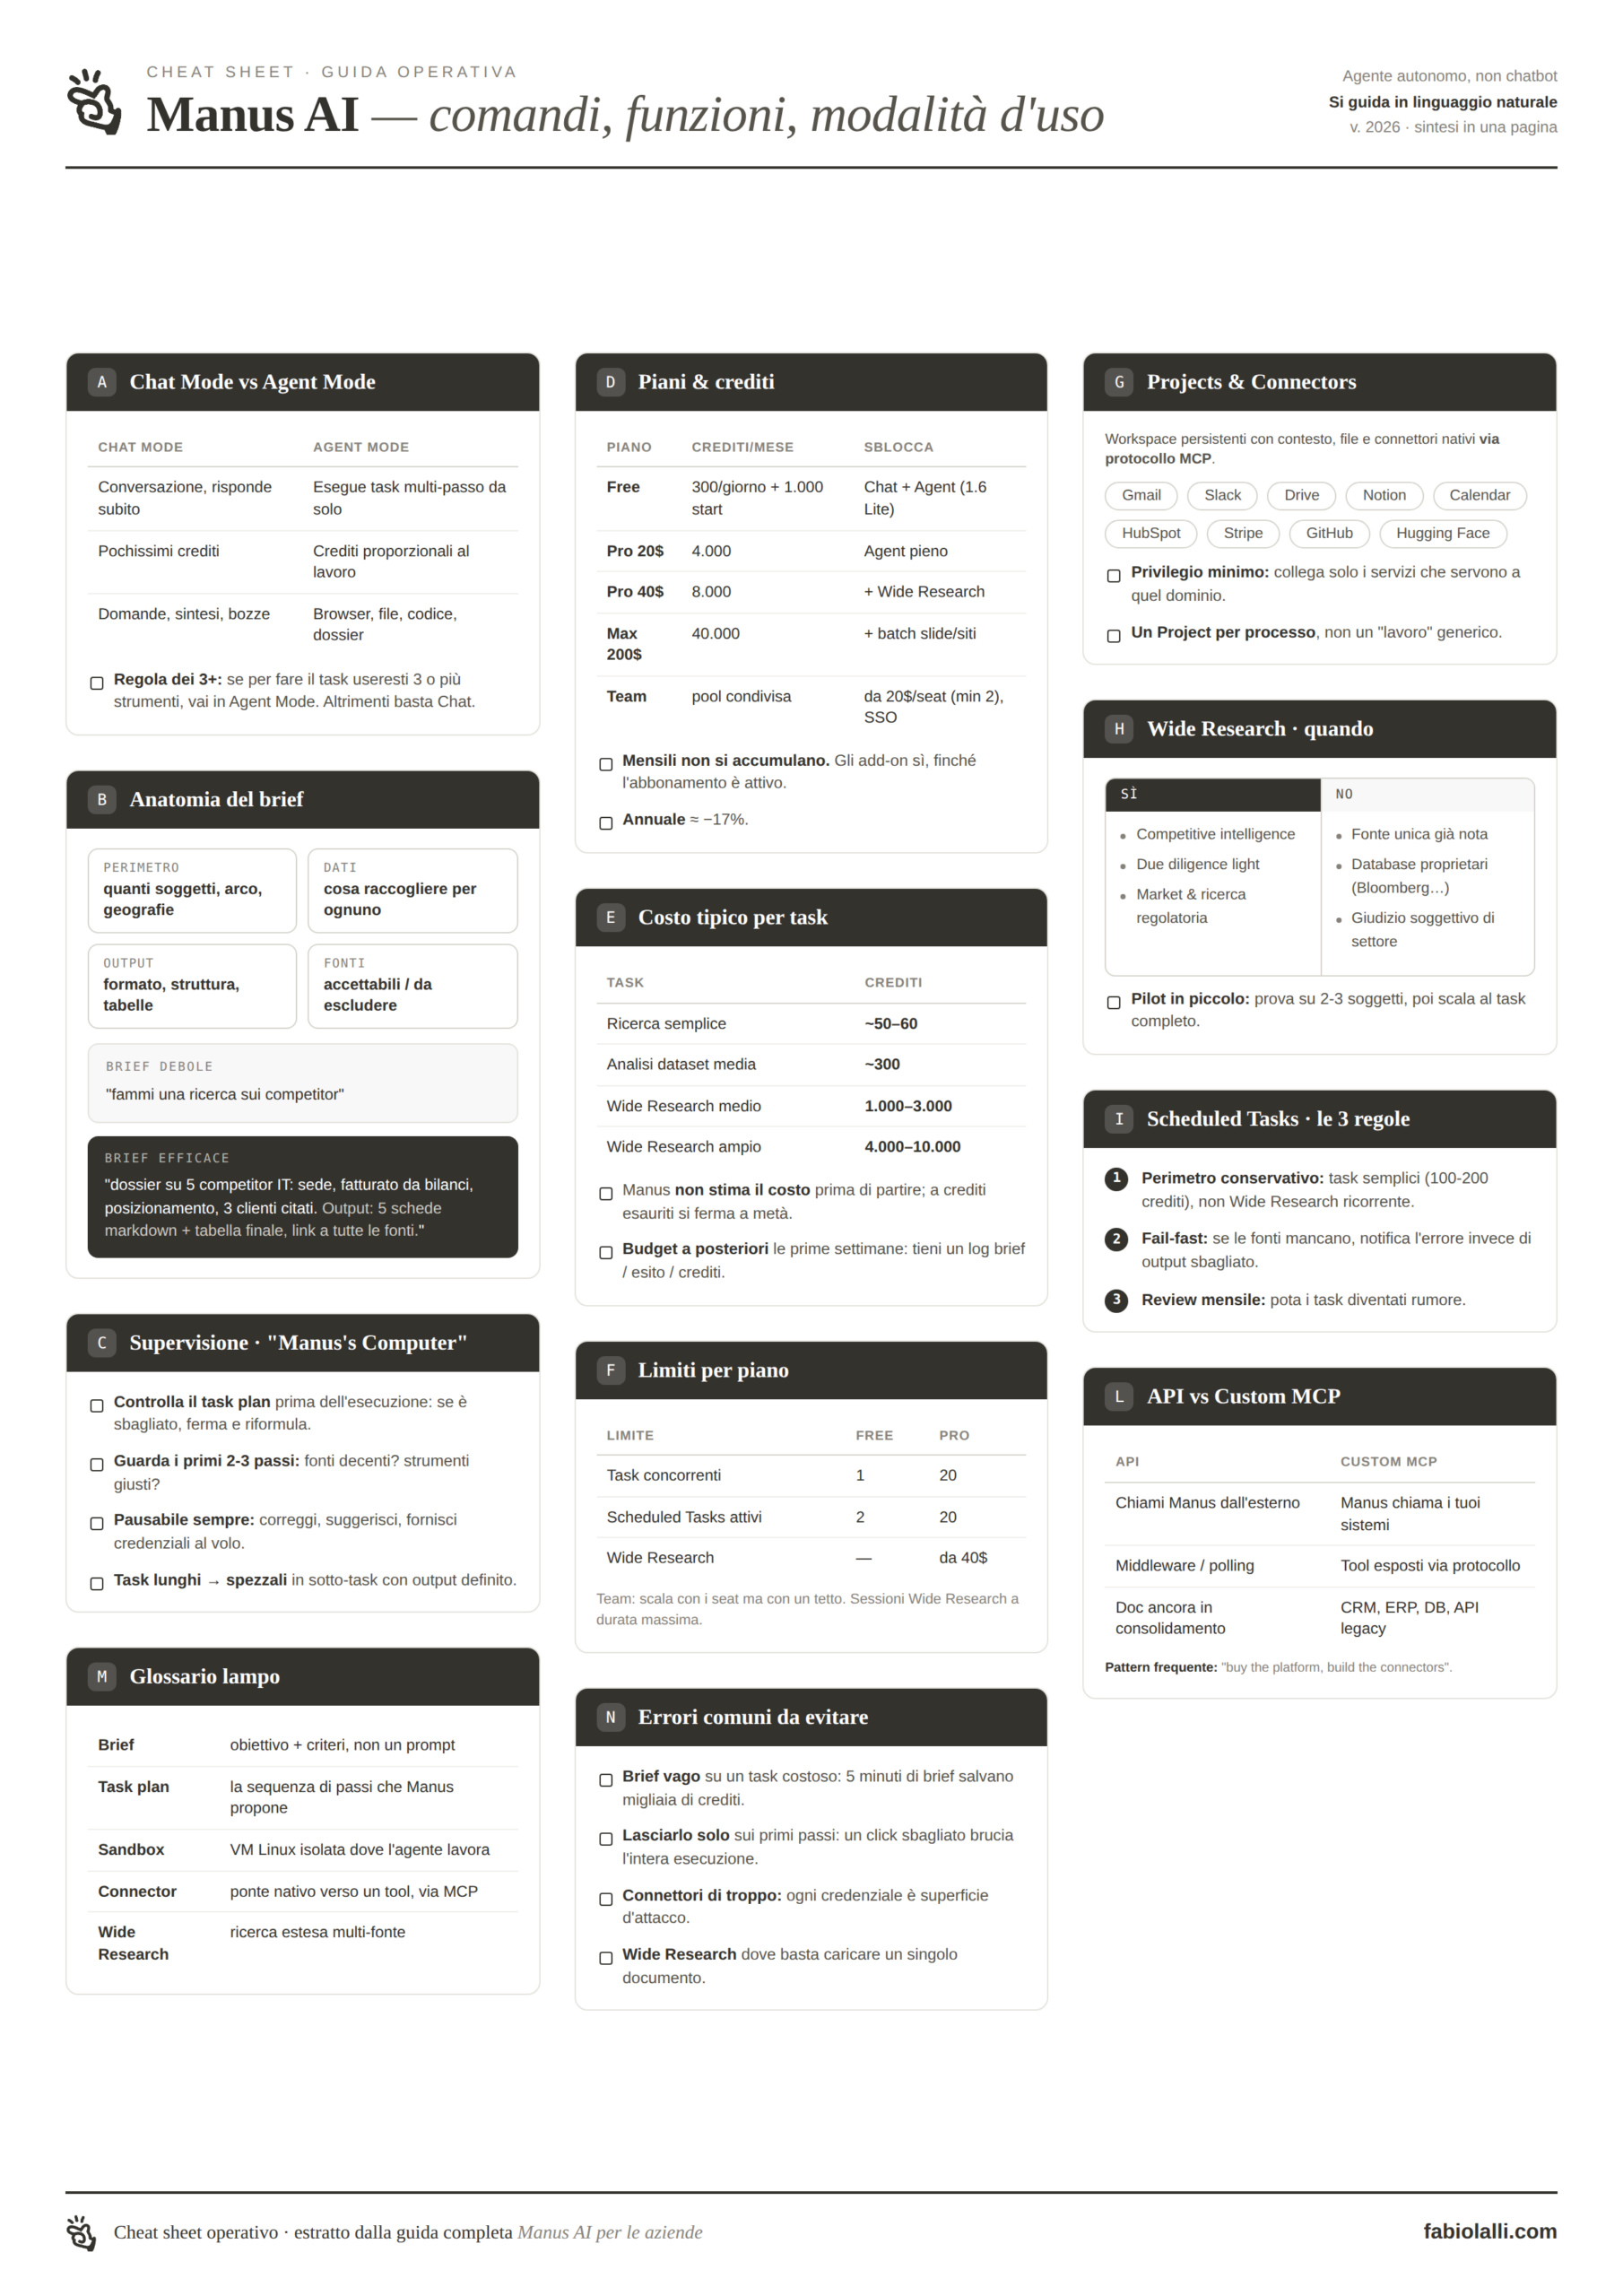
Il prodotto si articola su due modalità. Chat Mode funziona come un assistente conversazionale tradizionale, costa pochissimi crediti, serve a domande veloci, sintesi rapide, ricerca puntuale. Agent Mode è la modalità autonoma vera, dove Manus prende il brief, costruisce il task plan, e parte. La differenza in termini di costi è netta, e va capita prima di iniziare a usare il prodotto in modo regolare, perché Chat Mode resta per molti utenti il novanta per cento dell’uso quotidiano.

L’elemento più distintivo dell’interfaccia è “Manus’s Computer”, un pannello laterale che mostra in tempo reale tutto ciò che l’agente sta facendo: quali pagine apre, cosa cerca, quali file scrive, quali comandi lancia nel terminale. Per chi viene da anni di chatbot dove tutto è invisibile, è un’esperienza diversa, si vede l’agente lavorare, si intercettano gli errori prima che compromettano l’intero task, si interviene spostandolo da una direzione sbagliata. Una review su Cybernews lo descrive come guardare un ricercatore al lavoro con una checklist davanti, ed è fedele.

Il punto delicato è che questa trasparenza si paga con una maggiore responsabilità di supervisione. Manus può sbagliare click sul browser, fraintendere un’istruzione, costruire un piano errato, e senza un occhio sul “Computer” l’agente consuma crediti per minuti producendo un output che alla fine non serve. La logica corretta è dargli un brief chiaro, lasciarlo lavorare, ma tenere sotto controllo i primi passi del piano. Se il piano iniziale regge, di solito l’esecuzione regge. Se è sbagliato, meglio fermarsi e riformulare. La regola pratica, ad ogni nuovo task, è chiedersi quanti strumenti diversi userei se facessi io questo lavoro: se la risposta è uno, basta Chat Mode, se sono tre o più, vale la pena passare ad Agent Mode.

Come si scrive un brief per un agente autonomo

Un brief per Manus non è un prompt per ChatGPT, ed è la singola cosa che fa la differenza tra task riusciti e task abbandonati a metà esecuzione. Un prompt conversazionale è una richiesta puntuale a cui il modello risponde subito. Un brief per Manus è la descrizione di un risultato finale e dei criteri per riconoscerlo come riuscito.

Un esempio, partendo da una richiesta sbagliata: “fammi una ricerca sui competitor”. Manus parte, ma il piano è generico, l’output incerto, i crediti consumati senza un punto di arrivo chiaro. Lo stesso task in versione corretta: “produci un dossier su cinque competitor italiani nel settore X, per ognuno raccogli sede legale, fatturato ultimi due esercizi disponibili da bilanci pubblici, posizionamento dichiarato sul sito, principali clienti citati in case study, presenza su LinkedIn dei C-level. Output: un file markdown con cinque schede da una pagina ciascuna, link a tutte le fonti, e una tabella riassuntiva finale”. Stessa richiesta sostanziale, risultato completamente diverso.

La differenza è che il secondo brief specifica quattro cose che il primo lasciava implicite: il perimetro del task, i dati da raccogliere, la struttura dell’output, le fonti accettabili. Manus eccelle quando questi quattro vincoli sono chiari, perché può costruire un piano di esecuzione lineare. Quando uno solo dei quattro manca, l’agente deve indovinare, e gli indovinelli costano crediti. La documentazione ufficiale suggerisce di pensare a sé stessi come a un manager che assegna un compito a un collaboratore esterno, ed è un’analogia che vale la pena adottare mentalmente prima ancora di iniziare a digitare. C’è anche una funzione che conviene conoscere dalla prima sessione: l’agente può essere fermato in qualsiasi momento, e si interviene chiedendo correzioni puntuali, suggerendo alternative, fornendo credenziali quando il sito richiede login. Questa pausabilità è uno dei tratti che distinguono Manus dagli agenti puramente background.

Piani, crediti, costi: il modello economico

Manus usa un sistema a crediti, e questo cambia profondamente l’esperienza rispetto agli abbonamenti illimitati di ChatGPT Plus o Claude Pro. Il piano gratuito offre trecento crediti che si rigenerano ogni ventiquattr’ore, più mille crediti starter una tantum, con accesso al Chat Mode e a Manus 1.6 Lite in Agent Mode. Basta per testare il prodotto e capire se ha senso salire di piano.

I piani Pro partono da venti dollari al mese per quattromila crediti, salgono a quaranta dollari per ottomila crediti con accesso al Wide Research, e arrivano a duecento dollari per il piano top che porta i crediti mensili a quarantamila e abilita la generazione batch di slide e siti. Il piano Team parte da venti dollari per seat con un minimo di due membri, e introduce funzionalità di workspace condiviso. La fatturazione annuale taglia circa il 17 per cento. Per i numeri aggiornati c’è la pagina ufficiale dei piani, ma il dato che conta per ragionare sui costi è un altro: i crediti mensili non si accumulano da un mese all’altro, mentre quelli acquistati come add-on restano disponibili finché l’abbonamento è attivo. Una review su Spectrum AI Lab lo conferma analizzando le regole di rollover.

Il dato concreto che serve per dimensionare il budget: un task di ricerca semplice consuma intorno ai cinquanta-sessanta crediti, un’analisi dataset di media complessità ne brucia trecento, un dossier di Wide Research approfondito arriva a quattro o diecimila crediti in una singola esecuzione. Manus non stima il costo di un task prima di lanciarlo, e in caso di crediti insufficienti si ferma a metà esecuzione senza addebiti automatici di overage. Per le aziende il budgeting va dunque fatto a posteriori nelle prime settimane, finché il team non sviluppa un’intuizione sui costi tipici dei propri task ricorrenti. Un consiglio che do sempre: tenere un piccolo log dei task lanciati, con brief, esito, crediti consumati, perché dopo dieci o quindici task emergono i pattern, alcuni tipi di richiesta rendono bene e altri sono sistematicamente difficili, e quel log diventa la base per capire dove Manus sostituisce ore di lavoro e dove invece produce solo overhead di supervisione.

I limiti veri delle prime sessioni

Manus non è perfetto, e conviene saperlo in partenza per evitare delusioni mal indirizzate. I problemi più comuni nelle prime sessioni sono tre. L’agente a volte fraintende il brief e parte in una direzione sbagliata, fa click errati sul browser scegliendo elementi che sembravano giusti, e in task lunghi perde il filo del piano iniziale divergendo verso obiettivi secondari.

Il primo problema si risolve scrivendo brief più precisi. Il secondo è una limitazione tecnica, mitigata dal browser visivo che permette di vedere gli errori e correggerli, ma resta una causa frequente di crediti consumati senza output utile. Il terzo è il più insidioso, e si gestisce dividendo i task lunghi in sotto-task più piccoli, ognuno con un output ben definito, invece di chiedere all’agente di completare in una singola esecuzione una pipeline articolata. Una review approfondita su Lindy nota che Manus funziona bene su task con percorso lineare e meno bene su quelli con logica condizionale ramificata, ed è un’osservazione utile per calibrare le aspettative fin dall’inizio.

I task su cui rodarsi senza rischiare frustrazione, nelle prime settimane, sono tre. La ricerca strutturata multi-fonte, dove Manus apre decine di pagine e le legge integralmente, producendo risultati migliori di un assistente conversazionale. L’estrazione dati da fonti web, dove l’agente apre la pagina, esegue lo scraping, scrive uno script di parsing se serve, salva il CSV, e risolve in cinque o dieci minuti quello che a mano ne richiederebbe quaranta. La generazione di documenti formattati a partire da input strutturati, dove dato un file Excel con i risultati di una survey l’agente produce un report con grafici, executive summary, sezioni per ogni domanda. Questi tre pattern coprono buona parte del valore quotidiano di Manus per un manager, e funzionano come esercizi di apprendimento.

Projects e Connectors: l’agente che entra nello stack di lavoro

Fino a metà 2025 Manus aveva un problema strutturale: ogni sessione partiva da zero. L’agente non sapeva nulla del lavoro precedente, delle abitudini del team, delle conversazioni in corso, e andava istruito ogni volta. A dicembre 2025 è arrivata la prima risposta strutturale sotto forma di Projects con Connectors, ed è il momento in cui Manus smette di essere un tool per task estemporanei e inizia a operare dentro il proprio contesto.

Un Project è un workspace persistente che conserva istruzioni di base, file di riferimento, cronologia delle conversazioni correlate. Invece di spiegare ogni volta a Manus chi siete, cosa fa la vostra azienda, qual è il tono di voce, quali sono i clienti chiave, queste informazioni vivono dentro il Project e l’agente le richiama all’inizio di ogni nuovo task. La pagina ufficiale del lancio descrive l’idea di trasformare task ripetibili in spazi persistenti. L’impatto si manifesta in tre direzioni: la qualità degli output, perché con il contesto già caricato Manus produce risultati più allineati al brand e al settore, il risparmio di crediti, perché spariscono i passi che l’agente farebbe per capire il contesto, e la possibilità di delegare task ricorrenti a chi nel team ha meno familiarità con lo strumento, perché il Project incapsula la complessità.

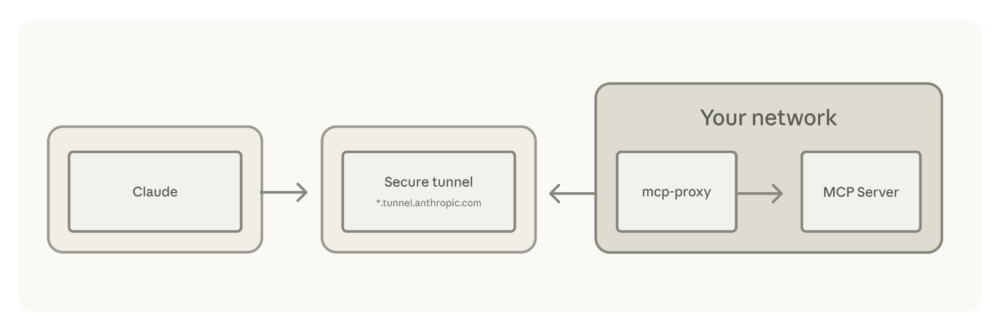
Qui si gioca la partita vera dei Connectors. Un Project può collegarsi nativamente, via protocollo MCP, ai servizi che già si usano: Gmail, Notion, Stripe, HubSpot, Slack, Google Calendar, Hugging Face, Google Drive, GitHub, e l’elenco continua a crescere. MCP è lo standard aperto che Anthropic ha proposto nel 2024 e che si sta affermando come lingua franca per l’integrazione tra agenti e tool esterni, un tema legato a doppio filo a come si evita il vendor lock-in nei progetti AI enterprise. Un esempio concreto: con il connettore Gmail attivo si può chiedere a Manus di leggere le email ricevute negli ultimi cinque giorni dai clienti enterprise, identificare quelle con una richiesta esplicita di follow-up, produrre una sintesi per priorità. Manus legge davvero la posta, applica i filtri, restituisce la sintesi. Con Slack attivo si può chiedere di guardare il canale vendite delle ultime due settimane e riassumere le obiezioni ricorrenti dalle call. A maggio 2026 Manus ha aggiunto i Connector Recommendations, che identificano quando un task richiede un servizio non ancora collegato e suggeriscono di attivarlo dall’interfaccia, riducendo l’attrito di scoprire a metà task che mancava una credenziale.

La tentazione iniziale è creare un Project generico chiamato “lavoro” e usarlo per tutto. Funziona male, e dopo qualche settimana produce confusione. La logica corretta è creare Project ristretti per dominio o per processo, uno per la competitive intelligence, uno per la produzione di contenuti, uno per l’analisi del customer feedback, ognuno con istruzioni mirate e connettori selezionati. Sui connettori conviene restare minimali, perché ogni connettore amplia la superficie di accesso ai dati: un Project di ricerca pubblica non ha bisogno di Gmail collegato, uno di produzione contenuti non ha bisogno di Stripe. La regola del privilegio minimo si applica anche qui, e protegge da scenari dove l’agente, in un momento di confusione, accede a dati che non doveva toccare.

Wide Research, la funzione dove Manus stacca gli altri

Ci sono task per cui un chatbot non basta, e per cui anche una “deep research” come quella di ChatGPT o Perplexity resta in superficie. Sono i dossier che richiedono di aprire decine di pagine, leggerle integralmente, estrarre dati strutturati, confrontarli, citarli con riferimenti puntuali. Wide Research è la funzione di Manus AI pensata esattamente per questo, disponibile sui piani Pro da quaranta dollari mensili in su, ed è uno dei punti dove il prodotto mostra il suo vantaggio competitivo più chiaro.

L’agente entra in una sessione estesa, lavora per quaranta-ottanta minuti, apre decine o centinaia di pagine, mantiene uno stato persistente, salva risultati intermedi, consegna un dossier corposo. La differenza con le ricerche standard riguarda la durata, certo, ma soprattutto la profondità di lettura: invece di fermarsi agli snippet dei primi risultati, l’agente apre davvero le pagine e le legge per intero. Sul confronto con la “deep research” di altri vale la pena guardare i numeri con cautela. Un’analisi su The Planet Tools che ha testato Manus su GAIA, il benchmark di riferimento per agenti AI, riporta uno score dell’86,5 per cento sul livello uno, 70,1 sul livello due, 57,7 sul livello tre, contro il 74,3, 69,1 e 47,6 di OpenAI Deep Research. I benchmark di prodotto vanno presi con le pinze, ma indicano una direzione: su task di ricerca multi-step strutturati Manus si comporta in modo competitivo, e in alcuni scenari supera la concorrenza più affermata.

Le regole sul brief valgono qui con un’intensità maggiore, perché un brief vago per un task da cinquanta crediti produce uno spreco accettabile, mentre per un task da cinquemila crediti produce uno spreco doloroso. I quattro elementi che fanno la differenza sono il perimetro, la struttura dell’output, le fonti accettabili, i criteri di successo. Wide Research rende particolarmente bene su tre terreni. La competitive intelligence strutturata, dove l’agente apre siti aziendali, comunicati, press release, e produce dossier che a un analista umano richiederebbero due o tre giornate. La due diligence light, che non sostituisce quella formale ma serve a valutare preliminarmente una controparte, raccogliendo informazioni pubbliche, segnalando red flag, ricostruendo la storia del management, con la capacità di citare puntualmente le fonti costruendo un audit trail della ricerca. Il market scan e la ricerca regolatoria, dove serve coprire molte fonti istituzionali, paper, comunicati di authority, banche centrali, organismi europei.

Sui costi conviene dare cifre concrete, perché il modello a crediti rende facile sottostimare l’investimento finché non ci si trova il budget mensile bruciato a metà mese. Un dossier di complessità media consuma tra i mille e i tremila crediti, uno ad alta complessità arriva a quattromila o diecimila in un’unica esecuzione. Sul piano Pro da quaranta dollari con ottomila crediti mensili, un task ben dimensionato occupa il dieci per cento del budget, mentre uno fuori scala può cannibalizzare un mese intero. Il calcolo che vale la pena fare è quanto tempo umano risparmia il dossier: se un’analisi da otto ore viene prodotta in trenta minuti con duemila crediti, il ROI è evidente, se invece il dossier è di qualità scarsa e va integrato a mano per quattro ore, il calcolo si ribalta. Per i dossier davvero importanti, quelli destinati a riunioni con stakeholder esterni o a decisioni di investimento, conviene un pilot in piccolo: stessa struttura ma su due o tre soggetti invece di dieci, si valuta la qualità, si calibra il brief, poi si lancia il task completo.

Wide Research è la scelta sbagliata quando la fonte primaria è una sola e già nota, e allora conviene caricare il documento in Chat Mode o in un Project e ragionarci sopra. Lo è quando la ricerca richiede accesso a database proprietari come Bloomberg, Crunchbase Pro, Pitchbook, perché Manus non ha accesso nativo e produrrà un dossier basato su fonti pubbliche più povere. E non funziona quando la domanda è soggettiva e richiede un giudizio interpretativo che presuppone esperienza di settore, perché valutare se un’azienda è un buon target di acquisizione è una sintesi di mercato, finanza, competitive e fit culturale che richiede chi conosce il contesto strategico interno. Wide Research prepara il terreno, non prende la decisione.

Scheduled Tasks e Cloud Computer: l’agente che lavora anche di notte

C’è un momento, in chi inizia a usare Manus seriamente, in cui ci si accorge che il vero collo di bottiglia si sposta: dalla capacità dell’agente al tempo dell’utente che deve lanciare i task. Le riunioni occupano la mattina, le revisioni il pomeriggio, e i task ricorrenti che si volevano lanciare ogni settimana si fanno una volta sì e due no, finché si smette. Qui Manus ha investito di più nell’ultimo anno, e a fine aprile 2026 ha consegnato il salto più rilevante del suo percorso prodotto.

Scheduled Tasks permette di programmare l’esecuzione di un task a cadenza fissa, ogni mattina, ogni lunedì, il primo del mese, ogni tre ore. L’agente lancia il task in autonomia, esegue, salva i risultati, eventualmente invia notifiche. Per chi è abituato a Zapier o n8n l’idea è familiare, per chi viene solo da chatbot è un cambio di prospettiva. Una review su Work Management lo descrive come la funzione che fa sembrare Manus più un operations tool che una novità AI, ed è fedele, perché il valore non sta nel singolo task pianificato ma nell’accumularsi di task ricorrenti che insieme costruiscono una piccola infrastruttura di business intelligence che gira da sola. I limiti vanno conosciuti: sul piano gratuito due Scheduled Tasks attivi, sui piani Pro il limite sale a venti task concorrenti e pianificati.

Il salto qualitativo è il Manus Cloud Computer, lanciato il 30 aprile 2026, descritto dalla stampa specializzata come il primo prodotto mainstream che dà a un agente un “permanent home”. Fino ad allora ogni sessione viveva in una sandbox effimera che si chiudeva al termine del task, mentre con Cloud Computer l’agente ha una macchina virtuale dedicata, sempre accesa, che mantiene stato, file, database, processi attivi anche tra un task e l’altro. Una rassegna su AI Automation Global descrive l’impatto come il passaggio dal 2025, anno del chat agent, al 2026, anno dell’agent runtime, un posto dove gli agenti vivono, reagiscono a eventi, accumulano effetti collaterali. Cloud Computer è disponibile in tre tier, accessibile da desktop e mobile, ed è proposto come no-code: si descrive l’obiettivo in linguaggio naturale e Manus provisiona e mantiene la macchina sottostante. Per le funzioni IT abituate a parlare di VM, container, processi supervisor, l’astrazione conta, perché non si gestisce più infrastruttura, si gestisce intento.

Gli scenari dove Scheduled Tasks ripaga rapidamente sono concreti. Il monitoring competitivo giornaliero, un task che ogni mattina controlla i siti dei competitor selezionati e invia un digest entro le otto, così il manager arriva in ufficio già allineato. Il digest settimanale di customer feedback, che ogni lunedì apre i ticket della settimana precedente, identifica i topic ricorrenti, segnala i feedback critici. La rassegna stampa di nicchia, che per chi lavora in public affairs o comunicazione scandaglia testate specializzate e account di settore producendo una rassegna ragionata, un sostituto credibile per certi scenari di servizi più costosi. Un caso descritto su NoCode MBA mostra come un setup simile per tracciare advertiser su newsletter di settore abbia intercettato lead prima della concorrenza.

I task pianificati hanno insidie diverse da quelli in tempo reale. Un task lanciato a mano lo supervisioni e se va male lo fermi, uno pianificato gira di notte e se sbaglia produce output sbagliati per giorni prima che qualcuno se ne accorga. Tre regole tengono conto di questa asimmetria. Essere conservativi sul perimetro, perché un task ricorrente deve fare poco ma bene, non è il contesto per un Wide Research da quattromila crediti ma per task semplici da cento o duecento. Configurare il fail-fast, in modo che se le fonti non sono accessibili l’agente notifichi l’errore invece di produrre output silenziosamente sbagliato. Fare una review periodica, una volta al mese, per vedere quali task generano valore e quali sono diventati rumore di fondo, perché la tendenza naturale è accumulare task senza mai potarli e dopo sei mesi ci si ritrova con quindici Scheduled Tasks di cui tre servono davvero.

Il valore vero emerge quando queste funzioni si combinano. Un Project con istruzioni mirate, connettori attivi sui propri tool, Scheduled Tasks che girano in autonomia, Cloud Computer che mantiene stato persistente, insieme diventano un’infrastruttura leggera di automazione che assomiglia a quello che le aziende grandi costruiscono con team IT dedicati. Un Project di sales intelligence con HubSpot attivo, dove ogni mattina un task apre i deal stagnanti da più di trenta giorni, controlla l’attività recente dei contatti su LinkedIn, identifica trigger di vita come un cambio ruolo o un post recente, suggerisce a quale account dare follow-up prioritario, con il Cloud Computer che mantiene memoria di lungo termine sui contatti per non ripetere segnalazioni già fatte. Due anni fa questo livello richiedeva un team di RevOps con Salesforce, Outreach, Clay, Apollo e un consulente di setup, oggi richiede un piano Manus Pro e una settimana di configurazione. C’è un caveat che ricordo sempre: tutta questa infrastruttura passa da una piattaforma esterna che ha accesso a dati aziendali sensibili, e il livello di automazione raggiunto è proporzionale alla quantità di credenziali condivise, un tema che chi ha vincoli di sovranità del dato risolve spostando lo strato AI dentro il perimetro, come racconto a proposito di infrastrutture di AI privata.

Collab, Desktop App e Design View: quando diventa risorsa di squadra

Per buona parte del 2025 Manus era un prodotto individuale. Un singolo utente apriva un task, lo seguiva, ne raccoglieva l’output, e per i team che volevano usarlo insieme l’unica strada era condividere screenshot e riprodurre a mano la stessa esecuzione. Da fine 2025 il prodotto ha coperto questo limite con un set di funzioni dedicate al lavoro di squadra.

Manus Collab apre i workspace alla collaborazione multi-utente con un solo link. Si genera, si condivide, e chi lo riceve entra nel workspace, vede lo stato dei task, partecipa alle conversazioni con l’agente, contribuisce al brief, accede agli output. Per chi viene da Notion, Linear, Figma, il pattern è familiare. L’effetto si misura sul sistemico più che sulla singola funzione: quando due persone lavorano insieme su un task le iterazioni si moltiplicano, una scrive il brief, l’altra lo affina, una valuta l’output intermedio, l’altra chiede correzioni, e la qualità finale supera quella che si otterrebbe in solitaria. Una review su Lindy nota che il lavoro di squadra è uno dei terreni dove i prodotti agentici stanno colmando il distacco rispetto agli strumenti collaborativi tradizionali. Un Manus solitario è uno strumento, un Manus condiviso può diventare un processo aziendale.

La Desktop App per Mac e Windows, descritta nella documentazione come “My Computer”, porta tre vantaggi pratici. L’accesso ai file locali senza upload manuale, così si lavora su documenti e fogli che vivono sulla propria macchina senza prima caricarli nel cloud. La persistenza visiva, perché l’app resta aperta in background e le notifiche sui task completati arrivano nel sistema operativo invece di disperdersi tra mille schede. E il senso di professionalità dello strumento, meno banale di quanto sembri, perché un’applicazione dedicata cambia il modo in cui un team percepisce un tool e abbassa la resistenza all’adozione strutturata. Resta una limitazione che conviene conoscere: anche con l’app desktop, l’esecuzione dell’agente avviene nella sandbox cloud, non sulla macchina locale, ed è un vincolo di sicurezza che vale per tutti gli agenti autonomi sul mercato.

Design View è il modulo dedicato alla generazione e all’editing di immagini, lanciato con una novità tecnica: integra Nano Banana Pro, il modello di generazione visuale di Google noto per la qualità delle iterazioni successive a partire dalla stessa immagine sorgente. Si carica o si genera un’immagine, e si chiedono modifiche in linguaggio naturale, cambia lo sfondo, togli la persona sulla destra, trasforma il giorno in notte, ogni modifica produce una nuova versione e il workspace mantiene la storia delle iterazioni. Per il marketing serve a produrre varianti per A/B test, social, landing page senza passare ogni volta dal design team per modifiche minori, per il design diventa uno sketchbook collaborativo, per la comunicazione interna permette di personalizzare template senza competenze grafiche. La qualità di Nano Banana Pro è alta sulle modifiche iterative dello stesso soggetto, meno costante quando si chiede una composizione completamente nuova, quindi conviene trattarlo come strumento di editing più che di creazione, affidando le brand asset di valore alto a designer professionisti.

C’è un tratto che accomuna gli scenari di squadra, e vale la pena fissarlo. Il valore di Manus per i team non sta nella sostituzione del lavoro umano, sta nella riduzione del tempo morto tra una decisione e la sua materializzazione. Cambia il throughput del processo creativo o produttivo, non la qualità finale dell’output, che resta dipendente dalla professionalità di chi lavora. Per aziende dove il time-to-market dei contenuti o delle materializzazioni visuali è un fattore competitivo, è una differenza che si misura in giornate di lavoro recuperate ogni settimana.
API e Custom MCP Server: integrare l’agente nei sistemi aziendali

C’è una fascia di lettori per cui usare Manus come prodotto finito non basta. Sono i CTO, gli IT manager, i lead developer che devono valutare se e come integrarlo dentro flussi esistenti, sopra database proprietari, dentro pipeline che girano su altri stack. Per questi profili la domanda non è come si usa Manus, è come si costruisce qualcosa con Manus. Due strade complementari, l’API per integrazioni server-to-server e i Custom MCP Server per esporre i sistemi interni all’agente.

L’API Manus permette a un sistema esterno di lanciare task sull’agente, ricevere risultati, gestire l’esecuzione in modo programmatico. La logica è quella di qualunque API moderna, chiave di accesso, endpoint, JSON in input e output, gestione asincrona dei task lunghi. Un caveat onesto: la documentazione tecnica sull’API è ancora in consolidamento e non ha la completezza di provider più maturi come OpenAI o Anthropic. Una guida su Skywork che ha analizzato pattern di integrazione con Stripe, Slack, Notion e Google Sheets nota che Manus si concentra sulla generazione rapida di app complete ma non documenta pubblicamente un developer SDK, un marketplace di plugin o un framework webhook strutturato. In pratica le integrazioni oggi si fanno in due modi, tramite middleware costruito ad hoc che riceve eventi dai propri sistemi e li traduce in chiamate Manus, oppure tramite polling per i servizi senza webhook affidabili. Entrambi richiedono uno sviluppatore esperto, e nessuno dei due è plug-and-play come l’esperienza dei Connectors nativi.

I Custom MCP Server fanno l’opposto: permettono a Manus di chiamare i sistemi aziendali interni come se fossero strumenti standard. Per le aziende strutturate è la direzione più potente, perché evita il problema della completezza dell’API e sfrutta lo standard aperto MCP. Si costruisce un server, ospitabile in cloud privato, on-premise o hybrid, che espone una serie di tool al protocollo, ognuno con un nome, una descrizione, parametri tipizzati, e un’implementazione che parla con i sistemi interni, per esempio “trova cliente per codice fiscale”, “estrai ultime fatture”, “aggiorna stato pratica”, “verifica disponibilità magazzino”. Si configura Manus per usare il server, e da quel momento l’agente opera sui sistemi proprietari dentro qualunque task autonomo. La documentazione integrazioni di Manus indica proprio questa possibilità di esporre CRM interni, database, API legacy in modo nativo. Per chi conosce il pattern del tool function calling negli LLM tradizionali, è la stessa cosa elevata a protocollo aperto e portabile, dove il server scritto per Manus può in linea di principio essere usato da altri agenti compatibili MCP, evitando il lock-in tecnologico.

Tre pattern ricorrono nelle integrazioni serie. Il ticket-enrichment, dove un sistema di ticketing genera un ticket, un trigger chiama Manus che con un Custom MCP Server sul CRM interno analizza il contenuto, identifica il cliente, recupera lo storico, classifica la richiesta, propone una priorità e un primo draft di risposta, e il ticket arricchito torna all’operatore umano con contesto già pronto. Il monitoring-and-routing, dove una pipeline di ingestion raccoglie input eterogenei e un task Manus li classifica, identifica i casi che richiedono attenzione umana, indirizza gli altri verso processi automatici, lo smistamento intelligente che dieci anni fa richiedeva regole if-then complesse. Il report-and-distribute, dove un task pianificato genera report periodici partendo da CRM, ERP, BI, li compone in documenti formattati, li distribuisce via email, Slack, Notion, una sostituzione credibile di parte del lavoro che oggi fanno manualmente i business analyst.

Tre temi tecnici vanno affrontati prima dello sviluppo. Webhook e polling sono i due modelli per la reattività, i webhook efficienti ma con endpoint pubblici e gestione delle retry, il polling più semplice ma con latenza e carico costante, e nella maggior parte dei casi conviene un layer ibrido. La gestione delle credenziali è il punto sensibile, perché con i Custom MCP Server le credenziali ai sistemi interni vivono nel server stesso, che diventa il punto critico di sicurezza, da isolare in rete dedicata, con credentials manager come Vault o i secrets manager cloud, con rotazione regolare e log di ogni accesso. L’idempotenza è il terzo, perché un task Manus può essere ritentato dopo errore o ricevere lo stesso input due volte, e i tool esposti devono produrre lo stesso risultato se chiamati due volte con gli stessi parametri, evitando doppie scritture. Sulla scelta tra costruire e comprare, il criterio è quello classico: si costruisce custom quando ci sono sistemi proprietari unici, requisiti di sicurezza specifici, volumi che ammortizzano lo sviluppo, e si compra il prodotto quando il caso d’uso è coperto dai Connectors nativi e il team non ha competenze per mantenere integrazioni custom. La variante intermedia più frequente è “buy the platform, build the connectors”, Manus come piattaforma chiavi in mano per il novanta per cento dei casi standard e un Custom MCP Server dedicato per i sistemi proprietari critici.

Adozione enterprise: governance, sicurezza, costi, proprietà

Un decisore che ha capito cosa fa il prodotto si trova davanti alle domande che contano quando si passa da “uno sperimenta nel team” a “lo adottiamo come strumento aziendale”. Quanto costa su scala team, quali garanzie di sicurezza offre, dove finiscono i dati, qual è il contesto di proprietà e governance, quando vale la pena e quando no.

Su scala team la logica di Manus AI è la stessa degli utenti individuali, con dinamiche di scala da comprendere. Il piano Team parte da venti dollari al mese per seat con un minimo di due membri, e introduce workspace condiviso, single sign-on, funzionalità di amministrazione, una pool di crediti gestita collettivamente. Per un’azienda con dieci utilizzatori attivi il costo base è duecento dollari al mese, più gli eventuali add-on per i picchi. Il calcolo che conta è quello dei crediti, non quello del seat, perché i casi più costosi, Wide Research, Cloud Computer attivo, task autonomi lunghi, concentrano buona parte del budget se non si stabilisce una disciplina interna. I crediti mensili non si accumulano, quelli da add-on restano finché l’abbonamento è attivo, e questa asimmetria spinge a una calibrazione fine, meglio un piano leggermente sotto il fabbisogno medio integrato con add-on quando serve, che un piano sovradimensionato che spreca crediti ogni mese.

Tre limiti operativi impattano l’organizzazione. Il limite di task concorrenti, uno solo sul gratuito, venti su Pro, scalabile con i seat ma con un tetto sul Team, che emerge quando un team di otto persone tenta di lanciare ognuno un Wide Research nello stesso pomeriggio e alcuni restano in coda. Il limite di Scheduled Tasks attivi, dove la disciplina di tenere pochi task ben fatti è anche un’auto-limitazione virtuosa. Il limite di Wide Research, dove le sessioni hanno durate massime e i crediti possono saturare il budget mensile, tanto che per team con bisogno frequente di dossier il piano top da duecento dollari diventa quello sostenibile.

Su sicurezza, data residency e audit trail Manus ha una maturità intermedia, i meccanismi di base ci sono ma la documentazione enterprise non è ancora al livello dei provider più consolidati. Tutto ciò che passa per la sandbox cloud, file caricati, contenuti delle conversazioni, output prodotti, viene processato dalla piattaforma, e per dati non particolarmente sensibili è coerente con qualunque SaaS moderno. Per dati regolamentati, categorie particolari GDPR, segreto bancario, dati sanitari, classificati pubblici, questa è la prima asimmetria da considerare, perché Manus non è oggi un prodotto certificato per la gestione di dati ad alta sensibilità, e per questi scenari va verificato puntualmente cosa il proprio framework di compliance consente. Sulla data residency, l’infrastruttura sottostante gira su provider cloud americani, e per aziende italiane ed europee in PA centrale o in settori finanziari di rilevanza sistemica, con vincoli espliciti di sovranità del dato, questo è un nodo da valutare caso per caso. Per la maggior parte delle aziende private il framework di trasferimento internazionale copre adeguatamente, ma l’analisi va documentata formalmente. Sull’audit trail il prodotto registra conversazioni ed esecuzioni e offre l’accesso alla cronologia, sufficiente per l’accountability interna, mentre per audit formali le funzionalità avanzate come log immutabili, export strutturato, integrazione SIEM, sono in consolidamento e vanno verificate con il vendor.

C’è poi un punto di proprietà e governance del prodotto che merita di essere riportato con precisione, perché si è mosso parecchio negli ultimi mesi. Manus nasce da Butterfly Effect, società fondata in Cina con radici a Pechino e Wuhan, poi reincorporata a Singapore nel 2025. A dicembre 2025 Meta ha annunciato l’acquisizione di Manus, riportata intorno ai due miliardi di dollari, dichiarando che avrebbe accelerato l’innovazione AI per i propri prodotti consumer ed enterprise. L’operazione ha attratto scrutinio sia negli Stati Uniti sia in Cina, e il 27 aprile 2026 la National Development and Reform Commission cinese ha bloccato l’acquisizione, chiedendo alle parti di annullarla, in una mossa che la stampa internazionale ha collegato alle preoccupazioni di Pechino sul trasferimento di tecnologia avanzata e talento. Meta ha risposto che la transazione era pienamente conforme alle leggi applicabili e che si attende una risoluzione appropriata della questione. Allo stato attuale lo scenario resta aperto e non del tutto chiarito, anche perché parte del personale risultava già integrato nei team Meta. Per le aziende che valutano l’adozione il punto non è prendere posizione su una vicenda geopolitica, è registrare che il prodotto attraversa una fase di evoluzione e incertezza societaria, con i lati positivi degli investimenti continui e i lati di consapevolezza sui possibili cambiamenti di pricing e di policy. Per settori con vincoli stringenti sulla provenienza geografica dei fornitori cloud, PA centrale, difesa, sanità, banking sistemico, questo va verificato con le funzioni di compliance interne, mentre per il resto del mercato privato il tema è meno stringente di quanto a volte appaia.
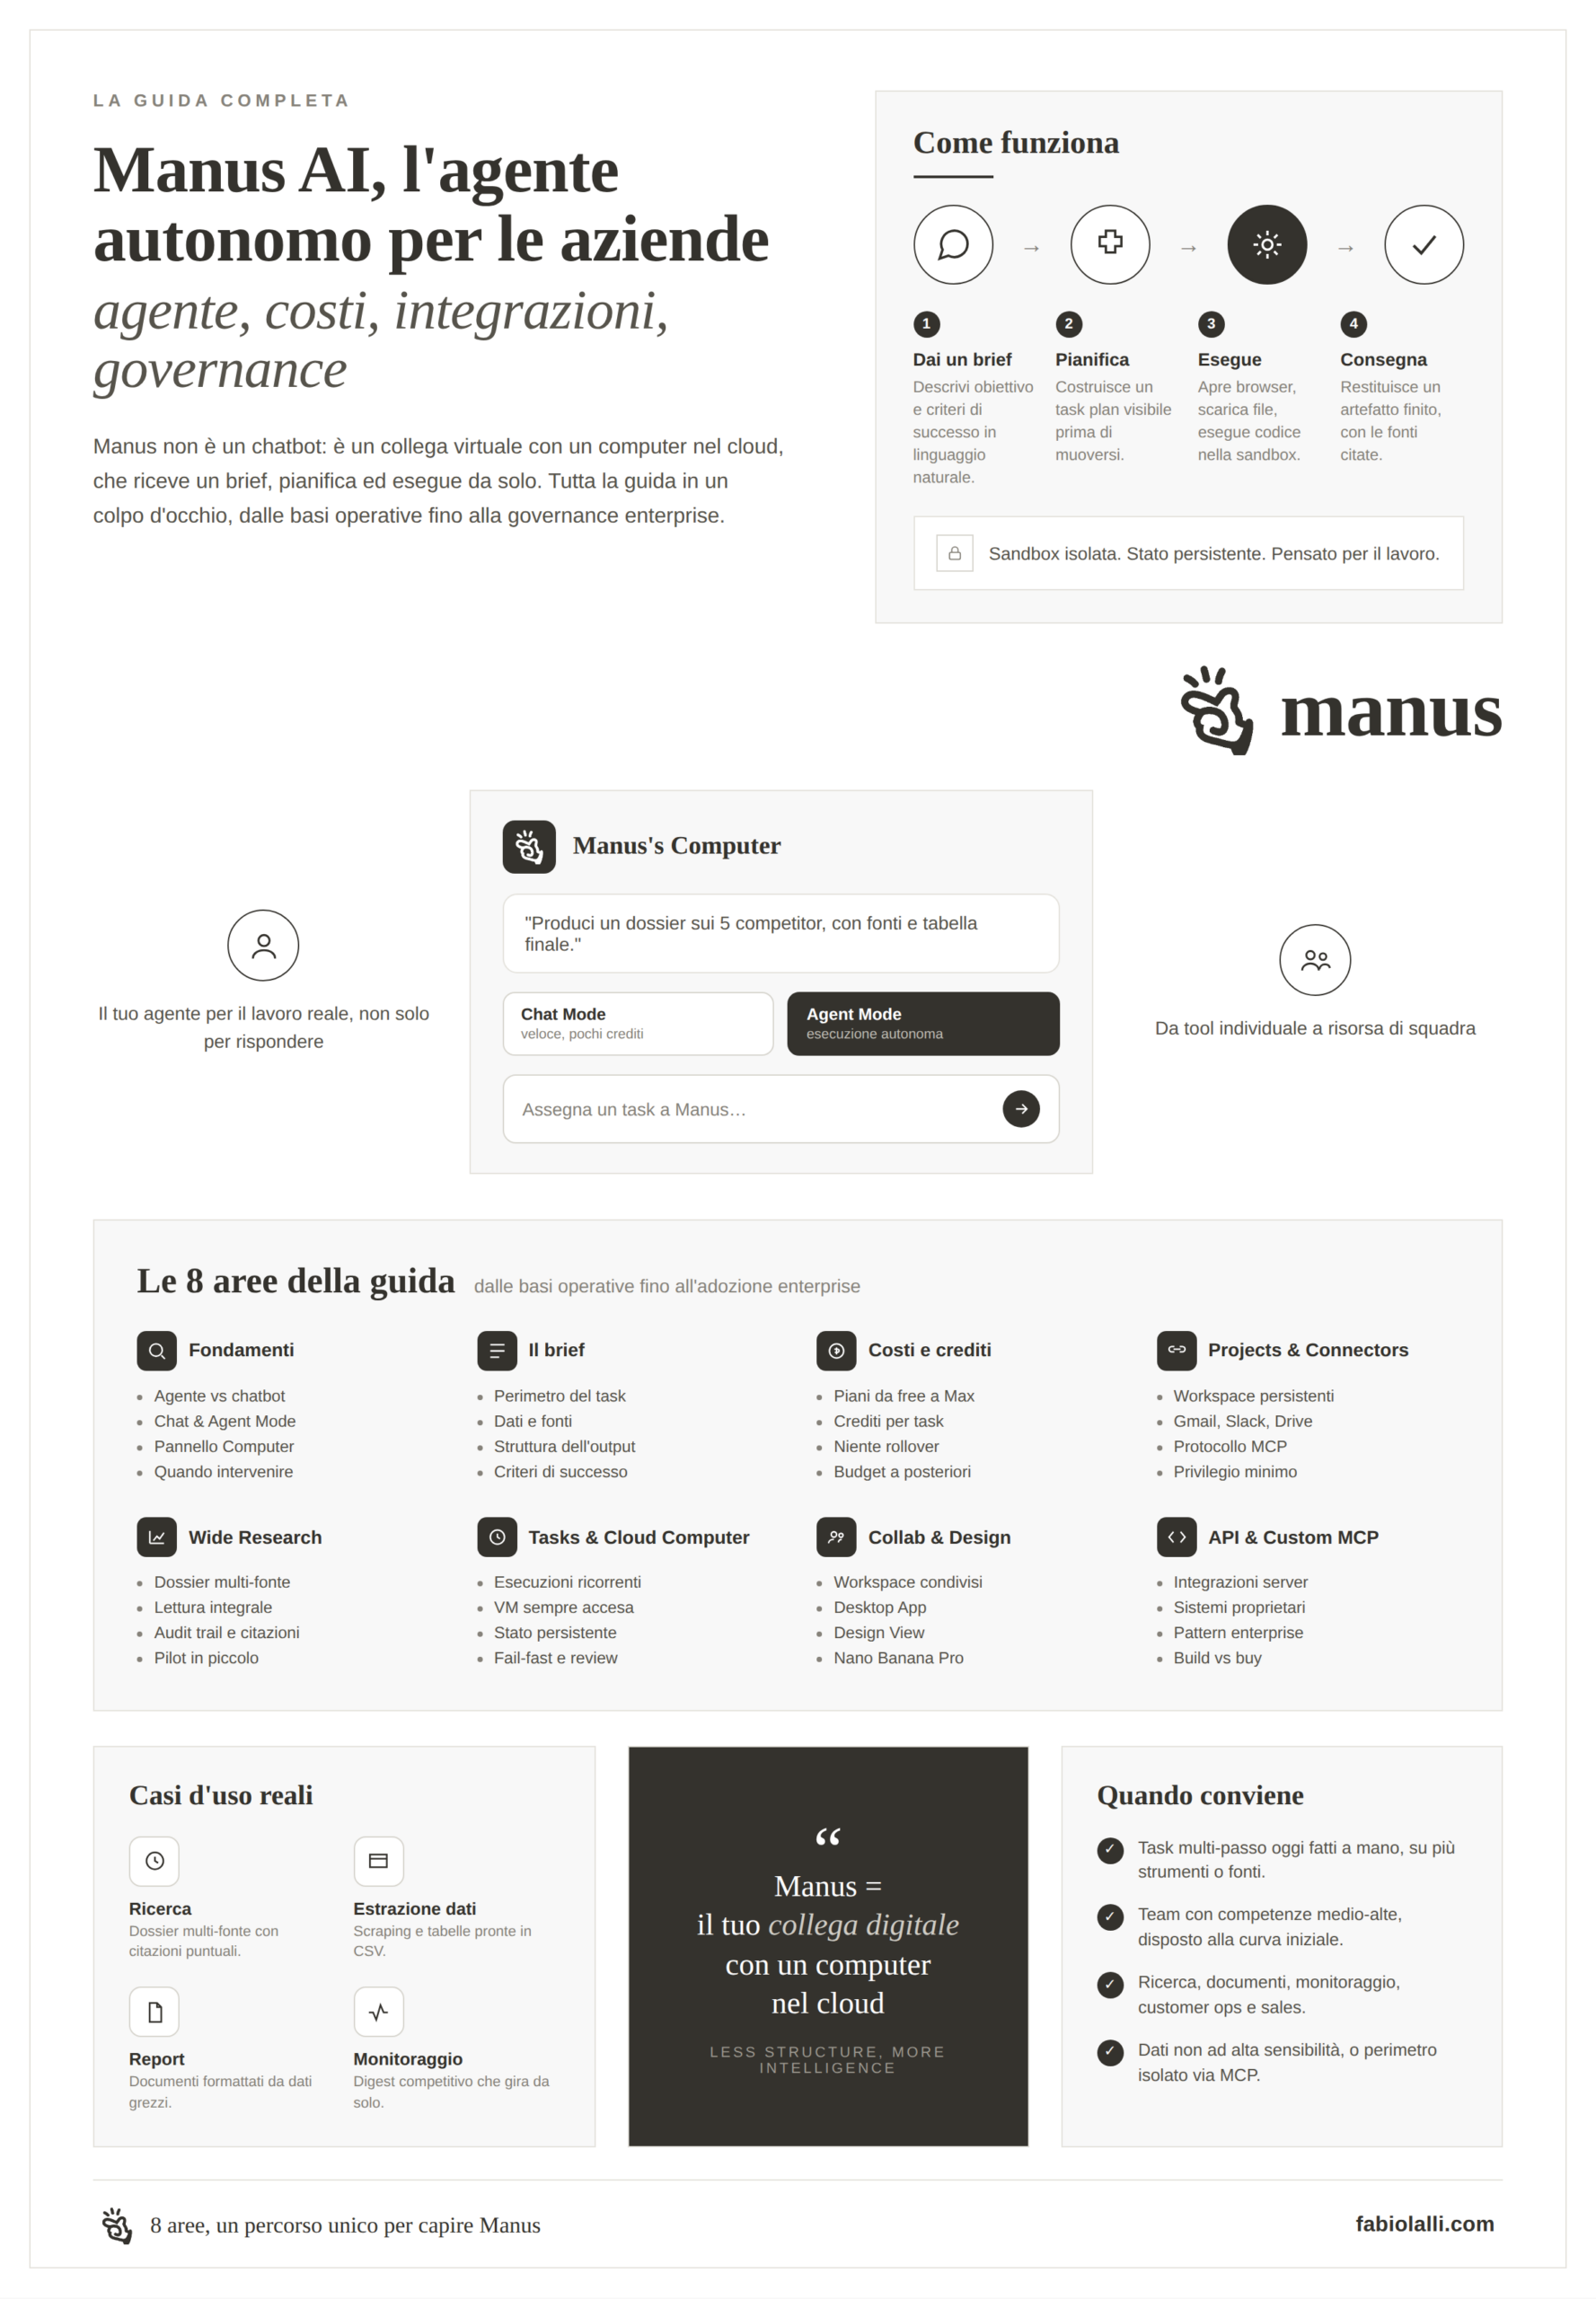
La griglia decisionale: quando Manus AI è la scelta giusta

Resta da mettere insieme tutto in criteri sintetici, da combinare con il contesto specifico di ogni azienda. La domanda preliminare, prima ancora di aprire l’account, riguarda il proprio flusso di lavoro: ha task multi-passo che oggi vengono eseguiti a mano per mancanza di alternative, oppure è già strutturato intorno a strumenti specializzati che coprono ogni segmento?

Una griglia grossolana ma utile parte dal tempo. Se il task richiede meno di cinque minuti di lavoro umano, Manus è un’overkill costosa ed è meglio un assistente conversazionale. Se richiede tra cinque minuti e un’ora, e attraversa più strumenti o più fonti, Manus può essere la scelta giusta. Se richiede più di un’ora di lavoro complesso ma altamente strutturato, vale la pena valutare se non sia più adatto a una pipeline costruita con API e tooling dedicato. Manus è la scelta giusta quando l’azienda ha bisogno regolare di task multi-passo oggi eseguiti a mano, quando il team ha competenze digitali medio-alte e può investire un mese o due nella curva di apprendimento, quando i casi d’uso prevalenti riguardano ricerca approfondita, generazione di documenti formattati, monitoraggio continuo, supporto a customer operations e sales, e quando i dati toccati non sono in fasce di sensibilità elevata oppure si è disposti a costruire un Custom MCP Server che isoli il perimetro.

È invece da rivalutare con attenzione quando l’azienda opera in settori altamente regolati con vincoli di sovranità del dato espliciti, quando il team non ha la disponibilità per investire nella curva di apprendimento e cerca un tool da accendere e usare, quando i casi d’uso sono prevalentemente conversazionali e iterativi, per i quali un assistente tradizionale è più adatto, e quando il budget è strutturalmente sotto i venti dollari mensili per utente, perché il modello a crediti rende il piano gratuito limitante per un uso professionale serio.

In molti casi reali la risposta sta nel mezzo, ed è una valutazione sfumata che conviene chiudere con un pilot strutturato, un trimestre di prova con un team ristretto di tre o cinque power user, obiettivi misurabili sul tempo umano risparmiato e sulla qualità degli output, e una decisione formale a fine trimestre se estendere all’organizzazione o fermarsi. È l’approccio che evita sia il rifiuto pregiudiziale sia l’adesione entusiastica non sostenibile, ed è quello che la maggior parte delle aziende che adottano con successo nuovi tool AI sta usando in questa fase. C’è anche un criterio organizzativo che vedo spesso sottovalutato: le aziende che adottano Manus con successo sono quelle che dedicano una persona o un piccolo team alla curva di apprendimento iniziale, prima di estendere l’uso al resto dell’organizzazione, perché lanciarlo dall’alto come tool generalista, senza un nucleo di power user che sviluppi pattern riconoscibili, tende a produrre frustrazione e abbandono.

Tutto questo ragionamento, dalla scelta del modello fino all’architettura di governance, è esattamente il tipo di valutazione che mi capita di affiancare quando un’azienda mi chiede un assessment sulla propria adozione AI. Se Manus entra in un disegno più ampio di sovranità del dato e infrastruttura interna, vale la pena leggerlo insieme alle scelte di stack che ho raccontato altrove, dal perché Mistral è diventata la scelta enterprise più seria d’Europa per chi vuole l’AI dentro il proprio perimetro, fino a cosa cambia per il GDPR quando un dato esce dall’azienda e si appoggia a una piattaforma esterna come Manus. In Pelle Digitale ho provato a descrivere come l’interfaccia digitale media il nostro rapporto con il lavoro e con noi stessi, e un agente autonomo come Manus è il caso limite di questa mediazione, uno strumento che non risponde più soltanto, agisce. Per una conversazione diretta sul vostro caso specifico c’è la pagina Advisory.

A inizio percorso lasciavo aperta una domanda, e la richiudo qui dopo aver attraversato tutto il prodotto. Aprire un account, dedicare due settimane all’esperimento concreto, scegliere tre task realistici del proprio lavoro e provarli con la disciplina vista in queste pagine, perché la risposta sul valore di Manus per il proprio contesto arriva solo dall’esperienza diretta e nessuna guida può sostituirla. Senza dubbio è in quella prova concreta che si gioca la differenza tra chi avrà cavalcato l’onda degli agenti autonomi e chi la guarderà passare?

Leggi anche: ecosistema di AI privata

Magnifica Humanitas: Leone XIV e il bivio dell’IA

Al centro di Magnifica Humanitas, la prima enciclica di Leone XIV, ci sono due immagini bibliche contrapposte. Una è la torre di Babele, costruita per toccare il cielo e per farsi un nome, fatta crollare nella confusione delle lingue. L’altra sono le mura di Gerusalemme che Neemia ricostruisce dopo l’esilio, pezzo per pezzo, affidando a ciascuna famiglia un tratto. Babele come progetto di potere, uniformità, autosufficienza. Gerusalemme come opera lenta e distribuita, fondata su responsabilità condivisa.

Quando oggi ho letto questa coppia di immagini, nelle prime pagine di Magnifica Humanitas, mi sono accorto che la stessa polarità l’avevo descritta in modo diverso quando ho scritto il mio libro Pelle Digitale ormai qualche mese fa, ma con altri nomi.

Babele per me si chiama “megastruttura accidentale”, riprendendo Bratton. Gerusalemme l’ho chiamata “umanesimo aumentato”. Stesso concetto, lessico diverso, e la cosa mi ha stupito non poco: c’è poco da stare sereni e pensare che sia un caso se una visione tecnologica converge con una visione teologica e spirituale. È un segnale, probabilmente, che il tempo del dibattito puramente tecnico è finito o sicuramente ormai superato.

Cosa dice Magnifica Humanitas

Leone XIV non scrive contro la tecnica e a mio avviso nemmeno contro l’AI. La inserisce dentro un quadro di responsabilità che le tecnologie da sole non possono darsi. L’impalcatura di tutto il testo si regge su cinque punti.

Il primo è la denuncia del paradigma tecnocratico, già al centro di Laudato si’, qui aggiornato all’IA con un’accentuazione nuova. Al paragrafo 95 il Papa scrive che il controllo di piattaforme, dati e capacità di calcolo non appartiene più agli Stati ma a grandi attori economici e tecnologici “che, di fatto, fissano le condizioni di accesso”. Lo dice un Papa, ma potrebbe averlo scritto Shoshana Zuboff, sociologa ed economista americana, professoressa dell’Harvard Business School che è diventata un riferimento centrale del dibattito critico sul digitale per via di un libro del 2019, The Age of Surveillance Capitalism (in italiano Il capitalismo della sorveglianza, Luiss University Press), considerato uno dei testi più influenti dell’ultimo decennio su economia digitale e potere delle piattaforme.

Il secondo punto è un’antropologia del limite contro transumanesimo e postumanesimo. I sistemi di IA, scrive al paragrafo 99, “imitano alcune funzioni dell’intelligenza umana” ma non hanno esperienza né corpo, non hanno coscienza morale. Non capiscono ciò che producono. La distinzione fra imitare e capire diventa il fulcro di un’intera argomentazione che oppone la pienezza umana, fatta di limite e relazione, alla promessa di un potenziamento illimitato.

Il terzo punto è la fenomenologia delle nuove schiavitù digitali. Ghost worker che etichettano dati per pochi centesimi, adolescenti che lavorano nelle miniere di terre rare, reti criminali che usano profilazione e pagamenti anonimi per la tratta, neocolonialismo dei dati sanitari estratti dal Sud globale sotto l’etichetta della ricerca. Su tutto questo, ai paragrafi 173-178, c’è un passaggio in cui il Papa chiede sinceramente perdono a nome della Chiesa per il ritardo storico sulla condanna della schiavitù, e usa quel precedente come monito a queste nuove forme di schiavitù.

Il quarto punto salda epistemologia e democrazia. Senza ricerca condivisa della verità dei fatti, la vita democratica si svuota. Hannah Arendt viene citata direttamente: il suddito ideale dei totalitarismi è chi non distingue più fra fatto e finzione. La disinformazione non nasce con l’IA, ma trova in questa un moltiplicatore.

Il quinto punto è il disarmo dell’IA. Rifiuto delle armi autonome letali, critica all’idea che il giudizio morale possa essere ridotto a calcolo, controllo umano effettivo come condizione non negoziabile. Qui dentro c’è il paragrafo 107, uno dei più affilati, complessi e delicati del testo, che secondo me dovrebbe leggerlo chiunque sviluppa modelli: non basta moralizzare la macchina, allinearla a valori umani, se non si discute chi decide quei valori. La domanda dell’alignment, scrive Leone XIV, non è un tema tecnico ma politico.

Sette nodi dove mi ritrovo in quello che scrivo spesso

Il primo nodo è il paradigma tecnocratico. In Pelle Digitale apro descrivendo Apple, Google e Amazon come “signori della gabbia dorata”, architetti di ecosistemi che catturano l’esperienza e la monetizzano. L’enciclica al paragrafo 95 arriva alla stessa diagnosi da un lessico apparentemente opposto. Io descrivo un meccanismo, fatto di estrazione di dati, monetizzazione, lock-in degli utenti. Il Papa nomina un peccato: idolatria del profitto, dominio sull’altro, pretesa di autosufficienza. Linguaggi differenti che vengono da tradizioni che da secoli non si parlano, e che improvvisamente convergono sulla stessa fotografia: pochi attori privati che decidono per tutti, con strumenti opachi e responsabilità diluite.

Poi c’è l’ambiente. Io lo chiamo “pelle digitale” e “sistema nervoso invisibile” e intendo lo strato che avvolge persone, oggetti e città. Leone XIV al paragrafo 76 parla esplicitamente di “ecosistema digitale” che, come l’ambiente naturale, può essere custodito o sfruttato, condiviso o monopolizzato. La metafora ambientale, applicata al digitale, è uguale.

Il terzo nodo è l’opacità algoritmica. Nel capitolo 7 del libro io racconto i bias, facendo degli esempi in particolare cito COMPAS sulla recidiva e il caso del recruiting di Amazon, e arrivo a parlare di “teocrazia digitale” per descrivere algoritmi-divinità che decidono senza dover dare spiegazioni. L’enciclica, ai paragrafi 102-107, costruisce la stessa argomentazione con parole più “sobrie”: black box, accountability, catena di responsabilità non delegabile alla macchina. Il Papa non usa “teocrazia”. Ma il problema che descrive è esattamente quello a mio avviso.

Quarto nodo: i ghost worker. Nel libro dedico una pagina alla materia che si nasconde dietro l’immaterialità apparente del cloud e al lavoro umano che c’è dietro. Una catena globale di corpi e luoghi che regge la leggerezza apparente di una risposta generata in due secondi. Il paragrafo 173 di Magnifica Humanitas entra in questa anatomia con una forza che pochi documenti pubblici hanno. Leone XIV scrive che ogni risposta dell’IA proviene da “una lunga catena di mediazioni” che include risorse naturali, infrastrutture energetiche e persone. Nomina la fatica invisibile di chi etichetta dati e modera contenuti per compensi minimi, “spesso giovani donne”. Aggiunge l’estrazione delle terre rare, dove “adolescenti e bambini lavorano in condizioni pericolose”. E chiude con la frase che spacca la sezione: “corpi segnati, mutilati, consumati perché il flusso del calcolo non si interrompa”.

Quando un Papa nomina i corpi mutilati dentro un’enciclica sull’intelligenza artificiale, sta facendo un’operazione che nessun rapporto o paper accademico può fare: mette la materia umana al centro morale del dibattito, e non ai suoi margini. La conseguenza al paragrafo 174 è esplicita e a mio avviso centrale: una tecnologia che promette emancipazione ma produce nuove forme di subordinazione globale contraddice il principio fondamentale della dignità della persona.

C’è poi tutto il tema della mente estesa, attenzione catturata, forme di dipendenza che ne derivano. Nel capitolo 4 io ho scritto della cognizione distribuita di Andy Clark, e nel capitolo 6 sull’economia dell’attenzione progettata per catturarci. L’enciclica ai paragrafi 100 e 170 parla di “delega” cognitiva e di modelli imprenditoriali che “prosperano sulla debolezza umana”. Qui c’è uno scarto interpretativo che vale la pena tenere aperto: Clark vede nell’estensione un guadagno, il Papa la legge come rischio. E a mio avviso tutte e due sono vere.

Sesto, c’è il tema dello human-in-the-loop, che ho dichiarato pilastro del capitolo finale del libro. L’enciclica, parlando di IA militare al paragrafo 200, usa la stessa nozione con parole quasi sovrapponibili: la forza letale non può essere delegata a processi automatizzati, deve restare sotto “un controllo umano effettivo, consapevole e responsabile”.

Settimo, il più delicato a mio avviso. L’alignment come questione politica. Nel libro parlo di ethics by design e cito Stuart Russell sull’allineamento ai valori umani. Il Papa al paragrafo 107 fa un passo che la letteratura tecnica raramente fa: chiede chi decide quei valori. Se l’allineamento è una scelta morale, è una scelta che non può essere appannaggio di pochi laboratori. È un punto della discussione che sposta tutta la conversazione sull’IA dall’ingegneria alla politica, e lo fa con una precisione che dovrebbe far riflettere chi lavora su questi temi.

Dove Magnifica Humanitas va ben oltre le riflessioni comuni

Il primo punto è la questione delle armi autonome. Io ne parlo in modo leggero nel capitolo sull’agency degli agenti, ma non la centro. Leone XIV le mette al cuore di un intero capitolo, riconosce che la riabilitazione contemporanea della guerra come strumento di politica internazionale è uno dei segni più gravi del tempo, e collega il riarmo all’IA in modo che dieci anni fa sarebbe stato impensabile. Ha ragione e condivido pienamente, gli scenari ibridi e gli attacchi cyber stanno cambiando la grammatica dei conflitti, e non si può parlare di etica dell’IA senza arrivare a parlare di questo.

Il secondo è il neocolonialismo dei dati sanitari. Nel libro descrivo l’asimmetria della medicina basata su dati, ma resto sul piano dell’individuo. L’enciclica al paragrafo 178 lo allarga ai popoli: chi possiede oggi i dati sanitari di intere popolazioni, raccolti sotto il segno della ricerca, “possiede in realtà una leva strutturale sul futuro”. È una lettura geopolitica dell’estrazione dei dati che a gennaio, quando ho pubblicato il libro, per quanto ne fossi consapevole non ho pensato di affrontare.

Il terzo, e forse il più importante, è la memoria storica. Il Papa usa il ritardo con cui la Chiesa ha condannato la schiavitù come monito sul presente: se non vogliamo chiedere perdono in futuro per non aver visto le nuove asimmetrie di oggi, dobbiamo nominarle adesso. È una valutazione che solo un’istituzione con quel tempo lungo può fare. La riflessione laica contemporanea, la mia compresa, ha una memoria corta. Senza memoria lunga, certe asimmetrie restano fuori dal campo visivo.

E poi c’è il nodo del lavoro

C’è un punto su cui Leone XIV passa, e su cui non ho una posizione netta. È il capitolo sul lavoro, paragrafi 148-169, praticamente la parte più operativa di tutta l’enciclica a mio avviso e quella che parla più direttamente al mondo dell’impresa e della trasformazione digitale.

Il Papa cita san Benedetto e l’ora et labora, parla del lavoro come cammino di maturità e realizzazione. Al paragrafo 148 “lavoro” significa opera e contributo, fatica che ha senso, attività con cui prolunghiamo in qualche modo l’opera del Creatore. Ma già al paragrafo 149 la parola scivola sull’occupazione retribuita che produce sostentamento.

Un’ambiguità antica, che la Dottrina Sociale trascina dalla Rerum Novarum del 1891 in poi, e che oggi pesa, perché tiene insieme due cose che dovremo scindere con intelligenza.

Lo scenario che mi interessa, e che discuto da tempo con un amico parroco con cui non sono d’accordo, è quello in cui l’automazione derivante da AI e Robot libera davvero l’umanità dalla necessità di lavorare per sussistere. È uno scenario plausibile, forse il più radicale (e ottimista per certi versi). In quel mondo un reddito universale di base diventa obbligo strutturale prima ancora che scelta politica: senza, l’IA produce solo concentrazione di ricchezza e povertà di massa. E se la base materiale è garantita, si apre uno spazio per un altro tipo di lavoro, fondato su contributo e non su scambio. Il lavoro dei monaci copisti che hanno salvato la civiltà occidentale tra il VI e il XII secolo. Il lavoro delle madri che crescono i figli. Il lavoro dei volontari che reggono le associazioni, dei contributori di codice open source, dei ricercatori che pubblicano senza ricavarne nulla. Nessuna di queste attività è retribuita. Tutte sono lavoro nel senso pieno benedettino del termine.

Il mio amico Don Michele la pensa diversamente. Non esiste dignità senza lavoro, mi ripete ogni volta che ne parliamo, e lo dice con una fermezza esperienziale prima che ideologica. Vede ogni giorno cosa succede alle persone che il lavoro lo perdono o non lo trovano. Vede come si perde il senso di sé. Per lui il lavoro è un dato antropologico, non un dettaglio economico: è la forma stessa attraverso cui l’essere umano matura e si riconosce. Ed è qui che la sua tradizione e la mia visione del futuro si incontrano in modo costruttivo, perché ha ragione anche lui, su un pezzo del problema che spesso chi ragiona di reddito universale rimuove.

L’essere umano matura attraverso il fare che ha conseguenze. Senza un’opera che lo metta in rapporto con la realtà, con i limiti dei materiali, con il giudizio degli altri, con la propria fatica, la dignità diventa un’astrazione interiore che non regge. La tradizione cristiana lo sa da Genesi in poi, l’uomo è collaboratore della creazione e non spettatore. E sociologicamente succede esattamente quello che il mio amico vede sul campo: nelle comunità dove l’occupazione collassa senza essere sostituita da altre forme di contributo riconosciuto, le persone non fioriscono, si rovinano, entrano in forme diverse di collisione sociale. Le ricerche sulle zone deindustrializzate americane, sui quartieri operai italiani dopo le chiusure delle fabbriche, lo confermano. Se le persone non si sentono utili, tutto collassa.

Magnifica Humanitas apre un varco proprio su questo nodo. Al paragrafo 154 Leone XIV scrive che una società che garantisse occupazione solo a una minoranza esporrebbe molti a “inattività forzata, assenza di responsabilità, mancanza di impegni e stimoli quotidiani, con esiti di impoverimento umano e culturale in contrasto con l’elevato livello di sviluppo tecnico”. Lo chiama “paradosso di progresso materiale e regressione antropologica”. E conclude che è necessario “ripensare il lavoro stesso e il suo rapporto con la cittadinanza, perché l’assenza di occupazione non pregiudichi la partecipazione sociale”. Il Papa non sta dicendo che senza occupazione retribuita non c’è dignità. Sta dicendo che la nozione novecentesca di lavoro, quella che lega stipendio e dignità in un nodo unico, sta diventando inadeguata e va sciolta con cura.

Il “lavoro” come lo intendiamo oggi, un’attività salariata separata dalla vita domestica, misurata in ore, scambiata sul mercato del lavoro, è un’invenzione industriale di duecento anni.

Prima c’erano contadini e artigiani, monaci e madri di famiglia, scribi e copisti. Tutte figure che producevano valore senza essere “occupate” nel senso novecentesco. Hannah Arendt nella Condizione umana distingue tre cose. Labor, la fatica per sopravvivere. Work, la creazione di opere durevoli. Action, l’azione che lascia traccia nel mondo umano. Solo il primo è lavoro nel senso economico stretto. Gli altri due sono ciò che intendo quando parlo di un lavoro non remunerato fatto di passione e contributo.

Da Arendt in poi sappiamo che la dignità del lavoro stipendiato novecentesco era un fascio di tre cose tenute insieme. Un fare che incontra resistenza reale: i materiali e il tempo, la fatica, il giudizio degli altri. Senza questo l’identità si squaglia. Un riconoscimento sociale del valore di quel fare. Senza questo l’attività diventa hobby privato e non sostiene la dignità pubblica. Una base materiale di sussistenza che permetta di farlo senza disperazione. Senza questa, ogni discorso su “passione e ambizione” è privilegio per ricchi. Il salario industriale offriva i tre insieme, e questo ne ha fatto il modello dominante per due secoli. L’errore di chi parla solo di reddito universale, il mio compreso quando alleggerisco troppo il discorso, è pensare che la sola base materiale basti. L’errore opposto, di chi difende una visione ottocentesca del lavoro, è pensare che solo il lavoro retribuito possa fornire le altre due.

C’è poi un nodo geografico che l’enciclica nomina al paragrafo 153 e che vale la pena ripetere. La transizione non procederà in modo omogeneo. Le società ricche si automatizzano caoticamente e producono disoccupazione. Vaste regioni del Sud globale restano intrappolate in quelle che Leone XIV chiama “economie ibride” dove lavoro umano sottopagato e tecnologie parziali convivono senza mai trasformarsi davvero. Diventano serbatoi di manodopera precaria e focolai di migrazioni forzate. Il discorso sul futuro del lavoro va sempre tenuto a due velocità, perché chi parla di reddito universale spesso parla da Paesi ricchi e dimentica che intere economie del pianeta non hanno mai conosciuto il salario industriale come modello.

Siamo all’inizio di una transizione in cui dobbiamo inventare istituzioni che riconoscano come lavoro il fare non retribuito. Se non lo facciamo, la sostituzione algoritmica del lavoro stipendiato sarà una catastrofe antropologica, e su questo l’enciclica ha ragione a essere allarmata. Se lo facciamo, può essere lo spostamento di senso del lavoro più grande dai tempi della riforma benedettina. La domanda concreta, quella che resta aperta, è questa: quali istituzioni possono oggi riconoscere come dignità il lavoro non remunerato? La parrocchia ne è una storica. L’associazione di volontariato un’altra. La famiglia estesa un’altra ancora. Sono tutte istituzioni in crisi, ognuna per ragioni sue. Servono forme nuove, e quelle vecchie vanno rigenerate. Su questo l’enciclica è ambigua secondo me, e credo che il prossimo passo della Dottrina Sociale dovrà essere più esplicito di quanto Leone XIV osi oggi in questa enciclica.

Cosa cambia, se cambia qualcosa

Chi sviluppa e finanzia IA, chi la regola, non può più dichiararsi “tecnico” come schermo. Il paragrafo 209 dell’enciclica chiama in causa scienziati e imprenditori, investitori e autorità accademiche, politici. Quando ci si limita a guardare al proprio settore, scrive Leone XIV, ci si illude di svolgere un compito moralmente neutro. Mi ci ritrovo perfettamente, perché è la stessa argomentazione che faccio nel manifesto finale del libro: il fallimento etico è un fallimento progettuale.

La responsabilità progettuale, che chiamo ethics by design, l’enciclica la riformula come responsabilità condivisa fra istituzioni capaci di regolare, imprese che riconoscono nel lavoro e nella dignità un criterio di successo, corpi intermedi che ricostruiscono fiducia.

C’è un altro elemento operativo che vale la pena segnalare, perché passa sottotraccia ma c’è e non è sottovalutabile. Magnifica Humanitas al paragrafo 159 chiede esplicitamente di superare il Prodotto Interno Lordo come metrica unica dello sviluppo. Servono, scrive Leone XIV, parametri complementari capaci di misurare dignità del lavoro, prosperità condivisa, riduzione delle disuguaglianze, salvaguardia ambientale. Per chi lavora in impresa e si confronta ogni trimestre con KPI finanziari, è un invito a chiedersi quali metriche stiamo davvero usando per misurare il successo dei progetti tecnologici che lanciamo.

Lo stesso vale per il paragrafo 163, dove il Papa elenca quattro criteri operativi che diventano una check-list utile per chi progetta sistemi di IA che incidono su persone. Trasparenza e responsabilità nelle decisioni algoritmiche che riguardano accesso al credito e al lavoro, ai servizi essenziali. Inclusione e accesso ai benefici dell’innovazione, perché la tecnologia non allarghi il divario fra chi ha e chi non ha. Misure di equità che correggano gli squilibri creati dalla concentrazione di ricchezza e potere. Cooperazione internazionale, perché molte decisioni economiche superano i confini degli Stati. Sono cose verificabili, più che principi generici. E sono il vero terreno comune fra una riflessione laica sulla tecnologia e la Dottrina Sociale aggiornata.

Nessuno di noi che lavora su queste materie ha gli strumenti per agire da solo. La convergenza fra tradizioni distanti, su questo, è un dono che vale la pena prendere sul serio.

Neemia ricostruì le mura di Gerusalemme con famiglie diverse, ognuna su un tratto. Nessuna ricostruì l’intera cinta da sola. A chi progetta tecnologia oggi tocca il tratto in cui passa la decisione su cosa deleghiamo, cosa controlliamo, cosa restiamo capaci di giudicare. Il prossimo noi, come scrivevo a chiusura del manifesto di Pelle Digitale, inizia da lì.


Lettera Enciclica Magnifica Humanitas di Papa Leone XIV, 15 maggio 2026.

Leggi anche: cosa mi muove oltre la tecnologia

10 ragioni per portare l’AI privata al tavolo del board

Quando un’azienda inizia a costruire prodotti su AI, la prima scelta è quasi sempre la stessa: ci si appoggia ai grandi provider americani, e si lascia la AI privata come ipotesi da valutare “più avanti”. OpenAI, Anthropic, Google, qualche volta Mistral. Sono comodi, documentati, hanno API stabili, hanno modelli che funzionano davvero bene, hanno reparti enterprise che rispondono alle email.

Per le prime settimane, va benissimo così. Il problema arriva dopo, quando il prodotto smette di essere un prototipo e diventa qualcosa su cui dipende un pezzo di fatturato, di reputazione, di rapporto col cliente. È a quel punto che la domanda cambia, e diventa una domanda di architettura, non più di tool. Quanto controllo abbiamo davvero sul fondamento di quello che stiamo costruendo?

Negli ultimi mesi ho lavorato su questa domanda con diversi CEO e CTO di aziende italiane, e mi sono convinto che la AI privata vada considerata seriamente per almeno dieci ragioni. Non come fissazione tecnica, non come scelta ideologica anti-Big Tech, ma come opzione architetturale concreta che merita un posto al tavolo del board accanto alle proposte cloud-only.

I dati del cliente finiscono in posti che non controllate

Un contratto enterprise con OpenAI o Anthropic vi dà garanzie legali importanti: zero retention, niente training sui vostri dati, audit trail. Ma il dato tecnico resta: quando il vostro cliente invia una richiesta, quel testo viene processato dentro un data center che non è vostro, da un’infrastruttura che non vedete, sotto giurisdizioni che cambiano in base a dove sta il fornitore. Per applicazioni che trattano contratti, dati sanitari, proprietà intellettuale, strategie commerciali, questa distanza fisica fra dato e azienda è esattamente il punto su cui si stanno irrigidendo i clienti enterprise. Una banca italiana che valuta un vostro prodotto AI non vuole solo sapere che siete GDPR-compliant. Vuole sapere dove gira il modello e chi può guardarci dentro.

Le fondamenta sono in affitto

Costruire un prodotto AI completamente sopra un servizio esterno è comodo per la velocità di sviluppo, ma è l’equivalente di costruire un edificio su un terreno di cui non avete il rogito. Funziona finché funziona. Il giorno in cui il proprietario decide di cambiare le regole del condominio, vi ritrovate a discuterle dalla posizione più debole possibile. Non sto dicendo che OpenAI o Anthropic siano cattivi padroni di casa, anzi. Sto dicendo che la relazione resta strutturalmente asimmetrica, e questa asimmetria diventa rischio quando il vostro prodotto è in produzione presso clienti che si aspettano continuità per anni.

Quanto durano davvero le API che state usando

Modelli che vengono deprecati. Endpoint che spostano comportamento da una versione all’altra. Limiti di token che si modificano. Policy d’uso che si stringono o si allargano. Funzionalità beta che diventano premium. Le aziende che hanno costruito prodotti seri sopra le API dei grandi provider lo sanno: ogni rilascio è anche un piccolo lavoro di regressione testing per capire cosa è cambiato senza preavviso. La vostra roadmap di prodotto non è mai veramente vostra finché dipende dalla roadmap di qualcun altro, soprattutto quando quel qualcun altro rilascia tre versioni maggiori l’anno.

Erediterete la reputazione di chi vi dà il modello

Il nome famoso oggi rassicura il vostro cliente. Domani può finire dentro uno scandalo, una controversia regolatoria, una scelta commerciale impopolare, un caso di sicurezza, un’inchiesta giornalistica. Quando succede, il vostro prodotto eredita istantaneamente la coda di quella reputazione. I clienti più sofisticati lo sanno e mettono nelle loro RFP domande sempre più specifiche su quale modello state usando, dove gira, chi lo controlla. La risposta “usiamo il provider X” è già oggi una risposta che apre conversazioni invece di chiuderle.

I costi non sono sotto il vostro controllo

Potete ottimizzare i prompt, ridurre i token in uscita, fare prompt caching, scegliere il modello più piccolo per ogni task. Sono tutti esercizi utili, e li facciamo tutti. Però il prezzo finale al token lo decide qualcun altro, e lo decide guardando le proprie esigenze di margine, non le vostre. Negli ultimi due anni i costi dei modelli sono scesi rapidamente, ed è una buona notizia per chi è entrato adesso. Ma non c’è nessuna garanzia che continuino a scendere allo stesso ritmo, e ci sono diversi segnali di prezzi che stanno iniziando a risalire su modelli premium con context window molto lunghe o capacità agentic specifiche. Per chi pianifica un business plan a tre anni, è una variabile che vale la pena guardare con attenzione. Su questo tema ho scritto di recente in Quanta intelligenza artificiale stai davvero governando?.

La demo non è la produzione

Quando si dimostra un proof of concept, si usa quasi sempre il modello più potente disponibile. Funziona bene perché costa, e perché si lavora su volumi piccoli. Quando lo stesso prodotto va in produzione con cento clienti, mille clienti, diecimila utenti finali, i conti cambiano: i volumi salgono, la latenza diventa un problema reale, il budget per ogni interazione si stringe, e all’improvviso il modello che faceva la magia nella demo è troppo costoso per girare a regime. Comincia la caccia al modello “abbastanza buono” più economico, e quella caccia si fa molto meglio quando il modello sotto è una commodity che potete sostituire, non un servizio chiuso che dovete riconfigurare ogni volta.

I grandi provider americani non sono imbattibili

C’è un’idea diffusa, e secondo me sbagliata, che i grandi player AI siano destinati a vincere sempre perché hanno inventato la categoria. Non hanno inventato la categoria. Hanno estratto un enorme valore da una combinazione storicamente fortunata di dati pubblici scrapati prima delle restrizioni, infrastruttura GPU comprata in massa al momento giusto, distribuzione ai consumer arrivata prima di tutti gli altri. Tutte cose imitabili da chiunque abbia abbastanza capitale e tempo. Mistral in Europa, DeepSeek e Qwen in Cina, Meta con Llama, Cohere, Stability, decine di laboratori più piccoli stanno già pubblicando modelli open-weight competitivi su task specifici. L’ecosistema sta inevitabilmente convergendo verso una commoditizzazione almeno parziale, ed è ragionevole pensare che fra tre anni il “vincitore” del 2024 non sarà più automaticamente la scelta obbligata del 2027.

La sovranità digitale è diventata clausola contrattuale

Fino al 2023, parlare di sovranità digitale veniva visto come un argomento politico da convegno, lontano dalle decisioni operative di un’azienda. Nel 2026 è diventato un capitolo dei contratti enterprise. Il combinato disposto di GDPR, AI Act europeo, Schrems II, scadenze del PNRR e tensioni geopolitiche fra Stati Uniti, Europa e Cina sta riportando a casa una domanda che sembrava sepolta: dove sta fisicamente il software critico della mia azienda, e chi ha potere giurisdizionale su di esso? Per le aziende che lavorano con la pubblica amministrazione, con la difesa, con il settore bancario o sanitario italiano, questa domanda si è già trasformata in clausole contrattuali specifiche. Per tutte le altre aziende, è solo questione di tempo prima che arrivi nelle gare e nelle due diligence.

Il vendor lock-in tecnico è un debito che si accumula in silenzio

Ogni volta che ottimizzate un prompt per un modello specifico, sviluppate una tool integration su un’API specifica, costruite memoria semantica sopra un embedding-as-a-service specifico, state accumulando un debito tecnico di portabilità. Quel debito non si vede nei primi sei mesi, perché tutto funziona. Si vede al ventiquattresimo mese, quando provate a fare una proof of concept con un altro provider per ragioni di prezzo o di feature e scoprite che la migrazione costa quanto rifare metà del prodotto da zero. Quel debito si riduce drasticamente se il modello sotto è un’astrazione che potete sostituire, e si azzera se quel modello vive dentro un’infrastruttura che possedete. La domanda da farsi oggi non è solo quanto costa cominciare con un provider, è quanto costerebbe cambiarlo fra due anni.

AI Act e compliance non sono un problema futuro

Dall’agosto 2026 entrano in vigore i primi obblighi sostanziali del Regolamento europeo sull’AI per i sistemi ad alto rischio. Le aziende che usano modelli proprietari di terze parti per casi d’uso classificati ad alto rischio si troveranno a dover dimostrare conformità su dati di training, valutazioni di bias, documentazione tecnica, sistemi di monitoraggio, gestione del rischio. Su un modello chiuso, gran parte di queste informazioni vi vengono fornite o non vi vengono fornite dal provider. Su un modello che gira nella vostra infrastruttura, anche se è un modello open-weight scaricato da Hugging Face, la documentazione è almeno auditable, il fine-tuning è tracciabile, il dataset usato è esplicito. La differenza, per chi opera in finanza, sanità, HR, pubblica amministrazione, sta diventando rilevante in modo concreto e a breve termine.

Per chi vuole iniziare, c’è LocalAI.io

La AI pubblica resta utile, e in molti casi resta la scelta giusta per le prime fasi di sperimentazione di un prodotto. Però se la vostra applicazione dipende strutturalmente da privacy, controllo dei costi, sovranità e autonomia strategica, allora la AI privata non è una fissazione tecnica, è semplicemente buona architettura.

Su questo tema ho investito personalmente come cofondatore di LocalAI.io, un progetto open-source che permette di costruire ecosistemi di AI privata a partire dai modelli open-weight già esistenti, con tutto lo stack che serve per portare un prodotto in produzione: gateway compatibile con le API OpenAI, gestione di modelli multipli, RAG, agenti con memoria, deployment on-premise o su cloud privato. LocalAI è usato oggi in produzione da aziende che hanno deciso di avere il proprio strato AI in casa, e da team che vogliono mantenere la flessibilità di cambiare modello senza rifare il prodotto. Per chi vuole capire come funziona nel concreto, ho scritto una guida operativa completa qualche mese fa. Vale la pena darci un’occhiata se queste dieci ragioni hanno toccato qualche corda del vostro contesto.

La domanda finale resta sempre la stessa, e si fa più seria man mano che il vostro prodotto AI cresce. Su cosa state costruendo davvero, comodità immediata di chi vi dà il modello, oppure controllo nel lungo periodo di chi tiene insieme il vostro business? Se è una conversazione che vi sta riguardando, c’è la pagina Advisory con i formati di collaborazione che propongo a CEO e leadership team che stanno affrontando questi temi.

La politica sull’AI non sa cosa promettere, e questo è un problema

Mi è capitato sotto gli occhi nelle ultime settimane un saggio di Dan Kagan-Kans, The left is missing out on AI, che parte da una constatazione sull’America ma vale anche per l’Italia e probabilmente per buona parte d’Europa. Il dibattito politico sull’intelligenza artificiale, dice in sostanza, ha un buco preciso al centro. Da una parte ci sono i tecnici e gli imprenditori che progettano i sistemi e ne disegnano gli usi. Dall’altra ci sono i policy maker che cercano di limitare i danni, regolare l’esistente, mettere paletti. Manca quasi del tutto, in mezzo, una cosa che invece c’era stata in abbondanza durante la Rivoluzione Industriale: la voce dei movimenti politici che proponevano una loro visione di come la nuova tecnologia avrebbe dovuto servire un progetto di società. Saint-Simon, Owen, Fourier, Marx, ciascuno con un’idea diversa, talvolta opposta, ma tutti con un’idea precisa di cosa fare delle macchine a vapore e dei telai meccanici per costruire il mondo che volevano.

Adesso, in piena rivoluzione AI, quella voce non c’è. O meglio, c’è in modo asimmetrico, in alcune frange della destra americana e in pochissimi nodi accademici, mentre la sinistra in particolare arriva all’AI con due posture parallele: o regolatoria-difensiva oppure indifferente. Manca il terzo movimento, quello che Kagan-Kans identifica come essenziale: una proposta di società in cui l’AI faccia certe cose specifiche per costruire un futuro migliore, immaginate non da chi vende la tecnologia ma da chi rappresenta gli interessi delle persone che ci dovranno vivere dentro.

Questa lettura mi sembra istruttiva e provo a portarla a casa, in Italia, dove la situazione è ancora più acuta.

Il vuoto che non vediamo

Per spiegare bene di cosa parla Kagan-Kans serve riallineare la prospettiva storica. Quando, a inizio Ottocento, le filande meccaniche cominciavano a riorganizzare la produzione manifatturiera in Inghilterra e Francia, non si limitarono a sostituire lavoratori artigiani: scatenarono un dibattito intellettuale e politico che durò decenni, in cui movimenti diversi presero posizione su come usare quelle macchine per fini sociali diversi. I sansimoniani volevano un’industria razionalizzata e gestita da scienziati per il benessere collettivo. Robert Owen sperimentava comunità modello in cui le macchine alleviavano il lavoro e generavano tempo libero per la formazione. Fourier immaginava i falansteri. Marx ed Engels costruivano un’analisi del rapporto capitale-lavoro che attraversa due secoli di pensiero.

Si può essere d’accordo o no con ognuno di questi progetti, ma tutti condividevano una cosa: la pretesa di prescrivere usi specifici della tecnologia per fini politici dichiarati. Non si chiedevano solo come limitare i danni delle macchine, si chiedevano come usarle per costruire la società che volevano.

Oggi, davanti all’AI, questo livello di proposta è quasi assente. C’è abbondanza di analisi sui rischi, di richieste di regolazione, di paure articolate. C’è una quantità ancora maggiore di entusiasmo tecnocratico da parte di chi costruisce i sistemi. In mezzo, però, manca il livello propositivo. Mancano i movimenti che dicono: l’AI dovrebbe essere usata per fare X, Y, Z, secondo un disegno di società che si chiama in questo modo, perché crediamo a queste idee specifiche sul bene comune.

Perché è un vuoto, non un’attesa

Una risposta facile sarebbe dire che è presto. Che si tratta di tecnologie nuove, di applicazioni in corso di stabilizzazione, di scenari ancora sfumati, e che la politica arriverà dopo, quando ci sarà più chiarezza su cosa effettivamente questa tecnologia faccia.

Non penso che sia così, per due ragioni che credo importanti. La prima è che la storia non funziona così. I sansimoniani non aspettarono che la rivoluzione industriale fosse completata per immaginare cosa farne. Cominciarono a immaginarla mentre era ancora in corso, mentre i contorni erano sfumati, e proprio per questo riuscirono a influenzare la direzione. Aspettare la chiarezza significa rinunciare al diritto di disegnare. La seconda è che mentre la politica aspetta, qualcun altro disegna. Quel qualcun altro sono in larga parte le imprese tech, che hanno priori molto definiti sull’uso desiderabile dell’AI: massimizzare l’efficienza, ridurre i costi del lavoro, accelerare il ciclo di sviluppo dei prodotti, espandere la capacità di calcolo. Nessuno di questi obiettivi è cattivo in sé, ma neanche uno coincide automaticamente con un disegno di società sostenibile, equa, capace di sostenere chi rimane indietro.

Il rischio reale di questo vuoto, secondo me, non è la sopraffazione politica della tecnologia. È il contrario: che la politica, non avendo proposte proprie, finisca per importare le priorità del settore tecnologico come se fossero priorità collettive. Già adesso, in molte agende governative italiane, si parla di AI in termini ripresi quasi letteralmente dai pitch di aziende che vendono soluzioni AI. Senza un livello propositivo autonomo, la politica resta in posizione subordinata, regolatoria nel migliore dei casi, ancillare nel peggiore.

Tre cose che potrebbe dire chi volesse riempirlo

Provo a immaginare cosa proporrebbe un movimento politico contemporaneo serio, se decidesse di occupare quel vuoto. Non parlo di programmi elettorali completi, parlo di idee-cardine attorno a cui costruire una visione propositiva sull’AI.

La prima idea potrebbe riguardare il tempo. L’AI può comprimere drasticamente il tempo necessario per certe attività cognitive e operative. Cosa ne facciamo di quel tempo? In una visione economicista, lo trasformiamo in maggior output a parità di ore. In una visione diversa, lo restituiamo alle persone sotto forma di settimana lavorativa più corta, riduzione del lavoro non retribuito, aumento del tempo per la cura, lo studio, la cittadinanza attiva. È una scelta politica, non tecnica. Ma serve un movimento che la metta sul tavolo, perché di default non si sceglierà mai questa direzione.

La seconda idea potrebbe riguardare la conoscenza. L’AI sta concentrando rapidamente l’accesso a una nuova generazione di strumenti cognitivi nelle mani di chi può pagarseli o di chi lavora in aziende che li adottano per primi. La differenza tra chi ha accesso a un assistente AI di alto livello e chi non ce l’ha è già oggi un nuovo divario, e crescerà rapidamente. Un movimento politico serio dovrebbe avere un’idea su come democratizzare quell’accesso: scuole pubbliche che integrano questi strumenti, biblioteche civiche come hub di accesso, formazione adulta non come optional ma come servizio universale. Anche qui, è una scelta politica.

La terza idea potrebbe riguardare l’autonomia. Più gli agenti AI diventano capaci di agire sul mondo, più diventa critica la domanda: chi controlla davvero questi sistemi quando decidono al posto nostro? L’attuale architettura, dominata da una manciata di aziende USA e cinesi, non è l’unica possibile. Esistono alternative open, federate, locali, che richiedono investimenti pubblici per essere competitive. Un movimento che voglia tenere il controllo democratico sulle infrastrutture cognitive del futuro dovrebbe finanziare e proteggere questi modelli alternativi, prima che la concentrazione attuale diventi irreversibile.

Sono tre proposte ovvie, in un certo senso. Eppure non vedo una forza politica italiana che le abbia formulate insieme, dentro una cornice coerente, con la pretesa di costruire un futuro specifico anziché solo gestire l’esistente.

Il punto che mi tocca personalmente

In Pelle Digitale avevo provato a descrivere come la frontiera tra noi e le macchine si stesse facendo più sottile e più aderente, e in Spatial Shift avevo allargato la prospettiva guardando come si stesse riconfigurando lo spazio in cui agiamo. Tornando su quei libri oggi mi accorgo che entrambi descrivono fenomeni in corso senza prescrivere un esito politico. Faccio l’analista, non il proponente. È una scelta legittima per chi scrive da imprenditore. È anche, però, un sintomo del problema che Kagan-Kans diagnostica.

La verità è che osservare e descrivere è la parte facile. Proporre cosa fare di queste tecnologie per costruire la società che vogliamo è la parte difficile, perché richiede una visione politica esplicita, e in questo momento storico in Italia è quasi imbarazzante esprimerne una. Si fa fatica a discutere di visioni politiche di lungo periodo senza essere immediatamente catalogati su un asse destra-sinistra che ha smesso di catturare le distinzioni rilevanti.

Eppure, se non lo facciamo noi, lo faranno altri al posto nostro. Lo faranno bene, perché hanno interesse a farlo. E nessuno di loro avrà come priorità le persone che oggi sento attorno a me ogni giorno, lavoratori cinquantenni che dovranno reinventarsi, studenti che non sanno se le loro lauree avranno valore tra cinque anni, imprenditori medi che si chiedono se le loro aziende riusciranno a stare in piedi nel decennio.

Non ho una proposta politica completa da offrire qui. Ho una sensazione precisa che mi accompagna da mesi: che il pezzo più importante della partita sull’AI non si stia giocando nei laboratori di Anthropic o nelle policy room di Bruxelles, ma in una stanza vuota che nessuno ancora sta occupando. La stanza in cui qualcuno dovrebbe stare disegnando un’idea di società che dia un senso politico a tutta questa potenza tecnica. Senza quel disegno, anche le tecnologie migliori finiscono per servire fini che nessuno ha mai esplicitamente scelto. È successo già due secoli fa, con conseguenze che paghiamo ancora. Mi piacerebbe che questa volta facessimo meglio.

Il 57% di McKinsey è il numero sbagliato per fare scelte aziendali

Il 25 novembre 2025 il McKinsey Global Institute ha pubblicato uno dei report più discussi dell’ultimo semestre, Agents, Robots, and Us: Skill Partnerships in the Age of AI. La cifra che è girata su tutti i media internazionali è una: il 57% delle ore lavorative negli Stati Uniti è tecnicamente automatizzabile oggi, senza attendere ulteriori breakthrough. Il 44% via agenti AI, il 13% via robotica. Una percentuale così alta che, raccontata male, suona come un annuncio di disoccupazione di massa.

Leggere così quel numero, secondo me, è il modo peggiore di usare quel report. Il 57% misura il potenziale tecnico in laboratorio, non lo scenario reale di adozione. Usarlo per fare scelte aziendali porta nella direzione opposta a quella utile. Ho letto il report intero in questi giorni e provo a dare la mia lettura, da chi lavora in azienda con le aziende, non da chi commenta da fuori.

Il 40% è il dato da cui partire

Il 57% è il limite superiore in laboratorio. Risponde alla domanda: se prendiamo gli strumenti AI e robotici che già esistono, quante ore di lavoro umano potrebbero in teoria essere svolte dalle macchine? La risposta è oltre la metà. Ma McKinsey stesso sottolinea che questa cifra non si tradurrà in posti persi nella stessa proporzione, per tre ragioni che il report spiega bene.

  • Tempo di adozione: l’adozione richiederà anni, in molti casi decenni, perché le aziende devono ridisegnare i flussi prima di poter automatizzare.
  • Mix di attività dentro ogni ruolo: la maggior parte dei lavori contiene un mix di attività, e raramente un singolo lavoro è automatizzabile al 100%.
  • Gap fra laboratorio e produzione: molte attività che oggi sembrano automatizzabili in laboratorio non lo sono in produzione, per ragioni di affidabilità, responsabilità legale, accettabilità sociale o semplice costo del bilanciamento errore-supervisione.

Il numero che secondo me andrebbe letto in parallelo è un altro che si nasconde nel report: circa il 40% dei lavori cade nelle categorie a più alta automatizzabilità, principalmente attività amministrative, legali junior, programmazione di routine. Quel 40% non sparisce, ma cambierà natura entro l’orizzonte 2030, e cambierà bruscamente per chi non si attrezza per tempo. Questo dovrebbe essere il dato da cui partono le riunioni di leadership team in questi mesi, non il 57% da titolo apocalittico.

Persone, agenti software, robot fisici: il framework di McKinsey

Il contributo più interessante del report è il framework dei sette archetipi di lavoro che McKinsey costruisce mappando 800 occupazioni rispetto a tre dimensioni: quanto è people-centric, quanto è agent-centric (cioè automatizzabile da AI software), quanto è robot-centric (cioè automatizzabile da hardware). Ne emergono profili misti che rispecchiano quello che si vede nei contesti reali. Un radiologo è people-centric per la responsabilità clinica e agent-centric per l’analisi delle immagini, e la combinazione delle due dimensioni in un’unica figura professionale è un nodo organizzativo nuovo da governare.

La parola chiave del framework è partnership. McKinsey parla di collaborazione fra persone, agenti software e robot fisici, ciascuno con la propria competenza, orchestrati in workflow ridisegnati. La parte più scomoda del messaggio è che il framework funziona solo se l’organizzazione fa il lavoro di ridisegno. Se prendi un workflow esistente, ci ficchi dentro un agente AI sopra al processo che hai sempre fatto, non ottieni il 57%, ottieni nel migliore dei casi un risparmio del 10-15% e una serie di frustrazioni operative.

Per chi compra AI in azienda, questo punto vale più di mille slide. Il valore non sta nel tool, sta nel ridisegno del processo intorno al tool. Senza ridisegno, il ROI delle implementazioni AI rimane sotto le attese e i progetti finiscono nel limbo dei pilot perpetui.

Tre competenze umane che si fanno scarse

Una parte del report che mi ha colpito riguarda le competenze umane che diventano più rare, e quindi più richieste, man mano che l’AI assorbe i compiti standardizzati. McKinsey mappa migliaia di skill estratte dagli annunci di lavoro e individua tre cluster che resistono e crescono.

Il primo è quello delle skill relazionali avanzate: gestione del conflitto, negoziazione, coaching, costruzione del consenso in gruppi diversi. Sono attività che richiedono lettura del contesto sociale, contestualizzazione, judgement etico, e che le macchine fanno male anche quando sanno parlare bene.

Il secondo è quello del problem framing: la capacità di formulare la domanda giusta da porre all’AI, di distinguere un buon prompt da uno mediocre, di interpretare un output e capire quando merita fiducia e quando no. È una skill che ha più a che fare con il pensiero critico che con la tecnica, e curiosamente è una skill che il sistema scolastico italiano non ha mai sviluppato in modo sistematico.

Il terzo è quello dell’orchestrazione: tenere insieme processi multi-step in cui interagiscono persone diverse, agenti diversi, sistemi diversi. Project manager evoluti che capiscono dove inserire un agente nel flusso e dove tenere fermo l’umano. Sono profili che fino a un anno fa non esistevano e che adesso le aziende si contendono.

Tre skill scarse, prezzi che si muovono. È quasi un piccolo manuale di come riallocare il budget HR per il prossimo triennio.

Tre conversazioni che i board italiani dovrebbero aprire entro fine anno

In Italia il dibattito sull’AI nel lavoro è ancora dominato da due narrative simmetriche e sbagliate. La prima dice che l’AI ci ruberà i posti e che bisogna proteggerli con qualche regolazione. La seconda dice che l’AI è un super-strumento neutro, basta adottarlo per essere più competitivi. Il report di McKinsey mostra che entrambe queste narrative perdono il punto.

Le aziende che vinceranno il prossimo decennio non saranno quelle che adottano l’AI prima, ma quelle che ridisegnano i propri processi intorno alla collaborazione fra persone, agenti software e robot fisici. Per farlo serve qualcosa che in Italia abbiamo strutturalmente poco, ovvero capacità di trasformazione organizzativa profonda. Non capacità di acquistare tool, ne abbiamo a sufficienza. Capacità di rimettere mano a chi fa cosa, di toccare le abitudini consolidate, di accettare che metà del valore di un’implementazione AI si gioca prima ancora di accenderla, nella riprogettazione del flusso che le sta intorno.

Per chi guida un’azienda strutturata, oggi, ci sono tre conversazioni che meritano di essere portate al tavolo del board nei prossimi tre mesi.

La prima: quali nostri workflow contengono il maggior numero di ore standardizzabili, e quali no? Una mappa di alto livello del 57% dentro la nostra realtà specifica.

La seconda: chi sono i nostri orchestratori naturali? Persone che hanno già la capacità di tenere insieme processi multi-attore, che capiscono dove servono le competenze relazionali e dove serve la disciplina tecnica. Le aziende che riescono a identificarli e a metterli nei posti giusti partiranno con un vantaggio enorme.

La terza: dove possiamo permetterci di pilotare un workflow completamente ridisegnato, e non solo automatizzato a strati? Dove ci possiamo permettere il rischio di romperlo e ricostruirlo, su uno scope contenuto, per imparare come si fa prima di doverlo fare su scala?

Sono tre domande che non hanno bisogno di numeri da 57% per essere utili. Hanno bisogno di tempo dedicato dalla leadership, e di sufficiente coraggio per dare risposte concrete entro fine anno. Da imprenditore vedo molte aziende ferme alla prima delle tre, alcune che hanno provato la seconda, pochissime che hanno avuto il coraggio della terza. È lì, secondo me, che si decide la parte interessante del prossimo ciclo competitivo italiano. Non nei budget AI, che ormai tutti hanno. Nelle scelte organizzative dietro a quei budget.


Articolo di riferimento: McKinsey Global Institute, Agents, Robots, and Us: Skill Partnerships in the Age of AI, 25 novembre 2025.

Quanta intelligenza artificiale stai davvero governando?

Usare intelligenza artificiale e governarla sono due cose diverse. Quasi nessuna organizzazione che conosco ha ancora fatto il salto dalla prima alla seconda, e il conto sta arrivando, in modo molto concreto, sotto forma di budget esplosi a fine mese.

Le due cose sembrano simili. Non lo sono per niente.

Ho visto circolare nelle ultime settimane un grafico che mi ha colpito per la sua semplicità, il tipo di visualizzazione che riesce a mettere insieme in modo immediato qualcosa che si intuiva ma non si riusciva ancora a formulare bene. Su scala logaritmica, due curve: i ricavi da abbonamento per posto, piatti e stabili nel tempo, e il costo reale per token di inferenza, che cresce in modo esponenziale con l’intensità d’uso. Finché le linee restano separate, il margine esiste, le aziende che costruiscono su questi modelli respirano. Dopo l’incrocio, il grafico lo chiama “Profit Collapse.” Non è un modello accademico, è quello che le aziende che hanno messo intelligenza artificiale in produzione su larga scala stanno già vedendo nelle loro dashboard finanziarie.

Un caso che ha fatto girare molto rumore nelle ultime settimane: il CTO di Uber ha dichiarato di aver consumato in quattro mesi l’intero budget previsto per l’anno intero. Non perché i modelli non funzionassero. Perché nessuno aveva progettato il workflow con la consapevolezza che ogni chiamata ha un peso, che la somma di migliaia di micro-interazioni che sembrano gratuite diventa, alla scala di un’azienda come Uber, una spesa concreta, reale, non pianificata.

Il prezzo del flat-rate è stato l’ignoranza

Per due anni, i modelli di pricing a tariffa fissa hanno fatto una cosa molto precisa: hanno reso invisibile il costo reale dell’inferenza. La subscription mensile, il “paga X al mese e usa quanto vuoi”, ha creato nelle organizzazioni un’abitudine pericolosa, quella di non porsi le domande giuste sul consumo. Quanti token stiamo generando davvero? Chi li genera? Quale parte del flusso di lavoro produce valore misurabile e quale è ridondanza computazionale, automazione per automazione?

Quelle domande non venivano poste perché il modello economico non le rendeva urgenti. Adesso lo diventano, perché il pricing a token le mette sul tavolo ogni mese, come voce di costo separata, attribuibile, visibile.

La reazione che osservo più spesso è quella sbagliata: tagliare le licenze, ridurre l’accesso, aspettare che i costi scendano ancora. È una risposta di gestione del budget, non una risposta di strategia. E rischia di far perdere il vantaggio competitivo che si stava costruendo nel momento peggiore.

Adottare e governare sono due fasi diverse

C’è una distinzione che mi sembra fondamentale e che non viene fatta abbastanza, anche tra le persone che lavorano sul tema con serietà.

Adottare vuol dire integrare strumenti nei processi, formare le persone, misurare i primi risultati, dimostrare che funziona. È la fase in cui quasi tutte le organizzazioni si trovano, o si sono trovate nell’ultimo anno e mezzo. È necessaria, è il punto di partenza, ed è giusta.

Governare è qualcosa di diverso, più granulare e più esigente. Significa sapere dove ogni interazione con un modello si inserisce nel flusso operativo, quali sono le condizioni di attivazione, quanto pesa in termini di contesto, quanto costa ogni singola risposta e perché vale quello che costa. Significa avere visibilità sul consumo in tempo reale, non scoprirlo a consuntivo a fine mese. Significa, soprattutto, aver progettato i processi attorno agli strumenti, non aver semplicemente incollato un modello linguistico sopra un flusso di lavoro che esisteva già prima e che continua a funzionare esattamente come prima, solo con un layer di testo generato in più.

La gran parte delle organizzazioni che conosco è ancora nella fase dell’adozione. Si vede dai sintomi: budget che arrivano come sorprese, utilizzi distribuiti in modo caotico tra team diversi, nessuna metrica di efficienza sul consumo, nessuna distinzione operativa tra le interazioni che creano valore e quelle che lo consumano senza restituirlo.

Perché tenere l’intelligenza dentro cambia tutto

In questo contesto, spostare i modelli dentro perimetri controllati, on-premise o in architetture ibride dove il dato sensibile non esce, smette di essere una posizione ideologica sulla sovranità del dato e diventa una scelta molto concreta, economica e operativa insieme.

I vantaggi sono due, e si sovrappongono. Il primo è la prevedibilità dei costi: un modello che gira su infrastruttura propria ha un costo fisso che si pianifica, con una variabile di consumo che rimane interna, controllabile, non affidata all’intensità d’uso di tremila dipendenti distribuiti su fusi orari diversi. Il secondo è la compliance, che con l’AI Act in vigore e la pressione normativa che continua a crescere è diventata un requisito operativo con scadenze e responsabilità, ben oltre il perimetro di chi si occupa di legale.

Non tutti i casi d’uso hanno bisogno di modelli privati. Molti flussi di lavoro funzionano perfettamente su API pubbliche, purché siano stati progettati con la consapevolezza del costo. Ma la scelta tra pubblico e privato non può essere presa senza aver prima risposto alle domande di governo: chi usa cosa, con quale frequenza, per fare cosa, e quanto rende.

I token come risorsa operativa

C’è un cambio culturale che secondo me non sta avvenendo alla velocità giusta, ed è quello di trattare il consumo di token come una risorsa operativa, con la stessa serietà con cui si trattano le ore di computing, la banda di rete, lo storage.

In ogni organizzazione tecnologicamente matura, queste metriche hanno un owner, un budget, un ciclo di ottimizzazione. Il consumo di token, finora, non ne ha avuto uno. Era nascosto nel flat-rate, o era abbastanza economico da sembrare irrilevante come singola voce.

Non è più così, e la risposta non è tagliare, come dicevo. La risposta è costruire la governance prima che il budget esploda: monitoraggio in tempo reale, attribuzione del consumo per team e per processo, soglie di allerta, revisione periodica dei flussi ad alto costo. È lavoro di ingegneria, di processo, di cultura organizzativa. È il lavoro che separa chi sta ancora adottando da chi sta davvero costruendo.

C’è un parallelo che mi viene in mente pensando a come siamo arrivati qui. Nel mondo dello sport professionistico, c’è stato un momento in cui le squadre hanno smesso di valutare i giocatori a occhio e hanno iniziato a misurare tutto, ogni azione, ogni metro percorso, ogni contatto. Quella trasformazione non ha reso lo sport meno umano, ha reso le decisioni più informate. Qualcosa di simile sta per succedere con l’intelligenza artificiale in azienda: chi impara a misurare prima, e a misurare le cose giuste, arriverà avvantaggiato alla fase successiva.

La competizione si sposta

Ci sarà un punto, e credo non lontano, in cui la competizione sull’intelligenza artificiale in azienda non si giocherà più sull’accesso ai modelli. I modelli sono già disponibili, i costi di inferenza scendono, la barriera tecnica all’ingresso si abbassa. La competizione si giocherà su chi riesce a usarli in modo economicamente sostenibile, con processi progettati per reggere la scala, non solo la demo, e con la capacità di misurare, ottimizzare, correggere in tempo reale.

Le organizzazioni che arriveranno avvantaggiate a quella fase sono quelle che adesso, mentre la conversazione pubblica è ancora tutta sull’adozione e sui casi d’uso, stanno costruendo la governance. Stanno ponendo ai loro team le domande scomode. Stanno mettendo metriche dove prima c’erano impressioni. Stanno disegnando flussi di lavoro che hanno senso economico oltre che funzionale.

Senza dubbio, la domanda che conta adesso non è “stai usando intelligenza artificiale?” ma “sai cosa sta facendo l’intelligenza artificiale che stai usando, e quanto ti costa davvero governarla?”

Onlyness e leadership: perché il change management non funziona più

Ho ascoltato in questi giorni il podcast con Nilofer Merchant in cui torna sul concetto che porta avanti da anni, quello che lei chiama onlyness, e lo applica a un’idea che mi sembra meriti più attenzione di quella che riceve in Italia: la fine del change management come l’abbiamo conosciuto. Merchant viene da una carriera lunga in Apple e Autodesk, ha lanciato oltre cento prodotti, è una delle voci più riconosciute sul Thinkers50, e da qualche tempo dice una cosa precisa. Il change management, inteso come piano che parte dall’alto e si distribuisce sotto, è uno strumento del Novecento. Funzionava in un mondo in cui chi stava in cima sapeva la direzione e chi stava sotto doveva essere portato a seguirla, con la giusta combinazione di leve di influenza, comunicazione e formazione. Era un sistema di controllo travestito da accompagnamento.

Quel mondo, dice Merchant, non esiste più. Esiste un altro mondo in cui la conoscenza necessaria per cambiare un’organizzazione non sta più tutta in cima ed esiste quasi sempre distribuita nei nodi, perché sono i nodi quelli che toccano i clienti, i prodotti, le anomalie, le opportunità invisibili dal piano direttivo. Allora il cambiamento non si gestisce più. Si co-crea. E il ruolo della leadership si trasforma da quello di chi indica la rotta a quello di chi sa porre le domande giuste e accetta di non sapere ancora la risposta.

Il sapere si è spostato, i framework no

Per anni ho visto progetti di trasformazione organizzativa fallire per la stessa ragione di fondo, quella che adesso Merchant nomina bene. C’era una sproporzione tra chi disegnava il cambiamento e chi lo doveva attuare. Quelli che lo disegnavano sapevano abbastanza di strategia ma poco del lavoro reale, quelli che lo dovevano attuare sapevano del lavoro reale ma erano tenuti fuori dal disegno. Il classico tentativo di sanare lo squilibrio era introdurre cicli di workshop, focus group, sondaggi di engagement. Roba che dava al sotto l’illusione di partecipare al sopra senza spostare davvero la decisione. Funzionava, a tratti, perché il sotto accettava la finzione in cambio di un po’ di considerazione.

Adesso quella finzione si rompe da sola, e non per ragioni etiche ma per ragioni di efficienza. L’AI sta amplificando un fenomeno che già era in corso da vent’anni: la conoscenza utile per prendere decisioni si è spostata verso i bordi dell’organizzazione. Strumenti come Claude, Copilot, e tutti i loro fratelli, mettono nelle mani di chi sta nei nodi capacità di analisi, sintesi, prototipazione che fino a ieri richiedevano staff dedicato. Una persona junior con un modello potente accanto può oggi produrre output decisionali che dieci anni fa erano appannaggio di consulenti senior pagati a giornata. Allora la domanda diventa imbarazzante: perché continuiamo a gestire il cambiamento come se la conoscenza fosse ancora gerarchica?

Onlyness applicata alla trasformazione

Il concetto di onlyness di Merchant è la chiave operativa che permette di uscire dall’impasse. Onlyness è il punto unico del mondo in cui solo tu stai, dato dalla combinazione esatta di esperienza, storia, prospettiva, relazioni che hai accumulato. Da quel punto unico puoi vedere cose che nessun altro vede e portare contributi che nessun altro può dare. Vista così, ogni persona in organizzazione è portatrice di onlyness, e l’onlyness non si delega.

Quando trasferisci questa idea al cambiamento organizzativo, succede una cosa interessante. Il piano dall’alto smette di essere un piano. Diventa una cornice: la domanda che si sta cercando di rispondere, il vincolo che bisogna rispettare, l’orizzonte temporale entro cui muoversi. Dentro quella cornice, sono gli onlyness distribuiti a costruire le soluzioni, una accanto all’altra, una sopra l’altra, fino a comporre qualcosa che nessuna mente singola avrebbe potuto disegnare. Il ruolo di chi guida diventa custodire la cornice, non riempirla. Tenere fermo il perché, lasciare aperto il come.

Sembra astratto e invece è molto operativo. Vuol dire che il leader passa la maggior parte del tempo a fare due cose: a formulare e riformulare la domanda finché diventa abbastanza precisa da orientare l’azione senza essere così stretta da chiudere lo spazio creativo, e a costruire le condizioni in cui le persone si sentono sicure abbastanza per portare il proprio punto unico al tavolo senza paura. La seconda cosa è la più difficile, perché va contro decenni di abitudini gerarchiche.

Onlyness e disagio: il segnale che qualcosa sta davvero cambiando

Merchant parla del disagio come componente strutturale del processo. Non lo vede come effetto collaterale da minimizzare, lo vede come segnale che si sta andando nella direzione giusta. Se durante un processo di cambiamento nessuno sta scomodo, allora con buona probabilità non sta cambiando niente di vero. Sta cambiando solo la superficie, magari i diagrammi, magari le nomenclature, magari i punteggi negli engagement survey. Ma sotto, le vecchie posizioni di potere stanno tenendo botta.

Il disagio vero arriva quando chi era abituato a decidere deve imparare ad ascoltare prima di parlare, quando chi era abituato a eseguire deve imparare a proporre, quando chi era abituato a sapere deve riconoscere apertamente che non sa. Sono tre disagi simmetrici, distribuiti nei tre livelli classici dell’organizzazione, e nessuno dei tre è gratis. Merchant non promette una scorciatoia. Dice che il leader serio è quello che lo accetta e ci convive, anziché cercare di anestetizzarlo con metodologie sempre più sofisticate.

Leader e onlyness: la nuova base dell’autorità

Nel mio libro La mente adattiva avevo cercato di descrivere come la capacità di adattamento individuale e organizzativo stesse diventando la competenza chiave del decennio. Adesso vedo che quella tesi ha bisogno di un’integrazione. L’AI non aumenta solo l’urgenza dell’adattamento, ne cambia anche la natura. Perché l’AI non è uno strumento che aspetta l’istruzione, è un agente che propone. Lavora con te, ti porge alternative, ti contesta assunzioni. Se sai usarla, è come avere accanto un collega che ha letto tutto ed è disposto a discutere all’infinito.

In quel quadro, l’organizzazione gerarchica vecchio stampo diventa un collo di bottiglia evidente. Se ogni nodo dell’organizzazione ha accesso a un partner di ragionamento di livello globale, il freno smette di essere informativo e diventa autorizzativo: non manca più la conoscenza, manca il permesso di usarla. La burocrazia interna che doveva proteggere dalla cattiva decisione adesso protegge dalla decisione e basta. E intanto i competitor più piccoli, più piatti, più disposti a co-creare, si muovono prima.

Cosa succede a chi guida quando questo si avvera? Succede che il modello mentale del leader come ultimo decisore informato non regge più. L’AI sa più cose di te, su quasi tutto. I tuoi collaboratori, ben armati di AI, sanno più cose di te sui loro ambiti specifici. La tua autorità non può poggiare sul “sapere di più”, perché è semplicemente falso. Deve poggiare su qualcos’altro: sulla qualità delle domande che fai, sulla precisione con cui custodisci la direzione, sulla capacità di tenere viva la coesione del gruppo quando tutti sanno troppe cose e nessuno sa quella decisiva.

Come si forma il prossimo livello di leadership

Se la co-creazione è davvero il nuovo paradigma e l’AI lo accelera, allora va riaperta la questione su come si forma il prossimo livello di leader. Le vecchie palestre, le carriere lineari, gli step da middle a top management, presupponevano un mondo in cui si saliva accumulando sapere e contatti. Adesso il sapere è distribuito e i contatti li media spesso un algoritmo. Quello che resta scarso, e che diventa quindi il vero asset, è la capacità di stare nel disagio della non-conoscenza, di formulare domande che muovono persone e organizzazioni, di tenere insieme talenti diversi intorno a un perché che regge.

Tre cose che non si imparano leggendo, si imparano facendo, in mezzo agli altri, fallendo davanti a loro qualche volta. Mi piacerebbe vedere più aziende che progettano percorsi di leadership su queste tre dimensioni invece che sulla classica triade conoscenze-competenze-soft skill. Sarebbe già un primo passo verso il post-change-management che Merchant prefigura. Per ora, da imprenditore che ha attraversato cambiamenti organizzativi di vari ordini di grandezza, dico che il problema più sottile sta nel cambiare l’idea che abbiamo del leader, prima ancora delle regole. E quella, le regole, non basta a smuoverla.

Se vuoi confrontarti su come riprogettare ruoli di leadership in un contesto in cui l’AI ridistribuisce la conoscenza nei nodi, c’è la pagina Advisory con i formati di collaborazione che propongo a CEO e leadership team.

Schema del MCP tunnel di Anthropic: esecuzione dentro la sandbox, regia esterna

Anthropic sposta l’esecuzione dentro l’azienda, la regia resta fuori

Il 19 maggio, al primo Code with Claude tenuto a Londra, Anthropic ha annunciato due funzionalità che spostano in modo concreto dove vivono gli agenti AI dentro le aziende. La prima si chiama self-hosted sandboxes ed è in public beta. La seconda si chiama MCP tunnels ed è in research preview. Messe vicine valgono più di quanto sembrino a una lettura veloce della release note, e provo a dire perché.

Il punto di partenza tecnico è semplice. Claude Managed Agents è l’infrastruttura ospitata di Anthropic per far girare sessioni agentiche lunghe e tool-heavy. Fino a maggio, tutto stava lì: l’agent loop con orchestrazione e gestione del contesto, l’esecuzione dei tool, la connessione ai servizi esterni. Adesso una parte di quello stack può uscire da Anthropic e rientrare dentro il perimetro del cliente, mentre l’altra resta dove era. La regia rimane su Anthropic. L’azione si sposta a casa tua.

Schema del MCP tunnel di Anthropic: esecuzione dentro la sandbox, regia esterna
Fonte: Anthropic, schema del MCP tunnel.

L’esecuzione si sposta a casa tua

Quando un agente esegue un tool, esegue codice. Apre file, installa pacchetti, chiama API, scarica risorse. Fino a ieri tutto questo avveniva nei sandbox gestiti da Anthropic. Da oggi puoi configurare l’agente perché esegua quegli stessi tool dentro la tua infrastruttura, oppure presso un provider gestito a tua scelta (Cloudflare, Daytona, Modal, Vercel sono i nomi citati). I tuoi file sensibili, le repository di codice, i pacchetti privati, i segreti di configurazione non lasciano più la tua rete. E il logging di audit, le policy di sicurezza, gli strumenti di monitoring che hai già sul tuo perimetro continuano a vedere e regolare quello che fa l’agente.

L’orchestrazione, invece, resta su Anthropic. L’agent loop, la gestione del contesto, la recovery dagli errori, la pianificazione delle azioni successive sono tutti gestiti dall’API di Claude. Cambia solo dove materialmente vengono eseguite le chiamate. Se l’agente decide di lanciare uno script Python per processare un file, lo script gira sul tuo sandbox, non sul loro.

Un canale che parla solo verso l’esterno

Gli MCP tunnels affrontano il problema speculare. Come fa un agente a parlare con i tuoi sistemi interni senza che tu debba esporli a internet? Il Model Context Protocol è lo standard aperto che Anthropic ha promosso lo scorso anno per far dialogare gli agenti con sorgenti dati e servizi esterni. Funziona bene quando i servizi sono pubblici, meno bene quando sono dentro un network privato.

Il meccanismo che hanno introdotto è un gateway leggero, che il cliente dispiega dentro la propria rete, e che apre una singola connessione outbound verso Anthropic, cifrata end-to-end. Nessuna porta inbound da aprire. Nessun endpoint pubblico. Nessuna modifica al firewall. Sopra quel canale possono passare conversazioni MCP verso server interni che ospitano database, knowledge base, ticketing system, API private. L’agente di colpo può chiamare quei sistemi come fossero tool standard, ma il traffico non transita mai sull’internet pubblico.

Dove finisce l’azienda, dove comincia il modello

A una lettura superficiale è un aggiornamento di sicurezza e compliance. Per le aziende regolate è una notizia importante perché toglie uno dei blocchi tipici all’adozione, quel “non possiamo far uscire i dati” che ferma centinaia di progetti ogni anno. Per chi vende AI in enterprise è una mossa competitiva contro i player che offrono già installazioni on-premise complete.

C’è anche un altro livello. Anthropic sta dichiarando, in modo molto operativo, dove finisce l’azienda e dove comincia il modello. Per anni la domanda “dove vive un’AI aziendale” ha avuto due risposte estreme: o tutto in cloud sul provider, oppure tutto on-premise con uno stack auto-ospitato. Adesso ne sta diventando praticabile una terza, più sottile. La testa pensante del sistema, l’agent loop, resta fuori dall’azienda perché lì sta l’innovazione che si muove troppo veloce per essere replicata internamente. Le mani che toccano i dati e i tool tornano dentro perché lì stanno le regole, la responsabilità, il perimetro legale e culturale.

È una decomposizione interessante. Non è cloud, non è on-prem, è un terzo modello in cui l’autorità decisionale dell’agente è separata dall’autorità esecutiva. Anthropic decide come ragiona. Tu decidi cosa può toccare. La superficie di contatto fra i due livelli è codificata in due primitive ben definite, il sandbox e il tunnel.

Cambia anche il modo di comprarla

In Pelle Digitale avevo provato a descrivere come la mediazione tra noi e le macchine stesse cambiando forma. Quello che vedo qui è una variante infrastrutturale dello stesso fenomeno. La pelle non è più solo l’interfaccia in cui parliamo col modello. È anche la membrana tecnica che decide cosa passa e cosa no, cosa esce dall’azienda e cosa rientra, cosa il modello può sapere e cosa no. La progettano gli ingegneri di Anthropic disegnando le primitive del sistema. La progettiamo noi configurando policy, tunnel, sandbox.

Chi sta portando agenti AI in produzione dentro un’azienda strutturata, con questa architettura, deve mettere in conto tre cose che fino a ieri non c’erano.

Sul piano contrattuale e legale il discorso “i miei dati attraversano i server del fornitore” diventa meno semplice da fare, perché in molti scenari non è più vero. Tool execution e dati restano dentro, l’agente fuori vede solo quello che il sandbox gli restituisce. Vanno aggiornati i template di DPIA, le clausole nei contratti con i fornitori, le policy di data residency.

Sul piano organizzativo bisogna decidere chi gestisce un agente AI con questa architettura. Lo sviluppo software perché esegue codice. L’infrastruttura perché ospita sandbox e gateway. Il security perché definisce le policy del perimetro. Il data team perché decide quali sistemi interni esporre via MCP. Sono quattro funzioni che fino a ieri non lavoravano insieme su questo tipo di progetti, e bisognerà costruire workflow nuovi per farle convivere.

Sul piano strategico, Anthropic dichiara con queste mosse di voler diventare l’infrastruttura di default per gli agenti enterprise. Non un fornitore di modelli sotto, ma un layer di orchestrazione che si integra dentro le aziende mantenendo i confini tecnici e di sicurezza che le aziende vogliono. Per chi compra è una scelta strategica diversa rispetto a scegliere un fornitore di LLM più una soluzione di agentic framework messa su a parte. Per chi vende prodotti AI on top, conviene capire dove si posiziona la propria offerta rispetto a questo stack che si sta consolidando.

Il debug a cavallo del confine

C’è una cosa che la documentazione di Anthropic non risolve, e che secondo me sarà il punto di osservazione più interessante nei prossimi mesi. Quando l’agent loop sta fuori e i tool girano dentro, il debugging di un comportamento anomalo dell’agente diventa un esercizio distribuito. Il log dell’orchestrazione lo vede Anthropic. Il log dell’esecuzione lo vedi tu. La correlazione fra una decisione presa dal modello e un’azione fatta sul tuo sandbox passa attraverso due piani di osservabilità separati. Per capire perché un agente ha cancellato un file di troppo, serviranno entrambi.

Vedere come si organizza questa osservabilità a cavallo del confine sarà uno degli indicatori migliori per capire se il pattern decolla davvero, o se resta confinato ai casi d’uso più semplici. La promessa tecnica c’è, la direzione mi sembra giusta. Resta da vedere quanto in fretta le aziende, anche quelle non super-tech, riusciranno ad attrezzarsi per giocare a questo gioco con la maturità che richiede.


Articolo di riferimento: New in Claude Managed Agents: self-hosted sandboxes and MCP tunnels, Anthropic, 19 maggio 2026.

HTML batte Markdown: cosa cambia quando l’output dell’AI smette di essere un testo

Il 20 maggio Thariq Shihipar, membro del team Claude Code di Anthropic, ha pubblicato un articolo dal titolo curioso, The unreasonable effectiveness of HTML, in cui spiega perché lui e altri colleghi hanno smesso di chiedere a Claude di produrre file in Markdown e hanno cominciato a chiedergli, invece, file in HTML. È un articolo che a una prima lettura sembra una scelta di formato, una preferenza personale tra due linguaggi di markup, e a una seconda lettura diventa qualcosa di molto più grande, perché tocca la domanda che mi gira in testa da quando ho iniziato a lavorare seriamente con questi modelli: quale forma deve avere ciò che l’AI ci restituisce, ora che ci restituisce sempre di più?

La tesi di Shihipar è semplice. Markdown è nato per essere leggibile umanamente in formato grezzo, scritto a mano da un developer, editato in un editor di testo, convertito poi in HTML per la lettura finale. Era un compromesso tra leggibilità della sorgente e formattazione del risultato. Ma quando la sorgente non la scrive più una persona, quando la scrive un modello che produce in pochi secondi migliaia di righe, il compromesso non ha più ragione di esistere, perché la sorgente nessuno la legge davvero. Si legge il risultato. E allora tanto vale generare direttamente l’output finale, già navigabile e già pronto a essere condiviso.

Cosa Markdown lascia fuori

Shihipar elenca i limiti pratici di Markdown in modo molto concreto, quasi domestico. I file più lunghi di cento righe non li legge più nessuno, neanche lui che li ha chiesti. Le immagini, i grafici, le tabelle complesse, le animazioni, i widget interattivi non ci stanno dentro. I diff, i flowchart, i mockup, le annotazioni a margine non ci stanno dentro. Per ovviare, Claude finisce per fare cose buffe come disegnare diagrammi in ASCII art o approssimare i colori con caratteri unicode. Stupendo come tentativo, evidentemente insufficiente come soluzione.

HTML, scrive Shihipar, può rappresentare praticamente qualsiasi tipo di informazione che il modello sappia produrre: dati tabellari, design via CSS, illustrazioni via SVG, interazioni via JavaScript, layout responsive che si adattano al mobile, posizionamento spaziale assoluto. Si scrive una volta, si apre nel browser, si condivide con un link. Una persona del team che riceve un report in HTML lo legge davvero, un report in Markdown da 200 righe finisce in un thread Slack ignorato.

C’è poi il punto che a me interessa di più, quello che Shihipar chiama two-way interactions. L’HTML non è solo un contenitore, può ospitare slider, knob, form, bottoni che restituiscono parametri da copiare e incollare di nuovo in Claude Code. L’output del modello smette di essere un blocco di testo da leggere e diventa uno strumento monouso da usare, da manipolare, da modificare. Una cosa che si fa, non una cosa che si guarda.

Software che si butta via

C’è una sezione dell’articolo che ho riletto tre volte, quella sui custom editing interfaces. Shihipar racconta di chiedere a Claude di costruirgli un editor HTML ad hoc per riordinare trenta ticket di Linear in colonne Now/Next/Later/Cut, con tanto di drag-and-drop e bottone copy as Markdown finale. Non un’app vera. Non un tool riusabile. Un singolo file HTML, fatto per quel preciso problema, da buttare via dopo. Un altro esempio: tunare un system prompt vedendo in tempo reale come tre input campione riempiono il template. Un altro ancora: un form-based editor per i feature flag con warning sulle dipendenze.

Qui sta avvenendo qualcosa che fino a due anni fa avrebbe richiesto un team di prodotto, un designer, almeno una settimana di sviluppo. Adesso lo chiedi, esce in trenta secondi, lo usi una volta, lo chiudi. È software usa-e-getta. Una categoria nuova, che non va confusa con una versione povera del software vero, perché si forma e si dissolve attorno al singolo problema, senza overhead di mantenimento e senza utenti oltre chi l’ha richiesto.

In Pelle Digitale ragionavo sul fatto che lo strato di mediazione tra noi e le macchine si stesse facendo più sottile, più aderente, più reattivo, fino a perdere i propri confini visibili. Lì pensavo a interfacce conversazionali, ad agenti, a wearable. Non avevo previsto questo, ovvero che lo strato di mediazione potesse diventare effimero, che ogni interazione potesse generarsi la propria interfaccia su misura e poi dissolverla. La pelle, in questa accezione, è anche questo: una superficie che si forma quando serve, esattamente come la chiediamo, e che non ha più bisogno di esistere quando non serve più.

Un milione di token cambia le abitudini

C’è un dato tecnico che Shihipar tratta come un dettaglio e che secondo me è il cuore della questione. Markdown spesso usa meno token di HTML, dice, ma con la finestra di contesto da un milione di token di Opus 4.7 la differenza è ormai trascurabile. Quindi tanto vale chiedere al modello di produrre l’output più espressivo possibile, perché tanto la spesa marginale è prossima allo zero.

Questo va letto bene, perché segna una soglia. Per anni la conversazione sull’AI generativa è stata tirata da due forze opposte: da una parte la spinta verso output più ricchi e contestualizzati, dall’altra il vincolo dei costi di inferenza e della lunghezza del contesto. Adesso la seconda forza si sta indebolendo, e quando un vincolo cade, le abitudini che si erano formate attorno a quel vincolo iniziano a sembrare assurde. Markdown era una di queste abitudini. Era buona quando i contesti erano corti e i token costavano. Lo è meno adesso che possiamo permetterci di chiedere al modello di costruire una pagina HTML completa con SVG vettoriali, animazioni CSS e logica JavaScript embedded, e di farlo in tempi e con costi accettabili.

La conseguenza, secondo me, è che il modo in cui consumiamo l’output dei modelli sta divergendo dal modo in cui scriviamo l’input. L’input resta testo, anzi resta sempre più conversazionale e disordinato. L’output, invece, si fa multiforme: pagine interattive che fungono da dashboard, diagrammi navigabili, oggetti da manipolare con le mani. Si rompe la simmetria. E quando si rompe la simmetria tra ingresso e uscita di un sistema, di solito è il segnale che la categoria che li conteneva entrambi, in questo caso “la chat con il modello”, sta diventando troppo stretta.

“Ho smesso quasi del tutto di usare Markdown”

Mi ha colpito una frase che Shihipar lascia cadere quasi senza enfasi: “ho smesso quasi del tutto di usare Markdown”. Una persona che lavora dentro Anthropic, dentro il team che costruisce Claude Code, dice che il formato di scambio più diffuso degli ultimi quindici anni tra umani e macchine non gli serve più. Va presa come quello che è, una testimonianza dal centro della trasformazione, non come una previsione di mercato. Però è interessante.

L’argomento più forte che porta riguarda il piano cognitivo, prima ancora del piano tecnico. Dice che con HTML si sente più “in the loop” rispetto al lavoro del modello. Quando Claude diventa sempre più capace e gli affidi compiti sempre più grandi, il rischio di perdere il controllo, di firmare in bianco quello che ha prodotto, diventa serio. Markdown lungo e denso favoriva la firma in bianco, perché era troppo faticoso da leggere. HTML, organizzato visivamente, con tab e ancore, con diagrammi al posto delle descrizioni testuali, riporta dentro il loop la persona che ha delegato il lavoro.

Questo è un punto che merita di essere ascoltato anche fuori dal contesto Claude Code. Tutta la conversazione sull’AI agentica, sui modelli che agiscono autonomamente, sui workflow automatizzati, gira attorno alla stessa tensione: quanto vuoi delegare, quanto vuoi vedere, dove vuoi essere consultato. Il formato di output non è un dettaglio cosmetico in questa tensione, ne è uno degli assi principali. Se l’output è leggibile e navigabile in venti secondi, resti dentro. Se è impenetrabile, scivoli fuori, e prima o poi smetterai di controllarlo.

Dove stiamo andando

Provo a tirare due fili. Il primo: gli output dei modelli non sono più documenti, sono interfacce. Smettono di essere artefatti statici da leggere e diventano superfici da usare, monouso, generate al momento, costruite attorno al singolo task. Il secondo: la finestra di contesto larga libera il modello dalla costrizione di essere economico nel formato, e questo cambia il tipo di artefatto che ha senso produrre. Messi insieme i due fili, il quadro è che la produzione di software piccolo ed effimero, cucito attorno al singolo task, diventa una commodity, e questo ridisegna sia come usiamo Claude sia come pensiamo al lavoro intellettuale che gli affidiamo.

In Spatial Shift parlavo di come la frontiera dell’interazione si stia spostando dal piano del testo verso lo spazio, il gesto, l’ambiente. Quella che Shihipar descrive è una variante interessante di questo spostamento, perché non avviene nel mondo fisico, avviene dentro al browser, ma con le stesse caratteristiche: lo strumento si materializza attorno al compito, dura il tempo del compito, scompare. Non c’è installazione, non c’è apprendimento, non c’è curva di adozione. C’è solo la cosa da fare, e attorno a quella la cosa giusta per farla.

Senza dubbio è un cambio di abitudine piccolo, quasi invisibile, scegliere HTML invece di Markdown quando chiedi a un agente di produrre un report. Quanti di noi, fra sei mesi, staremo ancora chiedendo file di testo a Claude quando potremmo chiedergli pagine interattive che facciano una cosa sola, esattamente quella che ci serve, e poi le butteremo via?


Articolo di riferimento: Thariq Shihipar, Using Claude Code: The unreasonable effectiveness of HTML, claude.com/blog, 20 maggio 2026.

Leggi anche: il design generativo AI-native di Anthropic

World model & LeCun: il nuovo strato dove l’intelligenza incontra il mondo

In alcuni casi, un grafico, nell’appendice di un paper appena uscito, dice più di tutto il paper se lo guardi con attenzione. È un grafico semplice. Mostra come, nel corso dell’addestramento di una rete neurale che impara a prevedere il futuro a partire da pixel grezzi, le traiettorie nello spazio interno del modello si “raddrizzino” progressivamente. Iniziano curve e complicate come la realtà che descrivono, e finiscono quasi rettilinee. Nessuno ha detto al modello di farlo, nessuna funzione di perdita lo chiede esplicitamente. Eppure il modello, lasciato libero di scoprire una rappresentazione utile per prevedere, sceglie la stessa cosa che il cervello dei mammiferi fa quando guarda un video, secondo l’ipotesi del “perceptual straightening” di Olivier Hénaff e colleghi: linearizzare il tempo, in modo che il prossimo istante sia letteralmente una linea retta a partire dall’istante presente.

Quel grafico non sembra molto. Eppure è una piccola crepa attraverso cui si vede una cosa più grande. L’idea che esista una geometria naturale dell’esperienza, una forma “giusta” in cui collassare il mondo per poterlo prevedere, e che reti artificiali e cervelli biologici, partendo da approcci radicalmente diversi, vi convergano. Il paper si chiama LeWorldModel, ed è firmato da Lucas Maes, Quentin Le Lidec, Damien Scieur, Yann LeCun e Randall Balestriero. Tecnicamente è un risultato di ingegneria stupefacente: un modello di 15 milioni di parametri, addestrabile su una sola GPU in poche ore, che impara la fisica intuitiva di ambienti simulati direttamente da pixel grezzi, senza supervisione, senza ricompense, senza encoder pre-addestrati. Pianifica in meno di un secondo dove i suoi predecessori impiegavano 47.

Ma ciò che il paper dice esplicitamente è solo la prima metà della storia. La seconda, quella più interessante, è in ciò che mostra senza dichiararlo, e in dove ci sta portando questa direzione di ricerca quando la guardiamo con occhi che non sono quelli della sola comunità tecnica.

Quando una GPU basta a fare ricerca di frontiera

Per anni la narrazione dominante è stata che l’intelligenza artificiale di frontiera richieda scale crescenti di calcolo e di capitale, oltre a un consumo energetico in continua espansione. Chi non possiede datacenter da gigawatt resta a guardare. Una scuola di pensiero, fatta di realismo industriale, sosteneva che l’AGI sarebbe arrivata dal lato del molto grande. Un’altra, meno udibile nel rumore di fondo, sosteneva che il problema centrale non era la scala ma la struttura, e che modelli architetturalmente meglio pensati avrebbero potuto raggiungere capacità importanti con risorse modeste.

LeWorldModel è uno dei segnali che la seconda scuola comincia a portare risultati concreti. Quindici milioni di parametri sono cinque ordini di grandezza in meno rispetto ai modelli linguistici di frontiera. Una singola GPU L40S costa qualche migliaio di euro, è alla portata di un piccolo laboratorio universitario, di un team di ricerca indipendente, persino di un appassionato motivato. E con quella GPU, in poche ore, si addestra un modello che pianifica azioni di un braccio robotico con successo nel 96% dei casi. Non è poco, e non è solo una curiosità accademica.

Vale la pena soffermarsi su una conseguenza epistemica meno ovvia. Quando la ricerca di frontiera in un dominio diventa accessibile a chi non controlla infrastrutture colossali, la composizione di chi può contribuire cambia. Le università tornano in gioco. Le startup possono permettersi di partire dalla ricerca, non solo dal product-market fit. I ricercatori indipendenti possono replicare e modificare gli esperimenti, e da lì migliorarli. È successo nei primi anni del deep learning, prima che il costo del training delle reti di scala salissi al cielo. È successo nel software open source. Ed è il presupposto perché una tecnologia entri davvero nella cultura, anziché restare proprietà di pochi soggetti dotati di risorse fuori scala.

L’efficienza non è solo un dato di prestazione, ha conseguenze politiche. Decide chi può pensare la prossima generazione di una tecnologia. Il fatto che LeCun e il suo team abbiano deliberatamente progettato un modello “fattibile su una GPU sola”, e abbiano rilasciato codice e pesi su GitHub, dice qualcosa sulla scuola di pensiero da cui questo lavoro proviene. Non parliamo di ricerca da torre d’avorio, parliamo di ricerca pensata per essere distribuita.

Cosa significa “non collassare”, filosoficamente

Il problema centrale che il paper risolve si chiama “rappresentazione collassata”. Quando una rete neurale impara a prevedere il futuro da una rappresentazione compatta di sé stessa, c’è una scorciatoia che la tenta sempre: mappare tutti gli input sullo stesso vettore costante. In quel modo la previsione è banalmente corretta, perché tutto è uguale a tutto. Il modello tecnicamente funziona, ma ha smesso di codificare informazione. Ha trovato il punto di equilibrio termodinamico minimo della propria esistenza percettiva: non distinguere più nulla.

In questo fenomeno c’è qualcosa di filosoficamente inquietante, perché ricorda da vicino certe deformazioni dell’esperienza umana. La depressione clinica è stata descritta da alcuni neuroscienziati cognitivi come uno stato in cui le rappresentazioni interne smettono di differenziarsi: tutto sembra uguale, tutto perde salienza, il futuro coincide con il presente perché niente più cambia. La routine eccessiva, l’iper-prevedibilità degli ambienti digitali algoritmicamente personalizzati, una certa apatia che attraversa epoche di sovrabbondanza informativa: sono tutte forme di “collasso rappresentazionale” della coscienza umana, viste da questa angolazione.

La soluzione che LeWorldModel propone è semplice e bellissima. Si chiama SIGReg, e in sostanza forza le rappresentazioni interne del modello a distribuirsi come una gaussiana isotropa nello spazio latente, ovvero a occupare lo spazio in modo “ben formato”, senza concentrarsi in un punto, senza appiattirsi su una direzione. Matematicamente garantisce che il collasso sia impossibile, perché un vettore costante non può essere una distribuzione gaussiana. Filosoficamente è qualcosa di più: è l’imposizione di una varietà strutturale come condizione di possibilità della percezione. Vedere è anche distinguere, distinguere richiede di occupare lo spazio delle differenze in modo articolato. Una mente che non differenzia non vede.


Si sente un’eco interessante con il modo in cui pensiamo la salute cognitiva umana. Le esperienze che ci tengono “rappresentazionalmente vivi” sono quelle che ci espongono a varietà non triviale: viaggi reali (non turismo da fotocopia), conversazioni con persone diverse da noi, lavoro su problemi nuovi, contatto con realtà materiali che non possiamo prevedere. Quando ci appiattiamo su routine senza variazione, quando lasciamo che algoritmi ci servano sempre lo stesso tipo di contenuto, stiamo addestrando noi stessi al collasso. Una macchina ha bisogno di SIGReg per restare percettivamente viva. A noi serve qualcosa di analogo, e probabilmente passa anche dalle cose vecchio stile: leggere libri non scelti dall’algoritmo, fare conversazioni faccia a faccia, riappropriarsi del proprio corpo come strumento di esplorazione del mondo.

Le traiettorie che si raddrizzano da sole

Torniamo al grafico dell’appendice, quello che mi è rimasto in testa. Lo straightening temporale: il fenomeno per cui, durante l’addestramento, le traiettorie del modello nello spazio latente diventano sempre più rettilinee. È stato descritto nel 2019 da Hénaff e colleghi come ipotesi su come il sistema visivo dei mammiferi rappresenti il tempo: invece di mantenere la complessità geometrica del flusso ottico, il cervello “raddrizzerebbe” le traiettorie nello spazio neurale, rendendo la prossima posizione una semplice estrapolazione lineare di quella corrente.

Quello che gli autori di LeWorldModel hanno osservato è che il loro modello fa esattamente la stessa cosa, in modo emergente. Nessuna funzione di perdita lo richiede. Nessun termine di regolarizzazione lo premia. Eppure, mentre il modello impara a prevedere il prossimo embedding a partire dall’embedding corrente e dall’azione, la sua geometria interna si raddrizza spontaneamente. È come se la rete avesse “capito” che la cosa più semplice da prevedere è una linea retta, e abbia riorganizzato il proprio mondo interiore di conseguenza.

Questa convergenza tra biologico e artificiale è profondamente non banale. Significa che esiste una pressione strutturale dentro l’apprendimento predittivo, indipendente dal substrato biologico o artificiale, che spinge le rappresentazioni a organizzarsi in forme geometriche specifiche. Non è solo “il cervello e la rete neurale fanno la stessa cosa”. È più forte: è “la previsione del futuro, come compito formale, ha una geometria preferita”. Reti biologiche e artificiali la scoprono per ragioni computazionali, non per imitazione reciproca.

Se è vero, e per ora abbiamo indizi forti più che prove definitive, allora la convergenza tra intelligenze biologiche e artificiali potrebbe essere meno questione di “ingegnerizzare la biologia” e più questione di “lasciare che le strutture computazionali ottimali emergano da sole”. Le reti artificiali ben progettate, sottoposte a compiti analoghi a quelli che il cervello affronta, tenderanno a riscoprire le stesse soluzioni. Non perché copino, ma perché la matematica del problema le incanala lì.

Questa è un’ipotesi che cambia il modo in cui ragiono sulla questione “macchine come noi”. L’allineamento profondo tra AI e cognizione umana potrebbe non essere il risultato di uno sforzo deliberato di antropomorfizzare le reti, ma un attrattore naturale verso cui sistemi predittivi efficienti convergono, qualunque sia il loro substrato. Sarebbe una buona notizia per la sicurezza, una pessima notizia per chi pensava che il digitale potesse evolvere in qualcosa di radicalmente alieno. La nostra intelligenza e quella delle macchine vivono nello stesso paesaggio geometrico, perché il paesaggio lo definisce il compito, non il substrato.

Una geometria naturale per le rappresentazioni

Il paper mostra senza enfatizzarla un’altra cosa che vale la pena tirare fuori. Quando il modello viene sottoposto a perturbazioni durante un episodio, gli autori distinguono due tipi: perturbazioni visive (un oggetto cambia colore di colpo) e perturbazioni fisiche (un oggetto viene teletrasportato in una posizione casuale, violando la continuità). Misurano poi la “sorpresa” del modello, ovvero quanto la sua previsione si discosta dall’osservazione reale, e confrontano le due condizioni.

Il risultato è che il modello reagisce poco al cambio di colore e tantissimo al teletrasporto. Statisticamente significativo, p minore di 0,01 sulla differenza tra le due condizioni. È un dato apparentemente piccolo, ma porta un’informazione enorme: il sistema ha sviluppato una gerarchia ontologica, sa che cambiare colore a un oggetto è un evento di superficie, mentre violare la continuità spaziale è un evento di sostanza. Il modello distingue la sostanza dall’apparenza senza che nessuno glielo abbia insegnato.

È una distinzione che la filosofia occidentale dibatte da Aristotele in poi: la domanda su quali proprietà di un oggetto siano essenziali e quali accidentali, su cosa faccia di una cosa “quella cosa” e non un’altra. La risposta che oggi arriva dalle reti predittive sembra essere questa: ciò che, se cambiato, rompe la previsione del futuro è essenziale, ciò che può cambiare senza disturbare la dinamica è accidentale. È una risposta funzionale, non metafisica, e proprio per questo è interessante. Risuona con certe intuizioni della fenomenologia: la sostanza di un oggetto è il suo modo di stare nelle nostre attese di esperienza, non una qualità nascosta dietro l’apparenza.

La macchina che impara a prevedere il futuro impara, lungo la strada, anche una forma rudimentale di ontologia. Sa cosa “conta” e cosa “non conta”. È capace di sorpresa selettiva, ovvero di sorprendersi solo quando vale la pena sorprendersi. Questo, in psicologia cognitiva, è la base dell’attenzione e della memoria semantica: non possiamo ricordare tutto, dobbiamo decidere cosa è rilevante, e la rilevanza emerge dalla struttura predittiva delle aspettative. Una macchina che ha imparato a sorprendersi solo per le perturbazioni fisiche ha imparato un proto-cogito.

Grafico dello straightening temporale delle traiettorie nello spazio latente di LeWorldModel

Il modello che distingue la sostanza dall’apparenza

Una seconda osservazione, che il paper fa quasi en passant, merita di essere tirata fuori. Nell’ambiente OGBench-Cube, una scena 3D in cui un braccio robotico manipola un cubo, il modello riesce a prevedere bene la posizione del cubo e dell’end-effector, ma fa più fatica con l’orientamento rotazionale del braccio. In termini quantitativi, le metriche di probing sulle posizioni traslazionali sono ottime, quelle sulle rotazioni del polso del robot peggiorano sensibilmente.

L’indicazione è che il modello, nel comprimere il mondo in 192 dimensioni di spazio latente, ha dovuto scegliere cosa preservare e cosa lasciare cadere. Ha scelto di tenere le posizioni, perché sono più rilevanti per prevedere conseguenze (dove finirà il cubo è quasi tutto), e ha sacrificato i dettagli rotazionali fini. Parliamo di selezione percettiva, più che di limitazione tecnica. Il modello sviluppa una forma di attenzione strutturale: privilegia ciò che è macroscopicamente rilevante e ignora ciò che è microscopico, persino quando entrambi sono visibili nei dati di training.

Questo solleva una domanda interessante per chi si occupa di interfacce e sistemi cognitivi. Quanto della nostra esperienza visiva quotidiana è effettivamente codificato nel nostro spazio latente cerebrale, e quanto invece viene scartato perché non utile alla previsione? Le neuroscienze cognitive lo sanno da anni: la nostra visione è molto meno completa di quanto crediamo, il cervello ricostruisce e inferisce in continuazione, scartando i dettagli che non servono. La fovea vede ad alta risoluzione un’area minuscola, il resto è completamento. Eppure soggettivamente ci sembra di vedere tutto.

LeWorldModel, in piccolo, ci fa toccare con mano lo stesso fenomeno. Una mente predittiva, biologica o artificiale, comprime per essere efficiente, e nella compressione decide cosa fa parte della “realtà rappresentata” e cosa è rumore. La realtà smette di essere una proprietà oggettiva del mondo, diventa il sottoinsieme di esso che vale la pena prevedere. Questa è una conclusione filosofica antica, che torna oggi sotto forma di una proprietà misurabile di una rete neurale di 15 milioni di parametri.

Schema della gerarchia ontologica appresa dal modello: perturbazioni visive vs perturbazioni fisiche

L’intelligenza che torna nel corpo

Per quasi tutto il primo cinquantennio dell’intelligenza artificiale, la parte “intelligente” si è creduto fosse quella simbolica: ragionare in modo astratto e manipolare concetti, pianificare sequenze di passi mentali. Il corpo, la capacità di muoversi e di percepire, era considerato periferia. Negli ultimi quindici anni il deep learning ha rotto questo paradigma per quanto riguarda la percezione, ma ha lasciato il corpo fuori. I grandi modelli linguistici sono potenti elaboratori simbolici disincarnati, leggono il mondo solo attraverso il filtro dello scritto.

I world model latenti riportano l’AI dentro il mondo fisico. Non lo fanno generando immagini fotorealistiche del futuro, lo fanno costruendo rappresentazioni interne sufficienti a prevedere conseguenze. La differenza è enorme. Un’AI che genera mondi tridimensionali fotorealistici è uno strumento creativo straordinario, ma resta uno spettatore. Un’AI che ha un world model latente è qualcosa di diverso: ha un’idea operativa di come funziona il mondo, può usare quell’idea per agire, e l’agire la mette alla prova continuamente.

Questa transizione, dal mondo come testo al mondo come scena, è il cambiamento più importante che sta avvenendo in questi mesi nell’AI applicata, e probabilmente non sarà raccontato sui giornali per anni. Quando arriveranno i prodotti, ce ne accorgeremo. Saranno robot domestici che ragionano sulle conseguenze prima di agire, droni di consegna che pianificano traiettorie tenendo conto di vento e ostacoli mobili, sistemi di assistenza chirurgica che prevedono come reagirà un tessuto a una pressione. Ognuna di queste applicazioni richiede esattamente quel tipo di intelligenza che LeWorldModel comincia a dimostrare: leggera nel calcolo ma plausibilmente fisica nelle sue previsioni.

Una conseguenza tocca da vicino chi pensa il futuro del lavoro umano. Per un po’ abbiamo creduto che l’AI avrebbe sostituito prima i lavori manuali ripetitivi e poi quelli intellettuali. Si sta vedendo che è successo l’opposto: i mestieri intellettuali ripetitivi sono i primi a essere automatizzati dai LLM, mentre quelli manuali che richiedono comprensione fisica del mondo restano stabilmente umani perché manca la tecnologia di base. I world model sono il pezzo mancante che finalmente comincia ad arrivare. Quando saranno maturi, anche la frontiera del manuale si sposterà. Il valore umano si redistribuirà ancora, e non necessariamente verso ciò che ora pensiamo sia “al sicuro”.

La cosa interessante è che questa transizione non disumanizza, anzi. Riconcilia l’intelligenza con il corpo, dopo decenni di disembodiment cognitivo. Le macchine diventano più simili a noi proprio nel loro modo di abitare il mondo, e questo, almeno per come la vedo, è una buona notizia. Una macchina che capisce la gravità è una macchina con cui possiamo collaborare in modo più trasparente. Una macchina che è solo un grafo simbolico fluttuante nel cloud è opaca per definizione.

Il limite che racconta più del successo

Un risultato del paper, a prima vista, sembra un’imperfezione, e invece secondo me racconta una verità importante. Nell’ambiente Two-Room, il più semplice tra quelli testati, LeWorldModel funziona peggio dei suoi concorrenti. Un agente deve muoversi tra due stanze attraverso una porta, è un problema di navigazione 2D banale. Eppure il modello, che batte tutti nei compiti più complessi, qui perde terreno. Perché?

Gli autori avanzano un’ipotesi che vale la pena prendere sul serio. SIGReg, la regolarizzazione che forza le rappresentazioni a distribuirsi come una gaussiana ad alta dimensionalità, si comporta male quando la complessità intrinseca dell’ambiente è bassa. Se il mondo da rappresentare ha pochissime dimensioni effettive, forzare il modello a occupare uno spazio latente ricco è controproducente. Il modello “sparge” la propria rappresentazione su dimensioni che non gli servono, perdendo focalizzazione.

È un risultato che fa pensare. Suggerisce una proprietà non triviale della cognizione: per fiorire, ha bisogno di una complessità minima dell’esperienza. Una macchina addestrata in un ambiente troppo povero produce rappresentazioni peggiori di una macchina addestrata in un ambiente ricco. Vale per i bambini cresciuti in deprivazione sensoriale, vale per gli animali in cattività con ambienti monotoni, e a quanto pare vale anche per le reti neurali.

La lezione tocca anche il design dei contesti digitali in cui passiamo le nostre giornate. Se la nostra esperienza quotidiana è troppo curata, troppo ottimizzata, troppo “facile”, potremmo stare costruendo il nostro Two-Room: un ambiente cognitivamente povero che impedisce alle nostre rappresentazioni interne di sviluppare la ricchezza necessaria per affrontare problemi complessi. È un’ipotesi, non una certezza. Ma il dato sperimentale è lì, ed è coerente con tanta letteratura di psicologia dello sviluppo.

Le interfacce che amo non semplificano tutto a oltranza, lasciano sopravvivere una giusta dose di attrito, di imprevedibilità, di scoperta. Il difficile in sé non ha valore, però senza un minimo di complessità da affrontare l’intelligenza, biologica o artificiale, si appiattisce.

Diagramma dei due strati dell'intelligenza artificiale: linguistico e fisico, LLM e world model

Verso uno strato spaziale comune

Le tecnologie raramente arrivano da sole. Arrivano in convergenze. I world model latenti come LeWM, i modelli generativi 3D come Marble di World Labs, l’hardware per realtà mista che si è fatto ragionevolmente buono negli ultimi due anni, l’industria della robotica che torna a investire dopo la traversata del deserto, le auto a guida autonoma che cominciano davvero a funzionare in alcune città americane. Sono tutti vettori che spingono nella stessa direzione: un mondo computazionalmente aumentato in cui l’intelligenza non sta più dietro uno schermo, ma è distribuita nello spazio fisico, negli oggetti, negli ambienti, e talvolta sul nostro corpo come pelle aggiuntiva.

LeWorldModel è uno dei mattoni invisibili di questa transizione. Da solo non vediamo che cosa diventerà. Tra cinque anni guarderemo indietro e diremo: ecco, da lì in poi le macchine hanno cominciato davvero a pensare al mondo, non solo alle parole sul mondo. È il passaggio che separa l’AI che descrive dall’AI che agisce, e nei prossimi due o tre anni vedremo emergere i primi prodotti che lo incorporeranno in modo invisibile.

Per chi costruisce prodotti, oggi, il segnale operativo è abbastanza chiaro. Continuare a presidiare i LLM dove servono (testo, codice, ragionamento simbolico), iniziare a presidiare i world model dove cominciano a contare (manipolazione fisica, navigazione, simulazione, predizione di sistemi complessi). Non sono mondi separati, si parleranno tra loro, ma sono filoni tecnici con strumenti, talenti e logiche diverse. Chi crede che basti aspettare un GPT-6 generalista per coprire entrambi, probabilmente sbaglia. Le architetture che funzionano per il testo non funzionano per la fisica intuitiva, e viceversa. Sono due forme di intelligenza che devono convivere.

Per chi si occupa di cultura e di formazione, c’è un tema parallelo. Stiamo entrando in un’epoca in cui le macchine sviluppano forme rudimentali di “buon senso fisico”, e la nostra responsabilità verso le tecnologie cambia di nuovo. Non bastano più gli strumenti per usare il digitale, servono strumenti per comprenderne le rappresentazioni interne, le scelte percettive, le gerarchie ontologiche implicite. Sapere che un’AI distingue la sostanza dall’apparenza diventa informazione utile per chiunque la userà, così come riconoscere il suo bisogno di varietà per sviluppare rappresentazioni ricche cambia il modo in cui chi le addestra prepara i dataset. Una proprietà come lo straightening temporale delle traiettorie interne diventa pertinente anche per chi integra questi modelli in sistemi più grandi.

Sono cose che oggi sembrano da specialisti, e che tra dieci anni faranno parte della cultura generale, come oggi è cultura generale capire grossomodo come funziona un motore di ricerca, anche senza saperne scrivere uno. Le persone che cominciano a capirle adesso saranno quelle che parteciperanno alla conversazione su come queste macchine entreranno nelle vite di tutti, e probabilmente faranno scelte diverse da chi resta nella sola dimensione linguistica.

C’è una scena che immagino spesso, ed è quella di un robot domestico che, dopo aver ricevuto l’istruzione di prendere un bicchiere fragile dal tavolo, si ferma un attimo, “vede” mentalmente cosa succederebbe se lo afferrasse con troppa forza, e modula la presa di conseguenza. Quel “vede mentalmente” non è una metafora, è esattamente la pianificazione in spazio latente che LeWorldModel comincia a fare oggi nei suoi ambienti semplificati. Quando quella stessa capacità sarà nei robot di casa, nei droni di consegna, nei sistemi di assistenza alla guida, avremo macchine che hanno ricominciato a vivere il mondo, dopo decenni in cui l’avevano solo letto.

Il preprint che ho davanti, in fondo, è un pezzo piccolo di una storia molto più grande. La storia di come, in questo decennio, l’intelligenza è tornata a incarnarsi.