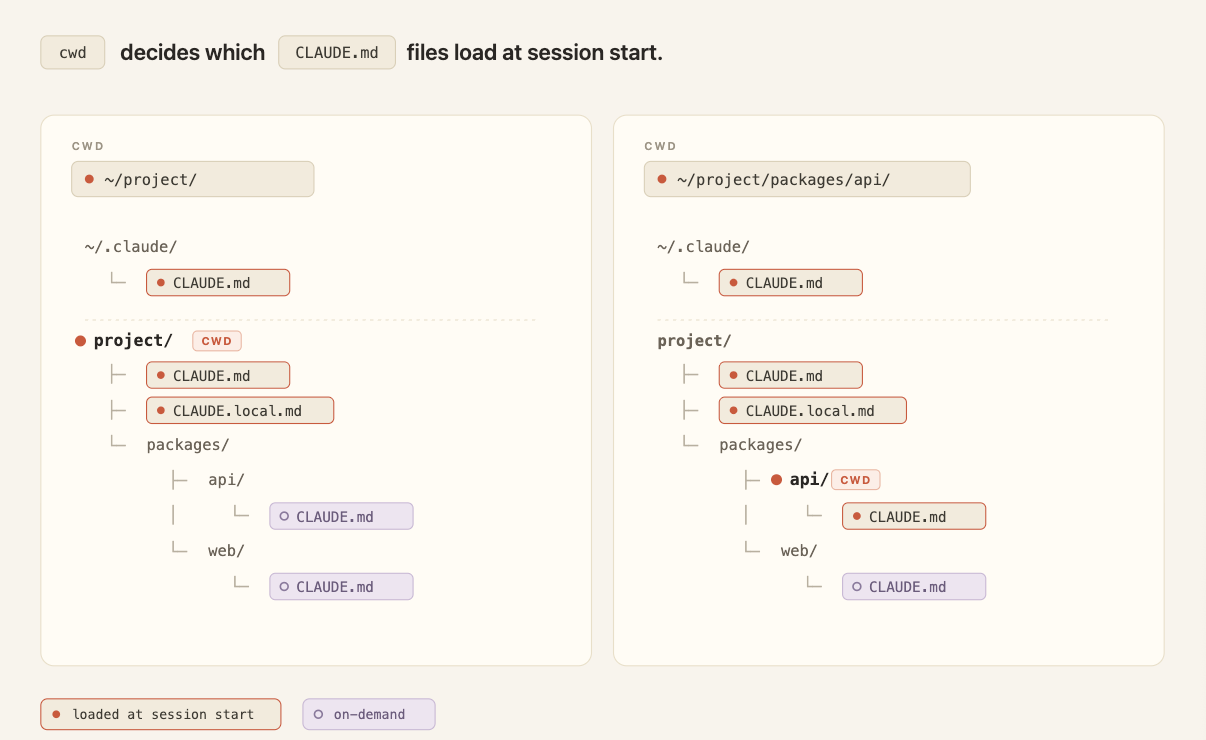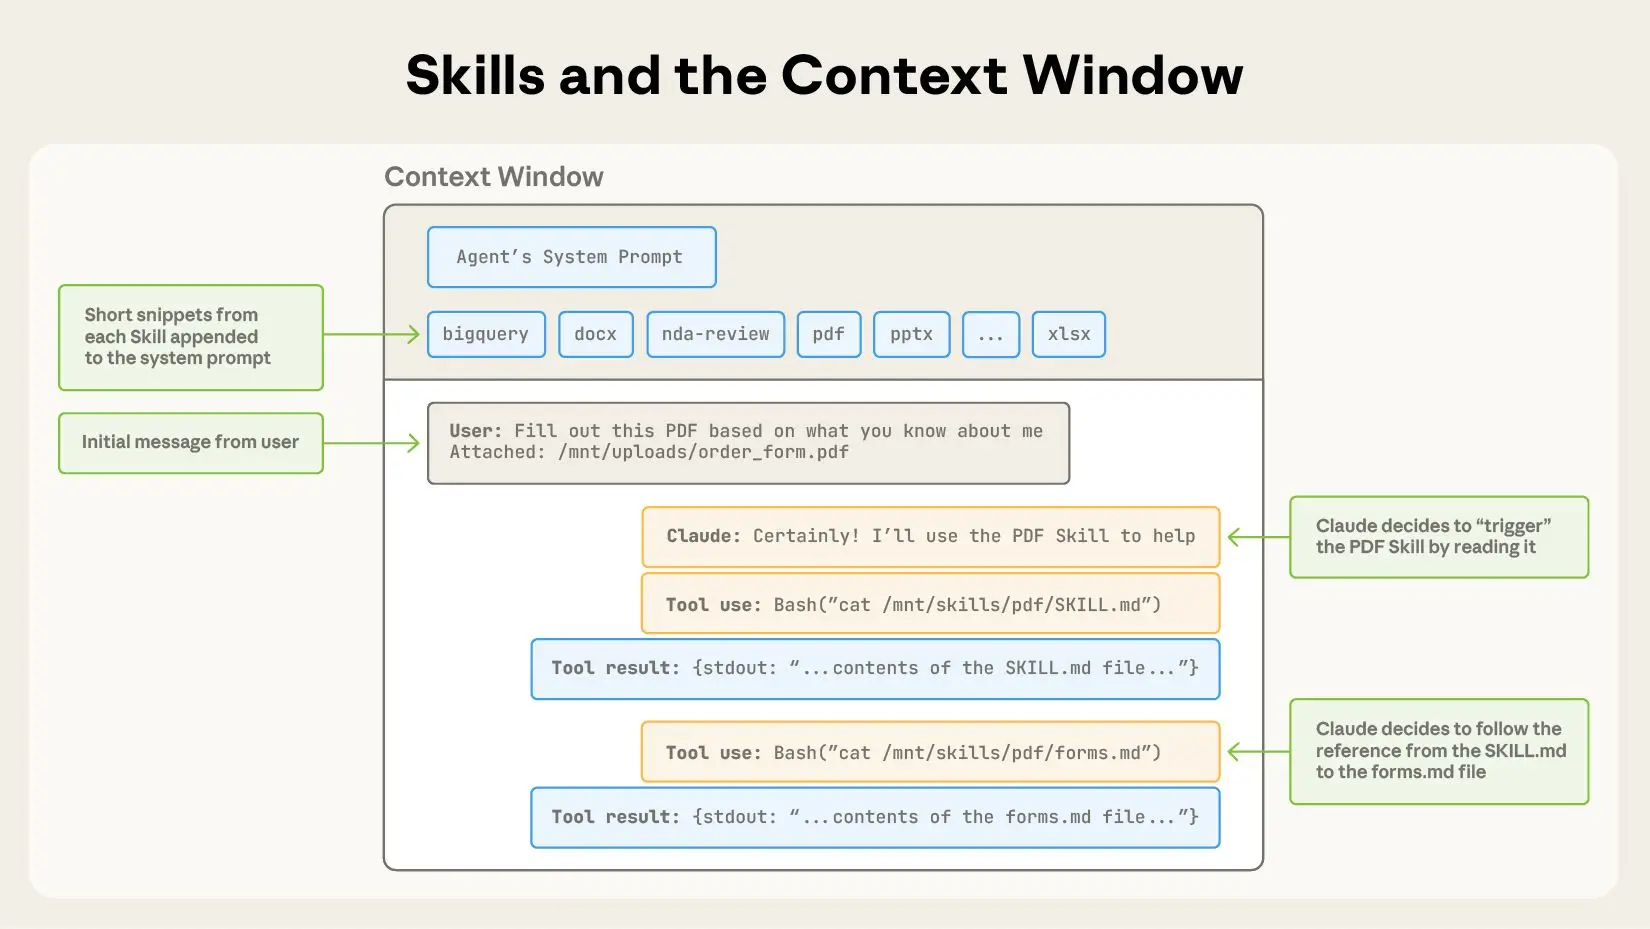
Governare il significato: l’ontologia, l’infrastruttura invisibile dell’AI in azienda

La parola “cliente” significa tre cose diverse allo stesso tavolo. Finché a leggerla siamo noi non è un problema. Quando a leggerla è un agente che decide, lo diventa. È da qui che parte Govern Meaning, il primo degli AI Strategy Papers di ZeroFive, e questa ne è la versione breve.

Prendi la parola “cliente” in una riunione dove siedono vendite, finanza e supporto. Per il commerciale è chiunque abbia lasciato un’email, per la finanza è un’entità fatturata, per il supporto è chi ha diritto ad aprire un ticket. Tre definizioni, una parola sola, e ogni numero costruito su quella parola porta dentro l’ambiguità senza dichiararla.

Finché a leggere quei dati siamo noi, il malinteso si assorbe: aggiustiamo a mente, chiediamo conferma. Il problema nasce quando a leggerli mettiamo una macchina che deve rispondere, decidere, agire. La macchina non aggiusta a mente. Prende la definizione che trova, la applica con sicurezza, e ti restituisce una retention, un’esposizione al rischio, una lista di destinatari, senza sapere che quella definizione ne conteneva altre due dentro.

Ecco perché la parola d’ordine del momento, ontologia, non è una moda da convegno. È la struttura del significato su cui poggia davvero l’AI in azienda, e decide se un sistema ragiona o indovina.

Ancorare il modello: dal plausibile al verificato

Un modello linguistico è straordinario a produrre testo plausibile, e non è progettato per essere corretto. Sono due qualità diverse, e le confondiamo di continuo perché il testo plausibile, quando lo leggiamo, ci sembra corretto.

Un “probabilmente corretto” va benissimo quando suggerisci un film. Non va bene nella manifattura, nell’antifrode, in finanza, in medicina, dove una risposta sbagliata detta con sicurezza costa denaro, conformità, a volte vite. Lì serve un ancoraggio: il modello resta l’ultimo passo, non il primo, e il ragionamento vero avviene prima, sulla struttura. L’ontologia dà il significato, il knowledge graph dà i fatti veri di adesso, e il modello si limita a mettere in linguaggio una risposta già verificata. Vietare che le cuffie diventino impermeabili è un vincolo scritto una volta, non un vezzo, e blocca il fatto invalido prima che il modello parli.

Dopo la qualità del dato viene la struttura

Per vent’anni abbiamo lavorato sulla qualità del dato. Giusto, e non è finito, però il vincolo si è spostato di un gradino. La qualità dice se un’informazione è affidabile, la struttura dice alla macchina cosa quell’informazione significa e come le cose si relazionano. Sono due domande diverse, e il ragionamento vive nella seconda.

L’esempio che uso ai tavoli è il piano dei conti. Nessuna azienda seria lascia decidere per caso cosa è ricavo e cosa è costo: lo custodisce, lo governa, lo difende. Le definizioni delle entità in un grafo, cosa è un cliente, un prodotto, un fornitore, hanno oggi lo stesso peso del piano dei conti, ma su una superficie molto più larga, perché toccano i numeri che riporti, gli obblighi in cui incappi, le persone che un sistema di AI tratterà come bersaglio di una decisione. Il chart of entities è il nuovo chart of accounts.

Governare il significato

Presa sul serio, la parola ontologia porta molto lontano dalla scelta di un prodotto o di un database. Porta in sala del consiglio, perché le decisioni vere riguardano chi possiede le definizioni, e le definizioni vincolano tutto ciò che sta a valle.

C’è un dettaglio che rende il tema urgente adesso. Costruire un grafo è diventato più facile che mai, ma solo un knowledge graph su quattro arriva davvero in produzione, e il collo di bottiglia non è più costruire, è mantenere allineato il significato mentre il business cambia. I modelli semantici non falliscono di colpo, divergono: una definizione cambia in un reparto, nessuno aggiorna il resto, e l’agente continua a rispondere con sicurezza su una logica ormai superata. La divergenza uccide l’adozione dell’AI più in fretta della vecchia BI, perché l’AI non ha il senso critico dell’analista che compensa a valle. Fallisce in silenzio, e il silenzio è la parte pericolosa.

L’ontologia serve, quindi, ma come fonte di verità interna e governata, il resoconto ufficiale di come la tua azienda definisce le proprie cose, non una verità universale. E si comincia sempre dal problema di business, mai dall’eleganza del grafo, con la maturità del dato come primo lavoro, la misurabilità e la governance dal primo giorno, l’umano nel ciclo come default.

Il primo AI Strategy Paper

Questo è il nocciolo. Il paper completo, Govern Meaning, lo affronta per intero: cos’è davvero un’ontologia, l’architettura che ferma le allucinazioni, come costruire riusando gli standard invece di reinventarli, la deriva che uccide i progetti dopo il go-live, e come si porta tutto questo in azienda. Taglio da studio, con le fonti, ma pragmatico e leggibile da chi decide, non solo da chi implementa.

È il primo degli AI Strategy Papers di ZeroFive, una serie che prende una domanda difficile sull’AI e la affronta senza hype. Lo scarichi, in italiano e in inglese, e lasci la mail per i prossimi, nella pagina dedicata:

👉 Scarica Govern Meaning su zerofive.ai/papers

Il grafo latente della tua azienda esiste già, distribuito nelle teste delle persone e nelle giunture tra i sistemi. Il giorno in cui saranno i tuoi agenti a ragionarci sopra, erediteranno le tue definizioni così come sono, coerenti o contraddittorie. Tanto vale sceglierle adesso, mentre a rileggerle ci sono ancora persone capaci di correggerle.
AI bill shock: la bolletta dei token è arrivata, come previsto

Il conto è arrivato, e ha pure un nome. Da mesi, tra le chiamate con i clienti e i pezzi che scrivo, ripeto la stessa cosa: il costo dei token non è un dettaglio da smanettoni, è la prossima voce che finisce sul tavolo del CFO. A marzo lo scrivevo su AI4Business, parlando di governo economico dei token come disciplina ancora da costruire. A maggio, qui sul blog, mettevo per iscritto che sarebbe arrivato sotto forma di budget esplosi a fine mese.

Questa settimana CorCom lo ha chiamato AI bill shock, riprendendo un’analisi di Analysys Mason: la spesa a consumo per modelli generativi, Api e agenti autonomi rende i budget aziendali sempre meno prevedibili, al punto da riportare sul tavolo di molti CIO l’idea di possedere un pezzo della propria infrastruttura invece di affittarla sempre. I numeri sotto contano più del titolo. Il budget è solo la parte più visibile: sotto ci sono i dati, la compliance, il controllo dell’infrastruttura su cui gira la tua azienda.

300 aziende, un balzo del 500%

Tra aprile e maggio circa 300 aziende hanno sollevato la questione dei costi legati ai token durante le chiamate agli investitori sui risultati trimestrali, contro le 93 dello stesso periodo dell’anno precedente. Lo racconta AI4Business citando Paul Roetzer e Mike Kaput del Marketing AI Institute. La Royal Bank of Canada ha visto il proprio consumo di token salire del 500% in sei mesi. Cisco descrive i propri volumi come fuori da ogni norma conosciuta.

Amazon, Walmart, Uber, Cisco e Meta, secondo quanto riportato dal Financial Times e ripreso sempre da AI4Business, hanno già introdotto tetti di spesa o indicazioni più severe su quando vale davvero la pena accendere un modello. Uber ha fissato un tetto di 1.500 dollari al mese per dipendente dopo aver esaurito, già ad aprile, l’intero budget AI previsto per il 2026. Amazon ha spento la classifica interna che misurava quanto i dipendenti usassero l’AI, dopo aver scoperto che alcuni ingegneri facevano girare bot autonomi solo per scalare la graduatoria: è il fenomeno che va sotto il nome di tokenmaxxing, la corsa alla vanità mascherata da adozione.

A Workato, azienda da 1.300 dipendenti, la spesa è aumentata di sette volte in un solo giorno quando Anthropic ha spostato l’azienda su un pricing basato sui token, a maggio. Goldman Sachs Research stima che l’uso degli agenti possa moltiplicare per 24 il consumo di token entro il 2030. E sul mercato aperto dei modelli, secondo i dati di OpenRouter ripresi dal Financial Times, i modelli cinesi hanno già superato quelli americani per consumo di token: quando il prezzo diventa il primo criterio di scelta, a vincere è chi costa meno, non chi segna il punteggio più alto sui benchmark.

Il token non misura il lavoro fatto

Più del volume, a ingannare è la natura della metrica. I fornitori fanno pagare i token di output da due a cinque volte più di quelli di input, perché generare una risposta costa computazionalmente più che leggerla: il modello prevede una parola alla volta, in sequenza, mentre l’input lo processa in un solo passaggio. Due flussi di lavoro che sembrano identici per volume possono avere costi molto diversi a seconda di quanto testo producono rispetto a quanto ne ricevono, e quasi nessuna azienda, quando firma il contratto, ci pensa davvero. Un prompt di 1.500 parole, quasi 2mila token, che produce una sintesi di 600 parole, circa 800 token, costa già un paio di centesimi con un modello come Claude 3.5 Sonnet: sembra nulla, finché non lo moltiplichi per centinaia di richieste al giorno e per ogni team che nel frattempo ha acceso un proprio agente senza dirlo a nessuno.

Gli agenti aggravano la cosa, perché a ogni passaggio ritrasmettono l’intero contesto della conversazione: alla decima fase di un compito, il modello rilegge integralmente le prime nove. AI4Business fa un esempio concreto, quello di un assistente per il servizio clienti che accede a una base di conoscenza di 20mila token: per mille richieste al giorno, genera 20 milioni di token quotidiani solo per rileggere sempre gli stessi dati, circa 60 dollari al giorno spesi prima ancora di rispondere a un cliente vero. Se l’agente si blocca in un loop, o richiama più volte lo stesso strumento, il conto sale prima che qualcuno se ne accorga.

L’AI bill shock non è un problema di cassa

Affidare l’inferenza a un fornitore esterno porta con sé più di un conto a consumo: la sua politica dei prezzi, i suoi limiti di utilizzo, le sue scelte su dove vivono i tuoi dati, la sua libertà di cambiare le regole senza preavviso. Il pricing può cambiare le regole da un mese all’altro, come è successo a Workato quando Anthropic l’ha spostata su un modello a consumo. Un fornitore può introdurre un tetto di utilizzo che scopri solo quando lo tocchi, a metà di una sessione di lavoro, come raccontano diversi utenti citati da AI4Business. Un governo può spegnere l’accesso a un modello, come abbiamo visto succedere quest’anno. E quando arriva un audit di conformità, la domanda su dove sia passato un dato aziendale durante l’inferenza, su quale server, sotto quale giurisdizione, spesso non ha una risposta scritta da nessuna parte.

Bain, in un sondaggio su 951 aziende pubblicato a giugno, trova che quasi il 40% di chi ha misurato i risparmi da AI è rimasto sotto il 10%, contro un obiettivo dichiarato dell’11-20%. Michael Heric, uno degli autori della ricerca, spiega che per molte aziende il business case si ferma alla spesa in token e non arriva mai a contare i costi di data engineering, di governance, di conformità che le girano intorno. Il 90%, nonostante tutto, aumenta comunque il budget per l’anno prossimo, prova che nessuno ha ancora imparato a misurare il ritorno dell’AI con lo stesso rigore con cui ne misura il costo.

LocalAI lavora esattamente in questa direzione: porta l’inferenza dentro il perimetro dell’azienda invece di affittarla ogni mese da qualcun altro. I costi non spariscono: cambia chi li governa. Sai dove vivono i dati, sai quanto costa davvero un carico di lavoro perché lo possiedi, e nessuno può cambiarti il prezzo o il tetto di utilizzo a metà mese.

Dall’opex che non controlli al capex che scegli

Analysys Mason legge lo spostamento come l’ennesimo giro di un ciclo che l’informatica ha già visto: dal mainframe centralizzato ai minicomputer distribuiti, dal PC in rete al cloud che ricentralizza tutto, e ora l’AI che riapre la stessa domanda. Comprare calcolo come servizio o possederne una parte? Per chi ha volumi di inferenza stabili, la risposta pratica passa quasi sempre dall’ibrido: hardware proprio per i compiti che non hanno bisogno di un modello di frontiera, server dedicati o cloud privato per il resto, il cloud pubblico riservato a ciò che lo giustifica davvero.

Il TCO a tre anni tra cloud e on-premise, calcolato sui prezzi reali di Claude, GPT, Gemini e DeepSeek, conferma la stessa cosa: nella maggior parte degli scenari aziendali italiani l’on-premise vince con margine quando i volumi sono prevedibili, mentre il cloud resta la scelta giusta per i picchi occasionali e per chi parte da zero. La maggior parte del traffico di un’azienda, del resto, non ha bisogno del modello più caro: ha bisogno di un sistema che decida bene dove instradarlo. Quella logica di instradamento, non il modello scelto per ultimo, è ciò che decide chi resta padrone della propria infrastruttura.

Decide il board, non il reparto IT

Il sondaggio di Bain lo conferma da un altro lato: le aziende che centrano i risparmi attesi sono quelle che hanno trattato l’accesso ai dati, la governance e il ridisegno dei processi come materia da consiglio di amministrazione, non da reparto IT. Vale lo stesso per il bill shock. Un alert di budget o un tetto di spesa imposto dall’alto sposta il sintomo, non la causa.

La prima domanda, in questi casi, non riguarda mai il modello. Riguarda dove vivono i dati, chi decide quanto vale un’ora di inferenza, cosa succede se domani il fornitore cambia le regole: non cambia molto se l’azienda ha cinquanta o cinquemila dipendenti, cambia solo quanto in fretta un budget fuori controllo diventa un problema di tutti, non solo di chi ha acceso l’ultimo agente.

La bolletta continuerà a salire, per tutti. La differenza, da qui in avanti, la fa chi ha già deciso come governarla e chi la scoprirà solo a budget già bruciato.


Fonti: CorCom su Analysys Mason; AI4Business, “La crisi dei token che spaventa i budget aziendali”; AI4Business, “AI, le aziende frenano”; Bain & Company, Automation and AI Pathfinder Survey 2026.

Lovable: la guida completa al builder AI che trasforma un prompt in un’app

A dicembre 2025 Lovable ha chiuso un round da 330 milioni di dollari a una valutazione di 6,6 miliardi. Diciotto mesi prima era l’app commerciale di un progetto open source che Anton Osika aveva chiamato GPT Engineer. In mezzo ci stanno otto milioni di utenti, più di centomila progetti creati ogni giorno, e oltre metà delle aziende Fortune 500 che la usano in qualche forma. La corsa è vera, e i numeri raccontano una corsa. A me interessa soprattutto il suo rovescio: oggi milioni di persone costruiscono software descrivendolo a parole, e quasi nessuna di loro saprebbe leggere il codice che ne esce.

Questa guida prova a dire cosa fa davvero Lovable, quanto costa, dove regge e dove si rompe, e quando vale la pena affidargli un progetto invece che a una persona. È la prima di tre, perché subito dopo arrivano Bolt e Replit, gli altri due nomi che chiunque incontri quando entra in questo territorio.

Da GPT Engineer a una valutazione da sei miliardi

Nel 2023, a Stoccolma, Osika rilascia GPT Engineer: software open source che usa un modello linguistico per scrivere intere applicazioni da una descrizione. Con Fabian Hedin ne fa una versione commerciale, la GPT Engineer App, e a dicembre 2024 la ribattezza Lovable aprendo l’accesso pubblico. Da lì la traiettoria diventa difficile da raccontare senza sembrare iperbolici.

A luglio 2025 il primo round serio, 200 milioni di Series A guidata da Accel, valutazione 1,8 miliardi. A novembre, sul palco di Slush a Helsinki, Osika annuncia 200 milioni di ricavi ricorrenti annui, il doppio rispetto a quattro mesi prima, quando l’azienda aveva passato i 100 milioni di ARR. Lui stesso lo descrive come la crescita più rapida nella storia del software, più veloce di OpenAI e di Cursor. A dicembre arriva la Series B da 330 milioni guidata da CapitalG e Menlo Ventures, con dentro anche Khosla, Salesforce Ventures e Databricks Ventures, a quei 6,6 miliardi che triplicano la valutazione in cinque mesi.

C’è un dettaglio che dice molto sul personaggio. Osika ha resistito alla pressione di trasferire l’azienda nella Silicon Valley, e attribuisce a quella scelta buona parte del risultato. Lovable resta svedese, con un organico piccolo rispetto ai ricavi, al punto che a marzo 2026 TechCrunch raccontava di 100 milioni di ricavi aggiunti in un solo mese con poco più di centoquaranta persone a libro paga. Tra i clienti compaiono Klarna, Uber, Zendesk. Non tutto è stato lineare: a novembre 2025 l’azienda è finita sotto accusa per non aver versato l’IVA dovuta in Svezia, un episodio che vale la pena tenere a mente quando si valuta la solidità di un fornitore così giovane e così veloce.

Per chi guida la tecnologia in azienda, il punto da registrare è semplice. Lovable ha smesso di essere un giocattolo per smanettoni ed è diventata a tutti gli effetti un fornitore enterprise, con tutto quello che questo comporta in termini di dipendenza, sicurezza e continuità.

Cosa succede quando descrivi l’app che vuoi

Scrivi cosa vuoi costruire, in linguaggio naturale, e Lovable genera un’applicazione full-stack completa. Il frontend esce in React con TypeScript e Tailwind CSS, il backend si appoggia a Supabase per database Postgres e autenticazione, e il tutto viene messo online su un URL pubblico con un clic. Da quel momento iteri conversando: chiedi una modifica, l’app cambia, ti accorgi di un errore, lo segnali, riprovi.

La parte che fa la differenza rispetto ai vecchi strumenti no-code è la portabilità del codice. Lovable mantiene una sincronizzazione bidirezionale con GitHub, quindi il progetto vive in un repository Git reale, e quel codice è tuo. Lo puoi esportare, estendere, far leggere a uno sviluppatore, oppure portarlo via del tutto. Non resti chiuso dentro un ecosistema visuale proprietario, che è esattamente la trappola in cui finivano le generazioni precedenti di costruttori senza codice.

Intorno al nucleo si sono accumulate funzioni che riducono i passaggi. La generazione di immagini è integrata nel builder, da marzo 2026 anche con sfondo trasparente, comoda per icone e illustrazioni di servizio senza uscire verso un altro strumento. C’è una modalità vocale per descrivere le modifiche parlando. E a marzo 2026 Lovable ha allargato il perimetro oltre le app, verso analisi dati, business intelligence, presentazioni e flussi di marketing, segno di un’ambizione che va ben oltre il prototipo.

Quello che cambia, sotto la superficie del prodotto, è chi può costruire. Quando l’interfaccia tra un’intenzione e un software diventa una frase scritta o detta, la barriera tecnica si abbassa di colpo e si sposta altrove. In Pelle Digitale ho provato a descrivere proprio questo, la mediazione tra la mente e gli strumenti che la estendono, e Lovable è uno degli esempi più nitidi di quella mediazione spostata sul linguaggio.

Come si pilota la generazione

Non c’è un solo modo di lavorare a un progetto, ce ne sono diversi, ognuno adatto a un momento. Agent Mode è la modalità autonoma: l’AI esplora il codice da sola, individua e corregge errori in modo proattivo, cerca informazioni sul web e ragiona su più passaggi prima di agire. Plan Mode, che prima si chiamava Chat Mode, è il suo opposto controllato: ragiona, pianifica, risponde a domande e aiuta a fare debug, ma non tocca il codice, ed è il posto giusto dove pensare un progetto prima di lasciarlo costruire.

Poi c’è la mano diretta. Visual Edits permette di cliccare su un elemento dell’interfaccia e cambiarne lo stile senza scrivere un prompt, utile a chi pensa per immagini più che per istruzioni. Dev Mode apre il codice e lo lascia modificare dentro Lovable, per i tecnici che vogliono mettere le mani dove l’AI non arriva. Le modifiche di solo testo e contenuto non consumano crediti, dettaglio che conta più di quanto sembri quando si guarda il conto a fine mese.

Quasi tutto questo è arrivato con Lovable 2.0, la versione che nella primavera del 2025 ha introdotto il lavoro in multiplayer, con workspace condivisi e fino a venti collaboratori, la scansione di sicurezza nel momento della pubblicazione, e la modalità di editing del codice. Da allora il prodotto ha continuato a crescere, ma è quella la base su cui si regge oggi l’esperienza d’uso.

Quanto costa, e quanto costa davvero

Il piano gratuito esiste e si usa, senza carta di credito. Dà cinque crediti al giorno con un tetto mensile intorno ai trenta, progetti pubblici ospitati su dominio lovable.app, branding di Lovable in vista, e nessuna possibilità di acquistare crediti extra o di aprire il codice. Basta per validare un’idea, non per costruirci sopra sul serio.

Il piano Pro parte da 25 dollari al mese, circa 21 con fatturazione annuale, e porta cento crediti mensili, progetti privati, dominio personalizzato, rimozione del branding, accesso al codice e crediti che si accumulano da un mese all’altro se non li usi. Il piano Business sale a 50 dollari al mese e aggiunge quello che serve a un team: SSO, controlli di accesso, fatturazione centralizzata, limiti di credito per singolo utente. Il piano Enterprise va a preventivo e mette sul tavolo SCIM, log di audit, attestazione SOC 2 e supporto dedicato.

Il meccanismo a crediti è semplice nella forma. Ogni interazione con l’AI ne consuma, le operazioni più complesse e quelle in Agent Mode ne consumano di più, le modifiche manuali non ne consumano affatto. Il problema arriva quando si traduce in conto reale. Chi ha spedito davvero un’applicazione lo racconta sempre allo stesso modo: i crediti bruciano più in fretta di quanto il piano lasci immaginare, e la spesa effettiva tende a essere due o tre volte quella nominale. A questo si aggiunge il backend, perché Supabase ha i suoi costi oltre il piano gratuito, a partire da circa 25 dollari al mese quando l’app supera i limiti di database, autenticazione o storage, e si aggiunge il dominio. Un piano da venti diventa facilmente un conto da sessanta o ottanta.

Rispetto a strumenti che chiedono una quota fissa mensile senza contatore a prompt, come Cursor, v0 o Windsurf, il modello a crediti di Lovable è più generoso sul lavoro semplice e meno prevedibile su quello complesso, soprattutto quando il debug si allunga. Nella comunità è emerso un flusso di lavoro che dice molto: si costruisce il settanta o ottanta per cento del progetto in Lovable, dove prototipare è rapido ed economico, poi si esporta su GitHub e si finisce in Cursor. I prezzi cambiano spesso, quindi la pagina ufficiale resta l’unica fonte da verificare prima di decidere, e la trovi su lovable.dev/pricing.

La Row Level Security e i dati usciti da Lovable

A maggio 2025 il ricercatore Matt Palmer documenta una vulnerabilità che diventa CVE-2025-48757. Oltre 170 applicazioni costruite con Lovable avevano il database completamente esposto, senza Row Level Security attiva. I dati raggiungibili comprendevano email e indirizzi di casa, informazioni finanziarie, chiavi API e storici di pagamento. Una sola di quelle app esponeva i dati di tredicimila utenti. Per leggerli non servivano credenziali: bastava la chiave pubblica che sta nel codice del frontend.

La radice tecnica merita di essere capita, perché spiega un’intera categoria di problemi. Supabase espone tutte le tabelle tramite API per impostazione predefinita. La chiave anonima è pubblica, vive nel bundle JavaScript che ogni visitatore può ispezionare. L’unica cosa che impedisce a chiunque di leggere e scrivere il database sono le policy di Row Level Security, e se quelle policy non vengono attivate e configurate a mano, il database è di fatto un’API pubblica aperta a tutti. Il problema non è il codice che Lovable scrive, è quello che non scrive: i controlli di sicurezza che nessuno ha pensato a chiedergli. Un ricercatore l’ha sintetizzato così: l’AI fa quello che le chiedi, non pensa mai a quello che non le hai chiesto.

Non è un caso isolato e non riguarda solo Lovable. Scansioni indipendenti su oltre mille applicazioni costruite con strumenti di vibe coding e appoggiate a Supabase hanno trovato problemi di sicurezza in circa il 98 per cento dei casi, con il 16 per cento di falle critiche, e i campioni includevano anche v0, Bolt e Replit. È un problema di categoria, legato all’architettura client più al modello generativo che a un singolo prodotto. Va detta però anche la parte scomoda per Lovable: secondo un audit successivo, l’autorizzazione interna della stessa piattaforma è rimasta esposta per settimane dopo la segnalazione, il che indebolisce l’argomento secondo cui la responsabilità sarebbe tutta di chi configura male l’app.

Lovable ha risposto con un Security Scan integrato nel momento della pubblicazione per le app collegate a Supabase, e con un Security center che controlla chiavi API esposte, policy RLS, dipendenze datate. È un passo avanti che resta acerbo. Per chi porta la responsabilità della sicurezza in azienda, le regole pratiche sono poche e nette. Niente segreti di produzione dentro gli strumenti di coding AI, che vanno trattati come ambienti non fidati. RLS attiva su ogni progetto, verificata a mano e non chiedendo conferma all’AI che l’ha generata. E una valutazione del rischio fornitore identica a quella che si farebbe per qualunque altro responsabile del trattamento dei dati, con le implicazioni che questo porta su SOC 2 e ISO 27001. Se è il tipo di governance che serve impostare, è esattamente la conversazione che faccio con le aziende prima che un prototipo scivoli silenziosamente in produzione.

Dove si colloca rispetto a Bolt e Replit

Nessuno di questi strumenti è uguale agli altri, e la scelta dipende da chi sei e da cosa devi spedire. Lovable offre l’esperienza più completa appena aperta la scatola, con backend, editing visivo e modalità agente già pronti, ed è la più amica dei designer e di chi non scrive codice. Bolt, costruito sopra StackBlitz, dà più flessibilità tecnica, supporta più framework, lascia editare il codice in modo diretto e gira interamente nel browser, e tende a piacere di più agli sviluppatori. Replit, con il suo Agent, è un ambiente di sviluppo completo che arriva fino alle app mobili native via React Native, quindi quando serve il mobile vero è la risposta più solida. v0 di Vercel genera componenti di interfaccia eccellenti e pubblica in fretta, ma parla a chi conosce già React. Base44 toglie ogni decisione di configurazione ed è la via più rapida per un fondatore senza competenze tecniche.

Su questa mappa entro nel dettaglio nelle prossime due guide del blog, dedicate a Bolt e a Replit, che raccolgo insieme a questa nella sezione AI e GenAI. Qui basta la posizione: Lovable è il punto di riferimento per le app web full-stack con un flusso amichevole, e il confronto si gioca sul resto.

Il primo progetto

Si parte dal piano gratuito, senza carta. La descrizione iniziale conta più di tutto il resto, quindi vale la pena essere precisi su cosa fa l’app, chi la usa e quali sono le schermate principali, invece di affidarsi a una frase generica. Prima di lasciar costruire conviene passare da Plan Mode per ragionare sull’impianto, poi attivare Agent Mode per la generazione vera. Quando servono dati e login si collega Supabase, e a quel punto la regola è una sola: lanciare il Security Scan prima di pubblicare e verificare a mano che la Row Level Security sia attiva, senza fidarsi della conferma dell’AI. Infine si sincronizza il progetto con GitHub, così il codice resta portabile, e si collega un dominio personalizzato. La spesa la si lascia crescere quando si toccano i limiti, non prima.

Dove regge, dove rallenta

Lovable è straordinario per comprimere la distanza tra un’idea e qualcosa di vivo. MVP, prototipi di SaaS, landing page, strumenti interni, portali cliente e dashboard, demo da mettere in mano a qualcuno la settimana stessa: su tutto questo regge benissimo, e mette un fondatore non tecnico o un product manager nella condizione di spedire un prodotto reale senza un team di sviluppo. Dove rallenta è prevedibile. La logica custom complessa richiede più giri, i casi limite vanno chiariti uno per uno, e qualunque applicazione che maneggi dati sensibili o regolati non dovrebbe vedere la luce senza una revisione di sicurezza fatta da chi sa leggere il codice.

Questi strumenti generano un buon punto di partenza, non un sistema finito. Una produzione vera ha ancora bisogno di revisione del codice, di un’architettura pensata, di test e di manutenzione nel tempo, e nessuno di questi passaggi sparisce perché l’app è nata da un prompt. Per chi guida la tecnologia, Lovable è due cose insieme: un modo legittimo per accorciare il ciclo dall’idea al prototipo, e una responsabilità di governance nel momento in cui qualcuno prova a spingere quel prototipo in produzione senza che nessuno lo abbia controllato. Il mestiere di chi sa leggere il codice non scompare, si sposta verso la revisione, la sicurezza, i casi che l’AI non vede.

Senza dubbio questi strumenti diventeranno più sicuri e più capaci. La domanda che resta aperta è un’altra: quando descrivere un’applicazione diventa facile come dirla a parole, chi si prende la responsabilità di quello che quell’applicazione fa nel momento in cui nessuno la sta guardando?


Trasparenza: i link a Lovable nel corpo di questa pagina sono referral. Le valutazioni del pezzo, inclusa la parte sulla sicurezza, restano quelle che avrei scritto senza. I link qui sotto sono diretti.

Riferimenti.

Ufficiali: sito Lovable, documentazione, annuncio Lovable 2.0, piani e prezzi, FAQ sicurezza.

Azienda e finanziamenti: scheda Wikipedia; TechCrunch sulla Series B da 330 milioni a 6,6 miliardi e sui 200 milioni di ARR con la scelta di restare in Europa.

Analisi e recensioni indipendenti: UI Bakery, No Code MBA sui prezzi.

Sicurezza: Superblocks sulla CVE-2025-48757, studio Security Boulevard sulle vulnerabilità nelle app vibe coded.

L’Europa e l’AI di frontiera che non controlla

Il 7 luglio la Commissione europea ha presentato un Action Plan su cybersicurezza e intelligenza artificiale. A firmarlo è Henna Virkkunen, che nella nuova Commissione porta una delega dal nome esplicito, sovranità tecnologica, sicurezza e democrazia, e che ha messo in fila un ragionamento semplice, l’AI sta cambiando il significato stesso della sicurezza informatica e l’Europa deve tenere il passo alle vulnerabilità che le nuove tecnologie si portano dietro. Nelle settimane precedenti, a Bruxelles, si leggeva un fatto molto preciso: un modello di frontiera, il Mythos di Anthropic, aveva mostrato di saper individuare vulnerabilità nascoste nel software, e un governo straniero aveva deciso di limitarne l’accesso a chi non è cittadino americano.

Per anni l’Europa ha scritto regole per un’intelligenza artificiale che non costruisce. Questo piano è il primo documento che lo dice ad alta voce, con parole sue: le capacità di frontiera nascono per lo più fuori dai confini dell’Unione, e la loro disponibilità dipende da processi decisi altrove, spesso poco trasparenti. La cybersicurezza, letta così, non è un problema di adempimento, è un problema di sovranità digitale.

Una capacità di valutazione da costruire

La prima mossa concreta è una capacità europea di valutazione dei modelli, che la Commissione vuole creare nel 2027. Servirà a esaminare i modelli di frontiera prima che arrivino sul mercato, anche dal lato della sicurezza informatica, a sostegno del lavoro dell’AI Office, con criteri pubblici per i valutatori indipendenti che vorranno candidarsi.

Sotto l’annuncio c’è un’ammissione. Oggi l’Europa non riesce a valutare da sola i modelli che pretende di regolare. L’AI Act le ha dato il diritto di chiedere che quei modelli vengano esaminati, questo piano riconosce che le manca il muscolo per farlo in proprio.

Il primo pezzo di quel muscolo arriva prima. ENISA, l’agenzia dell’Unione per la cybersicurezza, e il Centro comune di ricerca costruiranno entro fine 2026 una piattaforma europea sicura per mettere alla prova i modelli in ambienti simulati, portando competenza sull’uso sicuro dell’AI agli operatori dei settori critici, dalla finanza alla sanità, dall’energia ai trasporti fino alla pubblica amministrazione.

Quando a decidere l’accesso è un altro

Qui il piano tocca il nervo scoperto. Le capacità di frontiera, scrive la Commissione, si sviluppano quasi tutte fuori dall’Unione, e chi le vuole usare dipende da processi decisi altrove. Conoscerle e potervi accedere non riguarda soltanto la resilienza informatica, riguarda la sovranità tecnologica di un continente.

L’episodio Mythos serve da promemoria. Un modello capace di trovare falle nascoste diventa un’arma se finisce nelle mani sbagliate, uno strumento di difesa se resta in quelle giuste, però la mano che decide chi può usarlo, in quel caso, stava a Washington e non a Bruxelles. È l’idea del permesso revocabile portata su scala geopolitica: quando il permesso di usare una capacità può essere ritirato da qualcun altro, dall’esterno, la tua sovranità sui processi che quella capacità protegge è presa in prestito.

Somiglia alla competenza presa in prestito di cui scrivevo a proposito del nostro rapporto quotidiano con questi modelli, solo che qui il prestito non tocca una singola persona che smette di saper fare una cosa, tocca la capacità di un’intera economia di difendere le proprie infrastrutture.

Dal codice condiviso alla vulnerabilità che resta scoperta

Il secondo pilastro guarda dentro le organizzazioni. Il piano non chiede di aspettare, chiede di usare da subito le capacità di AI già disponibili, compresi i modelli aperti, per trovare e correggere le vulnerabilità più in fretta di prima, e per reagire quando un attacco è già in corso. Da qui a fine 2026 ENISA pubblicherà linee guida e buone pratiche, e aprirà un progetto pilota sulla resilienza del software libero critico, pensato per accelerare la correzione delle falle con l’aiuto dell’AI.

Il codice aperto, in questo disegno, pesa più di una bandiera ideologica. Resta la sola capacità che un’organizzazione può ispezionare riga per riga e far girare sulle proprie macchine, senza chiedere permesso a nessuno e senza che nessuno la spenga da lontano. La stessa falla che un modello di frontiera straniero potrebbe scovare al posto tuo, oggi, un modello aperto che controlli tu può aiutarti a chiuderla domani.

La difesa prima della norma

C’è un contrasto che vale la pena guardare in faccia. Nelle stesse settimane in cui prepara questo piano, l’Europa rallenta il suo stesso codice: il 29 giugno il Consiglio ha dato il via libera definitivo alla semplificazione dell’AI Act, che sposta in avanti gli obblighi sui sistemi ad alto rischio, al dicembre 2027 per quelli autonomi e all’agosto 2028 per quelli dentro i prodotti.

Frenare la regola e costruire la difesa, allo stesso tempo, sembra una contraddizione e invece è una sola mossa. Il baricentro si sposta da ciò che vietiamo prima a ciò che sappiamo fare adesso, dalla conformità alla capacità. È l’ansia da competitività dei rapporti Draghi e Letta tradotta in atti di governo, e cambia il modo in cui un CIO dovrebbe leggere la politica europea sull’AI.

La lettura solo per adempimento non basta più. Ciò che pesa davvero, sui tavoli dove si decide, è lo stesso metro che vale con gli agenti: la reversibilità, cioè il controllo su runtime, contesto e permessi e la rapidità con cui puoi fermare un processo e riportarlo indietro senza danni.

Sovranità digitale, da iniziare adesso

Il piano, in filigrana, detta anche cosa fare senza aspettare né l’agenzia del 2027 né la sfida europea di fine anno. C’è l’igiene di base da rafforzare e la sicurezza da mettere fin dentro la progettazione, come le regole sulla cybersicurezza già chiedono. Conviene poi iniziare a usare i modelli disponibili, anche quelli aperti, per scovare e chiudere le vulnerabilità e per rispondere quando un attacco è già partito. Merita attenzione, da qui a fine anno, la piattaforma di ENISA per la sperimentazione dei modelli, con le linee guida che arriveranno tra il terzo e il quarto trimestre.

E la dipendenza da un singolo modello di frontiera controllato da un altro Stato va trattata per quello che è, un’esposizione nella catena di fornitura che una decisione presa altrove può accendere o spegnere da un giorno all’altro.

L’occasione, per chi in Europa costruisce sicurezza e AI nello stesso posto, prende una forma concreta. Bruxelles lancerà entro fine 2026 una sfida europea per le soluzioni di cybersicurezza basate sull’AI, e sta studiando con la Banca europea per gli investimenti uno strumento pubblico che finanzi i progetti strategici, la frontiera dell’AI compresa. Attorno a una capacità sovrana, che si possa ispezionare e valutare in casa, si sta formando un mercato.

Il piano costruisce la capacità di valutare i modelli e gli strumenti per difendere le reti, e sono due cose che all’Europa mancano da tempo. Resta però, sui tavoli dove lavoro, una domanda a cui non ho ancora una risposta netta: si può davvero essere sovrani su una capacità che non hai costruito e che non riesci a vedere fino in fondo? Finché la risposta non è chiara, la sovranità digitale somiglia più a un cantiere aperto che a un traguardo raggiunto.


Il documento è l’Action Plan on Cybersecurity and Artificial Intelligence presentato dalla Commissione europea il 7 luglio 2026, con il comunicato integrale della Commissione. La struttura in tre pilastri e le scadenze operative sono ricostruite dal servizio di Agence Europe. Il via libera definitivo alla semplificazione dell’AI Act è del Consiglio dell’UE, 29 giugno 2026.

Chi può ancora dire di no

Sta diventando normale vedere un agente che si mette in moto da solo, magari perché è arrivata una nuova richiesta o perché qualcosa nel lavoro si è bloccato, prende in carico il compito, lo divide in molte parti più piccole e le affida ad altrettanti agenti che procedono in parallelo, ognuno nel suo spazio isolato, mentre lui tiene d’occhio quello che producono e rilancia i pezzi che si inceppano, fino a tornare con una proposta di modifica pronta da rivedere. Ai tavoli dove passo le giornate incontro sempre più persone che lavorano in questo modo, coordinando decine di agenti su progetti veri senza quasi più scrivere codice a mano.

Davanti a una scena del genere la domanda che viene subito è quanto sia autonomo il sistema, e per rispondere si è diffusa l’abitudine di usare una scala che assegna un numero e ti dice quanto sei avanti nel lavorare con l’AI. Quel numero è comodo proprio perché è uno solo, e per un po’ ha funzionato come misura veloce del rischio, ma finisce per nascondere la cosa che conta di più dentro un’impresa cognitiva, e cioè chi, in mezzo a tutto questo, può ancora dire di no e con quanta rapidità riesce a farlo.

Quanto lo lasci andare, quanti ne tieni insieme

La scala più citata è quella proposta da Steve Yegge in «Welcome to Gas Town», costruita su un asse solo che sale dal basso verso l’alto, da quando l’agente si limita a suggerire fino a quando arriva a gestire l’intera baracca per conto suo. Come modo per dire quanta fiducia riponi in un singolo agente funziona ancora bene, ma nel frattempo il lavoro è cambiato e la leva più importante è diventata un’altra, perché conta meno fino a che punto lasci andare un singolo agente e conta molto di più quanti agenti riesci a coordinare nello stesso momento. Sono due cose diverse, e Addy Osmani ha fatto bene a tenerle separate, mettendo su un asse l’autonomia del singolo e sull’altro la capacità di orchestrarne molti, dato che una persona bravissima a far lavorare in sicurezza cinquanta agenti in parallelo può benissimo restare prudente su quanto si fida di ciascuno di loro preso da solo.

Questo spostamento cambia il modo di ragionare sull’autonomia. Non è un livello da raggiungere né una medaglia da esibire mentre si sale di grado, è piuttosto un permesso, e come ogni permesso si concede quando serve e si ritira quando serve. Davanti a un compito, allora, la domanda giusta smette di essere quanto in alto posso spingermi e diventa quanto rischio quel compito è capace di sopportare, e quale prova mi permette di difendere la scelta di lasciarlo correre da solo.

Conta quanto pulito torni indietro

Per capire se un sistema sta lavorando con un’autonomia davvero alta mi appoggio a tre domande che devo a Osmani, e riguardano tutte la possibilità di correggere il tiro: con quanta rapidità mi accorgo se sta sbagliando, con quanta facilità posso annullare quello che ha fatto, e che cosa mi dimostrerebbe invece che sta andando nella direzione giusta. Quando le risposte sono che me ne accorgo tardi, che tornare indietro è complicato e che in fondo mi sto fidando del riassunto, di autonomia alta è rimasto soltanto il nome, e sotto c’è un azzardo con un cruscotto messo lì a rassicurare.

È qui che l’idea del permesso revocabile diventa concreta. La sovranità di un’organizzazione sui propri processi si misura da quanto in fretta riesce a fermarli e a riportare le cose com’erano senza fare danni, molto più che dal numero di agenti che riesce a mettere in moto. Un intervento delicato come la riscrittura del motore dei pagamenti, se è protetto da verifiche serie, da agenti che controllano il lavoro di altri agenti e da un ritorno indietro pulito, può sopportare un’autonomia molto più alta di un compito che tocca dei contenuti senza avere una fonte certa con cui confrontarsi. Il livello di autonomia dipende dal processo di verifica che gli abbiamo costruito attorno, molto più che dal nome che diamo al compito.

Il debito nascosto nel riassunto

Man mano che l’agente si prende carico di compiti ben delimitati, la verifica smette di passare dai tuoi occhi e si sposta sulle prove che l’agente stesso produce, come le verifiche automatiche che vanno a buon fine, le schermate, le registrazioni di quello che è successo e le istruzioni per riprodurre un problema. Da un lato è un guadagno, perché nel frattempo puoi occuparti d’altro o semplicemente andare a dormire, dall’altro è un rischio, perché la scorciatoia è sempre a portata di mano, e cioè prendere il riassunto che l’agente ti consegna e usarlo al posto della revisione vera, dando per scontato che basti.

Questa scorciatoia, nei miei appunti, ha un nome e si chiama debito cognitivo. Ogni volta che accetto un riassunto senza pretendere lo stesso corredo di prove che chiederei a una revisione fatta a mano, e cioè il confronto delle modifiche, le verifiche, le registrazioni e i rischi rimasti scoperti, contraggo un debito che prima o poi qualcuno dovrà ripagare, con gli interessi. Per questo, in un’organizzazione che lavora con gli agenti, la verifica diventa una forma di capitale, qualcosa che va costruito, va mantenuto e quando manca si nota subito. Nessun modello te la regala già pronta, è una capacità che l’impresa coltiva nel tempo. In «Pelle Digitale» ho provato a raccontare proprio questa membrana sottile che ci separa dalla macchina che agisce al posto nostro, ed è lì che il debito cognitivo comincia ad accendersi.

Anthropic ha misurato tutto questo osservando circa quattrocentomila sessioni di lavoro con Claude Code, raccolte tra l’ottobre del 2025 e l’aprile del 2026, e ne è uscito un quadro abbastanza chiaro, perché nella sessione tipica sono le persone a prendere circa il settanta per cento delle decisioni di pianificazione, quelle su cosa fare e su quando considerare finito il lavoro, mentre è il modello a prendere circa l’ottanta per cento delle decisioni di esecuzione, quelle su quali file toccare e quale comando eseguire. Letta con questi numeri, l’autonomia alta non toglie le persone dal processo ma le sposta di posto, portandole dal compiere ogni singolo passo al decidere in che direzione muovere quello successivo, e chi porta con sé più competenza del proprio ambito ottiene di più da ogni istruzione e se la cava meglio quando l’agente si blocca, perché sa rimettere a fuoco il problema invece di lasciar perdere.

Il contratto prima della corsa

Prima di lasciar partire un agente conviene mettere per iscritto, in modo breve, che cosa dovrà cercare di ottenere. Non serve un documento burocratico, basta un foglio chiaro che chiunque, compreso un altro agente, possa leggere per capire dove passano i confini. Osmani ne propone una forma pratica che trovo solida, e la riprendo adattandola al modo in cui ragiono io sui permessi.

La prima cosa da fissare è l’obiettivo, che va detto come risultato e non come attività, quindi non «usa questa tecnica» ma «porta il tempo di caricamento sotto il secondo». Attorno all’obiettivo si dispone tutto il resto, e cioè il perimetro entro cui l’agente può muoversi insieme alle cose che invece deve lasciar stare, i permessi con cui gli è concesso toccare il mondo fuori dal suo recinto, la condizione che gli dice quando fermarsi e che è meglio sia misurabile, le prove che confermano il risultato in modo indipendente da lui, il momento e la persona a cui deve passare la mano quando qualcosa si complica, e infine un limite prefissato di tempo, di tentativi e di token, che per questi sistemi sono la moneta con cui pagano il lavoro che fanno.

Su come funzionano davvero il runtime, il contesto e i permessi degli agenti mi sono già soffermato di recente, e non torno qui sui dettagli. Senza un contratto del genere, comunque, l’autonomia alta resta soltanto un atto di fede, e gli atti di fede, quando finiscono in produzione, prima o poi si pagano.

Più agenti lanci e più serve chi controlla

Il gradino più alto assomiglia a una piccola fabbrica. C’è un agente che fa da manager e si attiva quando arriva un compito, distribuisce il lavoro agli altri agenti, ne segue l’avanzamento, rilancia le parti fallite e porta all’attenzione di una persona soltanto le decisioni che richiedono davvero un occhio umano, mentre in ingresso riceve la coda del lavoro, che sia una lista di lavori da fare o un registro delle segnalazioni, e in uscita restituisce attività chiuse e proposte di modifica accompagnate dalle loro prove. Attorno a impostazioni di questo tipo stanno nascendo specifiche di orchestrazione costruite intorno a una lavagna dei compiti, in cui ogni problema riceve il proprio spazio di lavoro e il proprio agente, e la frontiera, per come la racconta Osmani, sono ormai fabbriche che non si fermano mai, con centinaia o addirittura migliaia di agenti al lavoro insieme.

A questa scala due trappole si aprono quasi da sole. La prima è un parallelismo solo apparente, che scatta quando lanci trenta agenti su porzioni di lavoro che si sovrappongono e invece di moltiplicare i risultati ti ritrovi con conflitti da risolvere e con decisioni prese due volte. La seconda è più insidiosa e riguarda noi, perché la tentazione è continuare a coordinare a mano ogni singola dipendenza mentre decine di agenti girano, un po’ come se ci ostinassimo a dirigere il traffico a un incrocio che ormai ha già i semafori. Sul mestiere del manager che passa dal gestire persone al gestire agenti ho scritto di recente, perché è lì che si decide la partita organizzativa più difficile.

Più agenti metti in campo e più diventa vitale una verifica che sia indipendente, con chi implementa tenuto separato da chi rivede, con chi prepara le prove distinto da chi ne controlla la qualità e con dei passaggi di approvazione diversi per accettare il lavoro finito. Le organizzazioni cognitive che vedo nascere si riconoscono proprio da questo, dal fatto che riescono a far lavorare molti agenti insieme e nello stesso tempo a tenere il permesso sempre revocabile, a ogni anello della catena.

Quanti agenti sai ancora fermare

Alla fine il vero collo di bottiglia resta sempre la verifica, più che l’ambizione o il numero di agenti che riusciamo a far girare, perché tutto si gioca su quanto in fretta ci accorgiamo di aver sbagliato e su quanto puliti riusciamo a tornare sui nostri passi. La postura più matura, per chi lavora con gli agenti, è un’autonomia calibrata, che sale di un gradino soltanto dopo che le prove per reggere quel gradino si sono accumulate e che accetta di restare bassa proprio là dove tornare indietro sarebbe difficile.

Mi porto dietro dai tavoli dove lavoro una convinzione che col tempo si è fatta netta. Il giorno in cui ci vanteremo di far girare mille agenti, la prova di essere davvero avanti starà tutta nella rapidità con cui possiamo ancora fermarli. Finché quella rapidità tiene il passo del lavoro che si avvia da solo il permesso resta revocabile e siamo al sicuro, e conviene costruire i processi perché resti così: il giorno in cui la lasciamo indietro avremo soltanto una fabbrica che non sappiamo più spegnere.


Lo spunto di partenza è l’articolo di Addy Osmani «Agentic Autonomy Levels». Le tre domande sulla reversibilità e la forma del contratto d’esecuzione vengono dal suo pezzo, mentre la lettura in chiave di permesso revocabile e di debito cognitivo è mia.

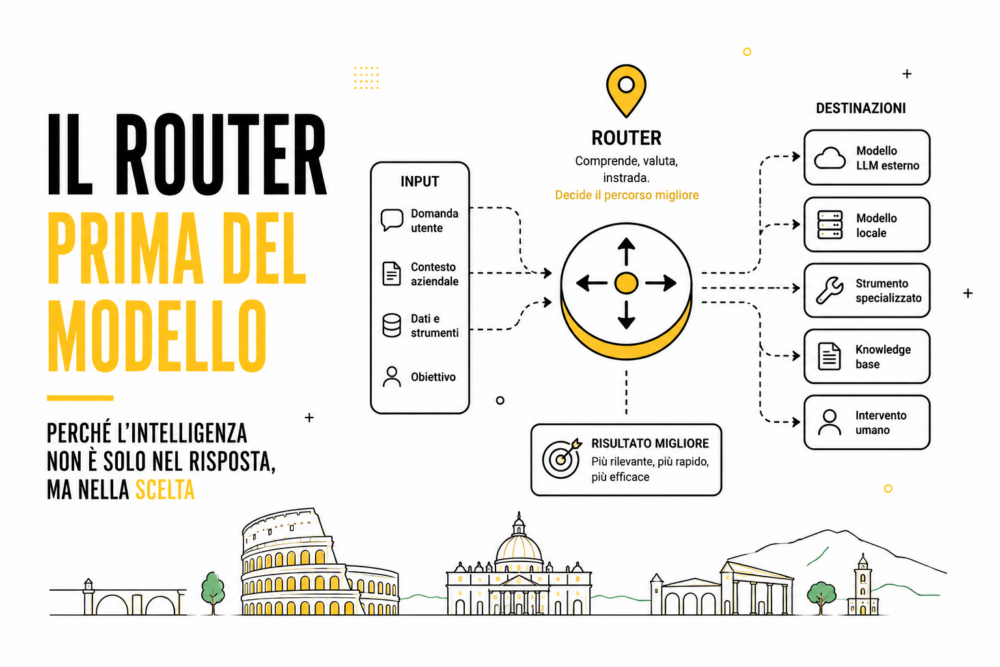
Il router prima del modello

Il 1° luglio Tomasz Tunguz di Theory Ventures ha scritto una cosa semplice che quasi nessuno applica: la maggior parte dei team che costruisce agenti sceglie il modello per primo. Sbaglia ordine, e lo sbaglia sistematicamente, perché il modello è la decisione più visibile e quindi quella su cui si concentra tutta l’attenzione, mentre il pezzo che davvero determina costo e latenza resta invisibile: il router, cioè il codice che decide chi risponde a ogni singola richiesta.

Tunguz lo racconta riferendosi al modo in cui Coinbase ha dimezzato la spesa in AI mentre il consumo di token cresceva, non frenando gli ingegneri con alert di budget ma cambiando i default di instradamento. È un’osservazione operativa, non una teoria, e tocca qualcosa che seguo da mesi lavorando con LocalAI: la sovranità computazionale si gioca sull’architettura, molto più che sulla scelta del modello.

Tre problemi diversi, non uno

Classificatore, router e selettore vengono trattati come sinonimi, e non lo sono. Il classificatore riconosce l’intento: trasforma una richiesta grezza dell’utente in un’operazione concreta, riassumere un repository, scrivere una risposta, lanciare una migrazione. Il router legge quell’etichetta insieme a poche feature, complessità, dimensione del contesto, storico di successo, e decide su quale livello far girare l’operazione. Il selettore, infine, sceglie il modello più economico dentro quel livello che rispetta una soglia di confidenza.

Confonderli è comodo mentre si scrive il primo prototipo, e costa caro dopo: la scelta del modello finisce sepolta dentro il prompt, e diventa impossibile testare due modelli diversi sulla stessa operazione senza riscrivere mezzo sistema. È lo stesso errore di livello che ho descritto parlando dello stack verticale dell’AI: confondere i piani porta a decisioni prese al piano sbagliato.

Il locale è gratis, l’asincrono è economico, il tempo reale costa

E infatti è questa la parte che mi ha fatto fermare a rileggere. Il calcolo locale ha un costo marginale prossimo allo zero, il batch asincrono costa due ordini di grandezza meno dell’inferenza in tempo reale, e la parte di lavoro che ha davvero bisogno di una risposta immediata è sorprendentemente piccola, una volta che il sistema può accodare.

Una bozza di risposta, un riassunto di repository, un memo di due diligence, la valutazione notturna di un batch di tracce: nessuno di questi compiti pretende un secondo di risposta. Pretende di essere fatto bene, non subito.

Ho visto questa stessa dinamica dentro LocalAI, dove la maggioranza del traffico non tecnico regge tranquillamente su modelli piccoli fatti girare in locale, con il cloud che entra in scena solo quando il compito lo richiede davvero. Non è un compromesso al ribasso, è disegno.

Un ciclo che impara mentre dorme

Ecco, e qui il design descritto da Tunguz aggiunge un doppio ritmo di feedback che vale la pena isolare. Un predittore sincrono annota ogni richiesta in ingresso con cinque segnali di rischio, dal contesto di repository mancante alle catene di dipendenze troppo lunghe, fino alle scritture che possono avere conseguenze pesanti se sbagliate, e intercetta così i compiti già noti come difficili prima che falliscano.

Poi, ogni notte, un valutatore batch rilegge le tracce del giorno e aggiorna i pesi del router, mentre il costo di quella valutazione resta vicino allo zero perché gira anch’esso in modalità asincrona. Ed è lì che il sistema scopre i modi di fallire che il predittore non aveva ancora imparato a riconoscere.

Mi sembra la versione infrastrutturale di qualcosa che scrivo da tempo a proposito del vantaggio che un’organizzazione accumula in memoria, non in modello: un sistema che non ha un meccanismo per far rientrare l’esperienza di ieri nelle decisioni di oggi accumula lo stesso tipo di debito, che si parli di persone o di router. L’ho scritto anche a proposito del tokenmaxxing: quel che resta dopo la spesa pesa più del numero speso, che si tratti di token o di traffico instradato.

Da dove si comincia davvero

Nei progetti dove entro a lavorare sull’adozione dell’AI, il primo intervento quasi mai tocca il modello. Tocca l’inventario dei segnali di fallimento: quali richieste arrivano senza contesto sufficiente, quali toccano dati sensibili, quali scritture, se sbagliate, costano care da correggere. Prima si rende visibile quel rischio, poi si decide dove instradarlo.

È un lavoro lento e poco fotogenico rispetto a scegliere l’ultimo modello uscito, e proprio per questo tende a restare indietro nella lista delle priorità. Ma un router costruito senza quella mappa dei rischi impara a fatica, perché non sa cosa sta effettivamente evitando di rompere. Il ciclo notturno di cui scrive Tunguz funziona solo se qualcuno, all’inizio, ha scritto a mano la prima versione grezza di quella mappa.

Chi possiede la logica di instradamento

Se il novanta per cento del traffico può girare su modelli piccoli e locali, la dipendenza da un singolo fornitore cloud smette di essere un fatto tecnico e diventa una scelta di governance, quasi sempre presa per default e non per decisione consapevole.

Progettare intorno al routing, non intorno al modello, sposta il controllo esattamente lì: chi scrive la logica che manda il traffico da una parte o dall’altra decide, di fatto, chi resta padrone dell’infrastruttura. Nella maggior parte delle aziende che conosco quella logica non la possiede nessuno davvero: cresce dentro il notebook di un ingegnere, non dentro un comitato di governance. Ed è lì, non nel modello scelto per ultimo, che si decide chi dipende da chi.


Spunto: Tomasz Tunguz, General Partner at Theory Ventures.

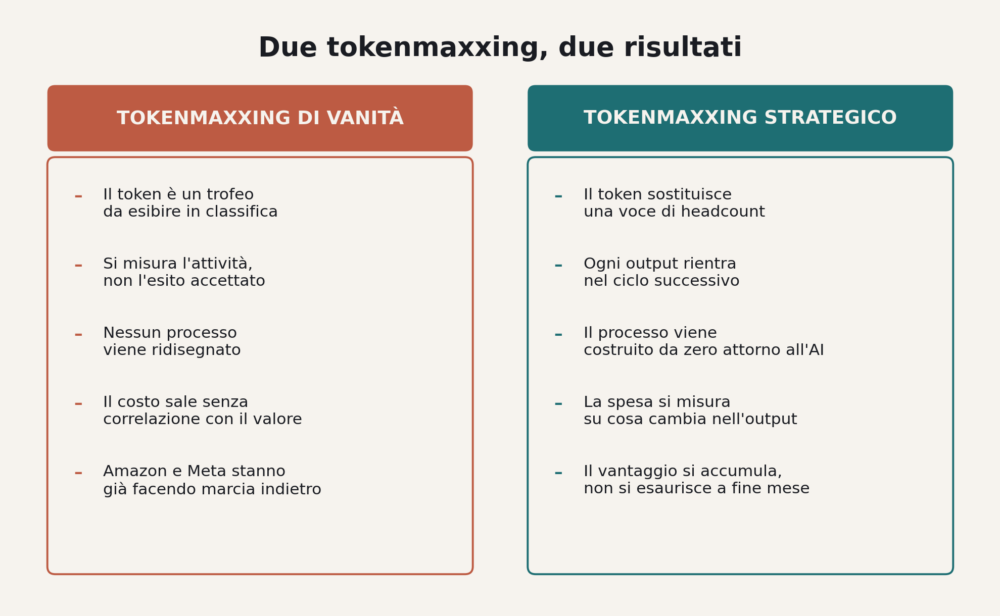
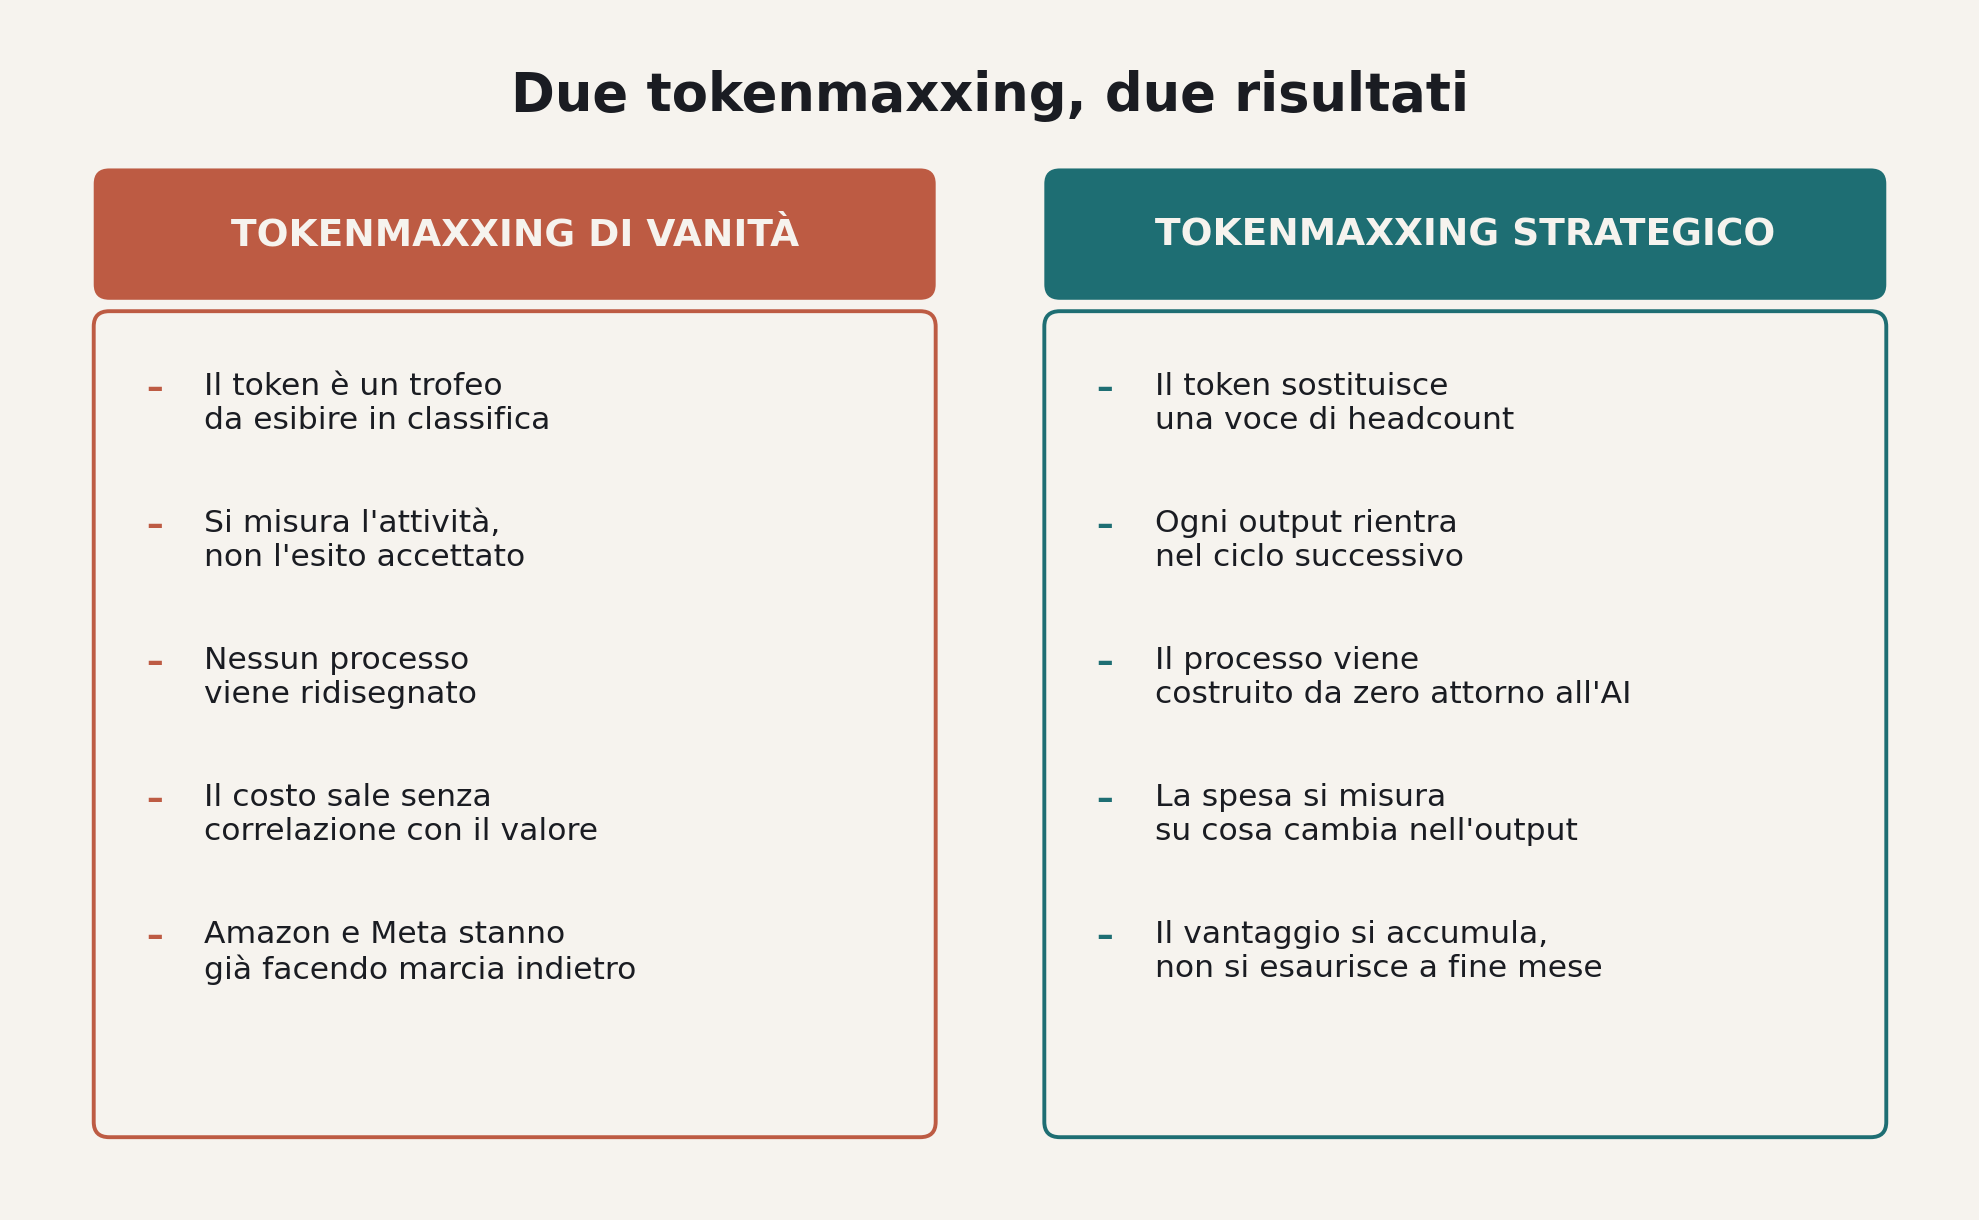
Confronto tra tokenmaxxing di vanità e tokenmaxxing strategico

Tokenmaxxing: cosa serve oltre a bruciare token

Ottantacinquemila dipendenti di Meta compaiono in una classifica interna dedicata al tokenmaxxing. Si chiama Claudeonomics, l’hanno costruita loro stessi incrociando i dati di utilizzo aziendale, e misura una cosa sola: quanti token ciascuno consuma lavorando con l’AI. In cima ci sono i “Token Legend”, vince chi ne brucia di più. A fine aprile Business Insider ha raccontato la lista, a fine maggio Amazon ha spento la sua versione interna dello stesso gioco, e a giugno Fortune titolava che il tokenmaxxing era già finito.

Finito nella forma che fa notizia, forse. Nella forma che sposta budget vero dalle assunzioni al motore agentico, il tokenmaxxing è appena cominciato, e le due cose vengono continuamente confuse.

Amazon ha spento la classifica interna sui token

La dinamica descritta da chi l’ha vissuta è semplice. Un dashboard aziendale mette in fila i dipendenti per numero di token consumati, il numero diventa visibile ai manager, e da lì in poi la classifica smette di misurare qualcosa e comincia a determinarlo. È il meccanismo che gli economisti chiamano legge di Goodhart: una misura, appena diventa un obiettivo dichiarato, smette di essere una buona misura. Al Financial Times alcuni dipendenti Amazon hanno raccontato di aver fatto girare agenti su compiti inutili solo per restare in classifica, mentre Uber, secondo Fortune, ha esaurito l’intero budget AI del 2026 in quattro mesi.

Il paradosso è che nessuno, in questa versione del fenomeno, sta ridisegnando un solo processo. Si sta solo alzando un contatore. Ridisegnare i flussi di lavoro attorno all’AI è lavoro lento, spendere token per apparire “AI-native” è immediato, e la seconda cosa continua a travestirsi da prova della prima.

Il bilancio AI di Uber esaurito in quattro mesi

Nello stesso periodo, però, circola un’idea quasi opposta con lo stesso nome. Y Combinator la spiega ai suoi fondatori così: tokenmaxx, non headcountmaxx. Diana Hu, partner del fondo, lo dice senza troppi giri: una persona con gli strumenti giusti oggi può valere quello che prima valeva un intero team di ingegneria, e un budget API “scomodamente alto” è spesso più economico di un organico gonfiato.

Qui il token non è un trofeo da esibire su una classifica interna, è una voce di bilancio che sostituisce uno stipendio. Una startup che nasce nel 2026 non deve disimparare trent’anni di processi legacy per diventare AI-native, li costruisce così fin dal primo giorno: meno persone, più agenti, decisioni che si prendono dentro un flusso continuo invece che in una riunione settimanale.

Due aziende possono dichiararsi entrambe “tokenmaxxing” e fare l’esatto contrario: una infila numeri in un dashboard per sembrare avanti, l’altra riscrive l’organigramma attorno a quei numeri.

Cosa distingue un token che produce conoscenza da uno sprecato

Confronto tra tokenmaxxing di vanità e tokenmaxxing strategico

Il test operativo che circola tra chi studia il tokenmaxxing si riduce a una domanda: quando il volume di token sale, cosa cambia nel lavoro che viene effettivamente accettato? Se la risposta è “niente”, si sta guardando la versione di vanità. Se la risposta è “un ciclo di revisione in meno, una decisione presa prima, un cliente servito senza aspettare”, si è dentro qualcosa che vale la pena misurare.

Un sistema che moltiplica le interazioni con l’AI senza lasciare che quelle interazioni si accumulino in qualcosa di riusabile genera un debito. Non lo vedi nella fattura del mese, lo vedi tre mesi dopo, quando ogni nuovo agente riparte da zero perché nessuno ha organizzato ciò che il primo aveva già imparato. Il vantaggio, in questo genere di sistemi, smette di stare nel modello e finisce nella memoria che un’azienda accumula, e lo stesso principio vale per il conto dei token: quel che resta dopo la spesa pesa più del numero speso.

Il ciclo che rende utile il tokenmaxxing

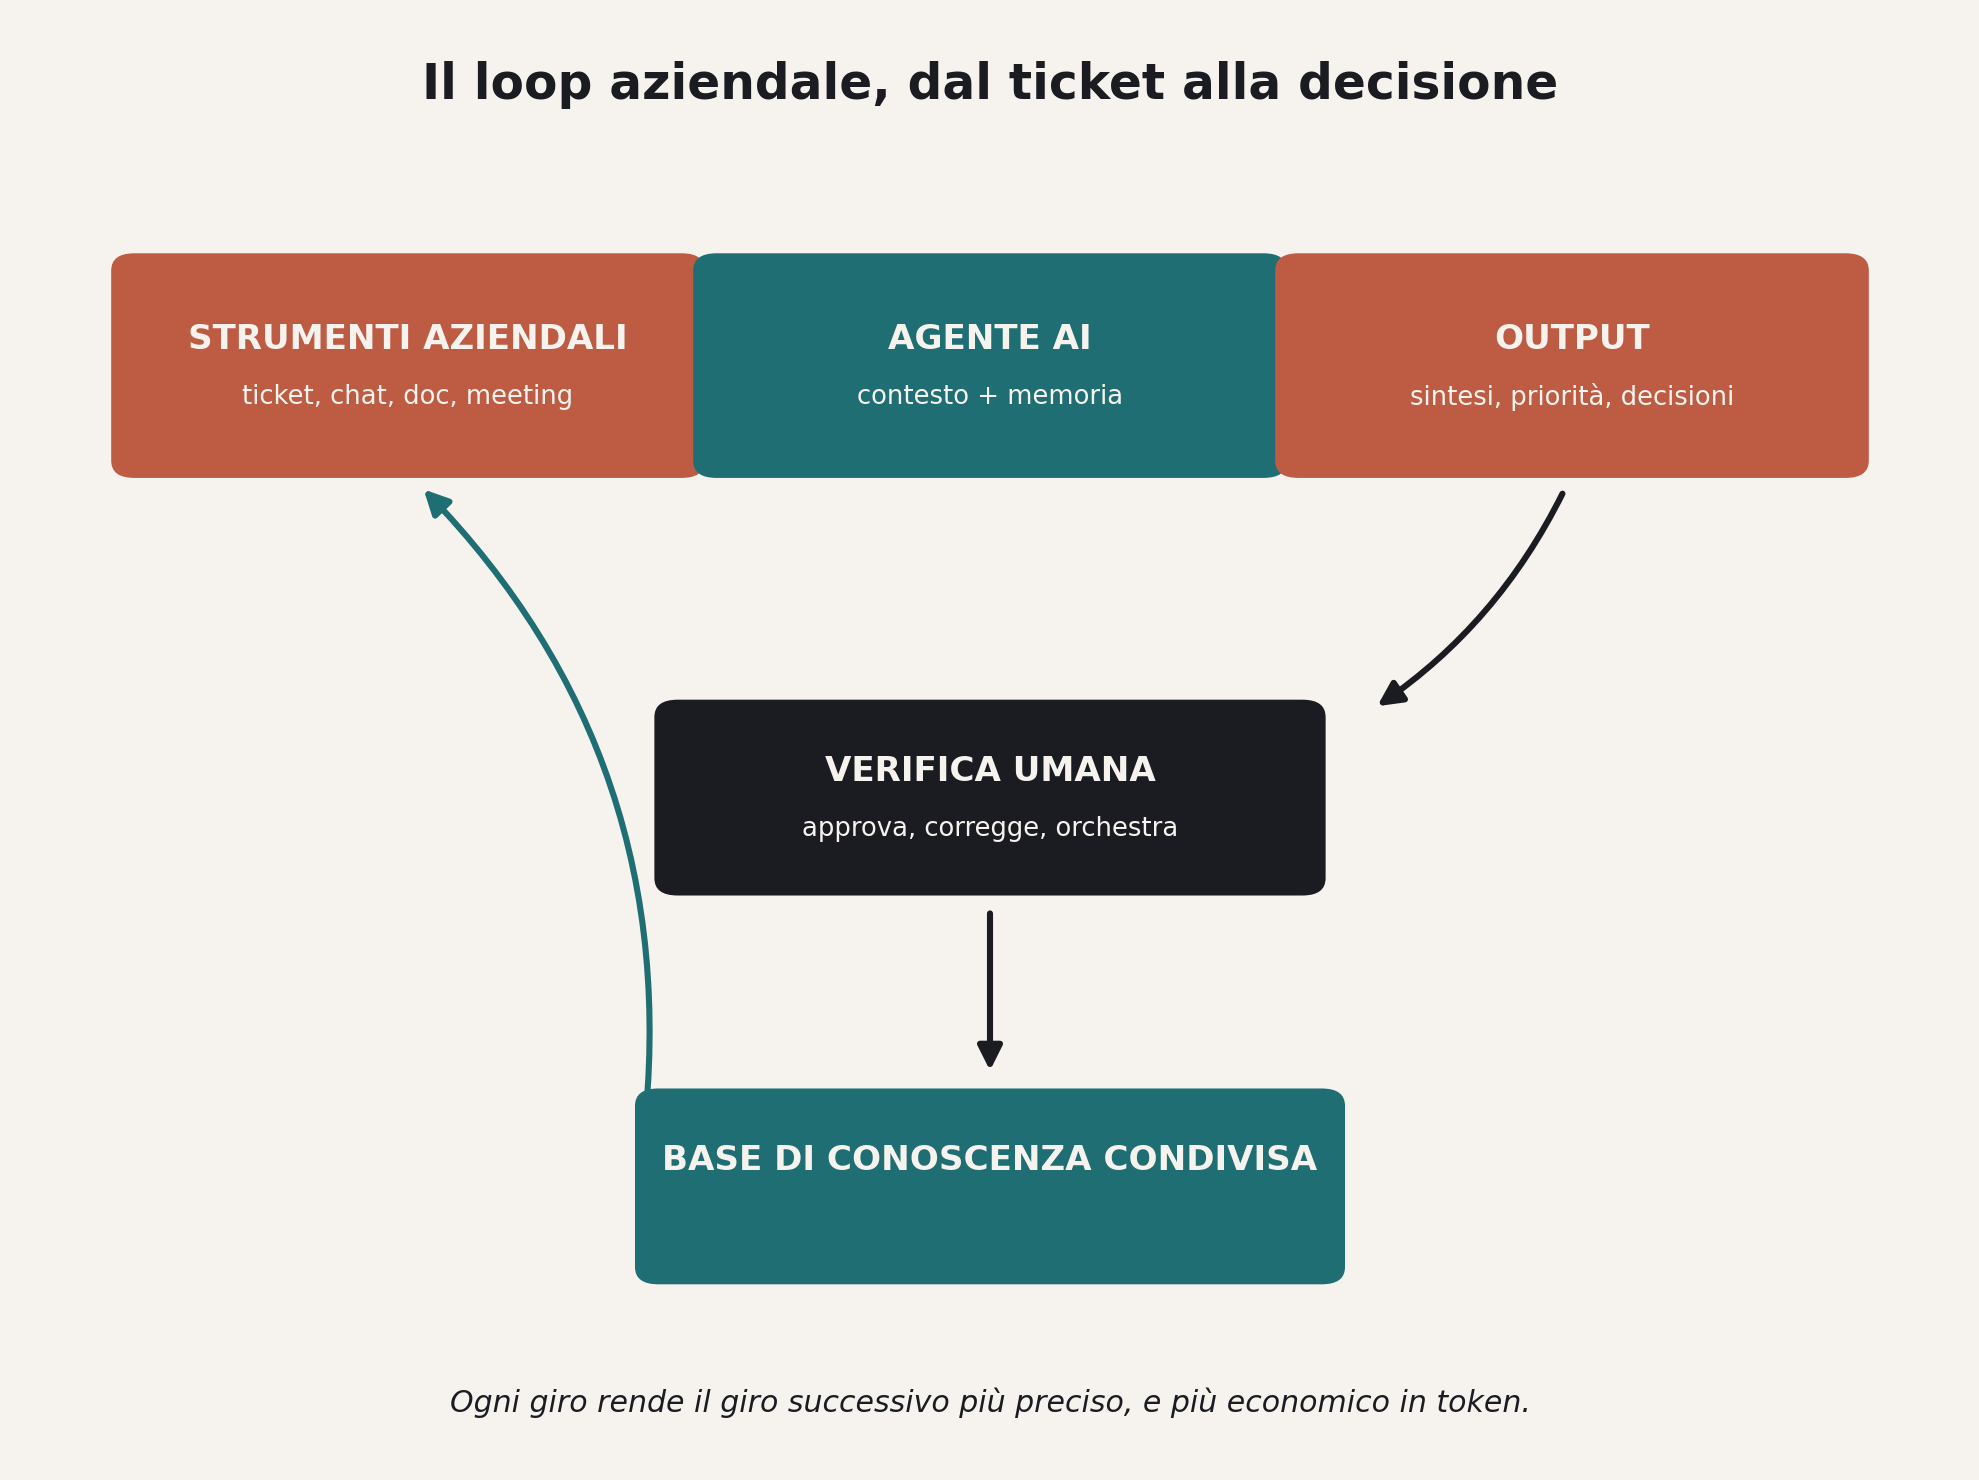
L’azienda che tokenmaxxa in modo utile non brucia token in sessioni isolate, li fa girare in un ciclo che si autoalimenta. Un ticket di supporto genera una sintesi, la sintesi aggiorna la base di conoscenza condivisa, la base di conoscenza informa il prossimo agente che risponde a un cliente simile, e ogni giro rende il giro successivo più preciso e più economico. Satya Nadella lo scorso mese ha messo lo stesso meccanismo al centro della sua visione d’impresa, chiamandolo learning loop, e il punto che aggiungo io è che il ciclo regge solo se qualcuno possiede l’infrastruttura che lo fa girare, non solo il modello che lo alimenta.

Schema del loop aziendale: strumenti aziendali, agente AI, verifica umana, base di conoscenza condivisa

La meccanica del ciclo: trigger, non riunioni

Il loop non si costruisce con più call di allineamento, si costruisce con eventi che si attivano da soli. Un ticket chiuso genera un webhook, il webhook passa il testo a un agente con accesso al contesto storico del cliente, l’agente produce una sintesi strutturata e la scrive in un repository condiviso, e quella sintesi diventa automaticamente parte del contesto disponibile per il prossimo ticket simile. Nessun passaggio richiede che un umano apra una chat e formuli una domanda: il trigger sostituisce la richiesta.

Nel tokenmaxxing che funziona, la differenza tecnica che conta è tra un agente che risponde quando qualcuno lo interpella e un agente che si attiva quando cambia lo stato di un sistema: un CRM aggiornato, un documento modificato, una trascrizione caricata. Il secondo tipo tiene il ciclo vivo anche quando in azienda nessuno sta guardando, ed è quello che separa un assistente da un processo.

I loop cambiano forma da reparto a reparto

In assistenza clienti il loop più maturo parte da un ticket risolto: il caso alimenta una base di risposte pronte, e il prossimo cliente con lo stesso problema riceve una soluzione prima ancora che un operatore la legga. In ingegneria il ciclo passa dai code review, ogni commento di un revisore diventa una regola che l’agente applica al pull request successivo invece di essere ripetuto una volta di più. Nelle vendite il loop nasce dalla trascrizione delle chiamate: l’agente estrae le obiezioni ricorrenti e le carica nel CRM come suggerimenti per la trattativa dopo, senza aspettare il report trimestrale. Nella finanza aziendale il ciclo si chiude sulle policy di spesa, ogni eccezione approvata aggiorna la regola scritta e la richiesta successiva non arriva più a un umano se rientra nel nuovo perimetro. Nelle risorse umane il loop gira attorno alle domande sui benefit: la prima risposta corretta diventa voce di una base consultabile, la centesima non richiede più nessuno.

Il segnale che il ciclo funziona si misura sul tempo, non sui reparti coinvolti: quanto passa tra un’interazione e il momento in cui quell’interazione aggiorna qualcosa di consultabile per la prossima. Se la risposta è “mai”, quel reparto sta ancora solo usando l’AI, il loop non è partito.

Non conta quanto token bruci ma cosa resta dopo

Le aziende nate trent’anni fa restano indietro non perché usino meno AI, ma perché il loro organigramma è stato disegnato prima che esistesse un’alternativa al mettere una persona su ogni compito. Cambiarlo ora significa smontare processi che hanno funzionato per decenni, ed è un lavoro che nessun dashboard di token può velocizzare. Le aziende che nascono oggi non hanno questo problema, e la differenza tra chi vince e chi perde questa fase si vede meno nella fattura di Anthropic o OpenAI e più in quante decisioni, alla fine del trimestre, vengono ancora prese da un umano che rilegge tutto da capo.

Il ruolo umano che resta, in questo schema, è quello descritto anche in un pezzo recente su chi oggi gestisce insieme persone e agenti: meno produzione diretta, più verifica, correzione, approvazione finale. Un lavoro che a differenza dei token non si può comprare a peso.

Chi guarda la classifica dei token e pensa di aver capito qualcosa dell’azienda del 2026 sta guardando la metrica sbagliata. La domanda utile non è quanti token, ma quanti di quei token tornano indietro sotto forma di conoscenza che il prossimo agente non deve reinventare.

Fonti: Fortune, The Pragmatic Engineer, Business Insider / Y Combinator.

Manager di umani e di agenti: un mestiere che sta cambiando

A febbraio 2026 Harvard Business Review ha pubblicato un articolo a firma Suraj Srinivasan (Harvard Business School) e Vivienne Wei (Salesforce) sul nuovo ruolo del manager di agenti AI nelle aziende, intitolato To Thrive in the AI Era, Companies Need Agent Managers. Dentro c’è la giornata di Zach Stauber, support agent manager a Salesforce: comincia e finisce davanti a dashboard, scorecard e sistemi di osservabilità degli agenti. Non gestisce persone, gestisce una flotta di agenti AI che lavorano su supporto, vendite e marketing dentro Agentforce. Marc Benioff a luglio 2025 aveva già detto che Salesforce è passata da 9.000 a 5.000 ruoli nel customer support, riallocando il resto in vendite e customer success, e che gli agenti chiudono autonomamente l’85% dei ticket clienti.

Sembra una notizia di Silicon Valley, ed effettivamente il caso Salesforce è estremo. La categoria di lavoro che descrive però, quella del manager di agenti che orchestra un gruppo misto di umani e di sistemi automatizzati, sta arrivando a velocità inattesa anche dentro aziende italiane molto meno radicali. Lo vedo nei progetti di advisory che seguo, lo sto vivendo addosso io stesso nel modo in cui lavoro, e ho la sensazione che molti CEO italiani non abbiano ancora messo a fuoco quanto profondamente questo cambierà l’organigramma reale delle loro aziende entro 24 mesi.

A casa di chi costruisce AI, questo è già il presente

Lo studio Anthropic How AI Is Transforming Work at Anthropic, pubblicato il 4 dicembre 2025, ha analizzato 132 ingegneri e ricercatori interni, 53 interviste qualitative e i dati di uso di Claude Code. Un numero solo, fra i tanti che il paper mette sul tavolo, mi è rimasto in mente: il 27% del lavoro fatto con assistenza AI è lavoro che senza AI non sarebbe stato fatto affatto. Esperimenti che restavano nel cassetto, dashboard nice-to-have, documentazione interna sempre rinviata, strumenti che sarebbero costati troppo da prototipare a mano. Tutto questo adesso si fa, perché il costo marginale di iniziare è crollato.

Sotto quel 27% c’è una conseguenza meno raccontata, ma evidente nelle interviste: gli ingegneri Anthropic descrivono se stessi sempre più come supervisori, persone che danno indicazioni e controllano output, che indirizzano il lavoro invece di farlo direttamente. La quota di lavoro che dicono di poter “fully delegate” all’AI resta intorno al 10-20%, ma il restante 80-90% è collaborazione attiva, con il loro tempo che scivola dall’esecuzione diretta al controllo, dalla scrittura del codice alla revisione del codice scritto da Claude. Anthropic è il caso estremo perché Claude è il loro prodotto, ma la curva che descrivono è la stessa che vedo nei team di sviluppo italiani che hanno adottato Claude Code o Cursor o equivalenti negli ultimi sei mesi.

“Il McKinsey” che ha messo sul tavolo i numeri

A gennaio 2026, sul podcast All In, Bob Sternfels (global managing partner McKinsey) ha dichiarato che la sua azienda ha 60.000 dipendenti totali, di cui 25.000 agenti AI a fianco di 40.000 umani, con l’obiettivo di parità entro fine anno. Sul valore reale di quei 25.000 agenti il dibattito è aperto, e i concorrenti EY e PwC hanno fatto notare che una manciata di agenti ben fatti spesso produce più valore di una flotta numerosa. La notizia più seria di quella conferenza, come ho scritto in maggio, era però un’altra: McKinsey sta spostando una quota maggiore della remunerazione dei partner da cash a equity, perché i ricavi diventano volatili e il vecchio modello non regge più.

Una conseguenza che né McKinsey né i suoi concorrenti hanno ancora interiorizzato è questa: se metà della tua workforce è composta da agenti, hai bisogno di una struttura manageriale che gestisca gli agenti come si gestiscono le persone, ma con strumenti diversi.

Servono ruoli di accountability per le performance degli agenti, persone che ne misurino la qualità, che li riallenino quando deragliano, che decidano quando un caso va escalato a un umano. È esattamente quello che fa Stauber a Salesforce, ed è il primo abbozzo di una professione che fino a 18 mesi fa non esisteva.

Come sto vivendo io questo cambiamento

Mi è capitato negli ultimi mesi di trovarmi a fare il lavoro che fino a 24 mesi fa avrei diviso fra tre o quattro junior. Brief di scoping per un cliente, ricerca preliminare di mercato, prima stesura di un’offerta tecnica, analisi di documenti corposi, audit di una codebase. Quattro cose che richiedevano persone diverse, tempi distribuiti su settimane, riunioni di coordinamento. Adesso le orchestro da solo, con Claude Code che lavora sulla parte tecnica, Claude o GPT che mi preparano i deck e le bozze, RSS Intelligence che mi setaccia le fonti, MCP server che leggono i miei progetti aziendali su Biztrack e li trasformano in materiale per il cliente. Non è perfetto, non sempre regge, ma il salto di efficienza è reale.

Ed è qui che inizia il dubbio, quello che lo studio Anthropic intercetta nelle sue interviste e che condivido. Se il junior che avrebbe fatto la ricerca di mercato per me non lo faccio più assumere, perché un agente la fa decentemente in venti minuti, dove lo formerà la prossima generazione di consulenti e advisor? E se la prima bozza di un’offerta tecnica la scrive un agente che ho istruito sui miei pattern, quando avrò ancora il tempo e l’occasione di fare quel lavoro io stesso, con la lentezza che serve per capirlo davvero?

Su questo voglio essere chiaro: non sto facendo argomenti contro l’adozione dell’AI, su cui sono fra i più convinti. Sto argomentando per adottarla con la consapevolezza che ogni nuova efficienza implica una scelta di cosa non sviluppiamo più come capacità umana. La supervisione di un agente richiede competenza profonda dello stesso dominio che l’agente ha automatizzato. Se quella competenza non si forma più sul campo, fra due cicli generazionali la supervisione diventa nominale.

Il ruolo del manager si sta sdoppiando

Quello che osservo nelle aziende italiane medie con cui lavoro, fra le tecnologiche di Roma e le manifatturiere del Nord, è che la figura del manager si sta sdoppiando in due direzioni che convivono nella stessa persona.

Una direzione resta quella tradizionale, fatta di relazione umana fra persone: motivare un collega che attraversa un momento complicato, costruire e mantenere fiducia, gestire i conflitti che nascono inevitabilmente in ogni team, prendere decisioni su altre persone. Questa parte non viene erosa dall’AI, anzi: con team più piccoli e più senior, ogni decisione su una persona pesa di più, ogni riunione conta di più, ogni colloquio di sviluppo diventa più strategico. Il manager di umani non scompare, diventa più importante per quei pochi umani che resteranno nel team.

L’altra direzione è completamente nuova. Si tratta di definire i task degli agenti, scegliere il modello adatto al singolo carico, versionare i prompt come si versionano i contratti, monitorare derive e performance, decidere quando portare un agente da pilot a produzione e quando spegnerlo. Sono attività che assomigliano al lavoro di un product manager più che a quello di un people manager, ma vivono dentro lo stesso perimetro di responsabilità.

Il risultato è che il manager italiano del 2027 dovrà essere bilingue. Parlare la lingua delle persone e la lingua dei sistemi agentici. E queste due lingue si imparano in scuole molto diverse.

Ambizione, giudizio, creatività: cosa cerca davvero Sternfels

A Las Vegas, sempre a gennaio, Sternfels ha indicato che McKinsey cerca oggi nei candidati junior tre qualità precise: ambizione, giudizio, creatività. Sembra una lista da ufficio HR, ma se la leggi con la lente del lavoro che descrive Stauber a Salesforce, ti accorgi che è la descrizione esatta del manager di agenti.

L’ambizione conta perché chi gestisce agenti non ha più la routine del controllo gerarchico stretto, ha invece il problema di decidere cosa far fare di nuovo a un sistema che fa molto da solo. Il giudizio conta perché la quasi totalità delle decisioni operative la prendono gli agenti, e l’umano interviene proprio nei casi limite dove non ci sono regole chiare. Sulla creatività poggia tutto il resto, dato che definire bene un agente significa immaginare casi d’uso e prompt che non sono nel playbook esistente.

Tutte e tre queste organizzazioni stanno cercando le stesse tre competenze, e stanno cercandole in nuovi ruoli mentre tagliano in quelli vecchi. È lo scenario che le aziende italiane medie devono interiorizzare, perché succederà anche da loro, con due-tre anni di ritardo e a una scala più piccola, ma con la stessa logica.

Come imposto i progetti dove serve un manager di agenti

Quando un CEO italiano mi chiede come si prepara la sua azienda al manager di agenti, gli rispondo che non si prepara con un master di sei mesi né con un progetto di consulenza chiavi in mano. Si prepara mettendo subito un piccolo gruppo di manager attuali in condizione di lavorare quotidianamente con agenti veri, su task veri, e di imparare sul campo cosa va e cosa non va.

Praticamente significa scegliere un caso d’uso non strategico ma reale, dove il rischio è basso e l’apprendimento alto: drafting di prime risposte commerciali, analisi periodica di documentazione regolatoria, gestione della knowledge base interna. Poi serve dare al manager interno tutto lo stack per orchestrare l’agente, dall’accesso ai modelli alla dimestichezza con MCP e tool calling, fino al controllo dei prompt e alle dashboard di monitoraggio. Infine, e qui è il passaggio che vedo più trascurato, quel manager va valutato non sull’output diretto ma sulla qualità con cui gestisce l’agente, esattamente come Stauber a Salesforce.

Questa logica funziona meglio quando si appoggia su un’architettura AI dentro al perimetro aziendale, perché un manager italiano che orchestra agenti su dati di clientela o su documentazione sensibile non può farlo bene se gli agenti girano su infrastruttura americana sotto Cloud Act. Senza sovranità del dato, il manager diventa supervisore di un sistema di cui non controlla i confini, e la sua funzione si svuota.

Il rischio che non discutiamo abbastanza

C’è una parte del lavoro manageriale che la sostituzione con agenti rischia di erodere, e credo valga la pena nominarla con calma. È il mentoring informale, quello che succede quando un giovane fa una domanda a un collega più anziano in corridoio, quando un junior osserva un senior gestire una telefonata difficile, quando un team-leader passa mezz’ora con un nuovo assunto per capire come ragiona.

Quel sapere tacito, che le aziende trasmettono per contagio quotidiano, ha bisogno di numero. Servono junior che facciano domande e senior che rispondano, e servono spazi fisici e mentali dove l’asimmetria di esperienza si trasforma in relazione di apprendimento. Se gli agenti rispondono prima e meglio, i junior smettono di chiedere ai colleghi e i senior smettono di formare, e l’azienda smette di trasferire memoria operativa. È una perdita che non si vede nei KPI trimestrali, si vede nel decennio.

In Pelle Digitale ho provato a descrivere il modo in cui l’interfaccia digitale media le nostre relazioni e modifica anche quello che credevamo di sapere su noi stessi. Vale lo stesso, in modo più specifico, dentro le organizzazioni. Un’azienda dove l’interlocutore di prima istanza è un agente, e non più il collega di stanza, è un’organizzazione diversa nella sostanza, non solo nelle prestazioni. Il buon manager di agenti del 2027 dovrà difendere attivamente gli spazi dove l’apprendimento informale avviene fra umani, perché non avverrà più da solo.

La domanda da porsi

Settembre 2026 sarà probabilmente il primo trimestre in cui molte aziende italiane medie metteranno in piedi i primi prototipi seri di agentic adoption, dopo la prova generale del 2025 e i pilot del 2026. Per chi guida quelle aziende, e per chi guida funzioni dentro quelle aziende, una domanda che vale la pena tenere davanti è semplice. Quale manager della mia organizzazione è già di fatto un orchestratore di agenti senza ancora averlo dichiarato, e quale invece sta rifiutando di diventarlo perché ne percepisce l’aliquota di disagio? Perché il primo va riconosciuto e formalizzato in fretta, prima che lo riconosca un concorrente. E il secondo va ascoltato, perché la sua diffidenza spesso vede cose che chi è già dentro non vede più.

Guidare Claude Code: la guida completa a skill, hook, subagent e regole

Il 18 giugno 2026 Anthropic ha pubblicato una mappa di tutti i modi in cui si può dire a Claude Code come comportarsi. Sono sette, e la cosa interessante non è l’elenco, è che ognuno di quei sette modi risponde a tre domande diverse: quando l’istruzione entra in memoria, se ci resta quando la sessione si allunga, e quanto è vincolante. Lavoro con questi agenti tutti i giorni, e ho imparato che la maggior parte degli errori di configurazione nasce dall’aver messo l’istruzione giusta nel posto sbagliato.

Per chi scrive codice da solo è una questione di efficienza. Per chi porta la responsabilità della tecnologia in un’azienda diventa qualcosa di più, perché la distanza tra un’istruzione e una garanzia è la stessa che separa una buona intenzione da una regola che nessuno può aggirare. Questa guida prova a mettere ordine: cosa sono i sette meccanismi, come si comportano quando la sessione cresce, e dove conviene scrivere ogni tipo di istruzione.

Ogni istruzione ha un costo e un’autorità

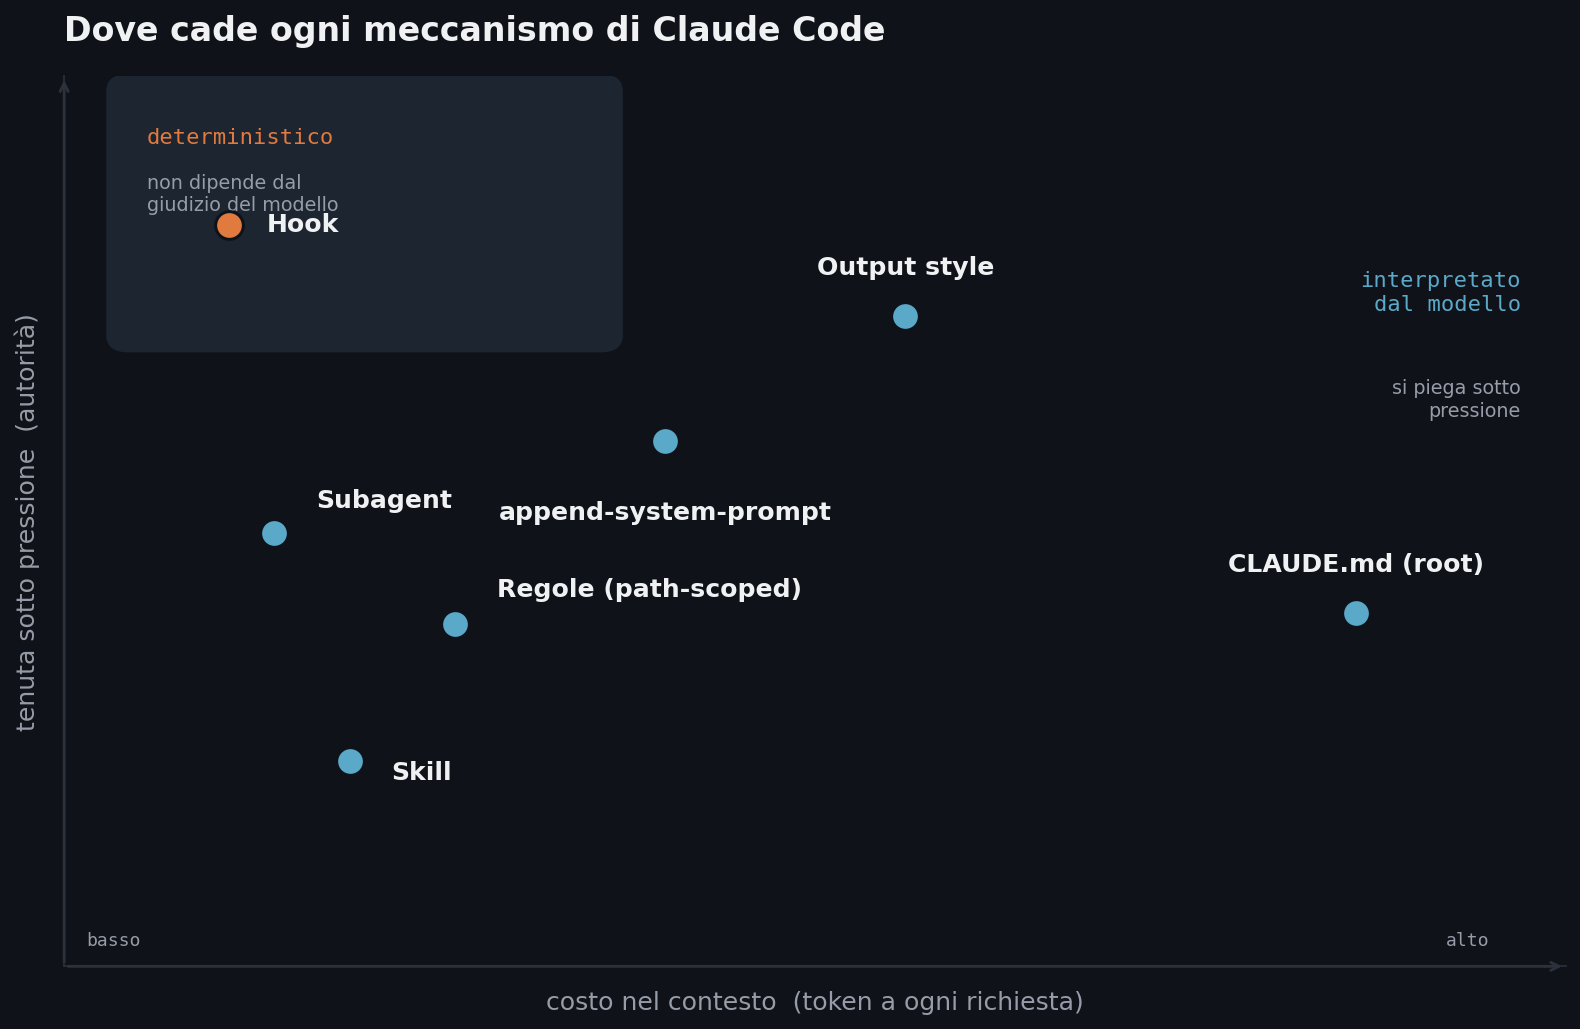
Ogni riga che finisce nella finestra di contesto di Claude occupa spazio e influenza il comportamento, e questi due effetti vanno tenuti insieme. Lo spazio è il costo: token che paghi a ogni richiesta, che l’istruzione serva o no in quel momento. L’autorità è il peso: quanto Claude segue quell’istruzione quando le cose si complicano, in una sessione lunga, in una situazione ambigua, o quando un file letto durante il lavoro contiene istruzioni nascoste che spingono in direzione opposta.

I sette meccanismi si distribuiscono lungo questi due assi. Alcuni costano molto e valgono sempre, altri costano poco perché entrano in scena solo quando servono, altri ancora non vivono affatto nel contesto perché sono codice che gira per conto suo. Sapere dove cade ciascuno è metà del lavoro. L’altra metà è una sola domanda, che torna a ogni scelta: questa cosa deve succedere quando il modello decide di farla, o deve succedere e basta?

CLAUDE.md, il file che Claude rilegge a ogni avvio

Il CLAUDE.md è un file markdown nella radice del progetto. Si carica all’inizio della sessione e ci resta per tutta la durata. Comandi di build, struttura delle cartelle, organizzazione di un monorepo, convenzioni di codice, norme del team: tutto questo sta bene qui, perché sono fatti che Claude deve avere sempre sottomano.

Ne esistono due tipi, e si comportano in modo opposto. Quello nella radice è sempre presente, sopravvive alle sessioni lunghe, e quando Claude Code comprime la conversazione per liberare spazio lo rilegge da capo. Quelli nelle sottocartelle invece si caricano su richiesta, solo quando Claude legge un file dentro quella cartella. Un app/api/CLAUDE.md non entra all’avvio, entra quando si tocca qualcosa sotto app/api, e sparisce di nuovo finché non si torna lì.

Il problema del file nella radice arriva con la scala. In un repository condiviso cresce come ogni configurazione senza padrone: ogni team aggiunge le sue righe, nessuno cancella niente, e quel testo si carica in ogni sessione di ogni persona, che riguardi il suo lavoro o no. Si pagano token, e si diluisce l’aderenza alle istruzioni che contano.

Il consiglio di Anthropic è di tenerlo sotto le duecento righe, dargli un proprietario, e trattarne le modifiche come si tratta il codice, con una revisione. Pensa a questo file come a un indice: una mappa del progetto che rimanda ad altri file dove Claude trova il dettaglio quando gli serve. Per le regole che devono valere su ogni repository dell’organizzazione, politiche di sicurezza o requisiti di conformità, esiste un CLAUDE.md gestito centralmente, distribuito sulle macchine via MDM, che il singolo non può escludere.

Le regole si caricano solo dove servono

Le regole sono file markdown dentro .claude/rules/, e danno a Claude vincoli o convenzioni precise. Senza un raggio d’azione si comportano come il CLAUDE.md: caricate all’avvio, rimesse dentro dopo ogni compressione, sempre presenti anche quando il compito non le riguarda.

Con il campo paths nell’intestazione cambia il momento del caricamento. Una regola legata a src/api/** resta fuori dal contesto durante una sessione che tocca solo la documentazione, e si carica unicamente quando Claude legge un file dentro quella cartella. L’intestazione si scrive così:

---
paths:
  - "src/api/**"
  - "**/*.handler.ts"
---
Ogni handler API deve validare l'input con Zod prima di processarlo.

Un vincolo legato a un file specifico, tipo le migrazioni che si possono solo aggiungere e mai modificare, sta bene come regola con il suo paths. Conviene preferire una regola con raggio d’azione a un CLAUDE.md annidato quando l’istruzione riguarda un aspetto trasversale, o un tipo di file che compare in più punti del codice ma non ovunque.

Le skill portano dentro la procedura al momento giusto

Le skill vivono in .claude/skills/, cartelle che contengono istruzioni, script e risorse, ognuna con un file SKILL.md fatto di nome, descrizione e corpo. All’avvio della sessione si caricano solo il nome e la descrizione. Il corpo entra quando la skill viene invocata, con un comando slash come /code-review oppure perché Claude riconosce che il compito corrisponde a quella descrizione.

/code-review è una skill già inclusa: legge le modifiche correnti e riporta cosa ha trovato senza toccare i file. La skill definisce il copione, e Claude segue lo stesso percorso ogni volta che la richiami. Quando la conversazione viene compressa, le skill già invocate vengono rimesse dentro fino a un tetto di token condiviso tra tutte: se ne hai usate molte nella stessa sessione, le più vecchie cadono per prime.

La regola pratica è corta. Le istruzioni procedurali, un flusso di deploy o una checklist di rilascio, stanno in una skill, non nel CLAUDE.md. Claude Code arriva con le sue skill, ma puoi scriverne di tue, ed è proprio quello che faccio per il lavoro editoriale e di consulenza, impacchettando in una cartella le procedure che ripeto.

Un agente separato per il lavoro che non vuoi leggere

I subagent sono file markdown in .claude/agents/, e definiscono assistenti isolati per compiti laterali. Ogni file ha un’intestazione YAML, nome e descrizione più eventuali campi per il modello e per gli strumenti a cui può accedere, seguita da un corpo che diventa il prompt di sistema di quel subagent.

Somigliano alle skill, perché all’avvio si caricano nome, descrizione ed elenco degli strumenti, mentre il corpo non si attiva da solo: Claude lo chiama tramite lo strumento Agent passandogli un prompt. La differenza vera è l’isolamento. Il corpo del subagent non entra mai nella conversazione principale. Il subagent gira in una finestra di contesto tutta sua, e al termine torna alla sessione madre solo il suo messaggio finale, spesso il risultato aggregato di molti passaggi, più qualche metadato.

Questo schema scala in un modo che vale la pena capire. I subagent si annidano fino a cinque livelli, e i flussi di lavoro dinamici orchestrano da decine a centinaia di agenti in background senza che tu debba specificare ogni dettaglio. Il piano di orchestrazione e i risultati intermedi vivono dentro variabili di script invece che nel contesto di Claude, e questo permette di crescere senza perdere fedeltà alle istruzioni.

L’isolamento è il motivo principale per scegliere un subagent invece di una skill. Lo usi quando un compito laterale, una ricerca profonda o l’analisi di un log ingombrerebbe la conversazione principale con risultati intermedi che non riguarderai più. Usi una skill quando vuoi che la procedura si svolga dentro il thread principale, sotto i tuoi occhi, un passaggio alla volta. La documentazione sui subagent entra nel dettaglio dei campi dell’intestazione e dei permessi sugli strumenti.

Gli hook girano fuori dal contesto

Gli hook sono comandi, endpoint HTTP o prompt che danno un controllo più deterministico sul comportamento di Claude, perché scattano su eventi precisi del suo ciclo di vita: una modifica a un file, una chiamata a uno strumento, l’avvio della sessione. Si registrano nel settings.json, nelle impostazioni gestite, o nell’intestazione di una skill o di un agente.

Ne esistono di cinque tipi: command, HTTP, mcp_tool, prompt e agent. Tutti scattano in modo deterministico, ma i primi tre eseguono codice, mentre prompt e agent usano il giudizio di Claude invece di una regola fissa per decidere l’output. Il costo in contesto è basso, perché la configurazione vive fuori dalla finestra principale. Qualche output può rientrare: l’errore di un hook che blocca un’operazione viene salvato nel contesto, così Claude sa perché la chiamata è stata negata. La maggior parte degli hook invece non lascia traccia, a meno che la configurazione non lo preveda. Se hai salvato la cronologia della chat in un altro file prima della compressione usando l’evento PreCompact, Claude non saprà in quale file l’hai messa.

È qui che gli hook si staccano dal CLAUDE.md, dalle regole e dalle skill. Servono per tutto ciò che deve accadere in modo deterministico: far girare un linter dopo ogni modifica, scrivere su Slack a lavoro finito, bloccare certi comandi prima che partano. Un hook PreToolUse può ispezionare qualunque chiamata a uno strumento e uscire con codice 2 per negarla. Costano poco perché sono codice che l’ambiente esegue, non istruzioni che Claude deve caricare e interpretare.

Output style e system prompt: l’autorità più alta

Gli output style sono file in .claude/output-styles/ che iniettano istruzioni nel prompt di sistema. Non vengono mai compressi, si caricano all’inizio di ogni sessione, e dopo la prima richiesta restano in cache, quindi il costo in contesto è moderato. Stando nel prompt di sistema portano il peso di aderenza più alto tra tutti i metodi visti finora, e vanno usati con misura.

C’è una trappola. Cambiare l’output style sostituisce quello predefinito, a meno che tu non imposti keep-coding-instructions: true nell’intestazione. In Claude Code questo cancella le istruzioni che dicono a Claude di star aiutando con un lavoro di ingegneria del software, e con loro abitudini critiche come quando aggiungere o togliere commenti al codice, come gestire le questioni di sicurezza, l’abitudine a far girare i test prima di dichiarare finito un lavoro. Senza accorgertene, Claude Code diventa un assistente generico invece di un assistente che programma. Prima di scriverne uno tuo, conviene guardare quelli già inclusi: Proactive, Explanatory e Learning coprono i bisogni più comuni.

L’alternativa più leggera è il flag append-system-prompt. Dove modificare un output style può avere effetti larghi e non voluti, il flag è solo additivo: non cambia il ruolo di Claude, gli aggiunge istruzioni. Si passa al momento dell’invocazione e vale solo per quella, non resta come file tra le sessioni. Costa qualche token in più in ingresso, attenuato dalla cache dopo la prima richiesta, ed è la via giusta per standard di codice specifici, formati di output, conoscenza di dominio. Con un avvertimento che vale per tutti i metodi a prompt: più istruzioni infili, meno Claude le segue alla lettera, soprattutto se qualcuna contraddice le altre.

Quando l’istruzione è nel posto sbagliato

Ci sono segnali che dicono che un’istruzione andrebbe spostata altrove. Se ti ritrovi a scrivere “ogni volta che X, fai sempre Y” nel CLAUDE.md, e quel comportamento deve essere affidabile, tipo far girare prettier dopo ogni modifica, quello è un hook nel settings.json. Il modello che sceglie di lanciare un formattatore è un’altra cosa rispetto al formattatore che parte da solo.

Se nel CLAUDE.md compare un “non fare mai questo”, l’istruzione è lo strumento sbagliato. Claude la seguirà quasi sempre, ma sotto pressione, in una sessione lunga, in una situazione ambigua, o per via di un’iniezione di prompt dentro un file aperto durante il compito, il modello può non rispettarla. Una barriera vera è deterministica, e si costruisce con gli hook e i permessi. Un hook PreToolUse ispeziona la chiamata ed esce con codice 2 per bloccarla. Le impostazioni gestite vanno oltre: le distribuisce un amministratore, l’utente non le può sovrascrivere, e sono l’unico modo per imporre una barriera deterministica su tutta l’organizzazione.

Una procedura di trenta righe nel CLAUDE.md va in una skill. Una regola che vale solo per src/api/** va scritta con il suo paths, perché senza è meccanicamente identica a mettere quel testo nel CLAUDE.md, sempre caricata, sempre a consumare token. E le preferenze personali, tipo usare sempre messaggi di commit semantici, vanno nei file a livello utente, che valgono per ogni sessione a prescindere dal repository, non nel file di progetto condiviso con il team.

Un’istruzione non è una garanzia

Tutto questo si riduce a una distinzione che per chi guida la tecnologia conta più di qualunque dettaglio di configurazione. Un’istruzione a prompt, stia nel CLAUDE.md o in una regola o in un output style, è una richiesta che il modello interpreta e quasi sempre rispetta. Una barriera costruita con hook e permessi è un fatto meccanico che non dipende dal giudizio del modello. La prima si piega sotto pressione, la seconda no. Quando in gioco ci sono dati sensibili, ambienti di produzione, o un comando che non deve partire mai, l’unica risposta seria è quella deterministica.

C’è anche un costo che si accumula nel tempo, e somiglia parecchio a quello di cui scrivo da mesi a proposito del debito cognitivo. Un CLAUDE.md senza proprietario cresce, e ogni riga in più si carica in ogni sessione di ogni persona, pesando sul budget di token e annacquando le istruzioni che servono. È un debito di contesto: lo paghi poco alla volta, finché un giorno la finestra è piena di righe che nessuno legge e il modello segue peggio quelle importanti. La cura è la stessa di sempre, un proprietario, una revisione, e la disciplina di spostare ogni istruzione dove il suo costo e la sua autorità corrispondono al compito.

Nei vari testi che scrivo da un po’ ho provato più volte a descrivere l’interfaccia tra la mente e gli strumenti che la estendono, e guidare un agente è proprio quel punto: il momento in cui un’intenzione umana si traduce in qualcosa che una macchina eseguirà al posto tuo. Quando hai qualcuno di questi meccanismi a posto, puoi raccoglierli insieme, skill, subagent, hook e output style, dentro un plugin, e condividere un assetto coerente con il team o tra i progetti.

Senza dubbio nei prossimi mesi questi strumenti diventeranno più semplici e più capaci. La domanda che resta aperta è chi, nella tua organizzazione, possiede la mappa di cosa Claude può e non può fare, e la tiene aggiornata mentre la finestra di contesto si riempie. Se è il genere di mappa che serve disegnare per la tua azienda, è una delle conversazioni che porto al tavolo nel mio lavoro di advisory.


Fonte: Anthropic, Steering Claude Code: CLAUDE.md files, skills, hooks, rules, subagents and more, 18 giugno 2026. Approfondimenti nella documentazione ufficiale su subagent e output style.

Vendor lock-in AI: l’errore architetturale dei progetti enterprise

Conversazione vera, due settimane fa, con il CTO di un’azienda manifatturiera italiana medio-grande. Loro hanno un sistema AI in produzione da quattordici mesi, costruito sopra le API di OpenAI con function calling, prompt engineerizzati con cura, memoria conversazionale gestita in Pinecone, agente che orchestra cinque tool diversi. Funziona bene, gli utenti sono contenti, il management è soddisfatto. Mi chiama perché ha letto i miei articoli su AI privata e vuole capire se ha senso, per loro, valutare una migrazione verso un setup on-premise con modelli open-weight.

La mia risposta è stata: “Tecnicamente sì, però oggi la migrazione vi costa quanto rifare metà del prodotto da zero”. Lui ha avuto un momento di silenzio, poi ha chiesto: “Come è possibile? Usiamo l’API standard di OpenAI. Mi avevano detto che era portabile”. La risposta a quella domanda è il tema di questo articolo. È un fenomeno che chiamo “vendor lock-in tecnico AI“, e fa fallire più progetti AI enterprise di quanti se ne discutano apertamente.

Il debito tecnico che non si vede

Le aziende che costruiscono prodotti AI sopra API cloud accumulano un debito tecnico di portabilità che non emerge nei primi mesi. Funziona tutto, perché ogni provider rispetta il proprio contratto API. Però sotto la superficie, dozzine di scelte tecniche e operative legano profondamente il prodotto al provider specifico, in modi che diventano evidenti solo quando si prova a cambiare.

Vorrei elencare i punti di lock-in più ricorrenti, in ordine crescente di gravità.

System prompt engineerizzati per quirk specifici del modello. Ogni LLM ha le sue idiosincrasie. Claude reagisce a certe formulazioni in modo diverso da GPT-4. Gemini ha pattern di risposta tutti suoi. Mistral e Llama hanno default culturali diversi. Quando il vostro team di prodotto ha lavorato 6 mesi per perfezionare prompt che funzionano bene sul modello scelto, quei prompt non funzionano più allo stesso modo se cambiate modello. La migrazione richiede re-engineering completo, con cicli di test e regression.

Function calling con sintassi proprietaria. OpenAI ha introdotto il function calling con uno schema specifico. Anthropic ha il suo formato per i tool. Gemini ha un altro ancora. Anche se tutti sono “function calling”, il modo in cui passare gli schemi, gli argomenti, le risposte è leggermente diverso. Codice che orchestra agenti complessi con dieci tool diversi è ricco di queste specificità.

Embedding model legati al provider. Se avete fatto RAG con embeddings di OpenAI ada-002 o text-embedding-3-large, quei vettori non sono compatibili con embeddings di Cohere, Voyage, BGE. Per cambiare modello di embedding, dovete re-indicizzare tutto il corpus documentale, che su grandi volumi richiede tempo e costa risorse.

Vector database con schemi rigidi. Avete usato Pinecone con metadati strutturati in un certo modo, indici composti definiti, filtri configurati. Migrare a Qdrant, Weaviate o Milvus significa rifare lo schema, validare i risultati, magari riadattare le query applicative.

Memoria conversazionale tarata sul modello. I limiti di token, le strategie di summarization, le truncation policies, sono tutti calibrati sul modello specifico. Cambiando modello, la memoria si comporta diversamente, i contesti vengono troncati in modo diverso, le conversazioni perdono coerenza in punti diversi.

Monitoring e observability legati alle API. Avete configurato logging strutturato per le chiamate OpenAI con i loro request ID, latency metrics, cost tracking basato sui loro pricing tier. Cambiare provider significa rifare l’osservabilità.

Skills del team. Il vostro sviluppatore AI senior conosce profondamente l’API OpenAI dopo due anni di lavoro. Conosce le edge case, sa come reagire ai 429, ha intuizione per i prompt che funzionano. Su un provider nuovo, quella conoscenza è azzerata. Servono mesi di learning curve.

Sommato tutto, una migrazione fra provider AI cloud su un’applicazione in produzione di 12+ mesi richiede tipicamente 2-4 mesi di lavoro di team specializzato. Quei mesi sono pieni di rischio: i clienti si lamentano dei comportamenti diversi, qualità delle risposte temporaneamente peggiore, bug che emergono solo in produzione, costi che non rientrano nei piani.

L’astrazione che salva la vita architetturale

C’è una soluzione architetturale ben nota, e si chiama “abstraction layer”. L’idea è semplice: invece di chiamare direttamente le API del provider AI, fate passare ogni interazione attraverso un layer intermedio che espone un’interfaccia stabile compatibile (tipicamente compatibile con OpenAI, perché è lo standard de facto). Il layer si occupa di tradurre nel formato del provider specifico sottostante. Quando volete cambiare provider, cambiate solo il layer, non le applicazioni.

Sembra banale, ma poche aziende lo fanno bene. La maggior parte di quelle che ho visto in advisory ha un’astrazione “leggera” che gestisce solo il routing delle chiamate al LLM, ma non astrae le altre cinque-sei superfici di integrazione (embeddings, vector DB, memoria, tools, logging). Risultato: il giorno della migrazione, scoprono che l’astrazione copre solo il 30% del problema.

L’astrazione completa deve coprire sette superfici, e qui entra il valore di un orchestratore maturo come LocalAI.io, su cui ho investito personalmente come cofondatore.

1. Chat completions. LocalAI espone l’endpoint OpenAI-compatible standard, ci puntate il vostro codice esistente, e il modello sotto può essere Llama, Mistral, Qwen, DeepSeek o anche un OpenAI/Claude pass-through. Cambiate il modello dalla console, le applicazioni continuano a funzionare.

2. Embeddings. Stessa cosa per il modello di embedding. Esponete l’endpoint embedding-compatible OpenAI, dietro c’è il modello che decidete (bge-m3, multilingual-e5, OpenAI ada). Cambiate dietro senza toccare il codice.

3. Function calling. L’orchestratore unifica le specifiche function calling fra provider diversi, traducendo in tempo reale.

4. Vector database. Qui l’astrazione è più sottile: serve un layer applicativo (LangChain, LlamaIndex, o codice custom) che si interfacci con un’API generica di vector DB. Qdrant, Weaviate, Chroma hanno tutti adapter per le librerie principali.

5. Memoria conversazionale. Va gestita in un livello applicativo che non dipenda dal modello specifico. Esistono librerie come mem0 che fanno questo lavoro bene.

6. Monitoring. Centralizzato sull’orchestratore, non sui singoli provider. Tutto il logging passa per il layer, indipendentemente da chi sta servendo le richieste.

7. Cost tracking. Anche qui centralizzato. L’orchestratore conta i token, applica le sue policy di pricing, espone le metriche aggregate.

Con un’astrazione completa di queste sette superfici, una migrazione di provider AI può ridursi a un’ora di lavoro di reconfigurazione, invece di tre mesi di refactor. È una differenza che, su un’applicazione enterprise, si traduce in 50.000-200.000 euro risparmiati ogni volta che cambiate.

Quando vale la pena pagare il costo dell’astrazione

Una nota di onestà. L’abstraction layer ha un costo iniziale. Aggiunge una dipendenza al vostro stack, un piccolo overhead di latenza (5-30ms tipicamente), un componente in più da manutenere. Per startup che stanno facendo POC veloci, è probabilmente overkill, perché il rischio di voler cambiare provider entro 6 mesi è basso e gli investimenti accumulati sono minimi.

Per le aziende enterprise che stanno costruendo un sistema AI destinato a vivere 3-5 anni, l’astrazione vale praticamente sempre l’investimento. Tre situazioni dove l’astrazione è essenziale:

Quando il modello scelto oggi non sarà quello di fra 24 mesi. L’ecosistema AI evolve velocemente. Nel 2024 OpenAI dominava. Nel 2026 Claude, Gemini, Mistral, modelli open-weight sono tutti competitivi su task specifici. Nel 2028 lo scenario sarà ancora diverso. Un’azienda che si lega oggi a un singolo provider si trova a inseguire la concorrenza con due anni di ritardo.

Quando la compliance può cambiare. Una banca italiana che oggi usa Claude potrebbe domani avere requisiti che impongono di portare il modello in casa per AI Act o evoluzioni normative. Se ha un’astrazione, la migrazione è di una settimana. Se non ha, sono 4 mesi.

Quando vi serve usare modelli diversi per task diversi. L’approccio “best model per ogni task” sta diventando standard. Claude per scrittura, GPT per reasoning, DeepSeek per codice, Qwen per estrazione strutturata, Mistral per italiano fluente. Senza astrazione, dovete integrare 5 SDK diversi. Con astrazione, è un parametro nel routing.

L’errore tipico che vedo nei progetti AI enterprise

Per chiudere, vorrei raccontare il pattern di errore più frequente che vedo nei progetti AI enterprise che falliscono. Si svolge sempre nello stesso modo, in tre fasi.

Fase 1: prototipo veloce. Il team prodotto vuole muoversi rapidamente. Chiamano direttamente l’API OpenAI, fanno il POC in due settimane, lo presentano al management. Il management è entusiasta, dà luce verde a una versione di produzione. Decisione presa: usiamo OpenAI come fornitore principale.

Fase 2: produzione e accumulo. Nei 12-18 mesi successivi, il team costruisce features sopra features. System prompt sempre più sofisticati, function calling, RAG con Pinecone, agenti multi-step. Tutto su API OpenAI. Nessuno si pone il problema dell’astrazione perché funziona tutto bene.

Fase 3: il momento di verità. Arriva una di queste situazioni: i costi OpenAI superano i budget previsti, il management chiede di portare l’AI in casa per ragioni di sovranità o compliance, un competitor si vanta di prestazioni migliori con Claude e il management vuole switchare. A questo punto il team scopre che la migrazione costa 3-4 mesi di lavoro e mette a rischio il prodotto. Si rinvia. Si rinvia ancora. Poi qualcuno decide che è meglio non toccare niente, e l’azienda resta legata al provider scelto due anni prima, anche quando non è più la scelta migliore.

Quel pattern, per me, è la singola causa più frequente di stagnazione strategica nei progetti AI enterprise italiani. La soluzione non è tecnicamente difficile (un abstraction layer maturo si setta in due settimane). È una decisione architetturale da fare presto, prima che l’accumulo di lock-in la rende troppo costosa.

Tre azioni concrete per chi sta valutando ora

Per chi sta costruendo o ha appena messo in produzione un sistema AI enterprise, tre azioni che vale la pena valutare nei prossimi 30 giorni.

Audit del lock-in attuale. Mappare quali punti del vostro stack sono legati al provider AI specifico. System prompt, embeddings, function calling, vector DB, memoria, logging, expertise del team. Quantificare quanto tempo costerebbe oggi una migrazione totale a un provider diverso. Se la stima è oltre un mese di lavoro, avete un debito tecnico che vale la pena ridurre.

Introduzione progressiva dell’abstraction layer. Non serve un big-bang refactor. Si può introdurre un’astrazione progressivamente: cominciando dalle chat completions (l’80% del traffico tipico), poi embeddings, poi function calling. In 6-8 settimane è possibile arrivare a un’astrazione completa su un sistema esistente.

Test di portabilità periodici. Anche se non avete intenzione di cambiare provider oggi, fate un esercizio: ogni 6 mesi, provate a far girare una percentuale del traffico (5-10%) su un provider alternativo via l’abstraction layer. Misura due cose: la qualità delle risposte resta accettabile, e l’astrazione regge il routing. Se sì, siete davvero portabili. Se no, scoprite dove sono i punti deboli mentre i costi della migrazione sono ancora bassi.

Per chi vuole approfondire il setup di un’architettura AI sovrana basata su abstraction layer, ho scritto questa serie di articoli: GDPR e LLM, hardware locale, TCO on-premise, scelta del modello open-weight, AI Act checklist, installazione di LocalAI, cloud sovrano italiano. Insieme coprono lo stack completo. Per una conversazione specifica sul vostro contesto, c’è la pagina Advisory.

La domanda finale, quella che cambia il futuro architetturale del vostro sistema AI, è semplice. Se domani il provider che usate oggi raddoppiasse i prezzi, deprecasse il modello che vi serve, o cambiasse i termini commerciali in modo per voi inaccettabile, in quanto tempo sareste in grado di rispondere? Se la risposta è in mesi, avete un problema architetturale che vale la pena affrontare adesso, mentre la migrazione costa ancora poco.