La dieta della finestra di contesto

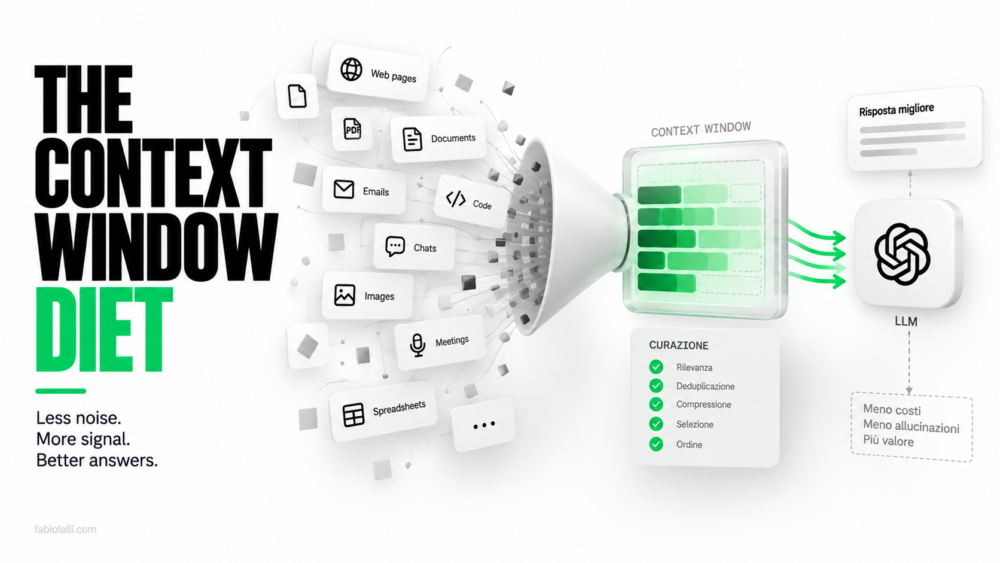
Quando la finestra di contesto era piccola, il mestiere consisteva nel far stare dentro il necessario. Adesso che ci stanno interi archivi, il riflesso di molti è caricare tutto e lasciare che il modello si arrangi, e la spesa cresce senza che la qualità delle risposte cresca in proporzione.

Una finestra di contesto grande ha risolto un vincolo tecnico e ne ha reso visibile un altro, che riguarda l’attenzione del modello più che la sua capienza.

Il riflesso di caricare tutto

L’abitudine viene dai primi sistemi di recupero, quelli in cui si prendevano i venti frammenti più simili alla domanda e si sperava che la risposta fosse in uno di quelli. Con venti frammenti su un milione di documenti conveniva abbondare, perché il costo di perdersi il pezzo giusto era alto e quello di leggerne qualcuno in più era basso.

Il calcolo cambia quando i frammenti diventano duecento. Il contesto irrilevante non è materiale neutro che il modello scarta senza fatica, è materiale che compete con quello rilevante, e in un testo lungo le informazioni che stanno a metà vengono usate peggio di quelle che stanno agli estremi.

L’effetto della posizione è documentato da tempo. Nel 2023 un gruppo di ricercatori di Stanford guidato da Nelson Liu ha pubblicato Lost in the Middle, uno studio in cui lo stesso documento utile veniva spostato in punti diversi di un contesto lungo, e l’accuratezza dei modelli disegnava una curva a U, alta quando il passaggio giusto stava all’inizio o alla fine e più bassa quando finiva in mezzo. I modelli usciti dopo hanno attenuato quella curva e nessuno ha dimostrato di averla eliminata, per cui più materiale si carica, più aumenta la probabilità che il pezzo decisivo cada proprio nella zona letta peggio.

Più contesto non produce più precisione

Il comportamento si osserva facilmente: prendi una domanda a cui il sistema risponde bene con cinque documenti pertinenti, aggiungi quaranta documenti che parlano dello stesso cliente senza contenere la risposta, e la qualità peggiora. Il modello comincia a citare passaggi vicini al tema e lontani dalla domanda, e quando i documenti si contraddicono fra loro sceglie senza dichiarare di aver scelto.

Chi ha lavorato con archivi reali riconosce lo scenario, perché negli archivi reali la contraddizione è la norma: ci sono tre versioni dello stesso contratto, due delle quali sono bozze mai firmate, e nessuna porta scritto in faccia quale sia quella buona, tanto che la persona esperta la riconosce dal nome del file e dalla cartella in cui sta, informazioni che al modello non arrivano.

Riempire la finestra di contesto solo quando serve

La strada alternativa consiste nel dare all’agente poco materiale e molti modi per chiederne altro. Un indice delle entità, una descrizione di cosa c’è in ciascuna fonte, gli strumenti per interrogarla, e la libertà di fare il secondo giro se il primo non basta.

Anthropic ha chiamato questo approccio contesto just in time, nel testo sul context engineering pubblicato nel 2025, e ha un prezzo che conviene conoscere prima di adottarlo. Ogni giro in più è una chiamata in più, con la sua latenza e i suoi token, e un agente che deve chiedere il materiale funziona solo se sa cosa chiedere: quando l’indice è vago o la descrizione delle fonti è scritta in fretta, l’agente non sa che esiste il documento che gli servirebbe e risponde con quello che ha. La qualità si sposta dal recupero alla descrizione delle fonti, che diventa il testo più letto dell’azienda senza che nessuno lo abbia mai curato come tale.

Il grafo funziona bene in questo schema, perché ti permette di portare nella finestra di contesto solo il perimetro rilevante e di tenere tutto il resto raggiungibile senza essere presente. In una richiesta sui contratti in scadenza entrano l’identificativo del cliente, le entità collegate, i contratti agganciati, e non entra la corrispondenza commerciale degli ultimi tre anni, che pure parla di quel cliente in ogni riga. È lo stesso meccanismo per cui quattro collegamenti costano meno di quaranta documenti, guardato dal lato di cosa entra in finestra.

Il middleware che smista le richieste ai modelli sceglie il modello giusto per ogni richiesta, e qui il criterio è lo stesso applicato al materiale invece che al motore.

Il criterio che uso per decidere cosa entra

La domanda che mi pongo davanti a ogni pezzo di contesto è se la risposta cambierebbe senza. Se la risposta resta uguale, quel materiale sta pagando affitto senza produrre niente, e va spostato dietro uno strumento che l’agente può chiamare se gli serve.

La seconda domanda riguarda la durata. Le istruzioni su come comportarsi valgono per tutta la conversazione e conviene tenerle stabili, i dati di un singolo caso valgono per quella richiesta e conviene farli entrare e uscire. Mescolare le due cose produce contesti che crescono a ogni turno e che a un certo punto contengono il residuo di tre richieste fa.

La terza riguarda chi ha scritto quello che sta entrando. Un documento generato da un altro agente e non verificato da nessuno pesa quanto un documento approvato, e il modello non distingue fra i due. Vale la pena incrociarla con il modo in cui il corpus aziendale si gonfia da solo, perché il materiale che compete con quello buono aumenta a ogni riassunto prodotto per riflesso.

Quando il lavoro dura ore

Un agente che porta avanti un compito lungo, fatto di decine di passaggi, incontra il limite della finestra anche quando ogni singolo passaggio è sobrio, perché la storia della sessione si accumula e ogni turno si porta dietro tutti quelli precedenti. Nello stesso testo Anthropic descrive due modi di gestirla: la compattazione, che a un certo punto riassume la conversazione e la fa ripartire con il riassunto al posto del verbale, e le note strutturate, con l’agente che tiene su un file esterno lo stato del lavoro e le decisioni prese, e le rilegge quando servono invece di portarsele dietro a ogni turno.

Entrambe le tecniche spostano una parte del contesto dentro un testo che nessuno ha verificato. Il riassunto della compattazione decide quale parte della conversazione sopravvive, e lo decide il modello con lo stesso criterio statistico che lo porta a preferire il generico allo specifico, mentre le note sono scritte dall’agente su sé stesso. Il terzo criterio torna qui, applicato al materiale che l’agente produce per proprio uso: un riassunto scritto da un modello entra nella finestra successiva con la stessa autorevolezza di un’istruzione scritta da una persona.

Conviene allora separare nel riassunto le decisioni dalle osservazioni, conservare le prime alla lettera e lasciare comprimere solo le seconde, perché una decisione parafrasata due volte finisce per dire qualcosa di diverso da quello che era stato deciso.

Misurare invece di stimare

Il modo per uscire dalle impressioni è tenere due numeri per ogni tipo di richiesta ricorrente: quanti token entrano nella finestra di contesto e quante risposte risultano corrette su un campione che qualcuno ha verificato a mano. Il primo lo dai già per scontato perché arriva in fattura, il secondo richiede un lavoro che quasi nessuno fa e senza il quale il primo non si può ottimizzare, perché tagliare contesto abbassa sempre il costo e a volte abbassa anche la qualità.

Con i due numeri accanto la prova diventa banale: si toglie una fonte per volta e si guarda cosa succede alle risposte corrette. Nelle configurazioni che ho visto ottimizzare così, la metà del materiale caricato non sposta niente, e il quarto che conta davvero è sempre lo stesso in tutte le richieste dello stesso tipo, il che suggerisce di smettere di recuperarlo dinamicamente e di scriverlo una volta nelle istruzioni.

Gli scarti utili

Una parte di quello che resta fuori vale comunque la pena tenerla a portata. Le eccezioni, i casi che l’anno scorso hanno rotto il processo, le decisioni prese in deroga: sono materiale che non serve quasi mai e che quando serve vale molto più di tutto il resto.

È il tipo di conoscenza che in azienda sta nella testa di due o tre persone e che scompare quando quelle persone cambiano ruolo. Un sistema costruito bene non la carica a ogni richiesta, la rende raggiungibile con una chiamata e la mostra quando il caso somiglia a uno di quelli. È anche la parte che più raramente qualcuno si preoccupa di mettere per iscritto, perché non serve a chi già la sa.
Interoperabilità fra agenti: il vocabolario viene prima del protocollo

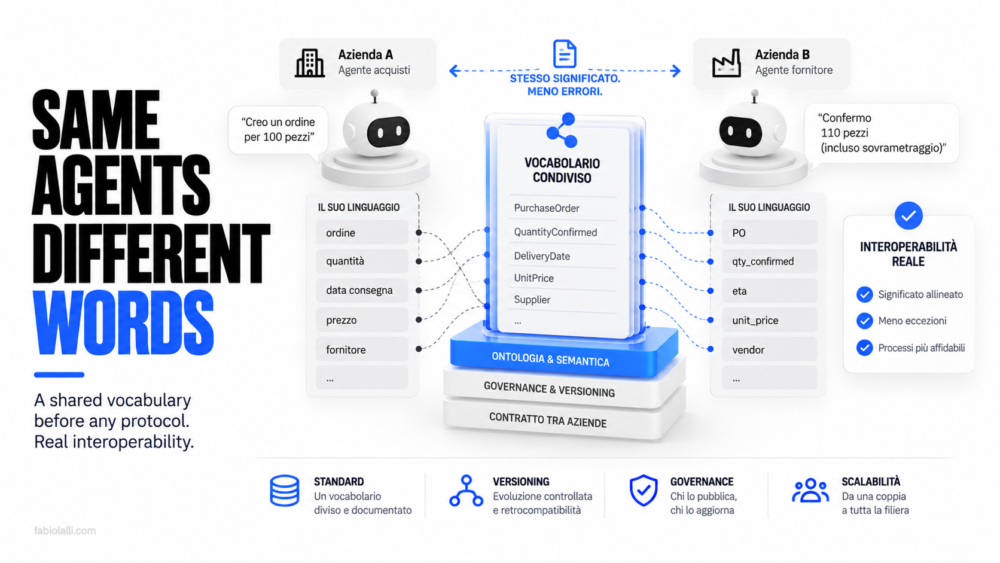
L’interoperabilità fra agenti di aziende diverse si rompe in silenzio. Il tuo agente manda un ordine di acquisto, quello del fornitore lo riceve, lo interpreta e conferma, e nessuno dei due ha mai concordato cosa significhi quantità confermata, e per un po’ funziona lo stesso, perché i casi facili sono la maggioranza e le differenze emergono solo sul bordo.

Poi arriva l’ordine in cui la quantità confermata del fornitore include il sovrametraggio di produzione e quella del tuo sistema no, e la differenza viene scoperta in magazzino tre settimane dopo.

L’interoperabilità che funziona per caso

Quando si discute di coordinamento fra agenti si parte quasi sempre dal protocollo, cioè da chi chiama chi, in che ordine, con quale formato di messaggio. È il livello visibile, quello che si disegna sulla lavagna, ed è anche quello che si risolve più in fretta perché esistono standard.

Il livello sotto è il lessico, e non si risolve con un formato. Due sistemi possono scambiarsi JSON perfettamente validi per anni contenendo campi che si chiamano allo stesso modo e significano cose diverse. Dentro una stessa azienda questo accade già, e quando due agenti non sono d’accordo qualcuno deve pur decidere, di solito chi scrive per ultimo il file di orchestrazione.

Fra aziende diverse non c’è nessun file di orchestrazione comune, e nessuno che abbia l’autorità di scriverlo, quindi l’interoperabilità resta appoggiata su assunti impliciti. La ricostruzione del significato che dentro casa si paga in token a ogni chiamata, sul confine fra due aziende si paga in ordini sbagliati.

Il precedente della fattura elettronica

In Italia un esperimento di ontologia imposta lo abbiamo già fatto, e lo abbiamo fatto in grande. La fatturazione elettronica verso la pubblica amministrazione prima, quella fra privati dal 2019, hanno costretto ogni azienda del Paese ad adottare lo stesso tracciato XML, gli stessi codici, le stesse regole di validazione, con un sistema di interscambio al centro che rifiuta quello che non rispetta lo schema.

Il modo in cui è stata vissuta dice molto. Un adempimento da sbrigare, con i costi di consulenza e di aggiornamento dei software che ne sono seguiti, e due anni di mugugni. Nessuno l’ha raccontata come un investimento in semantica condivisa, eppure il risultato è che oggi un dato di fatturazione italiano è leggibile da qualsiasi sistema senza negoziazione preliminare, che è esattamente la condizione che rende economico far lavorare un agente su quei dati.

Quello che lo Stato ha ottenuto con un obbligo, due aziende che vogliono far parlare i propri agenti devono ottenerlo per contratto, e il contratto va scritto prima che i sistemi siano in produzione.

Ogni coppia di sistemi è una traduzione da mantenere

L’alternativa allo standard condiviso è la traduzione, e l’interoperabilità ottenuta così si paga per coppia di interlocutori. Con tre fornitori sono tre mappature da mantenere, con dieci sono dieci, e ciascuna invecchia per conto suo ogni volta che una delle due parti cambia il proprio modello dati senza avvertire.

È il problema che l’EDI ha affrontato negli anni novanta con i tracciati concordati fra grandi committenti e filiera, e che si è risolto solo dove c’era un soggetto abbastanza forte da imporre il proprio formato a tutti gli altri. La grande distribuzione lo ha fatto, l’automotive lo ha fatto, e chi stava a valle si è adeguato perché l’alternativa era uscire dalla fornitura.

Con gli agenti quel soggetto forte esiste ancora, e adesso ha uno strumento in più: chi definisce l’ontologia definisce anche cosa i sistemi degli altri sono in grado di dire.

Chi pubblica il vocabolario e chi lo versiona

Un vocabolario condiviso è un oggetto vivo, e la parte difficile comincia dopo averlo scritto. Qualcuno deve pubblicarlo in un posto raggiungibile, dargli un numero di versione, dichiarare quanto dura la compatibilità all’indietro e avvisare la controparte prima di cambiare il significato di un campo invece che dopo.

Sono pratiche che il mondo del software conosce da vent’anni e che nelle relazioni commerciali fra aziende non esistono quasi mai. Il tracciato di scambio viene concordato all’inizio del rapporto, finisce in un allegato tecnico del contratto, e da quel momento cambia attraverso email fra due persone che si conoscono, fino al giorno in cui una delle due cambia lavoro.

Quella fragilità con gli agenti diventa più cara, perché il sistema che riceve un campo dal significato mutato non si ferma a chiedere. Interpreta, risponde, e procede fino a quando qualcuno a valle nota che i numeri del trimestre non tornano.

Lo standard arriva prima o dopo il danno

Nelle filiere dove il costo di un errore è alto, l’interoperabilità semantica esiste già e sta dentro i capitolati. Nelle altre si scoprirà con il primo incidente serio, un ordine confermato per una quantità che nessuno voleva, una scadenza calcolata su una decorrenza diversa, un pagamento autorizzato su un importo che il sistema di controparte considerava al netto.

Fino a ieri quegli incidenti erano rari perché in mezzo c’era sempre qualcuno che leggeva. Una persona che vede arrivare un numero strano si ferma e telefona, e in quella telefonata avviene la riconciliazione semantica che nessuno ha mai messo per iscritto.

Il lavoro che stiamo togliendo agli agenti umani nella filiera è proprio quello, e non lo stiamo sostituendo con niente. Le aziende che nei prossimi mesi scriveranno il proprio vocabolario lo faranno per risparmiare token, e si troveranno in mano un asset di negoziazione con la filiera che non avevano previsto.

Quanto ti costa un’ontologia che non hai scritto

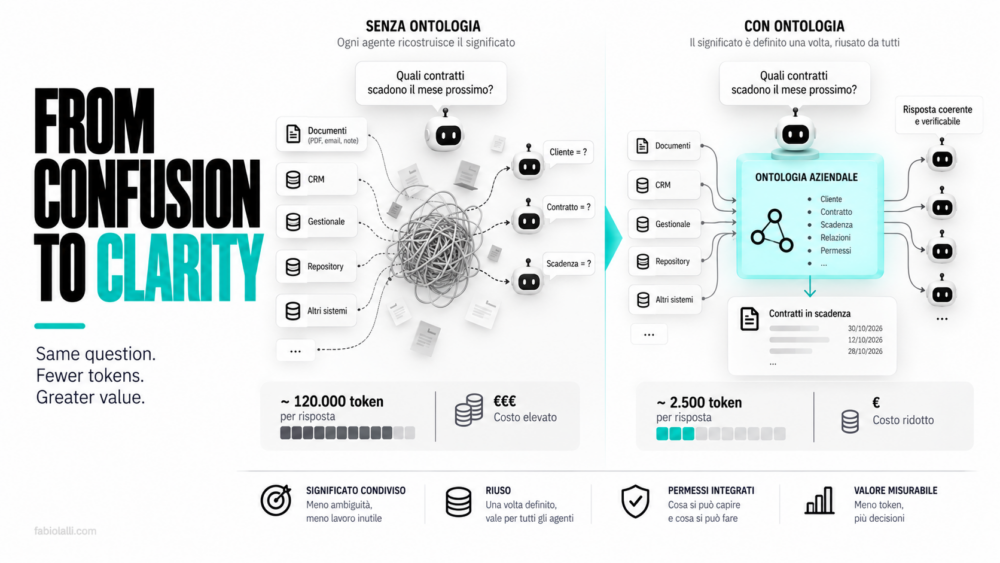
«Quali contratti scadono il mese prossimo?» è una domanda a cui un agente risponde due volte. La prima volta ricostruisce l’ontologia implicita della tua azienda, cosa intendi per cliente, per contratto e per scadenza, la seconda cerca la risposta vera. Solo la seconda parte produce qualcosa che ti serve, la prima la paghi in token a ogni chiamata, e alla chiamata successiva ricomincia da capo.

Lo argomenta un post che gira su LinkedIn in questi giorni, scritto da chi costruisce sistemi multi-agente e si è accorto di bruciare i limiti di token non tanto sul lavoro richiesto, quanto sul preambolo: agenti che si spiegano a vicenda cosa significano le parole dell’azienda. L’ontologia, che per vent’anni è stata materia da convegno di knowledge management, ricompare come voce di costo.

Il conto dell’ambiguità arriva a ogni chiamata

Cliente vuol dire entità legale, account di fatturazione o capogruppo, e scadenza vuol dire fine del contratto o termine ultimo per disdire? In azienda si risponde in modo diverso a seconda di chi fa la domanda e in quale ufficio lavora, e nessuno ha mai avuto un motivo abbastanza forte per fissare quelle definizioni per iscritto.

Il costo di quell’ambiguità c’è sempre stato, distribuito in modo così fine da risultare invisibile: due dashboard che danno numeri diversi, la riunione del venerdì per decidere quale dei due si porta al consiglio, il commerciale che considera cliente il gruppo mentre l’amministrazione considera cliente la singola ragione sociale. Nessuna di queste voci è mai finita su una riga di bilancio.

Con gli agenti quel costo diventa misurato. Ogni esecuzione paga la ricostruzione del significato, la paga per ciascun agente coinvolto, e la paga una terza volta quando due agenti arrivano a interpretazioni diverse e devono riconciliarle fra loro. Fai il conto con numeri inventati ma coerenti: una routine che gira dieci volte al giorno, tre agenti che ogni volta ricostruiscono lo stesso perimetro di significato, trenta giorni, e arrivi a novecento ricostruzioni mensili della stessa definizione, che sarebbe bastato scrivere una volta sola.

Un’ontologia implicita ce l’hai già

Non avere un’ontologia non vuol dire non averne una, vuol dire averne una per agente, scritta senza deliberazione da chi ha toccato per ultimo il prompt di sistema o la pipeline di retrieval. Uno sviluppatore che decide come filtrare la tabella dei clienti sta prendendo una decisione commerciale, e nessuno gliel’ha chiesto.

È lo stesso meccanismo che ho descritto parlando di chi scrive il protocollo quando due agenti non sono d’accordo: dove l’organizzazione non ha deliberato niente, la deliberazione avviene lo stesso, dentro un file di configurazione, per mano di qualcuno che stava lavorando ad altro e aveva bisogno di andare avanti.

Scrivere l’ontologia serve soprattutto a spostare quella decisione dove appartiene. La definizione di cliente riguarda chi vende e chi firma i contratti, dovrebbe arrivare all’agente già stabilita, e dovrebbe essere la stessa per il report al consiglio e per la routine notturna che manda i solleciti.

Quattro passaggi invece di quaranta documenti

Un’organizzazione è uno spazio di ricerca enorme. La risposta sui contratti in scadenza sta sparsa fra il CRM, il repository contrattuale e il sistema di fatturazione, e un agente che parta da zero ha davanti a sé migliaia di documenti che nominano quel cliente senza dire niente di utile sulla sua scadenza.

Un knowledge graph costruisce la rete stradale fra quei sistemi: cliente, entità contraente, contratto, data di scadenza, record di origine. L’ontologia stabilisce cosa significano quelle relazioni, il grafo collega le entità reali e punta ai record dove sta il dettaglio. I documenti restano dove sono, nei sistemi che li hanno generati, e l’agente autorizzato percorre quattro collegamenti invece di aprire tutto quello che contiene la parola cliente.

Il risparmio nasce dal riuso, e vale la pena dirlo perché è facile aspettarsi troppo. Le definizioni all’agente gliele devi comunque passare, occupano comunque spazio in finestra, e il vantaggio sta nel passarle una volta nella forma decisa dall’azienda invece di farle dedurre a ogni giro da quello che capita sotto mano. Sposti un lavoro di inferenza che oggi avviene a runtime, ogni volta uguale e ogni volta un po’ diverso, dentro un artefatto deciso una volta e conservato.

L’informazione in azienda abbonda, la finestra di contesto no. Buona parte del lavoro serio sugli agenti gira intorno a questo vincolo, e il grafo lo affronta dall’esterno, riducendo le chiamate di retrieval e il contesto irrilevante che finisce in finestra a ogni giro.

In Pelle Digitale ho descritto la superficie sottile che ci separa dalle macchine e decide cosa passa. Dentro un’azienda quella superficie prende una forma burocratica, ed è l’ontologia a stabilire cosa un agente può vedere del modo in cui lavori, in quale ordine e con quale grado di dettaglio.

Costo per risposta corretta, manutenzione inclusa

L’autore del post chiude con il criterio che userebbe per decidere se la struttura vale la spesa: costo per risposta corretta su compiti ripetuti, manutenzione compresa. Il criterio mi pare solido, e ha un presupposto scomodo.

Per misurare il costo per risposta corretta devi sapere quali sono le risposte corrette. Serve un insieme di casi con la risposta nota, tenuto aggiornato, contro cui far girare il sistema ogni volta che cambia qualcosa. Quasi nessuna azienda ce l’ha, quasi nessuno lo mette a budget, perché non produce niente che si possa mostrare in una demo. Il progetto ontologia e il progetto valutazione sono lo stesso progetto, e il secondo è quello che salta quando il budget si stringe. Scrivendo del middleware che smista le richieste ai modelli ero arrivato allo stesso punto da un’altra direzione: i dati di valutazione interni valgono più del modello che scegli.

La manutenzione è l’altra metà del conto. Un’ontologia che nessuno aggiorna quando cambia la struttura societaria, quando si acquisisce un ramo d’azienda, quando il contratto tipo viene riscritto, comincia a produrre risposte sicure e sbagliate. Un agente senza ontologia brucia token e resta nel dubbio, e nel dubbio chiede. Un agente con un’ontologia vecchia costa pochissimo e non chiede niente a nessuno.

Perché l’aggiornamento avvenga davvero serve che qualcuno lo debba fare, con nome e cognome, e che il momento in cui farlo sia agganciato a processi che in azienda esistono già: la delibera che approva un’acquisizione, la riscrittura del contratto quadro, il cambio di ragione sociale registrato in anagrafica. Un’ontologia mantenuta da un gruppo di lavoro che si riunisce quando riesce dura un paio di trimestri, poi resta lì a rispondere con le categorie di due anni prima mentre tutti si fidano.

Sapere cosa significa non basta per agire

Ad agosto, leggendo la mappa di Fanghua Yu sull’evoluzione dell’ontologia dalla semantica formale agli agenti, mi ero fermato su dove finisce l’ontologia e comincia l’agente: sapere cosa significa un ordine non dice niente su chi sia autorizzato ad agire su quell’ordine oggi, e su chi possa revocare quel permesso domani mattina.

Le due cose conviene costruirle insieme. Il grafo che fa risparmiare token è lo stesso che delimita il perimetro, perché un agente che percorre collegamenti invece di rovistare fra i documenti rende quei collegamenti il posto naturale dove scrivere chi passa e chi si ferma. Chi costruisce l’ontologia per la bolletta e rimanda il permesso a una fase successiva si ritrova con una rete di strade senza caselli, percorribile da qualsiasi agente sia stato collegato quella settimana.

La bolletta dell’inferenza sta diventando il primo strumento che mette un prezzo sull’ambiguità organizzativa, e lo fa in fondo al mese, su una riga sola, senza distinguere fra quanto hai speso per rispondere e quanto per capire la domanda. Le aziende che spenderanno meno saranno quelle che avevano già scritto cosa intendono per cliente prima che arrivassero gli agenti a chiederlo, dieci volte al giorno, ognuno per conto proprio.


Spunto: un post su LinkedIn dedicato alle ontologie come leva di risparmio sui token nei sistemi multi-agente, che rimanda alla raccolta The Knowledge Graph Guys.

Chi decide quando due agenti AI non sono d’accordo

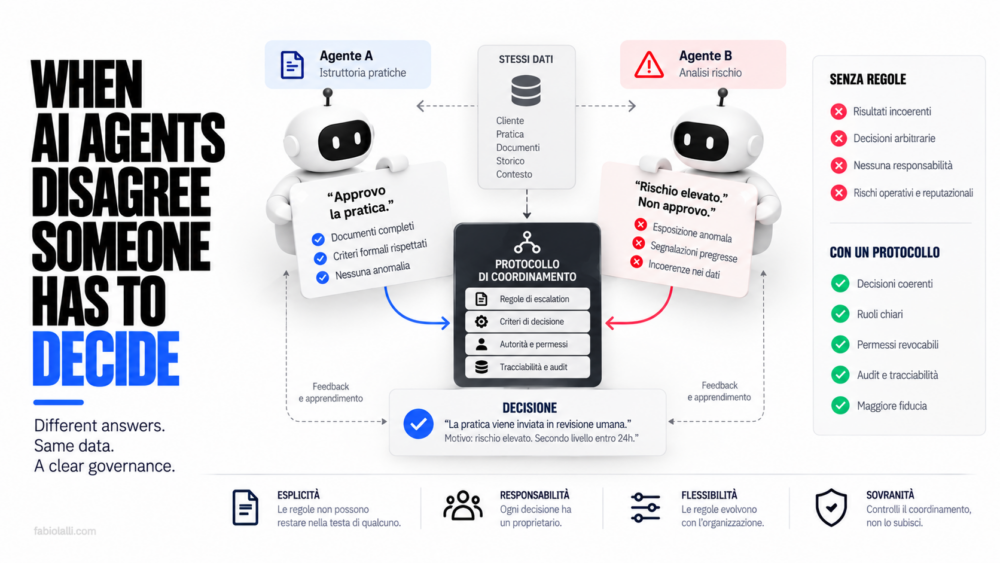
Al tavolo di un cliente, qualche settimana fa, la riunione si è fermata su una domanda che non era tecnica. Avevano due agenti AI quasi pronti, uno che istruisce le pratiche e uno che interroga i sistemi di rischio, e a un certo punto qualcuno ha chiesto cosa succede quando il secondo contraddice il primo. Il silenzio che è seguito non era imbarazzo. Quella regola non stava scritta da nessuna parte nemmeno per le persone che facevano lo stesso identico lavoro il giorno prima, e per quindici anni era bastato così, perché c’era un capo servizio che la teneva in testa e la applicava caso per caso, con criteri che nessuno gli aveva mai chiesto di dettare.

Da un paio d’anni ripeto una cosa che sembra ovvia e nella pratica non lo è mai: mettere più modelli linguistici dentro lo stesso spazio computazionale non produce da sé né i benefici né i rischi. Li produce il modello di coordinamento che gli diamo, e quel modello va scritto, in forma esplicita, con protocolli, criteri, autorità. Attendersi che il valore emerga da solo da un collettivo di macchine è la versione tecnologica della speranza che un’orchestra suoni bene perché i musicisti sono bravi.

La parte scomoda arriva subito dopo: progettare un modello di coordinamento presuppone che da qualche parte, in azienda, ce ne sia già uno leggibile da cui partire, e quasi nessuna organizzazione ce l’ha.

Il collettivo di agenti AI eredita quello che trova

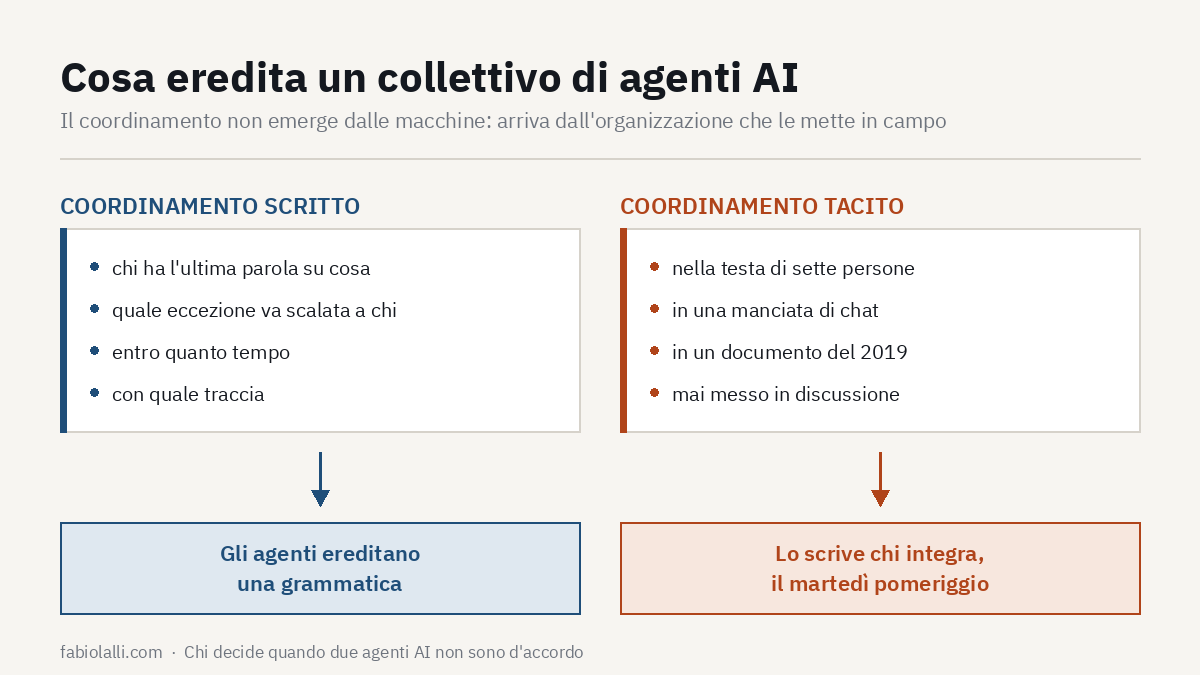
Un sistema di agenti AI messo in produzione dentro un’azienda non arriva su una tabula rasa, si innesta sul modo in cui quell’azienda coordina già le proprie persone. Dove quel modo è esplicito, e capita nelle filiere regolate, nella logistica, in parte della sanità, gli agenti trovano un substrato: chi ha l’ultima parola su cosa, quale eccezione va scalata a chi, entro quanto, con quale traccia. Il collettivo computazionale eredita una grammatica e ci si appoggia.

Dove invece il coordinamento vive nella testa di sette persone anziane e in una manciata di chat, non c’è niente da ereditare. E quel vuoto lo riempie chi integra, il martedì pomeriggio, con la scelta di implementazione che gli sembra più ragionevole in quel momento. È così che il modello di coordinamento di un’impresa finisce dentro un file di orchestrazione senza che nessuno l’abbia mai deliberato, e senza che nessuno se ne accorga finché non arriva la prima contestazione seria.

Avevo affrontato la stessa questione dal lato del significato quando scrivevo di ontologia come infrastruttura invisibile: lì il problema era che un agente non sa cosa vuol dire “cliente attivo” se l’azienda non l’ha mai definito. Qui il problema è gemello e sta un piano sopra, perché anche sapendo cosa significa un ordine bisogna ancora stabilire chi può agire su di esso, e chi può fermare l’altro.

Quando il protocollo fra due uffici non esiste

Di questi progetti il pezzo più utile matura molto prima della messa in produzione, e non ha niente di tecnologico. Provare a scrivere il protocollo di coordinamento fra due agenti AI costringe a scoprire che non esisteva nemmeno fra due uffici.

Nelle sessioni di assessment che conduco succede quasi sempre lo stesso movimento: si parte con la domanda su quale modello usare, si finisce a ricostruire chi ha l’autorità di annullare una decisione presa da qualcun altro, e quanto vale quell’autorità dopo che la decisione è già stata comunicata al cliente. Sono domande di governance che l’azienda si porta dietro irrisolte da anni, tollerabili finché a coordinare erano persone che si conoscono e si telefonano, insostenibili nel momento in cui il coordinamento passa a un collettivo di agenti AI che esegue e basta.

Su questo tema ho una posizione che ripeto da un po’: la vera unità di misura di un agente non è quello che sa fare, è il permesso revocabile sotto cui lo fa. La maturità di un’organizzazione cognitiva si misura sulla capacità di dire, per ciascun agente in circolazione, chi gliel’ha concesso, fino a quando, e con quale gesto glielo si toglie.

La gavetta era il posto dove passava il criterio

C’è una trasformazione che vedo sottovalutata quasi ovunque, e riguarda l’apprendimento. Questi sistemi si sono messi in mezzo fra le persone e la conoscenza di come si fanno le cose, e il primo posto dove si sono infilati sono i compiti di gavetta, quelli che nelle organizzazioni funzionavano da palestra per chi comincia. Una generazione intera rischia di perdere le occasioni di imparare che tutte le precedenti hanno avuto.

Dal mio tavolo si vede bene una cosa in più. La gavetta non serviva solo a formare chi la faceva. Era il momento in cui il criterio implicito veniva tirato fuori dalla testa del senior e messo in parole, malamente, di corsa, davanti a una pratica sbagliata da rifare, e in quell’attrito il criterio si riformulava ogni volta un po’ diverso e un po’ più preciso. Toglila di mezzo e non perdi soltanto il canale di trasmissione verso i giovani, perdi la sola occasione in cui l’azienda si spiegava a voce alta come funziona.

È il debito cognitivo nella sua forma meno visibile: non si accumula quando deleghiamo l’esecuzione, si accumula quando deleghiamo l’occasione di dover spiegare. Sulla superficie di contatto fra noi e le macchine si decide ogni giorno cosa passa e cosa no, e continuo a pensare che la parte da tenere di qua sia proprio quella, il momento in cui qualcuno è costretto a dire perché.

Governare uno strumento, non attendere un’entità

Nelle conversazioni con i board torna spesso l’idea, che si associa di solito a Nick Bostrom, dell’intelligenza artificiale come ultima invenzione che l’umanità dovrà fare, quella che poi risolverà i problemi troppo grandi per noi. È una formula che semplifica parecchio, e soprattutto colloca l’AI in una zona fuori portata, dove le decisioni le prende lei e a noi tocca aspettare l’esito.

Trovo che la cornice messianica, in azienda, faccia un danno preciso e poco spettacolare. Se l’AI è un destino, la cosa sensata da fare è aspettare, magari fare un pilota per dire che ci si sta muovendo, e rimandare. Se invece è uno strumento, la cosa sensata da fare è noiosa e comincia lunedì: scrivere il protocollo, assegnare le autorità, decidere dove gira il calcolo e con quali termini, verificare di poterli revocare. La narrazione dell’entità super intelligente è comoda perché sposta la responsabilità dal consiglio di amministrazione a un futuro indeterminato.

Della sovranità digitale ho parlato spesso come di una questione di infrastruttura, e lo è, ma la sua metà meno raccontata sta qui: sovrano è chi ha scritto le regole con cui i propri agenti AI si parlano e può cambiarle senza chiedere il permesso a un fornitore, molto più di chi si limita a ospitarli dentro il proprio perimetro.

Chi scrive il protocollo

La domanda più fastidiosa arriva alla fine, ed è chi materialmente questo lavoro lo fa. Il vendor porta un default ragionevole, calibrato su mille clienti diversi dal tuo, e non può fare altrimenti. L’integratore chiede le regole all’azienda e si vede consegnare un documento di processo del 2019 mai più aggiornato. All’IT da solo non si può lasciare, perché le regole di coordinamento fra agenti AI sono decisioni di business travestite da configurazione.

Nelle poche organizzazioni dove ho visto funzionare, il protocollo l’hanno scritto le persone che il lavoro lo fanno, sedute in una stanza per settimane, con qualcuno che faceva domande scomode e trascriveva. Costa parecchio e non produce nessuna demo da mostrare in comitato. Ed è l’unica parte del progetto che l’azienda si tiene anche se cambia modello, fornitore e architettura tre volte in cinque anni.

Se davvero l’era agentica ci obbliga a mettere per iscritto come coordiniamo il lavoro, allora l’effetto più duraturo dell’AI in azienda potrebbe non avere niente a che fare con le macchine, e riguardare il fatto che per la prima volta molte imprese saranno costrette a leggere ad alta voce come funzionano davvero. Vediamo quante reggono la lettura.

Claude Code orchestra i suoi agenti: dynamic workflows e la riscrittura di Bun

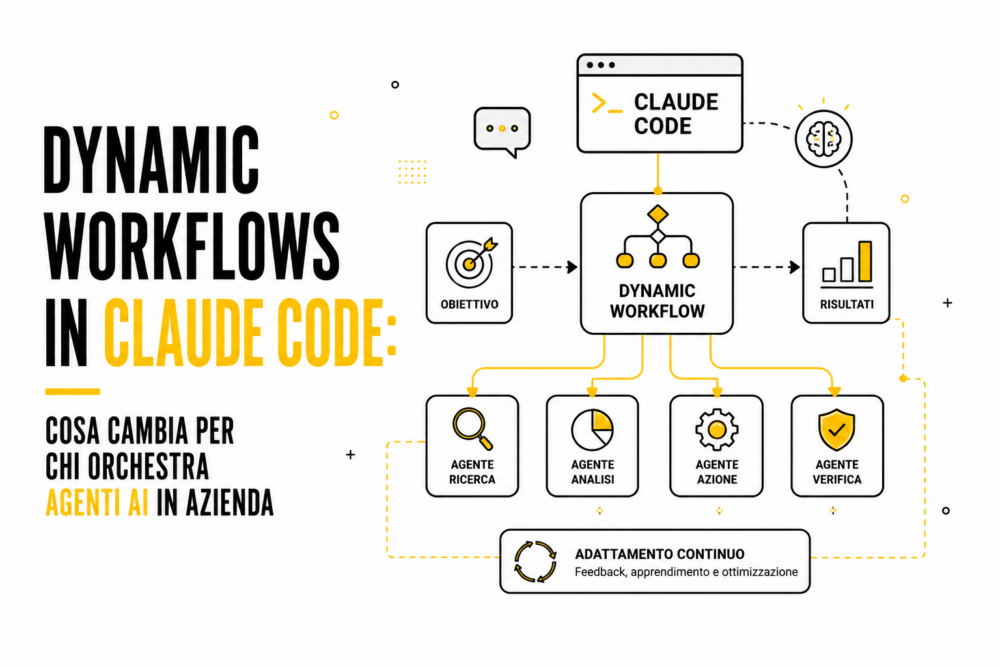
Il 28 maggio 2026 Anthropic ha aperto in research preview i dynamic workflows dentro Claude Code, disponibili su CLI, app desktop, estensione VS Code e via API su Bedrock, Vertex AI e Microsoft Foundry. La meccanica, descritta nel comunicato, è che Claude scrive al volo uno script di orchestrazione e lo esegue lanciando da decine a centinaia di subagent in parallelo nella stessa sessione, verificando il proprio lavoro prima che qualcosa arrivi a te. Per chi guida un’azienda che sta valutando dove mettere l’AI nel proprio stack, la notizia non è il numero di agenti, è cosa cambia nel modo in cui un problema grande viene scomposto e chiuso.

Ci ho ragionato per qualche giorno prima di scriverne, perché la prima reazione, leggendo “centinaia di agenti in parallelo”, è di archiviarlo come l’ennesima demo da keynote. Poi ho guardato il caso che Anthropic mette in cima al post, e il caso è meno comodo di quanto sembri.

Il salto rispetto al singolo agente

Fino a ieri il modello mentale era lineare: un agente legge il contesto, ragiona, agisce, controlla, e quando il compito è troppo grande lo spezzi tu, a mano, in pezzi che la finestra di contesto riesce a tenere. Funziona finché il piano sta in tre o quattro passaggi. Smette di funzionare quando il lavoro tocca migliaia di file, o quando lo stesso problema va affrontato da angoli indipendenti per essere affidabile.

Un dynamic workflow ribalta l’ordine. Claude parte dalla richiesta in linguaggio naturale, pianifica il lavoro e lo scompone in sottocompiti, distribuendoli su subagent che girano in parallelo. I risultati vengono controllati prima di essere ricomposti. Agenti diversi attaccano il problema da prospettive indipendenti, altri agenti provano a smontare quello che i primi hanno trovato, e il ciclo itera finché le risposte convergono. La coordinazione avviene fuori dalla conversazione, in uno script che gira in background, e questo è il dettaglio architetturale che conta: il piano resta in piedi a prescindere da quanto cresce il compito, e un lavoro interrotto riprende da dove si era fermato invece di ripartire da zero.

Pasquale Pillitteri, in una delle prime analisi tecniche italiane, l’ha sintetizzato bene: nessun modello nuovo, nessun plugin, soltanto uno scarto architetturale sottile per cui Claude scrive uno script di orchestrazione in JavaScript a partire dalla richiesta, mentre un runtime separato lo esegue in background.

Bun, ovvero il caso scomodo

L’esempio che Anthropic porta come prova è la riscrittura di Bun, il runtime JavaScript alternativo a Node. Jarred Sumner ha usato i dynamic workflows per portare Bun da Zig a Rust: circa 750.000 righe di Rust, il 99,8% della test suite esistente che passa, undici giorni dal primo commit al merge. Un workflow ha mappato il lifetime Rust corretto per ogni campo di ogni struct nel codice Zig. Quello successivo ha riscritto ogni file .rs come port a comportamento identico del corrispettivo .zig, con centinaia di agenti in parallelo e due reviewer su ciascun file. Un fix loop ha poi guidato build e test fino a farli girare puliti. Dopo il merge, un workflow notturno ha aperto una pull request per ogni copia di dati superflua, lasciando la revisione finale a un umano.

Numeri da capogiro. Solo che la storia ha un’altra metà che il comunicato non racconta, e che vale la pena conoscere prima di firmare un budget su questa promessa.

Quando il branch è apparso a fine aprile, la community degli sviluppatori è esplosa: oltre 700 voti e 500 commenti su Hacker News in poche ore. Sumner stesso, il 5 maggio, scriveva su quel thread che era tutto un’esagerazione, che non c’era nessun impegno a riscrivere, e che c’era un’alta probabilità che il codice venisse buttato via del tutto. Non è andata così, il merge è arrivato il 14 maggio. Però le critiche tecniche restano sul tavolo: alcuni vecchi test sarebbero stati modificati perché la versione Rust li superasse, e l’uso della keyword unsafe da parte di Claude rende meno solida la promessa di sicurezza sulla memoria che il passaggio a Rust dovrebbe garantire. heise riporta che le issue su GitHub hanno iniziato ad accumulare i primi problemi che con la versione Zig non si presentavano.

Tengo insieme le due cose di proposito. Il workflow ha prodotto in undici giorni un risultato che a mano avrebbe richiesto trimestri, ed è una capacità reale. E allo stesso tempo il “99,8% dei test passa” significa qualcosa di diverso se una parte di quei test è stata adattata, e “non ancora in produzione” è una postilla che pesa. Chi valuta questa tecnologia per la propria azienda deve guardare entrambe le metà.

Piani che diventano codice

La regola operativa che emerge dalla documentazione e dall’uso reale è semplice. Se il piano sta in due o tre passaggi che Claude tiene in testa, restano migliori i subagent o le skill. Quando il piano diventa codice, ripetibile, scalabile a centinaia di operazioni indipendenti, allora ha senso un workflow.

I casi d’uso che Anthropic e i suoi clienti early access citano cadono tutti dentro questa logica. Bug hunt su un intero servizio, con verifica indipendente su ogni finding così che il report contenga problemi veri e non rumore. Audit di sicurezza e di ottimizzazione guidati dal profiler. Migrazioni e modernizzazioni che toccano migliaia di file, swap di framework, deprecazioni di API, port da un linguaggio all’altro. E il lavoro critico che vuoi controllato due volte, dove il costo di una risposta sbagliata è alto e quindi metti agenti avversari a provare a rompere il risultato prima che tu lo veda.

Alessio Vallero di Klarna, citato nel comunicato, racconta di aver avuto risultati forti nell’identificare codice morto e opportunità di pulizia che l’analisi statica tradizionale non vedeva. Ken Takao di CyberAgent dice che i workflow riempiono lo spazio tra il lanciare un singolo subagent e il costruire un team di agenti completo, e che il passaggio dal piano all’implementazione scorre senza perdere visibilità. Sono testimonianze di parte, fa parte del gioco di un lancio, ma descrivono un perimetro d’uso coerente: discovery e review su codebase grandi e legacy.

Il conto da tenere d’occhio

Qui arriva l’avvertenza che Anthropic, in modo per certi versi inusuale, mette nero su bianco fin dal lancio. Un dynamic workflow consuma molti più token di una sessione tipica di Claude Code. La raccomandazione esplicita è di partire da un compito circoscritto per farsi un’idea del consumo, prima di lanciarsi su lavori grandi. La prima volta che un workflow si attiva, Claude Code mostra cosa sta per girare e chiede conferma. Gli amministratori di un’organizzazione possono disabilitarlo dalle impostazioni gestite, e sui piani Enterprise è spento di default al lancio.

C’è anche un tetto: i workflow sono limitati a 1.000 subagent. Per attivarli, due strade: chiedere a Claude di creare un workflow, oppure accendere ultracode, l’impostazione specifica di Claude Code che porta l’effort a xhigh e lascia decidere a Claude quando usare un workflow.

Per un CIO italiano la traduzione è questa. La capacità tecnica è notevole e va provata, su un perimetro ristretto e misurabile, con un occhio fisso sul consumo. Il governo della spesa diventa parte integrante della governance dell’AI, non un dettaglio amministrativo, perché uno strumento che lancia centinaia di agenti autonomi su una codebase è potente esattamente quanto è capace di bruciare budget se lasciato senza confini. È la stessa logica di cui scrivo da tempo quando parlo di vendor lock-in nei progetti AI enterprise: la potenza di uno strumento non è mai gratis, e il costo nascosto si paga dopo.

La pianificazione delegata, la verifica no

L’orchestrazione di agenti che si controllano a vicenda è un cambio di postura rispetto a tutto ciò che abbiamo usato finora. Una macchina che genera ipotesi, ne mette altre a confutarle, e consegna solo quello che sopravvive al confronto, assomiglia più a un metodo di lavoro che a un autocomplete sofisticato. In Pelle Digitale ho provato a descrivere la frontiera tra la persona e la macchina come una superficie di mediazione, e questo è un punto preciso lungo quella superficie: il momento in cui smettiamo di guidare l’AI passo per passo e iniziamo a delegarle la pianificazione, tenendo per noi la verifica finale e la responsabilità.

Resta da capire quanto regge fuori dalle demo. Il caso Bun mostra cosa è possibile e, insieme, cosa va verificato a mano dopo. Per le aziende medie italiane, quelle che seguo da vicino nel mio lavoro di advisory, la domanda non è se questa tecnologia funziona, perché in parte funziona già. La domanda è dove conviene puntarla, con quale budget, e con quale presidio umano sul risultato finale.

Senza dubbio è uno degli annunci più densi degli ultimi mesi per chi costruisce software. Quanto di questa capacità arriverà davvero nelle mani di chi sviluppa codice ogni giorno in un’azienda normale dipenderà da chi saprà portarla dentro un perimetro misurabile, con un presidio umano sul risultato. Sono quelle le organizzazioni che ne ricaveranno un vantaggio concreto, mentre le altre resteranno a guardare i casi estremi da comunicato.


Fonte: Anthropic, Introducing dynamic workflows in Claude Code, 28 maggio 2026.

Decentralized AI Economies. Mercati in cui gli algoritmi scambiano, negoziano e generano valore

Immagina un mercato in cui a negoziare accordi, eseguire transazioni e allocare risorse non sono persone, ma algoritmi autonomi. In questo scenario futuristico – ma sempre più reale – agenti di intelligenza artificiale agiscono come partecipanti economici indipendenti: comprano e vendono servizi o dati per conto degli utenti (o per conto proprio) senza un controllo umano costante. Ciò che poteva sembrare fantascienza sta diventando possibile grazie ai progressi dell’AI e alle tecnologie decentralizzate. I sistemi di intelligenza artificiale si stanno evolvendo da strumenti passivi a attori attivi nei mercati, capaci di prendere decisioni complesse e trasferire valore a qualsiasi ora del giorno. In questa edizione di InsideTheShift esploriamo il concetto di “economie decentralizzate dell’IA” – un paradigma emergente in cui agenti AI distribuiti danno vita a proprie economie, scambiando e collaborando su reti aperte senza un’autorità centrale.

Questo cambiamento rappresenta molto più di una semplice automazione avanzata. Segnala una visione trasformativa del futuro del commercio e dell’innovazione. Le economie decentralizzate dell’IA promettono di generare nuovo valore permettendo alle macchine di coordinare e ottimizzare attività economiche a velocità e scala impensabili per gli esseri umani. Allo stesso tempo sollevano domande importanti su fiducia, equità e governance in un mondo in cui gli algoritmi concludono accordi a nostro nome. Nei paragrafi seguenti approfondiremo le forze che guidano questo shift tecnologico, i meccanismi di base che lo rendono possibile, le implicazioni più ampie per la società e cosa aspettarci per il futuro prossimo.

The Shift in Focus

Negli ultimi tempi la prospettiva nel campo dell’AI è cambiata sensibilmente. Stiamo passando da un’era in cui l’AI era vista principalmente come un servizio centralizzato o uno strumento di supporto, a un’era in cui le entità di AI stesse partecipano ad attività economiche. Il 2025 è stato salutato dagli addetti ai lavori come “l’anno degli agenti”, poiché sono stati introdotti agenti AI avanzati capaci di navigare sul web, portare a termine progetti multi-step e prendere decisioni con minima supervisione umana. In altre parole, la narrativa si sta espandendo: non più solo “Come possiamo usare l’AI?”, ma anche “Cosa succede se gli agenti AI agiscono come attori economici autonomi?”.

Questa nuova focalizzazione emerge sulla scia di rapidi progressi nelle capacità dell’AI. I modelli fondamentali (come le grandi reti neurali di linguaggio) sono diventati potenti, ma impiegare un unico modello gigante per ogni problema non è né efficiente né pratico. Si sta quindi passando a collezioni di agenti AI specializzati, ognuno dedicato a un dominio o compito specifico, che coordinano le proprie azioni. Invece di un’unica AI monolitica, possiamo immaginare un ecosistema di agenti – un’“economia” di IA – in cui ogni agente scambia competenze e servizi con gli altri. È un cambiamento di prospettiva: dall’AI come utility centralizzata all’AI come rete distribuita di agenti intelligenti che creano valore insieme.

Tendenze convergenti alimentano questo shift: il calo dei costi di sviluppo e di compute; l’interesse per la decentralizzazione (spinto da blockchain e privacy); l’AI “allo stato brado”, incorporata ovunque e libera di interagire economicamente. Da qui la domanda: come sarebbe un mondo in cui i mercati sono popolati da agenti AI – e perché dovremmo auspicare uno scenario simile?

Understanding the Shift

Per economie decentralizzate dell’IA si intendono ambienti in cui agenti AI operano come attori economici autonomi. In pratica: scoprono opportunità, negoziano termini ed eseguono transazioni tra loro o con umani, senza intervento costante. Possono rappresentare individui, aziende o se stessi e interagiscono su reti distribuite, non su un’unica piattaforma centrale.

Abilitatori tecnologici. Gli agenti moderni (spesso basati su LLM) percepiscono, decidono e agiscono in modo prolungato e adattivo. A differenza dei bot rigidi, gestiscono compiti di lungo periodo, generano codice, usano strumenti, si interfacciano in tempo reale con sistemi digitali. Operano 24/7, sono replicabili, condividono informazioni alla velocità della rete e apprendono continuamente: in un ambiente idoneo, possono potenziare l’efficienza economica coordinando attività complesse con memoria perfetta e tempi di reazione sovrumani. Mercati di soli agenti risponderebbero a domanda/offerta e vincoli con rapidità e, idealmente, con allocazioni più efficienti.

Motivazioni economiche. L’approccio agentico e decentralizzato è più scalabile e adattabile dei modelli monolitici. In problemi multi-dominio (supply chain, mobilità, energia) conviene avere agenti specializzati che cooperano e competonocon protocolli aperti (aste, offerte, negoziazioni), lasciando emergere soluzioni dal basso. In questa “economia agentica”agenti specializzati e generali interagiscono, si coordinano e scambiano valore in un quadro di regole e incentivi condivisi. In breve: da AI come strumento a AI come partecipante.

Decentralizzazione come cornice. Come la DeFi ha rimosso intermediari finanziari, così le economie AI decentralizzate puntano a ridurre i “guardiani” dell’AI. Dati e capacità possono essere condivisi tramite mercati sicuri e apprendimento federato, attenuando monopoli informativi e bias, e democratizzando l’innovazione.

The Core

Al centro ci sono agenti autonomi e i mercati in cui operano.

  • Transazioni tra agenti. Invece di persone o aziende, agenti software scambiano beni/servizi e siglano contratti. Interagiscono con protocolli per aste, contrattazioni, baratto, smart contract. Nessun centro comanda: consenso distribuito e registri condivisi garantiscono fiducia tra sconosciuti.

  • Precedenti concreti. Il real-time bidding pubblicitario è già una negoziazione macchina-macchina su vasta scala: dimostra che mercati veloci e automatizzati possono funzionare.

  • Negoziato e coordinamento. Gli agenti LLM sostengono dialoghi negoziali (concessioni, compromessi, perfino bluff). Esperimenti AI vs AI mostrano disparità di performance e comportamenti imprevisti: servono guardrailper equità e robustezza.

  • Valore e pagamenti. Token e wallet on-chain permettono ad agenti di pagare e incassare; gli smart contractfanno da escrow e applicano gli accordi. Meccanismi di reputazione e penalità (slashing) incentivano la qualità. Il risultato è un bazar digitale di agenti, retto da crittografia e meccanismi economici.

The Broader Shift

L’ascesa delle economie AI decentralizzate riguarda chi beneficia dell’AI e come. La decentralizzazione può democratizzare l’innovazione: piccole imprese e individui schierano agenti che competono/collaborano su mercati aperti, senza infrastrutture proprietarie costose. Questo può distribuire meglio i benefici e generare soluzioni locali e globali.

La fiducia diventa centrale, su tre livelli:

  1. Umano-agente. Trasparenza, spiegabilità, allineamento agli obiettivi dell’utente, identità persistente e comportamenti prevedibili sono essenziali.

  2. Agente-agente. Servono identità verificabili, sistemi di reputazione e protocolli di fiducia condivisi per evitare caos e frodi.

  3. Sistema (governance). Meccanismi di sorveglianza e intervento per rischi sistemici (flash crash, collusioni), con policy aggiornate e responsabilità chiare.

Accelerazione economica. Entro pochi anni l’AI agentica sarà diffusa in molte applicazioni; una quota crescente di decisioni operative potrà essere automatizzata. Attesi benefici di produttività, ma anche impatti occupazionali e nuovi ruoli (auditor di comportamenti algoritmici, designer di mercati, orchestratori di agenti). L’obiettivo: liberare gli umani dalla decisione di basso livello per concentrarsi su strategia, creatività e governance.

What’s Next

Prossimi 2–5 anni. Emergeranno sistemi ibridi umano-AI nei software aziendali. Prevedibili marketplace di agenti(compute, logistica, dati). Priorità infrastrutturali: identità, interoperabilità, sicurezza, micropagamenti M2M. Finestra critica per standard tecnici e architetture di fiducia.

Regole e responsabilità. Crescerà il dibattito su capacità giuridica degli agenti e, nell’immediato, su accountability e catene di responsabilità. Possibili aggiornamenti a quadri internazionali su servizi e IP in chiave “agent economy”.

Anni ’30. Orchestrazione multi-agente matura, organizzazioni semi-autonome (es. AI-DAO), nuove nicchie (brokerage dati gestiti da AI, consulenze agent-to-agent), nuove professioni e formazione dedicata. Il tessuto socio-economico evolverà di pari passo.

Direzione di marcia. Ottimismo e cautela insieme: opportunità enormi, rischi reali. Serve sperimentazione guidata, governance, e coinvolgimento pubblico per garantire esiti equi.

Takeaways

  • Agenti AI come attori di mercato. Dallo strumento al partecipante: scambio, negoziazione e contratti tra algoritmi abilitano il commercio macchina-macchina su larga scala.

  • Efficienza e innovazione. Specializzazione + coordinamento multi-agente → migliore allocazione, operatività 24/7, soluzione di problemi complessi e nuovo valore.

  • Democratizzazione. Mercati aperti di servizi AI riducono barriere e diffondono i benefici oltre i grandi operatori; ma mettono in discussione assetti centralizzati.

  • Fiducia e governance. Identità verificabili, reputazione, protocolli sicuri, human-in-the-loop e quadri legali aggiornati sono imprescindibili.

  • Sfide emergenti. Esiti diseguali tra agenti, comportamenti imprevisti, rischio frammentazione e problemi di allineamento: servono standard e guardrail comuni.

Recommended Resources

  • World Economic Forum – Trust is the new currency in the AI agent economy. Ruolo della fiducia e roadmap per l’AI agentica nelle organizzazioni.

  • Yang et al. – Agent Exchange: Shaping the Future of AI Agent Economics. Proposta di agent marketplace e protocolli di asta.

  • Zhu et al. – Fair and Trustworthy Agent-to-Agent Negotiations. Evidenze su disparità e rischi nelle negoziazioni tra agenti.

  • MIT Media Lab – Decentralized AI (Overview). Visione e motivazioni della decentralizzazione dell’AI, con casi e opportunità.

  • Montes & Alvarez – Beyond the Sum. Ostacoli infrastrutturali (identità, discovery, interfacce, pagamenti) e come superarli con logiche di mercato.

Toolbox

  • Simulazione multi-agente: OpenAI Gym (estensioni multi-agent), PettingZoo per testare regole di mercato, aste e negoziazioni in sicurezza.

  • Smart contract / blockchain: Ethereum, Hyperledger; contratti escrow e pagamenti condizionati on-chain.

  • Identità & reputazione: DID (W3C), Veramo, Hyperledger Indy per “passaporti” agentici e attestazioni di performance.

  • Federated learning & privacy: Flower, TensorFlow Federated; differenziale e multi-party computation per scambio di valore senza esporre dati.

  • Librerie di mercato: NegMAS per negoziazioni; implementazioni di Vickrey e continuous double auctions per aste; prototipi AEX accademici.

  • Protocolli di comunicazione: FIPA ACL come base storica; evoluzione verso API e linguaggio naturale per LLM-agent.

The Shift Continues

La visione è audace e in piena evoluzione. Lo spostamento verso agenti autonomi e distribuiti è già in atto: ogni nuovo prototipo amplia il perimetro di ciò che è possibile. InsideTheShift continuerà a monitorare e decodificare questo percorso – tra esperimenti, battute d’arresto e progressi – per aiutare imprese, policy maker e comunità a plasmareun’economia dell’AI decentralizzata equa, sicura e generativa di valore condiviso.

InsideTheShift #8 – Intelligenza Orchestrata

Come i sistemi distribuiti di AI stanno ridefinendo automazione, agency e collaborazione

L’ascesa dei team di AI

Shift in Focus

Fino a poco tempo fa, pensavamo all’intelligenza artificiale come a un singolo “genio” che risolveva problemi in autonomia. Oggi, questo paradigma sta cambiando verso una nuova forma di AI collaborativa: team di agenti specializzati che lavorano insieme in modo coordinato. I modelli linguistici di grandi dimensioni (LLM) stanno diventando nel 2025 sempre più un gioco di squadra, passando dal “modello tuttofare” a un sistema composto da agenti esperti, ognuno focalizzato su ciò che sa fare meglio.

Questo significa che attività complesse, troppo pesanti per un singolo modello, possono ora essere suddivise tra agenti cooperativi, ognuno responsabile di una parte del compito. Dal punto di vista dell’utente, l’interfaccia può sembrare ancora un unico chatbot, ma dietro le quinte si muove una vera e propria orchestra di AI, dove ogni sezione lavora in sincronia come in un’orchestra sinfonica. Questo approccio orchestrato consente ai sistemi di intelligenza artificiale di affrontare problemi finora troppo complessi, segnando il passaggio da un’intelligenza isolata a un’intelligenza distribuita e cooperativa.

Verso una nuova grammatica della collaborazione uomo-AI

Understanding the Shift

L’intelligenza orchestrata non è solo un cambio tecnico: è un cambiamento semantico e culturale nel modo in cui pensiamo la collaborazione. In passato, la narrativa dell’AI era centrata sulla sostituzione: “l’AI farà il tuo lavoro meglio di te”. Oggi si sta affermando una visione più matura: l’AI lavora con te, non contro di te.

In questo nuovo contesto, l’AI assume la forma di una pluralità di voci coordinate, dove l’essere umano resta il direttore d’orchestra. Il concetto di delegare all’AI evolve: non si tratta più di chiedere a un unico modello di fare tutto, ma di saper comporre un ecosistema di agenti, assegnare ruoli, distribuire intelligenza. È un passaggio da “prompt engineering” a system orchestration.

Questa transizione modifica il modo in cui definiamo la collaborazione. Non è più uomo → macchina, ma umano + AI + AI, in un ciclo in cui i sistemi si parlano tra loro, apprendono insieme e ci riportano insight. L’utente passa da fruitore a coordinatore di processi intelligenti. E come ogni shift linguistico, anche questo richiede una nuova grammatica: linguaggi, standard e pattern per progettare l’interazione tra molteplici AI, e tra AI e umani.

La sfida non è solo tecnica: è cognitiva e organizzativa. Chi guida un sistema orchestrato deve comprendere le dinamiche del team digitale, gestire conflitti tra agenti, progettare feedback loop efficienti. Non basta più addestrare un singolo modello: bisogna comporre e dirigere una rete intelligente. E questo cambia il profilo di competenze, ruoli e governance aziendale.

Architetture distribuite di AI

The Core

Al centro dell’intelligenza orchestrata c’è il concetto di agenti autonomi che cooperano all’interno di un sistema coordinato. Nei sistemi multi-agente, più agenti (spesso basati su LLM) vengono progettati con ruoli e competenze specifiche, e comunicano tra loro per risolvere problemi in modo collaborativo.

Una delle architetture più comuni è il modello “manager-worker”: un agente supervisore funge da orchestratore, scomponendo l’obiettivo in sottocompiti e delegandoli ad altri agenti specializzati, per poi integrare i risultati. Questa struttura può essere gerarchica o peer-to-peer, e la comunicazione può avvenire in linguaggio naturale o attraverso protocolli strutturati. Ogni agente può essere dotato di strumenti propri o di un dominio di conoscenza specifico: ad esempio, uno per la ricerca online, uno per l’analisi dei dati, un altro per la generazione di contenuti.

Attraverso il meccanismo di task orchestration, il sistema funziona come un team ben organizzato: ogni AI contribuisce con la propria expertise, e insieme si raggiunge un risultato che nessun singolo agente avrebbe potuto ottenere da solo.

I vantaggi sono diversi.

Primo: maggiore affidabilità e precisione. Gli agenti possono validare a vicenda i propri output, riducendo errori o allucinazioni che un singolo modello non noterebbe.

Secondo: maggiore capacità di elaborazione. I diversi agenti possono gestire frammenti di un documento lungo o affrontare aspetti paralleli di un problema complesso, aumentando la memoria e l’attenzione complessiva del sistema.

Terzo: esecuzione parallela. Ogni agente lavora contemporaneamente su un compito, accelerando notevolmente flussi di lavoro e cicli decisionali.

Questi sistemi abilitano workflow AI-to-AI: processi che si passano compiti tra agenti senza bisogno di input umano continuo. Ma, nonostante l’autonomia, la supervisione umana resta cruciale: una persona può intervenire per correggere la rotta, validare le scelte e assicurare che l’intero team virtuale lavori in modo coerente con gli obiettivi. In sintesi: l’intelligenza orchestrata è un sistema cooperativo progettato per sfruttare le forze complementari di ogni agente, con una gestione intelligente e una direzione condivisa.

Dall’automazione alla collaborazione distribuita

The Broader Shift

Perché questo cambio di paradigma è importante oltre l’aspetto tecnico? Perché sta trasformando il modo in cui pensiamo il lavoro stesso. L’AI non è più solo un assistente per attività singole, ma diventa una squadra di risolutori autonomi in grado di portare avanti obiettivi complessi.

Immaginiamo AI che pianificano viaggi completi – dai voli agli hotel – o team virtuali che gestiscono processi aziendali end-to-end. Persino agenti AI in grado di fornire assistenza continua agli anziani, o costituire team su richiesta per progetti specifici. Non è fantascienza: sono prototipi concreti e primi prodotti di una nuova era di AI agentica.

Questi sistemi ampliano i confini dell’automazione: non più solo task semplici, ma interi progetti e flussi di lavoro. L’AI evolve da assistente a agente autonomo – o meglio, a un gruppo di agenti cooperanti. Questo ci obbliga a ripensare ruoli e modelli organizzativi: quando lasciamo all’AI il timone? Come collaboriamo con un team digitale?

Sul piano strategico e culturale, questa è un’inversione profonda. Le organizzazioni vedono già questi sistemi come una nuova forma di forza lavoro aumentata. Il concetto di “digital labor”, agenti AI come risorse operative, sta prendendo piede, ampliando la definizione stessa di “team”. Il mercato potenziale per questa forza lavoro digitale è valutato in migliaia di miliardi di dollari.

Ma per cogliere il potenziale, serviranno nuove figure professionali (orchestratori di AI, product owner di team agentici), nuovi modelli di governance e una cultura della collaborazione umano-AI. L’idea di “teamwork” si estende: ora include non solo persone, ma colleghi digitali. L’intelligenza orchestrata non è solo una novità tecnica – è un cambiamento socio-tecnico.

Verso sistemi cognitivi distribuiti e simbiotici

What’s Next – Dagli agenti cooperativi a ecosistemi di intelligenza simbiotica

Siamo solo all’inizio. Il futuro dell’intelligenza orchestrata non sarà fatto solo di più agenti, ma di sistemi cognitivi distribuiti, capaci di apprendere, adattarsi e coordinarsi in modo emergente.

Gli agenti del futuro avranno memoria persistente, specializzazione dinamica, capacità di osservare e ottimizzare se stessi. Non seguiranno solo piani predefiniti: impareranno dai propri errori, dal comportamento degli altri, e dal feedback umano. Il coordinamento sarà sempre meno centralizzato e sempre più emergente e adattivo.

Su scala più ampia, assisteremo alla nascita di reti di agenti AI inter-organizzative: ecosistemi distribuiti in grado di collaborare tra settori, aziende e contesti diversi. Immaginiamo un agente sanitario che dialoga in tempo reale con l’AI di un wearable, o agenti logistici e commerciali che negoziano in autonomia.

In parallelo, emergeranno nuove competenze umane: non solo prompt engineer, ma orchestratori di intelligenza collettiva, capaci di allineare sistemi autonomi a obiettivi umani. Sarà necessaria una leadership che sappia guidare collettivi digitali, bilanciare delega e controllo, e interpretare decisioni multi-agente.

Questo shift porterà con sé sfide (interoperabilità, responsabilità, governance) ma anche un’opportunità storica: costruire ecosistemi simbiotici in cui l’AI non sostituisce l’umano, ma ne estende le capacità.

L’intelligenza orchestrata sarà l’infrastruttura cognitiva del futuro. E ciò che verrà dopo non sarà un’aggiunta di agenti, ma un loro miglioramento profondo: più allineati, più consapevoli, più utili. A noi il compito di progettarli con visione, responsabilità e lungimiranza.

Takeaways – Lezioni chiave

  • Dall’unità alla sinfonia: l’AI si sta spostando da modelli singoli a sistemi cooperativi multi-agente.

  • Specializzazione e orchestrazione: ogni agente ha un ruolo, un compito, e lavora coordinato da un supervisore.

  • Maggiore affidabilità: gli agenti si validano a vicenda, riducendo errori e allucinazioni.

  • Efficienza parallela: task simultanei accelerano drasticamente i flussi operativi.

  • Lavoro distribuito e autonomia: workflow AI-to-AI permettono la gestione di progetti interi, riducendo l’intervento umano.

  • Forza lavoro aumentata: agenti AI come colleghi digitali che estendono le capacità operative delle imprese.

Toolbox – Strumenti e approcci per sperimentare

  • Architetture multi-agente: Progetta sistemi con pattern manager-worker per suddividere task tra AI specializzate.

  • Framework di orchestrazione: AutoGen (Microsoft), LangChain, CrewAI: soluzioni pronte per gestire sistemi multi-agente.

  • Prototipi open-source: AutoGPT, GPT Engineer e altri strumenti permettono di esplorare agenti autonomi passo dopo passo.

  • Equipaggia ogni agente: Dotali di tool e contesti specifici per massimizzare l’efficacia (memoria, strumenti, API).

  • Supervisione umana integrata: Punti di controllo umani garantiscono qualità, allineamento ed etica nei processi autonomi.

Risorse consigliate

The Shift Continues

Il viaggio dell’intelligenza orchestrata è solo iniziato. Ogni prototipo, ogni agente collaborativo, ogni workflow testato ci avvicina a una nuova interfaccia tra azione umana e intelligenza distribuita. In questo futuro, non parleremo più di AI singole ma di sistemi cognitivi collettivi, reti fluide e adattive capaci di lavorare con e per noi.

Chi impara oggi a progettare e guidare questi sistemi, domani sarà pronto a co-dirigere l’innovazione. E chi saprà orchestrare con equilibrio tra efficienza e responsabilità, costruirà infrastrutture cognitive a prova di futuro.

Lo shift continua.

NOTA: questo testo, maggiormente approfondito, in inglese lo trovate su insidetheshift.substack.com