Il web semantico ha aspettato il lettore giusto
Il web semantico ha una data di nascita precisa. Nel maggio del 2001 Tim Berners-Lee firmò con James Hendler e Ora Lassila un articolo su Scientific American in cui descriveva un web fatto di dati leggibili dalle macchine, con agenti software che prenotavano visite mediche incrociando calendari, coperture assicurative e distanze. L’articolo circolò moltissimo, generò standard veri, e la visita medica non la prenotò nessuno.
La scena d’apertura era quasi domestica. Pete e Lucy devono organizzare un ciclo di fisioterapia per la madre, e l’agente di Pete cerca i centri convenzionati con l’assicurazione entro una certa distanza e incastra gli appuntamenti nelle agende dei due fratelli. Quasi nessuno ricorda che quell’agente non capiva una parola di quello che leggeva: funzionava solo perché ogni pagina del web, dagli orari dello studio medico alle condizioni della polizza, era già stata descritta dai suoi autori in un linguaggio formale. Nel 2001 l’agente poteva essere stupido perché il web doveva essere intelligente.
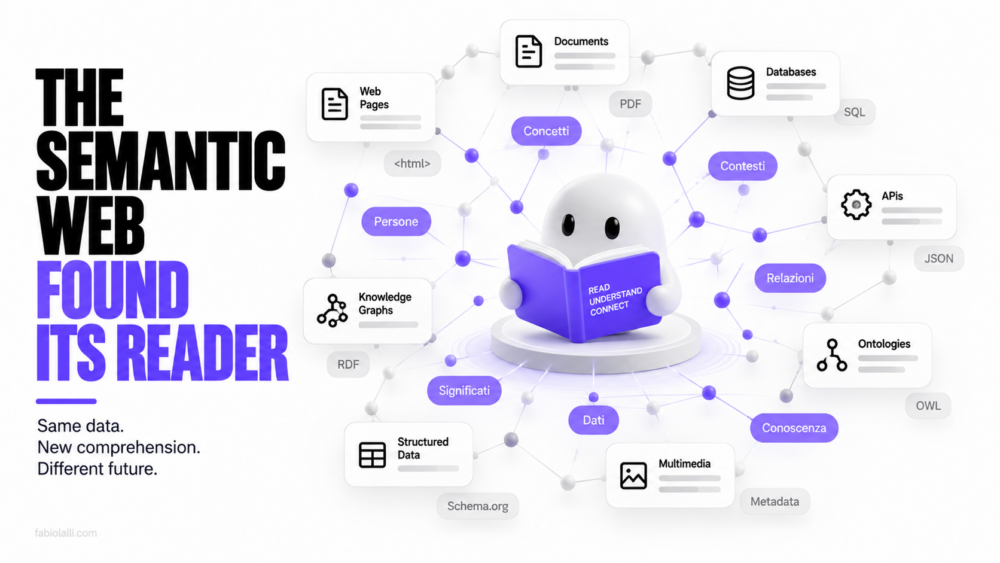
Venticinque anni dopo è andata al contrario: gli agenti hanno imparato a leggere il testo così com’è, il web non è mai stato descritto, e il vocabolario formale che doveva servire a quei software sta tornando nei progetti aziendali con un nome leggermente diverso.
Perché il web semantico non attecchì
Gli strumenti del web semantico furono costruiti sul serio. RDF per esprimere fatti come triple, OWL per definire classi e relazioni, SPARQL per interrogare. Sono tecnologie solide, sopravvissute nei domini dove la semantica vale abbastanza da giustificare la fatica: biomedicina, beni culturali, dati pubblici, editoria scientifica.
Fuori da quei domini non è successo niente, e la ragione è banale quanto decisiva. Annotare costava lavoro umano immediato, il beneficio era differito e andava a qualcun altro, e non esisteva nessuno disposto a pagare quel lavoro. Chi pubblicava una pagina non aveva motivo di descriverne il contenuto in una forma che serviva a un software di cui non conosceva nemmeno l’esistenza.
I motori di ricerca risolsero il problema per la loro strada, estraendo significato dal testo con la statistica invece di chiederlo agli autori, e quella scorciatoia funzionò così bene da togliere ogni urgenza al resto.
Adesso il lettore non è umano
La condizione che mancava era un consumatore che traesse vantaggio dalla struttura e che fosse disposto a pagarla. Quel consumatore adesso c’è, ha un costo marginale per richiesta e appartiene all’azienda che lo fa girare.
Il meccanismo si vede bene dentro un’azienda qualsiasi. Un agente che lavora sulla documentazione interna trova «cliente attivo» nel CRM, dove indica chi ha un contratto aperto, e nella reportistica amministrativa, dove indica chi ha pagato almeno una fattura nell’ultimo anno, e ogni volta deve capire quale dei due sensi vale per la domanda che ha davanti. Lo fa leggendo più contesto, a volte chiedendo, a volte sbagliando, e lo rifà alla richiesta successiva perché quella risoluzione non viene scritta da nessuna parte. Ogni ambiguità non dichiarata si paga di nuovo a ogni lettura, in token e in errori.
È un rovesciamento completo dell’economia del web semantico. Prima il beneficio era esterno e diffuso, e per questo nessuno investiva. Adesso è interno e misurabile sulla bolletta di chi costruisce l’ontologia, e chi la costruisce tiene per sé sia il risparmio sia il vocabolario. Il conto che arriva a fine mese misura l’ambiguità che nessuno aveva mai messo per iscritto, ed è la prima volta che quella misura esiste.
Per questo l’ontologia sta rientrando dalla porta dell’efficienza dopo aver fallito da quella della condivisione. Il ritorno è privato, con grafi aziendali chiusi, vocabolari che nessuno pubblica e mappature bilaterali fra chi ha bisogno di parlarsi, che è esattamente la condizione in cui la traduzione fra ontologie private si paga per coppia. Del progetto originale resta la tecnica e si perde l’idea di un bene comune, che era la parte per cui valeva la pena scriverne su una rivista.
L’unico pezzo che ha funzionato
Una parte di quel progetto ha funzionato, e vale la pena guardarla perché spiega il resto. Schema.org, il vocabolario nato nel 2011 per descrivere pagine, prodotti, eventi, ricette e recensioni, è oggi sui milioni di siti, e nessuno lo ha adottato per amore della semantica.
Lo hanno adottato perché i motori di ricerca hanno offerto un vantaggio immediato e visibile a chi marcava le proprie pagine, sotto forma di risultati arricchiti, stelline, prezzi e tempi di cottura sotto il link. Un responsabile marketing che vede il proprio risultato occupare più spazio in pagina firma quel lavoro senza chiedersi cosa sia un’ontologia.
È lo stesso meccanismo che oggi sta riportando in vita il resto. La struttura si adotta quando produce un beneficio che si vede entro il trimestre a chi sostiene il costo, e il beneficio che si vede entro il trimestre adesso si chiama spesa di inferenza.
Qualcosa di simile sta già succedendo, in scala più piccola, dal lato degli agenti. Quando Anthropic ha pubblicato il Model Context Protocol, alla fine del 2024, ha chiesto a chi espone un servizio di descrivere ogni strumento con un nome, una spiegazione in linguaggio naturale e uno schema formale dei parametri, e migliaia di sviluppatori lo hanno fatto senza discutere, per lo stesso motivo delle stelline sotto i link: se la descrizione è scritta bene l’agente usa lo strumento, altrimenti lo ignora o lo usa male. Rispetto a Schema.org questi schemi descrivono quello che si può fare, i verbi, e lasciano scoperti i sostantivi, cioè cosa sono le cose su cui si agisce, che è proprio la parte di cui si occupa un’ontologia.
Il modello che costruisce le proprie regole
C’è un secondo motivo per cui adesso funziona, e riguarda il costo dell’annotazione. Estrarre entità e relazioni da un corpus, che venticinque anni fa era lavoro manuale da specialisti, oggi lo fa un modello linguistico con una qualità che in molti domini basta.
La circolarità è evidente e va guardata in faccia. Si usa un sistema statistico per produrre lo schema formale che dovrebbe disciplinare i sistemi statistici, e se l’estrazione sbaglia una relazione, quella relazione diventa struttura, e la struttura viene creduta più del testo da cui è stata ricavata proprio perché è strutturata.
Un errore in un documento resta un errore in un documento. Un errore nel grafo diventa una regola, e le regole hanno la proprietà di sopravvivere a chi le ha scritte, come accade a ogni schema che nessuno ha più l’autorità di emendare.
La stessa dinamica vale per le omissioni. Un’estrazione automatica trova quello che somiglia a ciò che ha visto in addestramento, e le relazioni idiosincratiche di una singola azienda, quelle nate da un accordo particolare o da una vicenda societaria, sono proprio quelle che il modello tende a normalizzare in categorie più comuni. Il grafo che ne esce descrive bene un’azienda media del settore e descrive male la tua, che è l’unica per cui serviva.
La provenienza era già negli standard
Lo stack del 2001 conteneva già una risposta a questa circolarità, ed è la parte che si è usata meno. Nel 2013 il W3C ha pubblicato PROV-O, un vocabolario per registrare l’origine di un dato, cioè l’attività che lo ha generato e il soggetto che ne risponde, pensato proprio per i grafi in cui fatti di provenienza diversa finiscono mescolati.
Applicato all’estrazione automatica diventa una regola di igiene facile da enunciare e faticosa da rispettare: ogni relazione che entra nel grafo si porta dietro il passaggio del documento da cui è stata ricavata e la versione del modello che l’ha estratta. Quando una relazione si rivela sbagliata, quella traccia permette di tornare al passaggio e capire se l’errore sta nel testo o nell’estrazione. Permette anche di trovare tutte le altre relazioni nate dalla stessa fonte o dallo stesso modello, che con buona probabilità condividono il difetto.
Un grafo estratto senza provenienza è una scatola nera con l’aspetto dell’ordine, e correggerlo vuol dire intervenire su una relazione alla volta senza sapere quante altre ne condividano la causa. Con la provenienza il grafo si può interrogare anche sulla propria affidabilità, ed è questo che permette di concentrare la verifica dove serve invece di distribuirla ovunque.
Chi valida quando nessuno legge
Qui torna la parte che il web semantico non ha mai risolto e che l’automazione non risolve da sola, perché riguarda la fiducia nello schema più che la sua costruzione. Un’ontologia estratta va verificata da qualcuno che conosca il dominio, e quella verifica non si può distribuire su tutto il corpus, va concentrata dove le conseguenze pesano.
Il criterio che userei è banale: si controlla a mano quello su cui un agente prenderà decisioni con effetti verso l’esterno, contratti, pagamenti, obblighi verso clienti e autorità, e si lascia all’estrazione automatica tutto il resto, accettando che lì la qualità sia buona e non certa. Chiunque prometta una validazione completa su un grafo di milioni di relazioni sta descrivendo un progetto che finirà male.
Con questo pezzo chiudo la serie sull’ontologia. Abbiamo passato venticinque anni a spiegare alle aziende che descrivere i propri dati era un investimento, e non ha funzionato perché il beneficio non aveva un destinatario. Adesso il destinatario esiste, costa, e manda una fattura ogni mese. Non è il modo in cui speravo che arrivasse, ed è il modo in cui sta arrivando.