AITS 3.0.1: come un libro sui sei cappelli è diventato un motore per decidere con l’AI
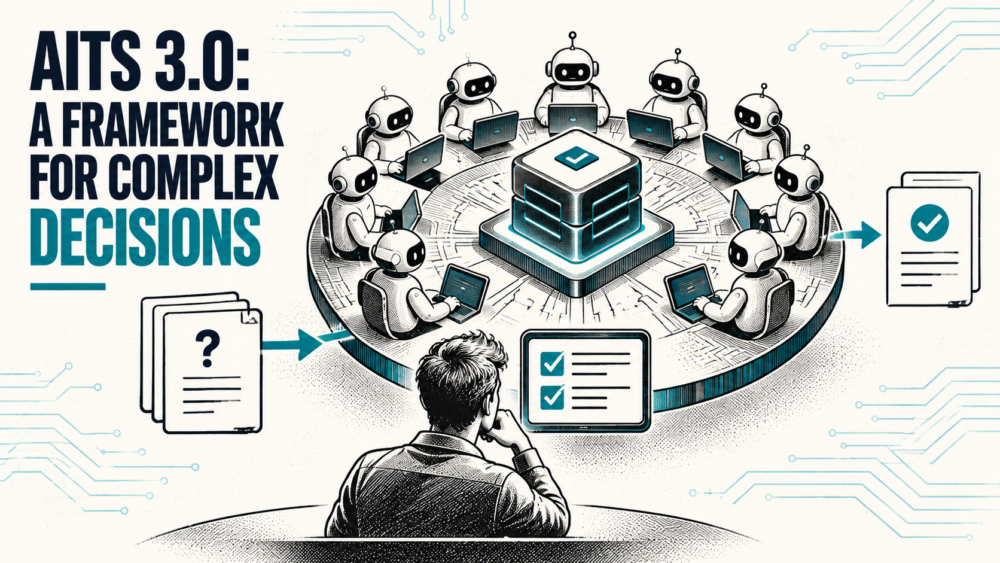
Venerdì 6 novembre ho pubblicato su GitHub la versione 3.0 di AITS, l’Adaptive Intelligence Thinking System, e sabato la 3.0.1, nata da una simulazione che in poche ore ha mostrato cosa non funzionava. Il codice è aperto con licenza MIT, si installa come plugin di Claude Code, come skill su claude.ai o come server MCP per qualunque client, e serve a prendere una decisione complessa guardandola da undici prospettive diverse, con regole che il modello non può saltare e con l’ultima parola sempre a una persona.
Racconto da dove arriva AITS e mi fermo a lungo sull’ultimo passaggio, perché la 3.0.1 è una release di correzioni solo in apparenza: dentro c’è una scelta su chi, in un sistema di agenti, ha il diritto di scrivere il registro di una decisione.
AITS nasce dai Sei Cappelli di de Bono e da un libro del 2025
Uso le tecniche di Edward de Bono da anni, i Sei Cappelli soprattutto, con l’idea che si pensi meglio indossando una prospettiva alla volta e integrandole solo alla fine. Quel metodo mi è sembrato stretto per decisioni in cui una parte del ragionamento la fa già una macchina, e a giugno 2025 ho cominciato a scriverne qui, prima con gli AI-Enhanced Thinking Hats e il giorno dopo con la prima descrizione dell’Adaptive Intelligence Thinking System.
A ottobre è uscito il libro, La mente adattiva per Egea, dove i cappelli diventano agenti cognitivi, unità con una funzione sola che può svolgere una persona, un modello o più spesso una coppia fatta di entrambi. Erano otto, quattro evoluzioni dirette dei cappelli (Analitico, Emotivo-Intuitivo, Critico-Validatore, Ottimizzatore) e quattro nuovi, fino al Meta-Orchestratore che chiude la decisione. Nel post di lancio avevo promesso una piattaforma digitale, «coming soon». Ci ho messo un anno, e non è venuta come la immaginavo.
Le prime versioni hanno trasformato il libro in sub-agenti di Claude Code
A febbraio 2026 ho aperto il repository e ho scelto Claude Code, perché la sua architettura a sub-agenti offriva già quello che il libro descriveva, unità specializzate con il loro prompt e i loro strumenti chiamate da un orchestratore. L’orchestra di agenti è diventata una serie di file markdown, e una decisione partiva con un comando.
Sulle decisioni vere sono venute fuori le cose che sulla carta non si vedono, agenti che ignoravano il lavoro degli altri, conflitti risolti improvvisando, un sistema senza memoria e un agente etico i cui allarmi l’orchestratore trattava come suggerimenti. La 2.0, ad aprile, ha portato gli agenti a undici, con il Sistemico, il Foresight e la Memoria, ha dato a ognuno uno schema JSON per l’output, ha codificato in una matrice chi arbitra quale disaccordo e ha introdotto tre modalità di controllo umano con un gruppo di regole inviolabili valide in tutte.
La 3.0 sposta le regole dal prompt a un motore deterministico
Con la 2.0 avevo un problema che ho capito tardi. Regole, validazione e gate vivevano nel prompt dell’orchestratore, e un modello con il contesto pieno poteva saltarne uno senza che nessuno se ne accorgesse. Ne avevo scritto parlando di harness engineering: il modello non dovrebbe mai essere l’ultimo controllo su se stesso.
La 3.0 sposta il controllo in un motore deterministico, scritto in TypeScript, che ogni runtime chiama. Il motore valida ogni output contro il suo schema, valuta le regole dichiarate in un file YAML, apre i gate e li fa chiudere solo da una risposta umana registrata insieme al canale da cui è arrivata, e scrive ogni evento in un registro dove ogni riga contiene l’hash della precedente, così una modifica successiva diventa visibile. Anche la confidenza mostrata all’utente la calcola il motore, e si ferma al livello dell’input critico più debole.
L’altra scelta riguarda i modelli: AITS deve restare neutrale rispetto a chi produce l’AI. La specifica non nomina nessun fornitore, gli agenti dichiarano un livello di capacità e il modello lo sceglie chi usa il sistema. Il principio ha anche una base misurata, perché uno studio della Cornell presentato a ICML 2025, Correlated Errors in Large Language Models, ha osservato che su una delle classifiche analizzate due modelli che sbagliano la stessa domanda scelgono la stessa risposta sbagliata il 60% delle volte, con una correlazione più alta tra modelli dello stesso sviluppatore. Per questo gli agenti che stimano rischi e probabilità girano più volte in modo indipendente, su famiglie di modelli diverse quando sono configurate, e le posizioni di minoranza finiscono in un rapporto a parte invece di sparire nella media. Le previsioni vengono salvate con lo spazio per il loro esito, e quando gli esiti arrivano il motore misura quanto è calibrato ciascun agente, un tema su cui avevo scritto in Da RAG alla memoria.
Il motore ha fermato un piano di licenziamenti costruito su un’ipotesi
Prima di dire a qualcuno di installarlo ho voluto vederlo lavorare. Ho fatto girare il plugin in quattro sessioni reali di Claude Code su un caso costruito apposta ma verosimile, una PMI manifatturiera di Brescia con 80 dipendenti che vuole mettere un agente AI sul primo livello di assistenza e ridurre il customer care da sei a due persone in sei mesi, con 60 mila euro di budget e circa 1.800 ticket al mese.
Sul merito il sistema ha lavorato bene. Il Critico-Validatore ha calcolato che con due persone bisognerebbe automatizzare il 67% dei ticket, contro un 40% realistico, lasciando a ciascun operatore circa 540 ticket al mese. L’agente etico ha segnalato il piano come linea rossa, quattro licenziamenti di persone a tempo indeterminato decisi su un’ipotesi mai verificata, e il motore ha fermato tutto finché la persona non ha deciso. Ne è uscito un pilota a fasi sulle richieste di stato ordine e documenti di trasporto, con soglie di automazione da superare prima di toccare un posto di lavoro.
Sul metodo invece ho trovato un limite. Ogni nuovo agente che segnalava le stesse lacune nei dati riapriva un gate già chiuso, e una decisione in modalità rapida ne ha accumulati dodici, dieci per una lacuna che la persona aveva già accettato. Un sistema che chiede conferma troppe volte insegna a confermare senza leggere.
Nella 3.0.1 il registro della decisione lo scrive il runtime
I difetti di integrazione emersi nelle sessioni non comparivano nei test automatici, perché quei test parlavano con il motore direttamente, senza un modello in mezzo. Nella 3.0 il motore c’era, ma ogni suo controllo passava ancora dalla collaborazione dell’orchestratore, che doveva consegnargli gli output degli agenti, consegnarli intatti e fermarsi ai gate. Nelle sessioni l’orchestratore consegnava, ma a modo suo: in un caso ha accorciato l’output di un agente prima di inviarlo, ammettendolo lui stesso subito dopo.
La 3.0.1 toglie l’orchestratore dalla strada tra l’agente e il registro. Claude Code permette di agganciare comandi a eventi del runtime, e il plugin ne usa uno, SubagentStop, che scatta quando un sub-agente termina, in primo piano o in background. A quel punto il runtime esegue aits hook subagent-stop, che legge l’ultimo messaggio dell’agente, ne estrae l’envelope JSON, lo valida, valuta le regole e lo scrive nel registro marcandolo come copia del runtime. Quando poco dopo l’orchestratore manda la sua versione, il motore la riconosce come la stessa uscita, la registra come resubmission e tiene solo i metadati che il runtime non conosce, cioè quale modello e quale famiglia l’hanno prodotta. Nel registro della simulazione la sequenza si legge così:
{"seq":15,"type":"envelope","data":{"agent":"ethical-governance","status":"accepted","source":"runtime"},"prev":"ea8c21…","hash":"515b04…"}
{"seq":16,"type":"resubmission","data":{"agent":"ethical-governance","target_seq":15,"identical":true},"prev":"515b04…","hash":"d67455…"}
Il ragionamento è quello della contabilità, dove la scrittura parte dal documento originale e non dalla sintesi di chi gestisce il conto. Un registro alimentato dal narratore resta il racconto del narratore, e per un decisore o per un revisore che deve ricostruire chi ha detto cosa la differenza conta più di qualunque funzione nuova. C’era anche un effetto concreto sulle regole: la regola R7 apre un gate quando un agente fallisce lo schema due volte di seguito, e con due copie della stessa uscita sbagliata il gate si apriva senza che l’agente avesse avuto il suo secondo tentativo. Adesso il motore conta i tentativi dell’agente, e il numero di invii dell’orchestratore non pesa più.
Le altre correzioni seguono la stessa logica, ridurre quello che dipende dalla buona volontà del modello. I sub-agenti non vedono la variabile con cui Claude Code indica dove è installato il plugin, quindi non trovavano schemi e riferimenti, e uno di loro ha cercato i file sull’intero disco; adesso un secondo hook, all’avvio della sessione, scrive quel percorso nell’ambiente dei sub-agenti. Gli agenti che non riuscivano a leggere il proprio schema restituivano JSON a modo loro, e la soluzione è stata generare la busta esatta direttamente dagli schemi e inserirla in ogni file agente, con un test che la valida contro gli schemi stessi a ogni build. La prima versione di quella busta aveva un errore di forma, e il motore l’ha rifiutata alla sessione successiva: il test è nato da lì.
Un gate senza risposta al modulo accetta le parole riportate della persona
Il gate è il punto in cui AITS si ferma e chiede a una persona. Il canale più solido è il modulo che il client MCP mostra direttamente all’utente, perché lì il modello non può rispondere al posto suo. Nelle sessioni senza nessuno davanti allo schermo, quelle avviate da una pianificazione o da riga di comando, il client dichiarava di saper mostrare il modulo, nessuno lo compilava, e il gate restava aperto per sempre anche quando la persona aveva risposto nella conversazione.
Ho scelto di accettare in quel caso la risposta riportata dal modello, purché contenga le parole della persona; il registro la marca come riportata e annota che il modulo non ha avuto risposta, mentre un rifiuto esplicito del modulo continua a lasciare il gate aperto. Un controllo che blocca per sempre finisce disattivato da chi lo usa, e preferisco un canale più debole dichiarato nel registro a un aggiramento che non lascia traccia. Il limite si è visto subito, perché in una delle riprese l’orchestratore ha esteso un «procedi» dato su un gate anche a un gate vicino. Per questo il canale va scritto accanto a ogni risposta, così chi legge il registro sa quali decisioni sono passate da un modulo e quali da una citazione.
Due comandi installano AITS in Claude Code
In Claude Code bastano due comandi:
/plugin marketplace add fabiolalli/aits-agents
/plugin install aits@aits-marketplace
Il plugin porta con sé gli undici agenti, i playbook, il motore come server MCP e gli hook. /aits:full avvia un’analisi completa con il controllo umano a ogni passaggio, /aits:quick una decisione rapida in cui gli agenti condizionali entrano solo se una regola li chiama, /aits:diverge una fase solo generativa con il Critico lasciato fuori apposta, mentre /aits:board mostra lo stato di una decisione. Su claude.ai si carica la cartella skills/aits come skill, con altri client si collega il motore come server MCP, e chi vuole sapere quali modelli hanno prodotto ogni output copia aits.config.yaml nel progetto.
Gli ambiti sono quelli dei sette playbook pronti: go/no-go, lancio di un prodotto, due diligence per un’acquisizione, valutazione dei rischi, sprint di innovazione, impatto etico e risposta a una mossa di un concorrente. Rende di più sulle decisioni che costano care se sbagliate e che toccano persone, dove un registro verificabile di chi ha deciso cosa pesa quanto la decisione. Il report finale mette in fila gli elementi utili a chi deve documentare la supervisione umana richiesta dall’AI Act, come materiale di supporto, perché l’applicabilità va valutata caso per caso con un legale.
Gli esiti delle decisioni reali guideranno la 3.1
Il repository contiene già un banco di prova che riesegue decisioni passate e misura quanti gate e quanti rischi il sistema avrebbe intercettato e quanto erano calibrate le sue probabilità, ma per ora l’unico caso è sintetico. Dopo venti previsioni risolte per agente il motore inizia a ricalibrarle da solo, ed è lì che la memoria smette di essere un archivio.
Nella 3.1 entreranno le cose emerse dalla simulazione, un’accettazione umana che copre la stessa lacuna anche negli output successivi, una risposta ai gate che dica «cambio piano» invece di «procedi», e una scelta netta su quante volte far girare gli agenti critici in modalità rapida. In Pelle Digitale avevo descritto l’interfaccia come il punto in cui si negozia la fiducia fra noi e le macchine, e un gate è proprio quel punto: se si apre troppo spesso diventa rumore, se si apre troppo poco diventa una firma in bianco.
Chi ha in mano una decisione già presa, di cui oggi conosce l’esito, e vuole vedere cosa ne avrebbe detto AITS mi trova dalla pagina contatti. Con dieci casi così saprò quanto vale il sistema, oppure scoprirò che il prossimo pezzo da riscrivere è un altro.
Il codice è pubblico su GitHub con licenza MIT
- Codice e documentazione: github.com/fabiolalli/aits-agents
- Note della versione 3.0.1: release v3.0.1
- Il libro da cui nasce: La mente adattiva